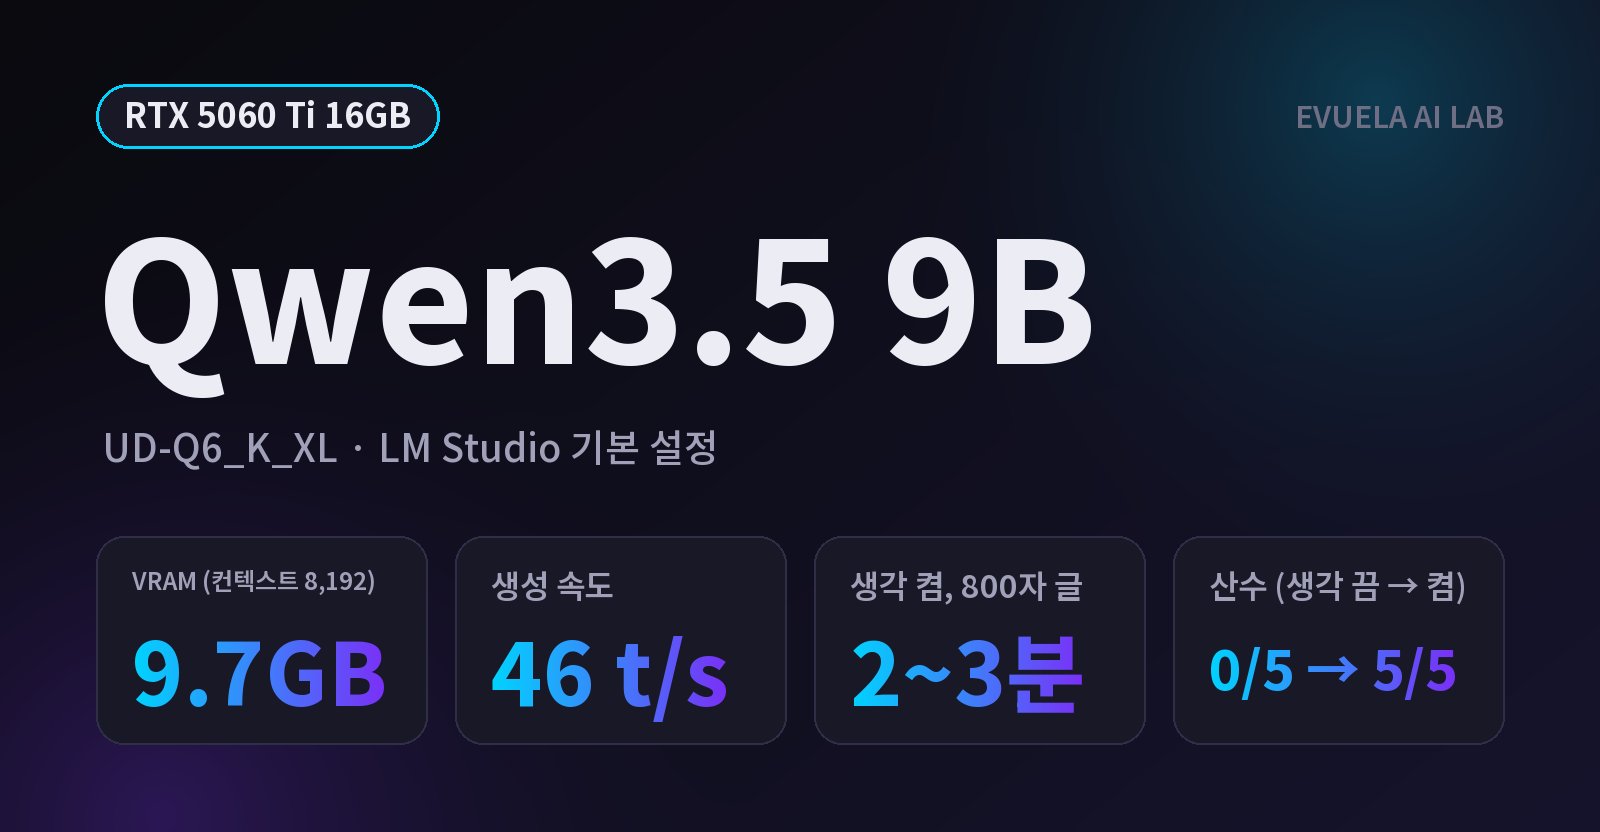
알리바바의 Qwen3.5 9B(unsloth UD-Q6_K_XL, 파일 8.76GB)를 RTX 5060 Ti 16GB PC의 LM Studio에서 기본 설정 그대로 돌려 봤습니다. 결론부터 말하면 16GB 그래픽카드에서 원활하게 돌아갑니다. VRAM은 9.7GB를 썼고, 생성 속도는 생각(Thinking)을 켜든 끄든 약 46t/s(초당 토큰)였습니다. 컨텍스트(모델이 한 번에 기억하는 글의 길이)를 131,072까지 올려도 VRAM에 다 들어갔고, 10만 자 글을 넣어도 19초 안에 답이 시작됐습니다.
다만 생각을 켜면 답이 나올 때까지 오래 걸립니다. 800자 글 하나에 생각만 4,900~7,200토큰을 써서 2~3분이 걸렸습니다. 대신 정확도는 올라갑니다. 산수 문제는 생각을 끄면 5번 모두 틀렸고, 켜면 5번 모두 맞았습니다. 한국어 답 24개에는 한자 같은 외국 문자가 한 번도 섞이지 않았습니다.
테스트 PC 사양
| 부품 | 사양 |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti (VRAM 16GB, 전력 제한 180W) |
| GPU 연결 | PCIe 3.0 x8 (메인보드가 PCIe 3.0까지 지원) |
| GPU 드라이버 | 616.92 |
| CPU | Intel Core i5-9400F (6코어 6스레드) |
| 메인보드 | MSI H310M PRO-VD PLUS |
| 시스템 램 | DDR4 32GB (16GB × 2, 2666MT/s) |
| 저장장치 | Crucial MX500 1TB SATA SSD (모델 파일 위치) |
| 운영체제 | Windows 11 Pro 25H2 (빌드 26200) |
| LM Studio | 0.4.25 |
| 런타임 | llama.cpp CUDA 12 런타임 2.47.0 (LM Studio 기본 선택) |
Ornith 1.5 9B 테스트, Gemma 4 12B 테스트와 같은 PC입니다. Ornith 1.5 9B와는 같은 날 같은 방법으로 쟀기 때문에, 이 글 곳곳에서 두 모델을 나란히 놓았습니다.
테스트한 모델: Qwen3.5 9B
Qwen3.5 9B는 알리바바 Qwen 팀이 2026년 2월에 공개한 9B(90억 파라미터) 모델입니다. 글과 함께 이미지·영상도 입력으로 받습니다. 테스트한 파일은 unsloth가 올린 UD-Q6_K_XL(6비트 양자화)입니다. 양자화는 모델의 숫자를 더 적은 비트로 줄여 저장하는 방법입니다.
| 항목 | 내용 |
|---|---|
| 파라미터 | 9B |
| 파일 | UD-Q6_K_XL 8.76GB + 이미지 인식 파일(mmproj) 1.82GB. LM Studio 표시 10.58GB |
| 최대 컨텍스트 | 262,144토큰 |
| 기능 | 이미지 입력, 도구 호출, 생각 켬·끔 |
| 라이선스 | Apache 2.0 |
모델 카드의 벤치마크 점수는 아래와 같습니다. 제작사 측정이고, 양자화하기 전 원본 모델 기준입니다(모델 카드).
| 벤치마크 | 점수(제작사 측정) |
|---|---|
| MMLU-Pro (지식) | 82.5 |
| MathVision (그림이 있는 수학) | 78.9 |
| VideoMME (영상 이해) | 84.5 |
| BFCL-V4 (도구 호출) | 66.1 |
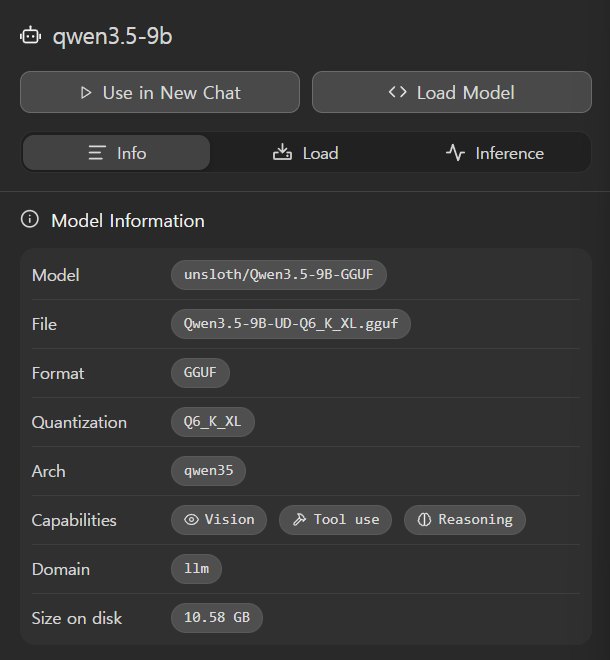
My Models 화면. Q6_K_XL, 아키텍처 qwen35, 크기 10.58GB로 표시됩니다.
LM Studio 기본 설정값
설정은 바꾸지 않고, LM Studio가 이 모델에 잡아 주는 기본값으로 테스트했습니다. 컨텍스트를 바꿔 보는 테스트만 예외입니다.
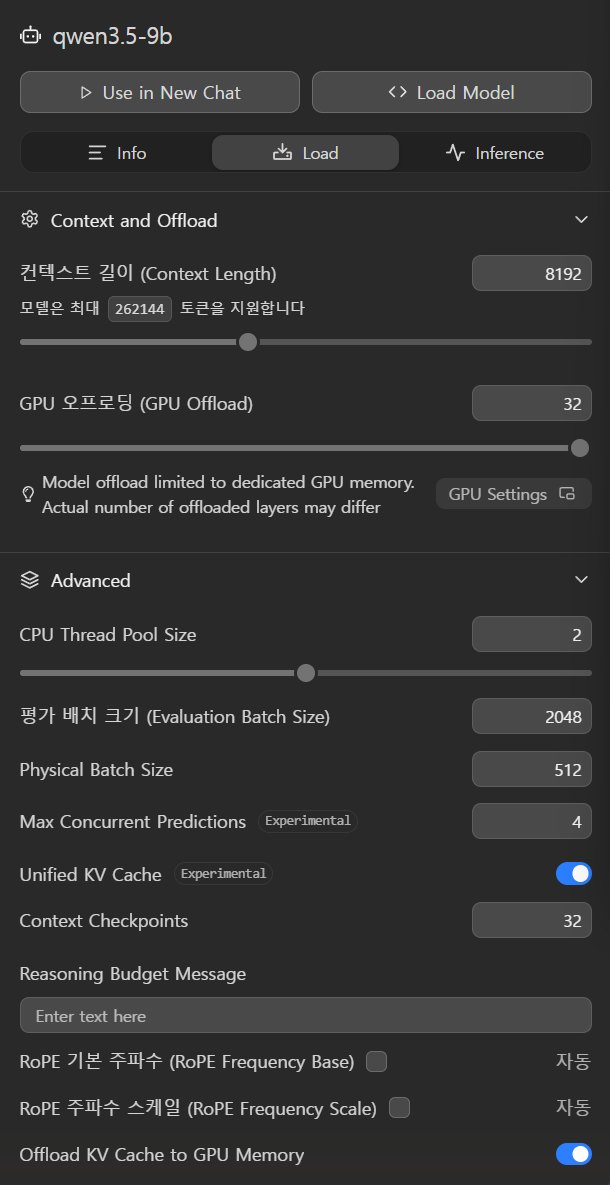
Load 탭 기본값. 컨텍스트 8,192, GPU 오프로드 32(전체 레이어)입니다.
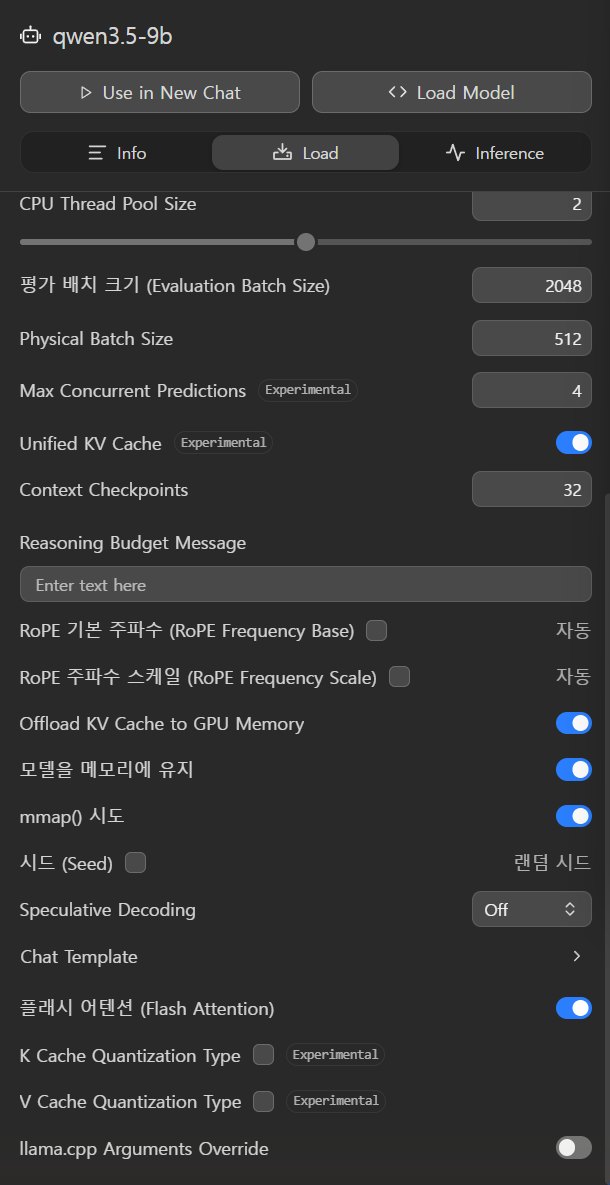
아래로 내리면 Speculative Decoding이 Off입니다. Flash Attention은 켜져 있습니다.
| 설정 | 기본값 | 뜻 |
|---|---|---|
| 컨텍스트 길이 | 8,192 | 한 번에 기억하는 토큰 수. 최대 262,144 |
| GPU 오프로드 | 32 (전체) | 32개 레이어를 모두 GPU에 올림 |
| Speculative Decoding | Off | 다음 토큰을 미리 짐작해 속도를 올리는 기능. 이 파일에는 그 기능에 쓰는 MTP 레이어가 없음 |
| Flash Attention | 켬 | 메모리를 덜 쓰고 빠르게 계산하는 방식 |
| 생각(Enable Thinking) | 켬, 한도 없음 | 답하기 전에 속으로 먼저 풀어 보는 단계 |
| 온도 | 0.1 | 낮을수록 매번 비슷한 답 |
| Top K / Top P / Min P | 40 / 0.95 / 0.05 | 다음 토큰 후보를 고르는 범위 |
| 반복 패널티 | 1.1 | 같은 말을 되풀이하지 않게 하는 값 |
모델 카드가 권하는 값은 생각을 켤 때 온도 1.0, Top P 0.95, Top K 20이고, 생각을 끌 때 온도 0.7, Top P 0.8입니다. LM Studio 기본값과 다릅니다. 이 글의 결과는 모두 LM Studio 기본값으로 잰 것입니다.
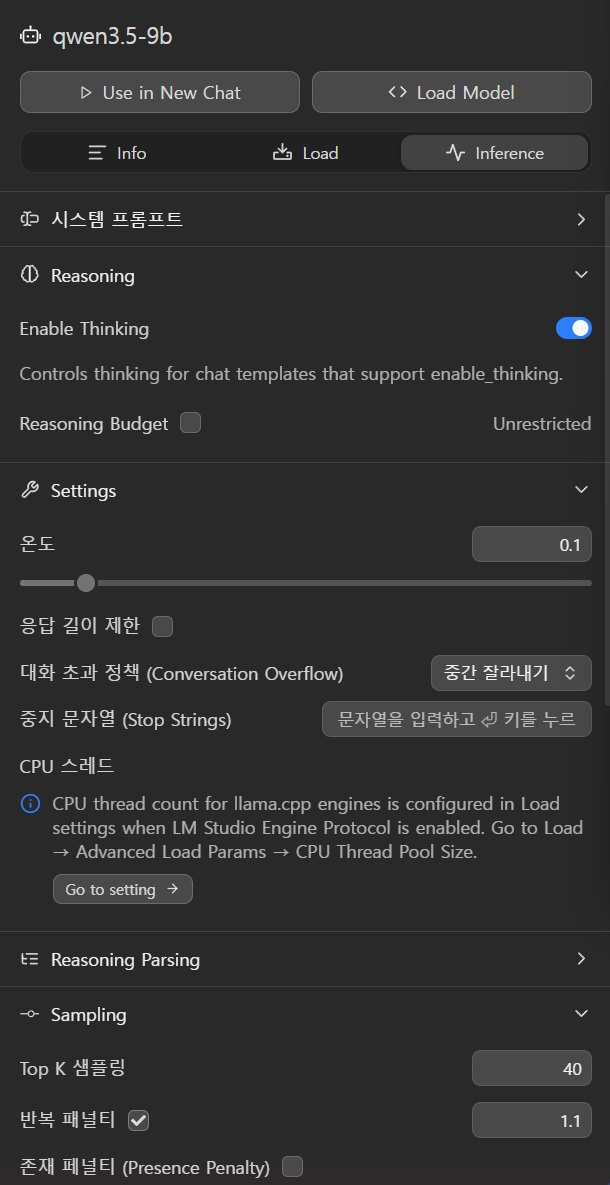
Inference 탭. Enable Thinking이 켜져 있고 Reasoning Budget은 Unrestricted(한도 없음)입니다.
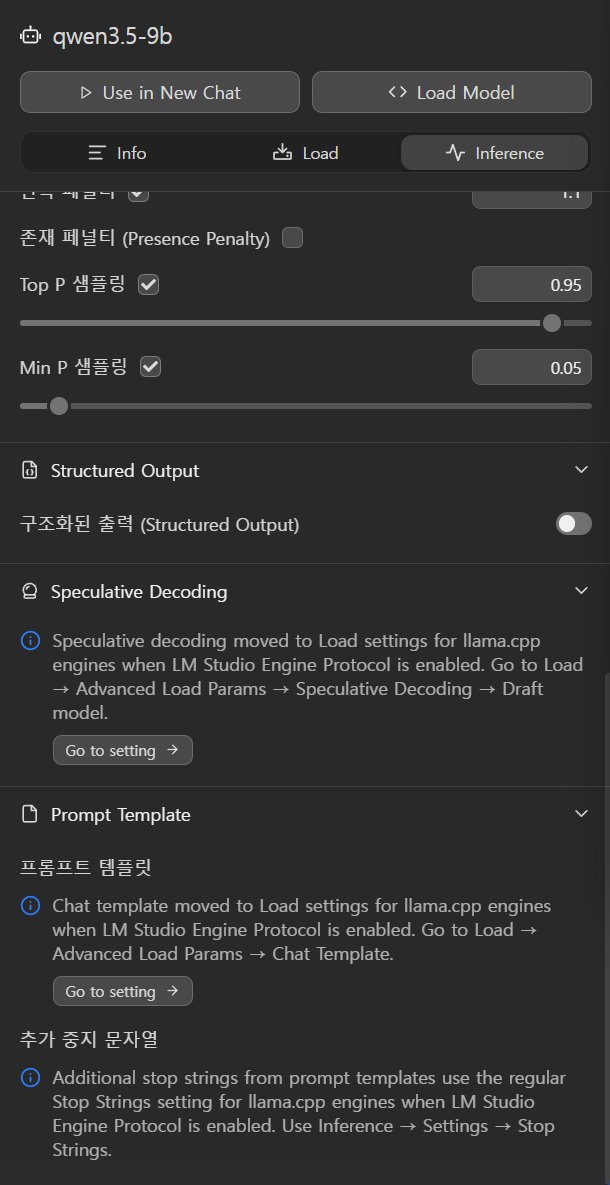
샘플링 기본값. Top P 0.95, Min P 0.05가 보입니다.
VRAM: 기본 설정에서 9.7GB
모델을 로드하기 전과 뒤의 VRAM 사용량 차이를 쟀습니다.
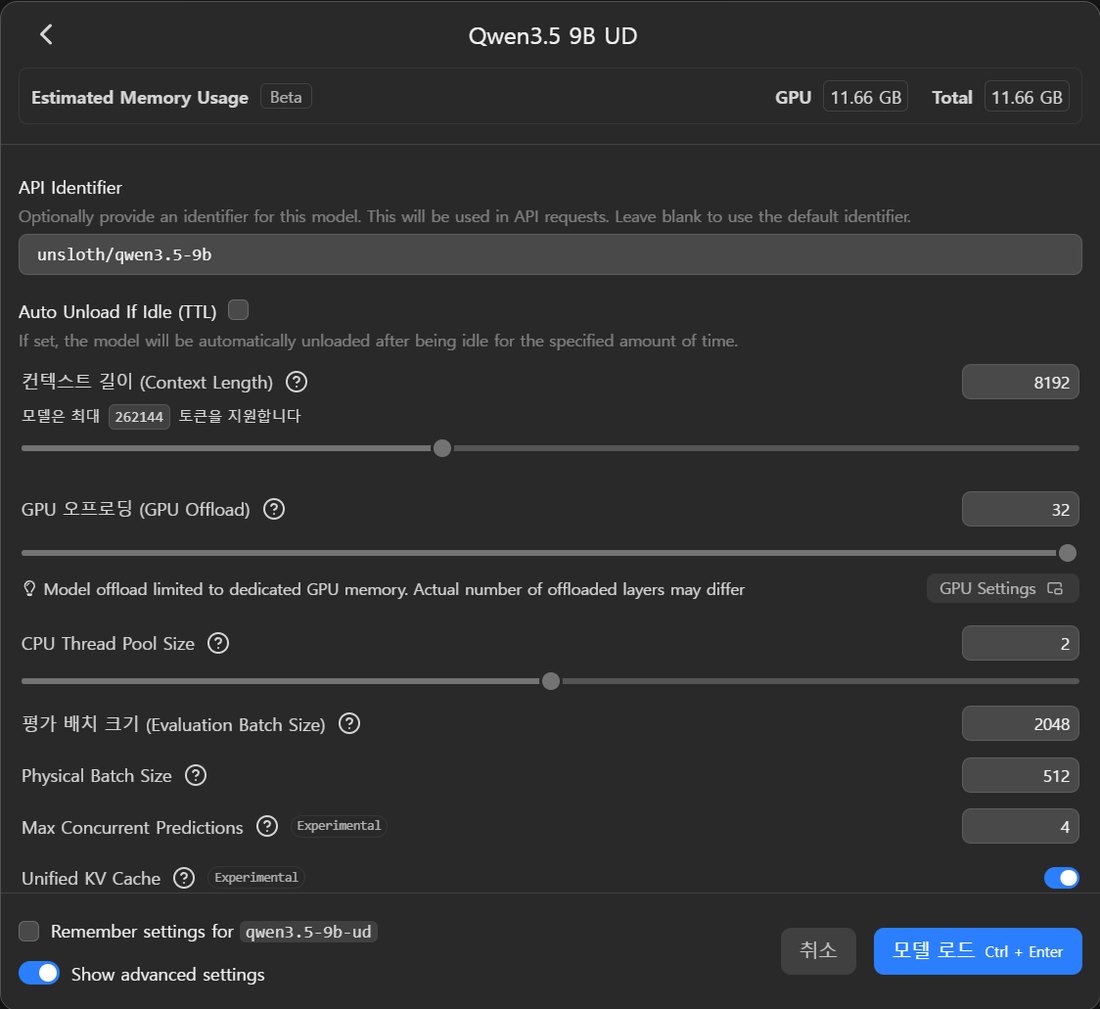
모델 로드 창. 기본 컨텍스트 8,192에서 예상 메모리는 11.66GB로 표시됩니다.
| 컨텍스트 | VRAM 사용 | 로드 시간 | 16GB에서 |
|---|---|---|---|
| 8,192 (기본) | 9.7GB | 10.0초 | 원활 |
| 32,768 | 10.5GB | 9.7초 | 원활 |
| 65,536 | 11.5GB | 9.7초 | 원활 |
| 131,072 | 13.6GB | 9.7초 | 원활 (2.4GB 남음) |
| 262,144 (최대) | 14.7GB + 시스템 램 약 3.1GB 더 | 12.0초 | 제한적 (일부가 시스템 램으로) |
131,072까지 VRAM에 다 들어갑니다. 262,144는 VRAM이 가득 차서 시스템 램을 다른 단계보다 약 3.1GB 더 썼습니다. 이 단계는 로드만 확인했고 속도는 재지 않았습니다. 같은 컨텍스트에서 Ornith 1.5 9B(Q8_0)보다 VRAM을 약 1GB 덜 씁니다.
모델을 처음 로드할 때는 디스크에서 읽어 오느라 58초가 걸렸습니다. 표의 시간은 두 번째부터의 값입니다.
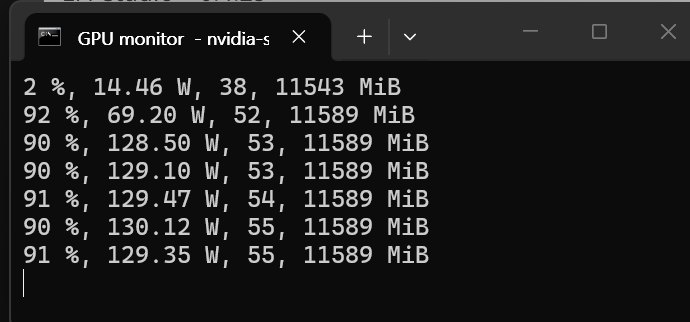
컨텍스트 32,768로 로드한 뒤 글을 쓰기 시작한 순간. 왼쪽부터 GPU 사용률, 전력, 온도, PC 전체의 VRAM 사용량입니다. 사용률이 2%에서 90%대로, 전력이 14W에서 약 129W로 올라갑니다.
생성 속도: 약 46t/s, 생각을 켜면 2~3분
"다음 주제로 800자 정도의 글을 써 주세요: 집에 있는 PC로 AI 모델을 돌릴 때 알아야 할 점"을 생각 끔·켬으로 3번씩 시켰습니다.
| 조건 | 생성 속도 | 생각에 쓴 토큰 | 끝날 때까지 |
|---|---|---|---|
| 생각 끔 | 46.4 / 46.4 / 46.6t/s | 0 | 9.0~9.6초 |
| 생각 켬 (기본) | 45.0 / 45.9 / 46.1t/s | 4,920 / 5,028 / 7,248 | 123~172초 |
| 생각 켬, 컨텍스트 32,768 | 46.0t/s | 6,823 | 162초 |
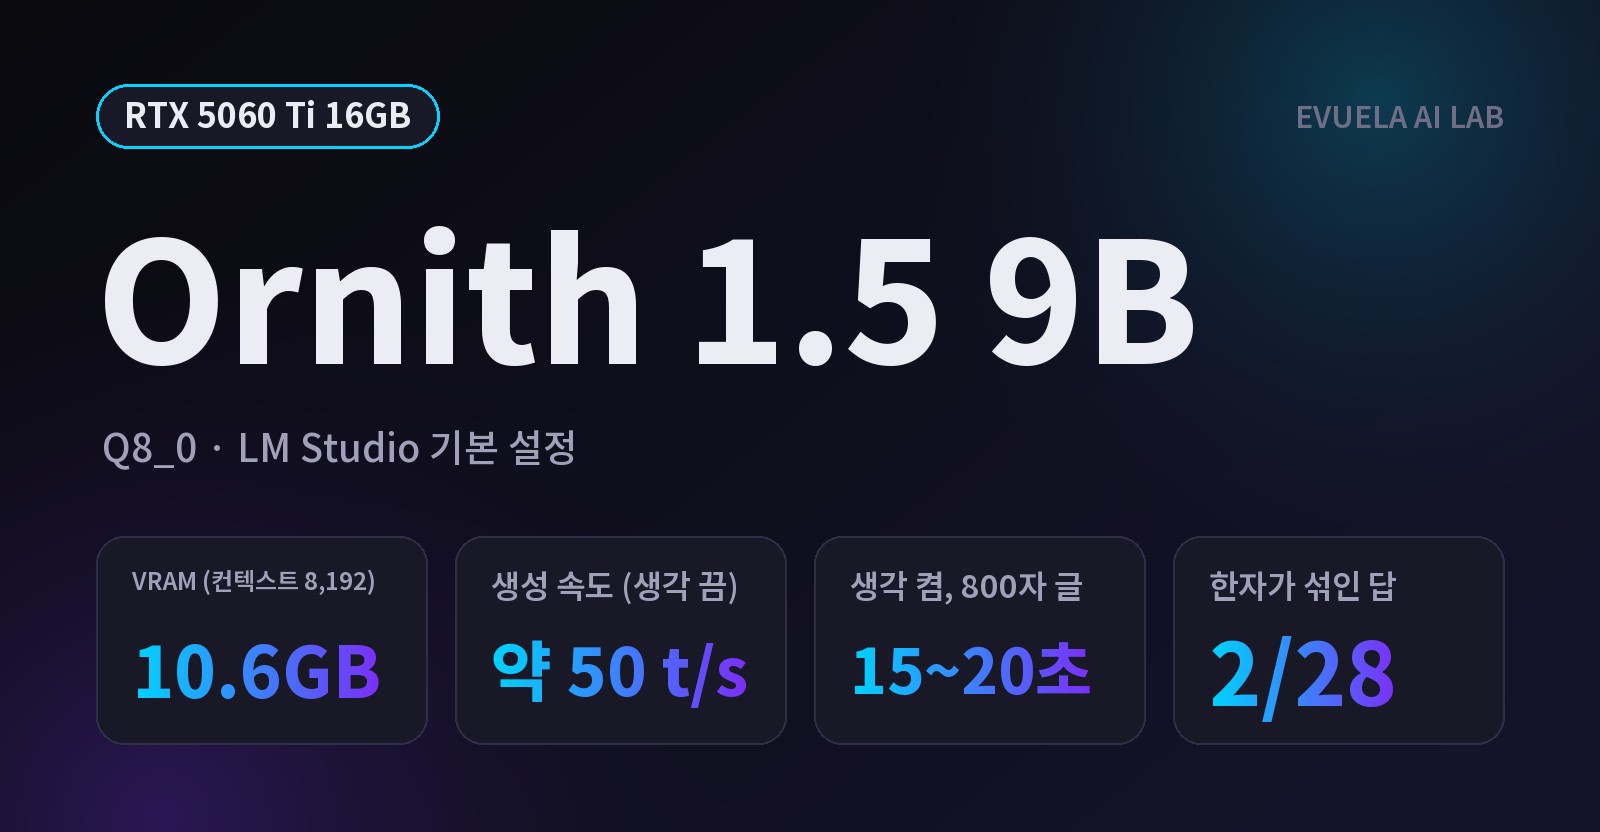
토큰을 만드는 속도는 생각을 켜도 같습니다. 달라지는 것은 기다리는 시간입니다. 생각을 끄면 10초 안에 글이 끝나고, 켜면 생각에만 2분 넘게 씁니다. 같은 질문에 Ornith 1.5 9B는 생각에 365~920토큰을 쓰고 15~20초에 끝났습니다.
기본 컨텍스트 8,192에서 생각이 넘쳐 답이 비는 일은 없었습니다. 다만 한 번은 생각만 7,248토큰을 써서 컨텍스트를 거의 다 채웠습니다. 생각을 켜고 쓸 거라면 컨텍스트를 32,768로 올려 두는 쪽이 안전합니다.
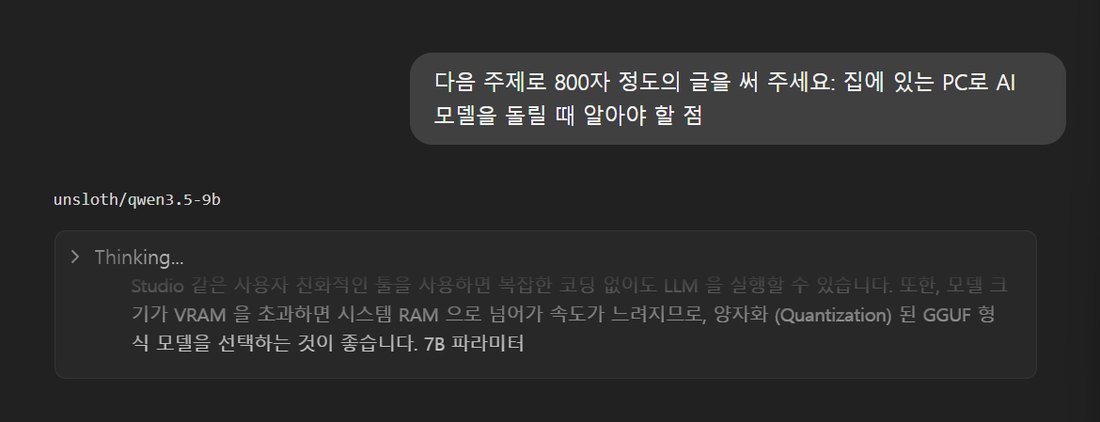
질문을 보내고 1분 뒤. 아직 "Thinking..."이고, "자"가 글자 수를 뜻하는지를 영어로 따지고 있습니다.
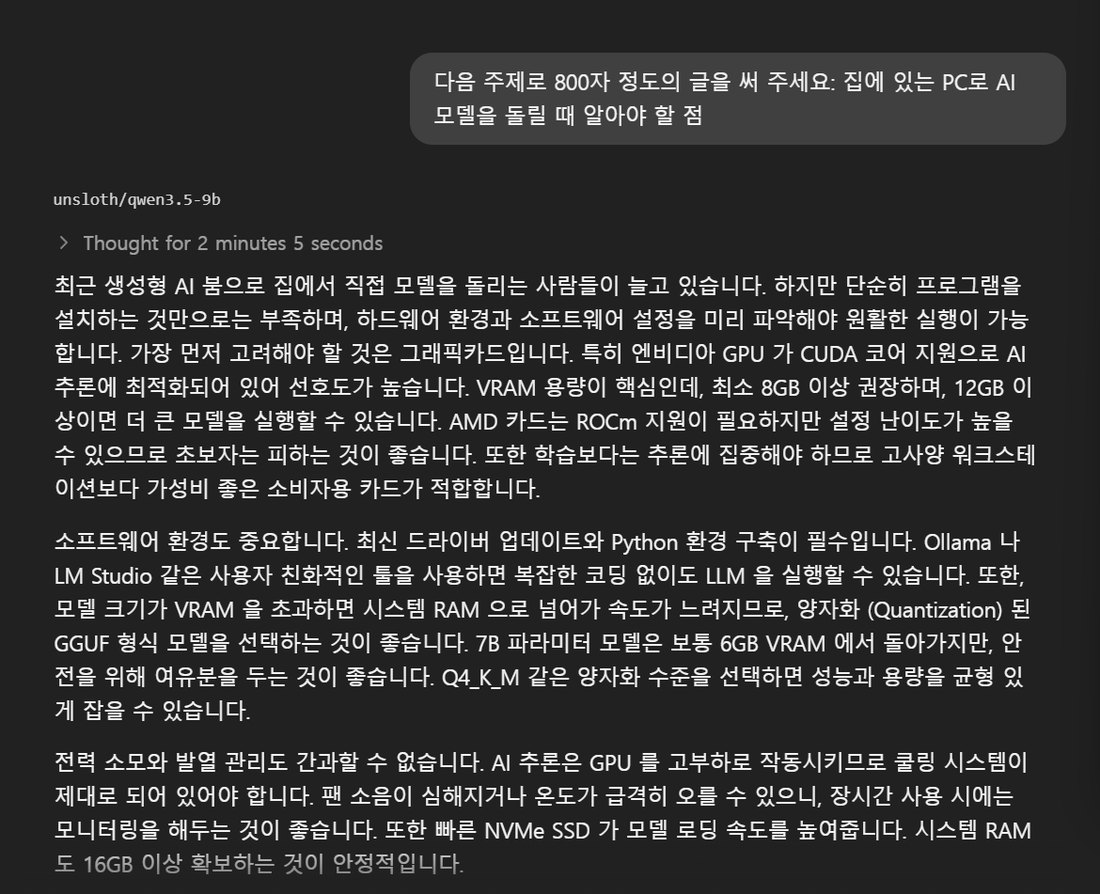
같은 채팅이 끝난 화면. 맨 위에 "Thought for 2 minutes 5 seconds"가 보입니다.
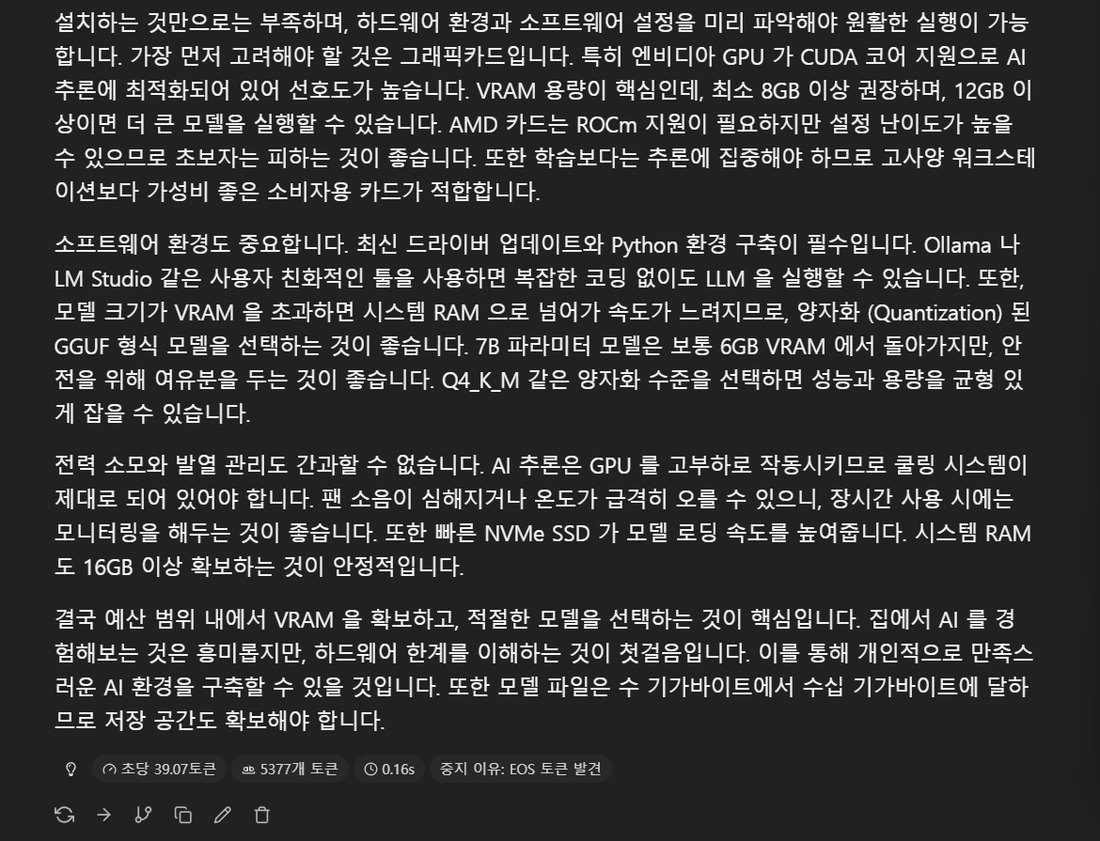
생각 켬 통계. 39.07t/s, 5,377토큰입니다. 토큰 대부분이 생각에 쓰였습니다.
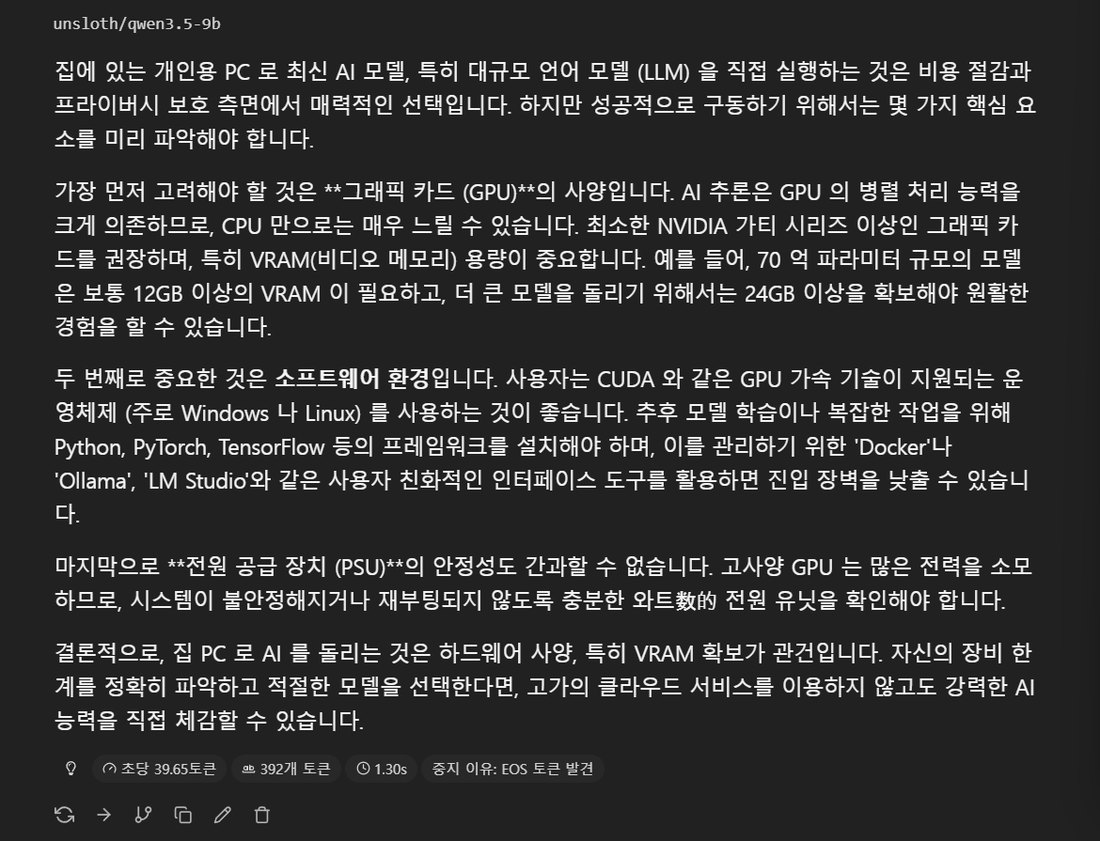
생각 끔. 39.65t/s, 392토큰입니다. 넷째 문단에 "와트数"처럼 한자가 섞인 낱말이 하나 보입니다.
캡처 속 속도(약 39t/s)는 표보다 15% 정도 낮습니다. 캡처는 원격 화면을 띄운 채 찍었고, 그동안 화면 표시가 GPU를 7~15% 나눠 썼기 때문입니다. 표의 값은 GPU가 쉬는 상태에서 API로 잰 값입니다. 원격 화면을 내린 뒤 한 번 더 재니 45.7t/s로 표와 같았습니다.
이 파일에는 MTP 레이어가 없어서 Speculative Decoding을 켜고 끄는 비교는 하지 않았습니다.
산수 문제: 생각을 끄면 0번, 켜면 5번 정답
"사과 한 상자에 24개가 들어 있습니다. 3상자를 사서 19개를 먹고, 남은 것을 5명이 똑같이 나누면 한 사람당 몇 개이고 몇 개가 남나요? '한 사람당 X개, 남는 것 Y개' 형식으로만 답하세요."를 5번씩 물었습니다. 정답은 10개, 3개입니다.
| 조건 | 정답 | 답 | 걸린 시간 | 생각에 쓴 토큰 |
|---|---|---|---|---|
| 생각 끔 | 5번 중 0번 | 5번 모두 "한 사람당 4개, 남는 것 1개" | 0.4초 | 0 |
| 생각 켬 | 5번 중 5번 | "한 사람당 10개, 남는 것 3개" | 10.6~108.5초 | 469~4,978 |
생각을 끄면 0.4초 만에 답하지만 5번 모두 같은 오답이었습니다. 생각을 켜면 모두 맞았고, 형식도 지켰습니다. 대신 같은 문제인데도 걸리는 시간이 11초에서 109초까지 크게 달랐습니다. Ornith 1.5 9B는 생각을 꺼도 마지막 답이 맞았지만 풀이를 함께 적어 형식 지시를 어겼습니다. 계산이 들어가는 질문이라면 Qwen3.5 9B는 생각을 켜고 써야 합니다.
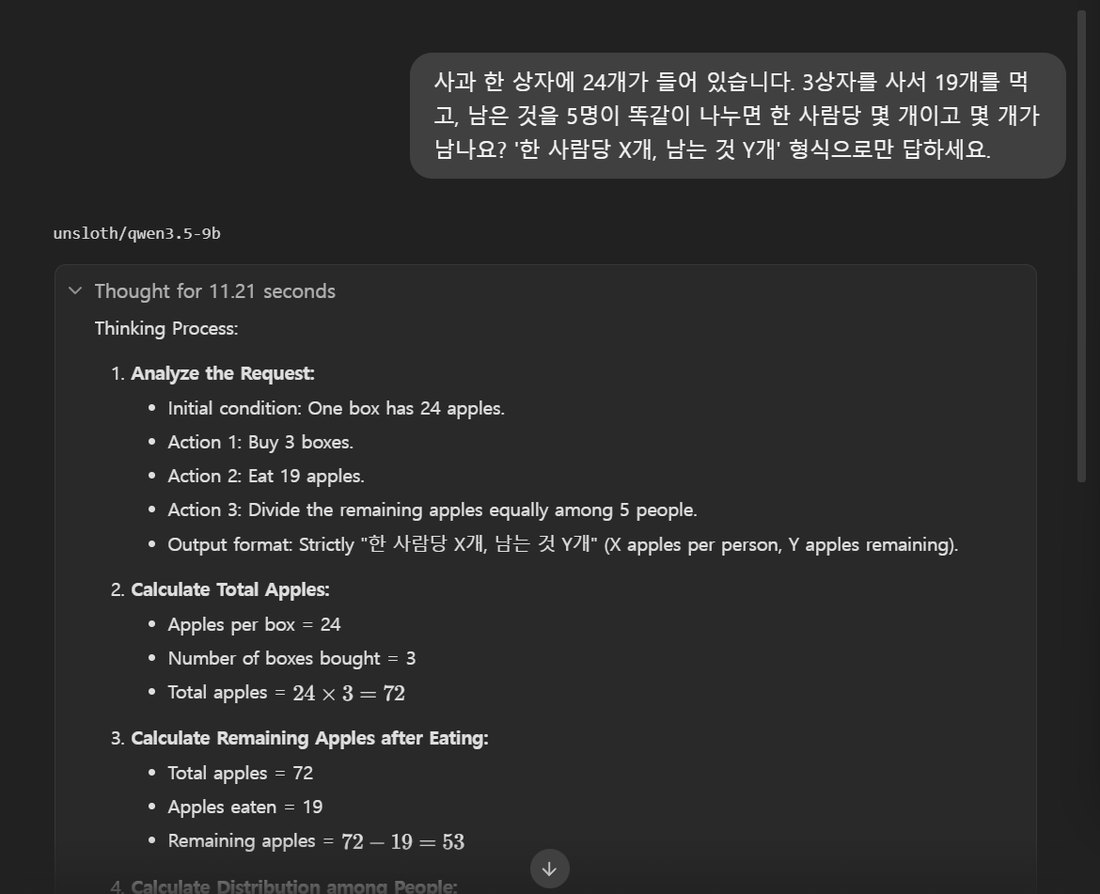
생각 과정을 펼친 화면. 영어로 조건을 정리하고 72개, 53개를 차례로 계산합니다. 이때는 11.21초 생각했습니다.
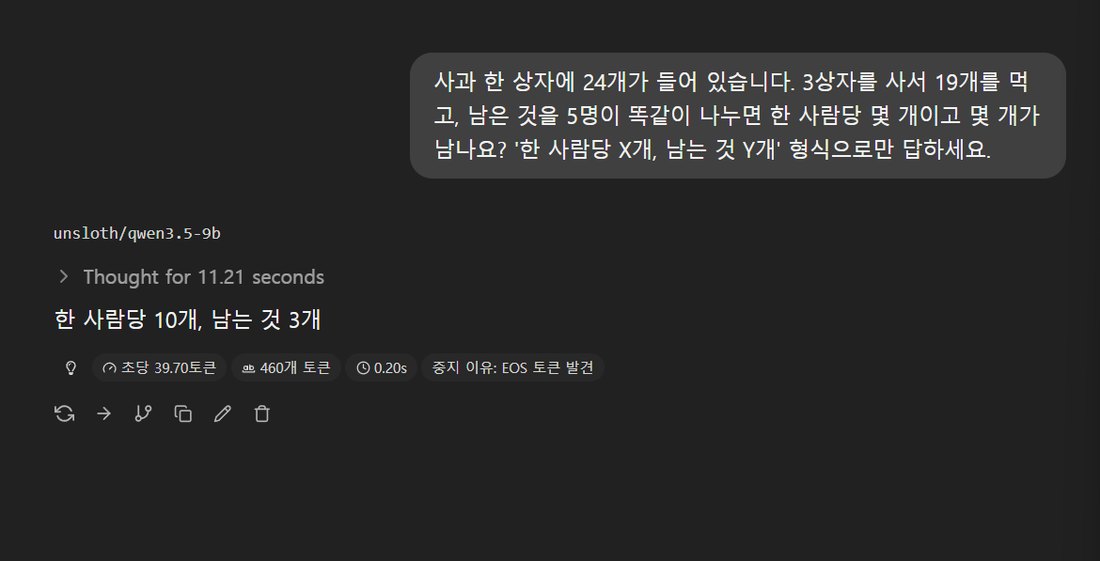
생각 켬. 지시한 형식대로 "한 사람당 10개, 남는 것 3개"만 답했습니다.
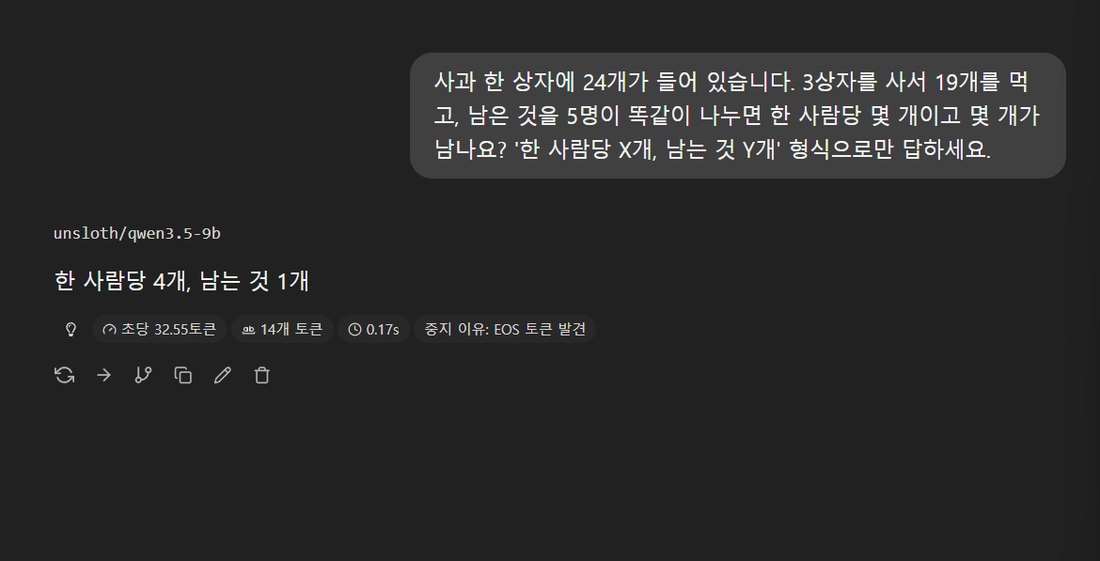
생각 끔. "한 사람당 4개, 남는 것 1개"라는 틀린 답입니다.
긴 글 요약
이 블로그의 업데이트 기록을 앞에서부터 잘라 넣고 세 문장으로 요약하게 했습니다. 생각은 껐습니다. TTFT는 질문을 보낸 뒤 첫 토큰이 나올 때까지의 시간입니다.
| 넣은 글 | 입력 토큰 | 컨텍스트 | 첫 토큰까지(TTFT) | 생성 속도 |
|---|---|---|---|---|
| 3,000자 | 1,486 | 32,768 | 0.87초 | 45.1t/s |
| 15,000자 | 7,402 | 32,768 | 2.4초 | 45.7t/s |
| 100,000자 | 44,315 | 131,072 | 18.6초 | 40.0t/s |
10만 자를 넣어도 19초 안에 답이 시작됐습니다. 3,000자는 지시대로 세 문장으로 요약했고 내용도 원문과 맞았습니다. 15,000자는 세 문단, 다섯 문장으로 썼습니다. 내용은 대체로 맞았지만, 8월 18일에 한 일(공개 페이지 캐시 허용)을 8월 22일 업데이트에 묶어 적었습니다. 10만 자 요약은 번호를 붙인 세 묶음으로 답했습니다.
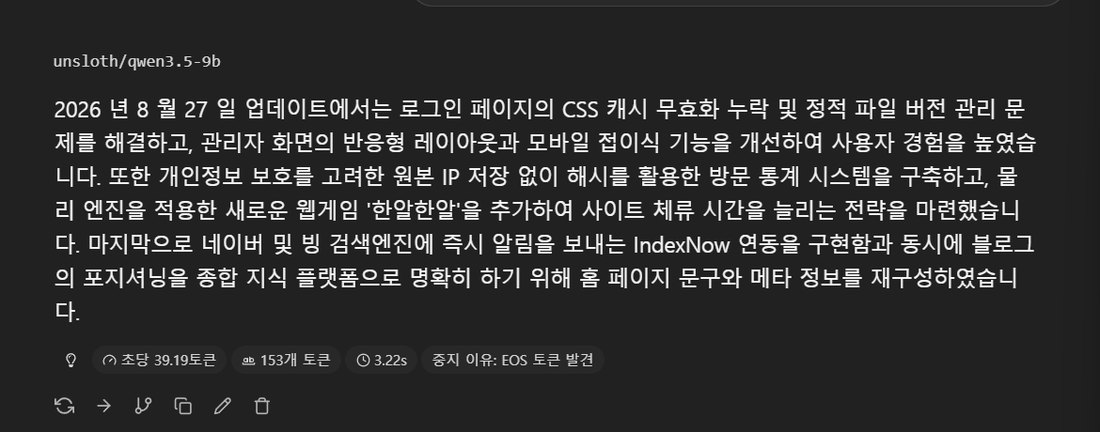
15,000자 요약. 세 문장으로 답했습니다. 첫 토큰까지 3.22초입니다.
전력과 온도
800자 글을 쓰는 동안 1초마다 GPU 전력과 온도를 쟀습니다(컨텍스트 32,768, 생각 끔, 2번).
| 항목 | Qwen3.5 9B | Ornith 1.5 9B (같은 PC) |
|---|---|---|
| 대기 전력 | 14~17W | 약 17W |
| 글 쓰는 동안 평균 | 128~130W | 122~124W |
| 최고 전력 | 139W | 132W |
| 최고 온도 | 61~64°C | 60~63°C |
| 평균 GPU 사용률 | 88~90% | 85~87% |
| 토큰 하나당 에너지 | 약 2.8J | 약 2.5J |
전력 제한 180W까지 올라가지 않았고 온도도 60°C 초반이었습니다. 두 9B 모델의 전력과 온도는 거의 같습니다.
대화가 길어지면
앞 대화가 길어질수록 느려지는지 봤습니다(컨텍스트 32,768, 생각 끔).
| 앞 대화 길이 | 첫 토큰까지(TTFT) | 생성 속도 |
|---|---|---|
| 약 1천 토큰 | 0.44초 | 46.5t/s |
| 약 8천 토큰 | 2.7초 | 45.7t/s |
| 약 2만 1천 토큰 | 5.5초 | 43.4t/s |
대화가 2만 토큰까지 길어져도 생성 속도는 3t/s밖에 줄지 않았습니다. 첫 토큰까지의 시간만 5.5초로 늘었습니다.
약 1만 토큰 글을 넣은 채팅에서 이어서 물은 화면. 첫 토큰까지 0.19초였습니다. 앞 내용이 이미 처리돼 있어서 빠릅니다.
긴 문서에서 정보 찾기
약 1만 토큰 글의 10·30·50·70·90% 위치에 "블로그 관리자가 키우는 고양이 보리차는 2019년에 태어났다"는 문장을 하나 숨기고 찾게 했습니다. 숨기지 않은 글에서 "없음"이라고 답하는지도 봤습니다.
| 숨긴 위치 | 10% | 30% | 50% | 70% | 90% | 숨기지 않음 |
|---|---|---|---|---|---|---|
| 결과 | 찾음 | 찾음 | 찾음 | 찾음 | 찾음 | "없음" |
다섯 곳 모두 찾았고, 없는 정보를 지어내지도 않았습니다. 답도 지시한 형식 그대로 "이름: 보리차, 태어난 해: 2019"였습니다.
글의 가운데(50%)에 숨긴 정보를 찾은 화면. 첫 토큰까지 4.23초였습니다.
한국어 품질
API로 받은 한국어 답 24개를 모두 확인했습니다.
| 항목 | 결과 |
|---|---|
| 외국 문자 섞임 | 24개 답 중 0개. 다만 화면 캡처용으로 따로 받은 답 하나에 "와트数"가 있었음 |
| 띄어쓰기 | "PC 로", "AI 를", "10 개", "2026 년 8 월 27 일"처럼 영어·숫자 뒤를 띄어 쓰는 버릇이 있음 |
| 오타 | "토크 수 (TPS)"(토큰 수) |
| 사실 오류 | "70억 파라미터 모델을 4비트 양자화로 돌리려면 최소 16GB VRAM 권장"처럼 실제보다 크게 적은 숫자가 있음. "CUDA 코어"라는 없는 말도 씀 |
| 말투 | 모두 존댓말. 문장은 자연스러움 |
외국 문자가 섞이는 일은 Ornith 1.5 9B(28개 답 중 2개)보다 적었습니다. 영어·숫자 뒤를 띄어 쓰는 버릇은 거의 모든 답에 있어서, 글을 그대로 내보내려면 한 번 다듬어야 합니다.
없는 소설과 이미지
지어낸 책인 "한국 소설가 윤서하가 2018년에 발표한 장편소설 『푸른 등대의 겨울』의 줄거리"를 물었습니다.
| 조건 | 걸린 시간 | 답 |
|---|---|---|
| 생각 켬 | 83초 | "구체적인 정보는 찾아지지 않았습니다"라고 답하고 줄거리를 지어내지 않음 |
| 생각 끔 | 5.8초 | "작품도 실재하지 않습니다"라고 답함. 줄거리를 지어내지 않음 |
두 번 모두 줄거리를 지어내지 않았습니다. 다만 화면 캡처용으로 다시 물었을 때는 책이 없다고 하면서도 "윤서하 작가는 시나 에세이 분야로 알려져 있는 경우가 많으며"라는, 근거 없는 말을 한 줄 덧붙였습니다.
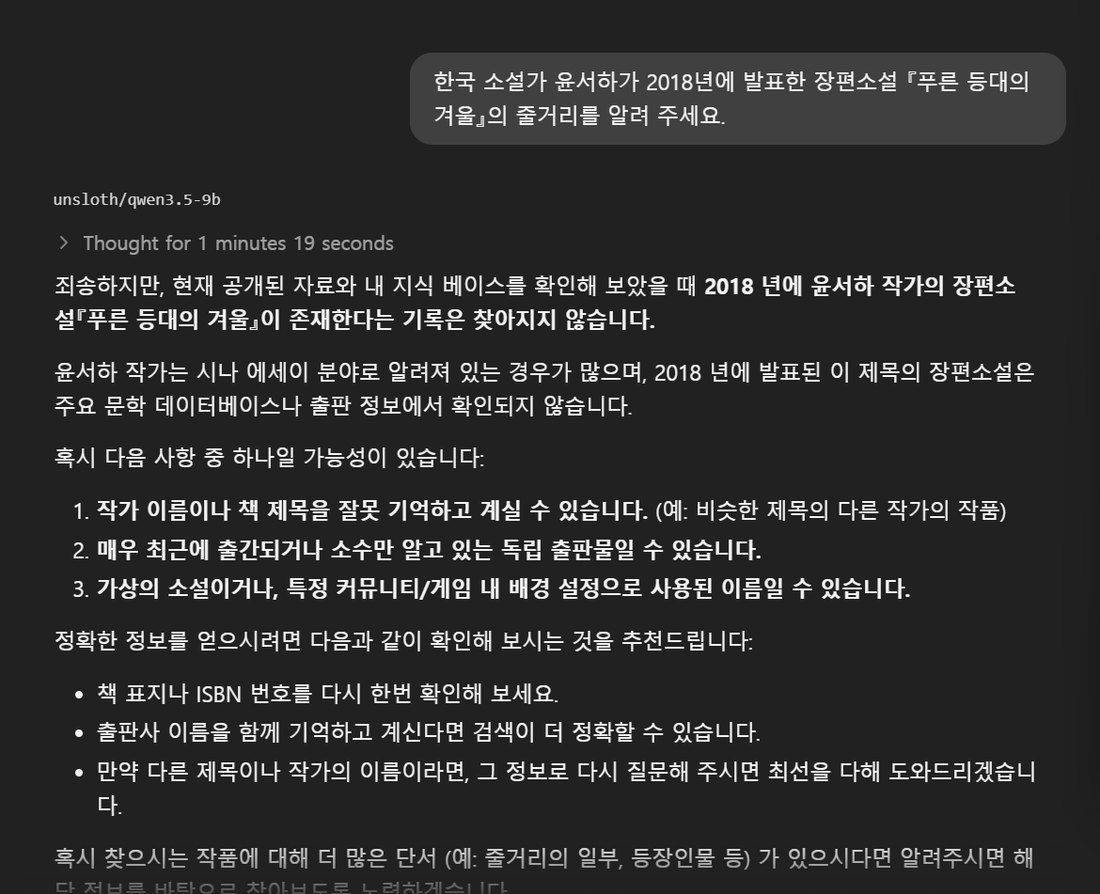
생각 켬. 1분 19초 생각한 뒤 기록을 찾을 수 없다고 답했습니다. 둘째 문단에 작가에 대한 근거 없는 설명이 한 줄 있습니다.
이미지는 모래시계 두 개가 놓인 사진을 주고 3문장으로 설명하게 했습니다. 오른쪽 모래시계 뒤에는 전자 부품이 보이는 사진입니다.
| 조건 | 걸린 시간 | 답 |
|---|---|---|
| 생각 켬 | 13.8초 | 모래시계 두 개, 오른쪽은 안에 전자 부품이 보이는 구조, 뒤쪽 오디오 장비까지 설명 |
| 생각 끔 | 2.3초 | 왼쪽은 전통적인 형태, 오른쪽은 전자 부품과 회로판이 보인다고 구분. 뒤쪽 장비의 조명까지 설명 |
생각을 꺼도 두 모래시계의 차이를 정확히 짚었습니다. Ornith 1.5 9B는 생각을 끄면 이 차이를 놓쳤습니다.
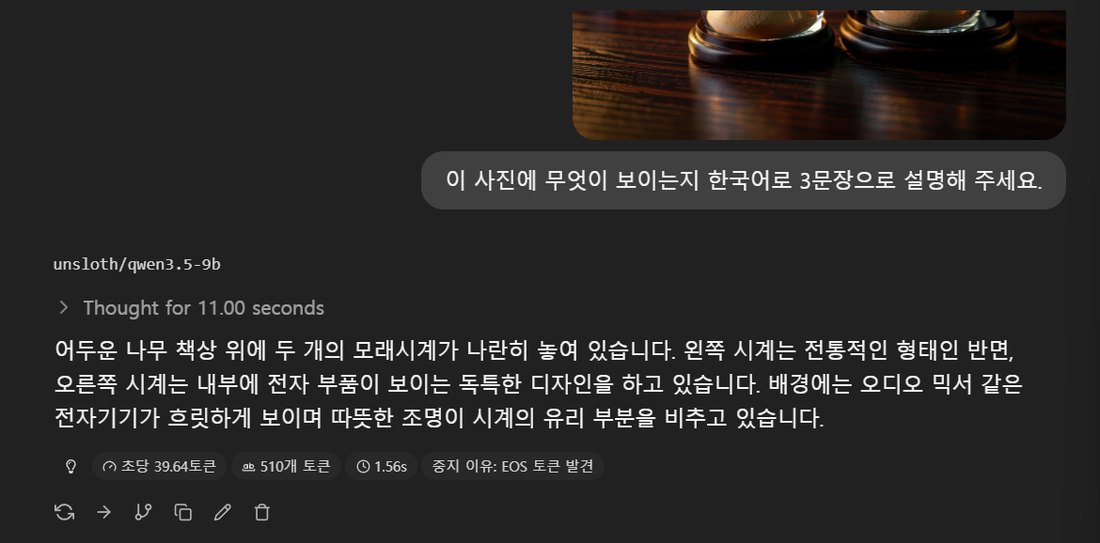
생각 켬. 11초 생각한 뒤 왼쪽은 전통적인 형태, 오른쪽은 전자 부품이 보인다고 설명했습니다.
정리
같은 PC에서 잰 다른 모델과 나란히 놓으면 아래와 같습니다. 모두 LM Studio 기본 설정, 800자 글 기준입니다.
| 모델 | 파일 | VRAM (8,192) | 생성 속도 (생각 끔) | 생각 켬 800자 글 | 16GB에서 |
|---|---|---|---|---|---|
| Qwen3.5 9B | Q6_K_XL 8.76GB | 9.7GB | 약 46t/s | 2~3분 | 원활 |
| Ornith 1.5 9B | Q8_0 9.79GB | 10.6GB | 약 50t/s | 15~20초 | 원활 |
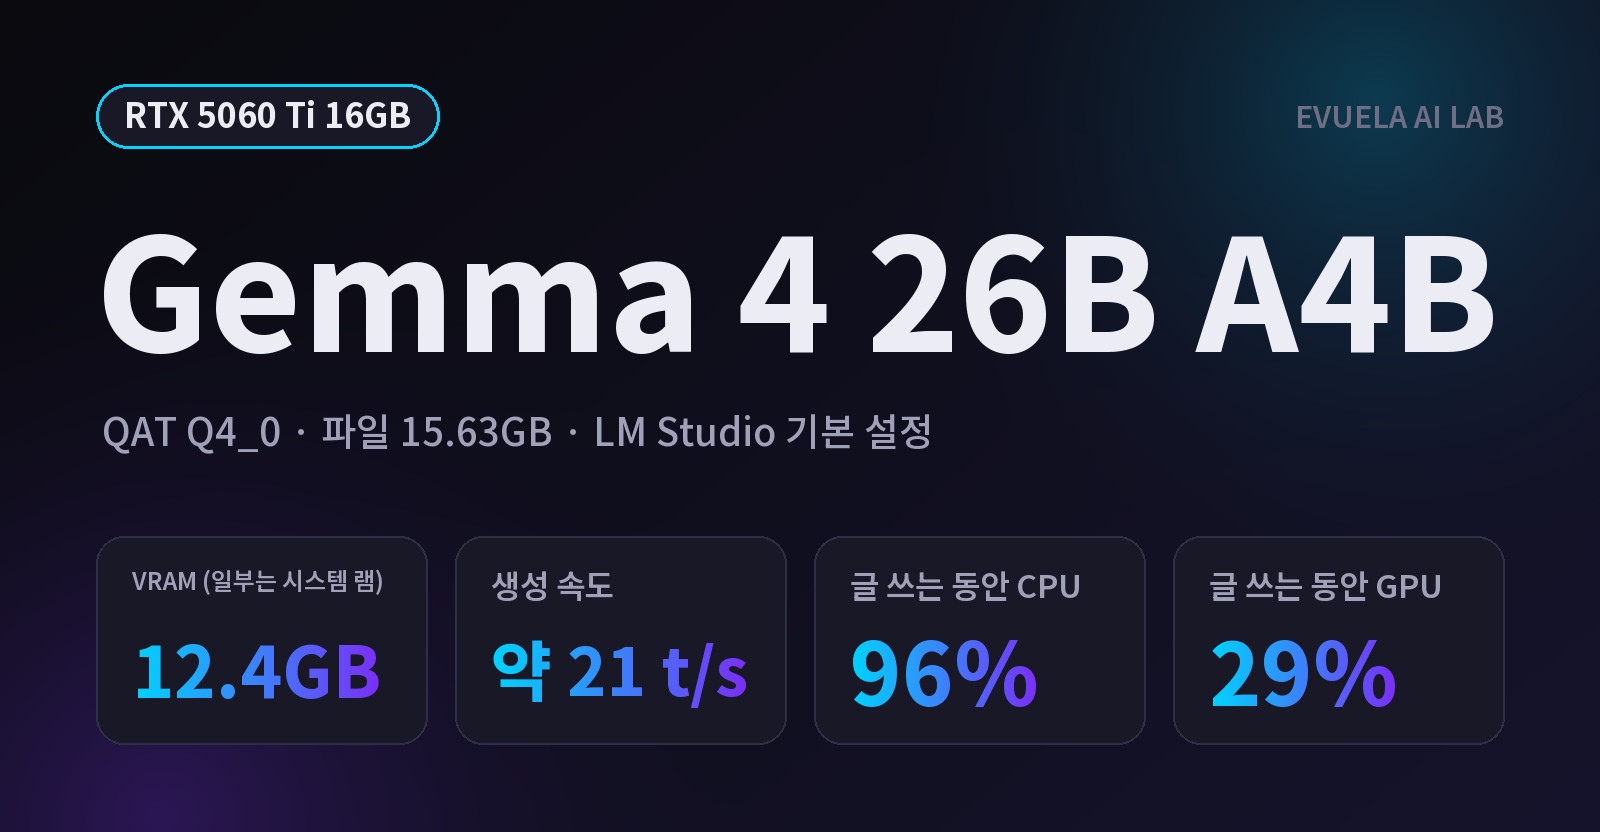
| Gemma 4 12B QAT | Q4_0 6.93GB | 8.6GB | 약 44t/s | - | 원활 |
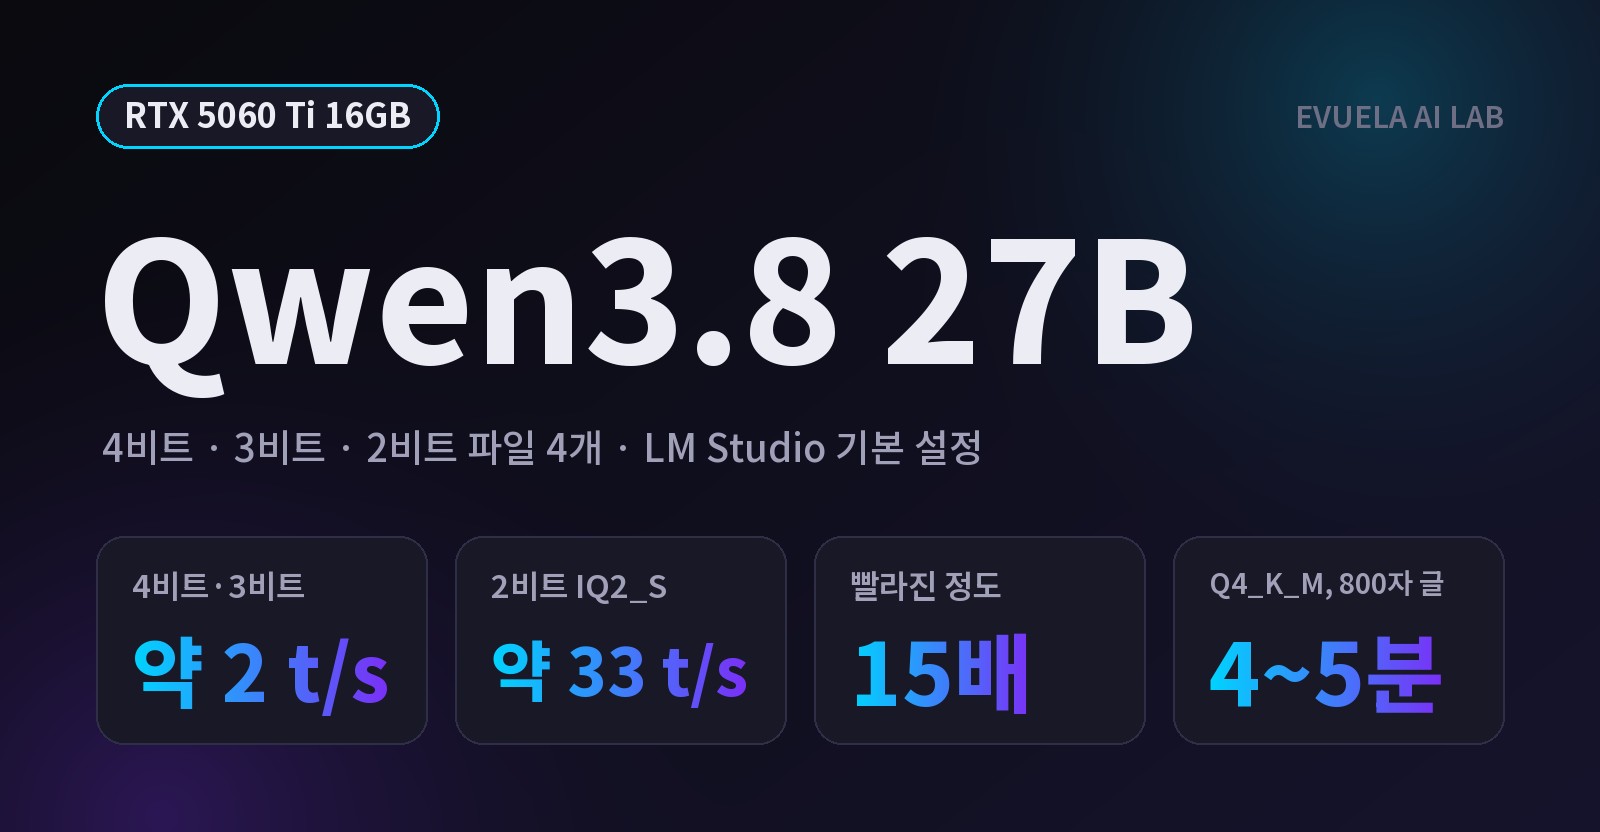
| Qwen3.8 27B IQ2_S | IQ2_S 9.30GB | 9.9GB | 약 33t/s | - | 원활 |
Qwen3.5 9B와 Ornith 1.5 9B를 항목별로 비교하면 이렇습니다.
| 항목 | Qwen3.5 9B | Ornith 1.5 9B |
|---|---|---|
| 산수, 생각 끔 | 5번 중 0번 정답 | 마지막 답은 5번 모두 정답, 형식은 어김 |
| 산수, 생각 켬 | 5번 모두 정답, 11~109초 | 5번 모두 정답, 약 3초 |
| 형식 지시 지키기 | 지킴 | 지키지 않음 |
| 한국어 답의 외국 문자 | 24개 중 0개 | 28개 중 2개 |
| 생각 끔 이미지 설명 | 두 모래시계의 차이를 짚음 | 차이를 놓침 |
- 16GB에서 원활합니다. 컨텍스트 131,072까지 VRAM에 다 들어가고, 10만 자 요약도 19초 안에 시작됩니다.
- 빠른 답이 필요하면 생각을 끄고, 계산이 필요하면 켭니다. 생각을 끄면 10초 안에 글이 끝나지만 산수는 틀렸습니다. 켜면 맞지만 2분 넘게 걸릴 수 있습니다.
- 지시한 형식을 잘 지킵니다. 산수와 정보 찾기에서 정해 준 형식 그대로 답했습니다.
- 한국어 답에 외국 문자가 거의 없습니다. 대신 영어·숫자 뒤를 띄어 쓰는 버릇이 있습니다.
- 생각을 켜고도 빨리 답하는 모델이 필요하면 같은 PC에서 15~20초에 끝난 Ornith 1.5 9B가 맞습니다.
내 그래픽카드에서 다른 모델이 어느 정도 속도로 도는지는 GPU 체험에서 직접 잰 값으로 볼 수 있습니다.
자주 묻는 질문
Qwen3.5 9B는 VRAM이 얼마나 필요한가요?
UD-Q6_K_XL 파일을 LM Studio 기본 설정(컨텍스트 8,192)으로 로드하면 9.7GB를 씁니다. 컨텍스트 32,768에서는 10.5GB, 65,536에서는 11.5GB, 131,072에서는 13.6GB였습니다.
RTX 5060 Ti 16GB에서 속도는 어느 정도인가요?
800자 글 기준으로 생각 끔 46.4~46.6t/s, 생각 켬 45.0~46.1t/s였습니다. 속도는 같지만 생각을 켜면 생각에 4,900~7,200토큰을 써서 글 하나에 2~3분이 걸렸습니다.
생각(Thinking)은 켜는 게 좋은가요?
질문에 따라 다릅니다. 산수 문제는 생각을 끄면 5번 모두 틀렸고 켜면 5번 모두 맞았습니다. 글쓰기나 요약, 사진 설명은 생각을 꺼도 결과가 좋았고 10초 안에 끝났습니다.
Ornith 1.5 9B와 비교하면 어떤가요?
생성 속도는 Ornith 1.5 9B가 조금 빠르고(약 50t/s), 생각을 켰을 때 기다리는 시간은 Ornith 쪽이 훨씬 짧습니다(15~20초). Qwen3.5 9B는 지시한 형식을 더 잘 지키고, 한국어 답에 한자가 섞이는 일이 적었습니다.
컨텍스트는 얼마로 두면 좋은가요?
생각을 켜고 쓴다면 32,768을 권합니다. 기본값 8,192에서는 생각만으로 7,000토큰 넘게 쓴 적이 있습니다. 16GB에서는 131,072까지 VRAM에 다 들어갔습니다.
댓글 0개