 AI 뉴스
웹사이트들이 AI 에이전트를 막기 시작했다, 한국 사이트 47곳의 robots.txt를 직접 확인하니 19곳이 막았다
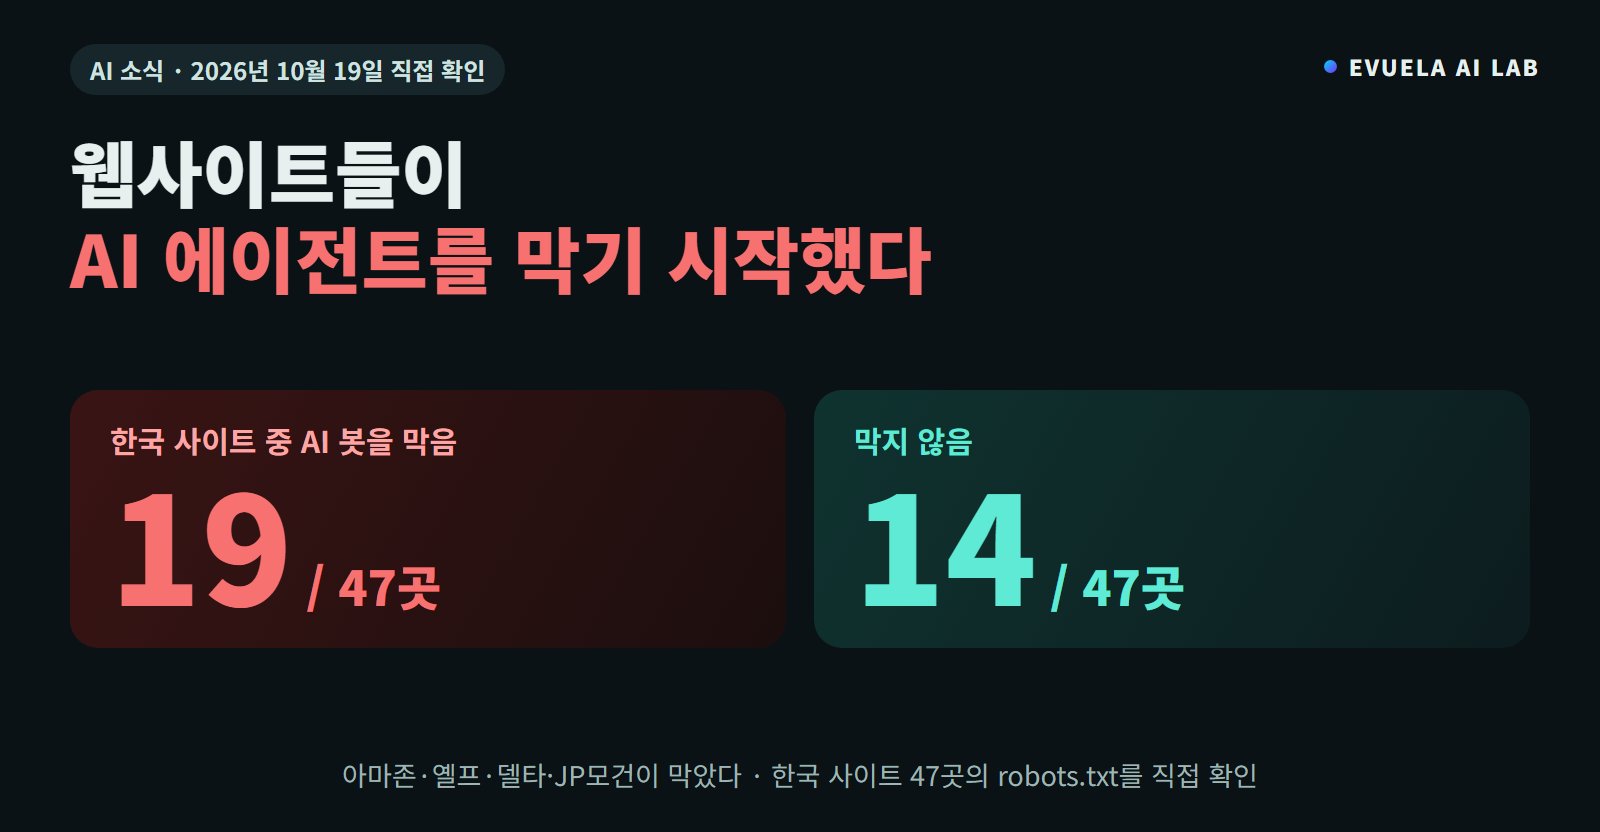
아마존·옐프·델타·JP모건이 AI 에이전트를 막기 시작했습니다. 한국 사이트 47곳의 robots.txt를 직접 받아 읽어 보니 19곳이 AI 봇을 따로 막았고 14곳은 막지 않았습니다. 학습·검색·대신 봇별로 나눈 결과와 실제 원문을 정리했습니다.
로컬 AI를 직접 돌려 잰 속도와 메모리, 출처를 확인한 IT·AI 소식, 프로그래밍 이야기를 적습니다.
AI 뉴스
아마존·옐프·델타·JP모건이 AI 에이전트를 막기 시작했습니다. 한국 사이트 47곳의 robots.txt를 직접 받아 읽어 보니 19곳이 AI 봇을 따로 막았고 14곳은 막지 않았습니다. 학습·검색·대신 봇별로 나눈 결과와 실제 원문을 정리했습니다.
 RTX-5090
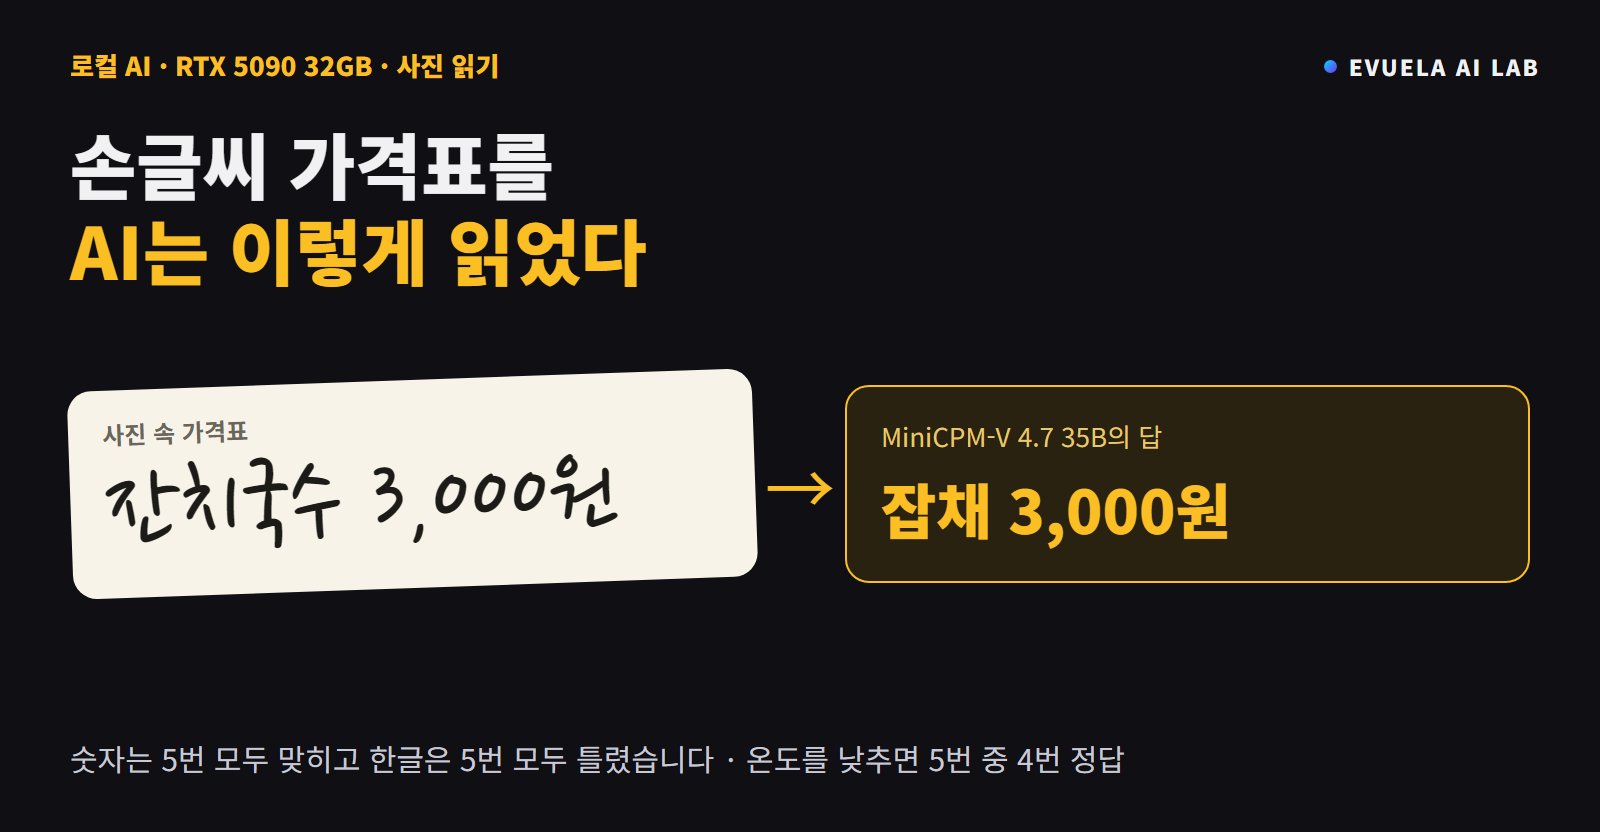
사진과 영상을 읽는 공개 모델 MiniCPM-V 4.7 35B A3B를 RTX 5090에서 쟀습니다. 속도는 초당 269토큰, 표와 화면 캡처는 70번 중 65번, Pixabay 실제 사진은 55번 중 29번 맞혔습니다. Unsloth Studio에서 사진이 안 된 이유와 한글 간판을 틀린 모습, 나아지는 설정도 적었습니다.
 AI 뉴스
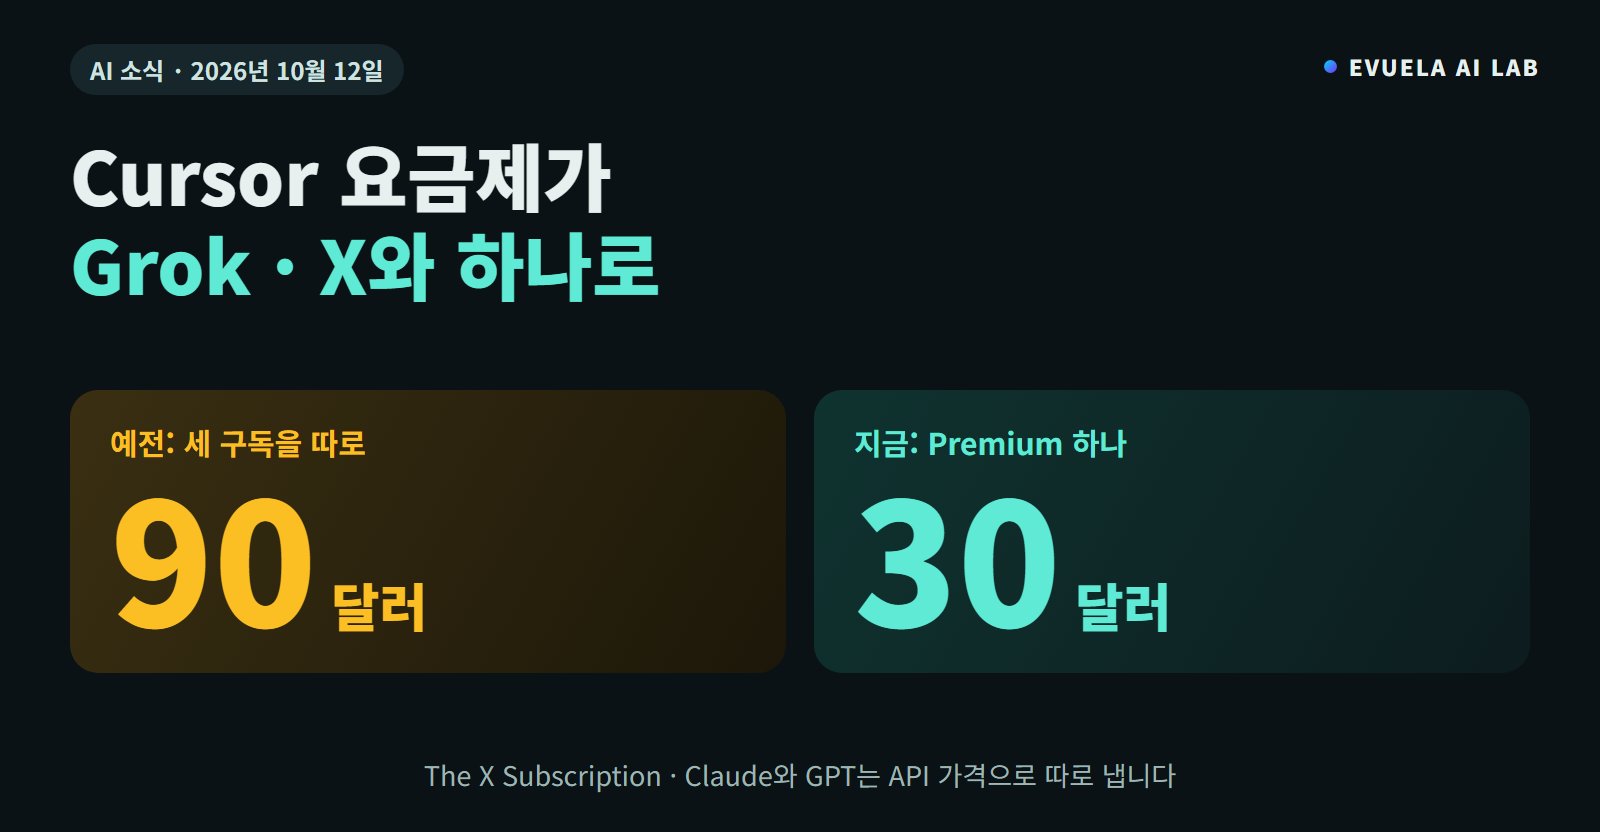
Cursor, Grok, X Premium 요금제가 The X Subscription으로 합쳐졌습니다. 셋을 따로 내면 90달러였던 것이 Premium 30달러가 됐습니다. 다만 Claude와 GPT는 API 가격으로 따로 내야 해서, 기존 구독자가 바꿀지 말지를 계산 예시와 함께 정리했습니다.
 RTX-5060TI 16GB
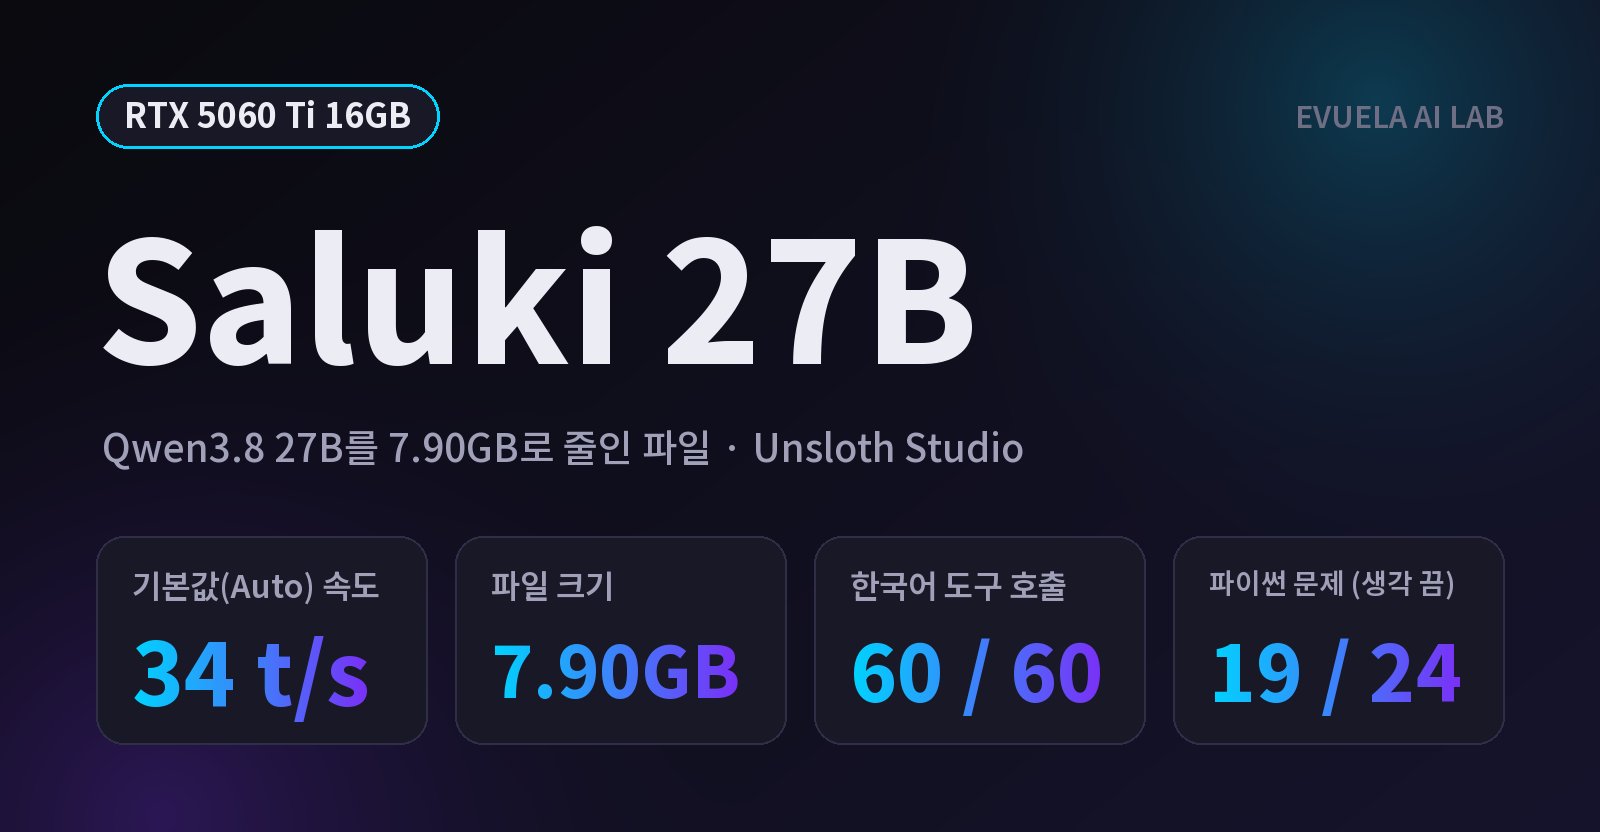
Qwen3.8 27B를 7.90GB로 줄인 Saluki 27B를 RTX 5060 Ti 16GB의 Unsloth Studio에서 쟀습니다. 기본값 초당 34토큰, 한국어 도구 호출 60번 모두 정답이었고, 생각 단계를 정하지 않으면 15번 중 6번은 답이 나오지 않았습니다.
 RTX-5060TI 16GB
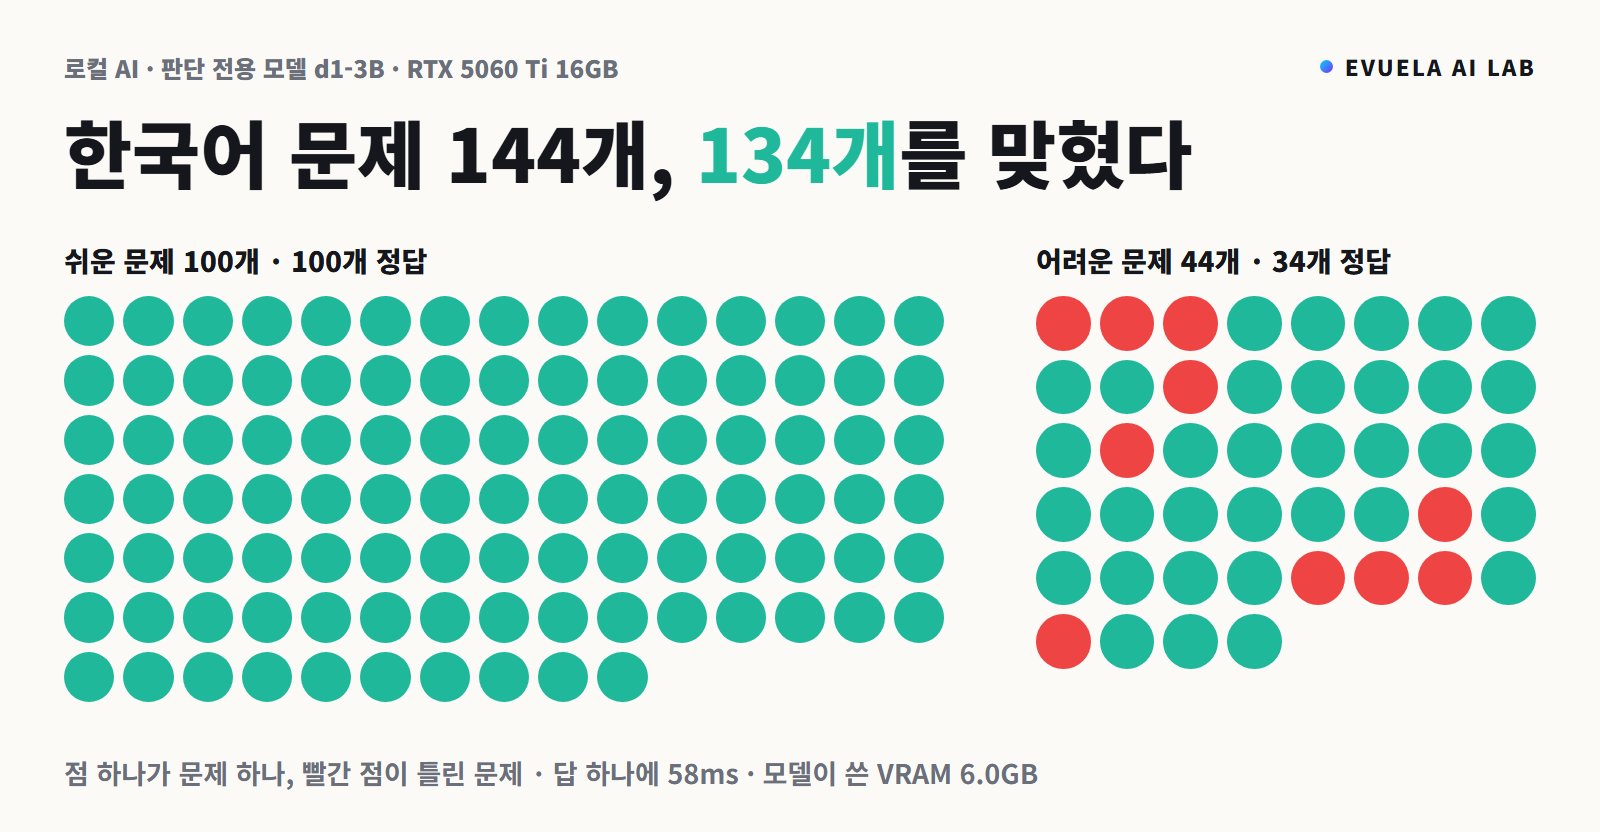
글을 쓰지 않고 보기마다 확률로 답하는 Liquid AI의 판단 전용 모델 d1-3B를 RTX 5060 Ti 16GB에서 한국어 144문제로 쟀습니다. 쉬운 100문제는 모두, 어려운 44문제는 34개를 맞혔고 답 하나에 0.06초, VRAM 6.0GB였습니다.
 RTX-5060TI 16GB
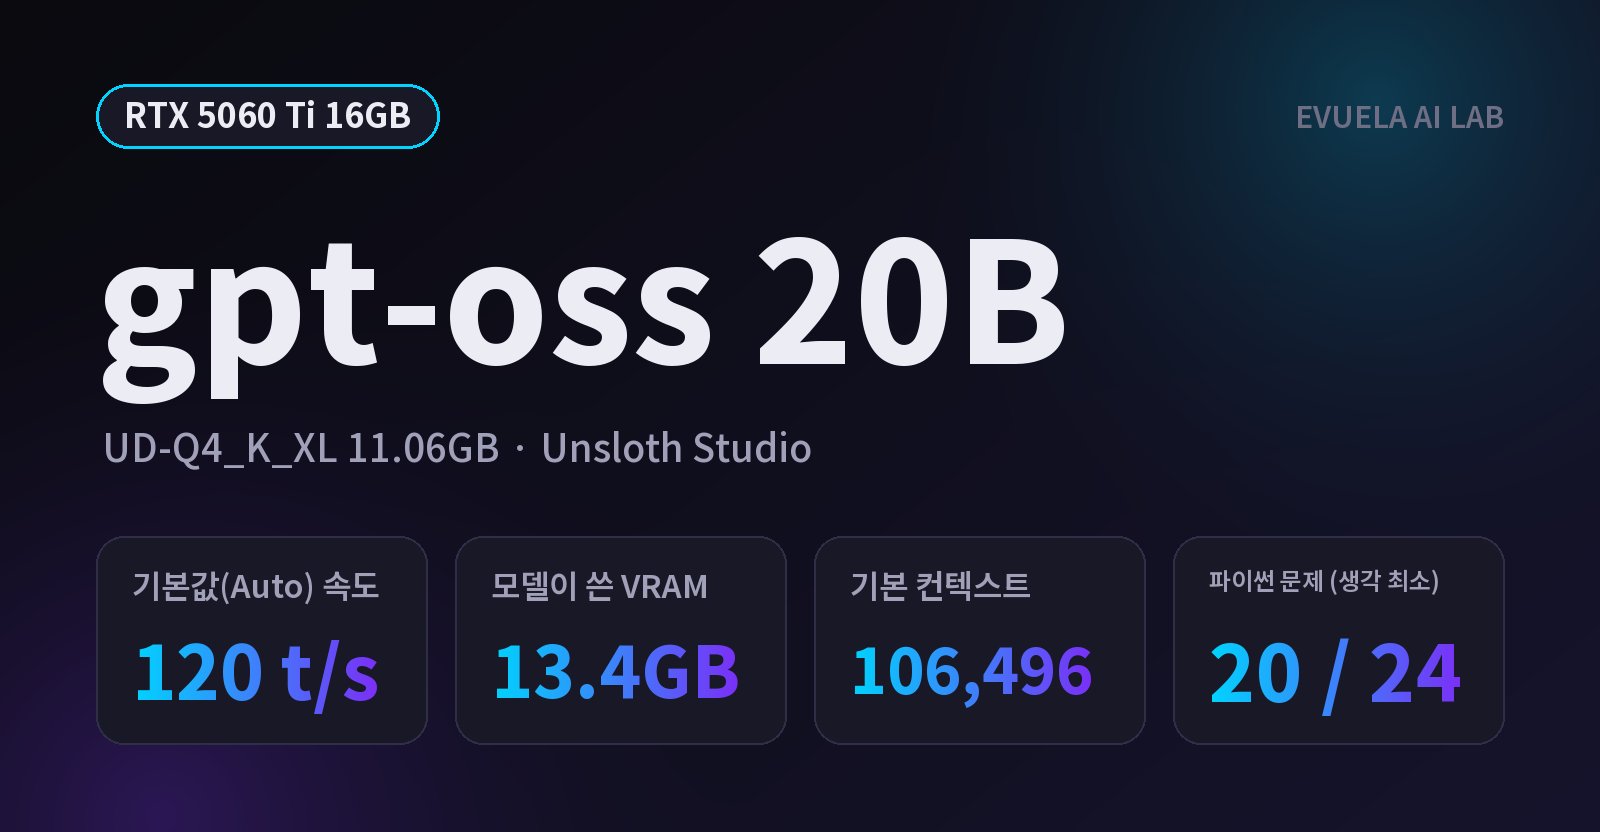
RTX 5060 Ti 16GB의 Unsloth Studio에서 OpenAI의 gpt-oss 20B(UD-Q4_K_XL 11.06GB)를 기본값으로 돌렸습니다. 초당 약 120토큰, 컨텍스트 65,536까지 같은 속도였고, 생각 단계에 따라 시간과 코딩 결과가 크게 달랐습니다.
 RTX-5090
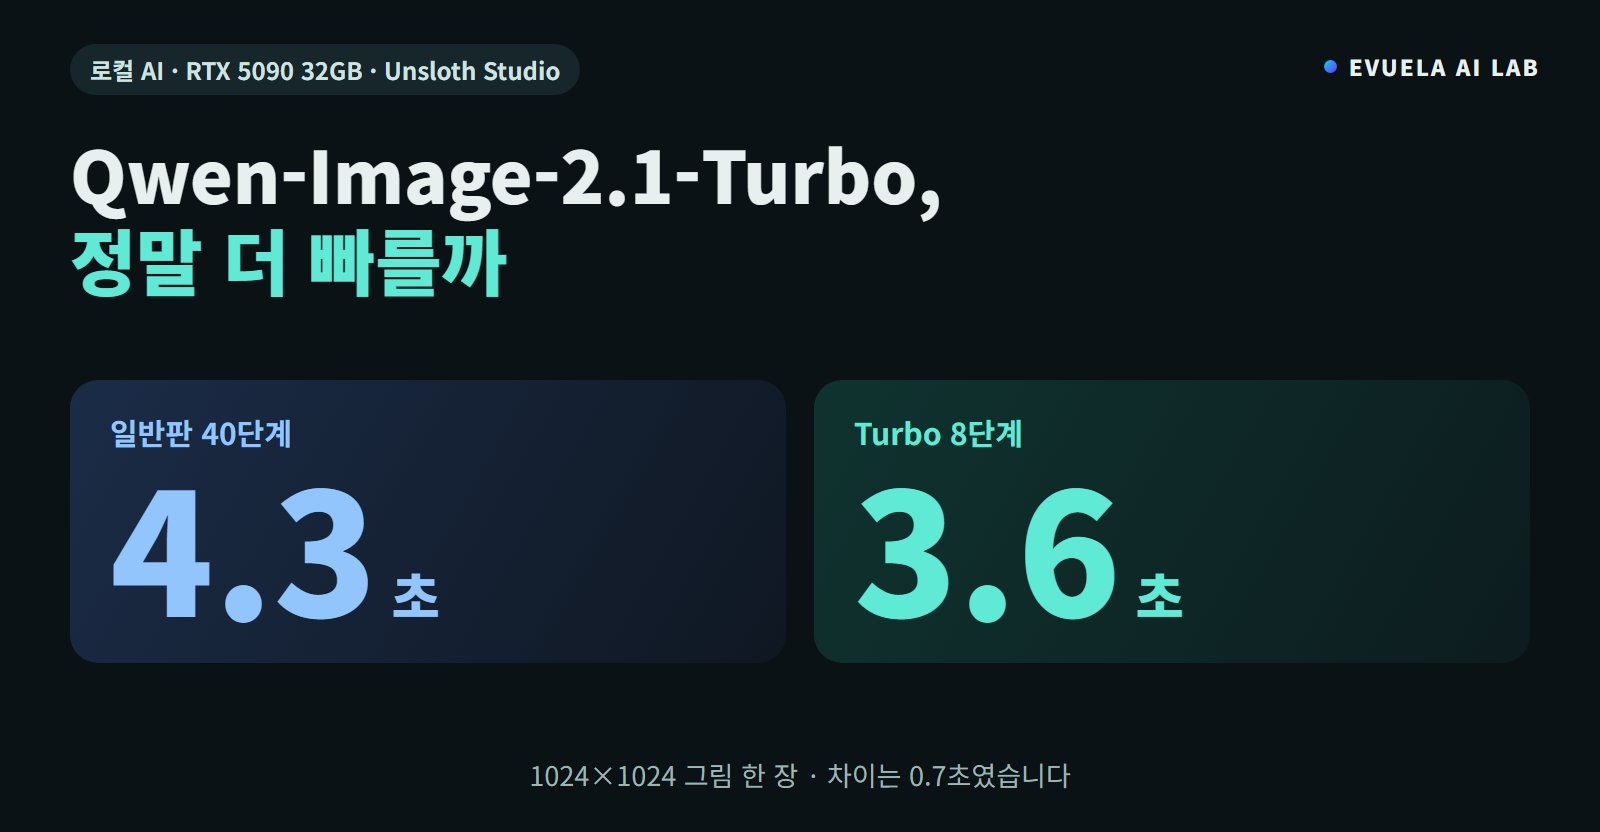
Qwen-Image-2.1-Turbo를 RTX 5090의 Unsloth Studio에서 일반판과 비교했습니다. 1024×1024 한 장에 Turbo 8단계 3.6초, 일반판 40단계 4.3초였고 VRAM은 13.9GB와 21.3GB였습니다. 기본 설정으로 올리면 일반판 가중치로 그려지는 문제와 해결 방법도 적었습니다.
 RTX-5060TI 16GB
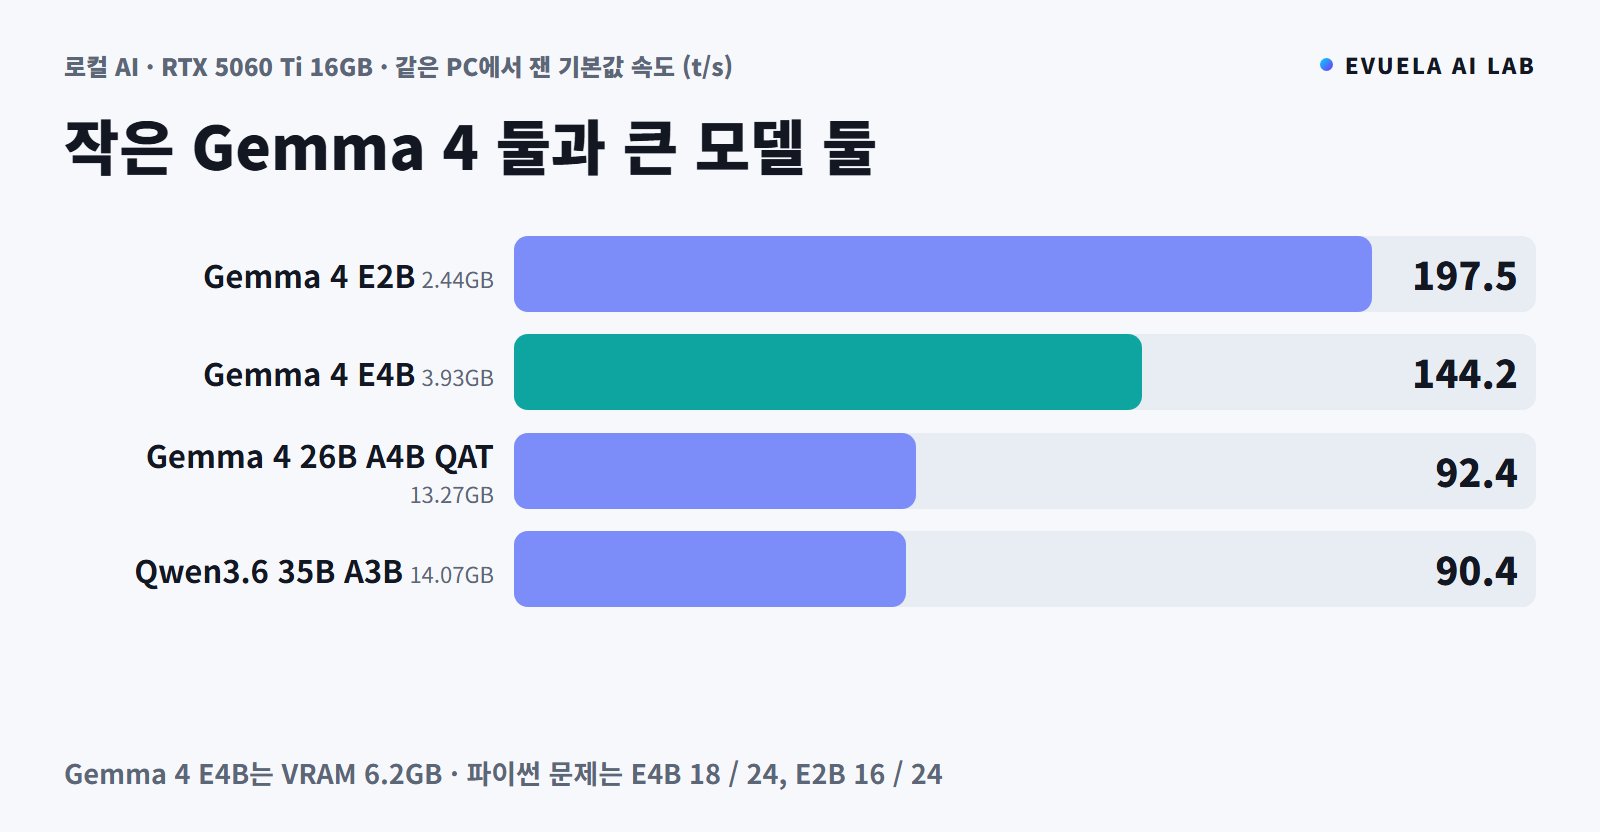
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 E4B(QAT UD-Q4_K_XL 3.93GB)를 기본값으로 돌렸습니다. VRAM 6.2GB에 초당 약 144토큰이었고, 같은 PC에서 잰 E2B와 속도·산수·코딩·사진 결과를 나란히 비교했습니다.
 RTX-5060TI 16GB
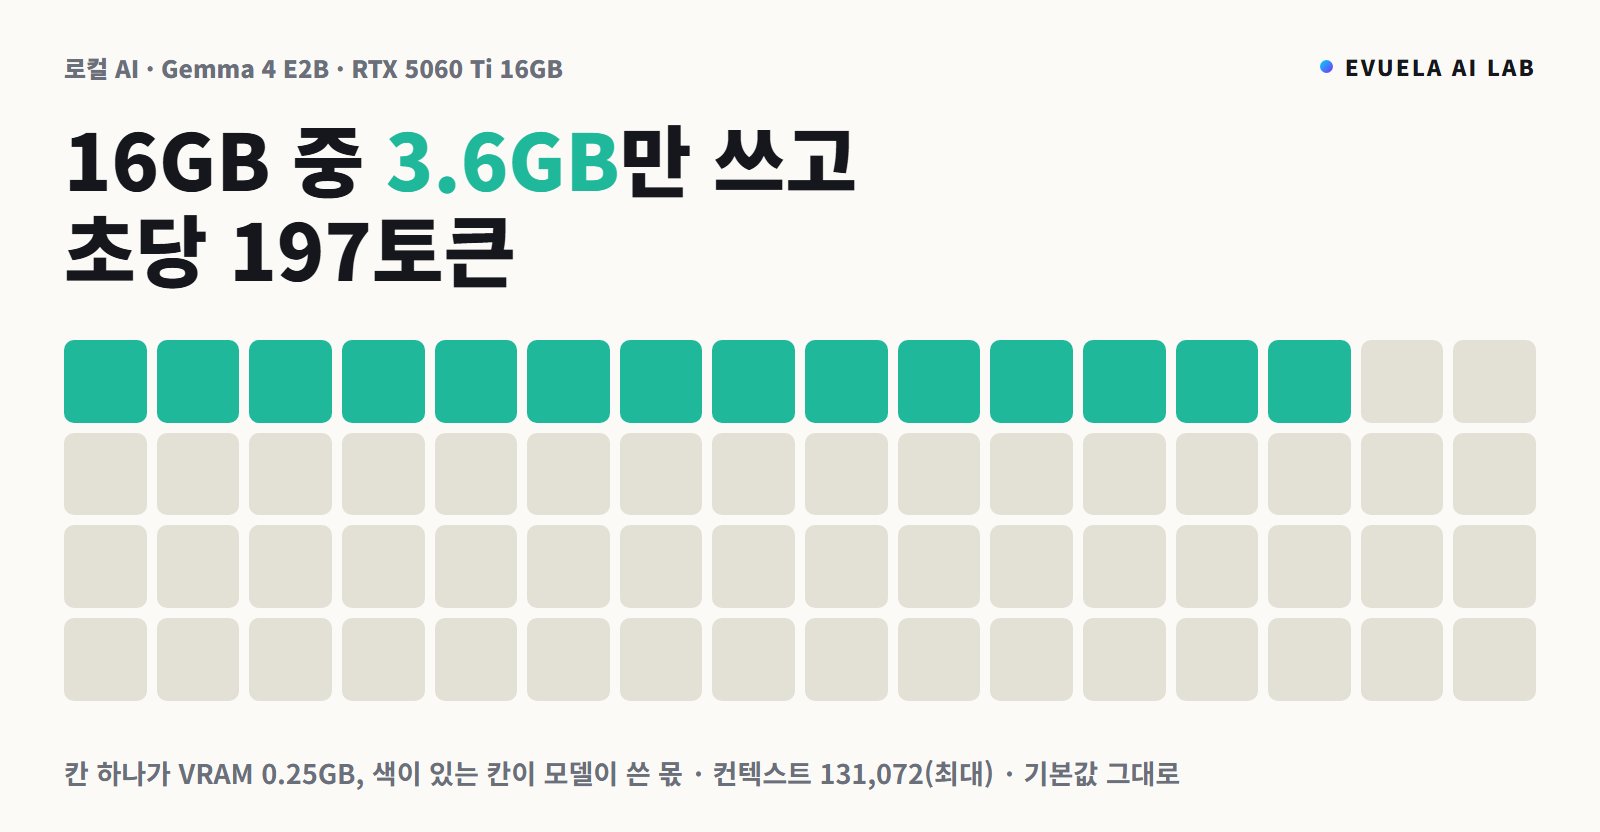
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 E2B(QAT UD-Q4_K_XL 2.44GB)를 기본값으로 돌렸습니다. VRAM 3.6GB에 초당 약 197토큰, 최대 컨텍스트 131,072에서도 같은 속도였습니다. 산수·코딩·사진 결과를 담았습니다.