 Tools
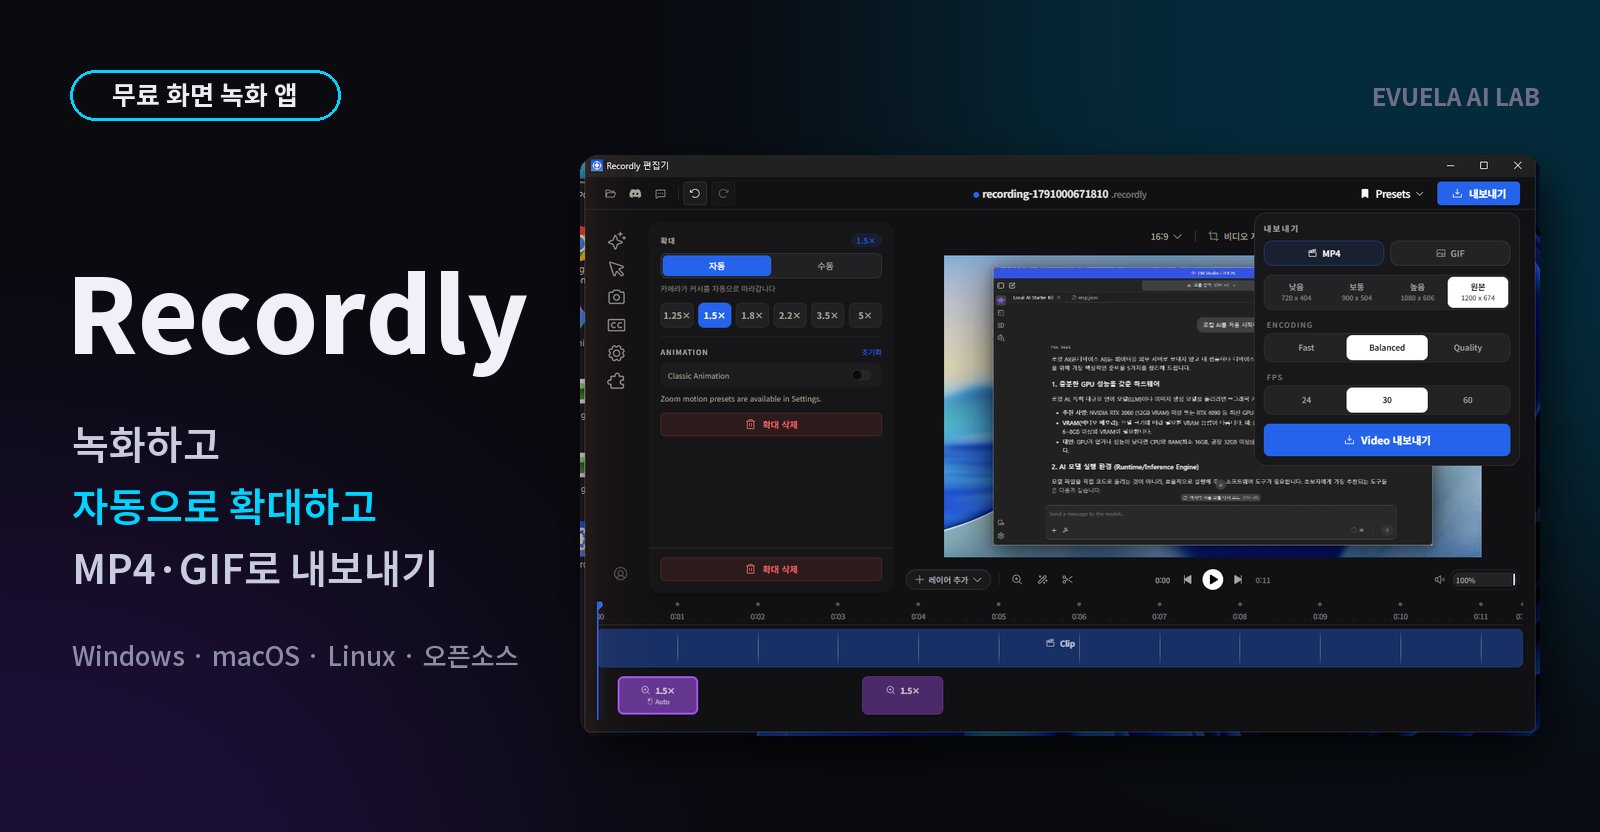
무료 녹화 앱 Recordly로 시연 영상 만들기, 23초 영상이 309KB였다
GitHub 스타 3만 개를 받은 무료 화면 녹화·편집 앱 Recordly를 직접 설치해 써 봤습니다. 녹화, 자동 확대, 커서 효과, MP4·GIF 내보내기를 확인했고, 77초 1080p 영상은 약 12초 만에 내보냈습니다. 창 녹화 주의점과 녹화 중 로컬 AI 속도도 정리했습니다.
로컬 AI를 직접 돌려 잰 속도와 메모리, 출처를 확인한 IT·AI 소식, 프로그래밍 이야기를 적습니다.
Tools
GitHub 스타 3만 개를 받은 무료 화면 녹화·편집 앱 Recordly를 직접 설치해 써 봤습니다. 녹화, 자동 확대, 커서 효과, MP4·GIF 내보내기를 확인했고, 77초 1080p 영상은 약 12초 만에 내보냈습니다. 창 녹화 주의점과 녹화 중 로컬 AI 속도도 정리했습니다.
 RTX-5060TI 16GB
RTX 5060 Ti 16GB에 로컬 음성 AI VoiceStudio 0.5.6을 직접 설치해 한국어로 써 봤습니다. 기본 엔진 OmniVoice는 50초 음성을 약 11초에 만들었고 VRAM은 3.5GB 안쪽, 더 사람 같았던 VoxCPM2는 2분 넘게 걸렸습니다.
 RTX-5060TI 16GB
RTX 5060 Ti 16GB에서 Ternary Bonsai 2 27B(PQ2_0)를 PrismML llama-server로 재 봤습니다. VRAM 9.3GB, 생성 속도 약 48t/s였고, 기본 생각 단계 xhigh는 800자 글에 4~7분, medium은 14~21초였습니다.
 AI 뉴스
Perplexity가 판단 모델 pplx-decider-v1-27b를 Apache 2.0으로 공개했습니다. 글 대신 확률로 답하고, 11가지 시험에서 바탕 모델 Qwen3.8 27B보다 약 11%포인트 높았습니다. 요금 계산과 RTX 5090·16GB 그래픽카드에서 돌릴 수 있는지도 정리했습니다.
 RTX-5060TI 16GB
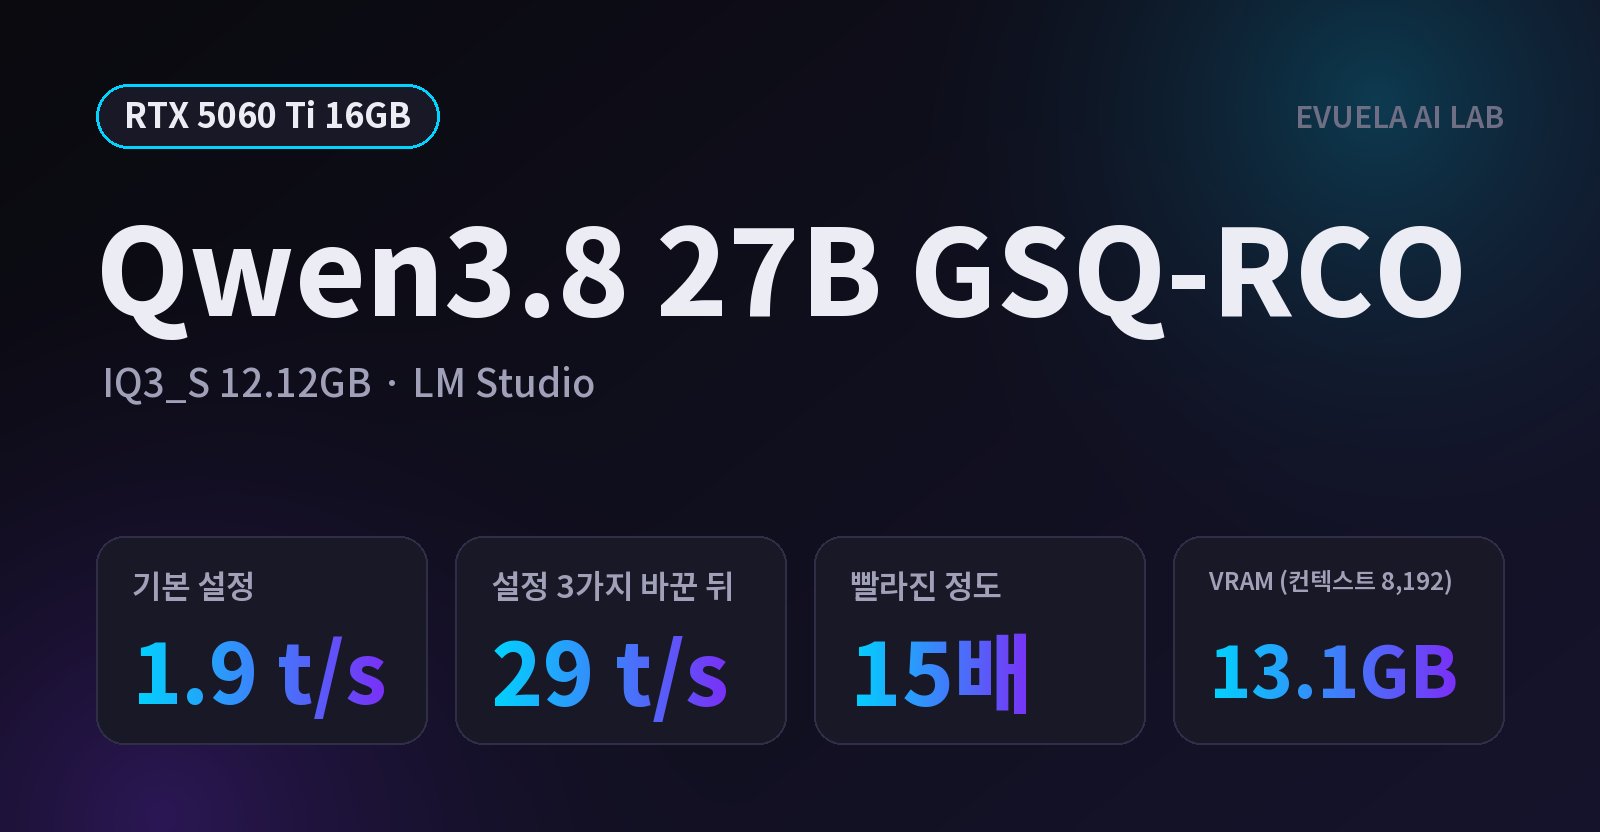
RTX 5060 Ti 16GB PC의 LM Studio에서 Qwen3.8 27B GSQ-RCO(IQ3_S, 12.12GB)를 재 봤습니다. 기본 설정에서는 65개 레이어 중 56~58개만 GPU에 올라가 약 1.9t/s였고, Limit Model Offload 끄기·GPU 오프로드 최대·MTP 끄기 세 가지를 바꾸자 약 29t/s가 됐습니다. VRAM은 13.1GB, 컨텍스트는 32,768까지 맞았습니다.
 RTX-5060TI 16GB
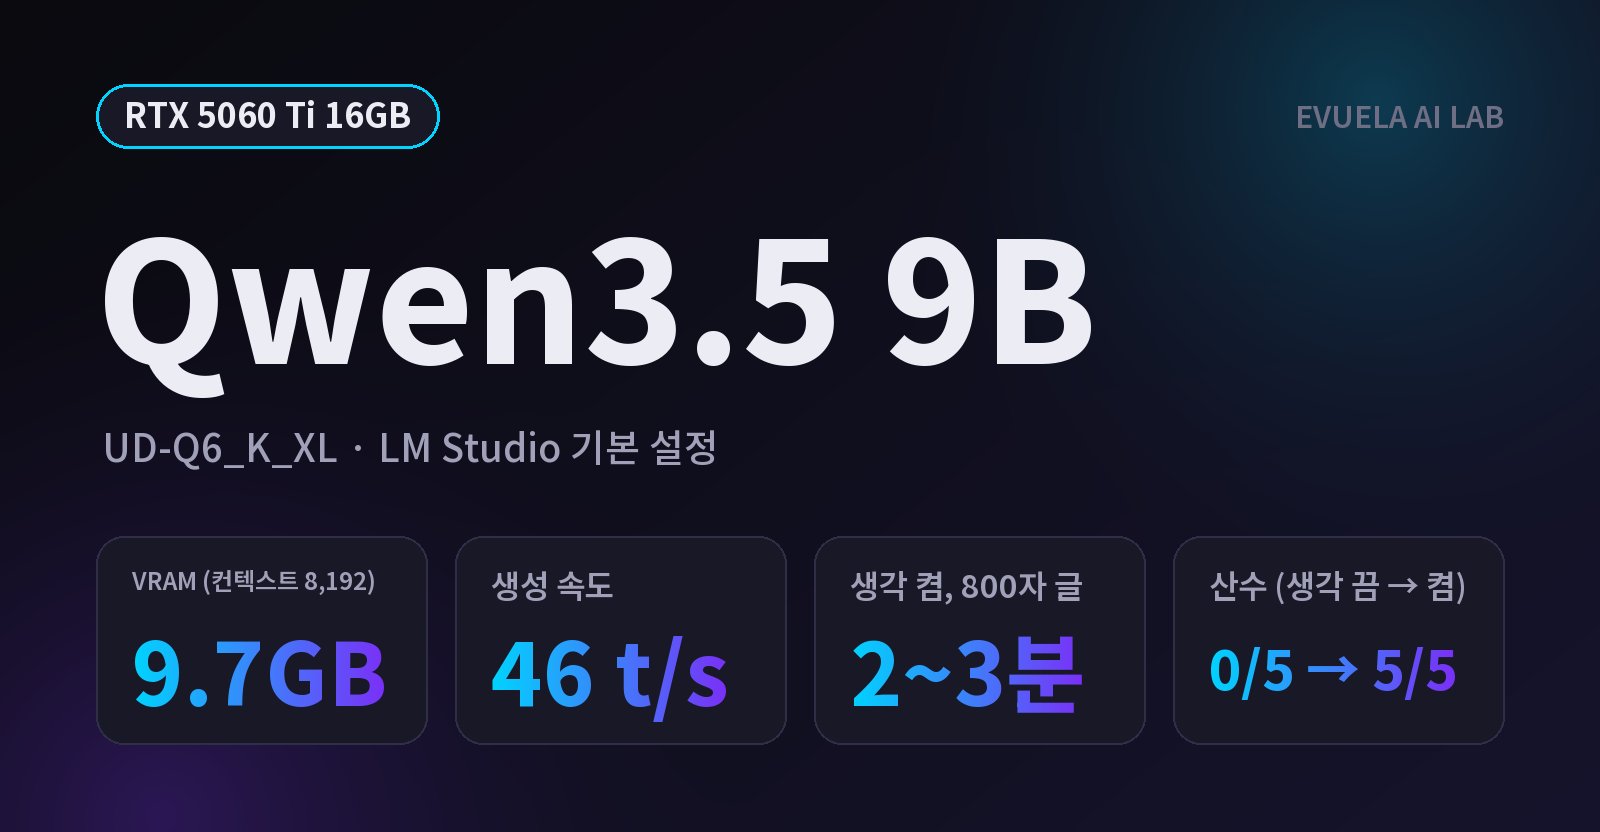
RTX 5060 Ti 16GB PC의 LM Studio에서 Qwen3.5 9B(UD-Q6_K_XL)를 기본 설정으로 재 봤습니다. VRAM 9.7GB, 약 46t/s였고 컨텍스트 131,072까지 VRAM에 다 들어갔습니다. 생각을 켜면 산수는 5번 모두 맞았지만 800자 글에 2~3분이 걸렸습니다. Ornith 1.5 9B와도 비교했습니다.
 RTX-5060TI 16GB
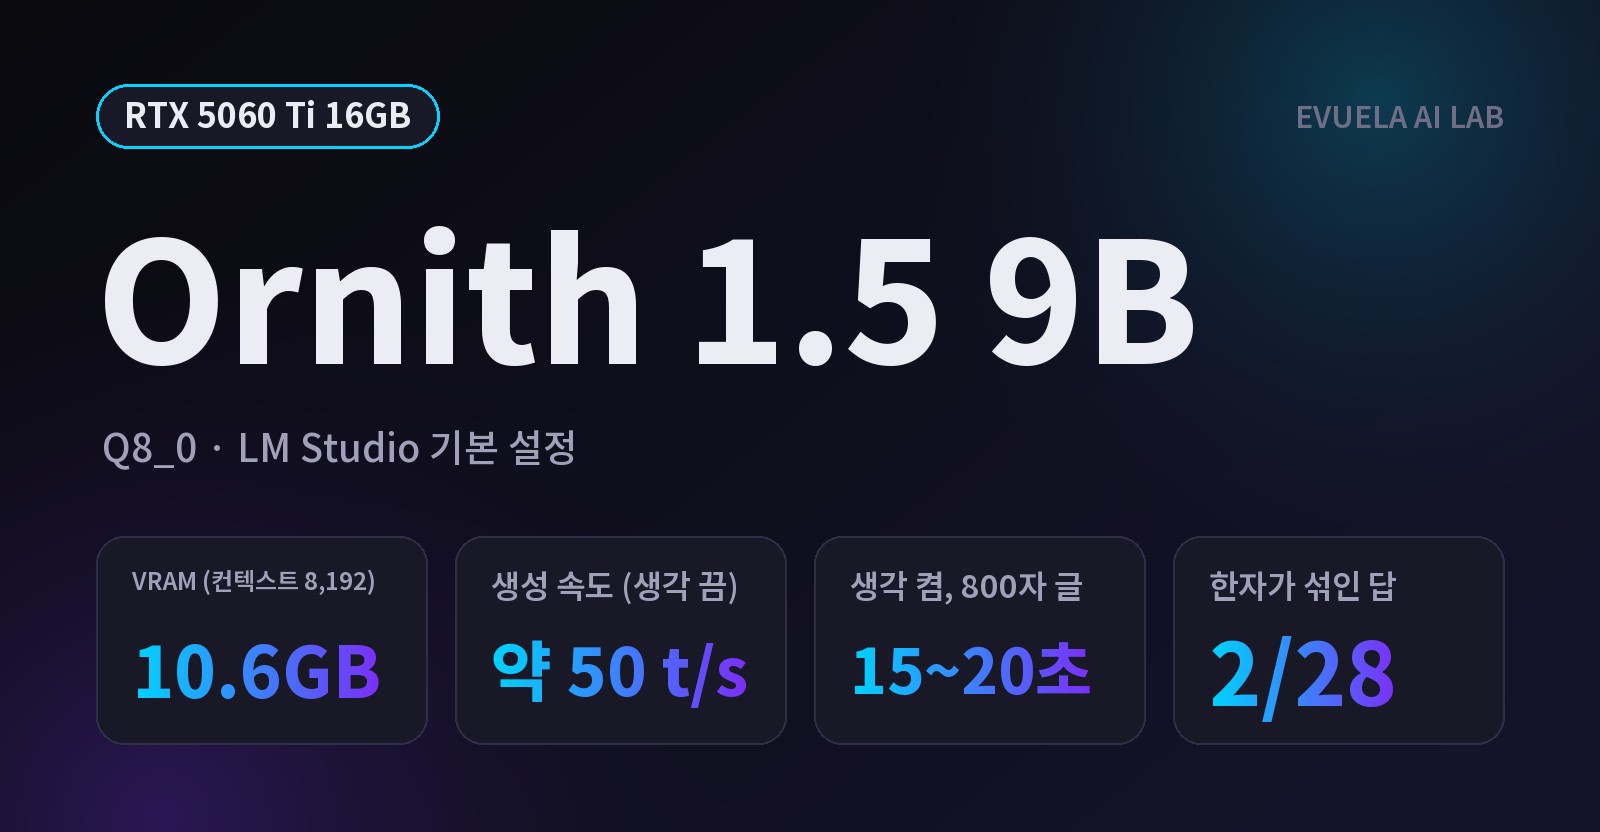
RTX 5060 Ti 16GB PC의 LM Studio에서 Ornith 1.5 9B(Q8_0, 9.79GB)를 기본 설정으로 재 봤습니다. VRAM 10.6GB, 생각 끔 약 50t/s, 생각 켬 56~65t/s였고 생각을 켜도 800자 글이 20초 안에 끝났습니다. 한국어 답 28개 중 2개에 한자가 섞였고, 형식 지시는 지키지 않았습니다.
 AI 뉴스
Comfy가 ComfyUI 워크플로를 커스텀 노드, 모델, LoRA까지 통째로 묶어 클라우드 GPU에 올리는 Comfy API를 열었습니다. 유료 요금제(월 20달러부터)가 필요하고 GPU는 초 단위로 냅니다(RTX PRO 6000 96GB가 1시간 4.54달러). Build·Release·Deployment가 무엇인지, 원래 있던 내 PC의 ComfyUI API와 무엇이 다른지, 실제로 얼마가 나오는지 계산과 함께 정리했습니다.
 AI 뉴스
구글이 새 최고 모델 Gemini 4 Argon을 발표했습니다. 출력 한도가 6만 4천 토큰에서 100만 토큰으로 늘었고, 도입 가격은 100만 토큰당 입력 2달러, 출력 10달러입니다. 하지만 지금은 정부·병원·통신사 같은 보안 담당 기관 650여 곳만 쓸 수 있습니다. 공식 발표문으로 출력 100만 토큰이 한글로 얼마나 되는지, 왜 순서를 나눠 공개하는지, 구글이 밝힌 시험 점수와 가격을 정리했습니다.