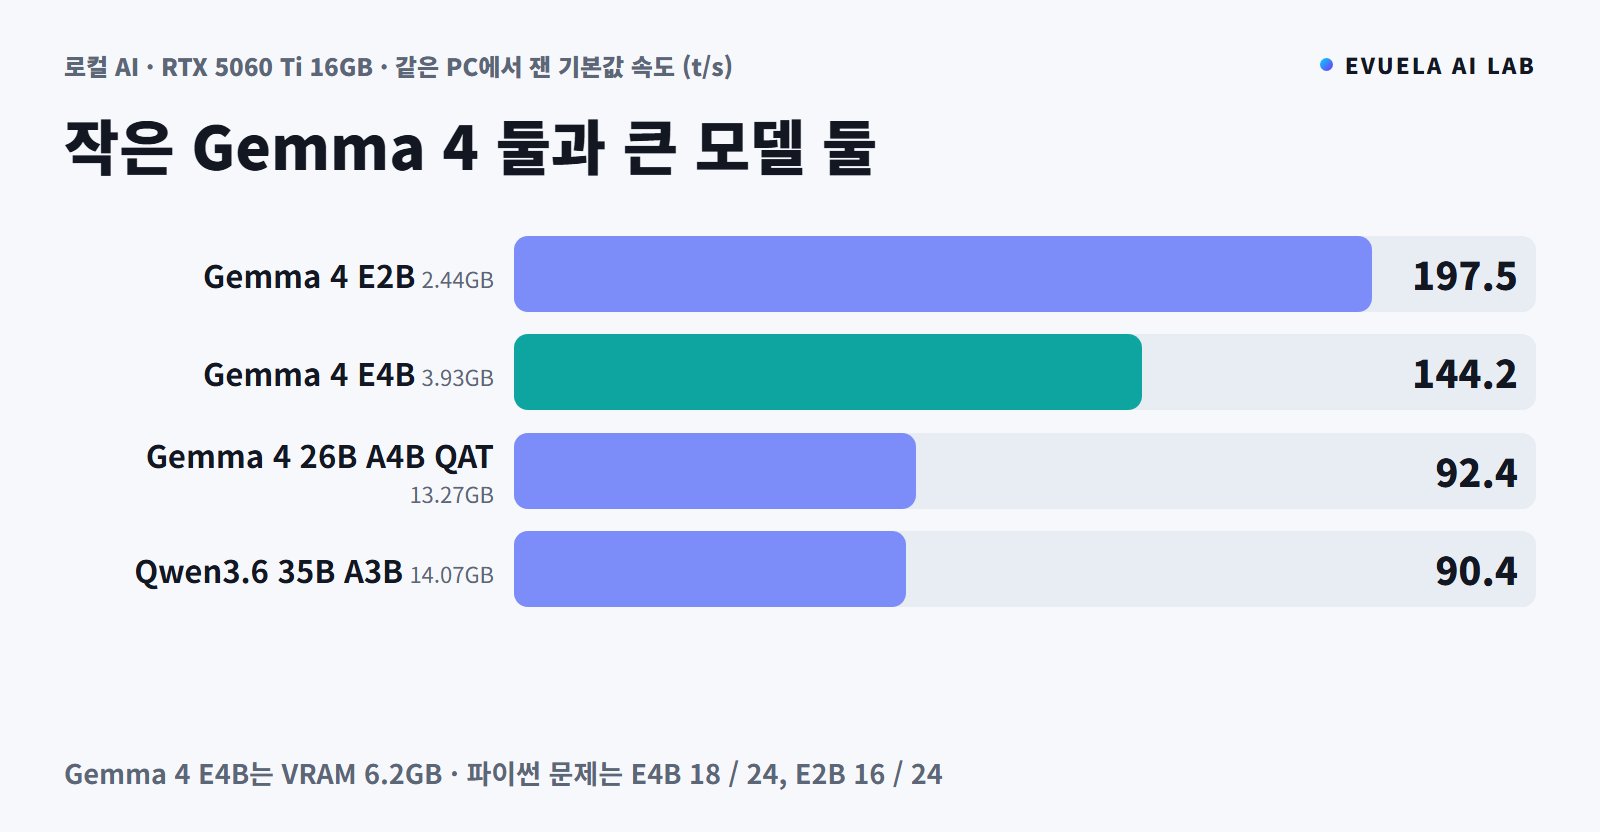
구글의 작은 Gemma 4 모델인 Gemma 4 E4B(unsloth의 QAT UD-Q4_K_XL, 파일 3.93GB)를 RTX 5060 Ti 16GB PC의 Unsloth Studio에서 기본값(Auto) 그대로 돌려 봤습니다. 결론부터 적으면 VRAM 약 6.2GB를 쓰고 초당 약 144토큰(t/s)이 나왔고, 한 단계 작은 E2B(약 197t/s)보다 27% 느린 대신 코딩 문제를 두 개 더 풀었습니다. 같은 질문을 5번 잰 평균이 144.3t/s(최소 140.6, 최대 149.4)입니다.
- 기본값이 최대 컨텍스트입니다. Auto가 컨텍스트를 131,072로 잡고 MTP도 켰습니다. 컨텍스트를 줄여도 속도는 같았습니다.
- MTP의 몫이 큽니다. 끄면 약 139t/s가 약 102t/s로 내려갑니다. 기본값이 켜 두고 있으니 건드릴 필요는 없습니다.
- 산수는 생각(Thinking)을 켜야 맞습니다. 끄면 5번 모두 틀리고, 켜면 5번 모두 맞았습니다(1~2초).
- 파이썬 8문제는 3번 풀어 24개 중 18개를 통과했습니다. 같은 여섯 문제를 매번 풀었고, 같은 두 문제를 매번 틀렸습니다.
- 없는 소설을 지어내지 않았습니다. 2번 물어 2번 모두 정보가 없다고 답했습니다.
이 글의 결과를 20초로 요약한 영상입니다(소리 없음).
이 글의 숫자는 모두 이 PC에서 직접 잰 값입니다. 속도와 정답 수는 Unsloth Studio의 API로 재고, 화면 캡처와 영상은 측정이 끝난 뒤 따로 찍었습니다. 측정은 2026년 10월 10일에 했습니다. 하루 전에 같은 PC, 같은 방법으로 잰 Gemma 4 E2B와 나란히 비교합니다.
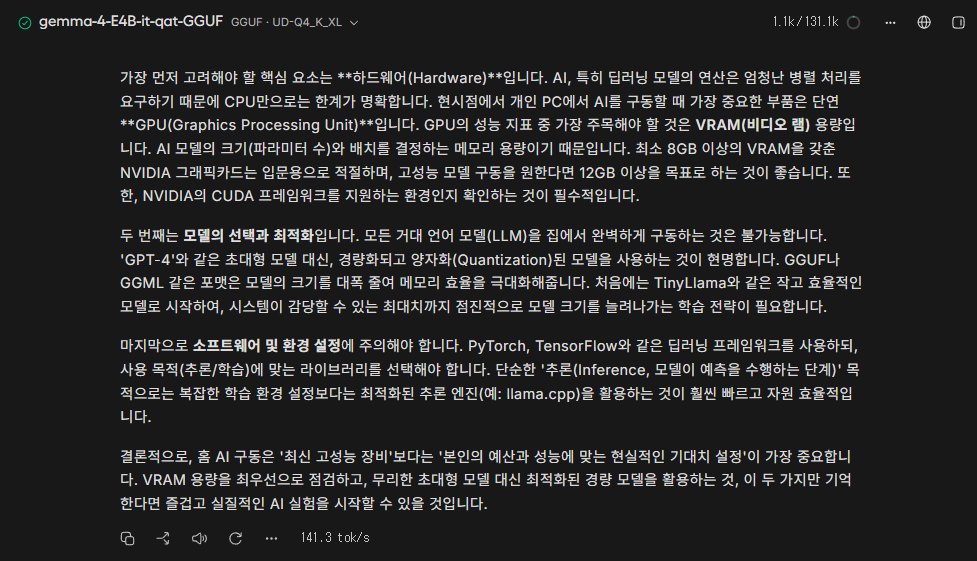
생각을 켠 채(앱 기본값) 800자 글을 쓰게 한 화면입니다. 답 아래에 초당 141.3토큰이 표시됩니다.
테스트 PC와 실행 프로그램
| 항목 | 내용 |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti (VRAM 16GB, 전력 제한 180W) |
| GPU 연결 | PCIe 3.0 x8 (메인보드가 PCIe 3.0까지 지원) |
| CPU | Intel Core i5-9400F (6코어 6스레드) |
| 시스템 램 | DDR4 32GB (16GB × 2, 2666MT/s) |
| 저장장치 | Crucial MX500 1TB SATA SSD |
| 운영체제 | Windows 11 Pro, 전원 구성표 균형 조정 |
| 실행 프로그램 | Unsloth Studio 데스크톱(베타) 2026.9.14 |
| 엔진 | llama.cpp 0.5.0-dev (build 11160, commit a3c12db9d, Unsloth가 빌드한 것) |
| GPU 드라이버 | 617.42 |
| 측정 방법 | Unsloth Studio의 OpenAI 호환 API(127.0.0.1:8888)로 같은 질문을 반복해서 보냄. 속도는 첫 토큰이 나온 뒤부터 잰 생성 속도 |
| 측정 스크립트 | Python 3.14.3, requests 2.34.2, psutil 7.2.2 |
| 샘플링 | 따로 지정하지 않음(프로그램 기본값) |
| 측정 날짜 | 2026년 10월 10일 |
테스트 PC 두 대의 사양과 측정 방법은 소개 페이지에 있습니다. 로컬 AI를 처음 써 본다면 로컬 AI 시작하기 1편부터 보면 됩니다.
테스트한 모델: Gemma 4 E4B
구글이 2026년에 공개한 Gemma 4 가운데 두 번째로 작은 모델입니다. 이름의 E는 "실효(effective)" 파라미터를 뜻합니다. 임베딩까지 합친 전체 파라미터는 8B이지만, 계산에 실제로 쓰는 파라미터는 4.5B라는 뜻입니다.
| 항목 | Gemma 4 E4B | Gemma 4 E2B (125번 글) |
|---|---|---|
| 파라미터 | 실효 4.5B (임베딩 포함 8B) | 실효 2.3B (임베딩 포함 5.1B) |
| 레이어 | 42 | 35 |
| 받은 파일 | unsloth/gemma-4-E4B-it-qat-GGUF의 UD-Q4_K_XL 3.93GB (4비트, QAT) | UD-Q4_K_XL 2.44GB |
| 함께 받은 파일 | 이미지 입력용 파일(mmproj) 0.92GB, MTP용 파일 0.06GB. 합쳐서 4.90GB, 받는 데 1분 30초 | 합쳐서 3.41GB |
| 최대 컨텍스트 | 모델 카드 128K, Unsloth Studio에서 131,072토큰 | |
| 입력 | 글, 사진, 소리(30초까지). 영상은 장면을 나눠서 | |
| 생각(Thinking) | 있음. 켜고 끌 수 있음 | |
| 라이선스 | Apache 2.0 | |
QAT는 양자화(파일을 줄이는 것)를 미리 염두에 두고 학습시킨 파일이라는 뜻입니다. 이 글에서는 QAT 파일과 일반 4비트 파일의 품질 차이를 따로 재지 않았습니다.
아래는 구글이 모델 카드에 적은 벤치마크 점수입니다. 제작사가 직접 잰 값이고, 양자화하지 않은 원본 기준입니다.
| 벤치마크 | Gemma 4 E2B | Gemma 4 E4B | Gemma 4 12B |
|---|---|---|---|
| MMLU Pro | 60.0% | 69.4% | 77.2% |
| AIME 2026 (도구 없이) | 37.5% | 42.5% | 77.5% |
| LiveCodeBench v6 | 44.0% | 52.0% | 72.0% |
| GPQA Diamond | 43.4% | 58.6% | 78.8% |
| MMMU Pro (사진 이해) | 44.2% | 52.6% | 69.1% |
제작사 점수로는 E2B보다 항목마다 5~15점 높고, 12B와는 여전히 차이가 큽니다. 이 PC에서 낸 문제에서 그 차이가 얼마나 보이는지는 아래에 적었습니다.
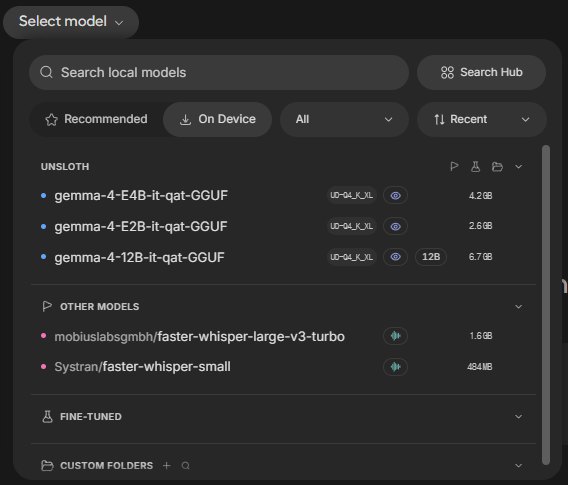
모델 선택 창입니다. 받아 둔 Gemma 4 E4B(4.2GB)가 맨 위에 보입니다.
Unsloth Studio 기본값(Auto)은 어떻게 올렸나
실행 설정 창에서 컨텍스트(모델이 한 번에 기억하는 글의 길이)를 기본값인 Auto로 두고 올렸습니다. 예상 메모리는 GPU 7.85GiB, 전체 9.42GiB로 나옵니다.
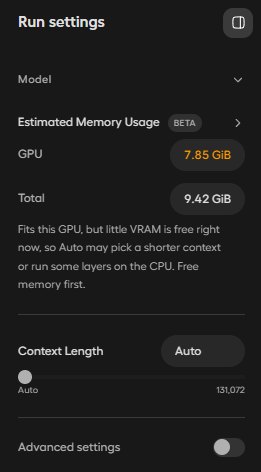
실행 설정 창입니다. 모델을 이미 올린 상태에서 찍어서 "지금은 남은 VRAM이 적다"는 안내가 붙어 있습니다.
| 설정 | Auto가 고른 값 | 뜻 |
|---|---|---|
| 컨텍스트 | 131,072 | 이 모델의 최대값. VRAM이 넉넉해서 줄이지 않음 |
-ngl -1 --fit off | 레이어를 모두 GPU에 | 모델 전체를 그래픽카드에 올림 |
--spec-type draft-mtp | MTP 켬 | 작은 보조 모델이 다음 토큰을 미리 예측해 속도를 높이는 기능 |
| 이미지 입력용 파일 | GPU에 올림 | 사진을 바로 읽을 수 있음 |
| KV 캐시 | f16 | 줄이지 않은 기본값 |
E2B와 똑같이 올라갔습니다. 16GB에서는 아무것도 줄이지 않고, 설정을 손댈 일이 없습니다.
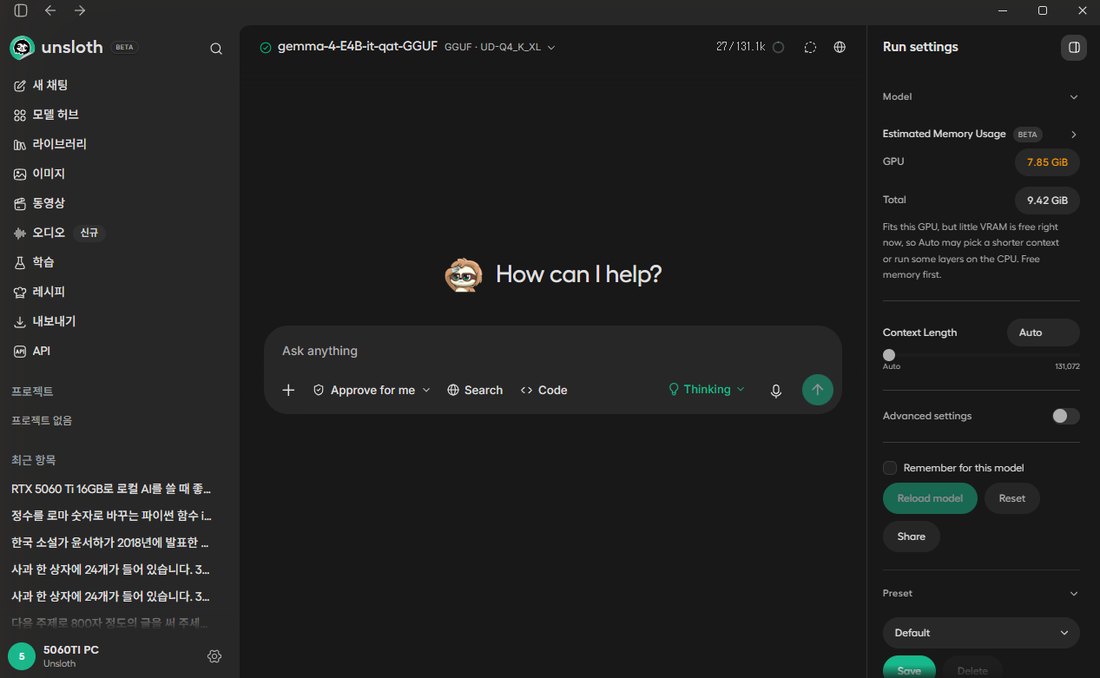
로드가 끝난 화면입니다. 컨텍스트 131.1k가 보이고, 입력칸에 Thinking(생각)이 켜져 있습니다.
VRAM과 시스템 램: 최대 컨텍스트에서 VRAM 6.2GB
로드 직전과 직후의 GPU 메모리와 PC 전체 램의 차이를 쟀습니다. 로드 전에 윈도우와 다른 프로그램이 VRAM 약 0.6GB, 램 약 9.5GB를 쓰고 있었습니다.
| 컨텍스트 | 모델이 쓴 VRAM | PC 전체 VRAM | 늘어난 시스템 램 | 로드 시간 | E2B가 쓴 VRAM |
|---|---|---|---|---|---|
| 8,192 | 4.1GB | 4.7GB | - | - | 2.7GB |
| 32,768 | 4.5GB | 5.1GB | 2.6GB | 10.2초 | 2.9GB |
| 65,536 | 5.1GB | 5.7GB | 2.6GB | 10.0초 | 3.2GB |
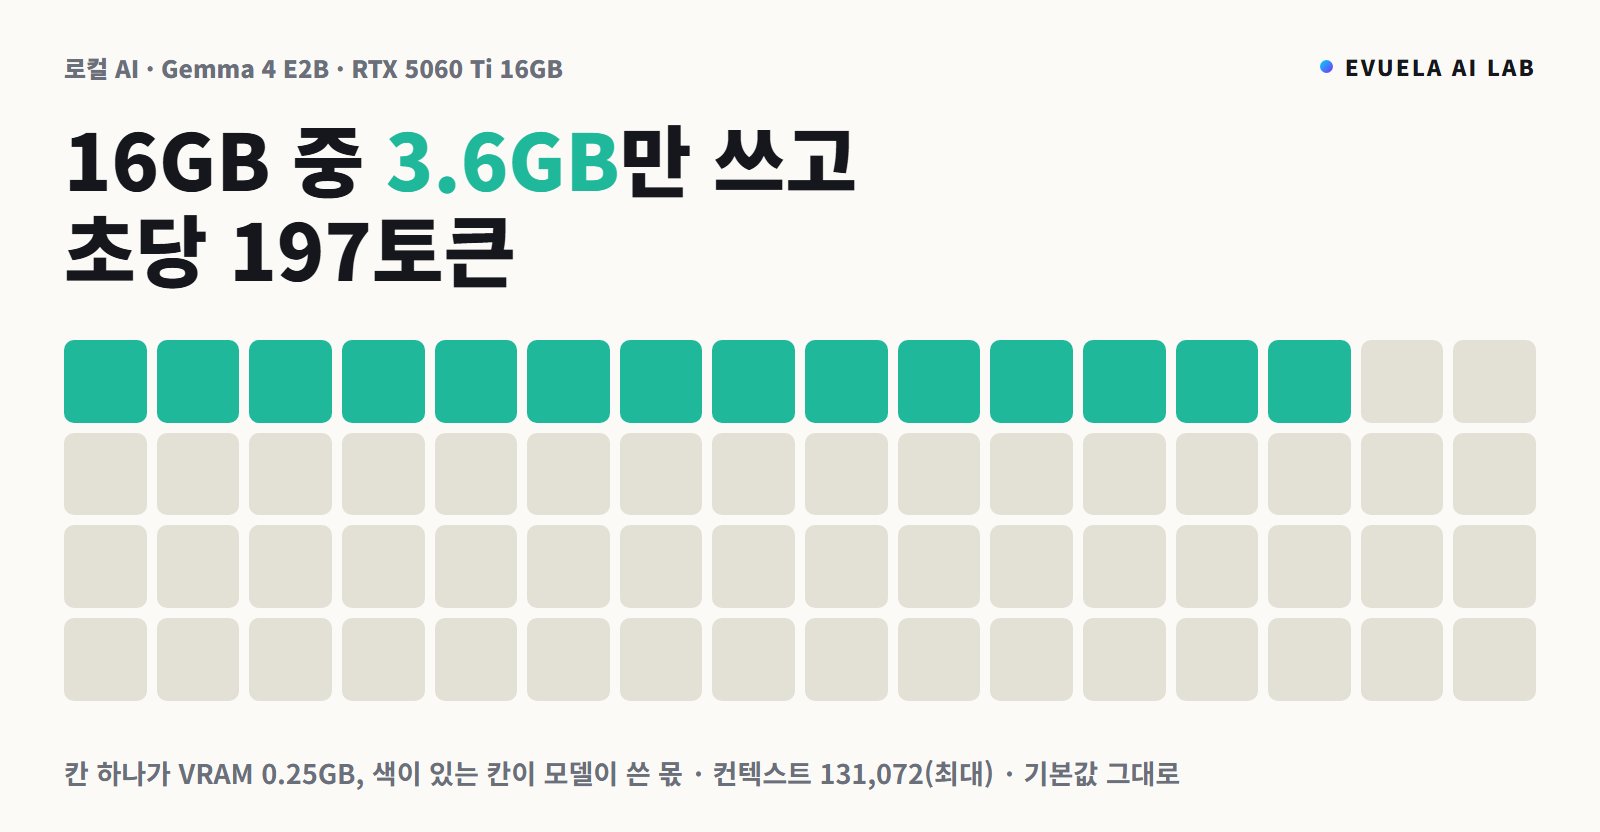
| 131,072 (Auto, 최대) | 6.2GB | 6.8GB | 2.8GB | 처음 33.1초, 다시 로드 10.3초 | 3.6GB |
최대 컨텍스트에서 PC 전체 VRAM이 6.8GB입니다. 16GB에서는 9GB쯤 남습니다. 8GB 그래픽카드라면 최대 컨텍스트로는 빠듯하고, 컨텍스트를 32,768로 줄이면 5.1GB라서 들어갈 크기입니다(8GB 카드에서 직접 재지는 않았습니다). E2B보다 컨텍스트가 커질 때 VRAM이 더 빨리 늘어납니다. 8,192에서 131,072로 갈 때 E2B는 0.9GB, E4B는 2.1GB 늘었습니다.
API로 컨텍스트 262,144를 요청하면 131,072로 올라갑니다. 로드 시간은 디스크에서 처음 읽을 때 33.1초, 내렸다가 바로 다시 올리면 10.3초였습니다. 이 PC는 SATA SSD입니다.
생성 속도: Auto에서 평균 144.3t/s
"집에 있는 PC로 AI 모델을 돌릴 때 알아야 할 점"으로 800자 글을 쓰게 했습니다. 생각을 끄고 5번 이어서 물었습니다.
| 순서 | 생성 속도 | 첫 토큰까지(TTFT) | 답 토큰 | 전체 시간 |
|---|---|---|---|---|
| 1번째 (로드 직후) | 140.6t/s | 0.15초 | 973 | 7.1초 |
| 2번째 | 144.4t/s | 0.08초 | 1,038 | 7.3초 |
| 3번째 | 140.7t/s | 0.05초 | 929 | 6.6초 |
| 4번째 | 146.1t/s | 0.07초 | 791 | 5.5초 |
| 5번째 | 149.4t/s | 0.04초 | 1,124 | 7.6초 |
| 평균 (최소~최대, 표준편차) | 144.3t/s (140.6~149.4, 3.7) | 0.08초 | 971 | 6.8초 |
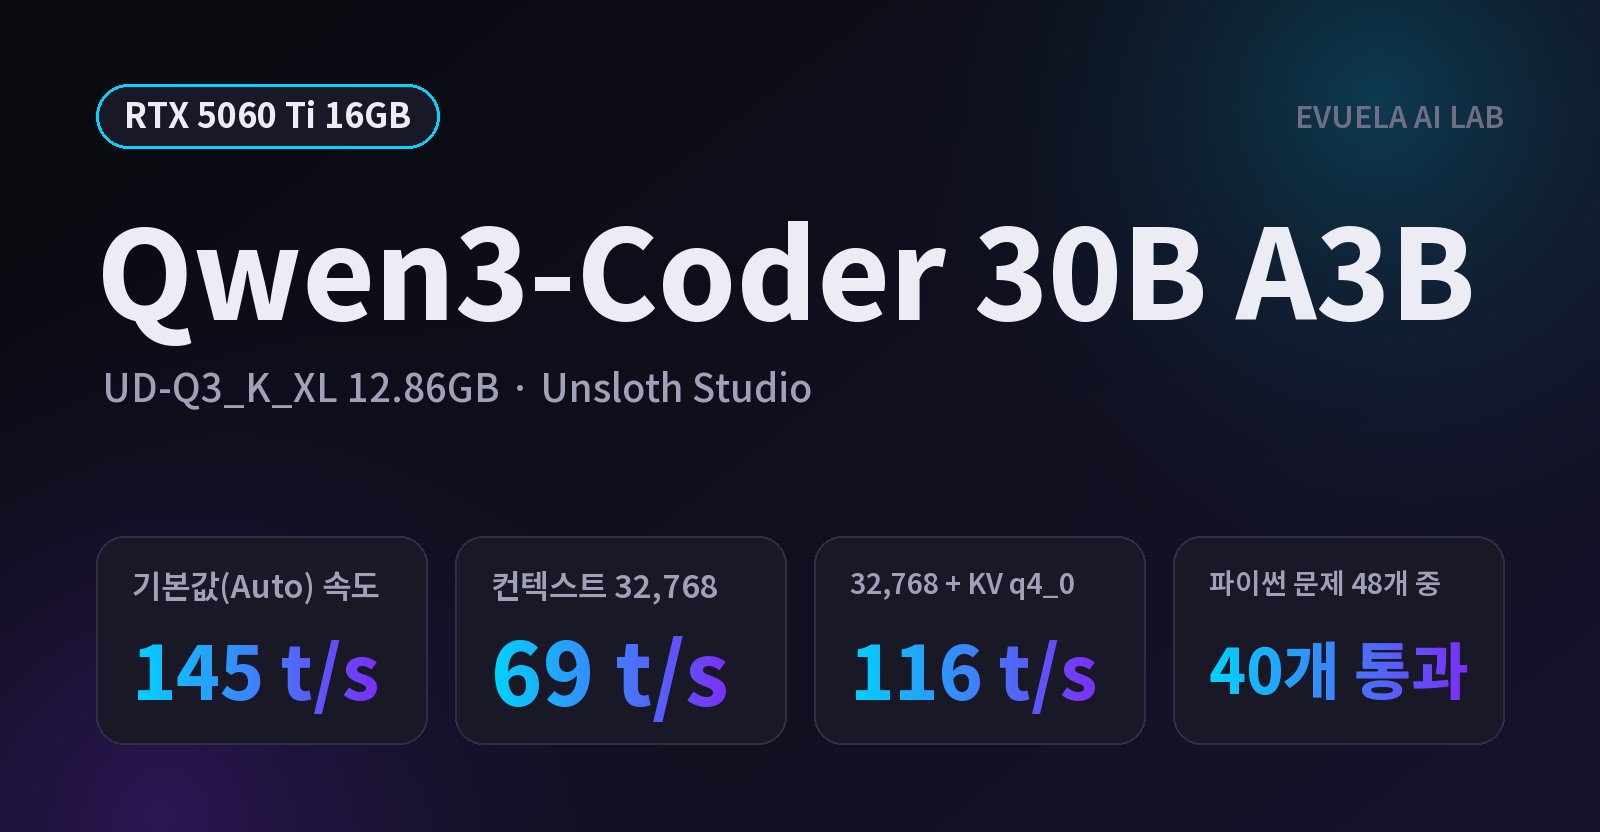
E2B의 197.5t/s보다 27% 느리고, 같은 PC에서 잰 Qwen3-Coder 30B A3B(145.3t/s)와 거의 같습니다. GPU 사용률은 평균 71%였습니다. 800자를 써 달라고 했는데 답은 1,630~2,218자로, E2B(1,492~1,764자)보다도 길었습니다. 분량 요청을 지키지 않는 것은 두 모델이 같습니다.
생각을 켜면: 답까지 8~10초
| 단계 | 생각 끔 (5번) | 생각 켬 (3번) |
|---|---|---|
| 모델 로드 (한 번만) | 처음 33.1초, 다시 로드 10.3초 | |
| 질문을 읽고 첫 토큰까지 | 0.04~0.15초 | 약 0.1초 |
| 생각 | 없음 | 약 4~5초 (563~811토큰) |
| 답 쓰기 | 약 5~8초 (791~1,124토큰) | 약 4~6초 |
| 질문부터 답 끝까지 | 5.5~7.6초 | 9.9 / 8.3 / 10.2초 |
| 생성 속도 | 140.6~149.4t/s | 148.9 / 144.2 / 138.1t/s |
생각을 켜도 10초 안팎입니다. E2B는 약 8초였습니다. 생각을 켰을 때 답 자체는 오히려 짧아져서(생각 끔 평균 971토큰, 켬은 답만 약 600~840토큰) 전체 시간 차이가 크지 않습니다.
컨텍스트를 늘려도: 속도가 그대로
컨텍스트만 바꿔 다시 로드하며 같은 800자 글을 쟀습니다(생각 끔 2번).
| 컨텍스트 | 생성 속도 (생각 끔) | 생각 켬 800자 글 | 15,000자 요약 TTFT | 사진 TTFT |
|---|---|---|---|---|
| 8,192 | 153.4 / 148.3t/s | 7.7초 | 1.7초 | (답을 받지 못함) |
| 32,768 | 144.6 / 151.8t/s | 8.1초 | 1.7초 | 0.47초 |
| 65,536 | 146.1 / 148.3t/s | 8.6초 | 1.7초 | 0.47초 |
| 131,072 (최대) | 147.6 / 143.4t/s | 6.4초 | 1.7초 | 0.47초 |
8,192부터 131,072까지 속도 차이가 없습니다. E2B와 같은 모습입니다. 컨텍스트 8,192에서는 사진 질문에 빈 답이 돌아왔습니다. 그 한 번만 그랬고, 원인은 확인하지 못했습니다.
설정을 바꾸면: MTP를 끄면 27% 느려진다
기본값(Auto)에서 설정을 하나씩만 바꿔 다시 로드하고, 같은 800자 글을 3번씩 쟀습니다(생각 끔 평균). 설정은 Unsloth Studio API의 로드 옵션으로 바꿨습니다.
| 설정 | 생성 속도 (3번 평균) | 생각 켬 800자 글 | 사진 TTFT | 모델이 쓴 VRAM |
|---|---|---|---|---|
| Auto (기본값, 컨텍스트 131,072, MTP 켬) | 139.3t/s | 9.5초 | 0.49초 | 6.2GB |
| MTP 끔 (Speculative Decoding off) | 101.7t/s | 15.6초 | 0.45초 | 6.0GB |
| 컨텍스트 32,768 | 142.6t/s | 8.4초 | 0.47초 | 4.5GB |
| 이미지 입력 끔 | 139.0t/s | 7.8초 | - | 5.1GB |
| KV 캐시 q4_0 | 124.2t/s | 12.9초 | 0.47초 | 5.7GB |
| 레이어 GPU 고정 | 137.2t/s | 9.5초 | 0.62초 | 6.2GB |
- MTP가 약 37%를 보탭니다. 끄면 139.3t/s가 101.7t/s로 내려가고, 생각을 켠 글은 9.5초가 15.6초로 늘었습니다. E2B에서는 MTP의 몫이 약 18%였는데, E4B에서는 두 배입니다.
- KV 캐시를 줄이면 느려졌습니다. VRAM은 0.5GB 줄지만 속도가 124.2t/s로 내려갑니다. VRAM이 남는 16GB에서는 쓸 이유가 없습니다.
- VRAM을 아끼려면 컨텍스트를 줄이는 편이 낫습니다. 32,768로 줄이면 모델이 쓰는 VRAM이 6.2GB에서 4.5GB가 되고 속도는 그대로입니다. 이미지 입력을 끄면 1.1GB가 더 줄어듭니다.
- 기본값을 같은 조건으로 여러 번 쟀을 때 139~148t/s 사이에서 움직였습니다. 표에서 10t/s 안쪽의 차이는 의미를 두기 어렵습니다.
다른 곳의 측정과 견주기
같은 모델을 잰 다른 글 두 편과 조건을 나란히 놓았습니다. 숫자는 각 글쓴이가 잰 값입니다.
| 항목 | 이 글 | alfonsofortunato.com (2026년 4월) | ai-muninn (2026년 4월) |
|---|---|---|---|
| 장비 | RTX 5060 Ti 16GB | RTX 4070 Ti 12GB | 맥북 프로 M1 Max 32GB / 엔비디아 GB10 128GB / 애플 M4 16GB |
| 파일 | QAT UD-Q4_K_XL 3.93GB | Q8_0 7.62GiB | Ollama의 gemma4:e4b (약 9.6GB, 양자화 종류는 적혀 있지 않음) |
| 프로그램 | Unsloth Studio (llama.cpp build 11160) | llama.cpp build 8641 (llama-bench) | Ollama 0.20.0~0.20.3 |
| 컨텍스트 | 131,072 | 측정 명령에는 적혀 있지 않음 | GB10은 65,536, 나머지는 적혀 있지 않음 |
| MTP | 켬 (기본값) | 적혀 있지 않음 | 적혀 있지 않음 |
| 생성 속도 | 144.3t/s (MTP를 끄면 101.7) | 69.7t/s (레이어를 모두 GPU에 올렸을 때) | 52.8 / 37.1 / 23.5t/s |
RTX 4070 Ti 기록은 8비트 파일로 69.7t/s입니다. 이 글은 4비트 QAT 파일에 MTP가 켜진 144.3t/s이고, MTP를 끈 101.7t/s와 견줘도 이 PC가 빠릅니다. 파일 크기가 절반인 것이 큰 차이로 보입니다(추정). 그 글에는 레이어 일부만 GPU에 올렸을 때 27.9t/s로 떨어졌다는 기록도 있습니다. 작은 모델이라도 GPU에 다 올라가는지가 속도를 가릅니다.
화면에서 돌린 영상
새 채팅을 열고 질문 하나를 보낸 영상입니다(11초, 소리 없음, 생각 끔).
영상에는 초당 116.5토큰으로 찍혔습니다. 화면 녹화 프로그램이 CPU를 쓰는 동안 찍었기 때문에 표의 숫자(약 144t/s)보다 느립니다. 같은 방법으로 찍은 E2B는 140.2t/s였습니다. 답의 내용에는 확인되지 않은 말이 섞여 있을 수 있습니다. 속도를 보여 주려는 영상이니 내용은 참고하지 마세요. 녹화에 쓴 프로그램은 103번 글에서 소개했습니다.
산수: 생각을 끄면 0/5, 켜면 5/5
"사과 한 상자에 24개가 들어 있습니다. 3상자를 사서 19개를 먹고, 남은 것을 5명이 똑같이 나누면 한 사람당 몇 개이고 몇 개가 남나요? '한 사람당 X개, 남는 것 Y개' 형식으로만 답하세요."를 5번씩 물었습니다. 정답은 한 사람당 10개, 남는 것 3개입니다.
| 생각 | 정답 | 답 | 걸린 시간 |
|---|---|---|---|
| 끔 | 0 / 5 | "10개, 4개", "2개, 3개", "3개, 1개", "1, 남는 것 3개", "한 사람당 3개, 남는 것 0개" | 약 0.1초 |
| 켬 | 5 / 5 | "한 사람당 10개, 남는 것 3개" 4번, "10개, 3개" 1번 | 1.1~2.4초 (생각 174~423토큰) |
E2B와 결과가 같습니다. 생각을 끄면 계산 없이 바로 답을 적어서 틀리고, 정해 준 형식도 5번 중 4번 지키지 않았습니다. 생각을 켜면 5번 모두 맞았습니다. 모델이 커졌다고 해서 생각 없이 계산을 맞히지는 못했습니다. 계산이 들어가는 질문에는 생각을 켜 둬야 합니다.
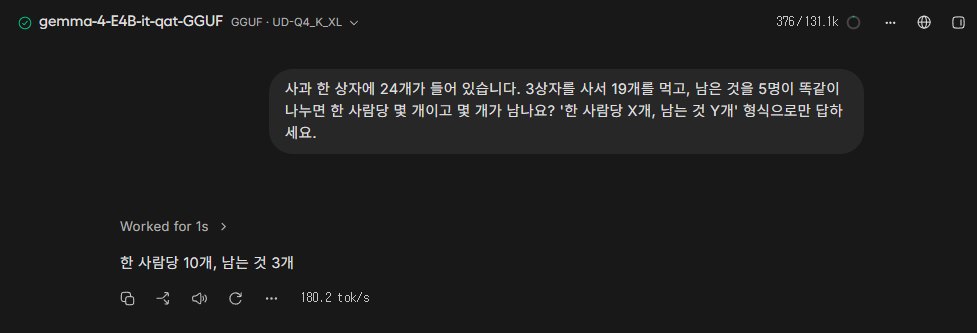
생각을 켠 답입니다. 1초 생각한 뒤 "한 사람당 10개, 남는 것 3개"로 맞혔습니다.
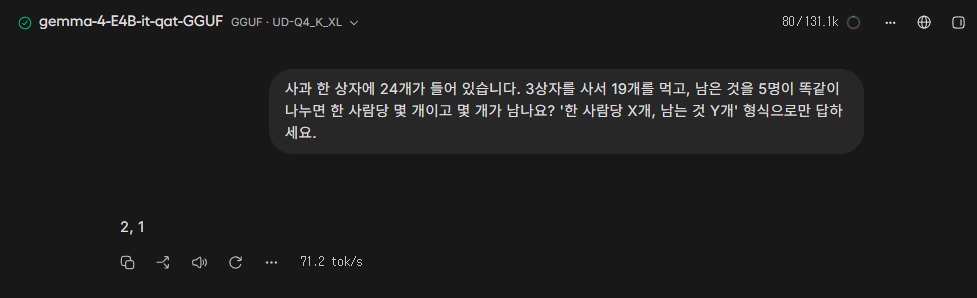
생각을 끈 답입니다. "2, 1"로 틀렸고 형식도 지키지 않았습니다.
코딩: 파이썬 8문제를 3번씩, 생각 끔 18/24 · 켬 18/24
파이썬 함수 8개를 짜게 하고, 숨겨 둔 테스트로 채점했습니다. 문제는 구간 합치기, 로마 숫자 변환, 수식 계산기, 가장 긴 회문, 다음 영업일, 많이 나온 낱말, 나선 순서, 한글 숫자를 정수로 바꾸기입니다. 8문제를 처음부터 끝까지 3번 풀게 했습니다.
| 생각 | 1회 | 2회 | 3회 | 합계 | 8문제 전체 시간 |
|---|---|---|---|---|---|
| 끔 (답 최대 2,000토큰) | 6 / 8 | 6 / 8 | 6 / 8 | 18 / 24 | 30~34초 |
| 켬 (최대 8,000토큰) | 6 / 8 | 6 / 8 | 6 / 8 | 18 / 24 | 66~97초 |
| 문제 | 생각 끔 (3번 중) | 생각 켬 (3번 중) |
|---|---|---|
| 구간 합치기, 로마 숫자, 가장 긴 회문, 다음 영업일, 많이 나온 낱말, 나선 순서 | 3번 모두 통과 | 3번 모두 통과 |
| 수식 계산기 | 0번 (테스트 9개 중 7개, 0개, 8개) | 0번 (7개, 0개, 8개) |
| 한글 숫자를 정수로 | 0번 | 0번 |
| 모델 (같은 PC, 같은 문제) | 생각 끔 | 생각 켬 |
|---|---|---|
| Gemma 4 E2B (2.44GB) | 16 / 24 | 16 / 24 |
| Gemma 4 E4B (3.93GB) | 18 / 24 | 18 / 24 |
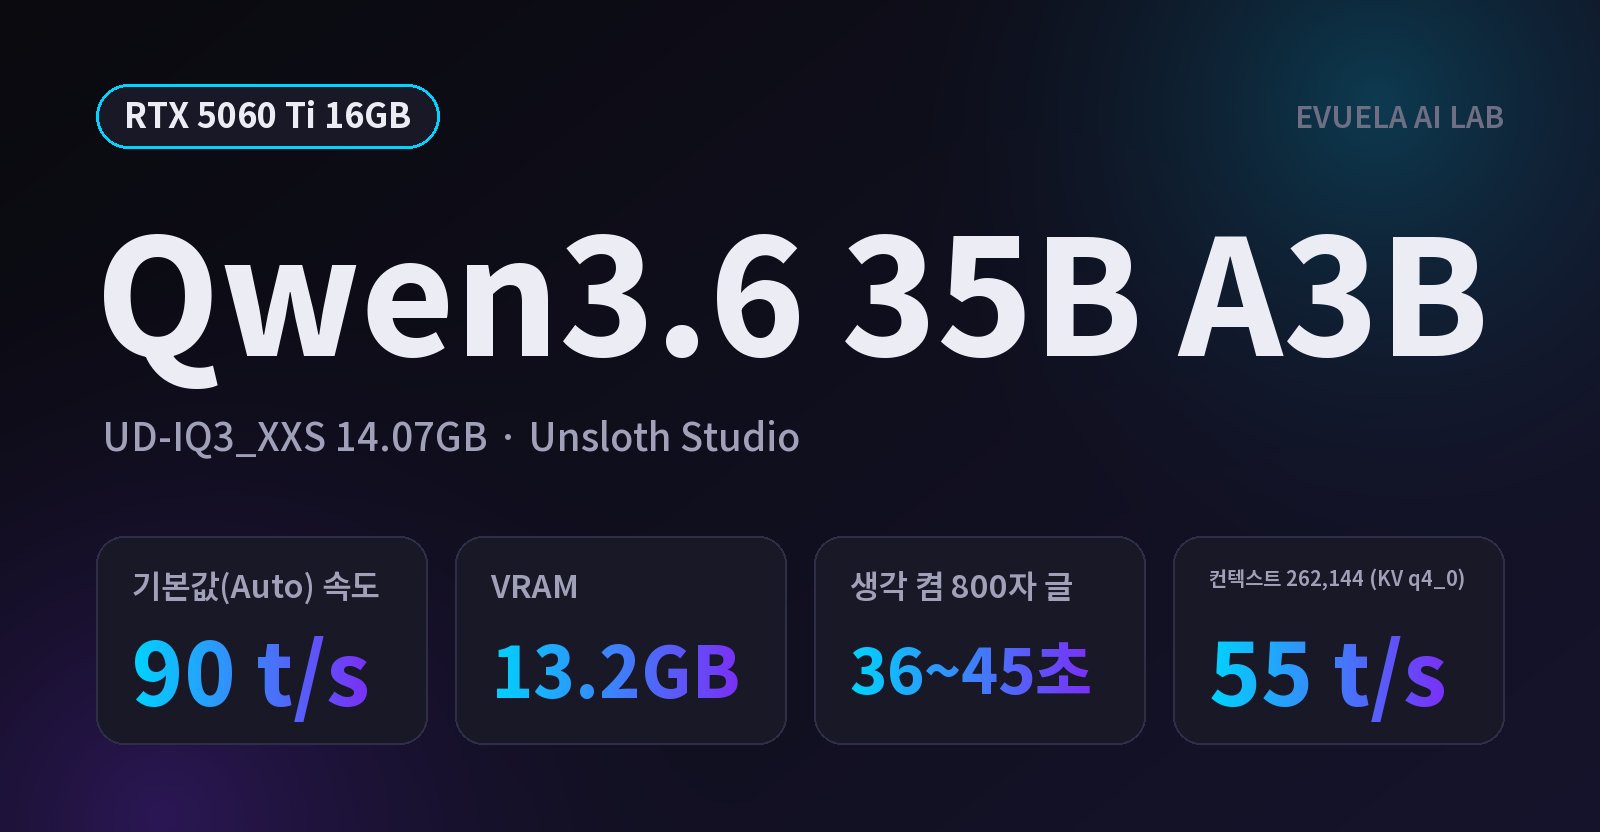
| Qwen3.6 35B A3B (14.07GB) | 18 / 24 | 20 / 24 |
| Gemma 4 26B A4B QAT (13.27GB) | 19 / 24 | 21 / 24 |
| Qwen3-Coder 30B A3B (12.86GB, 생각 기능 없음) | 40 / 48 | |
E2B와 달라진 점은 고르게 푼다는 것입니다. E2B는 쉬운 여섯 문제에서도 가끔 틀렸는데(회차마다 4~6개), E4B는 여섯 문제를 여섯 번 모두 통과했습니다. 틀린 두 문제도 매번 같습니다. 수식 계산기는 테스트 9개 중 7~8개까지 맞힌 적이 있어, 한 번도 가까이 가지 못한 E2B보다는 나았습니다. 생각을 켜도 정답 수는 같았고 시간만 두세 배 걸렸습니다. 생각 끔 기준으로는 파일이 3.5배 큰 Qwen3.6 35B A3B와 같은 18개입니다. 다만 문제가 8개뿐이라, 작은 차이는 우연일 수 있습니다.
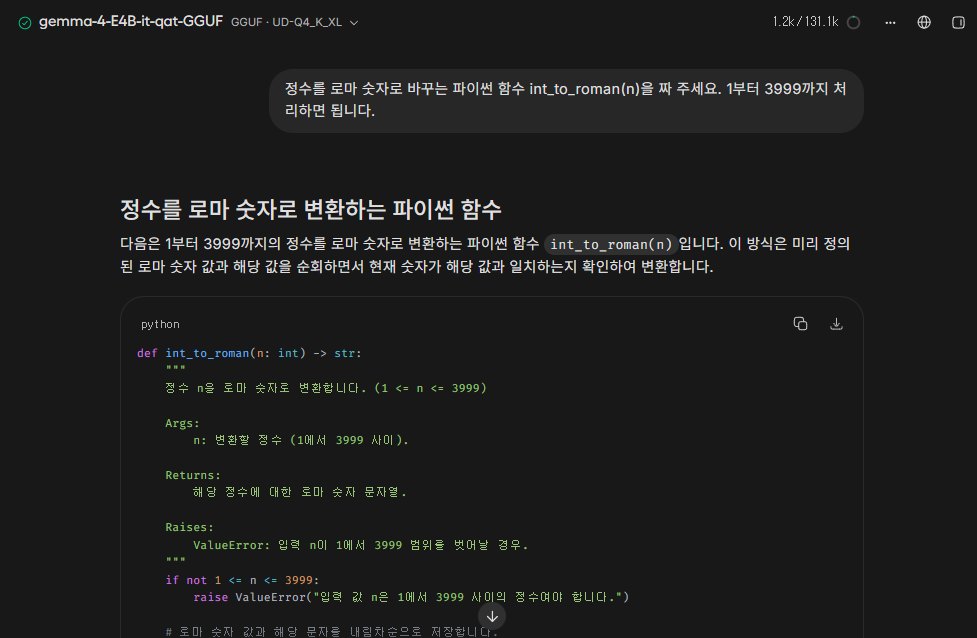
정수를 로마 숫자로 바꾸는 함수를 짜게 한 화면입니다. 설명문에 인자, 반환값, 예외를 한국어로 적었습니다.
긴 글 요약과 긴 대화
이 블로그의 업데이트 기록을 넣어 세 문장으로 요약하게 했습니다(생각 끔). 3,000자와 15,000자는 컨텍스트 32,768, 100,000자는 131,072에서 넣었습니다.
| 넣은 글 | 입력 토큰 | TTFT | 생성 속도 | 결과 |
|---|---|---|---|---|
| 3,000자 | 1,603 | 0.5초 | 145.6t/s | 세 문장으로 요약 |
| 15,000자 | 7,976 | 1.3초 | 148.8t/s | 번호를 붙인 세 항목으로 요약. 게임 이름 '한알한알'을 맞게 적음 |
| 100,000자 | 48,606 | 13.4초 | 100.0t/s | 번호를 붙인 세 항목으로 요약 |
약 4만 9천 토큰짜리 글을 13.4초 만에 읽고 답을 쓰기 시작했습니다. E2B는 9.9초였습니다. 3,000자 글은 요청대로 세 문장으로 요약했습니다. E2B는 세 번 모두 문장 수를 지키지 않았습니다. 긴 글 두 개는 E4B도 세 항목으로 나눠 적었습니다.
대화가 길어질 때를 보려고, 앞에 긴 글을 두고 한 문장짜리 질문을 붙였습니다(컨텍스트 32,768).
| 앞에 쌓인 토큰 | TTFT | 생성 속도 | E2B의 생성 속도 |
|---|---|---|---|
| 1,096 | 0.4초 | 167.9t/s | 208.0t/s |
| 8,491 | 1.6초 | 149.0t/s | 204.8t/s |
| 20,892 | 3.1초 | 128.6t/s | 193.0t/s |
약 2만 1천 토큰이 쌓이면 속도가 23% 내려갔습니다. E2B는 7%만 내려갔습니다. 대화가 길어질수록 두 모델의 속도 차이가 벌어집니다.
긴 문서에서 정보 찾기: 5번 모두 찾음
약 10,300토큰짜리 글의 10%, 30%, 50%, 70%, 90% 위치에 "블로그 관리자가 키우는 고양이 보리차는 2019년에 태어났다"는 문장을 하나 숨기고, 고양이 이름과 태어난 해를 물었습니다. 5번 모두 정해 준 형식대로 보리차와 2019를 답했습니다(첫 토큰까지 2.2초). 문장을 숨기지 않은 글에서는 "없음"이라고 답했습니다.
전력과 온도: 평균 약 96W, 최고 58도
800자 글을 쓰는 동안 0.5초마다 그래픽카드 상태를 읽었습니다(컨텍스트 32,768, 생각 끔, 2번).
| 항목 | Gemma 4 E4B | Gemma 4 E2B | Gemma 4 26B A4B QAT |
|---|---|---|---|
| 쉬고 있을 때 전력 | 약 12W | 약 12W | 약 11.5W |
| 글 쓰는 동안 평균 전력 | 95~97W | 78~79W | 60~62W |
| 최고 전력 | 113W | 96W | 78W |
| 최고 온도 | 56~58도 | 52~54도 | 48~49도 |
| 평균 GPU 사용률 | 69~70% | 59~60% | 35~36% |
| 토큰 하나에 쓴 전기 | 약 0.7J | 약 0.4J | 약 0.75J |
E2B보다 전력을 약 20W 더 쓰고, 토큰 하나에 드는 전기는 0.4J에서 0.7J로 늘었습니다. 훨씬 큰 Gemma 4 26B A4B QAT와 비슷한 수준입니다. 그래도 전력 제한 180W의 절반 정도입니다.
없는 소설과 사진
실제로 없는 소설("윤서하의 2018년 장편소설 『푸른 등대의 겨울』")의 줄거리를 API로 한 번, 앱 화면에서 한 번 물었습니다. 2번 모두 그 작품의 정보를 가지고 있지 않다고 답했고, 지어내지 않았습니다. 제목이나 작가 이름이 맞는지 다시 확인해 달라고 했습니다. E2B와 같은 결과입니다.
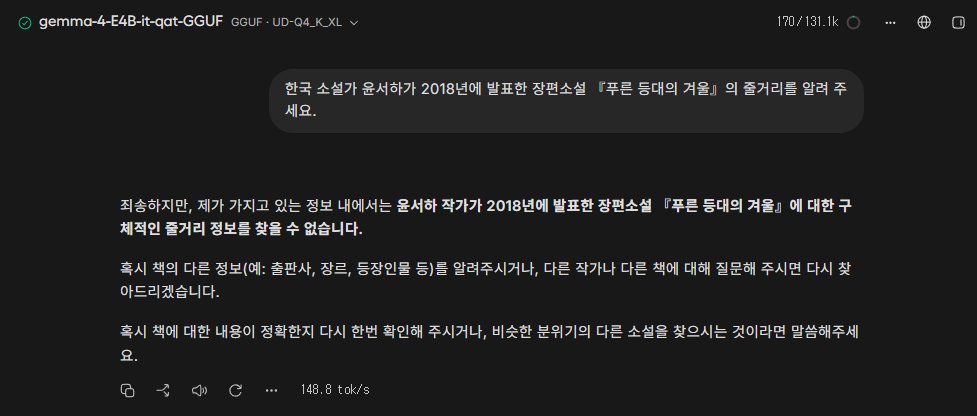
없는 소설을 물은 화면입니다. 줄거리 정보를 찾을 수 없다고 답했습니다.
모래시계 두 개가 놓인 사진을 주고 무엇이 보이는지 물었습니다. 설정을 바꿔 가며 API로 물었고, 답의 글을 확인한 것은 8번입니다.
- 읽는 속도는 빠릅니다. 첫 토큰까지 약 0.5초였습니다.
- 두 모래시계가 다르다는 것은 알아봤습니다. 8번 중 6번은 오른쪽 모래시계가 왼쪽과 다르게 생겼다고 말했습니다("금속 프레임에 감싸져 있다" 등). E2B는 대부분 둘을 똑같이 묘사했습니다.
- 무엇이 다른지는 맞히지 못했습니다. 이 사진의 특징은 "오른쪽 모래시계 안에 전자 부품이 들어 있다"입니다. 전자 부품이라고 말한 답은 없었고, "복잡한 기계 장치"라고 한 것이 2번이었습니다. Qwen3.6 35B A3B는 9번 중 7번, Gemma 4 26B A4B QAT는 13번 중 7번 맞게 말했습니다.
E2B보다는 사진을 조금 더 자세히 보지만, 세부를 물을 때는 여전히 큰 모델이 필요합니다. 소리 입력은 이 글에서 시험하지 않았습니다.
API로 받은 한국어 답 80개를 모두 확인했는데, 한자나 다른 나라 글자가 섞인 답은 없었습니다. 앱 화면에서는 굵은 글씨 표시(**)가 한글 조사 앞에서 그대로 보이는 곳이 있었습니다. 맨 위 캡처의 "**하드웨어(Hardware)**입니다"가 그 예입니다.
정리: E2B와 E4B, 무엇을 고를까
하루 차이로 같은 PC, 같은 프로그램, 같은 질문으로 잰 두 모델입니다.
| 항목 | Gemma 4 E4B | Gemma 4 E2B |
|---|---|---|
| 파일 (QAT UD-Q4_K_XL) | 3.93GB | 2.44GB |
| Auto 컨텍스트 | 131,072 (최대) | 131,072 (최대) |
| Auto 속도 (5번 평균) | 144.3t/s | 197.5t/s |
| 모델이 쓴 VRAM (Auto) | 6.2GB | 3.6GB |
| MTP를 끄면 | 101.7t/s (27% 느려짐) | 161.4t/s (16% 느려짐) |
| 800자 글 (생각 끔 / 켬) | 약 7초 / 8~10초 | 약 4초 / 약 8초 |
| 산수 (끔 / 켬) | 0/5, 5/5 | 0/5, 5/5 |
| 코딩 8문제 3번 (끔 / 켬) | 18/24, 18/24 | 16/24, 16/24 |
| 없는 소설 | 모른다고 답함 | 모른다고 답함 |
| 사진 속 두 물건의 차이를 말한 횟수 | 8번 중 6번 (전자 부품이라고 한 것은 0번) | 8번 중 1번 |
| 4만 9천 토큰 글의 TTFT | 13.4초 | 9.9초 |
| 2만 1천 토큰 쌓인 뒤 속도 | 128.6t/s | 193.0t/s |
| 토큰 하나에 쓴 전기 | 약 0.7J | 약 0.4J |
- E4B는 더 고르게 답합니다. 쉬운 코딩 문제를 매번 풀었고, 짧은 글은 요청한 문장 수를 지켰고, 사진에서 두 물건의 차이를 알아봤습니다.
- E2B는 더 빠르고 가볍습니다. 속도가 37% 높고 VRAM은 2.6GB 적게 씁니다. 대화가 길어져도 속도가 덜 떨어집니다.
- 같은 점도 많습니다. 둘 다 16GB에서 기본값이 최대 컨텍스트이고, 산수는 생각을 켜야 맞고, 없는 것은 모른다고 답했습니다. 어려운 코딩 문제 두 개는 둘 다 한 번도 풀지 못했습니다.
- 16GB에서 고른다면: VRAM이 넉넉하니 E4B를 쓰는 편이 낫습니다. 다른 GPU 작업과 함께 올려 두거나, 긴 글을 많이 넣거나, 8GB 이하 그래픽카드라면 E2B가 맞습니다.
한 단계 큰 Gemma 4 12B를 16GB에서 잰 결과는 82번 글에, 내 그래픽카드에서 다른 모델이 어느 정도 속도로 도는지는 GPU 체험에 있습니다.
이 글의 한계
- 2026년 10월 10일, Unsloth Studio 2026.9.14(llama.cpp build 11160), 그래픽 드라이버 617.42 기준입니다. E2B는 하루 전에 같은 조건으로 쟀습니다.
- QAT UD-Q4_K_XL 파일 하나만 쟀습니다. 더 작은 UD-Q2_K_XL(3.00GB)이나 QAT가 아닌 파일은 재지 않았고, 파일에 따른 답 품질 차이도 재지 않았습니다.
- 5번 반복은 기본값의 생각 끔 800자 글에만 했습니다. 컨텍스트별 표는 2번씩, 설정 비교 표는 3번씩 잰 값이고 요약은 조건마다 한 번입니다.
- 같은 기본값을 다시 쟀을 때 평균이 139~148t/s 사이에서 움직였습니다. 설정 비교 표의 작은 차이는 이 범위 안입니다.
- 컨텍스트 8,192에서 사진 질문에 빈 답이 한 번 돌아왔습니다. 원인을 확인하지 못했고 다시 재지 않았습니다.
- 컨텍스트를 실제로 가장 길게 채운 것은 약 4만 9천 토큰입니다.
- 소리 입력과 영상 입력은 시험하지 않았습니다.
- 사진은 한 장으로만 물었습니다. "두 물건이 다르다고 말했다"는 판정은 답의 글을 읽고 내린 것입니다.
- 8GB 그래픽카드에서 직접 재지는 않았습니다.
- 코딩 문제는 직접 만든 짧은 8문제입니다. E2B와의 두 문제 차이는 우연일 수 있습니다.
- 모델 카드가 권하는 샘플링 값(temperature 1.0, top_p 0.95, top_k 64)을 따로 지정하지 않고 프로그램 기본값으로 쟀습니다.
- 프로그램을 켠 직후의 첫 실행은 따로 재지 않았습니다.
자주 묻는 질문
RTX 5060 Ti 16GB에서 Gemma 4 E4B는 몇 t/s인가요?
QAT UD-Q4_K_XL(3.93GB) 파일을 Unsloth Studio 기본값으로 돌렸을 때 800자 글 기준 평균 144.3t/s(140.6~149.4)였습니다. 컨텍스트 8,192부터 131,072까지 속도가 같았습니다.
VRAM은 얼마나 쓰나요?
최대 컨텍스트 131,072에서 모델이 6.2GB, PC 전체로 6.8GB였습니다. 컨텍스트를 32,768로 줄이면 모델이 4.5GB를 씁니다.
E2B와 E4B 중 무엇을 받아야 하나요?
16GB 그래픽카드라면 E4B를 권합니다. 속도는 E2B가 37% 빠르지만(197.5 대 144.3t/s), E4B가 쉬운 코딩 문제를 더 고르게 풀었고 사진도 조금 더 자세히 봤습니다. VRAM이 8GB 이하이거나 다른 GPU 작업과 함께 쓴다면 E2B가 맞습니다.
MTP는 켜야 하나요?
Unsloth Studio 기본값이 이미 켜 둡니다. 끄면 139.3t/s가 101.7t/s로 내려가니 그대로 두면 됩니다.
댓글 0개