[RTX 5090] VRAM 5.5GB 로컬 AI 에이전트는 어디까지 될까, LFM3-1.7B + Hermes Agent 한국어 과제 33번 중 28번 성공
에이전트용 1.7B 모델 LFM3-1.7B를 Hermes Agent에 붙여 RTX 5090에서 과제 7가지를 시켰습니다. 33번 중 28번 성공, VRAM 5.5GB, 초당 252토큰. 짧은 일은 Qwen3.8 27B보다 빨랐지만 여러 단계 작업은 5번 중 1번만 성공했습니다.
RTX 5090 32GB 그래픽카드로 로컬 AI 모델을 직접 돌려 테스트합니다.
총 18개의 글
에이전트용 1.7B 모델 LFM3-1.7B를 Hermes Agent에 붙여 RTX 5090에서 과제 7가지를 시켰습니다. 33번 중 28번 성공, VRAM 5.5GB, 초당 252토큰. 짧은 일은 Qwen3.8 27B보다 빨랐지만 여러 단계 작업은 5번 중 1번만 성공했습니다.
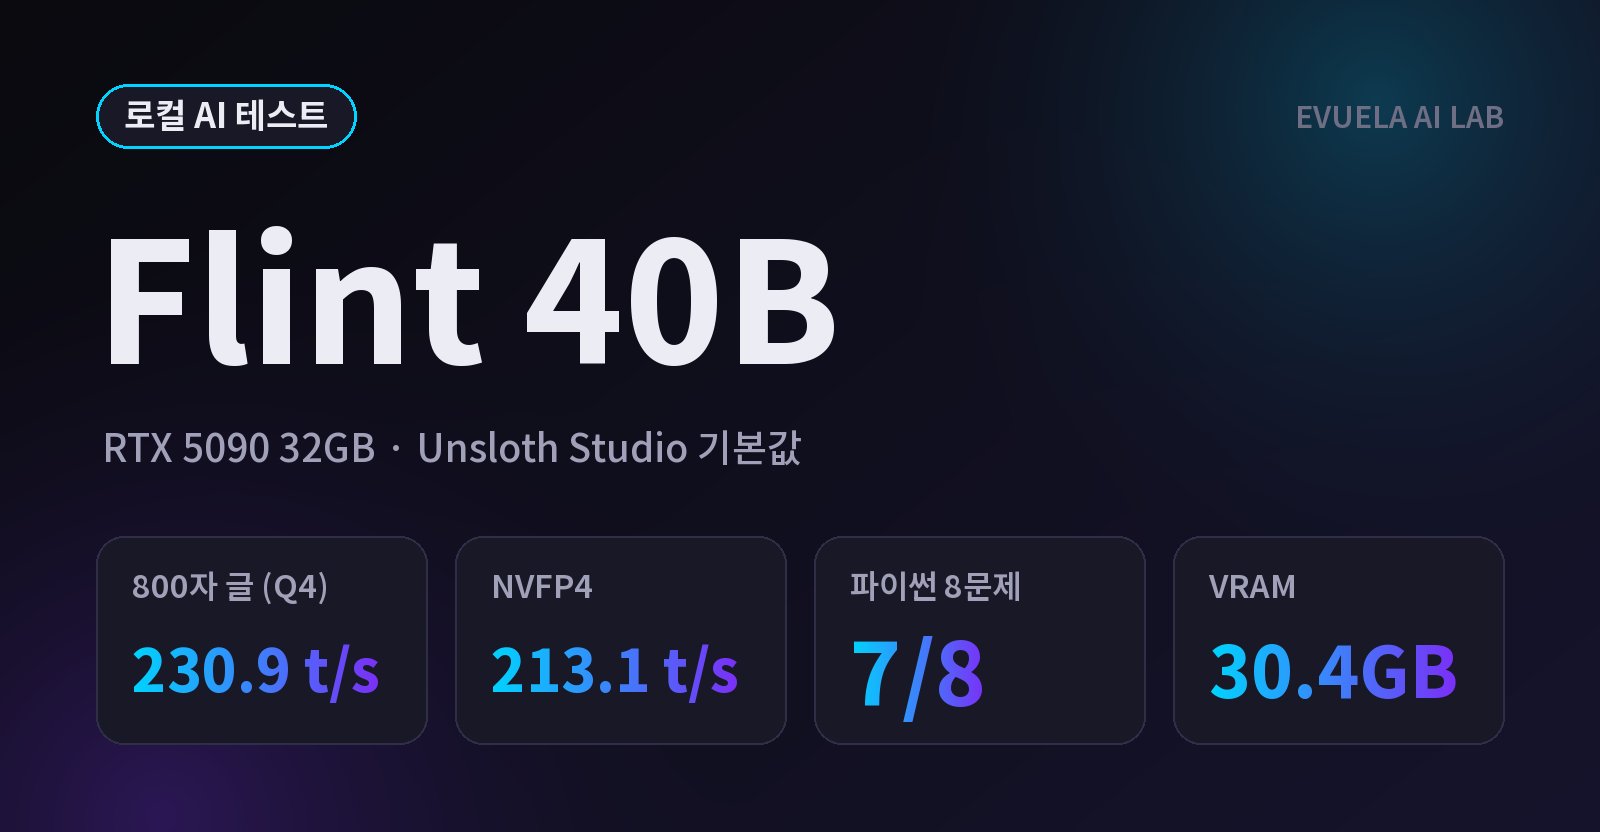
Recursive SI의 공개 코딩 모델 Flint 40B를 RTX 5090 32GB의 Unsloth Studio에서 Q4와 공식 NVFP4로 쟀습니다. 초당 230.9토큰, VRAM 30.4GB, 파이썬 8문제 중 7문제를 풀었고, 생각은 끌 수 없었으며 37만 8천 원을 3만 7,800원으로 읽었습니다.
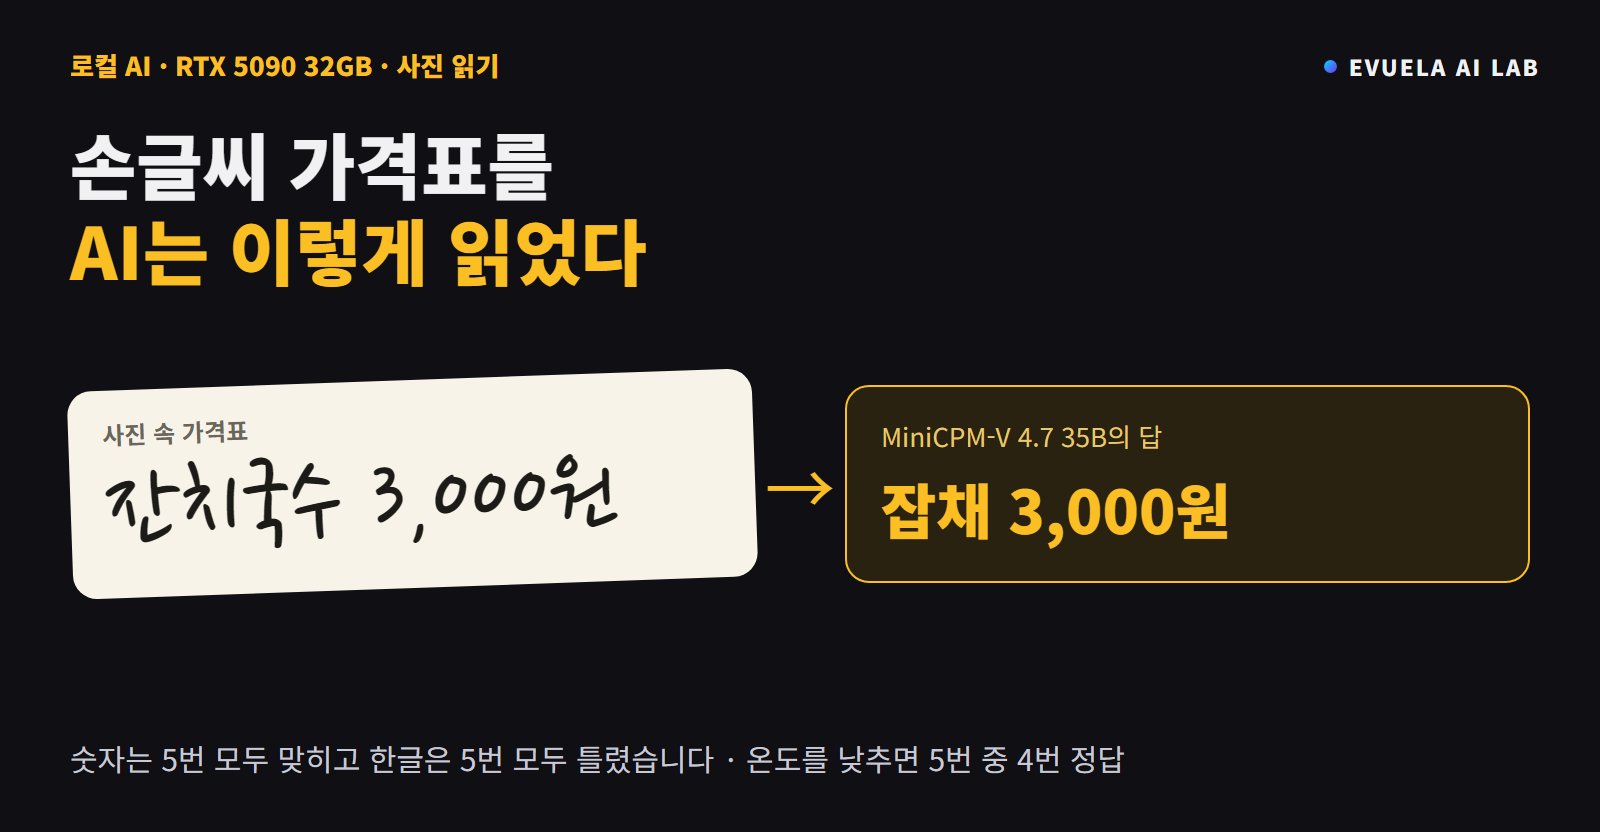
사진과 영상을 읽는 공개 모델 MiniCPM-V 4.7 35B A3B를 RTX 5090에서 쟀습니다. 속도는 초당 269토큰, 표와 화면 캡처는 70번 중 65번, Pixabay 실제 사진은 55번 중 29번 맞혔습니다. Unsloth Studio에서 사진이 안 된 이유와 한글 간판을 틀린 모습, 나아지는 설정도 적었습니다.
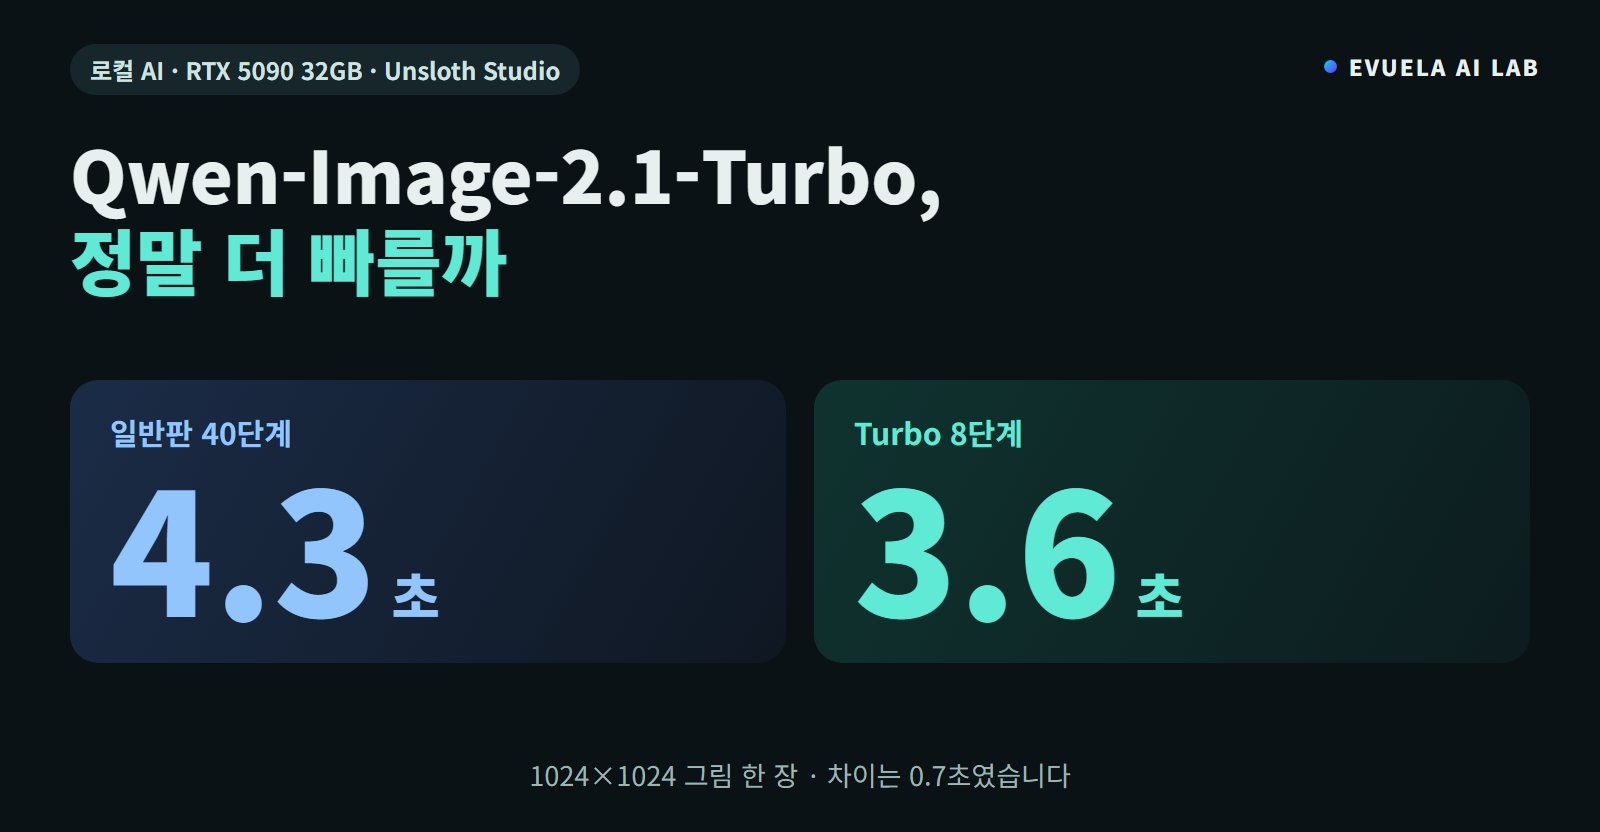
Qwen-Image-2.1-Turbo를 RTX 5090의 Unsloth Studio에서 일반판과 비교했습니다. 1024×1024 한 장에 Turbo 8단계 3.6초, 일반판 40단계 4.3초였고 VRAM은 13.9GB와 21.3GB였습니다. 기본 설정으로 올리면 일반판 가중치로 그려지는 문제와 해결 방법도 적었습니다.
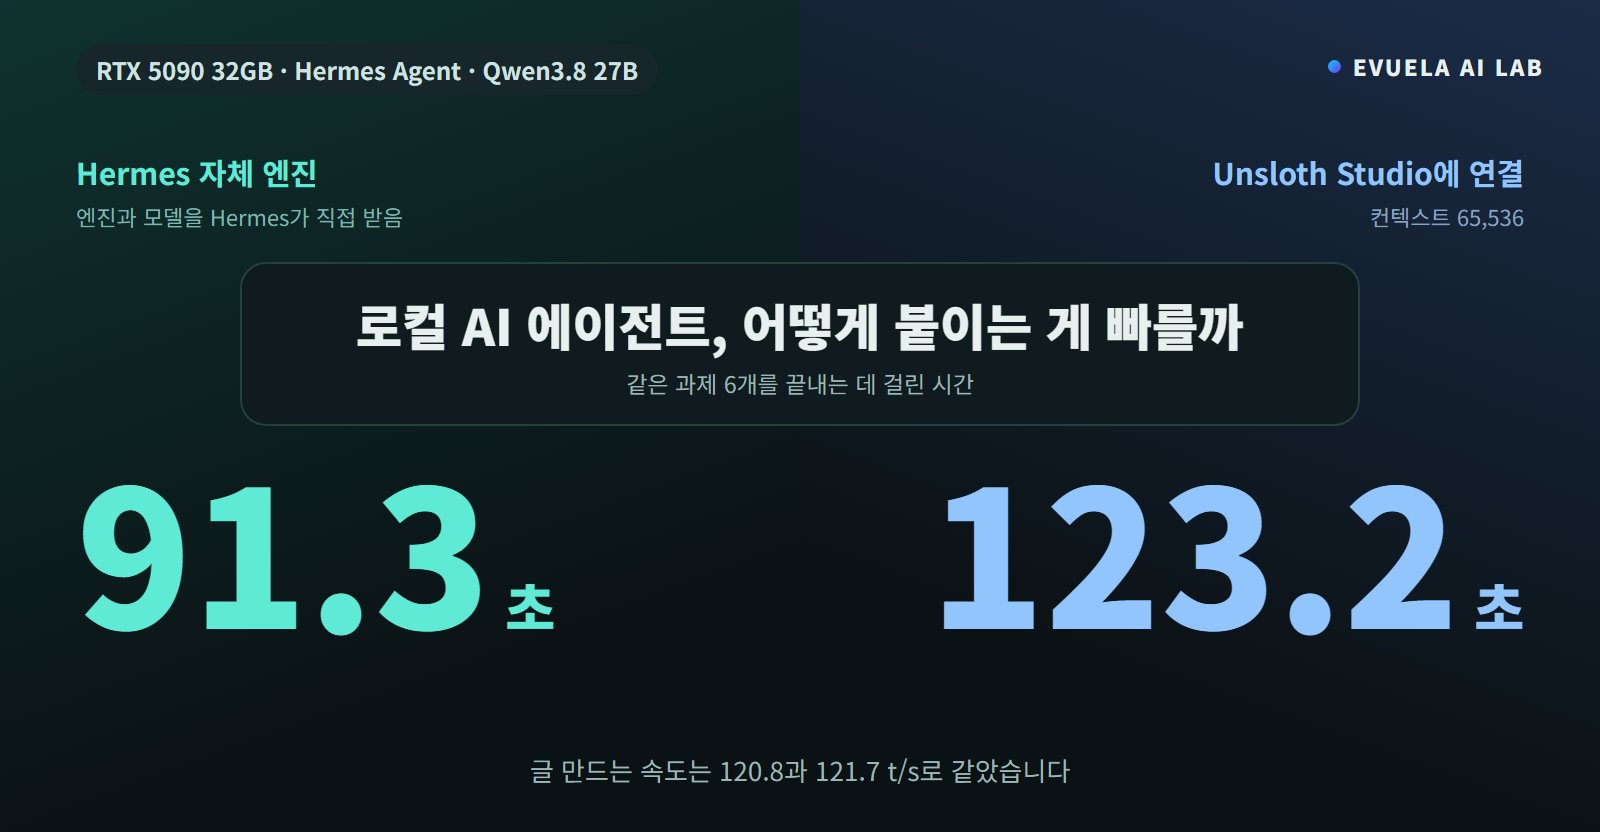
Hermes Agent를 로컬 모델에 붙이는 두 방식을 RTX 5090에서 Qwen3.8 27B로 비교했습니다. 글 만드는 속도는 120.8과 121.7 t/s로 같았지만 과제 6개는 91.3초와 123.2초였습니다. 차이는 프롬프트를 다시 읽는 양에서 났습니다.
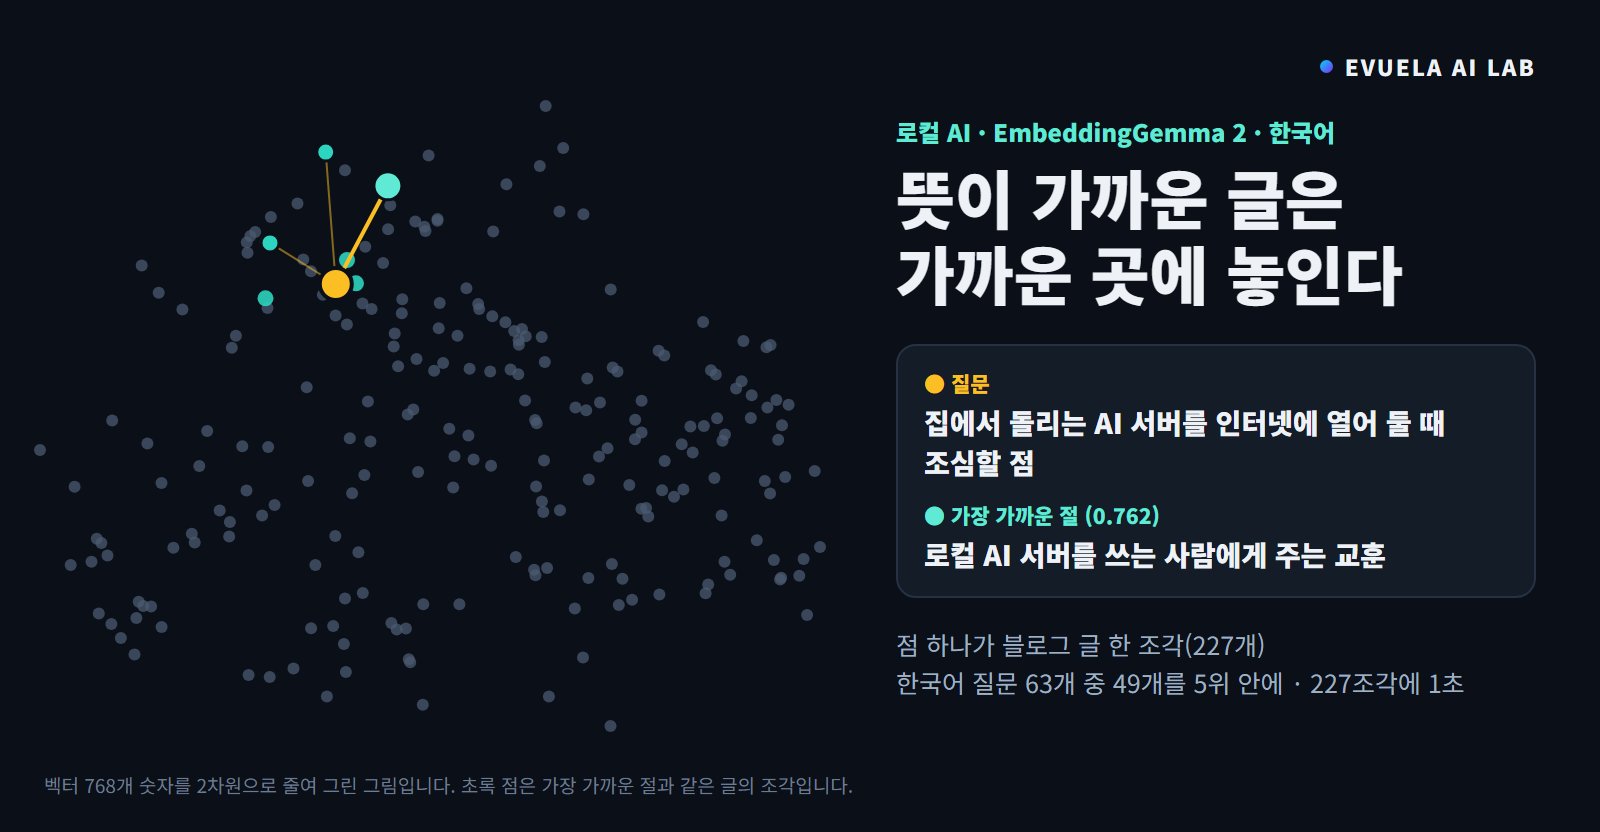
구글 EmbeddingGemma 2로 이 블로그 글 227조각을 한국어 질문 63개로 검색했습니다. 다른 낱말로 바꿔 물은 질문은 17개를 1위로 찾아 낱말 검색(9개)의 약 두 배였고, 영어로 물어도 34개를 찾았습니다. 227조각을 벡터로 바꾸는 데 1.06초, VRAM은 0.5GB였습니다.
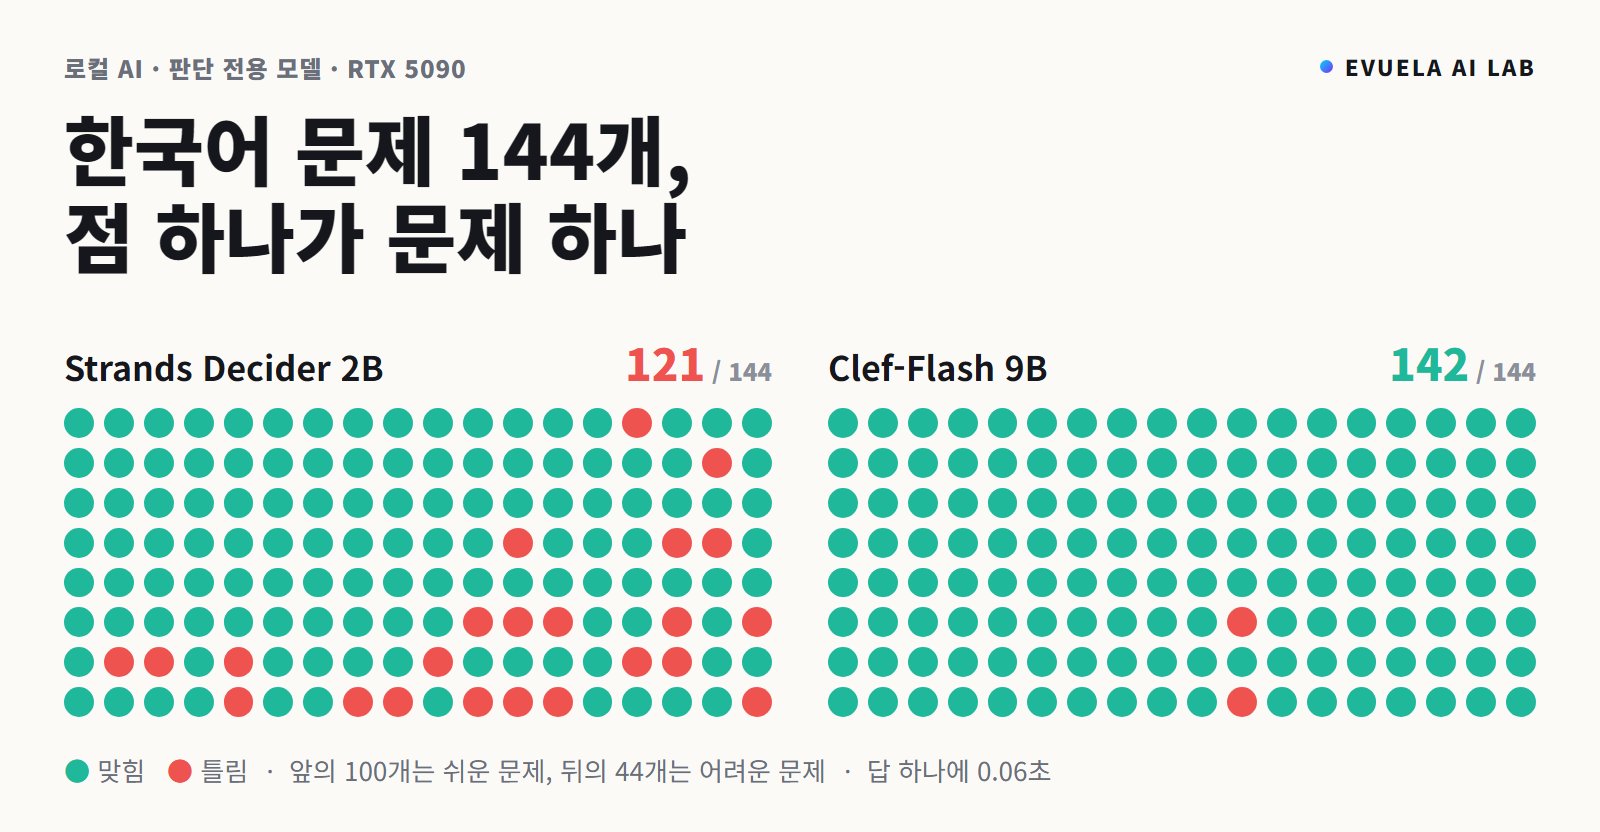
글을 쓰지 않고 보기 가운데 답을 확률로 고르는 판단 전용 모델 Strands Decider 2B와 Clef-Flash 9B를 RTX 5090에서 한국어 144문제로 비교했습니다. 쉬운 문제는 95개와 100개, 어려운 문제는 26개와 42개를 맞혔고 답 하나에 0.05~0.07초였습니다.
Gemma 4 12B QAT를 RTX 5090 32GB와 RTX 5060 Ti 16GB에서 Unsloth Studio 기본값으로 올렸습니다. 32GB는 MTP가 켜져 초당 233토큰, 16GB는 MTP가 꺼져 52토큰이었습니다. 16GB는 컨텍스트만 지정해도 94토큰이 됩니다.
영상 생성 모델 LTX-2.5를 RTX 5090에서 ComfyUI로 돌렸습니다. 소리가 든 5초 영상(1280×704)이 약 20초, 풀HD는 50.5초, VRAM은 31.2GB였습니다. 한국어 대사와 한국에서 써도 되는 라이선스도 정리했습니다.