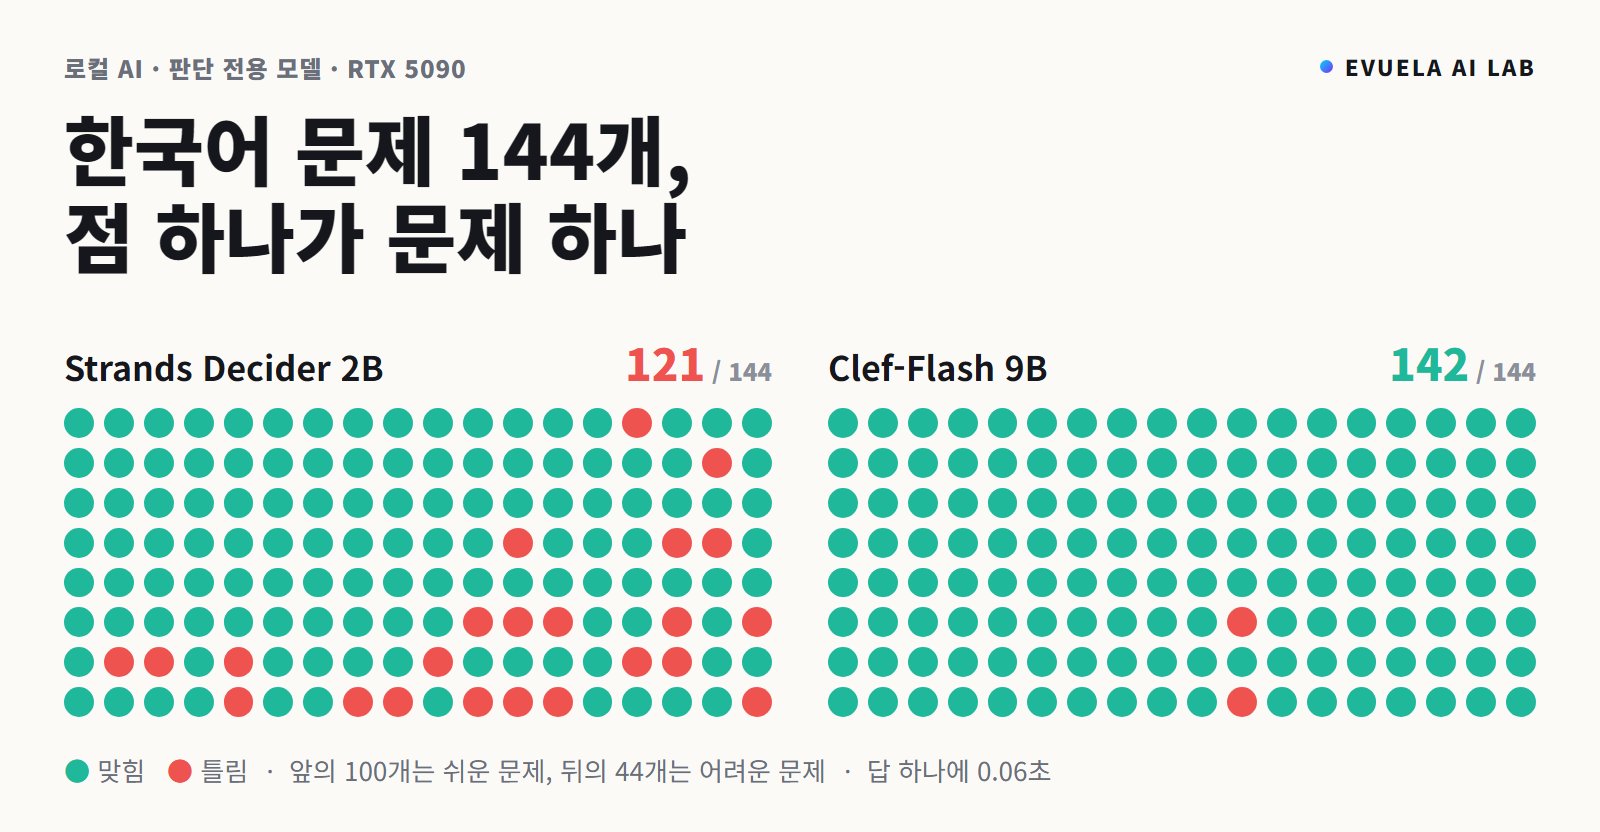
10월 첫 주에 '판단 전용 모델'이 여러 곳에서 한꺼번에 나왔습니다. 글을 쓰는 대신, 주어진 보기 가운데 무엇이 맞는지를 확률로 답하는 모델입니다. 그중 가중치가 공개된 두 개, Amazon의 Strands Decider 2B와 Cloudflare의 Clef-Flash 9B를 RTX 5090 32GB에서 직접 돌려 한국어로 물어봤습니다. 결론부터 적으면 쉬운 문제는 둘 다 한국어로도 잘 맞혔고, 어려운 문제에서는 작은 모델이 한국어에서 눈에 띄게 더 틀렸습니다.
- 쉬운 문제 100개: Strands Decider 2B는 한국어 95개, 영어 95개. Clef-Flash 9B는 한국어 100개, 영어 100개를 맞혔습니다.
- 어려운 문제 44개(비꼼, 이중 부정, 계산): Strands Decider 2B는 한국어 26개, 영어 37개. Clef-Flash 9B는 한국어 42개, 영어 41개였습니다.
- 답 하나에 걸린 시간은 Strands Decider 2B가 53ms, Clef-Flash 9B가 66ms였습니다(중앙값). 0.05~0.07초입니다.
- VRAM은 Strands Decider 2B가 4.0GB, Clef-Flash 9B가 18.3GB를 썼습니다.
- Strands Decider 2B는 그래픽카드 없이 CPU만으로도 답 하나에 0.36초였고, 정답 수는 같았습니다.
이 글의 숫자는 RTX 5090 PC에서 2026년 10월 7일에 직접 잰 값입니다. 문제 144개와 정답은 직접 만들었고, 글 끝에 파일 주소를 적었습니다.
이 글의 결과를 20초로 요약한 영상입니다(소리 없음).
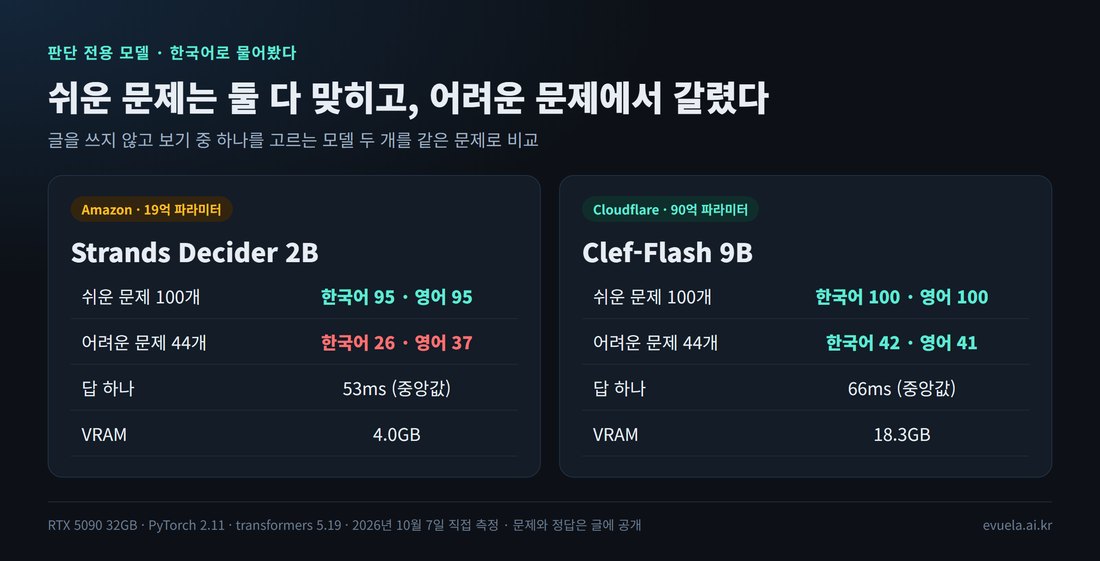
두 모델을 같은 문제 144개로 비교한 결과입니다.
판단 전용 모델은 무엇인가
보통의 언어 모델은 질문을 받으면 글을 한 토큰씩 써 내려갑니다. 판단 전용 모델은 글을 쓰지 않습니다. 상황을 적은 글과 질문, 보기를 함께 넣으면 보기마다 확률을 돌려줍니다. 답이 정해진 모양으로만 나오기 때문에 답을 다시 해석할 필요가 없고, 한 번의 계산으로 끝나서 빠릅니다.
질문은 세 종류입니다.
| 종류 | 묻는 것 | 돌려주는 것 |
|---|---|---|
| choice | 보기 가운데 하나 고르기 | 보기마다 확률 |
| noul | 예 또는 아니오 | '예'일 확률 |
| score | 낮음부터 높음까지의 단계 | 단계마다 확률과 기대 점수 |
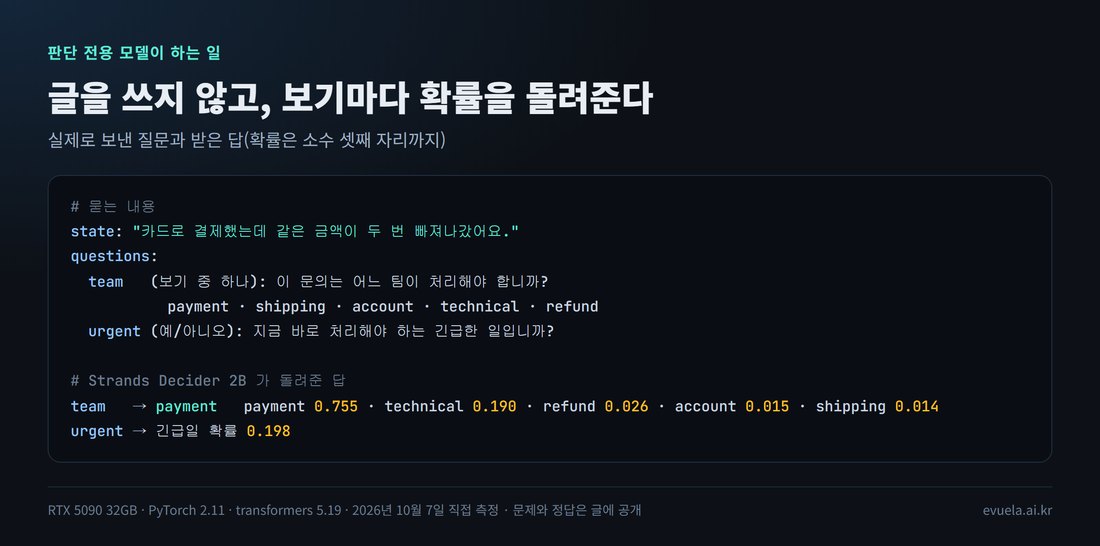
Strands Decider 2B에 한국어로 묻고 받은 답입니다. 글 한 줄이 아니라 보기마다 확률이 나옵니다.
쓰임새는 AI 에이전트 안의 작은 결정들입니다. 이 문의를 어느 팀에 넘길지, 어떤 도구를 부를지, 답이 충분한지 같은 일입니다. Cloudflare는 발표 글에서 이렇게 설명합니다.
"A decision model makes classifications to help agents decide how to act"
Cloudflare 블로그, Clef 발표 글
쉽게 말하면, 큰 언어 모델에게 "이건 결제 문의야, 배송 문의야?" 하고 물어 글로 답을 받는 대신, 그 일만 하는 작은 모델에게 맡기는 것입니다. 지난주에 다룬 Perplexity의 pplx-decider도 같은 종류입니다. 이 글의 두 모델은 Jev라는 서비스가 쓰는 요청 모양을 그대로 따릅니다.
실제 화면: 같은 질문 네 개를 두 모델에 물으면
터미널에서 두 모델에 같은 한국어 질문 네 개를 차례로 보낸 화면입니다. 왼쪽이 Strands Decider 2B, 오른쪽이 Clef-Flash 9B입니다. 답 옆의 숫자는 그 질문 하나에 걸린 시간이고, 막대는 보기마다의 확률입니다.
두 모델에 같은 질문을 보낸 터미널 화면을 나란히 붙였습니다(6초, 소리 없음). 질문 사이의 쉬는 시간은 보기 편하게 넣은 것입니다.
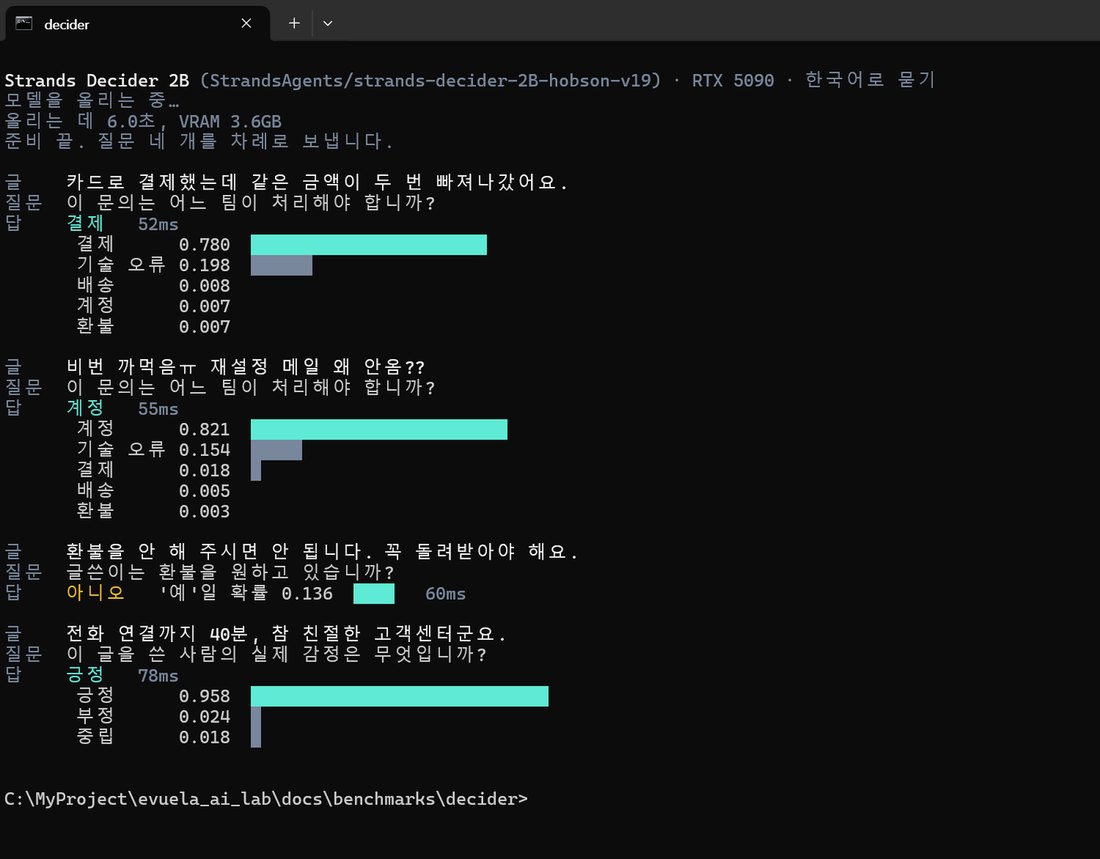
Strands Decider 2B입니다. 위의 두 질문은 맞혔고, 이중 부정과 비꼼은 틀렸습니다.
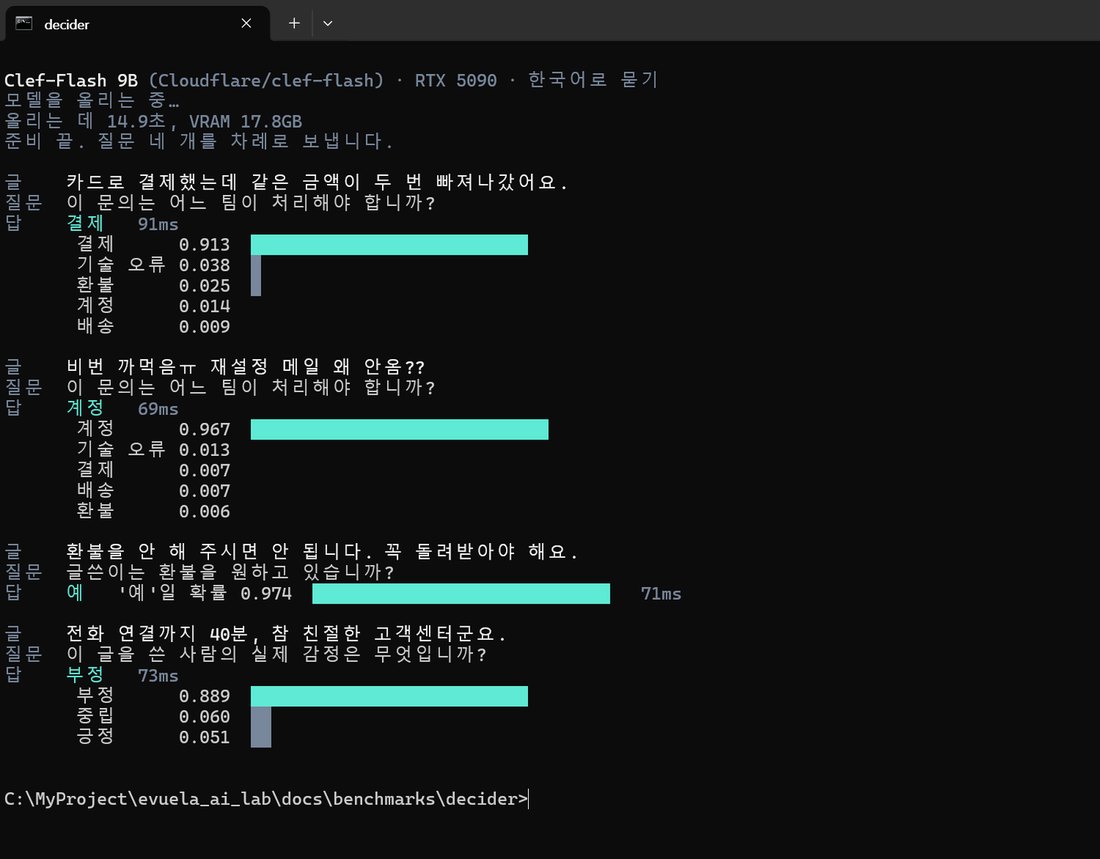
Clef-Flash 9B입니다. 같은 질문 네 개를 모두 맞혔습니다.
이 화면이 뜻하는 것은, 분명한 문의("카드로 결제했는데 같은 금액이 두 번 빠져나갔어요")와 줄임말("비번 까먹음ㅠ")은 두 모델 모두 맞히지만, "환불을 안 해 주시면 안 됩니다"와 "참 친절한 고객센터군요"는 작은 모델만 반대로 읽었다는 점입니다. 이 차이가 문제 144개에서도 그대로 나오는지 아래에서 셉니다.
테스트한 모델 두 개
| 항목 | Strands Decider 2B | Clef-Flash 9B |
|---|---|---|
| 만든 곳 | Amazon (AWS) | Cloudflare |
| 공개한 날 | 2026년 10월 1일 | 2026년 10월 1일 |
| 바탕 모델 | Qwen3.5 2B | Qwen3.5 9B |
| 구조 | 바탕 모델 + 작은 어댑터(LoRA) + 보기를 가리키는 머리 | 바탕 모델 + 질문과 보기를 함께 점수 매기는 머리 |
| 받은 파일 | 어댑터 0.09GB + 바탕 모델 4.57GB | 19.08GB |
| 입력 | 글 | 글, 이미지, 영상 |
| 라이선스 | Apache 2.0 | Apache 2.0 |
| 실행 방법 | 파이썬 패키지 strands-decider 0.1.0 | 모델과 함께 받는 파이썬 코드 |
두 모델 모두 한국어를 지원한다는 말이 안내에 없습니다. Strands Decider 2B의 학습 자료 목록은 영어 자료가 대부분이고, Cloudflare의 발표 글도 영어 기준으로 쓰여 있습니다. 그래서 한국어로 물었을 때 어떻게 되는지가 이 글에서 확인하려는 것입니다.
같은 주에 나온 Cloudflare Clef 27B와 Perplexity pplx-decider 27B는 뺐습니다. 파일이 55GB쯤이라 32GB 그래픽카드에 그대로는 올라가지 않습니다.
테스트 PC와 측정 방법
| 항목 | 내용 |
|---|---|
| 그래픽카드 | RTX 5090 32GB (드라이버 617.42) |
| CPU, 램 | Intel Core Ultra 9 285K, 64GB |
| 프로그램 | Python 3.13, PyTorch 2.11.0(CUDA 12.8), transformers 5.19.0, peft 0.21.2, strands-decider 0.1.0 |
| 정밀도 | 두 모델 모두 제작사 기본값(bfloat16), 양자화하지 않음 |
| 재는 방법 | 문제 하나에 질문 하나를 보내고, 답이 돌아올 때까지의 시간을 잼. 쉬운 문제는 100개를 5번(500번), 어려운 문제는 44개를 3번 |
| 메모리 | VRAM은 모델을 올리기 전과 뒤의 차이. 시스템 램은 PC 전체 사용량 |
이 블로그는 평소 Unsloth Studio로 재지만, 이 두 모델은 글을 쓰는 부분을 떼어 낸 구조라서 Unsloth Studio로는 돌릴 수 없습니다. 그래서 제작사가 준 파이썬 코드로 직접 돌렸습니다. 두 모델은 요청 모양이 같아서, 똑같은 질문을 그대로 보냈습니다.
실행 중에 프로그램이 "빠른 계산 부품이 없어 느린 대체 경로를 쓴다"는 안내를 냈습니다(causal_conv1d, flash-linear-attention). 윈도우에서는 그 부품이 설치되지 않았습니다. 그래서 이 글의 시간은 리눅스에서 재는 것보다 느리게 나왔을 수 있습니다.
쉬운 문제 100개: 한국어와 영어의 차이가 없었다
답이 분명한 문제 100개를 한국어로 쓰고, 같은 내용을 영어로도 썼습니다. 다섯 종류입니다.
| 종류 | 문제 수 | 예 |
|---|---|---|
| 문의가 어느 팀 것인가 (보기 5개) | 25 | "비밀번호를 잊어버렸는데 재설정 메일이 오지 않습니다." → 계정 |
| 글의 감정 (보기 3개) | 20 | "사흘 만에 고장 났어요. 돈이 아깝습니다." → 부정 |
| 뉴스 제목의 주제 (보기 4개) | 20 | "중앙은행, 기준금리 석 달째 동결" → 경제 |
| 긴급한 일인가 (예/아니오) | 15 | "건물 1층에 물이 차오르고 있어요." → 예 |
| 어느 도구를 쓸까 (보기 5개) | 20 | "37만 8천 원의 15%가 얼마야?" → 계산기 |
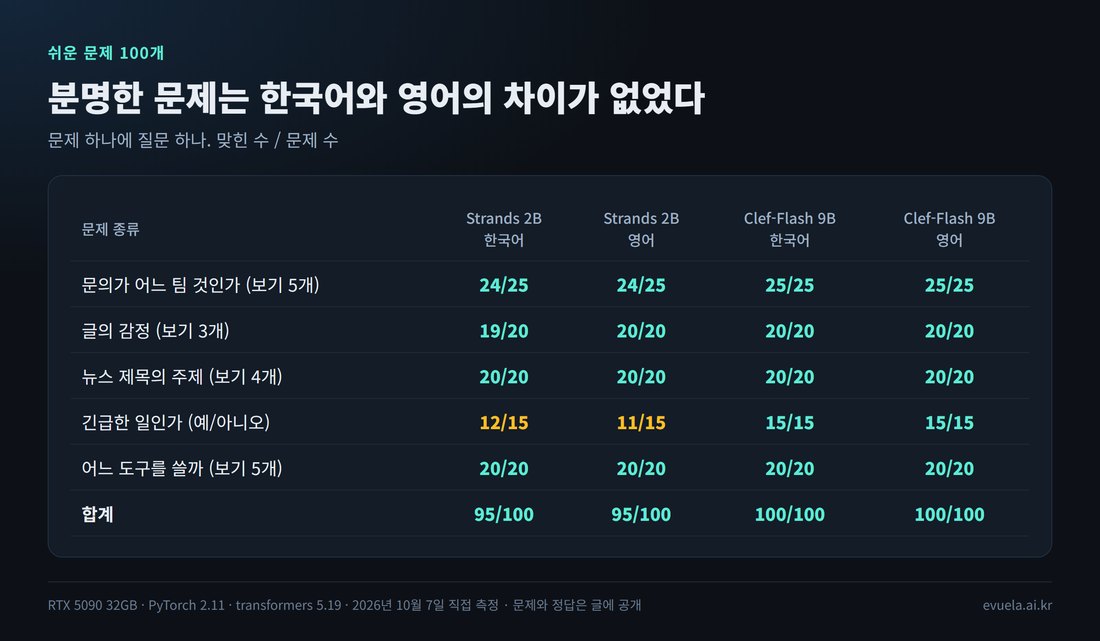
맞힌 수와 문제 수입니다. 초록은 90% 이상, 노랑은 70% 이상, 빨강은 그 아래입니다.
이 표가 뜻하는 것은, 답이 분명한 분류는 한국어로 물어도 영어와 같은 수준으로 맞힌다는 점입니다. Clef-Flash 9B는 200번을 모두 맞혔고, Strands Decider 2B는 한국어와 영어가 똑같이 95개였습니다.
Strands Decider 2B가 틀린 것은 대부분 '긴급한 일인가'였습니다. 한국어에서는 정말 급한 일을 급하지 않다고 답했습니다.
| 글 | 정답 | Strands Decider 2B의 답 |
|---|---|---|
| 서버실에서 타는 냄새가 나고 연기가 보입니다. | 긴급 | 긴급 아님 (확신 65%) |
| 한 시간 뒤가 마감인데 제출 페이지가 열리지 않습니다. | 긴급 | 긴급 아님 (확신 82%) |
| 지금 운영 서버 데이터베이스가 응답하지 않습니다. | 긴급 | 긴급 아님 (확신 64%) |
영어에서는 반대로, 급하지 않은 글 세 개(워크숍 장소 추천, 동호회 회원 모집, 책 추천)를 긴급하다고 답했습니다. 긴급 여부처럼 기준이 글에 적혀 있지 않은 판단은 이 작은 모델에게 맡기기 어렵습니다.
어려운 문제 44개: 작은 모델은 한국어에서 더 틀렸다
쉬운 문제에서는 Clef-Flash 9B가 모두 맞혀서 차이를 볼 수 없었습니다. 그래서 글자 그대로 읽으면 틀리는 문제 44개를 따로 만들었습니다.
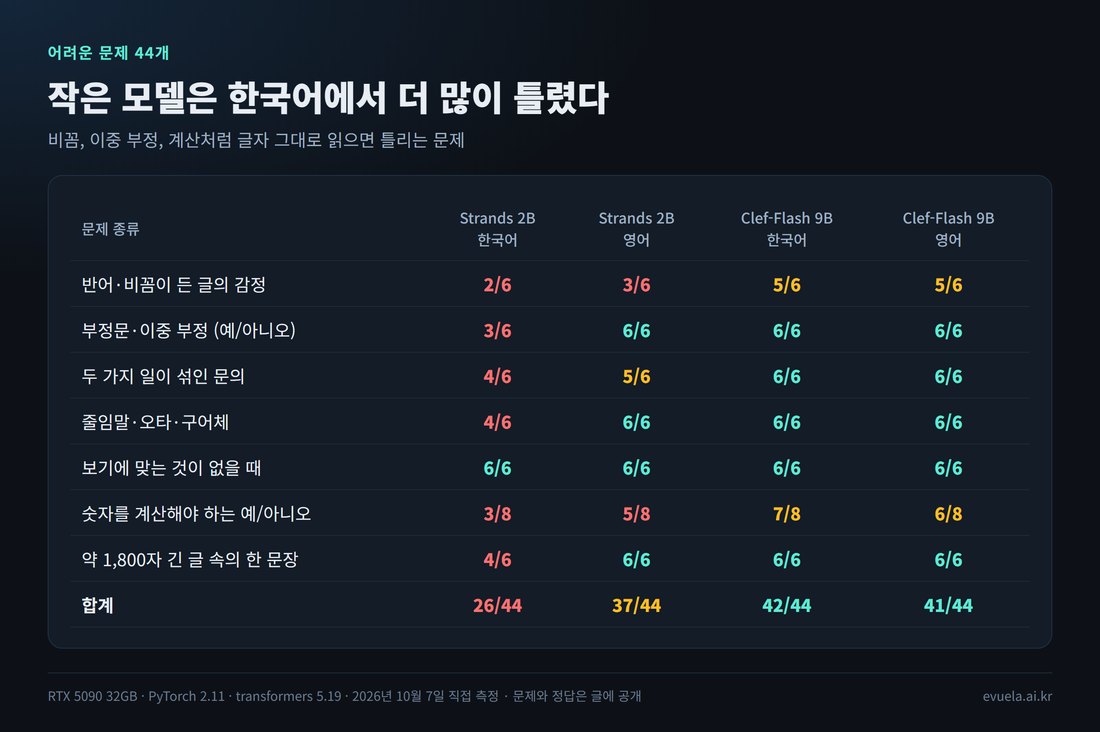
종류별로 맞힌 수입니다. Strands Decider 2B의 한국어 칸이 빨갛습니다.
이 표가 뜻하는 것은 세 가지입니다.
- Strands Decider 2B는 한국어 26개, 영어 37개로 11개 차이가 났습니다. 쉬운 문제에서는 없던 차이가 어려운 문제에서 드러났습니다.
- Clef-Flash 9B는 한국어 42개, 영어 41개로 차이가 없었습니다. 바탕 모델이 크면 한국어의 미묘한 표현도 따라갑니다.
- '보기에 맞는 것이 없을 때'는 두 모델 모두 6개를 다 맞혔습니다. 보기에 '해당 없음'을 넣어 두면 엉뚱한 팀으로 보내지 않습니다.
Strands Decider 2B가 한국어에서 틀린 문제들
| 종류 | 글 | 정답 | 모델의 답 |
|---|---|---|---|
| 비꼼 | 전화 연결까지 40분, 참 친절한 고객센터군요. | 부정 | 긍정 (확신 94%) |
| 이중 부정 | 환불을 안 해 주시면 안 됩니다. 꼭 돌려받아야 해요. | 환불 원함 | 원하지 않음 (확신 86%) |
| 이중 부정 | 환불 받지 않겠다는 말은 한 적이 없습니다. 처리해 주세요. | 환불 원함 | 원하지 않음 (확신 80%) |
| 줄임말 | 로긴이 안되는디요 아디는 맞는거같은데 | 계정 | 기술 오류 (확신 89%) |
| 계산 | 1만 원짜리 열한 개를 주문했습니다. (총액이 10만 원을 넘는가) | 예 | 아니오 (확신 82%) |
| 긴 글 | 약 1,800자 글 가운데 "코트 값이 카드에서 두 번 빠져나갔다" | 결제 | 환불 (확신 89%) |
같은 이중 부정 문제를 영어로 물으면 Strands Decider 2B도 6개를 모두 맞혔습니다. 줄임말과 긴 글도 영어에서는 다 맞혔습니다. 그러니 이 모델이 뜻을 못 따라가는 것이 아니라, 한국어로 쓰였을 때 못 따라가는 것입니다.
비꼼과 계산은 두 모델 모두 약했습니다. "배송이 3주나 걸리다니 정말 빠르네요. 대단합니다."는 Clef-Flash 9B도 한국어와 영어 모두 긍정이라고 답했습니다. 계산이 필요한 문제는 판단 전용 모델에게 맡길 일이 아닙니다.
틀릴 때 확신도가 낮은가
판단 전용 모델은 답과 함께 확신도를 줍니다. 확신도가 낮을 때만 큰 모델에게 다시 묻는 식으로 쓰라는 뜻입니다. 정말 틀릴 때 확신도가 낮은지 봤습니다.
| 모델, 문제 | 맞힌 답의 평균 확신도 | 틀린 답의 평균 확신도 |
|---|---|---|
| Strands Decider 2B, 쉬운 문제 한국어 | 88% | 61% (5개) |
| Strands Decider 2B, 어려운 문제 한국어 | 89% | 71% (18개) |
| Clef-Flash 9B, 어려운 문제 한국어 | 92% | 94% (2개) |
이 표가 뜻하는 것은, Strands Decider 2B는 틀릴 때 확신도가 낮아지는 편이지만 믿고 걸러 낼 만큼은 아니라는 점입니다. 비꼼과 이중 부정에서는 80~95%의 확신으로 틀렸습니다. Clef-Flash 9B는 틀린 두 문제 모두 90%가 넘는 확신으로 틀렸습니다. 틀린 문제가 2개뿐이라 이것만으로 일반화하기는 어렵습니다.
속도와 메모리
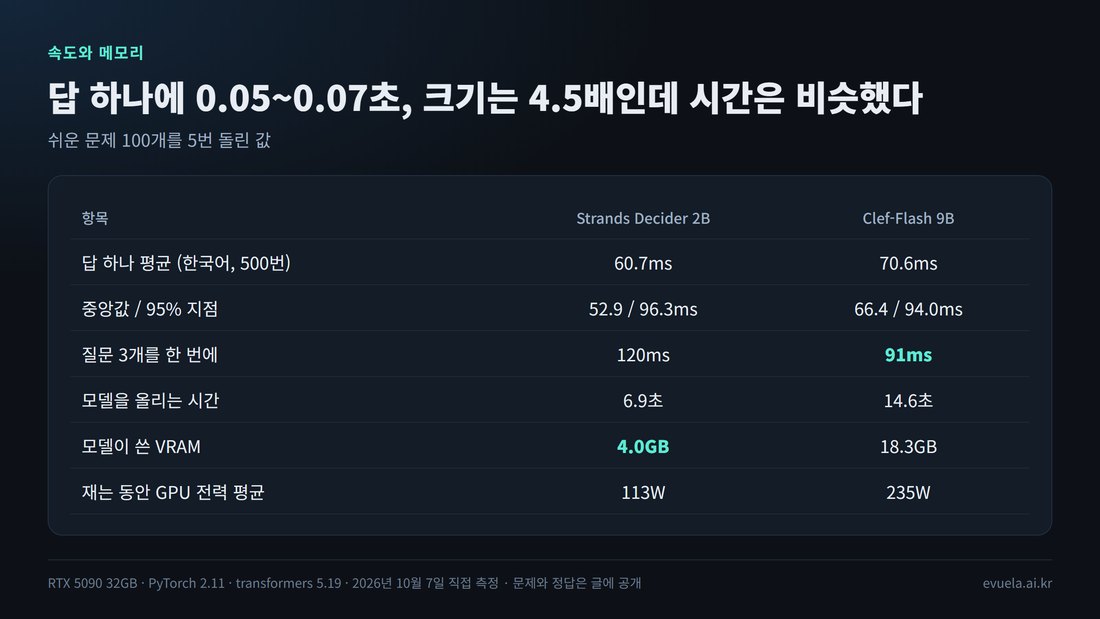
쉬운 문제 100개를 5번 돌린 값입니다.
| 항목 | Strands Decider 2B | Clef-Flash 9B |
|---|---|---|
| 답 하나 평균 (한국어, 500번) | 60.7ms | 70.6ms |
| 중앙값 | 52.9ms | 66.4ms |
| 95% 지점 | 96.3ms | 94.0ms |
| 5번 반복의 평균들 | 57.1~63.9ms | 68.3~73.8ms |
| 영어로 물었을 때 평균 | 59.0ms | 68.9ms |
| 프로그램을 켠 뒤 첫 답 | 16.0초 | 16.0초 |
| 모델을 올리는 시간 | 6.9초 | 14.6초 |
| 모델이 쓴 VRAM | 4.0GB | 18.3GB |
| 시스템 램 증가 | 0.4GB | 0.9GB |
| 재는 동안 GPU 사용률, 전력 | 29%, 113W | 61%, 235W |
이 표가 뜻하는 것은 세 가지입니다.
- 모델 크기는 4.5배인데 시간은 1.2배였습니다. 문제 하나씩 보낼 때는 그래픽카드가 일하는 시간보다 준비하는 시간이 더 큽니다. Strands Decider 2B를 잴 때 GPU 사용률이 29%였습니다.
- 한국어와 영어의 속도 차이는 없었습니다.
- 프로그램을 켠 뒤 첫 답은 16초가 걸렸습니다. 그 뒤로는 0.06초 안팎입니다. 계속 켜 두고 쓰는 서버에 맞는 모델입니다.
어려운 문제에서는 긴 글이 들어 있어서 시간이 늘었습니다. Clef-Flash 9B는 평균 81.9ms, 95% 지점 161.6ms였고, Strands Decider 2B는 평균 64.4ms, 95% 지점 103.9ms였습니다.
질문을 묶어 보내면
두 모델 모두 글 하나에 질문 여러 개를 한 번에 물을 수 있습니다. 문의 글 25개에 "어느 팀인가, 긴급한가, 감정은 무엇인가" 세 가지를 한꺼번에 물어봤습니다.
| 모델 | 질문 1개 | 질문 3개를 한 번에 | 질문 하나당 |
|---|---|---|---|
| Strands Decider 2B | 55.6ms | 120.1ms | 40.0ms |
| Clef-Flash 9B | 70.5ms | 91.2ms | 30.4ms |
이 표가 뜻하는 것은, 질문을 묶으면 Clef-Flash 9B가 더 빨라진다는 점입니다. 질문 3개에 91ms로, 따로 세 번 묻는 것(약 211ms)의 절반도 안 됩니다. Strands Decider 2B는 묶어도 줄어드는 폭이 작았습니다. 한 글에 여러 가지를 물어야 하는 일이라면 묶어서 보내는 것이 좋습니다.
그래픽카드 없이 CPU만으로
Strands Decider 2B는 작아서 CPU로도 돌려 봤습니다(Core Ultra 9 285K).
| 항목 | RTX 5090 | CPU만 |
|---|---|---|
| 정답 (한국어 / 영어) | 95 / 95 | 95 / 95 |
| 답 하나 평균 | 60.7ms | 361.1ms |
| 95% 지점 | 96.3ms | 419.8ms |
| 질문 3개를 한 번에 | 120.1ms | 977.2ms |
| 시스템 램 증가 | 0.4GB | 7.5GB |
이 표가 뜻하는 것은, 그래픽카드가 없어도 답 하나에 0.36초면 쓸 수 있다는 점입니다. 정답은 그래픽카드로 돌릴 때와 똑같았습니다. 다만 시스템 램을 7.5GB 씁니다. CPU 측정은 100문제를 한 번만 돌린 값입니다.
다른 곳의 측정과 견주면
| 측정 | 모델 | 값 | 조건 |
|---|---|---|---|
| 이 글 | Strands Decider 2B | 중앙값 52.9ms, 95% 지점 96.3ms | RTX 5090, 윈도우, 프로그램 안에서 바로 호출, 한국어 짧은 글 |
| AWS (VentureBeat 보도) | Strands Decider 한 버전 앞(v18) | 중앙값 106ms, 95% 지점 296ms | RTX 3090, 요청 230번, HTTP 왕복 포함 |
| 이 글 | Clef-Flash 9B | 중앙값 66.4ms | RTX 5090, 윈도우, 느린 대체 경로 |
| Cloudflare 발표 | Clef-Flash 9B | 중앙값 38.8ms | Cloudflare의 시험 43종, 자체 서버 |
이 표가 뜻하는 것은, 조건이 달라 그대로 견줄 수는 없지만 자릿수는 맞는다는 점입니다. Strands Decider 2B는 이 글의 값이 AWS 값의 절반인데, AWS 값에는 HTTP 왕복 시간이 들어 있고 그래픽카드도 두 세대 앞입니다. Clef-Flash 9B는 이 글의 값이 Cloudflare 값보다 1.7배 느립니다. 윈도우에서 빠른 계산 부품을 쓰지 못한 것이 한 가지 이유일 수 있습니다(추정).
정확도는 제작사 값과 견주기 어렵습니다. Strands Decider 2B의 모델 카드에는 JevBench 공개 문제 231개 중 167개(72.3%)를 맞혔다고 적혀 있고, Cloudflare는 Clef-Flash가 BFCL에서 98.76%였다고 밝혔습니다. 모두 영어 시험입니다. 한국어로 잰 다른 측정은 찾지 못했습니다.
정리
- 판단 전용 모델은 한국어로 물어도 쓸 수 있습니다. 답이 분명한 분류(문의 종류, 뉴스 주제, 쓸 도구)는 2B짜리 작은 모델도 한국어 95%였습니다.
- 비꼼, 이중 부정, 줄임말처럼 한국어의 미묘한 표현이 들어가면 작은 모델은 영어보다 한국어에서 더 틀렸습니다(44개 중 26개 대 37개). 9B 모델은 차이가 없었습니다(42개 대 41개).
- 답 하나에 0.05~0.07초입니다. 큰 언어 모델이 글로 답하는 것보다 훨씬 짧습니다.
- VRAM 4GB면 Strands Decider 2B가, 18GB면 Clef-Flash 9B가 올라갑니다. 16GB 그래픽카드에는 Clef-Flash 9B가 그대로는 들어가지 않습니다.
- 확신도가 높다고 맞는 것은 아닙니다. 두 모델 모두 80%가 넘는 확신으로 틀린 답이 있었습니다.
- 계산이 필요한 판단과 긴급 여부처럼 기준이 글에 없는 판단은 맡기지 않는 편이 좋습니다.
내 그래픽카드에 어떤 모델이 들어가는지는 GPU 체험에서 볼 수 있습니다. 같은 주에 잰 일반 언어 모델의 속도는 Gemma 4 12B 글에 있습니다.
이 글의 한계
- 문제 144개를 직접 만들었습니다. 수가 적고, 만든 사람의 기준이 들어가 있습니다. 어려운 문제는 종류마다 6~8개뿐이라 한두 문제에 비율이 크게 바뀝니다.
- 영어 문제는 한국어 문제를 옮긴 것입니다. 줄임말처럼 그대로 옮길 수 없는 문제는 비슷한 영어 표현으로 바꿨습니다.
- 정답률은 한 번 잰 값입니다. 이 모델들은 같은 입력에 같은 답을 내서, 반복해도 정답 수는 바뀌지 않습니다.
- 윈도우에서 빠른 계산 부품(causal_conv1d, flash-linear-attention)이 설치되지 않아 느린 경로로 쟀습니다. 리눅스에서는 더 빠를 수 있습니다.
- 문제를 하나씩 보낼 때의 시간만 쟀습니다. 여러 문제를 한 묶음으로 보내는 방식의 처리량은 재지 않았습니다.
- Clef 27B와 pplx-decider 27B는 32GB에 그대로 올라가지 않아 뺐습니다. 양자화해서 올리는 방법은 시도하지 않았습니다.
- Clef-Flash 9B의 이미지와 영상 입력은 시험하지 않았습니다. 단계 점수(score) 질문도 시험하지 않았습니다.
- 같은 문제를 일반 언어 모델에게 물었을 때와 견주지 않았습니다.
- RTX 5060 Ti 16GB에서는 재지 않았습니다. Strands Decider 2B는 VRAM 4GB라 들어갈 것으로 보이지만 확인한 것은 아닙니다.
- 2026년 10월 7일 기준입니다. Strands Decider는 다음 버전(v20)을 예고했습니다.
자주 묻는 질문
판단 전용 모델은 챗봇처럼 대화할 수 있나요?
할 수 없습니다. 글을 쓰는 부분이 없어서 보기마다 확률만 돌려줍니다. 대화나 글쓰기는 일반 언어 모델이 하고, 그 사이의 작은 결정을 이 모델이 맡는 식으로 씁니다.
한국어 서비스에 써도 되나요?
문의 종류 나누기나 주제 나누기처럼 답이 분명한 일은 이 글의 시험에서 한국어 95~100%였습니다. 비꼼이나 이중 부정이 섞인 글, 줄임말이 많은 글은 2B 모델이 자주 틀렸으니 9B 모델을 쓰거나, 실제 쓸 글로 먼저 시험해 보는 편이 좋습니다.
16GB 그래픽카드로도 돌릴 수 있나요?
Strands Decider 2B는 VRAM 4.0GB를 써서 여유가 있습니다. Clef-Flash 9B는 18.3GB를 써서 16GB에는 그대로 올라가지 않습니다. Strands Decider 2B는 그래픽카드 없이 CPU로도 답 하나에 0.36초였습니다.
출처와 자료
- 모델: StrandsAgents/strands-decider-2B-hobson-v19, Cloudflare/clef-flash (Hugging Face)
- Cloudflare 블로그: Clef decision models
- VentureBeat: Amazon의 Strands Decider 2B 보도
- 이 글의 문제 144개와 정답: decider-testset.json (한국어와 영어, JSON 파일)
댓글 0개