[RTX 5060 Ti 16GB] Liquid AI의 LFM2.5-24B-A2B를 16GB에서 돌리면, 이 PC에서 잰 모델 중 가장 빠른 초당 209토큰이었다
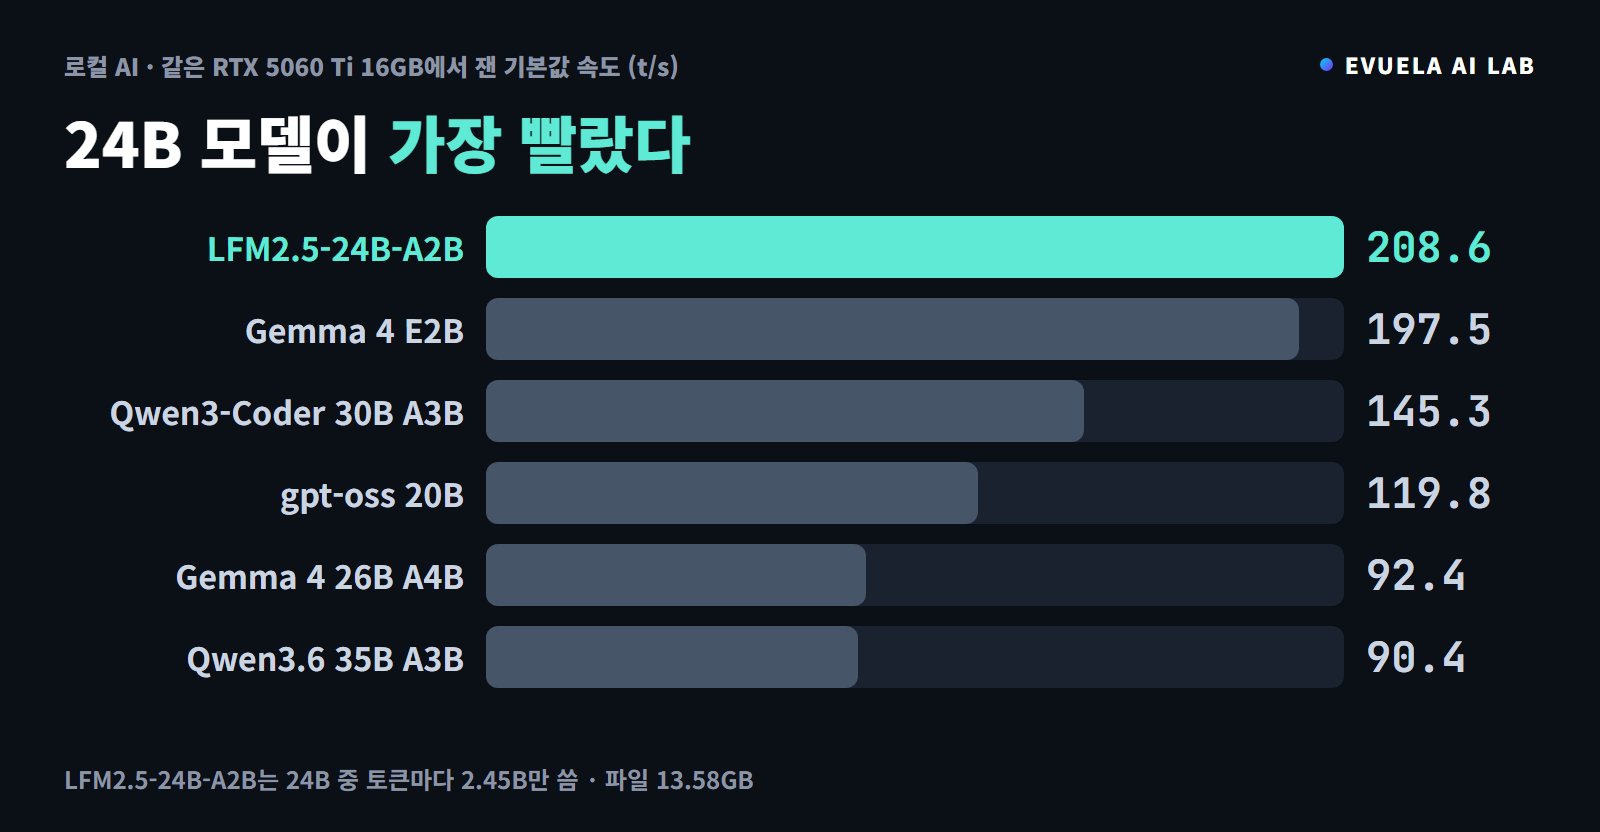
24B 중 토큰마다 2.45B만 쓰는 Liquid AI의 LFM2.5-24B-A2B를 RTX 5060 Ti 16GB의 Unsloth Studio에서 쟀습니다. 기본값 초당 208.6토큰으로 이 PC에서 가장 빨랐고, 100,000자 요약은 20.7초, 생각은 끌 수 없었습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"판단 전용 모델" 검색 결과 6건
24B 중 토큰마다 2.45B만 쓰는 Liquid AI의 LFM2.5-24B-A2B를 RTX 5060 Ti 16GB의 Unsloth Studio에서 쟀습니다. 기본값 초당 208.6토큰으로 이 PC에서 가장 빨랐고, 100,000자 요약은 20.7초, 생각은 끌 수 없었습니다.
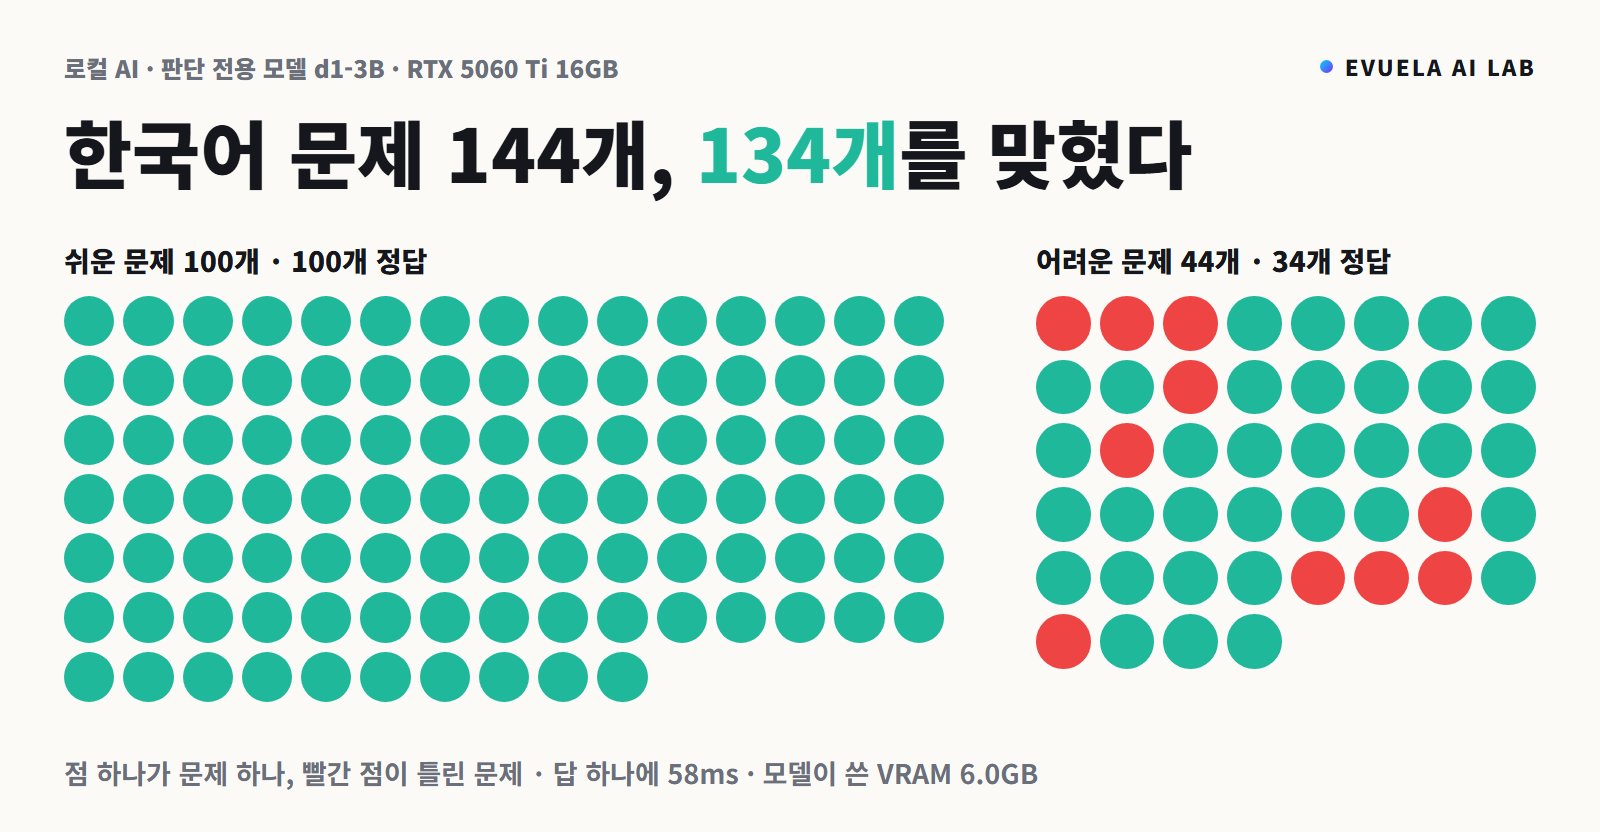
글을 쓰지 않고 보기마다 확률로 답하는 Liquid AI의 판단 전용 모델 d1-3B를 RTX 5060 Ti 16GB에서 한국어 144문제로 쟀습니다. 쉬운 100문제는 모두, 어려운 44문제는 34개를 맞혔고 답 하나에 0.06초, VRAM 6.0GB였습니다.
대화에 익숙해진 다음에 해 볼 것을 코딩, 도구(MCP), API, 그림, 영상, 음성, 검색으로 정리했습니다. 그림 한 장 7.6초, 5초 영상 약 20초, 50초 음성 약 11초였고, 필요한 VRAM은 음성 3.5GB부터 영상 31.2GB까지 달랐습니다.
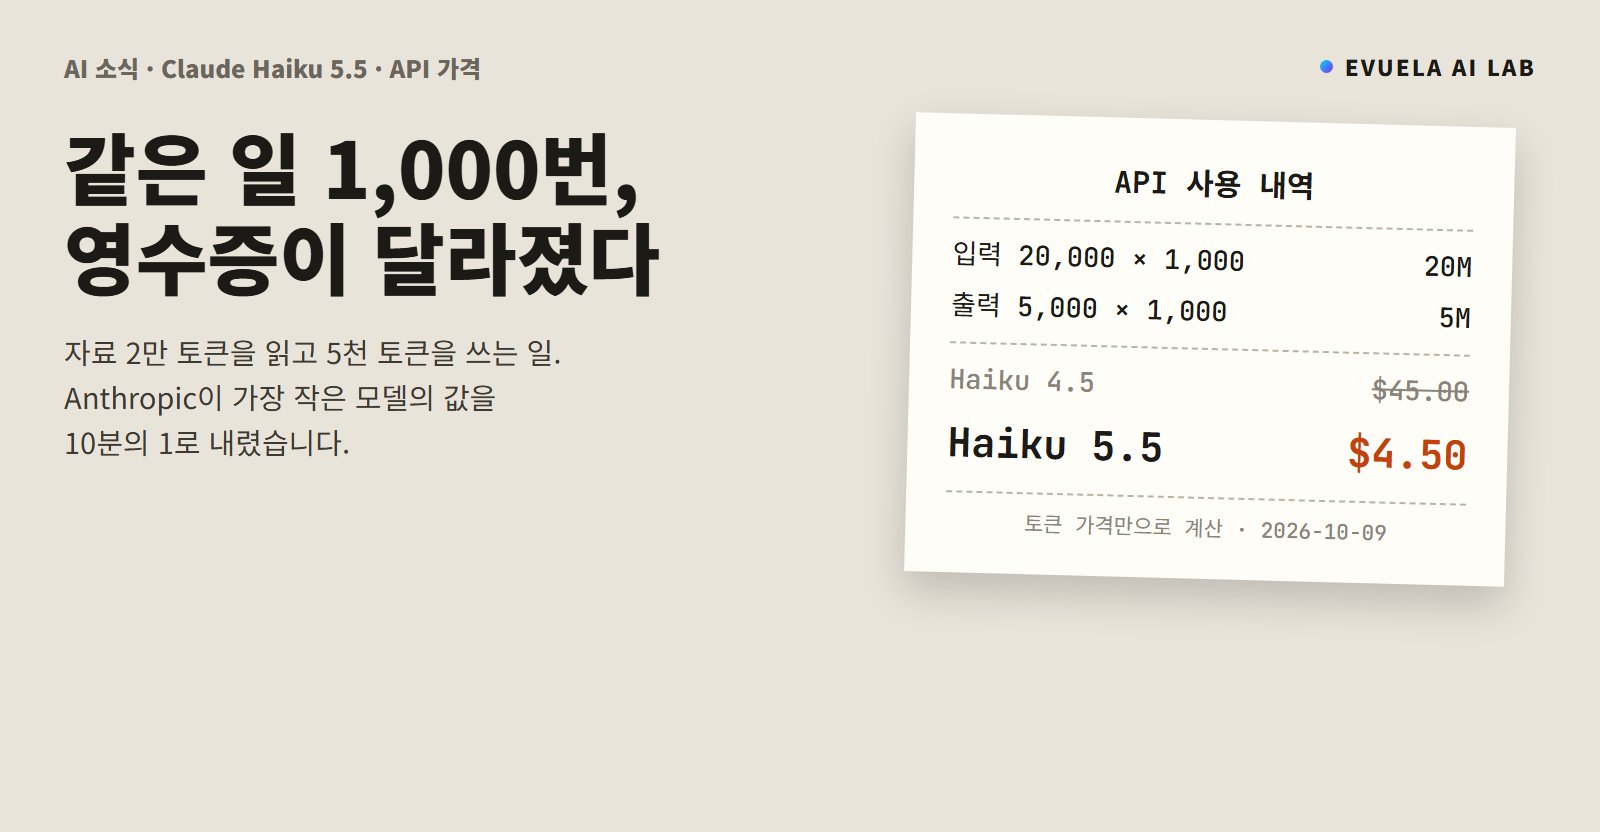
Anthropic이 10월 7일 Claude Haiku 5.5를 냈습니다. 입력 100만 토큰 0.10달러, 출력 0.50달러로 Haiku 4.5의 10분의 1이고 GPT-6 Luna와 같습니다. 프롬프트가 10만 토큰을 넘으면 값이 다섯 배가 되는 규칙과 로컬 AI 전기요금 비교까지 계산했습니다.
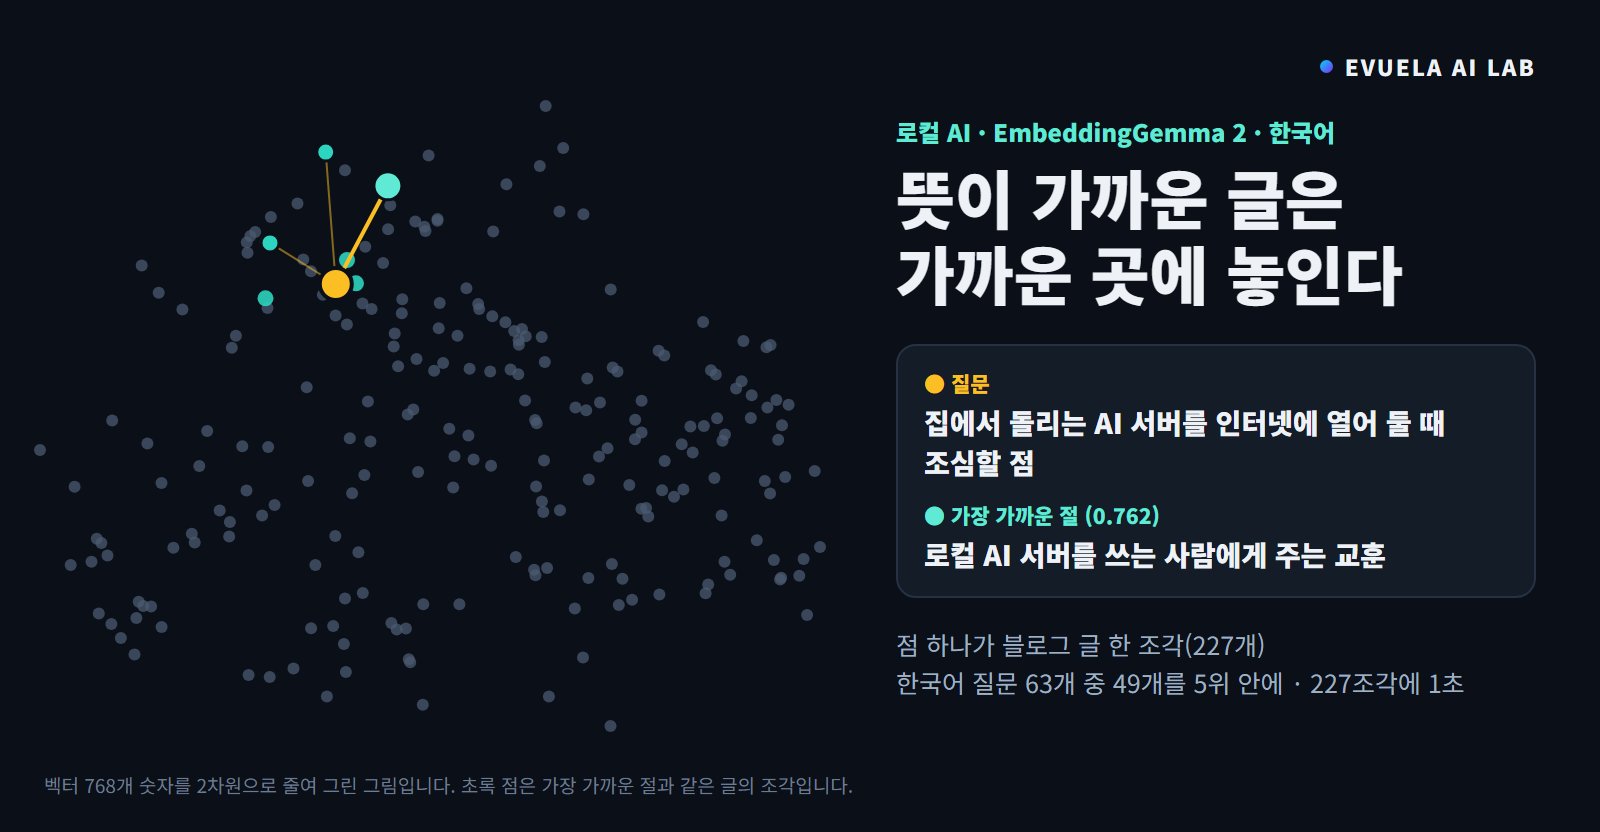
구글 EmbeddingGemma 2로 이 블로그 글 227조각을 한국어 질문 63개로 검색했습니다. 다른 낱말로 바꿔 물은 질문은 17개를 1위로 찾아 낱말 검색(9개)의 약 두 배였고, 영어로 물어도 34개를 찾았습니다. 227조각을 벡터로 바꾸는 데 1.06초, VRAM은 0.5GB였습니다.
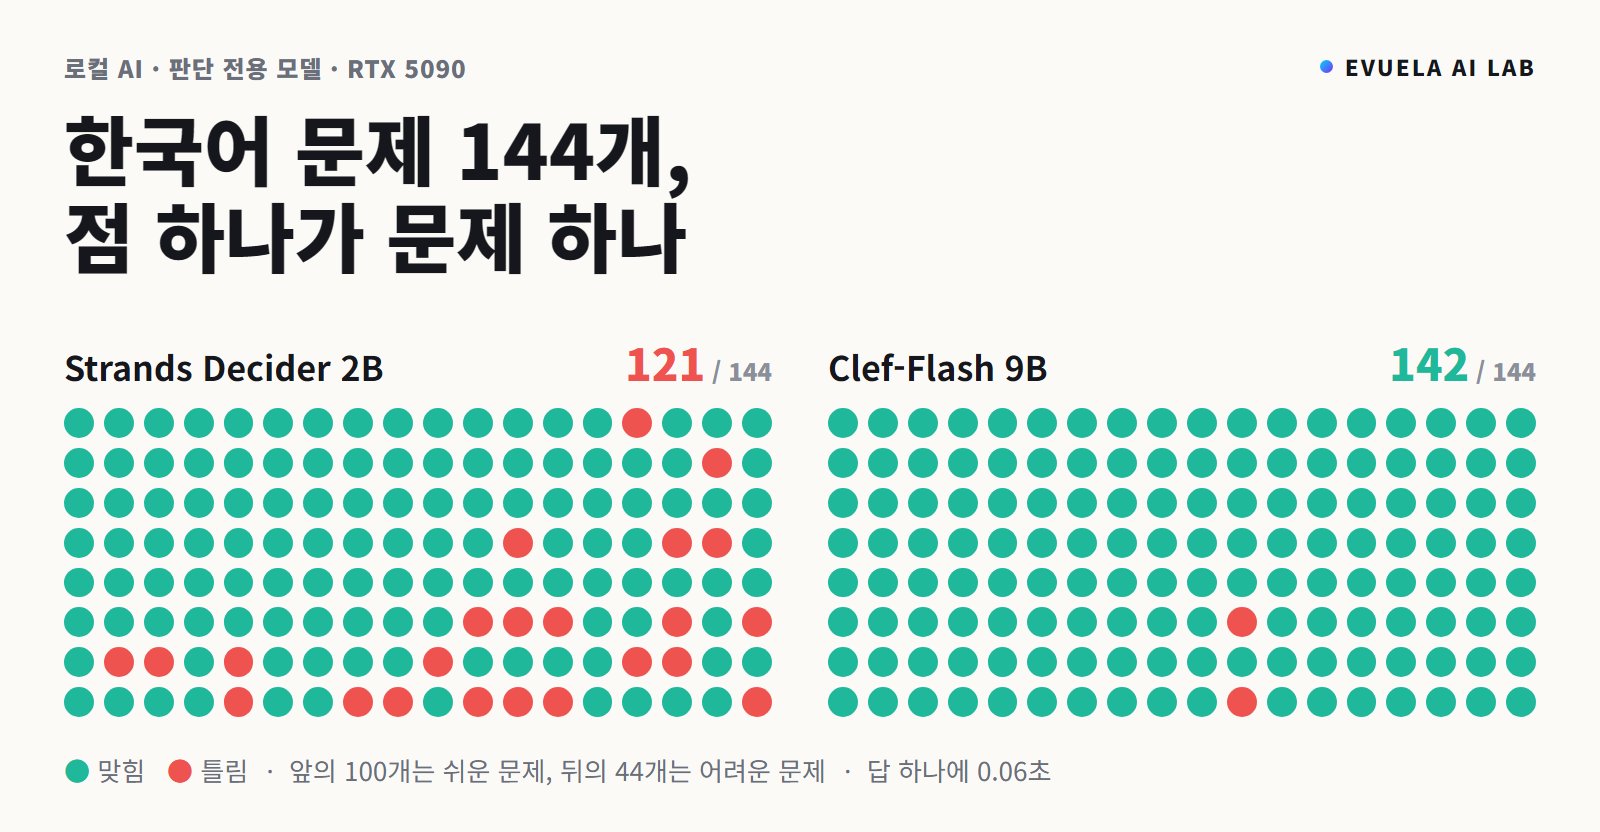
글을 쓰지 않고 보기 가운데 답을 확률로 고르는 판단 전용 모델 Strands Decider 2B와 Clef-Flash 9B를 RTX 5090에서 한국어 144문제로 비교했습니다. 쉬운 문제는 95개와 100개, 어려운 문제는 26개와 42개를 맞혔고 답 하나에 0.05~0.07초였습니다.