로컬 AI로 할 수 있는 일은 대화만이 아닙니다. 이 블로그에서 직접 돌려 보니 그림 한 장은 7.6초, 소리가 든 5초 영상은 약 20초, 50초 길이의 한국어 음성은 약 11초에 만들어졌습니다. 다만 필요한 VRAM이 크게 달랐습니다. 음성은 3.5GB 안쪽이었고 영상은 31.2GB였습니다. 이 글은 로컬 AI 시작하기 가이드의 마지막 7편으로, 대화에 익숙해진 다음에 해 볼 것을 여섯 가지로 정리했습니다.
- 코딩: 코딩용 모델이 16GB에서 초당 약 145토큰이었고, 파이썬 문제 48개 중 40개를 통과했습니다.
- 도구 붙이기: 웹과 파일을 읽게 하자 240번 중 3번이던 정답이 237번이 됐습니다.
- 내 프로그램에서 부르기: Unsloth Studio가 OpenAI 호환 API를 열어 둡니다.
- 그림, 영상, 음성: 모두 내 PC에서 만들 수 있습니다. 그림과 영상은 VRAM이 많이 필요했습니다.
- 검색: 임베딩 모델은 VRAM 0.5GB로 글 227조각을 1.06초에 검색용으로 바꿨습니다.
이 글의 숫자는 모두 이 블로그가 직접 돌려서 잰 값이고, 항목마다 자세한 글을 링크했습니다. 모델마다 사용 조건(라이선스)이 다르다는 점도 함께 적었습니다.
이 글의 내용을 20초로 요약한 영상입니다(소리 없음).
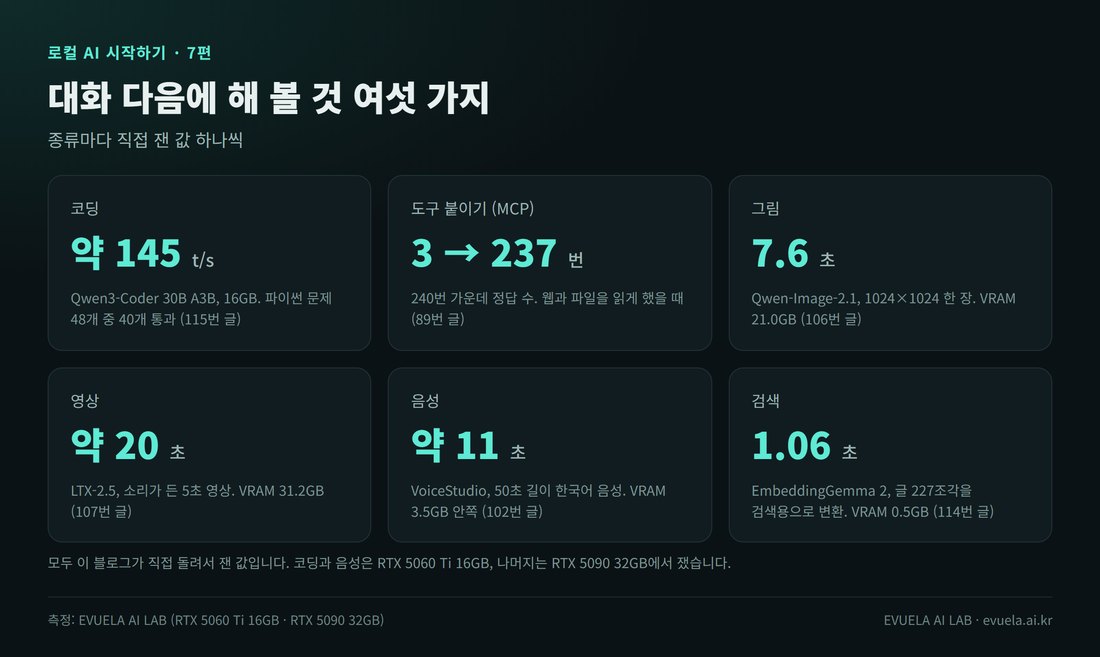
종류마다 직접 잰 값 하나씩입니다.
무엇을 하느냐에 따라 필요한 VRAM이 다르다
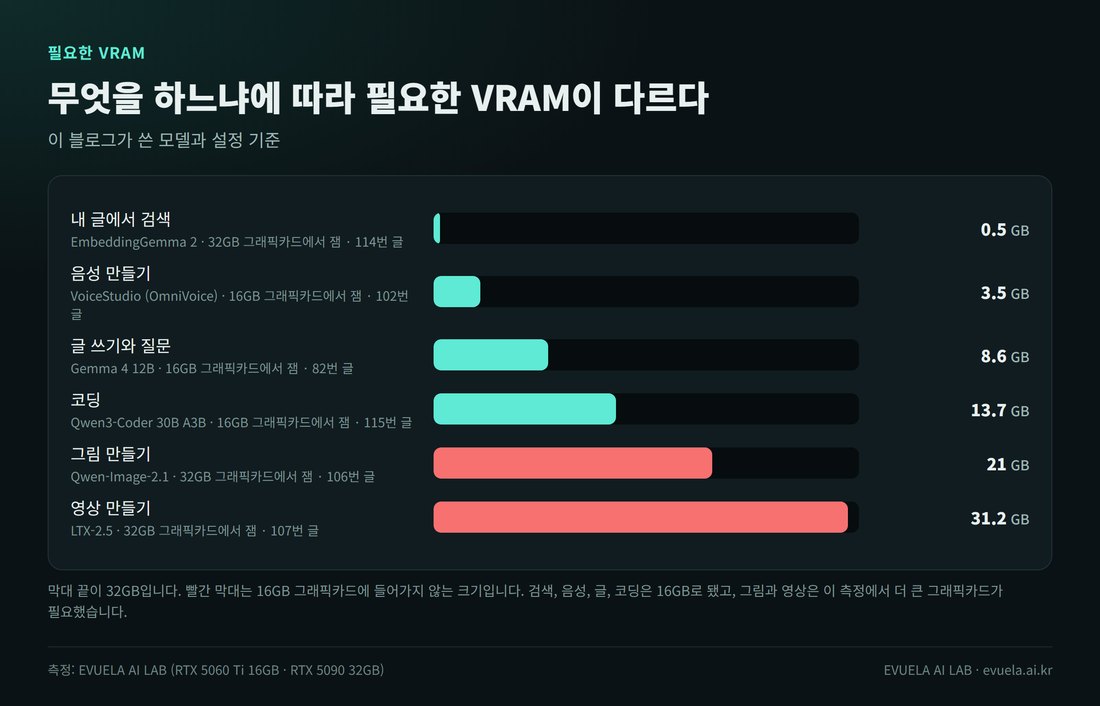
막대 끝이 32GB입니다. 빨간 막대는 16GB에 들어가지 않는 크기입니다.
| 할 일 | 쓴 모델과 프로그램 | VRAM | 잰 그래픽카드 | 글 |
|---|---|---|---|---|
| 내 글에서 검색 | EmbeddingGemma 2 | 0.5GB | 32GB | 114번 |
| 음성 만들기 | VoiceStudio (OmniVoice) | 3.5GB 안쪽 | 16GB | 102번 |
| 글 쓰기와 질문 | Gemma 4 12B, LM Studio | 8.6GB | 16GB | 82번 |
| 코딩 | Qwen3-Coder 30B A3B, Unsloth Studio | 13.7GB | 16GB | 115번 |
| 그림 만들기 | Qwen-Image-2.1, Unsloth Studio | 21.0GB | 32GB | 106번 |
| 영상 만들기 | LTX-2.5, ComfyUI | 31.2GB | 32GB | 107번 |
이 표가 뜻하는 것: 검색, 음성, 글, 코딩은 16GB 그래픽카드로 됐습니다. 그림과 영상은 이 블로그가 쓴 모델과 설정에서 21GB와 31GB를 썼습니다. 더 작은 그림·영상 모델도 있지만 이 블로그에서 직접 재 본 것은 이 둘입니다.
① 코딩에 써 보기
코딩용으로 만든 모델이 따로 있습니다. 이름에 Coder가 붙습니다(3편). RTX 5060 Ti 16GB에서 Qwen3-Coder 30B A3B를 돌려 보니 기본값에서 초당 약 145토큰이었고, 함수 하나를 2~3초에 짰습니다.
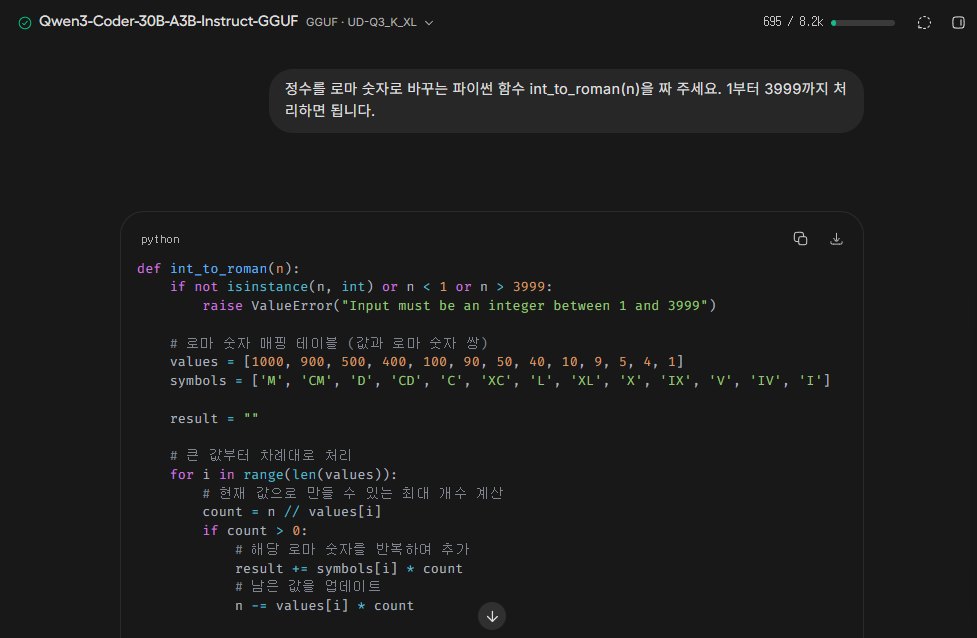
Qwen3-Coder 30B A3B가 파이썬 함수를 짠 화면입니다.
| 모델 (16GB) | 파이썬 문제 | 속도 | 글 |
|---|---|---|---|
| Qwen3-Coder 30B A3B | 48개 중 40개 통과 (8문제를 6번) | 약 145 t/s | 115번 |
| Gemma 4 26B A4B QAT | 24개 중 생각 끔 19개, 켬 21개 (8문제를 3번) | 약 94 t/s | 109번 |
| Qwen3.6 35B A3B | 24개 중 생각 끔 18개, 켬 20개 (8문제를 3번) | 약 90 t/s | 110번 |
이 표가 뜻하는 것: 짧은 함수를 빨리 짜는 데는 코딩용 모델이 가장 빨랐습니다. 대신 이 모델은 생각 기능이 없어서 산수를 틀렸고, 컨텍스트를 늘리면 빨리 느려졌습니다. 긴 파일을 넣거나 설명까지 맡길 때는 일반 모델이 맞았습니다. 문제 8개로 본 결과라서 어려운 코딩의 실력을 말해 주지는 않습니다.
② 도구 붙이기: 웹과 파일을 읽게 하기
모델은 학습한 뒤의 일과 내 PC의 파일을 알지 못합니다. MCP는 모델에게 도구를 붙이는 표준 방식입니다. 웹 페이지를 읽는 도구, 지금 시각을 알려 주는 도구, 파일을 읽는 도구를 붙이면 모델이 필요할 때 그 도구를 불러 씁니다.
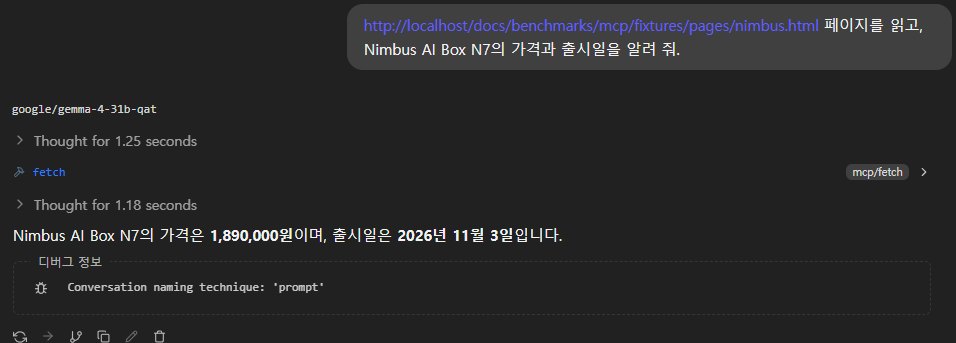
모델이 fetch 도구로 페이지를 읽고 답한 화면입니다. 테스트용으로 만든 가상 제품 페이지입니다.
| 조건 | 최신 정보와 파일 질문의 정답 |
|---|---|
| 도구 없이 | 240번 중 3번 |
| 도구를 주고 | 240번 중 237번 |
이 표가 뜻하는 것: 모델 네 개에 같은 질문 30개를 물은 결과입니다(89번 글). 도구가 없을 때 모델은 실제 있을 법한 문서를 읽은 척하고 틀린 답을 하기도 했습니다. 도구를 붙이면 질문마다 입력이 1,500~2,000토큰 늘어나니 쓰지 않는 도구는 꺼 둡니다.
조심할 점이 있습니다. MCP 서버는 내 PC에서 코드를 실행할 수 있습니다. 믿을 수 있는 서버만 쓰고, 파일 도구에는 꼭 필요한 폴더 하나만 열어 둡니다. 89번 글의 테스트는 LM Studio에서 했습니다.
③ 내 프로그램에서 부르기: API
Unsloth Studio는 채팅 화면 말고도 OpenAI 호환 API를 열어 둡니다. 주소는 http://127.0.0.1:8888/v1이고, 프로그램에서 만든 API 키가 있어야 합니다. OpenAI의 API를 쓰도록 만든 프로그램이나 코드에서 주소와 키만 바꾸면 내 PC의 모델을 부를 수 있습니다.
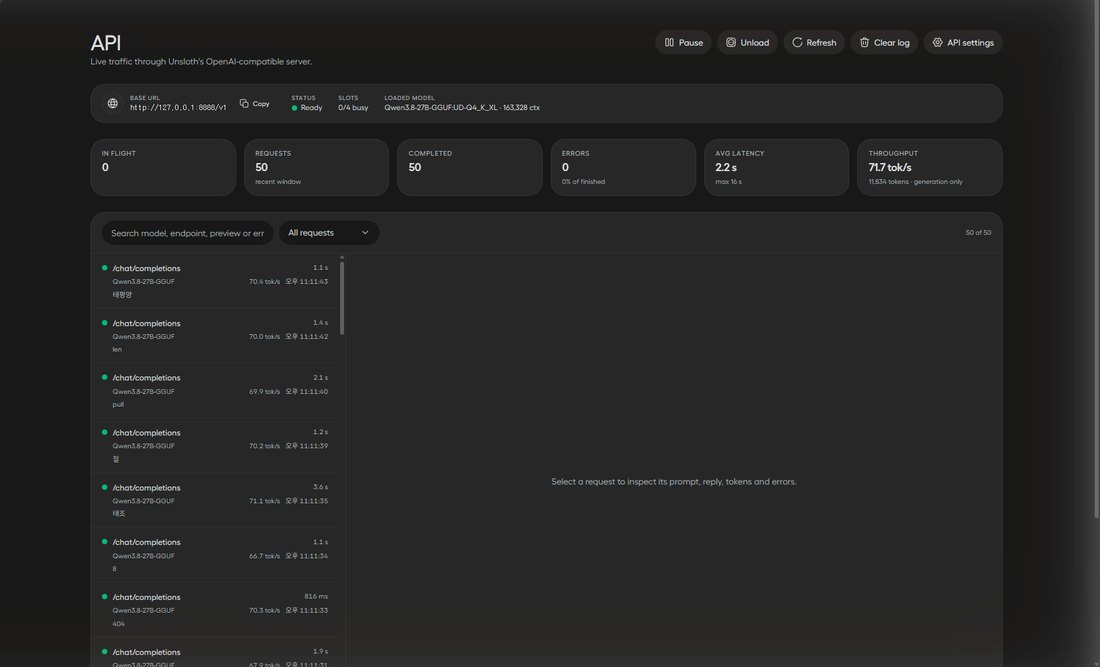
더 보기 → API 화면입니다. 들어온 요청, 걸린 시간, 속도가 기록됩니다.
이 블로그의 속도 측정도 모두 이 API로 합니다. 같은 질문을 여러 번 보내고 시간을 재는 일은 화면보다 API가 편하기 때문입니다. 코딩 도우미 프로그램에 로컬 모델을 붙일 때도 이 주소를 씁니다(92번 글).
④ 그림 만들기
Unsloth Studio의 왼쪽 메뉴에 이미지가 있습니다. 이미지 모델을 받아서 글로 설명하면 그림을 만듭니다. RTX 5090에서 Qwen-Image-2.1로 1024×1024 그림 한 장이 7.6초였습니다.
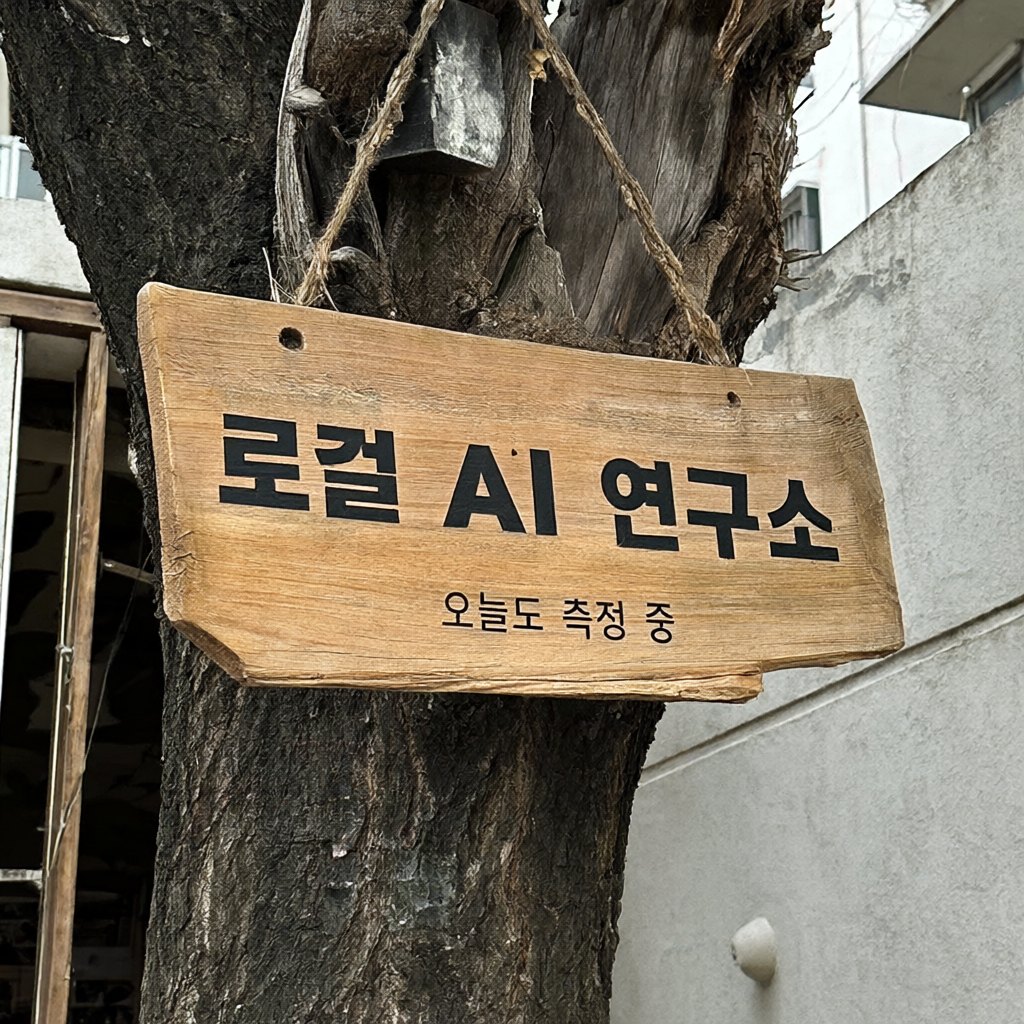
Qwen-Image-2.1이 만든 그림입니다. 한글 글자를 정확히 그렸습니다.
| 항목 | 값 |
|---|---|
| 1024×1024 한 장 | 7.6초 (Unsloth Studio 판이 올라간 뒤 다시 재니 4.2초) |
| VRAM | 21.0GB |
| 받은 파일 | 17.2GB |
| 사용 조건 | 연구·평가용 라이선스 |
이 표가 뜻하는 것: 그림은 글 쓰는 모델보다 VRAM을 많이 썼습니다. 사용 조건도 봐야 합니다. 이 모델은 연구와 평가용이라서, 이 블로그의 갤러리에서도 미리보기만 보여 주고 내려받기는 막아 두었습니다. 자세한 것은 106번 글에 있습니다.
⑤ 영상과 음성 만들기
영상
영상은 ComfyUI라는 프로그램에서 LTX-2.5 모델로 만들었습니다. 소리가 든 5초 영상(1280×704)이 약 20초에 나왔고, 한국어 대사도 또렷했습니다.
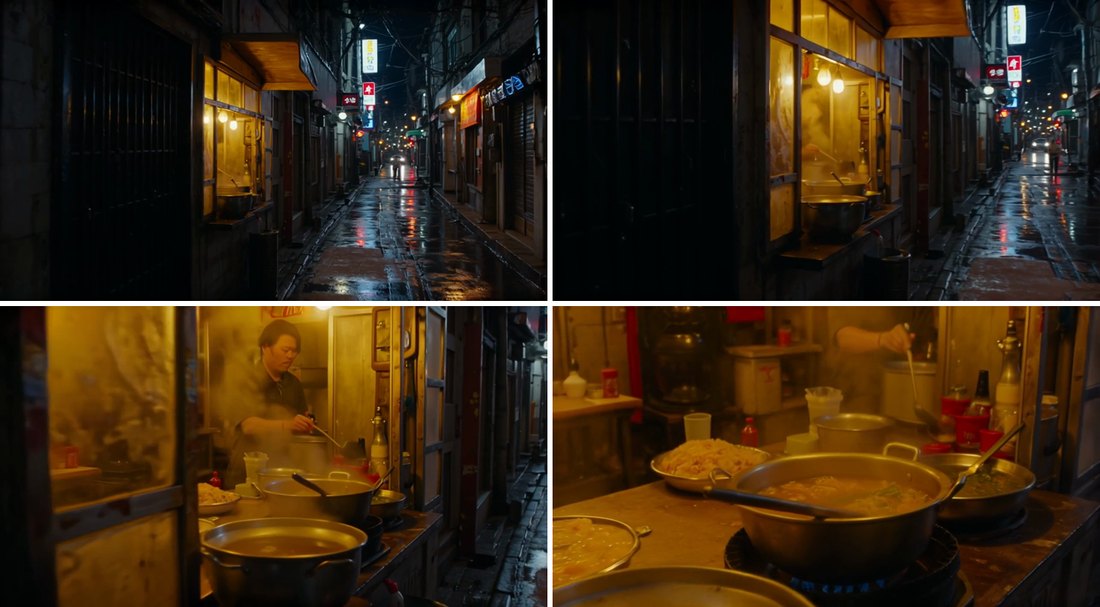
LTX-2.5가 만든 영상의 장면들입니다.
| 항목 | 값 |
|---|---|
| 소리가 든 5초 영상 (1280×704) | 약 20초 |
| 풀HD 5초 영상 | 50.5초 |
| VRAM | 31.2GB |
이 표가 뜻하는 것: 영상은 32GB 그래픽카드의 VRAM을 거의 다 썼습니다. 16GB에서는 이 설정으로 돌려 보지 못했습니다. 만든 영상은 갤러리에 있고, 측정과 사용 조건은 107번 글에 있습니다.
음성
음성은 가장 가볍습니다. RTX 5060 Ti 16GB에서 VoiceStudio의 기본 엔진 OmniVoice가 50초 길이의 한국어 음성을 약 11초에 만들었고, VRAM은 3.5GB 안쪽이었습니다. 더 사람 같았던 VoxCPM2 엔진은 2분 넘게 걸렸습니다(102번 글). 그 글에서 만든 음성을 직접 들어 볼 수 있습니다.
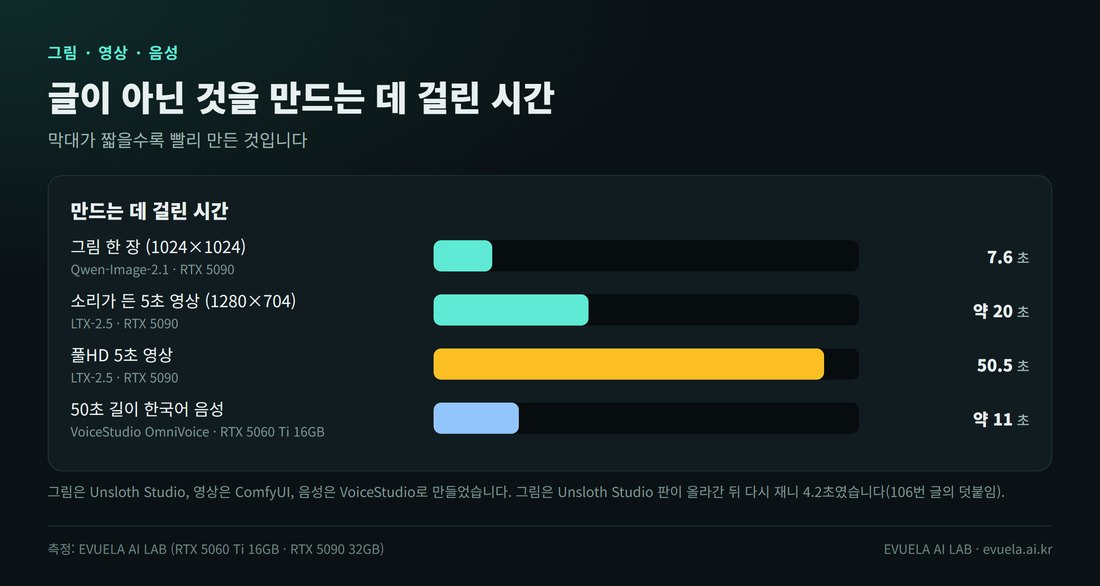
그림과 영상은 RTX 5090, 음성은 RTX 5060 Ti 16GB에서 쟀습니다.
⑥ 내 글에서 검색하기
임베딩 모델은 글을 쓰지 않습니다. 대신 글을 숫자 묶음(벡터)으로 바꿔서, 뜻이 가까운 글끼리 찾을 수 있게 합니다. 낱말이 달라도 뜻이 같으면 찾아 줍니다.
| 질문의 종류 | EmbeddingGemma 2 | 낱말 검색 |
|---|---|---|
| 다른 낱말로 바꿔 물은 질문 (1위로 찾은 수) | 17개 | 9개 |
| 영어로 물은 질문 (찾은 수) | 34개 | 4개 |
| 글과 같은 낱말로 물은 질문 (1위로 찾은 수) | 7개 | 12개 |
이 표가 뜻하는 것: 이 블로그 글 227조각을 한국어와 영어 질문 63개로 검색한 결과입니다(114번 글). 다르게 물은 질문과 영어 질문은 임베딩이 훨씬 잘 찾았고, 글에 있는 낱말 그대로 물은 질문은 낱말 검색이 더 잘 찾았습니다. 227조각을 바꾸는 데 1.06초, VRAM은 0.5GB였습니다. 내 문서를 모델에게 찾아 읽히는 방식(RAG)의 바탕이 이 기술입니다.
글을 쓰지 않는 모델은 하나 더 있습니다. 보기 가운데 답 하나를 확률로 고르는 판단 전용 모델입니다. 분류나 선택 문제에 쓰고, 답 하나에 0.05~0.07초였습니다(113번 글).
어떤 순서로 해 보면 좋은가
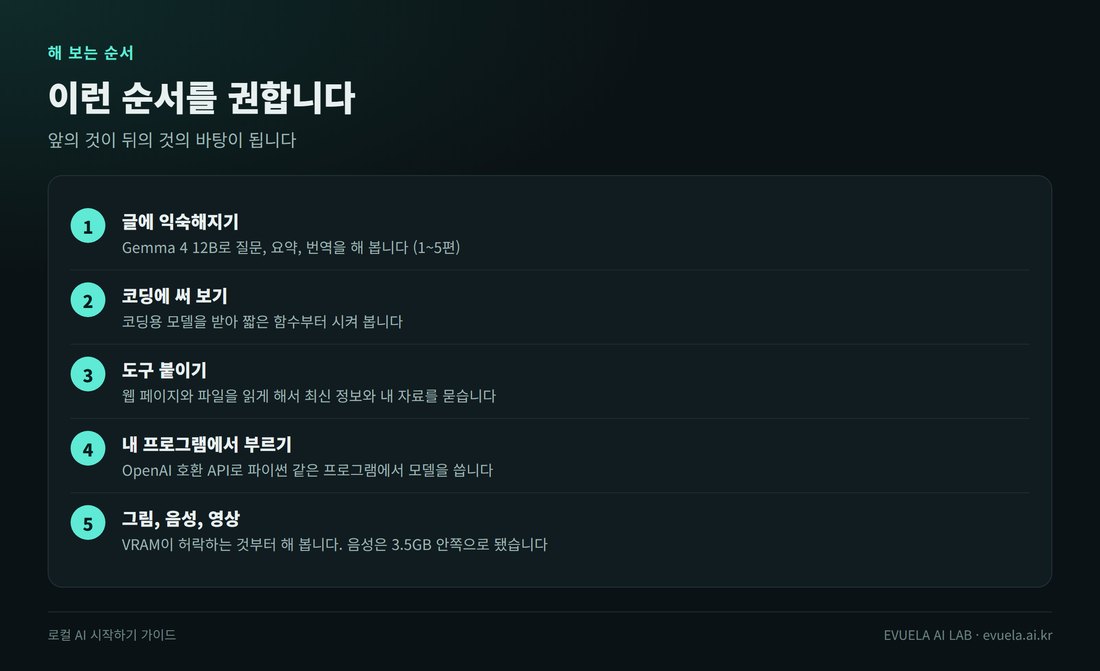
앞의 것이 뒤의 것의 바탕이 됩니다.
| 내 VRAM | 해 볼 만한 것 |
|---|---|
| 16GB | 글, 코딩, 도구, API, 음성, 검색. 모두 직접 해 본 것입니다 |
| 32GB | 위의 것에 더해 그림(21.0GB)과 영상(31.2GB) |
| 8GB, 12GB | 음성(3.5GB)과 검색(0.5GB)은 VRAM 값으로 보면 될 것으로 보입니다(가늠). 직접 재지 못했습니다 |
이 표가 뜻하는 것: 16GB로도 여섯 가지 가운데 네 가지를 했습니다. 그림과 영상은 이 블로그가 쓴 모델 기준으로 더 큰 그래픽카드가 필요했습니다.
가이드를 마치며: 일곱 편 차례
| 편 | 내용 |
|---|---|
| 1편 | 로컬 AI가 무엇이고, 내 PC로 되는가 |
| 2편 | Unsloth Studio를 설치하고 첫 대화까지 |
| 3편 | 모델 이름은 어떻게 읽는가 |
| 4편 | 내 그래픽카드에는 어떤 모델이 맞는가 |
| 5편 | 꼭 알아야 할 설정 세 가지 |
| 6편 | 느리거나 답이 안 나올 때 |
| 7편 | 그다음에 해 볼 것 (이 글) |
이 표가 뜻하는 것: 처음이라면 1편부터 차례로, 막힌 곳이 있다면 해당 편만 읽어도 됩니다. 새 모델을 테스트할 때마다 GPU 체험에 값이 추가됩니다.
정리
- 코딩은 코딩용 모델이 가장 빨랐습니다. 긴 파일과 설명에는 일반 모델이 맞았습니다.
- 도구를 붙이면 모델이 모르는 것을 읽어서 답합니다. 정답이 3번에서 237번이 됐습니다.
- API로 내 프로그램에서 모델을 부를 수 있습니다.
- 그림과 영상은 VRAM이 많이 필요했습니다. 음성과 검색은 가벼웠습니다.
- 모델마다 사용 조건이 다릅니다. 일에 쓰기 전에 라이선스를 확인합니다.
이 글의 한계
- 항목마다 모델 하나씩만 돌려 봤습니다. 더 작거나 더 나은 모델이 있을 수 있습니다.
- 그림과 영상은 32GB에서만 쟀습니다. 16GB에서 되는 설정은 찾아보지 않았습니다.
- 도구 테스트는 LM Studio에서 했습니다. Unsloth Studio에서 같은 테스트를 다시 하지는 않았습니다.
- 코딩은 파이썬 8문제로 본 것입니다. 큰 프로젝트를 맡기는 일은 재지 않았습니다.
- 사용 조건은 각 글을 쓸 때 확인한 내용입니다. 바뀔 수 있으니 모델 페이지에서 다시 확인해야 합니다.
- 2026년 10월 9일 기준으로 정리했습니다.
자주 묻는 질문
16GB 그래픽카드로 그림을 만들 수 있나요?
이 블로그가 돌려 본 Qwen-Image-2.1은 VRAM 21.0GB를 써서 32GB에서만 쟀습니다. 16GB에서 되는 이미지 모델과 설정은 아직 재 보지 않았습니다.
로컬 모델로 만든 그림과 영상을 마음대로 써도 되나요?
모델마다 다릅니다. Qwen-Image-2.1은 연구·평가용 라이선스였고, LTX-2.5는 조건이 붙어 있었습니다. 일이나 돈을 버는 데 쓰기 전에 모델 페이지의 라이선스를 꼭 확인해야 합니다.
MCP는 어렵나요?
설정 파일에 몇 줄을 적으면 붙습니다. 다만 MCP 서버는 내 PC에서 코드를 실행할 수 있으니 믿을 수 있는 것만 쓰고, 파일 도구에는 필요한 폴더만 열어 둡니다.
API를 쓰려면 돈이 드나요?
내 PC의 모델을 부르는 것이라 요금이 없습니다. Unsloth Studio에서 만든 API 키는 내 PC의 서버에 들어가는 열쇠이고, 회사에 내는 요금과는 관계가 없습니다.
댓글 0개