모델 이름에는 그 모델이 얼마나 크고, 어떻게 줄였는지가 적혀 있습니다. gemma-4-12B-it-qat-GGUF · UD-Q4_K_XL에서 꼭 봐야 할 것은 두 가지입니다. 12B는 모델의 크기이고 Q4는 4비트로 줄였다는 뜻입니다. 같은 모델 Qwen3.8 27B도 4비트 파일(Q4_K_M)은 17.74GB, 2비트 파일(IQ2_S)은 9.30GB로 8GB 넘게 차이가 났습니다. 이 글은 로컬 AI 시작하기 가이드의 3편입니다.
- B: 파라미터 수입니다. B는 10억이고, 클수록 VRAM이 더 필요합니다.
- A3B, A4B: 전체 가운데 한 번에 쓰는 크기입니다. 이 표시가 있는 모델은 크기에 비해 빠릅니다.
- Q4, Q3, Q2: 줄인 정도입니다. 숫자가 작을수록 파일이 작고, 품질은 조금씩 떨어집니다.
- GGUF: 내 PC에서 돌릴 때 받는 파일 형식입니다.
- 같은 Q4_K_M도 올린 곳마다 다릅니다. 세 곳의 파일이 16.46GB에서 18.97GB까지 달랐습니다.
파일 크기와 속도는 이 블로그가 직접 받아서 잰 값입니다. 표기의 뜻은 llama.cpp와 Hugging Face에서 쓰는 관례를 정리했습니다. 올리는 곳마다 표기를 조금씩 다르게 쓰기도 해서, 모든 파일에 똑같이 맞지는 않습니다.
이 글의 내용을 20초로 요약한 영상입니다(소리 없음).
이름을 조각으로 나누면
Unsloth Studio의 모델 허브에서 Gemma 4 12B를 찾으면 이런 이름이 나옵니다.
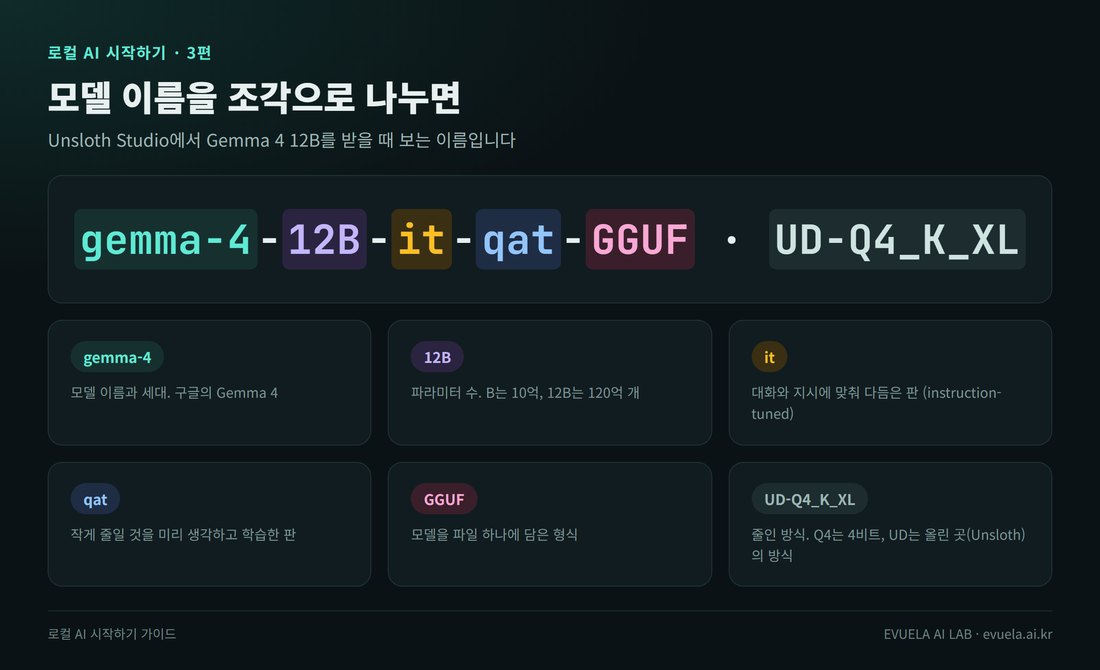
이름을 여섯 조각으로 나눈 모습입니다.
| 조각 | 뜻 | 왜 봐야 하나 |
|---|---|---|
gemma-4 | 모델 이름과 세대 | 누가 만든 어떤 모델인지 |
12B | 파라미터 120억 개 | 클수록 VRAM이 더 필요합니다 |
it | 대화와 지시에 맞춰 다듬은 판 | 채팅에는 it나 Instruct가 붙은 것을 씁니다 |
qat | 작게 줄일 것을 미리 생각하고 학습한 판 | 4비트로 줄였을 때 품질이 덜 떨어지도록 제작사가 만든 것입니다 |
GGUF | 모델을 파일 하나에 담은 형식 | Unsloth Studio, LM Studio 같은 프로그램이 읽는 형식입니다 |
UD-Q4_K_XL | 줄인 방식 | 파일 크기가 여기서 정해집니다 |
이 표가 뜻하는 것: 여섯 조각 가운데 내 그래픽카드에 맞는지 가르는 것은 12B와 Q4 두 개입니다. 나머지는 모델의 종류와 형식을 알려 줍니다.
B는 모델의 크기
AI 모델은 숫자 수십억 개로 이루어져 있습니다. 이 숫자 하나하나를 파라미터(또는 가중치)라고 합니다. B는 Billion, 곧 10억입니다. 12B는 120억 개, 27B는 270억 개입니다.
파라미터가 많을수록 대체로 더 어려운 일을 해내지만, 파일이 크고 VRAM을 더 씁니다. 직접 잰 값으로 보면 이렇습니다.
| 모델 | 파일 (4비트) | VRAM | 그래픽카드 | 잰 글 |
|---|---|---|---|---|
| Gemma 4 12B QAT (Q4_0) | 7.15GB | 8.6GB | 16GB | 82번 |
| Qwen3.8 27B (Q4_K_M) | 16.81GB | 19.7GB | 32GB | 83번 |
이 표가 뜻하는 것: 같은 4비트 파일이라도 12B는 약 7GB, 27B는 약 17GB입니다. B 앞의 숫자가 두 배쯤 커지면 파일도 두 배쯤 커집니다.
A3B, A4B는 한 번에 쓰는 크기
이름에 35B-A3B처럼 숫자가 두 번 나오는 모델이 있습니다. 앞의 35B는 전체 크기이고, 뒤의 A3B는 토큰 하나를 만들 때 실제로 계산하는 크기(활성 파라미터)가 약 3B라는 뜻입니다. 이런 구조를 MoE(Mixture of Experts)라고 합니다. 모델 안에 익스퍼트라는 작은 묶음이 여러 개 있고, 질문에 따라 그중 몇 개만 골라 씁니다.
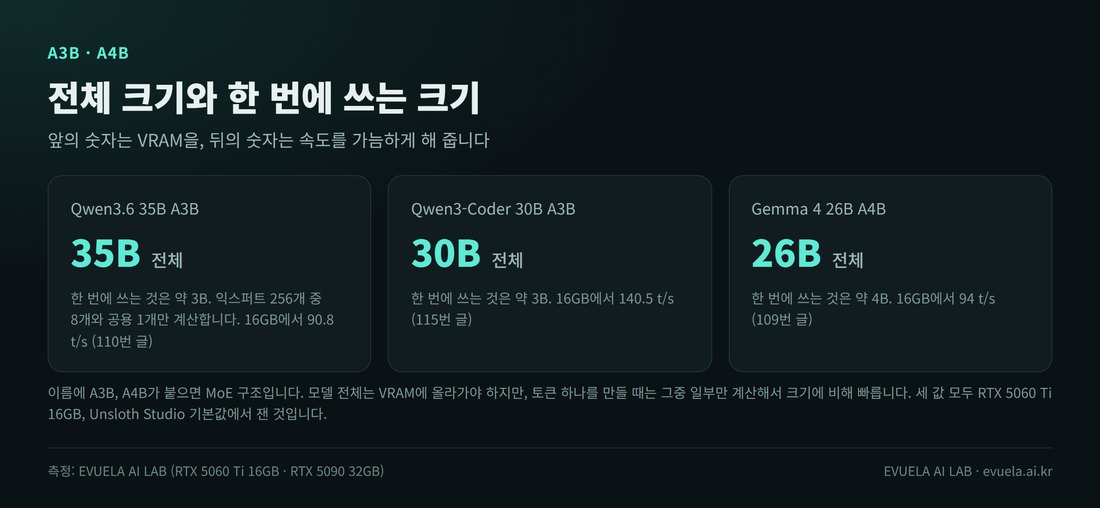
세 모델 모두 RTX 5060 Ti 16GB, Unsloth Studio 기본값에서 잰 값입니다.
읽는 법은 간단합니다. 앞의 숫자로 VRAM을, 뒤의 숫자로 속도를 가늠합니다. 모델 전체가 VRAM에 올라가야 하므로 메모리는 35B만큼 필요합니다. 하지만 계산은 3B만큼만 해서 빠릅니다. Qwen3.6 35B A3B는 익스퍼트 256개 가운데 8개와 공용 1개만 쓰고, 16GB 그래픽카드에서 초당 90.8토큰이 나왔습니다(110번 글). 같은 Gemma 4에서도 MoE 구조인 26B A4B가 보통 구조인 31B보다 2~3배 빨랐습니다(89번 글).
it, Instruct, Coder는 쓰임새
- it, Instruct: 질문하고 답을 받는 대화에 맞춘 판입니다. 채팅에 쓸 때는 이것을 받습니다.
- Coder: 코딩에 맞춘 판입니다. Qwen3-Coder 30B는 파이썬 문제 48개 중 40개를 통과했지만, 산수와 일반 질문은 약했습니다(115번 글).
- 아무 표시가 없는 것: 요즘 모델은 표시가 없어도 대화용인 경우가 많습니다. 모델 페이지의 설명을 확인합니다.
Q4, Q3, Q2는 줄인 정도
모델의 파라미터는 원래 16비트나 32비트 숫자입니다. 그대로 두면 27B 모델이 50GB를 넘습니다. 그래서 숫자 하나를 4비트나 3비트로 덜 정밀하게 저장해 크기를 줄입니다. 이것이 양자화이고, Q 뒤의 숫자가 그 비트 수입니다.
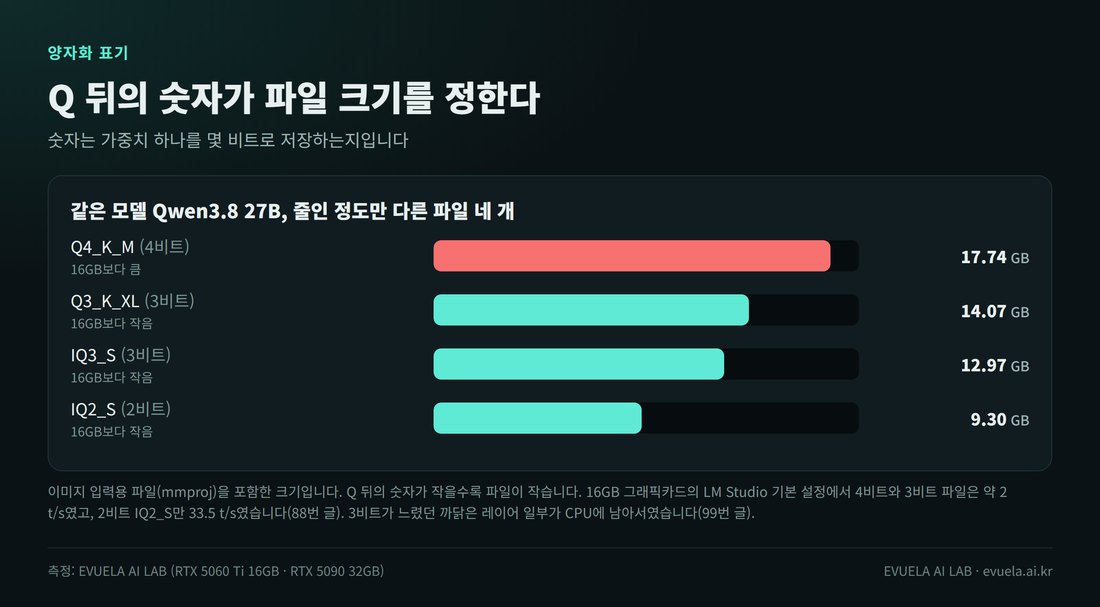
같은 모델인데 줄인 정도에 따라 파일 크기가 9.30GB에서 17.74GB까지 달랐습니다.
| 표기 | 비트 | 파일 크기 | 16GB에서 잰 속도 |
|---|---|---|---|
| Q4_K_M | 4비트 | 17.74GB | 2.2 t/s |
| Q3_K_XL | 3비트 | 14.07GB | 약 2 t/s |
| IQ3_S | 3비트 | 12.97GB | 약 2 t/s |
| IQ2_S | 2비트 | 9.30GB | 33.5 t/s |
이 표가 뜻하는 것: Qwen3.8 27B를 RTX 5060 Ti 16GB에서 LM Studio 기본 설정으로 잰 값입니다(88번 글). 파일 크기에는 이미지 입력용 파일이 들어 있습니다. 3비트 파일은 16GB보다 작은데도 느렸습니다. 나중에 확인해 보니 LM Studio 기본 설정이 레이어 65개 가운데 56~58개만 그래픽카드에 올리고 나머지를 CPU로 계산하고 있었습니다. 다른 3비트 파일은 설정 세 가지를 바꾸자 약 1.9 t/s에서 약 29 t/s가 됐습니다(99번 글). 파일이 VRAM보다 작아도 레이어가 모두 그래픽카드에 올라갔는지는 따로 봐야 한다는 뜻입니다. 6편에서 다룹니다.
Q 뒤에 붙는 글자들
| 표기 | 뜻 |
|---|---|
Q4_0 | 모든 값을 똑같이 4비트로 줄인 단순한 방식입니다. QAT 모델은 이 방식에 맞춰 학습한 경우가 많습니다 |
Q4_K_M | K는 레이어마다 비트를 다르게 섞는 방식입니다. 뒤의 S, M, L, XL은 같은 비트 안에서의 크기로, 클수록 파일이 크고 품질이 좋습니다 |
IQ3_S, IQ2_S | 낮은 비트에서 품질을 지키려고 만든 방식입니다. 3비트 아래에서 많이 씁니다 |
UD- | Unsloth가 쓰는 자체 방식(Unsloth Dynamic)입니다. 중요한 레이어는 덜 줄이고 덜 중요한 레이어는 더 줄입니다 |
Q8_0 | 8비트입니다. 원본과 거의 같지만 파일이 큽니다 |
이 표가 뜻하는 것: 처음에는 Q 뒤의 숫자만 봐도 됩니다. 4가 기준이고, VRAM이 모자라면 3이나 2로 내려갑니다. 나머지 글자는 같은 비트 안에서의 작은 차이입니다.
파일 크기를 어림하는 법
파일 크기는 파라미터 수 × 비트 ÷ 8로 어림할 수 있습니다. 27B를 4비트로 줄이면 27 × 4 ÷ 8 = 13.5GB입니다. 실제 Q4_K_M 파일은 16.81GB였습니다. Q4_K_M이 정확히 4비트가 아니라 평균 4.92비트이기 때문입니다. 27 × 4.92 ÷ 8 = 16.6GB로 실제와 거의 맞습니다.
이름이 같아도 올린 곳마다 다르다
같은 모델, 같은 Q4_K_M이라도 누가 만들어 올렸느냐에 따라 파일이 다릅니다. Qwen3.8 27B의 Q4_K_M을 세 곳에서 받아 파일 안을 직접 읽어 봤습니다.
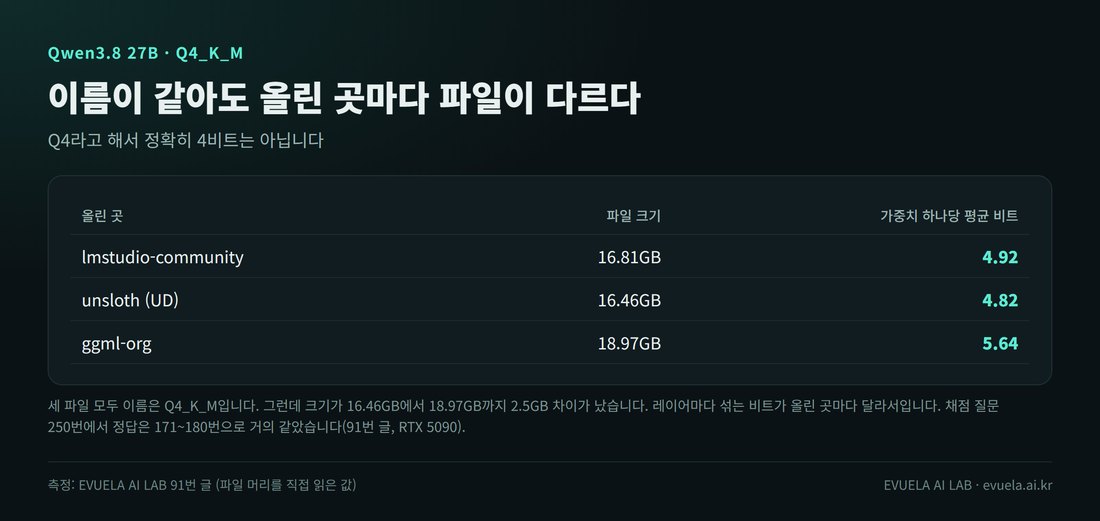
세 파일 모두 이름은 Q4_K_M인데 크기가 2.5GB까지 달랐습니다.
| 올린 곳 | 파일 크기 | 평균 비트 | 쓴 방식 |
|---|---|---|---|
| lmstudio-community | 16.81GB | 4.92 | Q4_K, Q6_K 두 가지 |
| unsloth | 16.46GB | 4.82 | Q3_K부터 Q8_0까지 8가지 |
| ggml-org | 18.97GB | 5.64 | Q4_K, Q6_K, Q8_0 세 가지 |
이 표가 뜻하는 것: 크기는 2.5GB까지 달랐지만 채점 질문 250번에서 정답은 171~180번으로 거의 같았습니다. 속도는 파일 안에 MTP 레이어가 들어 있는지에 따라 초당 63.8~86.2토큰으로 갈렸습니다(91번 글). 어디서 받을지 모르겠다면 가장 많이 받는 곳의 파일을 고르면 무난합니다.
더 줄이면 무엇을 잃나
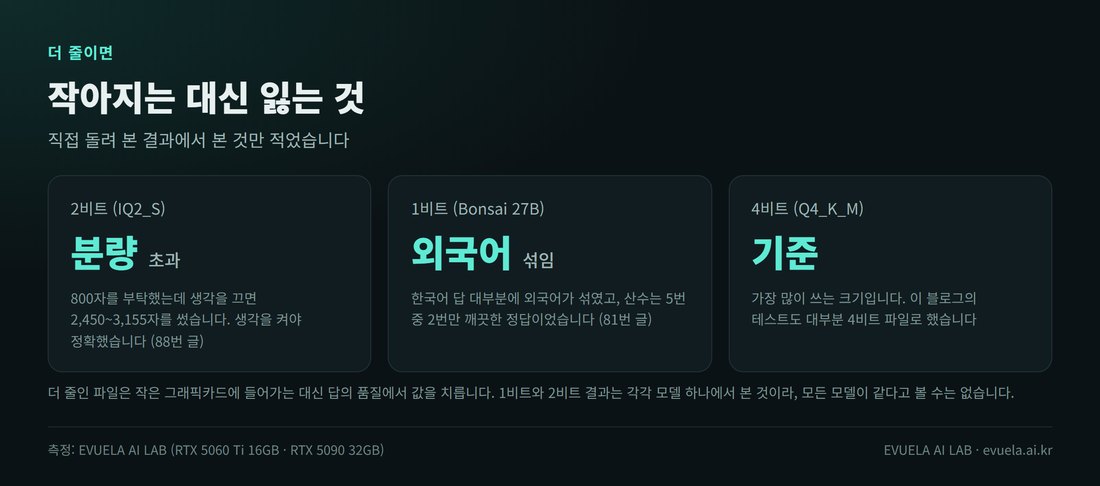
직접 돌려 본 결과에서 본 것만 적었습니다.
- 2비트(Qwen3.8 27B IQ2_S): 16GB에 들어가서 빨랐지만, 800자를 부탁하면 생각을 끈 상태에서 2,450~3,155자를 썼습니다. 틀린 설명도 섞였습니다. 생각을 켜면 531~677자로 맞췄습니다(88번 글).
- 1비트(Bonsai 27B): 파일이 3.8GB로 아주 작지만, 한국어 답 대부분에 외국어가 섞였습니다(81번 글).
- 3비트 + 큰 모델: 반대로 Qwen3.6 35B A3B의 3비트 파일은 산수와 코딩에서 4비트 Gemma 4 26B와 정답 수가 거의 같았습니다(110번 글).
그래서 흔히 쓰는 기준은 이렇습니다. 4비트를 먼저 보고, VRAM에 안 들어가면 3비트로 내립니다. 2비트 아래는 꼭 필요할 때만 씁니다. 작은 모델의 4비트와 큰 모델의 3비트 가운데 무엇이 나은지는 모델마다 달라서, 4편에서 고르는 방법을 다룹니다.
그 밖에 보이는 말들
| 말 | 뜻 |
|---|---|
| GGUF | 모델을 파일 하나에 담은 형식. 내 PC에서 돌릴 때는 이 형식을 받습니다 |
| mmproj | 이미지 입력용 파일. 사진을 읽는 모델은 이 파일을 함께 받습니다(약 1GB) |
| MTP | 토큰 여러 개를 한꺼번에 예측해 속도를 올리는 기능. 저장소 이름에 MTP가 있으면 이 기능용 레이어가 들어 있습니다 |
| Thinking, Reasoning | 답하기 전에 풀이를 먼저 적는 기능이 있는 모델 |
| safetensors | 학습이나 이미지 모델에서 쓰는 다른 형식. 채팅용으로는 GGUF를 받습니다 |
이 표가 뜻하는 것: 채팅에 쓸 모델을 고를 때는 GGUF인지만 확인하면 됩니다. mmproj는 프로그램이 알아서 함께 받습니다.
실제 이름을 읽어 보면
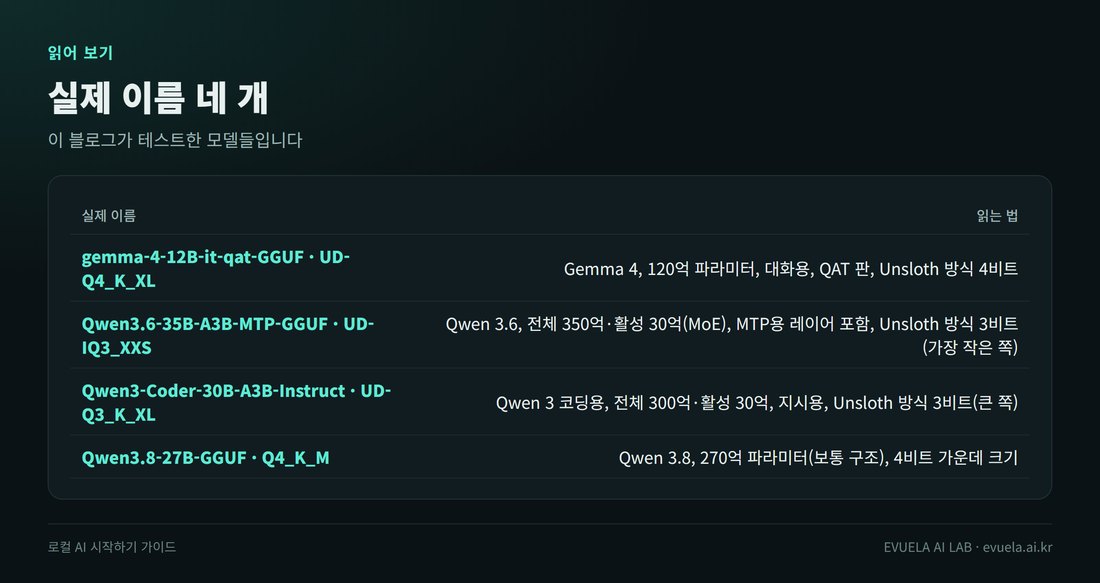
이 블로그가 테스트한 모델 네 개의 이름입니다.
| 이름 | 크기 | 줄인 정도 | 파일 | 16GB에서 |
|---|---|---|---|---|
| gemma-4-12B-it-qat · UD-Q4_K_XL | 12B | 4비트 | 6.72GB | 다 들어감 |
| Qwen3.6-35B-A3B-MTP · UD-IQ3_XXS | 35B (활성 3B) | 3비트 | 14.07GB | 다 들어감, 90.8 t/s |
| Qwen3-Coder-30B-A3B-Instruct · UD-Q3_K_XL | 30B (활성 3B) | 3비트 | 12.86GB | 다 들어감, 140.5 t/s |
| Qwen3.8-27B · Q4_K_M | 27B | 4비트 | 16.81GB | 일부는 시스템 램, 2.2 t/s |
이 표가 뜻하는 것: 이름만 읽어도 16GB 그래픽카드에 들어갈지 어림할 수 있습니다. 27B의 4비트는 넘치고, 30B와 35B도 3비트에 A3B가 붙은 것은 들어가서 빨랐습니다.
정리
- B 앞의 숫자가 크기입니다. 클수록 VRAM이 더 필요합니다.
- A3B, A4B가 붙으면 크기에 비해 빠릅니다. 메모리는 앞의 숫자만큼 필요합니다.
- Q 뒤의 숫자가 줄인 정도입니다. 4가 기준이고, 안 들어가면 3으로 내립니다.
- 파일 크기는 파라미터 수 × 비트 ÷ 8로 어림합니다. 실제는 그보다 조금 큽니다.
- 이름이 같아도 올린 곳마다 파일이 다릅니다. 정답률은 거의 같았습니다.
앞의 글: 1편 로컬 AI가 무엇이고 내 PC로 되는가, 2편 Unsloth Studio 설치와 첫 대화. 다음 편(4편)은 내 그래픽카드에 맞는 모델을 고르는 방법입니다.
이 글의 한계
- 표기의 뜻은 관례를 정리한 것입니다. 정해진 표준이 아니라서 올리는 곳마다 조금씩 다르게 씁니다.
- 줄였을 때의 품질 차이는 모델 몇 개에서 본 것입니다. 1비트와 2비트 결과는 각각 모델 하나의 결과입니다.
- 파일 크기 표기가 두 가지입니다. 88번 글의 값은 이미지 입력용 파일을 포함하고, 91번 글의 값은 모델 파일만입니다. 표마다 밝혔습니다.
- QAT의 효과는 직접 재지 않았습니다. 같은 모델의 QAT 판과 보통 판을 견준 측정은 이 블로그에 없습니다.
- 2026년 10월 9일 기준으로 정리했습니다.
자주 묻는 질문
Q4_K_M과 Q4_K_S 가운데 무엇을 받나요?
둘 다 4비트이고 M이 조금 더 크고 품질이 조금 더 좋습니다. VRAM에 들어간다면 M을 받고, 빠듯하면 S를 받습니다. 이 블로그에서 둘을 직접 견준 측정은 없습니다.
같은 크기라면 큰 모델의 3비트와 작은 모델의 4비트 가운데 무엇이 낫나요?
모델마다 다릅니다. 이 블로그의 측정에서는 Qwen3.6 35B A3B의 3비트 파일과 Gemma 4 26B A4B의 4비트 파일이 산수와 코딩에서 정답 수가 거의 같았습니다. 문제 수가 적어서 어느 쪽이 낫다고 말하기는 어렵습니다.
QAT가 붙은 것과 안 붙은 것은 무엇이 다른가요?
QAT는 제작사가 작게 줄일 것을 미리 생각하고 학습한 판입니다. 4비트로 줄였을 때 품질이 덜 떨어지도록 만든 것입니다. 얼마나 차이 나는지는 이 블로그에서 직접 재지 않았습니다.
GGUF가 아닌 파일은 못 쓰나요?
Unsloth Studio와 LM Studio의 채팅은 GGUF 파일을 씁니다. safetensors 같은 다른 형식은 학습이나 이미지 생성에서 씁니다.
댓글 0개