[RTX 5090 32GB] 로컬 AI Gemma 4 12B, Unsloth 기본값이면 충분할까, 32GB는 초당 233토큰인데 16GB는 52토큰이었다
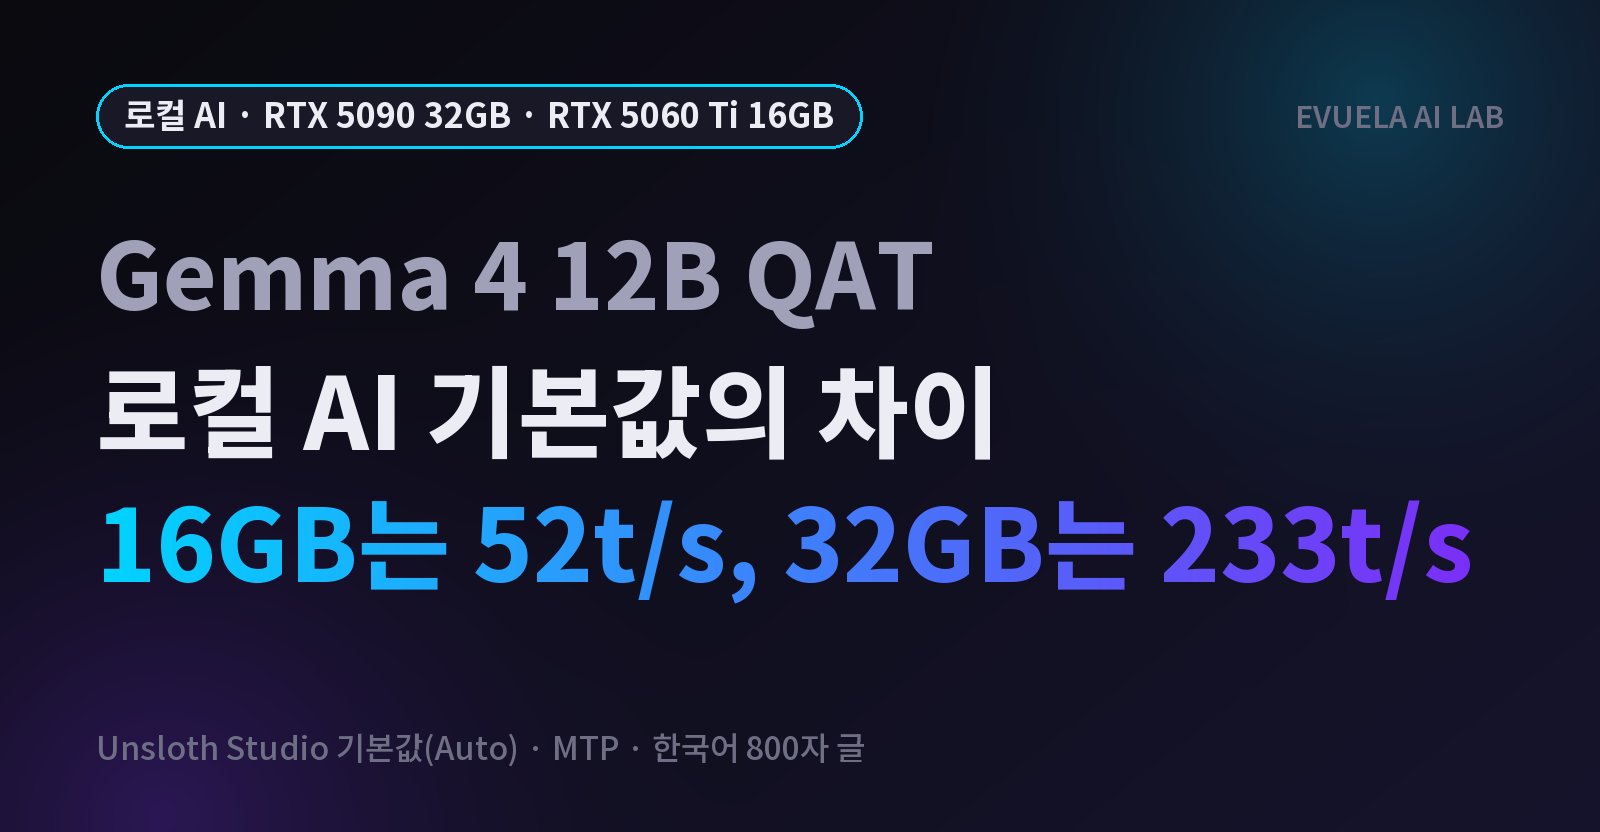
Gemma 4 12B QAT를 RTX 5090 32GB와 RTX 5060 Ti 16GB에서 Unsloth Studio 기본값으로 올렸습니다. 32GB는 MTP가 켜져 초당 233토큰, 16GB는 MTP가 꺼져 52토큰이었습니다. 16GB는 컨텍스트만 지정해도 94토큰이 됩니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"Gemma 4 12B" 검색 결과 14건
Gemma 4 12B QAT를 RTX 5090 32GB와 RTX 5060 Ti 16GB에서 Unsloth Studio 기본값으로 올렸습니다. 32GB는 MTP가 켜져 초당 233토큰, 16GB는 MTP가 꺼져 52토큰이었습니다. 16GB는 컨텍스트만 지정해도 94토큰이 됩니다.
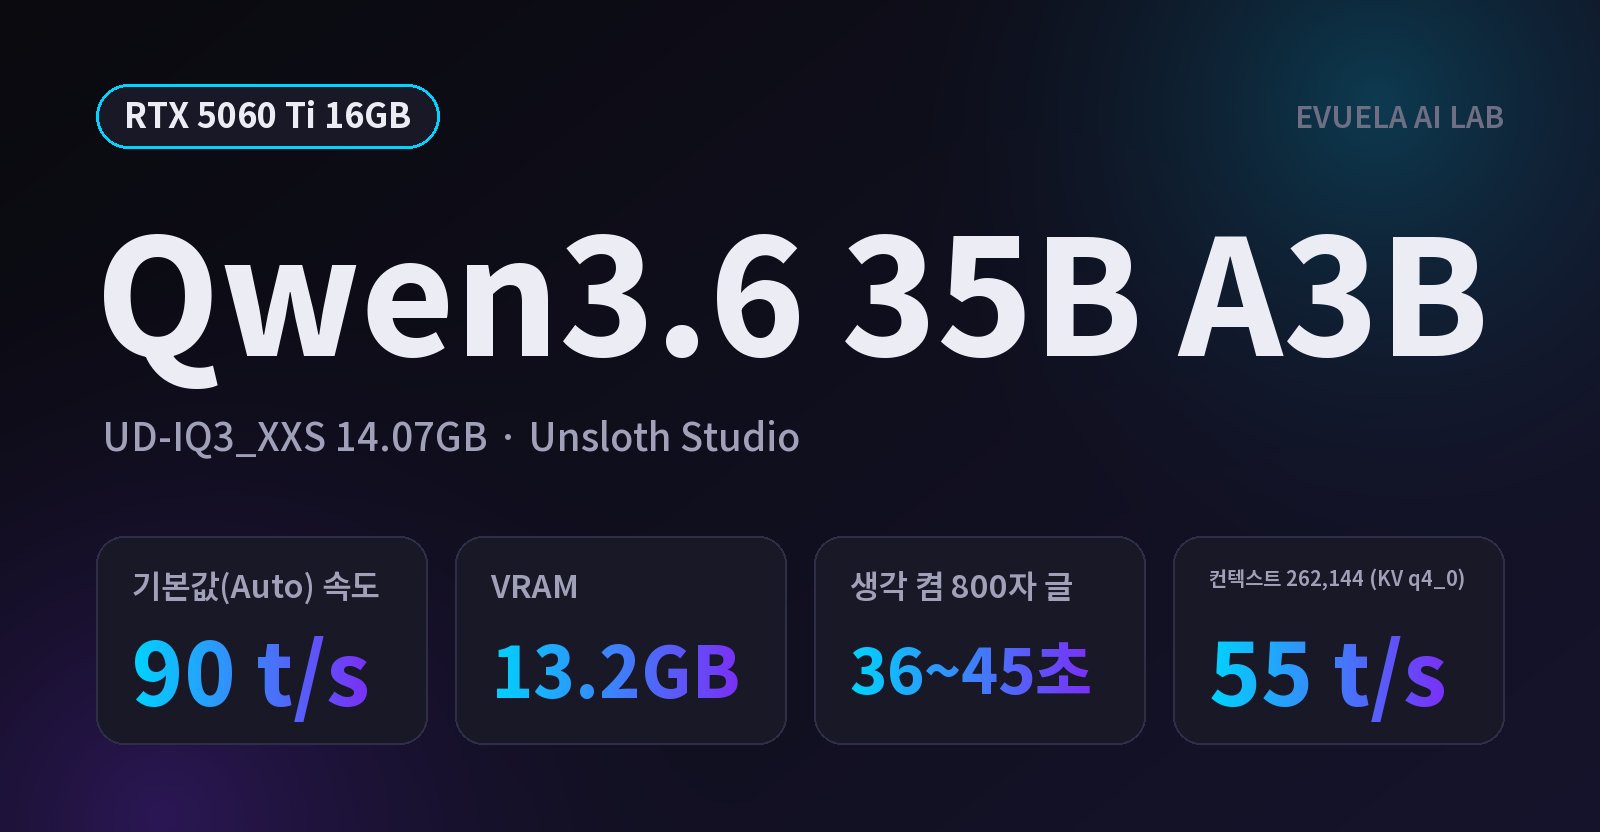
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3.6 35B A3B(UD-IQ3_XXS)를 기본값으로 돌렸습니다. VRAM 13.2GB에 다 들어갔고 초당 약 90토큰이었습니다. 컨텍스트별 속도, 설정 비교, Gemma 4 26B와의 비교를 담았습니다.
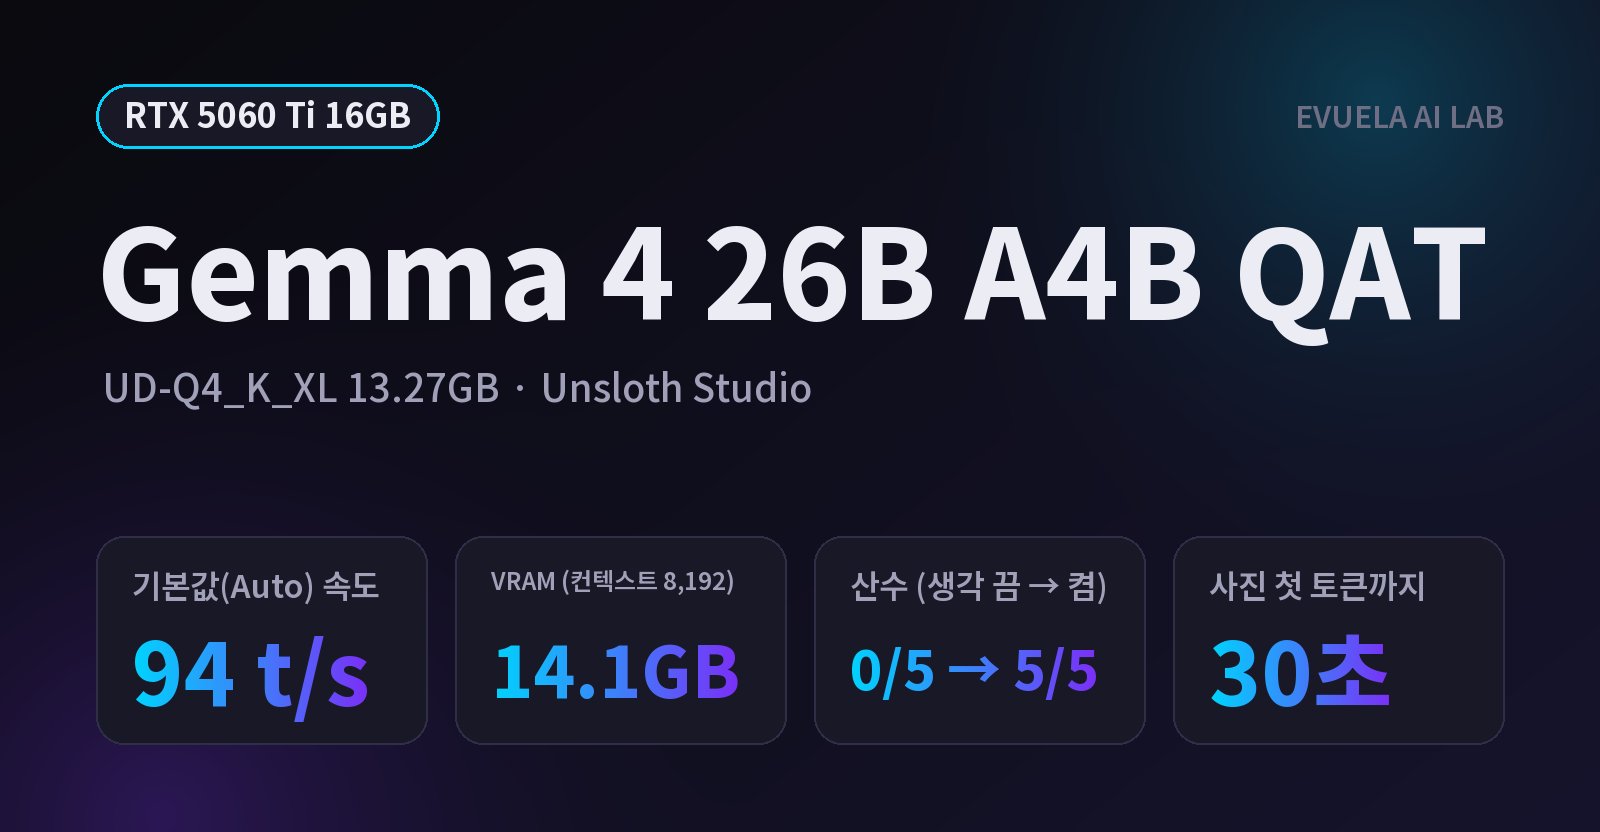
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.
영상 생성 모델 LTX-2.5를 RTX 5090에서 ComfyUI로 돌렸습니다. 소리가 든 5초 영상(1280×704)이 약 20초, 풀HD는 50.5초, VRAM은 31.2GB였습니다. 한국어 대사와 한국에서 써도 되는 라이선스도 정리했습니다.
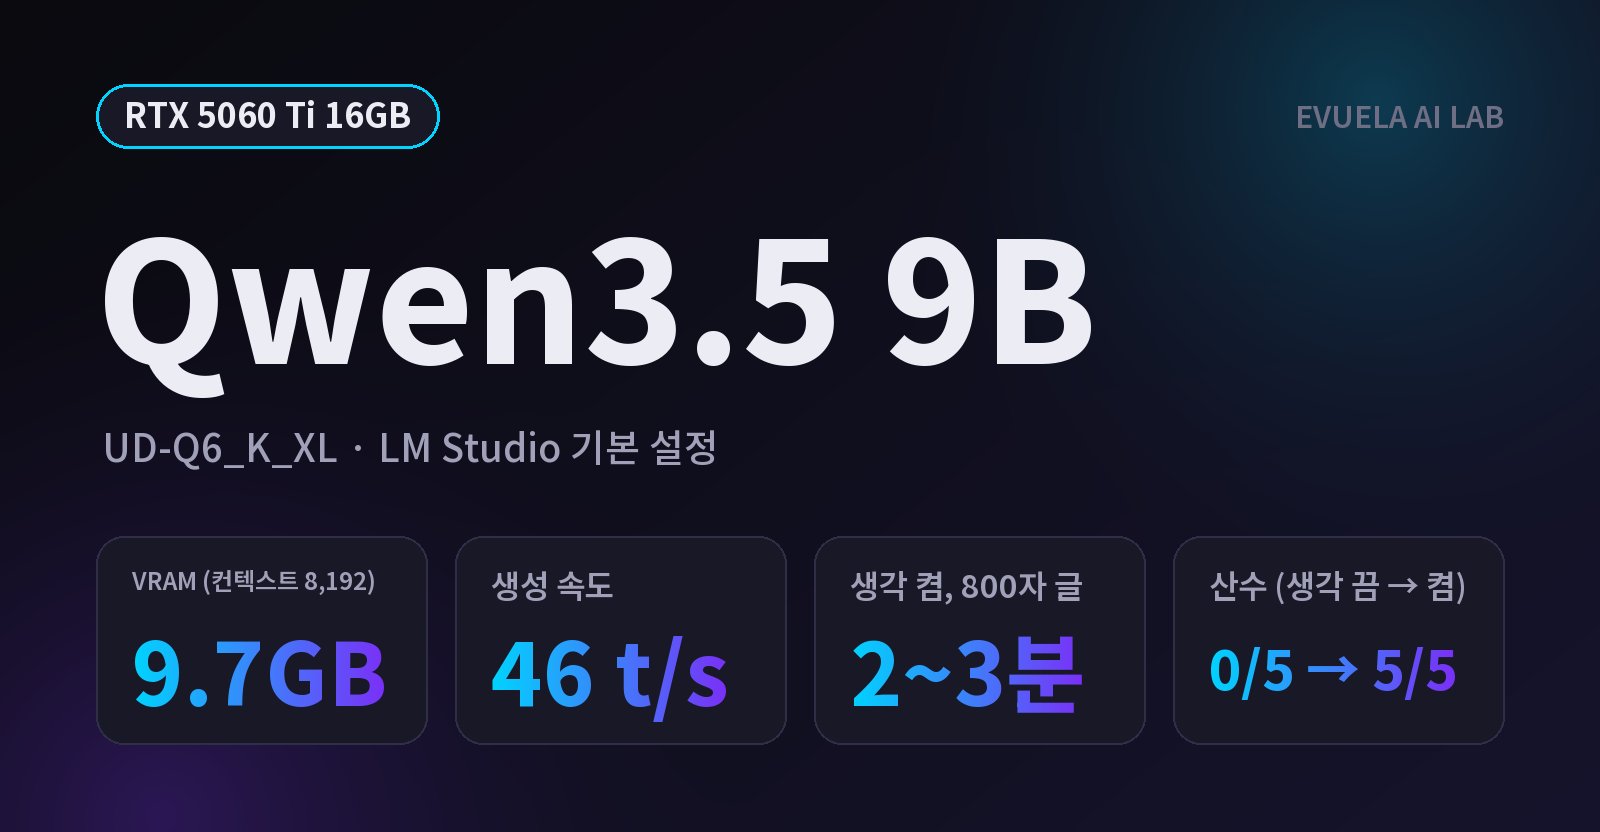
RTX 5060 Ti 16GB PC의 LM Studio에서 Qwen3.5 9B(UD-Q6_K_XL)를 기본 설정으로 재 봤습니다. VRAM 9.7GB, 약 46t/s였고 컨텍스트 131,072까지 VRAM에 다 들어갔습니다. 생각을 켜면 산수는 5번 모두 맞았지만 800자 글에 2~3분이 걸렸습니다. Ornith 1.5 9B와도 비교했습니다.
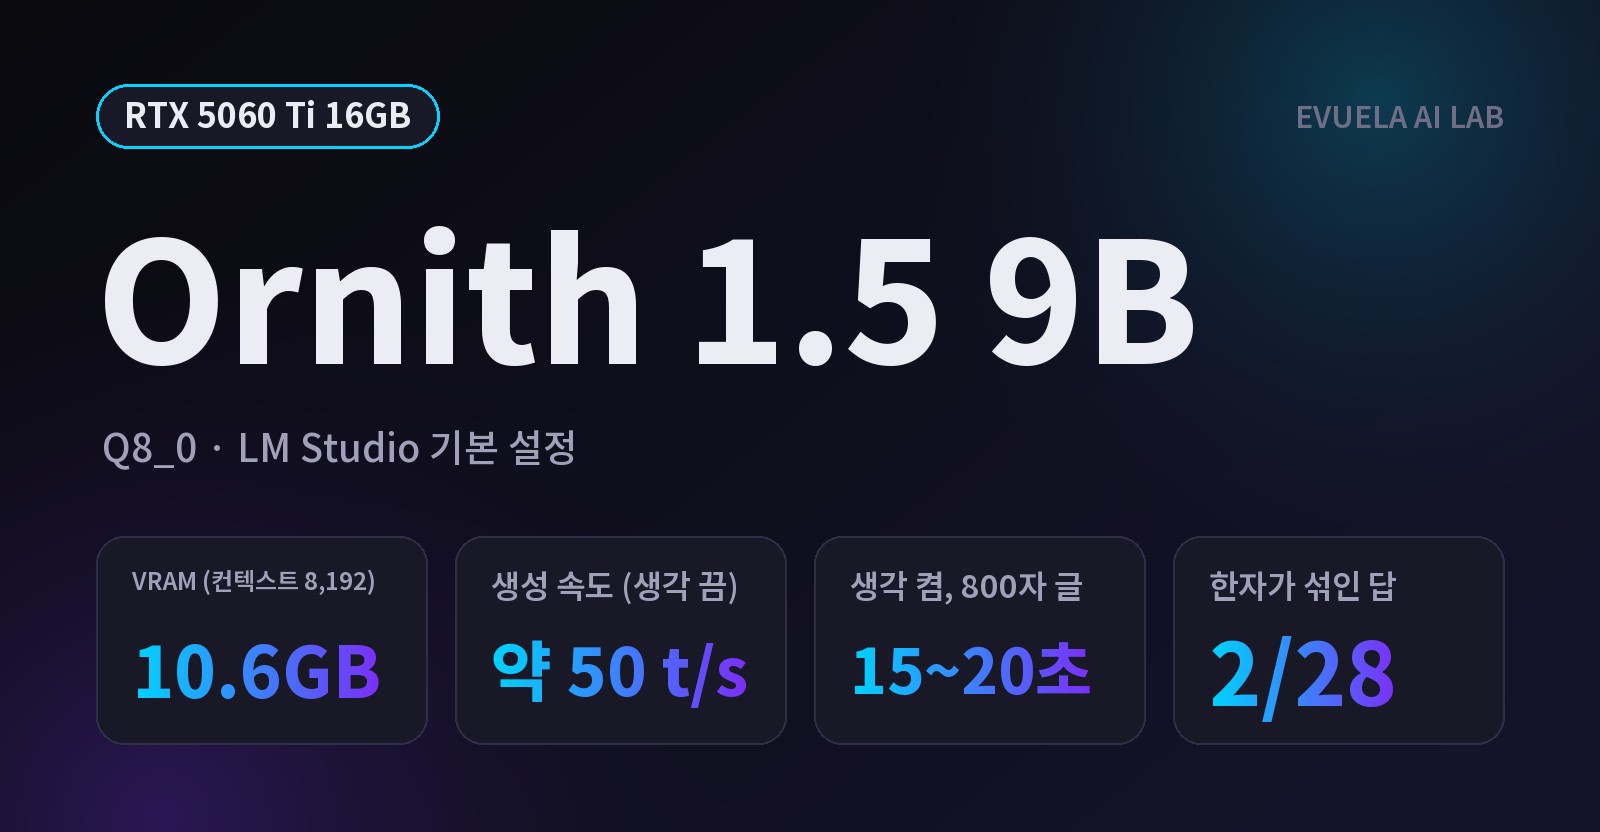
RTX 5060 Ti 16GB PC의 LM Studio에서 Ornith 1.5 9B(Q8_0, 9.79GB)를 기본 설정으로 재 봤습니다. VRAM 10.6GB, 생각 끔 약 50t/s, 생각 켬 56~65t/s였고 생각을 켜도 800자 글이 20초 안에 끝났습니다. 한국어 답 28개 중 2개에 한자가 섞였고, 형식 지시는 지키지 않았습니다.
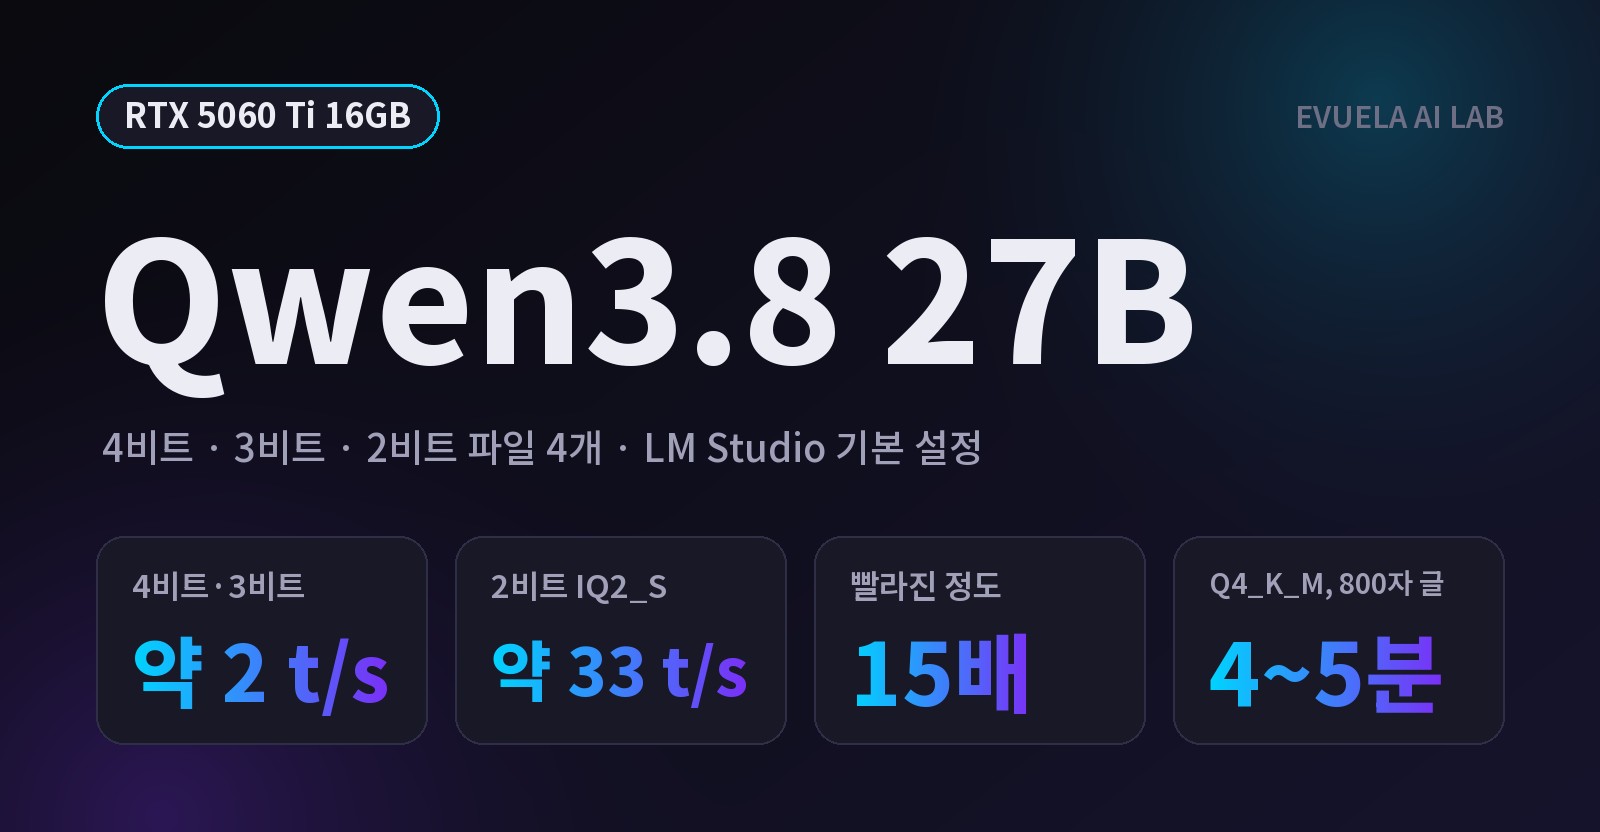
RTX 5060 Ti 16GB PC의 LM Studio에서 Qwen3.8 27B를 양자화 4종(Q4_K_M, Q3_K_XL, IQ3_S, IQ2_S)으로 돌려 봤습니다. 4비트와 3비트는 약 2t/s였고, 2비트 IQ2_S만 약 33t/s로 15배 빨랐습니다. 2비트는 생각을 켜야 정확했고, 컨텍스트는 32K가 알맞았습니다.
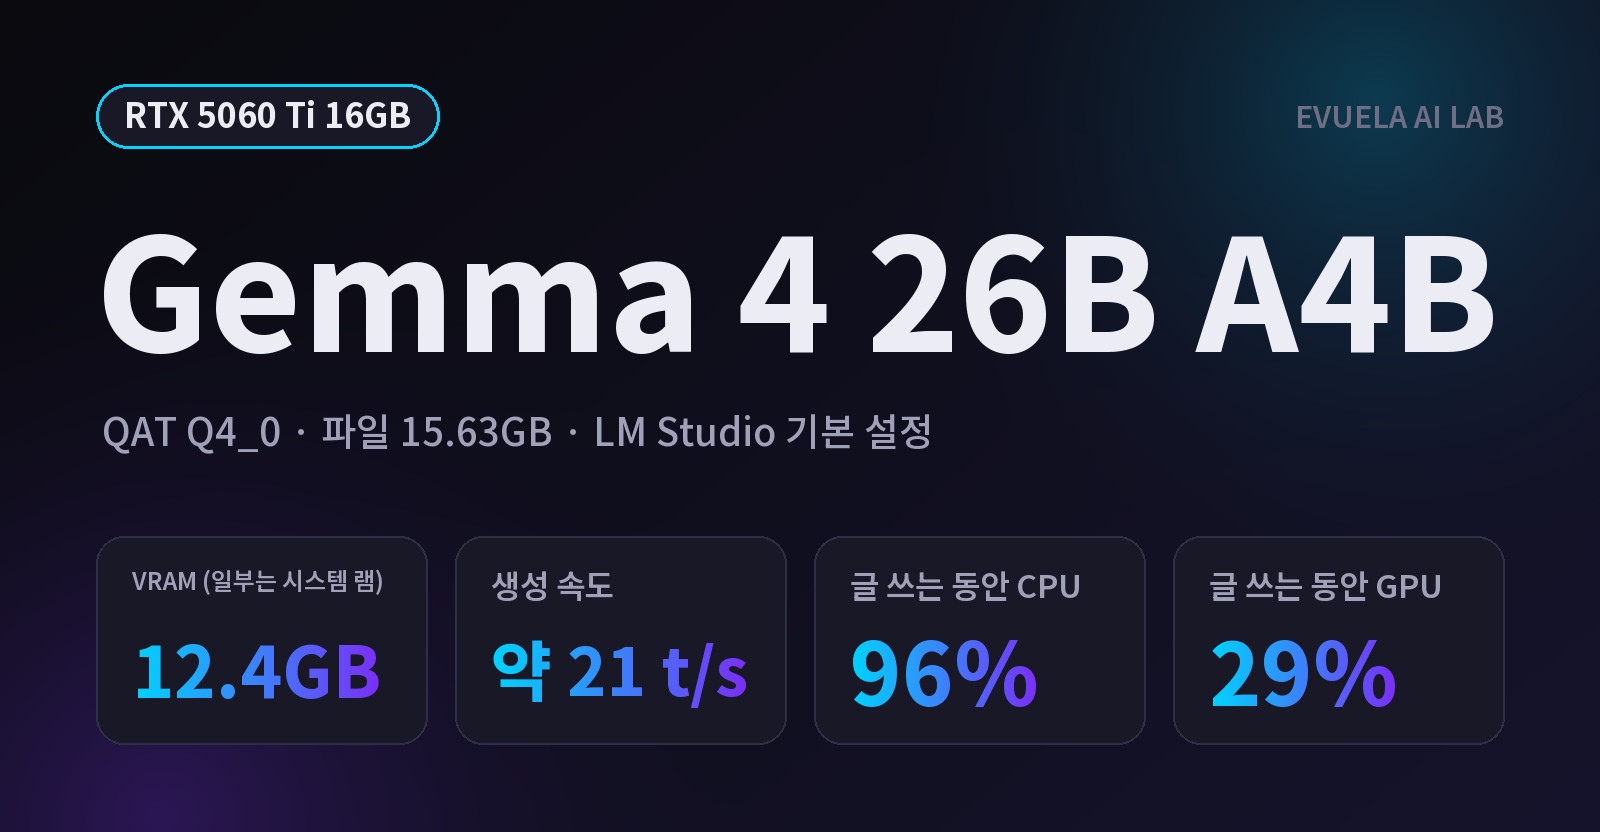
RTX 5060 Ti 16GB PC의 LM Studio에서 Gemma 4 26B A4B QAT(15.63GB)를 기본 설정 그대로 돌려 봤습니다. 모델은 로드됐지만 일부가 시스템 램에 남아, 답을 만드는 동안 CPU는 96%, GPU는 29%였습니다. 생성 속도는 약 21t/s로 같은 PC의 Gemma 4 12B의 절반이었습니다.
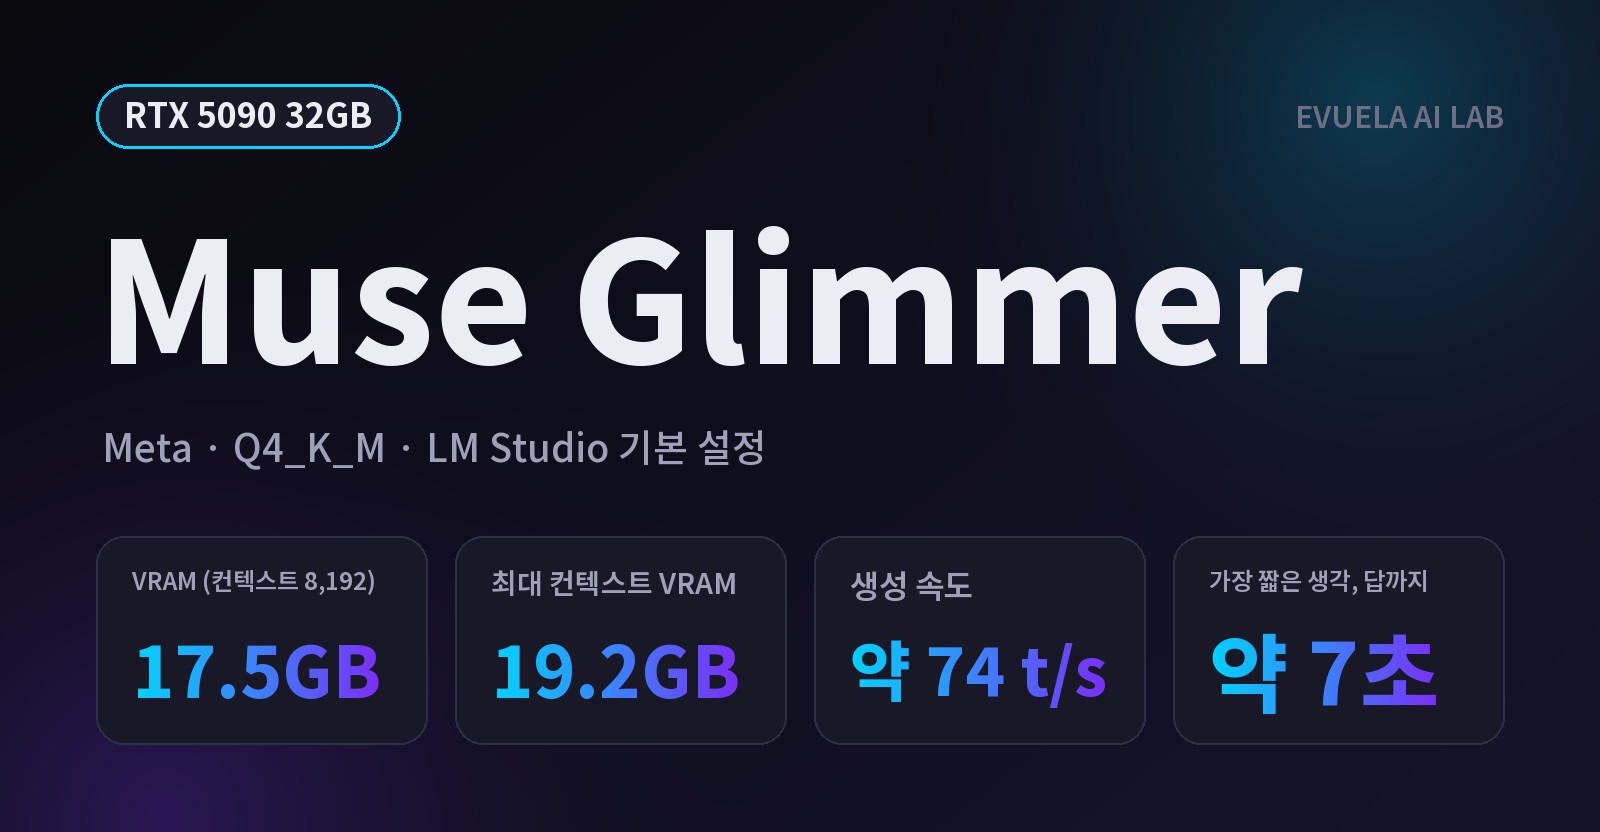
Meta가 공개한 약 300억 파라미터 모델 Muse Glimmer를 RTX 5090의 LM Studio 기본 설정으로 재 봤습니다. 컨텍스트를 16배 늘려도 VRAM은 17.5GB에서 19.2GB로 1.7GB만 늘었고, 기본 설정에서 27번 모두 답했습니다. 속도, 생각 단계, 한국어 품질, 이미지 입력까지 정리했습니다.