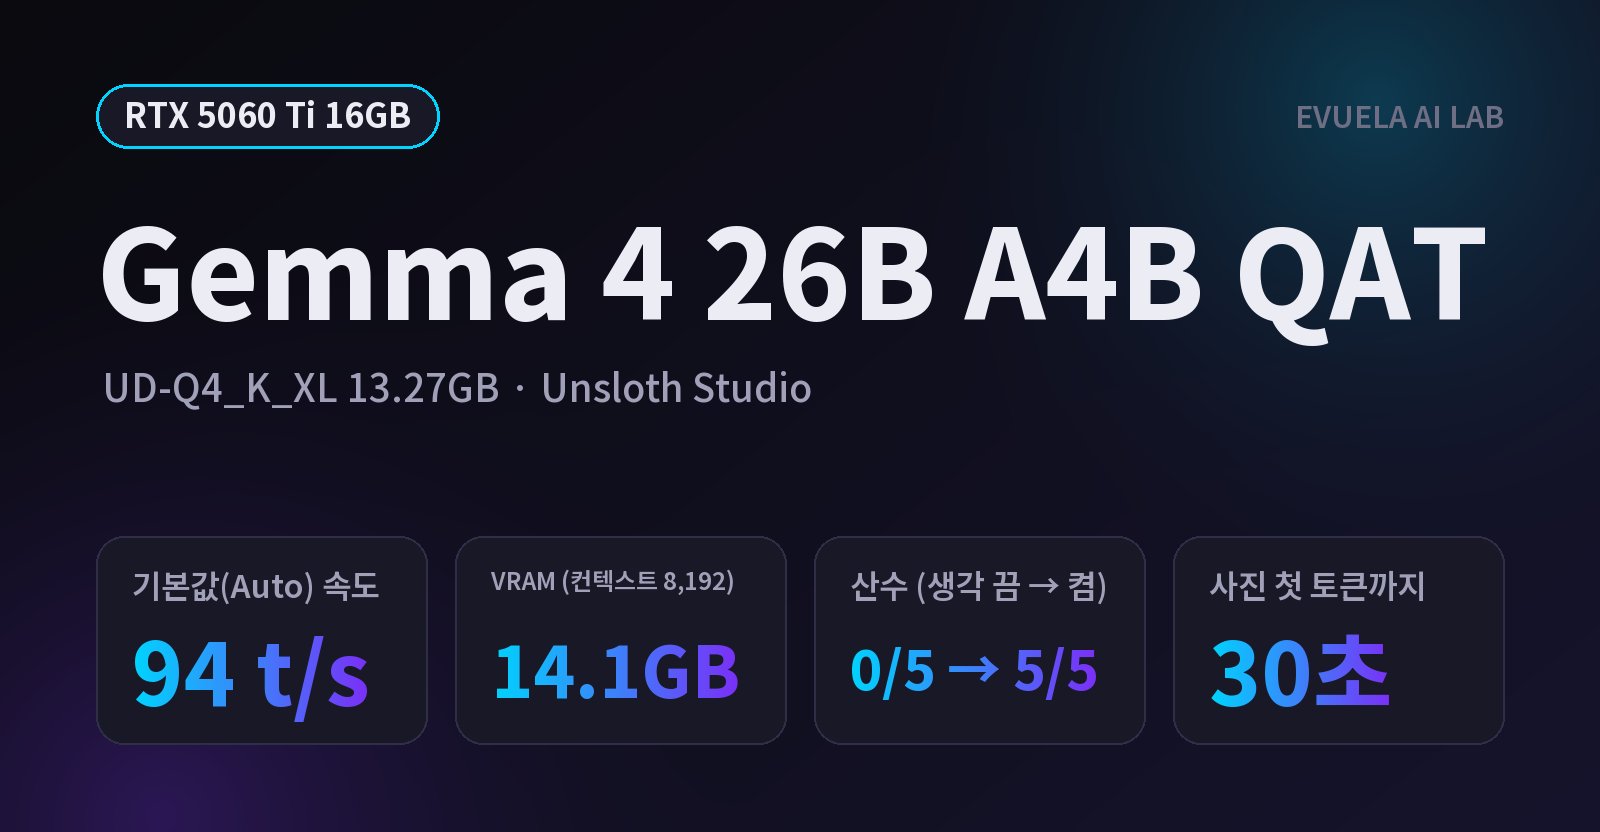
구글의 Gemma 4 26B A4B QAT(unsloth UD-Q4_K_XL, 파일 13.27GB)를 RTX 5060 Ti 16GB PC의 Unsloth Studio에서 기본값(Auto) 그대로 돌려 봤습니다. 결론부터 적으면 초당 약 94토큰(t/s)이 나왔습니다. 세 차례에 걸쳐 11번 잰 평균이 93.5t/s(최소 83.5, 최대 101.8)입니다. 같은 PC의 LM Studio에서 기본 설정으로 쟀을 때는 약 21t/s였습니다(87번 글, 파일은 Q4_0 15.63GB).
- VRAM은 약 14.1GB를 썼습니다. 윈도우가 쓰는 몫까지 합치면 16GB 중 14.7~14.8GB라서 판정은 "제한적"입니다.
- Auto는 컨텍스트를 8,192로 잡았습니다. 컨텍스트를 131,072까지 늘려도 로드는 됐지만 속도는 약 63t/s로 내려갔습니다.
- 산수는 생각(Thinking)을 켜야 맞았습니다. 끄면 5번 모두 틀렸고, 켜면 5번 모두 맞았습니다.
- 사진을 읽을 때는 첫 토큰까지 약 30초가 걸렸습니다. 이미지 입력용 파일을 CPU에 두기 때문입니다. 이 파일을 GPU에 올리면 1.8초가 되지만 글 속도는 약 76t/s로 내려갔습니다.
- 기본값보다 빨라지는 설정이 있었습니다. 레이어를 모두 GPU에 올리도록 고정하면 약 107t/s였고, 컨텍스트 131,072에서는 KV 캐시를 q4_0으로 줄이자 약 63t/s가 약 79t/s로 올랐습니다.
- 최대 컨텍스트 262,144는 기본 KV 캐시로는 쓰기 어려웠습니다. 로드는 됐지만 시스템 램이 31.7GB까지 차고 약 10t/s로 떨어졌습니다.
이 글의 숫자는 모두 이 PC에서 직접 잰 값입니다. 속도와 정답 수는 Unsloth Studio의 API로 재고, 화면 캡처와 영상은 측정이 끝난 뒤 따로 찍었습니다. 모델을 받아서 측정을 끝내기까지 2026년 10월 4일 하루에 했습니다. 글을 올린 뒤 같은 날 밤에 5번 반복, 시스템 램, 설정 비교, 다른 곳의 측정과 견주기를 더해 고쳤습니다.
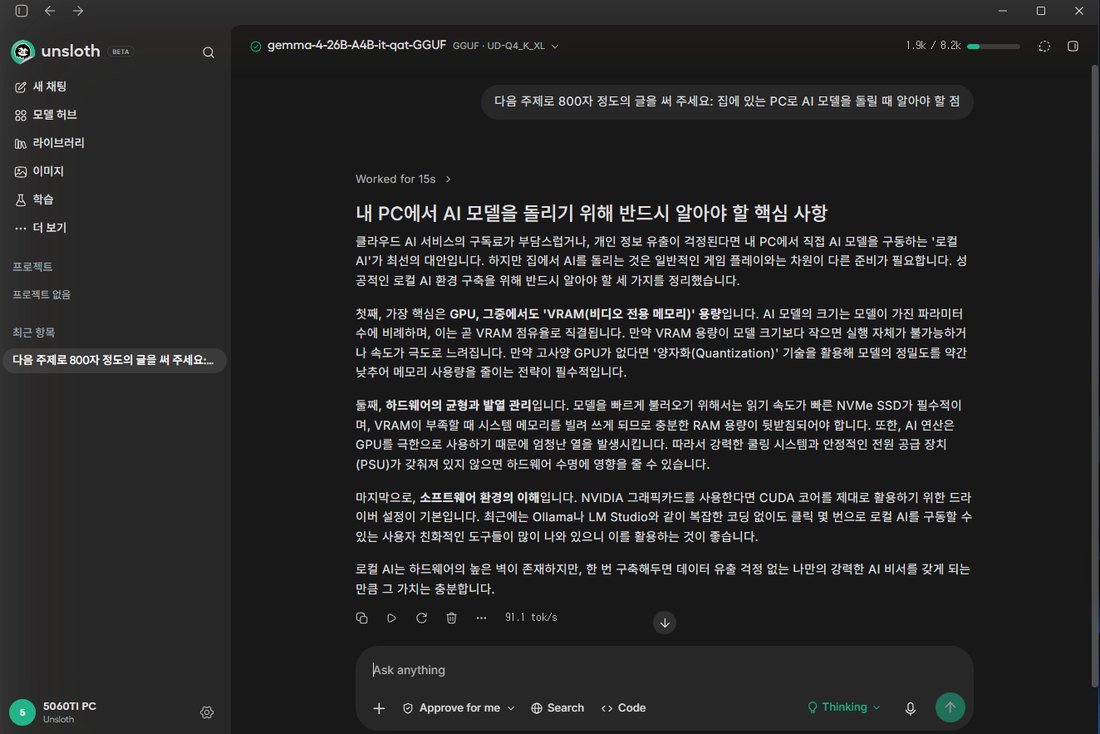
생각을 켠 채 800자 글을 쓰게 한 화면입니다. 생각에 15초를 썼고, 답 아래에 초당 91.1토큰이 표시됩니다.
테스트 PC와 실행 프로그램
| 부품 | 사양 |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti (VRAM 16GB, 전력 제한 180W) |
| GPU 연결 | PCIe 3.0 x8 (메인보드가 PCIe 3.0까지 지원) |
| CPU | Intel Core i5-9400F (6코어 6스레드) |
| 시스템 램 | DDR4 32GB (16GB × 2, 2666MT/s) |
| 저장장치 | Crucial MX500 1TB SATA SSD |
| 운영체제 | Windows 11 Pro |
| 실행 프로그램 | Unsloth Studio 데스크톱(베타) 2026.9.14 |
| 엔진 | llama.cpp 0.5.0-dev (build 11160, commit a3c12db9d, Unsloth가 빌드한 것) |
| GPU 드라이버 | 616.92 |
| 윈도우 전원 구성표 | 균형 조정 |
| 측정 스크립트 | Python 3.14.3, requests 2.34.2, psutil 7.2.2 |
| 샘플링 | 따로 지정하지 않음(프로그램 기본값) |
| 측정 날짜 | 2026년 10월 4일 |
| 측정 방법 | Unsloth Studio의 OpenAI 호환 API(127.0.0.1:8888)로 같은 질문을 반복해서 보냄. 속도는 첫 토큰이 나온 뒤부터 잰 생성 속도 |
이 블로그는 로컬 AI 테스트 프로그램을 LM Studio에서 Unsloth Studio로 바꿨습니다. 이유는 105번 글에 적었습니다. 테스트 PC 두 대의 사양과 측정 방법은 소개 페이지에 있습니다.
테스트한 모델: Gemma 4 26B A4B QAT
구글이 만든 Gemma 4 가운데 MoE(Mixture of Experts) 구조를 쓴 모델입니다. 전체 파라미터는 25.2B이지만, 토큰 하나를 만들 때는 익스퍼트 128개 중 8개와 공용 1개만 씁니다. 그래서 활성 파라미터는 약 4B이고, 이름의 A4B가 이 뜻입니다. QAT는 양자화(파일을 줄이는 것)를 미리 감안하고 학습시켰다는 뜻입니다.
| 항목 | 내용 |
|---|---|
| 파라미터 | 전체 25.2B, 활성 약 4B |
| 구조 | MoE, 익스퍼트 128개 중 8개 + 공용 1개, 30레이어 |
| 받은 파일 | unsloth UD-Q4_K_XL 13.27GB |
| 함께 받는 파일 | 이미지 입력용 파일(mmproj) 1.11GB, MTP용 작은 모델 0.24GB. 합쳐서 14.62GB, 받는 데 약 3분 |
| 최대 컨텍스트 | 262,144토큰 |
| 입력 | 글, 이미지 |
| 라이선스 | Apache 2.0 |
아래는 구글이 모델 카드에 적은 벤치마크 점수입니다. 제작사가 직접 잰 값이고, 양자화하지 않은 원본 기준입니다.
| 벤치마크 | Gemma 4 12B | Gemma 4 26B A4B | Gemma 4 31B |
|---|---|---|---|
| MMLU Pro | 77.2 | 82.6 | 85.2 |
| AIME 2026 | 77.5 | 88.3 | 89.2 |
| LiveCodeBench v6 | 72.0 | 77.1 | 80.0 |
| Codeforces | 1659 | 1718 | 2150 |
제작사 점수로는 26B A4B가 12B보다 모든 항목에서 높습니다. 이 PC에서 직접 낸 문제에서는 어땠는지는 아래 정리 절에서 비교합니다.
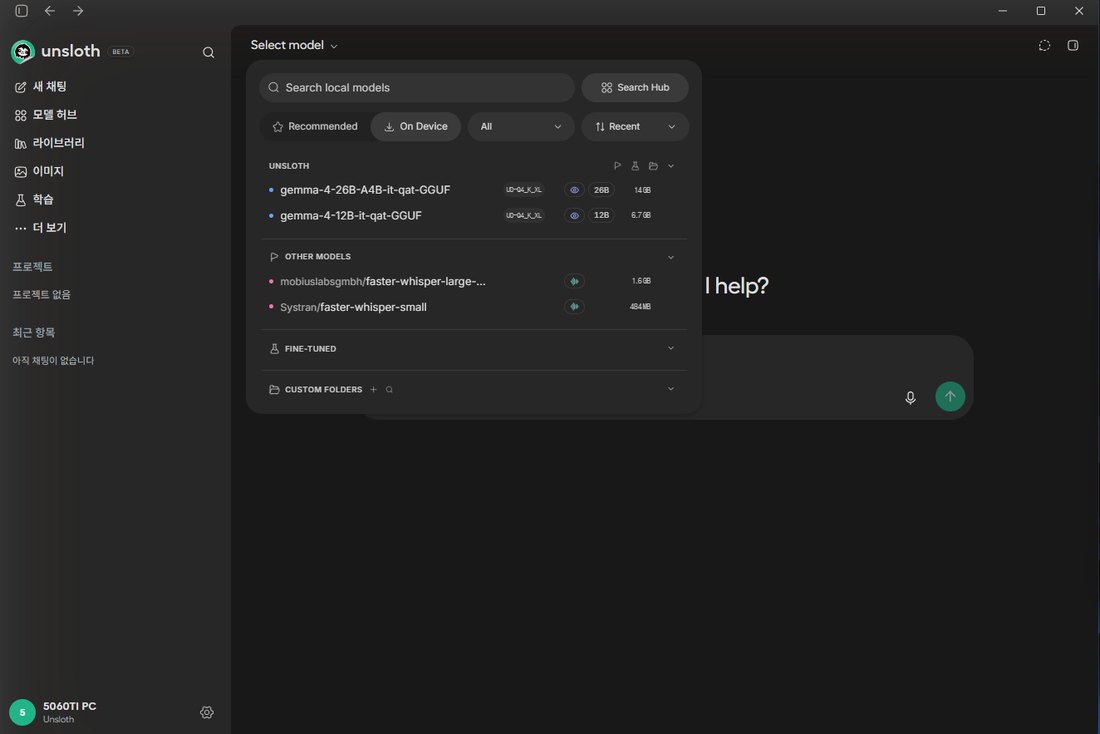
모델 선택 창입니다. 받아 둔 Gemma 4 26B A4B QAT(14GB)와 12B QAT(6.7GB)가 보입니다. 눈 모양은 이미지를 읽을 수 있다는 표시입니다.
Unsloth Studio 기본값(Auto)은 어떻게 올렸나
모델 이름 옆의 설정을 열면 실행 설정 창이 나옵니다. 컨텍스트(모델이 한 번에 기억하는 글의 길이)는 기본이 Auto입니다. 예상 메모리가 GPU 22.68GiB, 전체 24.24GiB로 나오고 "Exceeds GPU memory"(GPU 메모리를 넘음)라는 경고가 붙습니다. 최대 컨텍스트 기준으로 계산한 값으로 보이며, Auto로 두면 VRAM에 맞게 컨텍스트를 줄여서 올립니다.
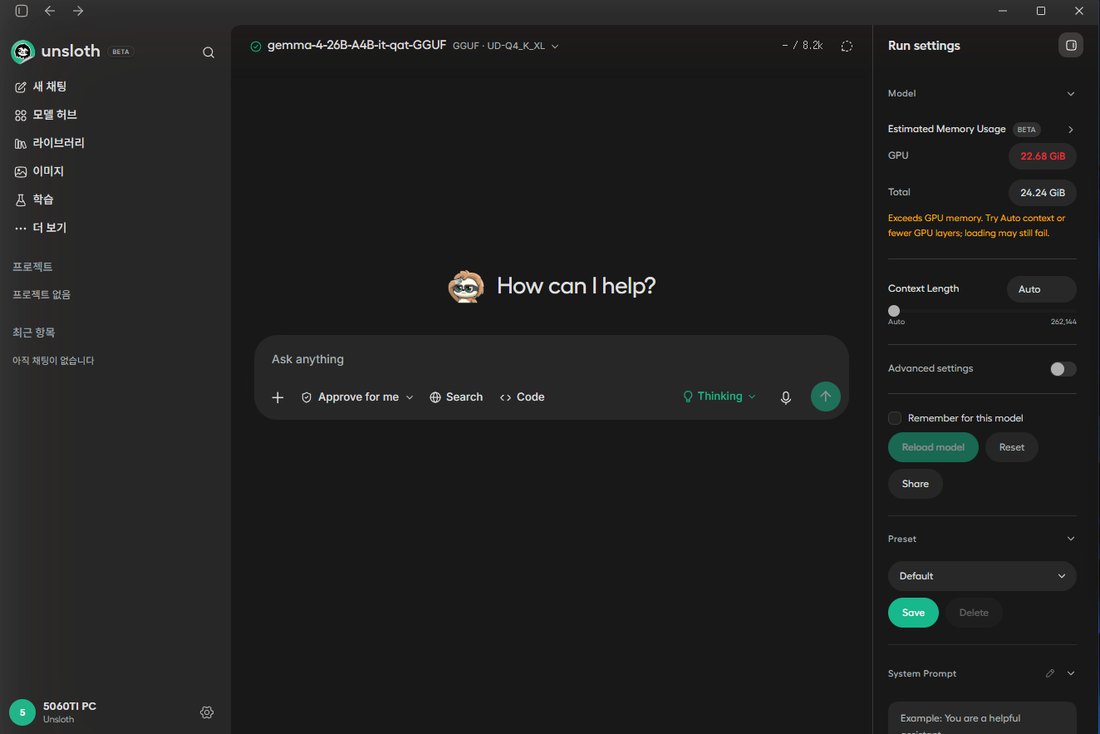
실행 설정 창입니다. 예상 메모리가 VRAM을 넘는다고 경고하지만, Context Length가 Auto라서 그대로 로드됩니다.
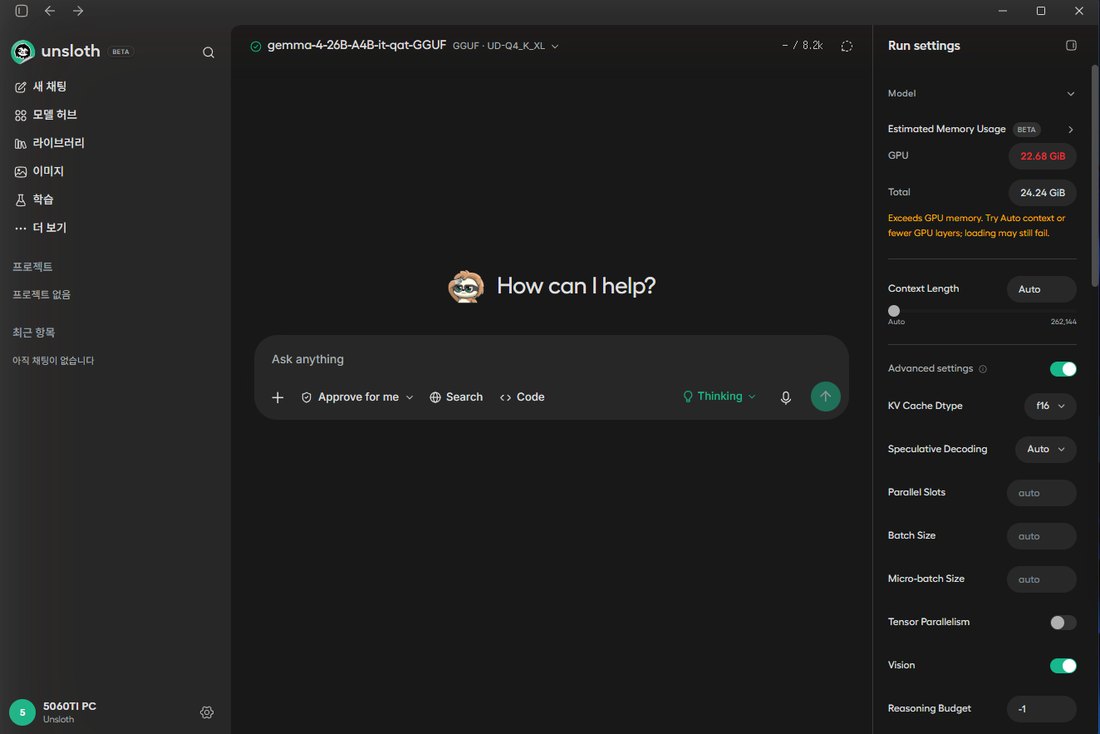
고급 항목의 기본값입니다. KV 캐시 f16, Speculative Decoding Auto, Vision 켬, Reasoning Budget -1(제한 없음)입니다.
Auto로 올렸을 때 실제로 적용된 값은 이렇습니다.
| 설정 | Auto가 고른 값 | 뜻 |
|---|---|---|
| 컨텍스트 | 8,192 | 한 번에 기억하는 토큰 수. 최대는 262,144 |
| --fit on | 켬 | VRAM에 맞춰 올릴 양을 프로그램이 정함 |
| --spec-type draft-mtp | MTP 켬 | 작은 보조 모델이 다음 토큰을 미리 예측해 속도를 높이는 기능(Speculative Decoding의 한 종류) |
| --no-mmproj-offload | 이미지 입력용 파일은 CPU | VRAM을 아끼는 대신 사진을 읽는 시간이 길어짐 |
| KV 캐시 | f16 | 줄이지 않은 기본값 |
같은 PC에서 Gemma 4 12B QAT를 Auto로 올리면 컨텍스트는 262,144로 잡히고 MTP는 켜지지 않았습니다. 모델 크기에 따라 Auto가 고르는 값이 다릅니다.
모델을 고르면 오른쪽 위에 로드 중이라는 알림이 뜹니다.
로드가 끝난 화면입니다. 오른쪽 위에 컨텍스트 8.2k가 표시됩니다.
VRAM과 시스템 램: Auto에서 VRAM 14.1GB, 램 3.5GB
로드 직전과 직후의 GPU 메모리와 PC 전체 램의 차이를 쟀습니다. 로드 전에 윈도우와 다른 프로그램이 VRAM 약 0.7GB, 램 약 11GB를 쓰고 있었습니다.
| 컨텍스트 | 모델이 쓴 VRAM | PC 전체 VRAM | 늘어난 시스템 램 | 로드 시간 | 16GB에서 |
|---|---|---|---|---|---|
| 8,192 (Auto) | 14.1GB | 14.8GB | 3.5GB | 30.4초 (다시 로드 22.8초) | 제한적 |
| 32,768 | 14.3GB | 15.0GB | 4.0GB | 22.6초 | 제한적 |
| 65,536 | 14.3GB | 14.9GB | 5.0GB | 24.6초 | 제한적 |
| 131,072 | 14.4GB | 15.1GB | 6.5GB | 27.4초 | 제한적 |
| 262,144 (최대) | 14.8GB | 15.5GB | 8.4GB | 47.0초 | 제한적 (아래 "설정을 바꾸면" 참고) |
컨텍스트를 32배로 늘려도 VRAM은 0.7GB밖에 늘지 않았습니다. 대신 시스템 램이 3.5GB에서 8.4GB로 늘었습니다. Unsloth Studio가 --fit on으로 VRAM을 넘지 않게 맞추면서, 넘치는 부분을 시스템 램에 두기 때문입니다. 그만큼 CPU가 하는 일이 늘어서 아래 표처럼 속도가 내려갑니다. 어느 크기든 남는 VRAM이 2GB가 안 돼서 판정은 "제한적"입니다.
로드 시간은 처음 30.4초, 모델만 내렸다가 바로 다시 올리면 22.8초였습니다. 이 PC는 SATA SSD라서 NVMe SSD보다 오래 걸립니다. 낮에 처음 쟀을 때의 값(8,192에서 24.4초, PC 전체 VRAM 14.7GB)과는 조금 다릅니다.
생성 속도: Auto에서 약 94t/s
"집에 있는 PC로 AI 모델을 돌릴 때 알아야 할 점"으로 800자 글을 쓰게 했습니다. 생각을 끈 것 3번, 켠 것 3번입니다.
| 생각 | 생성 속도 | 생각에 쓴 토큰 | 답까지 걸린 시간 |
|---|---|---|---|
| 끔 | 96.6 / 94.6 / 90.3 t/s | 0 | 6.6~8.2초 |
| 켬 | 96.0 / 97.9 / 98.4 t/s | 약 1,090~1,240 | 15.3~17.4초 |
생각을 켜도 속도는 같고, 생각하는 만큼 시간이 더 걸립니다. 800자 글 기준으로 약 9~11초가 더 들었습니다. 생각에 쓴 토큰 수는 프로그램이 따로 알려 주지 않아서 글자 수 비율로 어림한 값입니다.
5번 반복한 결과와 걸린 시간 나누기
같은 날 밤에 모델을 새로 로드하고 같은 질문을 5번 이어서 물었습니다(생각 끔).
| 순서 | 생성 속도 | 첫 토큰까지(TTFT) | 답 토큰 | 전체 시간 |
|---|---|---|---|---|
| 1번째 (로드 직후) | 83.5t/s | 0.69초 | 547 | 7.2초 |
| 2번째 | 93.1t/s | 0.48초 | 584 | 6.7초 |
| 3번째 | 95.4t/s | 0.70초 | 537 | 6.3초 |
| 4번째 | 96.0t/s | 0.47초 | 634 | 7.1초 |
| 5번째 | 94.1t/s | 0.52초 | 595 | 6.8초 |
| 평균 (최소~최대, 표준편차) | 92.4t/s (83.5~96.0, 5.1) | 0.57초 | 579 | 6.8초 |
로드한 뒤 첫 글만 83.5t/s로 느렸고, 두 번째부터는 93~96t/s로 고르게 나왔습니다. 낮에 잰 3번(90.3~96.6)과 설정 비교 때 잰 3번(91.0~101.8)까지 합치면 11번 평균 93.5t/s입니다.
| 단계 | 생각 끔 | 생각 켬 |
|---|---|---|
| 모델 로드 (한 번만) | 처음 30.4초, 다시 로드 22.8초 | |
| 질문을 읽고 첫 토큰까지 | 0.5~0.7초 | 0.6~0.7초 |
| 생각 | 없음 | 약 13~14초 (약 1,280~1,440토큰) |
| 답 쓰기 | 약 6~7초 (537~634토큰) | 약 4~5초 |
| 질문부터 답 끝까지 | 6.3~7.2초 | 17.6~19.3초 |
생각을 켰을 때 걸리는 시간의 70% 이상이 생각 단계입니다. 답만 빨리 받으려면 생각을 끄고, 계산이 들어가면 켜는 식으로 나눠 쓰는 편이 낫습니다.
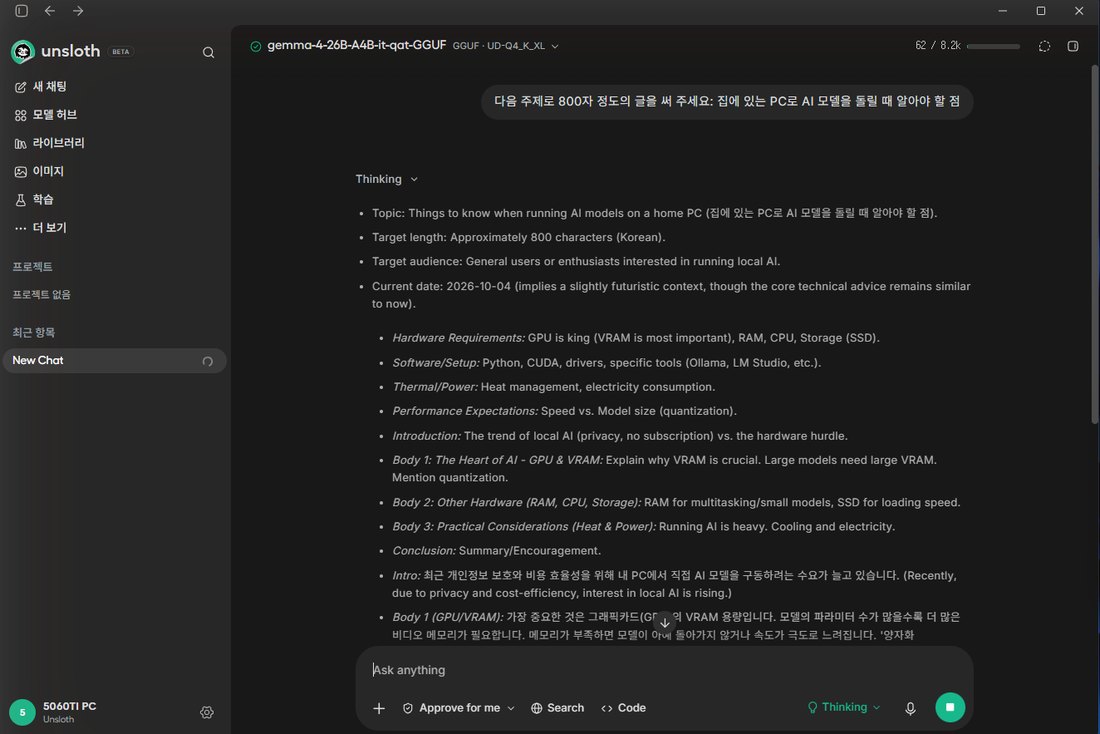
생각을 켜면 답을 쓰기 전에 생각하는 내용이 먼저 나옵니다.
컨텍스트를 늘리면 속도가 내려간다
컨텍스트만 바꿔 다시 로드하며 같은 800자 글을 쟀습니다(생각 끔 2번).
| 컨텍스트 | 생성 속도 (생각 끔) | 생각 켬 800자 글 | 15,000자 요약 TTFT | 사진 TTFT |
|---|---|---|---|---|
| 8,192 (Auto) | 100 / 101 t/s | 17.8초 | 4.2초 | 29.9초 |
| 16,384 | 100 / 99 t/s | 14.0초 | 4.2초 | 29.2초 |
| 32,768 | 93 / 92 t/s | 19.0초 | 4.6초 | 30.5초 |
| 65,536 | 82 / 79 t/s | 21.3초 | 5.5초 | 29.7초 |
| 131,072 | 63 / 64 t/s | 21.3초 | 6.9초 | 29.7초 |
TTFT는 첫 토큰까지 걸린 시간입니다. 16,384까지는 속도가 같고, 32,768에서 약 8%, 131,072에서 약 37% 느려졌습니다. 긴 문서를 다룰 일이 없다면 Auto(8,192)나 16,384가 가장 빠릅니다. 긴 문서를 넣는다면 32,768이 속도를 크게 잃지 않는 선입니다.
설정을 바꾸면: 빨라지는 설정과 안 되는 조건
기본값(Auto)에서 설정을 하나씩만 바꿔 다시 로드하고, 같은 800자 글을 3번씩 쟀습니다(생각 끔 평균). 설정은 Unsloth Studio API의 로드 옵션으로 바꿨습니다. KV 캐시와 Speculative Decoding은 실행 설정 창의 고급 항목에도 있습니다.
| 설정 | 생성 속도 | 생각 켬 800자 글 | 사진 TTFT | PC 전체 VRAM | 늘어난 시스템 램 |
|---|---|---|---|---|---|
| Auto (기본값, 컨텍스트 8,192) | 94.9t/s | 16.9초 | 29.9초 | 14.8GB | 3.4GB |
| MTP 끔 | 75.4t/s | 23.1초 | 29.5초 | 14.4GB | 3.2GB |
레이어를 모두 GPU에 고정 (--fit off, GPU 레이어 99) | 107.0t/s | 15.1초 | 31.0초 | 15.6GB | 3.3GB |
이미지 입력용 파일을 GPU에 (--mmproj-offload) | 75.9t/s | 25.3초 | 1.8초 | 14.7GB | 3.6GB |
| 이미지 입력 끔 | 98.9t/s | 13.5초 | - | 14.8GB | 2.0GB |
| 컨텍스트 131,072, KV 캐시 기본(f16) | 약 63t/s | 21.3초 | 29.7초 | 15.1GB | 6.5GB |
| 컨텍스트 131,072, KV 캐시 q8_0 | 67.0t/s | 23.6초 | 30.2초 | 15.4GB | 5.3GB |
| 컨텍스트 131,072, KV 캐시 q4_0 | 79.1t/s | 20.8초 | 29.9초 | 15.3GB | 4.5GB |
| 컨텍스트 262,144, KV 캐시 q4_0 | 62.9t/s | 26.7초 | 32.3초 | 15.5GB | 7.2GB |
| 컨텍스트 262,144, KV 캐시 기본(f16) | 9.9t/s | 2분 56초 | 75.0초 | 15.5GB | 18.7GB (최대 31.7GB 사용) |
- MTP가 약 26%를 올려 줍니다. 끄면 94.9t/s가 75.4t/s가 됩니다. Auto가 이 모델에서 MTP를 켜 주는 것이 기본값이 빠른 이유 중 하나입니다.
- 레이어를 모두 GPU에 고정하면 약 13% 더 빠릅니다. GPU 사용률도 42%에서 67%로 올랐습니다. Auto는 레이어 일부를 CPU에 남겨 둔다는 뜻입니다. 대신 PC 전체 VRAM이 15.6GB까지 차서, 브라우저나 다른 프로그램이 VRAM을 더 쓰면 느려지거나 로드가 안 될 수 있습니다.
- 사진을 자주 쓴다면 이미지 입력용 파일을 GPU에 올리는 쪽이 낫습니다. 첫 토큰까지 30초가 1.8초로 줄었습니다. 대신 그만큼 모델이 CPU로 더 밀려나서 글 속도가 약 20% 내려갑니다.
- 긴 컨텍스트에는 KV 캐시 q4_0이 효과가 있었습니다. KV 캐시는 지금까지 읽은 글을 기억해 두는 공간입니다. 이것을 줄이면 VRAM에 모델이 더 들어가서 131,072에서 약 63t/s가 79.1t/s가 됐습니다. 줄인 만큼 긴 글에서 답의 정확도가 달라지는지는 재지 않았습니다.
- 최대 컨텍스트 262,144를 기본 KV 캐시로 올리면 쓸 수 없는 속도가 됩니다. 로드에 3분 12초가 걸렸고, 글을 쓰는 동안 시스템 램 32GB 중 31.7GB가 찼고, GPU 사용률은 3% 아래였습니다. MTP도 켜지지 않았습니다. 같은 컨텍스트를 KV 캐시 q4_0으로 올리면 62.9t/s로 쓸 만했습니다. 위 VRAM 표의 262,144(47초, 램 8.4GB 증가)는 로드만 하고 글은 쓰지 않은 값입니다. 로드 시간과 램 증가는 올릴 때마다 달랐습니다.
한 가지 조심할 점이 있습니다. API로 넘긴 추가 옵션(llama_extra_args)은 그다음 로드에도 그대로 남았습니다. 빈 목록을 다시 보내야 기본값으로 돌아갑니다. 처음에 이것을 모르고 재서 설정 4개에 --mmproj-offload가 섞였고, 지우고 다시 쟀습니다. 위 표는 다시 잰 값입니다.
다른 곳의 측정과 견주기
같은 모델을 16GB 그래픽카드에서 잰 다른 글 두 편과 조건을 나란히 놓았습니다. 두 글의 숫자는 각 글쓴이가 잰 값입니다.
| 항목 | 이 글 | njannasch.dev (2026년 5월) | glukhov.org |
|---|---|---|---|
| 그래픽카드 | RTX 5060 Ti 16GB | RTX 5060 Ti 16GB | RTX 4080 16GB |
| CPU | i5-9400F (6코어) | AMD Ryzen 7 | i7-14700 |
| 파일 | QAT UD-Q4_K_XL 13.27GB | UD-IQ3_XXS 11.2GB | UD-IQ4_XS |
| 프로그램 | Unsloth Studio (llama.cpp build 11160) | llama-server | llama-cli |
| 컨텍스트 | 8,192 (Auto) | 262,144 | 19K / 32K / 64K |
| KV 캐시 | f16 | q4_0 | 적혀 있지 않음 |
| MTP | 켬 | 쓰지 않음 | 적혀 있지 않음 |
| 생성 속도 | 평균 93.5t/s | 96~99t/s | 121.7 / 114.9 / 96.1t/s |
| VRAM | PC 전체 14.8GB | 최대 13.2GB | 14.7~14.9GB |
같은 RTX 5060 Ti인 첫 번째 글은 파일이 2GB 더 작습니다. 그래서 모델 전체가 VRAM에 들어가고, MTP 없이도 최대 컨텍스트에서 96~99t/s가 나옵니다. 이 글의 파일은 13.27GB라서 VRAM이 빠듯하고, 컨텍스트를 늘리면 시스템 램으로 넘어가 느려집니다. 16GB에서 긴 컨텍스트를 쓰려면 더 작은 양자화 파일과 KV 캐시 q4_0 조합이 맞다는 점은 이 글의 설정 비교와도 같은 방향입니다. 두 번째 글은 그래픽카드와 CPU가 더 빠른 PC입니다. 컨텍스트가 커질수록 느려지는 모양(19K에서 64K로 가면 약 21% 감소)은 이 PC(8,192에서 65,536으로 가면 약 20% 감소)와 비슷합니다.
화면에서 돌린 영상
새 채팅을 열고 질문 하나를 보낸 영상입니다(28초, 소리 없음).
이 영상의 속도는 초당 15토큰으로, 위 표의 숫자보다 훨씬 느립니다. 화면 녹화 프로그램이 CPU를 100% 가까이 쓰는 동안 찍었기 때문입니다. 이 PC의 CPU는 6코어입니다. 이 모델은 평소에도 GPU 사용률이 35~47%에 그치고, 로드하면 시스템 램이 3.5GB 늘어납니다. 일부가 CPU에서 돈다는 뜻입니다. 그래서 CPU가 바쁘면 속도가 크게 떨어집니다. 표의 숫자는 녹화하지 않을 때 잰 값입니다. 녹화에 쓴 프로그램은 103번 글에서 소개했습니다.
산수: 생각을 끄면 0/5, 켜면 5/5
"사과 한 상자에 24개가 들어 있습니다. 3상자를 사서 19개를 먹고, 남은 것을 5명이 똑같이 나누면 한 사람당 몇 개이고 몇 개가 남나요?"를 5번씩 물었습니다. 정답은 한 사람당 10개, 남는 것 3개입니다.
| 생각 | 정답 | 답 | 걸린 시간 |
|---|---|---|---|
| 끔 | 0 / 5 | "11개, 1개" 3번, "10개, 1개" 2번 | 약 0.6초 |
| 켬 | 5 / 5 | "10개, 3개" 5번 | 2.5~3.8초 (생각 약 200~300토큰) |
생각을 끄면 계산 과정 없이 바로 답을 적어서 틀립니다. 3초만 더 쓰면 맞히므로, 계산이 들어가는 질문에는 생각을 켜 두는 편이 낫습니다. LM Studio로 쟀을 때도 끔 0/5, 켬 5/5로 같았습니다.
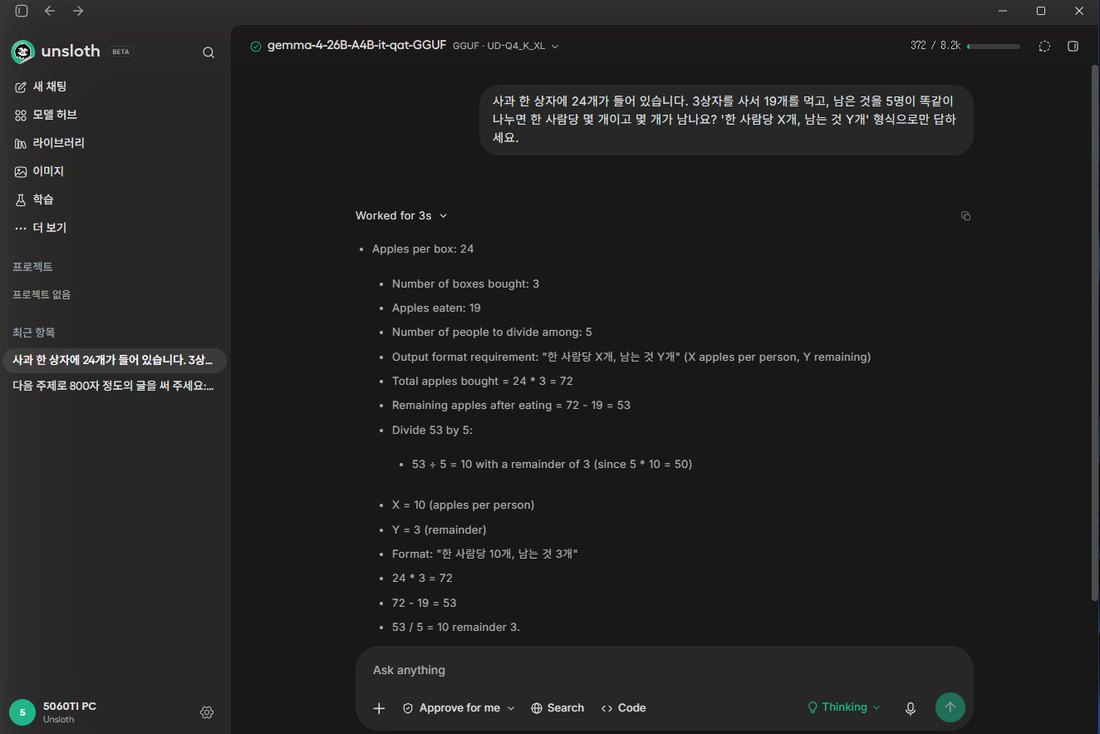
생각을 켠 답입니다. 3초 생각한 뒤 "한 사람당 10개, 남는 것 3개"로 맞혔습니다.
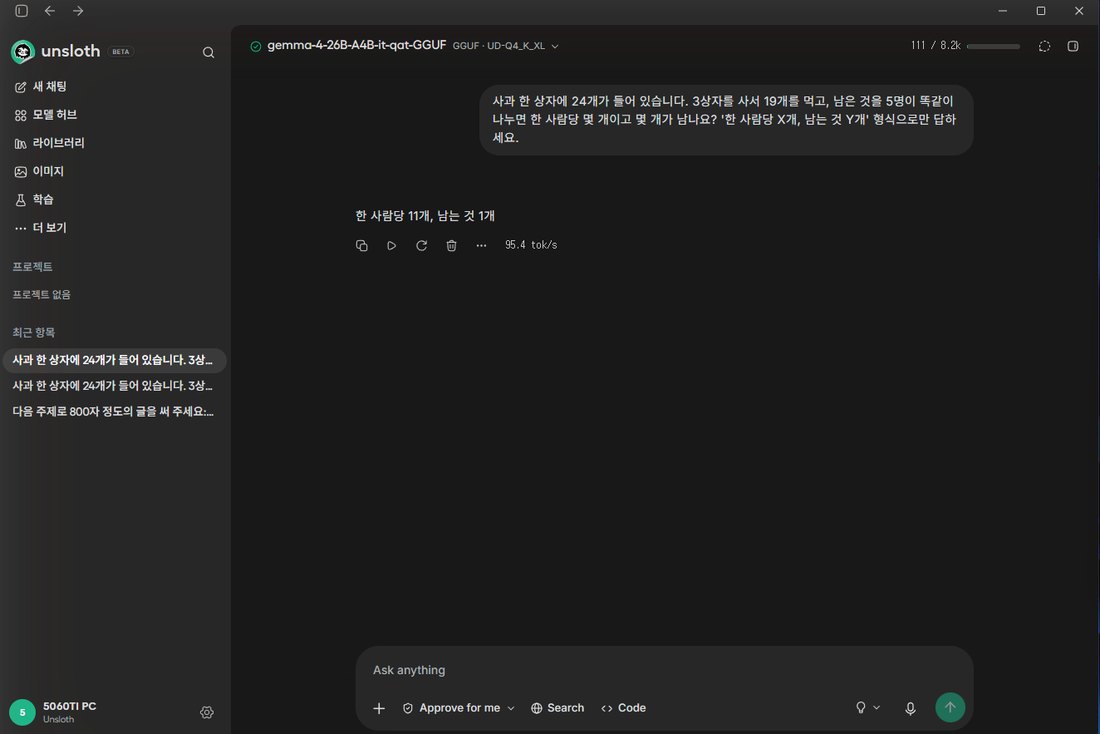
생각을 끈 답입니다. "한 사람당 11개, 남는 것 1개"로 틀렸습니다.
코딩: 파이썬 8문제를 3번씩, 생각 끔 19/24 · 켬 21/24
파이썬 함수 8개를 짜게 하고, 숨겨 둔 테스트로 채점했습니다. 문제는 구간 합치기, 로마 숫자 변환, 수식 계산기, 가장 긴 회문, 다음 영업일, 많이 나온 낱말, 나선 순서, 한글 숫자를 정수로 바꾸기입니다. 컨텍스트는 Auto(8,192)이고, 8문제를 처음부터 끝까지 3번 풀게 했습니다.
| 생각 | 1회 | 2회 | 3회 | 합계 | 8문제 전체 시간 |
|---|---|---|---|---|---|
| 끔 (답 최대 2,000토큰) | 6 / 8 | 6 / 8 | 7 / 8 | 19 / 24 | 39~58초 |
| 켬 (최대 8,000토큰) | 7 / 8 | 7 / 8 | 7 / 8 | 21 / 24 | 3분 53초~4분 47초 |
| 문제 | 생각 끔 (3번 중) | 생각 켬 (3번 중) |
|---|---|---|
| 구간 합치기, 로마 숫자, 가장 긴 회문, 다음 영업일, 많이 나온 낱말, 나선 순서 | 3번 모두 통과 | 3번 모두 통과 |
| 수식 계산기 | 1번 통과 (2번은 2,000토큰 안에 못 끝냄) | 3번 모두 통과 |
| 한글 숫자를 정수로 | 0번 (2번은 토큰 부족, 1번은 틀린 코드) | 0번 (3번 모두 8,000토큰 안에 못 끝냄) |
쉬운 여섯 문제는 생각을 꺼도 2~3초에 답이 나왔고 3번 모두 통과했습니다. 수식 계산기는 생각을 켜야 안정적으로 통과했습니다. 한글 숫자 문제("삼천이백오십일"을 3251로)는 여섯 번 모두 실패했습니다. 생각을 켜면 생각만 길어지다가 토큰이 떨어졌습니다. 직접 만든 8문제라서 다른 곳의 점수와 비교할 수는 없고, 같은 PC의 다른 모델과 비교하는 용도입니다.
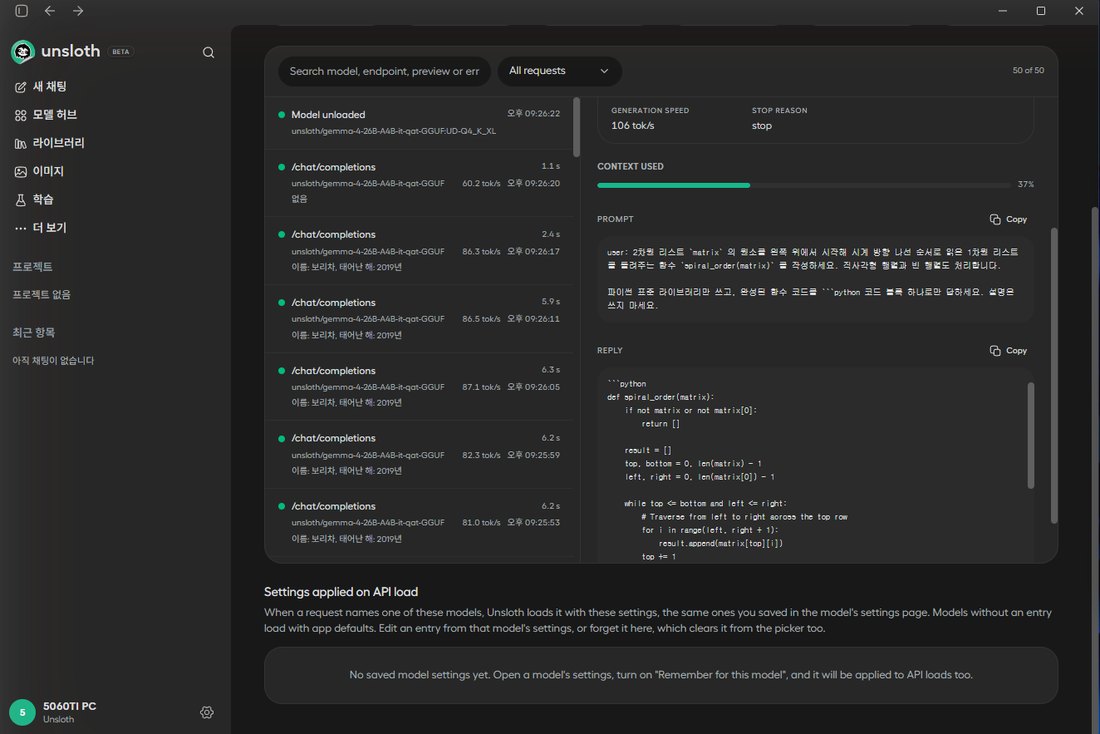
Unsloth Studio의 API 기록 화면입니다. 측정에 쓴 요청과 답, 속도가 하나씩 남습니다.
긴 글 요약과 긴 대화
컨텍스트 32,768로 올리고 이 블로그의 업데이트 기록을 넣어 세 문장으로 요약하게 했습니다(생각 끔).
| 넣은 글 | 입력 토큰 | TTFT | 생성 속도 | 결과 |
|---|---|---|---|---|
| 3,000자 | 1,607 | 1.8초 | 82.7t/s | 번호 붙인 세 문장, 내용 맞음 |
| 15,000자 | 7,980 | 3.9초 | 69.8t/s | 번호 붙인 세 문장, 내용 맞음 |
대화가 길어질 때를 보려고, 앞에 긴 글을 두고 한 문장짜리 질문을 붙였습니다.
| 앞에 쌓인 토큰 | TTFT | 생성 속도 |
|---|---|---|
| 1,100 | 1.2초 | 92.3t/s |
| 8,495 | 4.4초 | 78.8t/s |
| 20,896 | 7.4초 | 69.9t/s |
2만 토큰이 쌓여도 첫 토큰까지 7.4초였습니다. LM Studio 기본 설정에서는 10만 자 요약의 첫 토큰까지 78초가 걸렸는데, 조건이 달라 바로 비교할 수는 없지만 기다리는 시간은 훨씬 짧았습니다.
긴 문서에서 정보 찾기: 5번 모두 찾음
약 1만 토큰짜리 글의 10%, 30%, 50%, 70%, 90% 위치에 "블로그 관리자가 키우는 고양이 보리차는 2019년에 태어났다"는 문장을 하나 숨기고, 고양이 이름과 태어난 해를 물었습니다. 5번 모두 "이름: 보리차, 태어난 해: 2019년"으로 답했습니다. 문장을 숨기지 않은 글에서는 "없음"이라고 답했습니다. 첫 토큰까지는 1.1~6.1초였습니다.
전력과 온도: 평균 약 60W, 최고 49도
800자 글을 쓰는 동안 0.5초마다 그래픽카드 상태를 읽었습니다(컨텍스트 32,768, 생각 끔).
| 항목 | 값 |
|---|---|
| 쉬고 있을 때 전력 | 약 11.5W |
| 글 쓰는 동안 평균 전력 | 60~62W |
| 최고 전력 | 78W |
| 최고 온도 | 48~49도 |
| 평균 GPU 사용률 | 35~36% |
| 토큰 하나에 쓴 전기 | 약 0.75J |
전력 제한 180W인 카드가 평균 60W만 썼습니다. GPU 사용률도 35% 안팎입니다. 활성 파라미터가 4B뿐인 MoE 구조라서 토큰 하나를 만들 때 GPU가 하는 계산이 적고, 나머지 시간은 CPU 쪽 작업을 기다리는 것으로 보입니다(추정). LM Studio로 쟀을 때도 GPU 사용률이 절반을 넘지 않았습니다.
없는 소설과 사진
실제로 없는 소설("윤서하의 2018년 장편소설 『푸른 등대의 겨울』")의 줄거리를 물었습니다. 2번 물었고 2번 모두 그런 작품은 확인되지 않는다고 답했습니다. 줄거리를 지어내지 않았습니다.
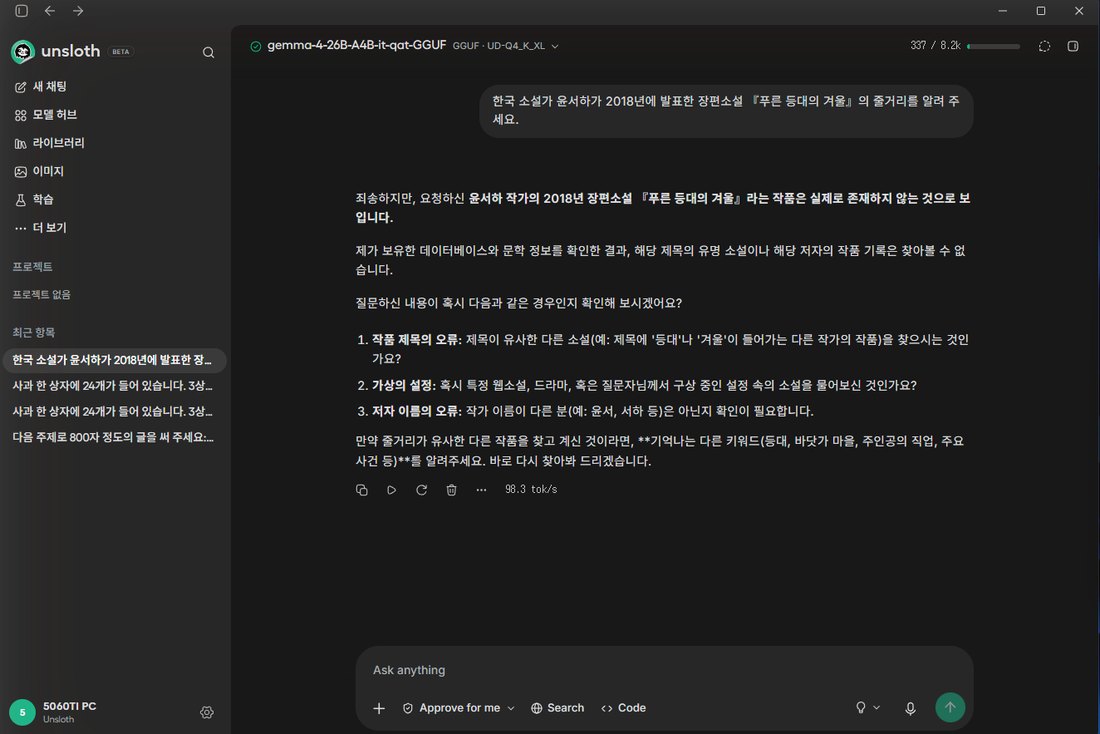
없는 소설을 물은 화면입니다. 확인되지 않는다고 답하고, 실존하지 않는 작품일 수 있다고 적었습니다.
모래시계 두 개가 놓인 사진을 주고 무엇이 보이는지 물었습니다. 설정을 바꿔 가며 모두 13번 물었습니다. 13번 모두 오른쪽 모래시계 안에 다른 것이 들어 있다고 짚었지만, "회로 기판"이나 "전자 부품"이라고 맞게 말한 것은 7번이었고 나머지 6번은 "기계 부품"이라고 했습니다. 다만 첫 토큰까지 약 30초가 걸렸습니다. 이미지 입력용 파일을 CPU에 두는 설정(--no-mmproj-offload) 때문입니다. 같은 PC의 Gemma 4 12B QAT는 이 파일이 VRAM에 올라가서 약 1.2초였습니다.
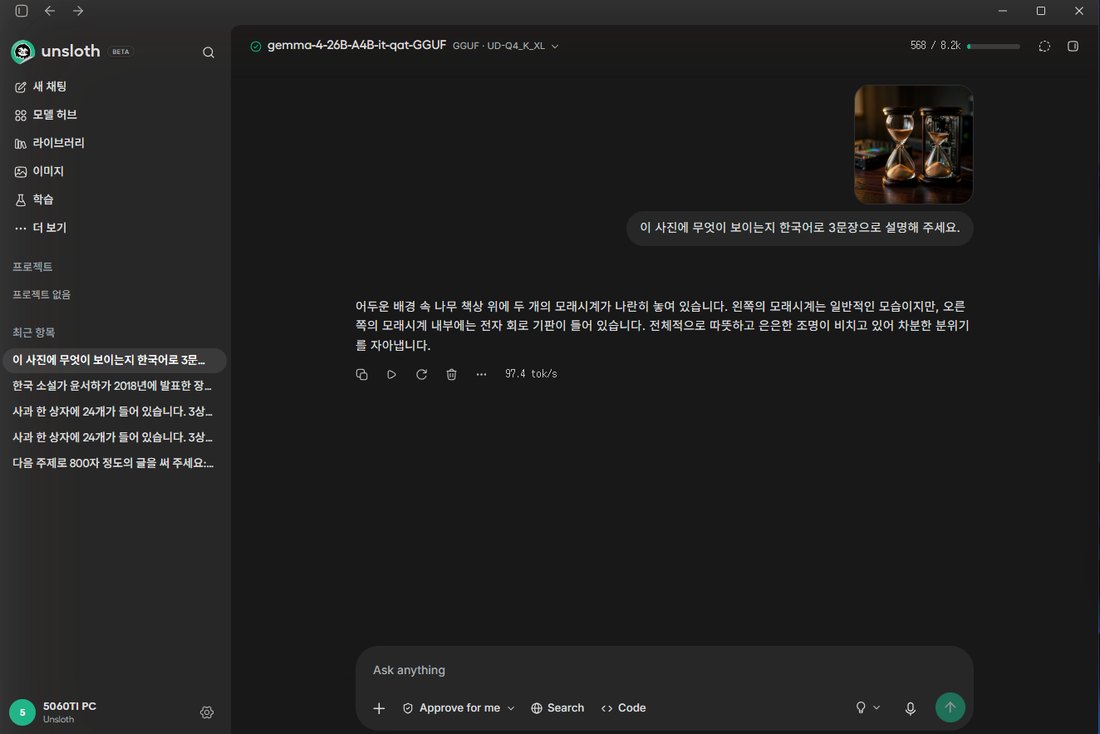
사진을 붙여 넣고 물은 화면입니다. 설명은 맞았지만 답이 시작되기까지 약 30초를 기다려야 했습니다.
한국어 답 21개를 모두 확인했는데, 한자나 다른 나라 글자가 섞인 답은 없었습니다.
정리: 같은 PC의 Gemma 4 12B QAT와 비교
같은 날, 같은 프로그램(Unsloth Studio)으로 잰 Gemma 4 12B QAT(UD-Q4_K_XL)와 나란히 놓았습니다. 맨 오른쪽은 9월 29일에 LM Studio 기본 설정으로 잰 같은 모델의 다른 파일(Q4_0)입니다.
| 항목 | Gemma 4 26B A4B QAT (Unsloth) | Gemma 4 12B QAT (Unsloth) | Gemma 4 26B A4B QAT (LM Studio) |
|---|---|---|---|
| 파일 | UD-Q4_K_XL 13.27GB | UD-Q4_K_XL 6.26GB | Q4_0 15.63GB |
| Auto(기본) 컨텍스트 | 8,192 | 262,144 | 8,192 |
| Auto(기본) 속도 | 약 94t/s | 약 52t/s (MTP 꺼짐) | 약 21t/s |
| 컨텍스트 32,768 속도 | 약 92t/s | 92~96t/s (MTP 켜짐) | - |
| 컨텍스트 32,768 VRAM | 14.3GB | 9.6GB | - |
| 컨텍스트 131,072 | 14.4GB, 약 63t/s | 11.5GB, 92~96t/s | - |
| 산수 (끔 / 켬) | 0/5, 5/5 | 1/5, 5/5 | 0/5, 5/5 |
| 코딩 8문제 (끔 / 켬) | 6~7/8, 7/8 (3번씩) | 6/8, 7/8 (1번씩) | - |
| 사진 TTFT | 약 30초 | 약 1.2초 | - |
- Unsloth Studio 기본값만으로 LM Studio 기본 설정보다 4배 넘게 빨랐습니다. 다만 파일이 다르고(13.27GB와 15.63GB), Unsloth Studio는 MTP를 켜고 VRAM을 14.1GB까지 썼습니다. LM Studio 때는 12.4GB였습니다. 프로그램 차이, 파일 차이, 설정 차이가 함께 들어 있는 숫자입니다.
- 이 PC에서 낸 문제에서는 12B와 결과가 같았습니다. 산수와 코딩 8문제 통과 수가 거의 같습니다. 문제 수가 적어서 26B가 더 낫다는 것도, 같다는 것도 이 결과만으로 말하기는 어렵습니다. 제작사 벤치마크에서는 26B A4B가 더 높습니다.
- 16GB에서는 12B가 쓰기 편합니다. 12B는 컨텍스트 131,072에서도 11.5GB에 속도가 그대로이고, 사진도 1초 남짓에 읽습니다. 26B A4B는 VRAM을 거의 다 쓰고, 컨텍스트를 늘리면 느려지고, 사진은 30초를 기다려야 합니다.
- 26B A4B를 쓴다면 컨텍스트는 Auto나 32,768까지가 속도를 잃지 않는 선입니다. 더 긴 컨텍스트가 필요하면 KV 캐시를 q4_0으로 줄이는 편이 빨랐습니다(131,072에서 약 79t/s).
- 속도를 더 내려면 레이어를 모두 GPU에 고정합니다(약 107t/s). VRAM이 15.6GB까지 차므로 다른 프로그램을 닫고 써야 합니다.
16GB 그래픽카드에서 Gemma 4 12B를 처음 잰 결과는 82번 글에 있습니다. 내 그래픽카드에서 다른 모델이 어느 정도 속도로 도는지는 GPU 체험에서 볼 수 있습니다.
이 글의 한계
- 2026년 10월 4일, Unsloth Studio 2026.9.14(llama.cpp build 11160) 기준입니다. 베타 프로그램이라 버전이 바뀌면 Auto가 고르는 값과 속도가 달라질 수 있습니다.
- 5번 반복은 기본값(Auto)의 생각 끔 800자 글에만 했습니다. 컨텍스트별 표는 2번씩, 설정 비교 표는 3번씩 잰 값이고 사진과 요약은 조건마다 한 번입니다.
- 프로그램을 켠 직후의 첫 실행은 따로 재지 않았습니다. 프로그램이 켜져 있는 상태에서 모델만 올리고 내렸습니다.
- Auto에서 레이어 몇 개가 CPU에 남는지 숫자로는 확인하지 못했습니다. GPU 사용률과 시스템 램 증가, 레이어를 GPU에 고정했을 때의 속도 차이로 미루어 본 것입니다.
- UD-Q4_K_XL 파일 하나만 쟀습니다. 더 작은 파일(IQ3_XXS 등)이나 LM Studio 때의 Q4_0 파일은 Unsloth Studio에서 재지 않았습니다.
- KV 캐시를 줄였을 때 답의 품질이 달라지는지는 재지 않았습니다. 속도와 메모리만 봤습니다.
- 코딩 문제는 직접 만든 8문제입니다. 다른 곳의 점수와 비교할 수 없습니다.
- 다른 곳의 측정은 두 편만 찾아 견줬고, 조건(파일, CPU, 프로그램)이 달라 숫자를 바로 비교할 수는 없습니다.
- 생각에 쓴 토큰 수는 글자 수 비율로 어림한 값입니다.
- 영상은 녹화 때문에 속도가 느리게 찍혔습니다. 녹화가 속도를 얼마나 떨어뜨리는지는 따로 재지 않았습니다.
자주 묻는 질문
RTX 5060 Ti 16GB에서 Gemma 4 26B A4B QAT는 몇 t/s인가요?
Unsloth Studio 기본값(Auto, 컨텍스트 8,192)에서 800자 글 기준 약 94t/s였습니다(11번 평균 93.5t/s, 최소 83.5, 최대 101.8). 컨텍스트를 32,768로 늘리면 약 92t/s, 131,072로 늘리면 약 63t/s입니다. 레이어를 모두 GPU에 고정하면 약 107t/s까지 나왔습니다.
VRAM은 얼마나 쓰나요?
모델이 약 14.1GB를 썼고, 윈도우가 쓰는 몫까지 합치면 16GB 중 14.7~14.8GB였습니다. 시스템 램도 3.5GB 늘었습니다. 컨텍스트를 131,072로 늘려도 VRAM 15.1GB로 로드는 되지만, 시스템 램이 6.5GB 늘고 속도가 내려갑니다. 다만 다른 GPU 작업과 같이 쓰기는 어렵습니다.
16GB 그래픽카드에서는 Gemma 4 12B와 26B A4B 중 무엇이 낫나요?
이 PC에서 낸 산수와 코딩 문제에서는 결과가 거의 같았고, 속도도 비슷했습니다. 12B는 VRAM이 4GB 넘게 남고 사진도 빨리 읽어서 16GB에서는 쓰기 편합니다. 제작사 벤치마크 점수는 26B A4B가 더 높습니다.
사진을 읽을 때 왜 30초나 걸리나요?
Unsloth Studio가 이 모델을 올릴 때 이미지 입력용 파일(mmproj)을 CPU에 두기 때문입니다. VRAM을 아끼려는 설정입니다. 사진을 읽은 뒤 답을 쓰는 속도는 글만 물을 때와 같습니다. 이 파일을 GPU에 올리도록 바꾸면 1.8초로 줄지만, 글 속도는 약 76t/s로 내려갑니다.
댓글 0개