이번 주 깃허브에서 별을 가장 많이 받은 로컬 음성 AI 프로그램 VoiceStudio(0.5.6)를 RTX 5060 Ti 16GB PC에 직접 설치해 한국어로 써 봤습니다. 결론부터 말하면 기본 엔진(OmniVoice)은 50초 분량의 한국어 음성을 약 11초에 만들었습니다. 말하는 속도보다 4.5배쯤 빠르고, 그래픽카드 메모리(VRAM)는 PC 전체로 2.8~3.5GB만 썼습니다.
다만 들어 봤을 때 가장 사람 같았던 것은 추가로 설치한 VoxCPM2 엔진이었습니다. 대신 이 엔진은 같은 50초 분량에 2분 넘게 걸려, 말하는 속도보다 2.7배쯤 느렸습니다. 설치는 클릭 몇 번으로 끝났지만 프로그램과 모델을 합쳐 C 드라이브를 약 33GB 썼습니다.
이 글의 숫자는 모두 이 PC에서 직접 잰 값입니다. 시간은 앱에 들어 있는 로컬 API로 같은 문장을 여러 번 보내 쟀고, 발음은 만든 음성을 다시 받아써서 원래 문장과 글자를 비교했습니다. 듣고 판단한 자연스러움은 사람이 직접 들어 본 평가입니다.
글 중간중간에 실제로 만든 음성을 넣었습니다. 재생 단추를 눌러 직접 들어 보세요.
테스트 PC와 프로그램
| 항목 | 내용 |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti (VRAM 16GB, 전력 제한 180W), 드라이버 616.92 |
| CPU / 메모리 | Intel Core i5-9400F / DDR4 32GB |
| 저장장치 | SATA SSD 1TB (C 드라이브에 설치) |
| 운영체제 | Windows 11 Pro |
| 프로그램 | VoiceStudio 0.5.6 (Electron 데스크톱 앱, 2026년 9월 23일 공개) |
| 엔진 실행 환경 | Python 3.11.16, PyTorch 2.8.0 (CUDA 12.8) |
같은 PC로 Ternary Bonsai 2 27B, Qwen3.5 9B 같은 글 모델도 테스트했습니다. PC 사양과 측정 방법은 소개 페이지에 모아 두었습니다.
VoiceStudio는 어떤 프로그램인가
목소리 만들기, 목소리 복제, 영상 더빙, 받아쓰기, 오디오북 만들기를 내 PC 안에서 하는 무료 프로그램입니다. 제작자는 깃허브 소개에 "완전히 로컬에서 도는 일레븐랩스(ElevenLabs) 대안"이라고 적었습니다. 예전 이름은 OmniVoice-Studio입니다.
| 항목 | 내용 |
|---|---|
| 기본 음성 엔진 | k2-fsa/OmniVoice. 제작자 설명으로 600개 넘는 언어, 참고 음성 몇 초로 목소리 복제 |
| 고를 수 있는 음성 엔진 | 17종(VoxCPM2, CosyVoice 3, IndexTTS 2.5, GPT-SoVITS 등). 이 PC에서 바로 쓸 수 있던 것은 3종 |
| 받아쓰기 엔진 | faster-whisper(Whisper large-v3 Turbo), WhisperX 등 |
| 기타 | 로컬 API(OpenAI 형식과 같은 주소), MCP 서버 내장, 만든 음성에 보이지 않는 워터마크(기본 켬) |
| 라이선스 | AGPL-3.0. 개인이 쓰는 데는 제한이 없지만, 고쳐서 서비스로 내놓으면 고친 코드도 공개해야 합니다 |
| 깃허브 별 | 51,948개, 이번 주에만 16,475개 늘어남(2026년 10월 3일 확인) |
설치: 클릭 몇 번, 4분 안에 끝
설치는 세 단계였습니다. 설치 프로그램(214MB)을 실행하고, 앱이 처음 켜질 때 Python 실행 환경을 받고, 마지막으로 음성 모델 묶음(모델 팩)을 고릅니다.
| 단계 | 걸린 시간 | 받은 크기 |
|---|---|---|
| 설치 프로그램 실행 | 18초 | 설치 폴더 900MB |
| Python 실행 환경 | 약 2분 | 화면 표시 약 3.6GB, 설치 뒤 폴더 9.5GB |
| 모델 팩 '균형' | 약 1분 30초 | 4.8GB |
인터넷이 빨라서 화면에 처음 뜬 예상 시간(약 40분)보다 훨씬 빨리 끝났습니다. 설치 프로그램은 서명이 없는 파일이라고 제작자가 밝혔습니다. 이번에는 깃허브 릴리스에 올라온 SHA-256 값과 받은 파일이 같은지 확인하고 설치했습니다.
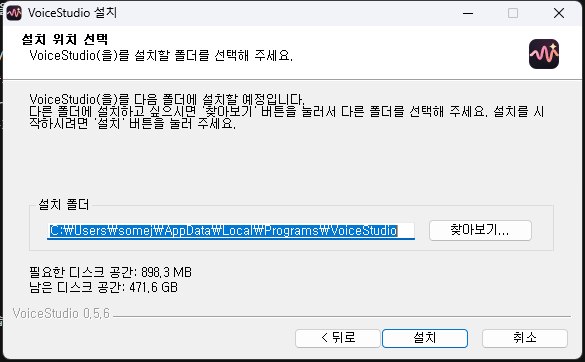
설치 위치 화면. 현재 사용자 폴더(AppData\Local\Programs)에 설치되고, 필요한 공간은 898.3MB로 나옵니다. 관리자 권한은 필요 없었습니다.
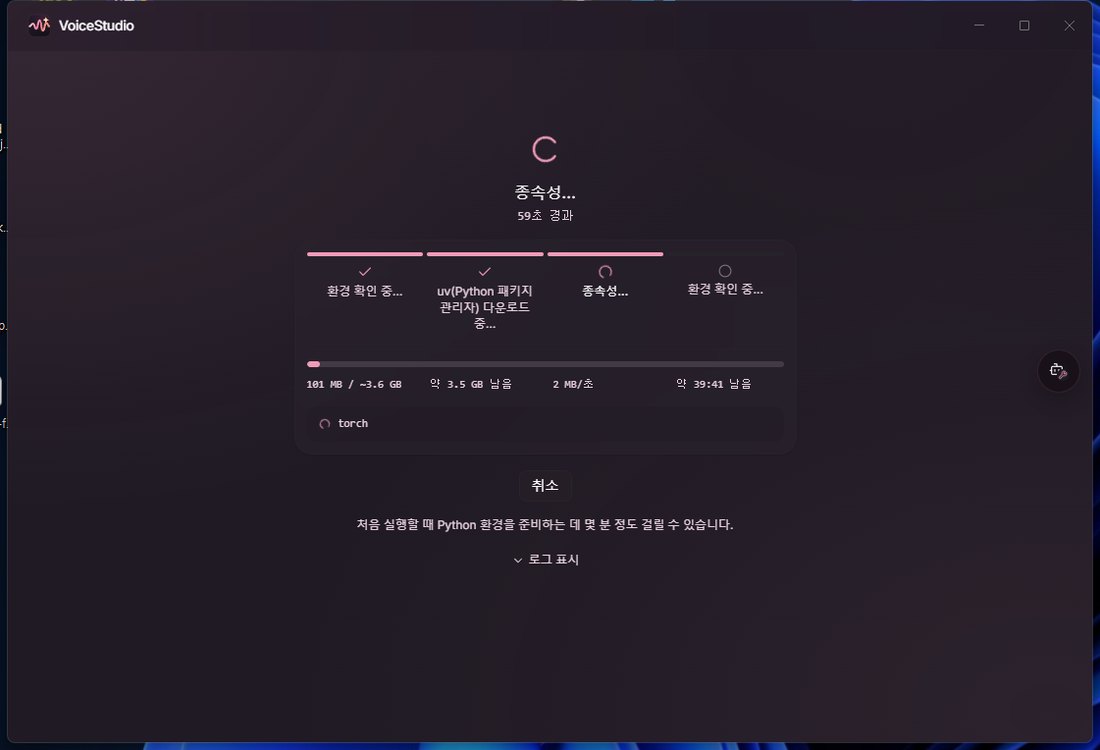
처음 실행하면 Python과 PyTorch를 받습니다. 화면에는 약 3.6GB, 남은 시간 39분으로 나왔지만 실제로는 2분쯤에 끝났습니다.
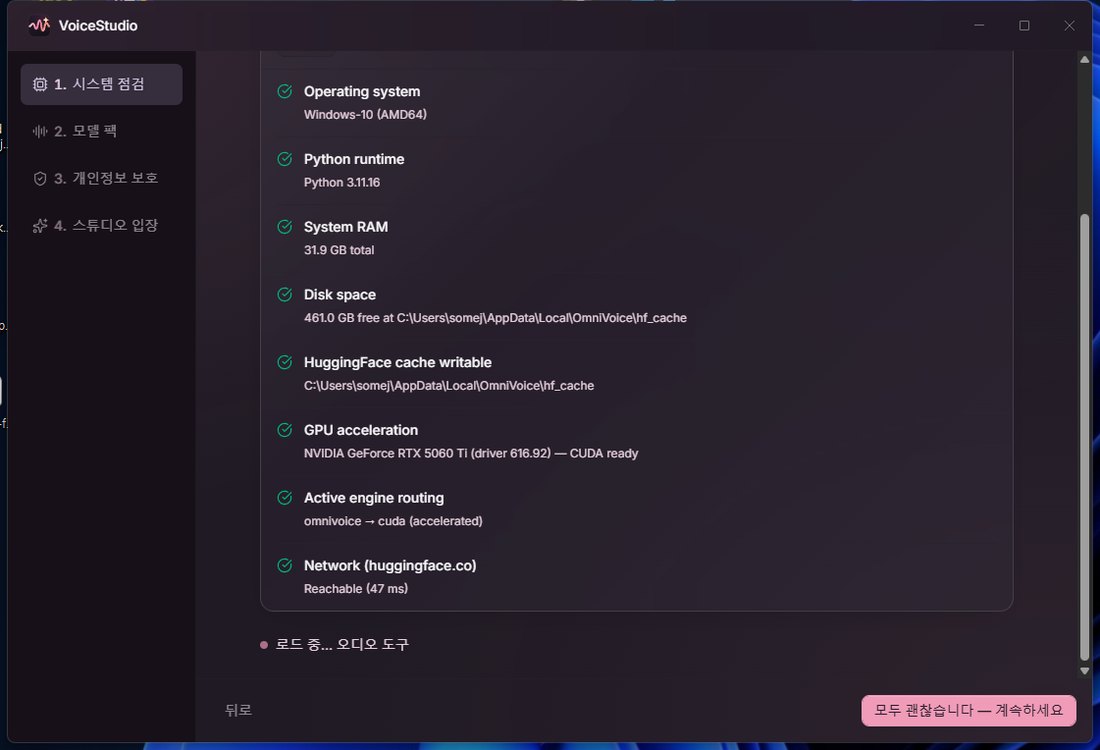
시스템 점검. 램 31.9GB, 디스크 461GB 남음, RTX 5060 Ti(드라이버 616.92) CUDA 준비 완료, 기본 엔진은 omnivoice → cuda로 나옵니다.
모델 팩은 네 가지 중에서 고릅니다. 기본으로 선택된 '균형'을 썼습니다.
| 모델 팩 | 크기 | 들어 있는 것 |
|---|---|---|
| 빠르게 | 2.7GB | 음성 엔진 2.4GB + 작은 받아쓰기 모델 |
| 균형 (기본) | 4.8GB | OmniVoice 2.4GB, Whisper large-v3 Turbo 1.6GB, 받아쓰기용 Whisper Tiny 0.104GB, Parakeet TDT v3 0.67GB |
| 품질 / 최대 | 8.5GB | 균형 + 더 큰 받아쓰기 모델(2.9GB) + 번역 모델(2.4GB) |
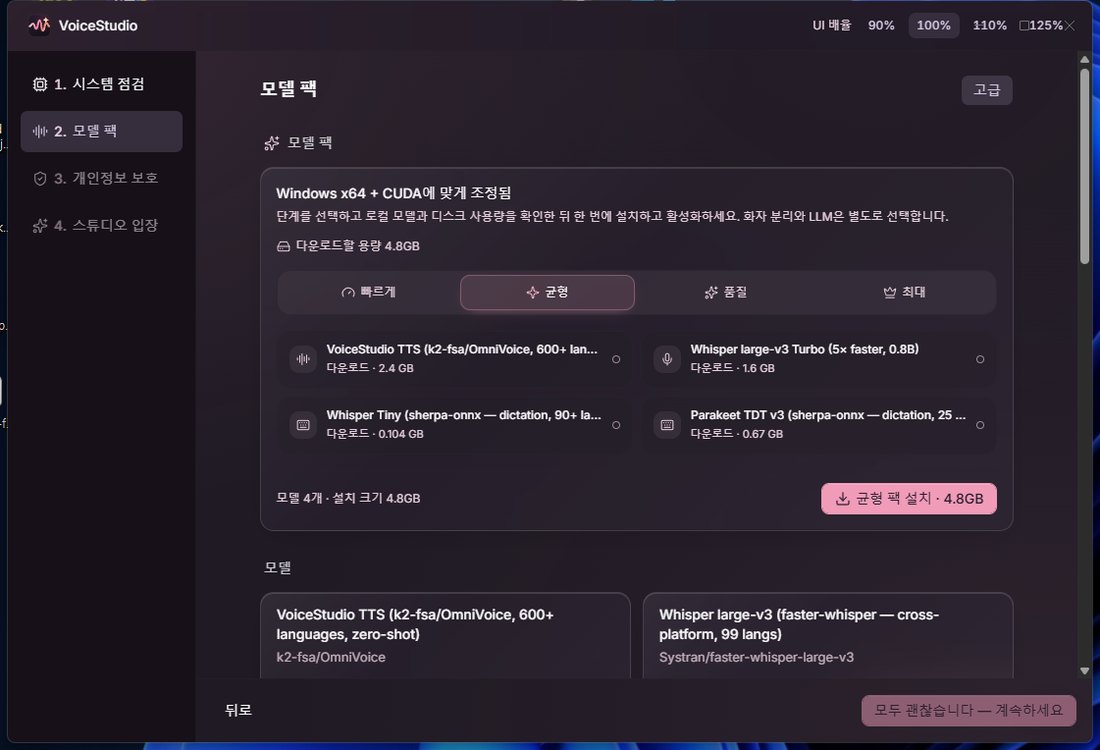
'균형' 모델 팩. OmniVoice(2.4GB), Whisper large-v3 Turbo(1.6GB), Whisper Tiny(0.104GB), Parakeet TDT v3(0.67GB)가 들어 있습니다.
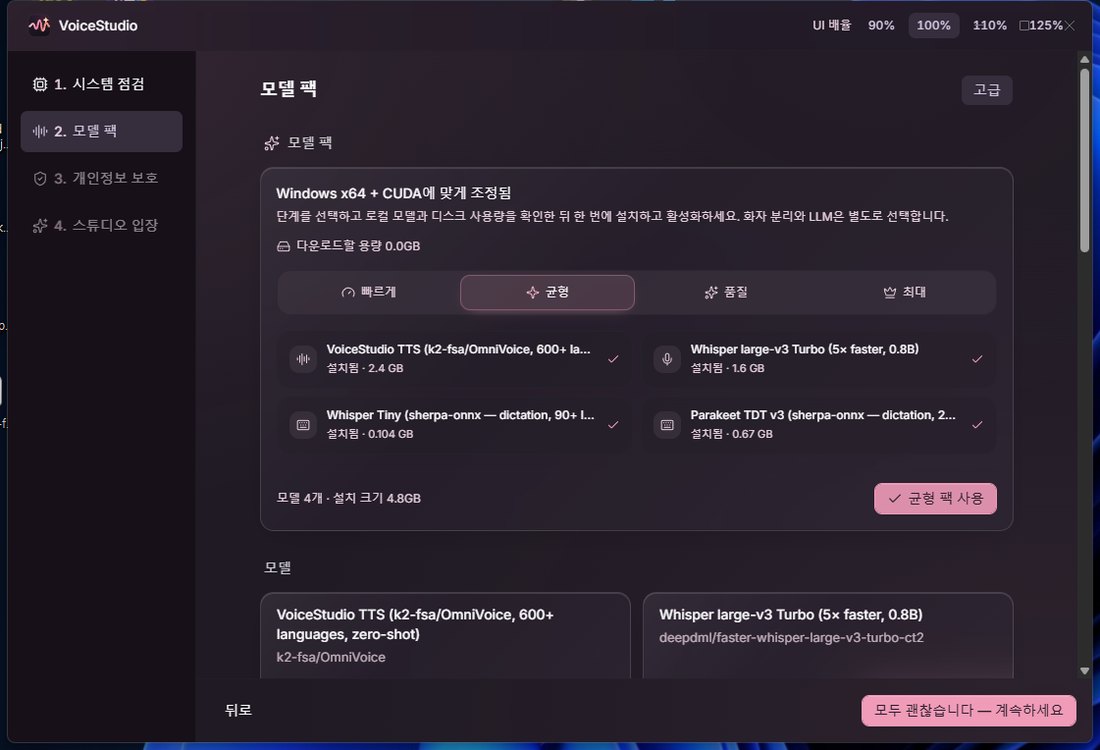
1분 30초쯤 뒤 네 모델이 모두 '설치됨'으로 바뀌었습니다.
다음 화면에서 사용 정보 수집은 '아니요'를 골랐습니다. 만든 음성에 'AI로 만든 소리'라는 표시를 숨겨 넣는 보이지 않는 워터마크는 기본으로 켜져 있습니다.
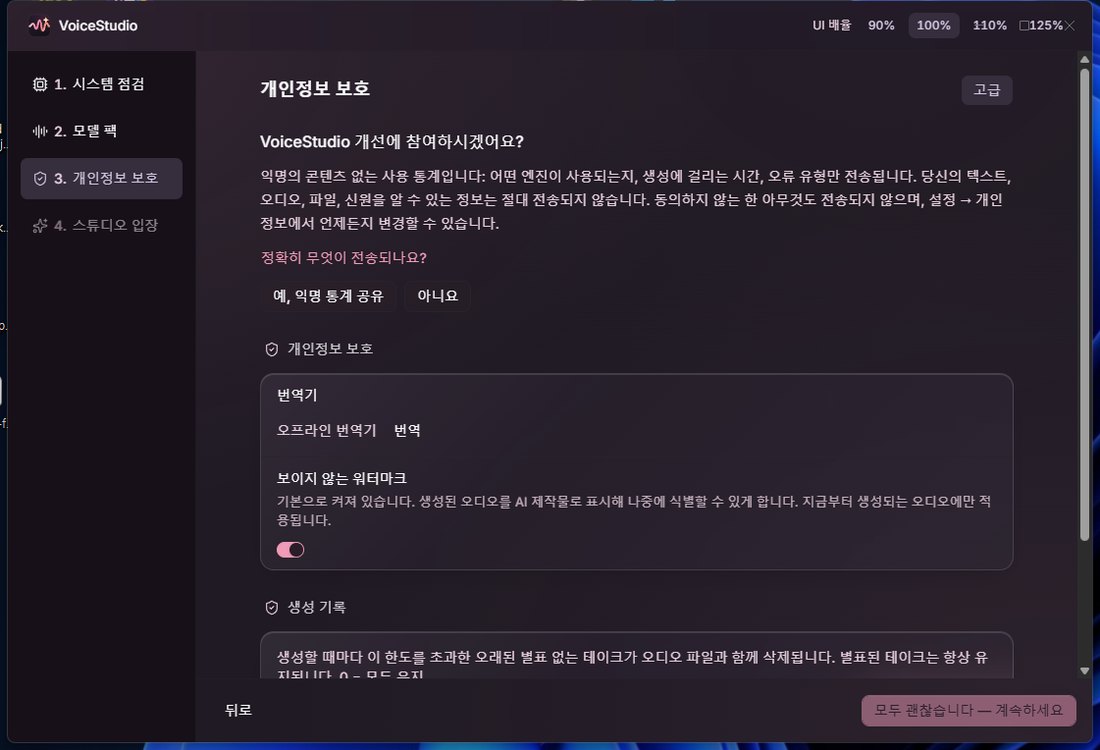
개인정보 단계. 보이지 않는 워터마크가 기본으로 켜져 있고, 생성 기록은 별표 없는 테이크를 200개까지 남깁니다.
기본 엔진 OmniVoice: 말하는 속도보다 3~5배 빠르다
한국어 문장 5개를 3번씩 만들었습니다. 실시간 대비 속도(RTF)는 만드는 데 걸린 시간을 만든 음성 길이로 나눈 값입니다. 0.25면 10초짜리 음성을 2.5초에 만든다는 뜻이고, 1보다 작으면 말하는 속도보다 빠릅니다.
| 문장 | 글자 수 | 음성 길이 | 걸린 시간 | RTF |
|---|---|---|---|---|
| 인사 ("안녕하세요. 오늘은…") | 43 | 4.6~5.6초 | 약 2.0초 | 0.35~0.43 |
| 숫자·영어 섞인 문장 ("16기가바이트인 RTX 5060 Ti…") | 63 | 8.2~8.6초 | 2.4~2.7초 | 0.28~0.33 |
| 날짜·시간 ("2026년 10월 3일 오전 10시 30분…") | 56 | 7.4~8.4초 | 2.1~2.4초 | 0.28 |
| 잰말놀이 ("간장 공장 공장장은…") | 40 | 5.2초 | 1.8~2.0초 | 0.35~0.38 |
| 세 문장짜리 문단 | 153 | 20.0~20.6초 | 3.7~4.7초 | 0.18~0.23 |
| 긴 문단(위 문단을 4번 이어 붙임) | 404 | 48~51초 | 10.7~11.6초 | 0.22~0.23 |
짧은 문장은 2초 안팎, 50초짜리 긴 문단도 11초 남짓이었습니다. 문장이 길수록 RTF가 더 낮아집니다. 모델을 처음 불러오는 첫 요청만 6.2초가 걸렸습니다.
발음은 만든 음성 15개를 다시 받아써서(Whisper large-v3 Turbo) 원래 문장과 비교했습니다. 띄어쓰기와 문장부호를 빼고 틀린 글자 비율(CER)을 쟀더니 평균 3.6%였습니다. 그런데 차이 난 곳을 하나씩 보면 "16기가바이트"를 "16GB"로, "45퍼센트"를 "45%"로, "세 번씩"을 "3번씩"으로 적은 표기 차이뿐이었습니다. 낱말을 잘못 읽은 곳은 없었습니다.
OmniVoice 기본 목소리로 만든 세 문장짜리 문단(20.6초). 만드는 데 3.8초 걸렸습니다.
| 항목 | OmniVoice 생성 중 |
|---|---|
| PC 전체 VRAM | 2.8~3.5GB (아무것도 안 올린 상태 0.64GB, 모델 자체는 약 1.9GB) |
| GPU 전력 | 평균 37~53W, 긴 문단에서 최고 127W |
| GPU 온도 | 최고 58°C |
| GPU 사용률 | 평균 10~20%대 (짧게 끊어서 계산) |
16GB 그래픽카드의 4분의 1도 쓰지 않았습니다. 제작자는 OmniVoice의 최소 VRAM을 6GB로 안내합니다.
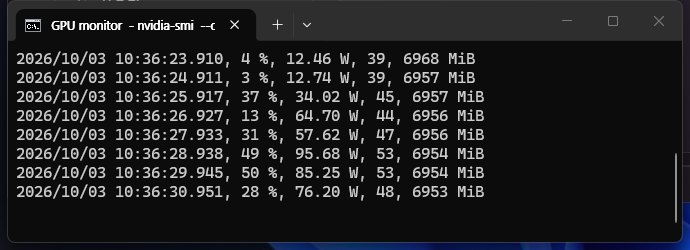
OmniVoice로 긴 문단을 만드는 동안 1초마다 찍은 GPU 상태. 왼쪽부터 시각, 사용률 13~50%, 전력 34~96W, 온도 44~53°C, PC 전체 VRAM 약 6.8GB(받아쓰기 모델도 함께 올라가 있던 때)입니다.
목소리 만들기와 복제
'디자인' 화면에서 "여성, 젊은 성인, 높은 음"처럼 특징을 고르면 참고 음성 없이 새 목소리를 만듭니다. 영어로 "30대의 차분한 여성 뉴스 앵커, 맑고 따뜻한 목소리"라고 적었더니 '여성·젊은 성인'으로 바뀌었고, "맑고 따뜻한"은 고를 수 있는 특징이 아니라서 빠졌습니다. OmniVoice는 성별, 나이, 음높이, 속삭임 같은 정해진 특징만 받습니다.
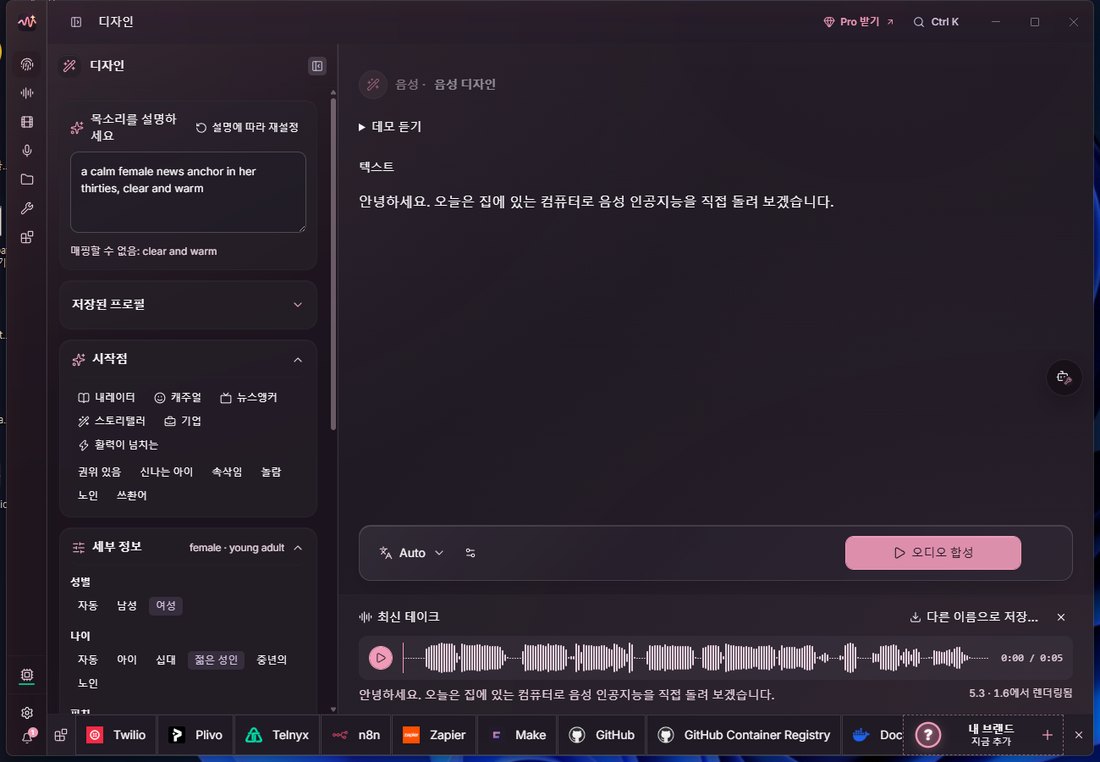
디자인 화면. 설명이 '여성·젊은 성인'으로 바뀌었고, 5.3초짜리 한국어 음성을 1.6초에 만들었습니다(아래 '5.3 · 1.6에서 렌더링됨').
목소리 복제는 실제 사람 목소리를 쓰지 않았습니다. 디자인 기능으로 만든 가상 목소리 두 개(남성·낮은 음, 여성·높은 음, 각 14초)를 참고 음성으로 올리고, 같은 문장 5개를 그 목소리로 만들었습니다.
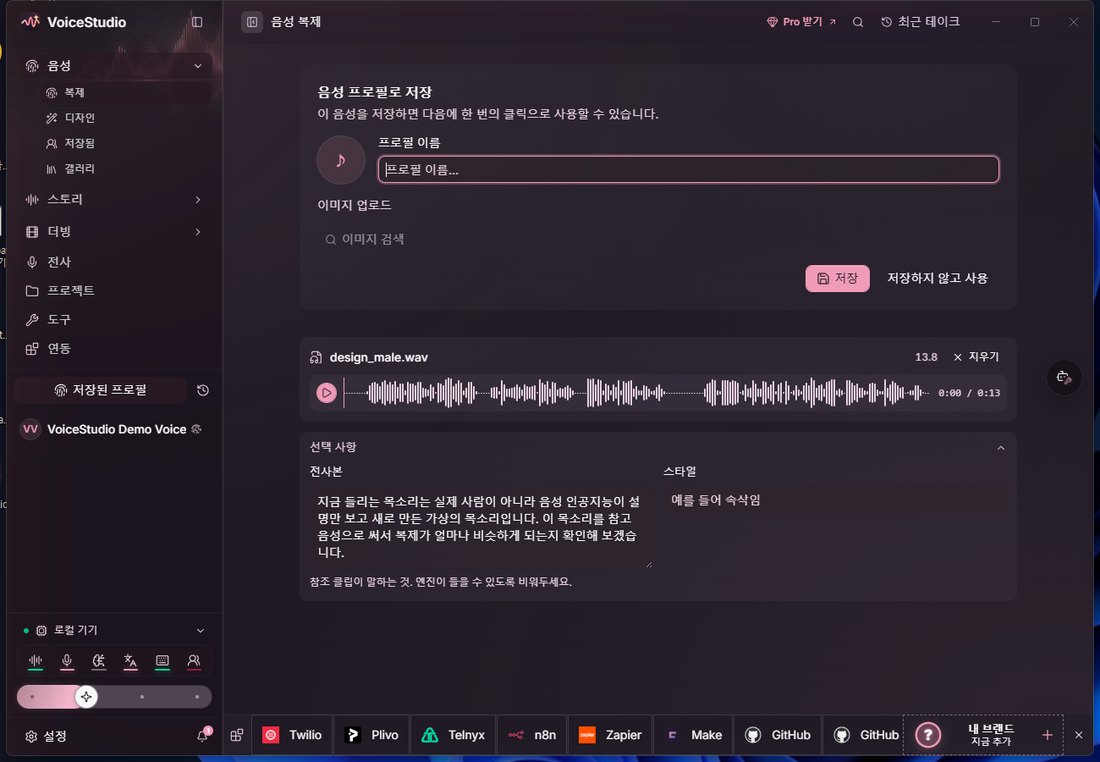
참고 음성(design_male.wav, 13.8초)을 올리자 앱이 내용을 자동으로 받아써서 '전사본'에 채웠습니다. 받아쓴 문장은 원래 문장과 같았습니다.
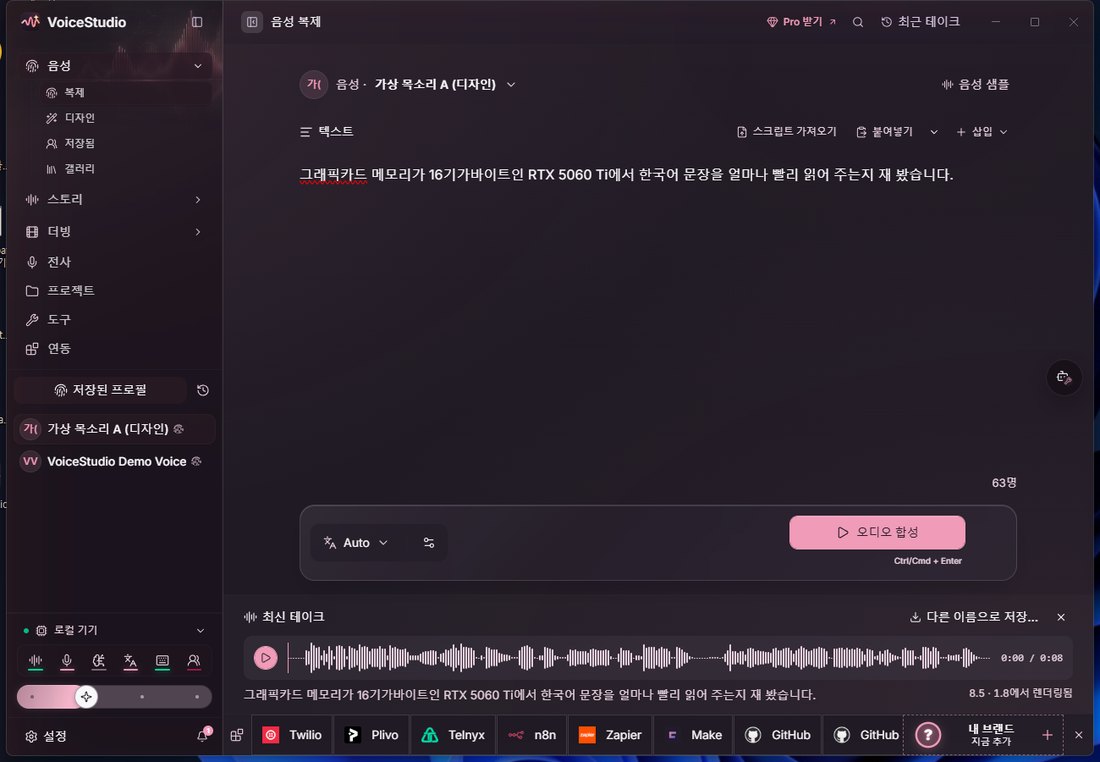
저장한 가상 목소리로 숫자·영어가 섞인 문장을 만든 화면. 8.5초짜리 음성을 1.8초에 만들었습니다.
| 항목 | 남성 가상 목소리 | 여성 가상 목소리 |
|---|---|---|
| 한 문장 만드는 시간 | 1.7~3.9초 | 1.6~3.8초 |
| RTF | 0.19~0.38 | 0.20~0.32 |
| 틀린 글자 비율(CER) | 4.3% | 4.0% |
| 음높이(가운데값) | 원본 154Hz → 복제 146~161Hz | 원본 316Hz → 복제 267~314Hz |
참고 음성으로 쓴 가상 목소리(남성·중년·낮은 음, 13.8초). 실제 사람이 아니라 앱이 설명만 보고 만든 목소리입니다.
위 목소리를 복제해 만든 문단(20.2초). 만드는 데 3.9초 걸렸습니다.
복제해도 속도는 그대로였습니다. 음높이도 원래 목소리를 따라갔습니다. 표기 차이를 빼면 실제로 잘못 읽은 곳은 두 군데였습니다. 남성은 "강 공장장"을 "감 공장장"처럼, 여성은 "5060"을 "50G60"처럼 들리게 읽었습니다.
목소리 복제는 그 목소리 주인의 동의를 받고 써야 합니다. 다른 사람 목소리로 말을 지어내면 사칭이나 사기에 쓰일 수 있습니다. VoiceStudio가 만든 음성에 기본으로 워터마크를 넣는 것도 이 때문입니다.
두 번째 엔진 VoxCPM2: 느리지만 더 사람 같았다
한국어를 지원하는 다른 엔진으로 VoxCPM2(OpenBMB, 30개 언어, 48kHz)를 설치했습니다. 모델 카탈로그에서 모델(4.96GB)을 받고, 엔진 줄의 '설치'를 누르면 전용 실행 환경을 따로 만듭니다. 모델은 약 1분 45초, 실행 환경은 약 3분 걸렸고 실행 환경이 5.3GB를 더 썼습니다.
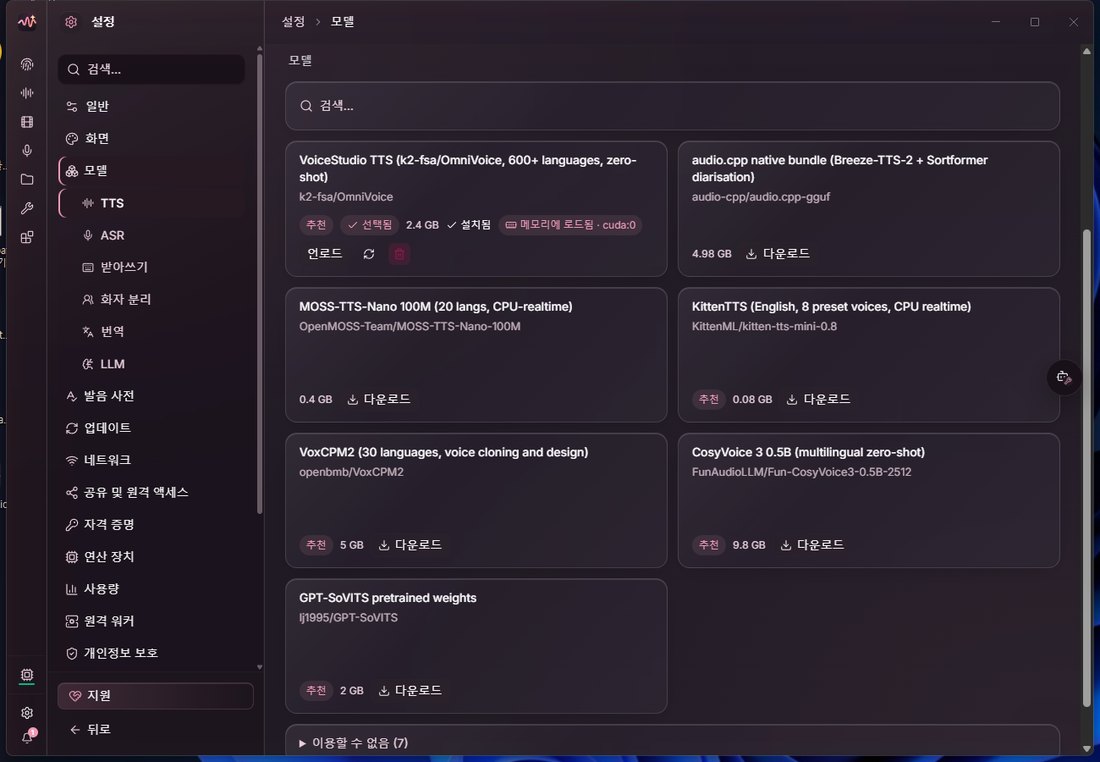
모델 카탈로그. VoxCPM2는 5GB, CosyVoice 3 0.5B는 9.6GB, GPT-SoVITS는 2GB로 나옵니다.
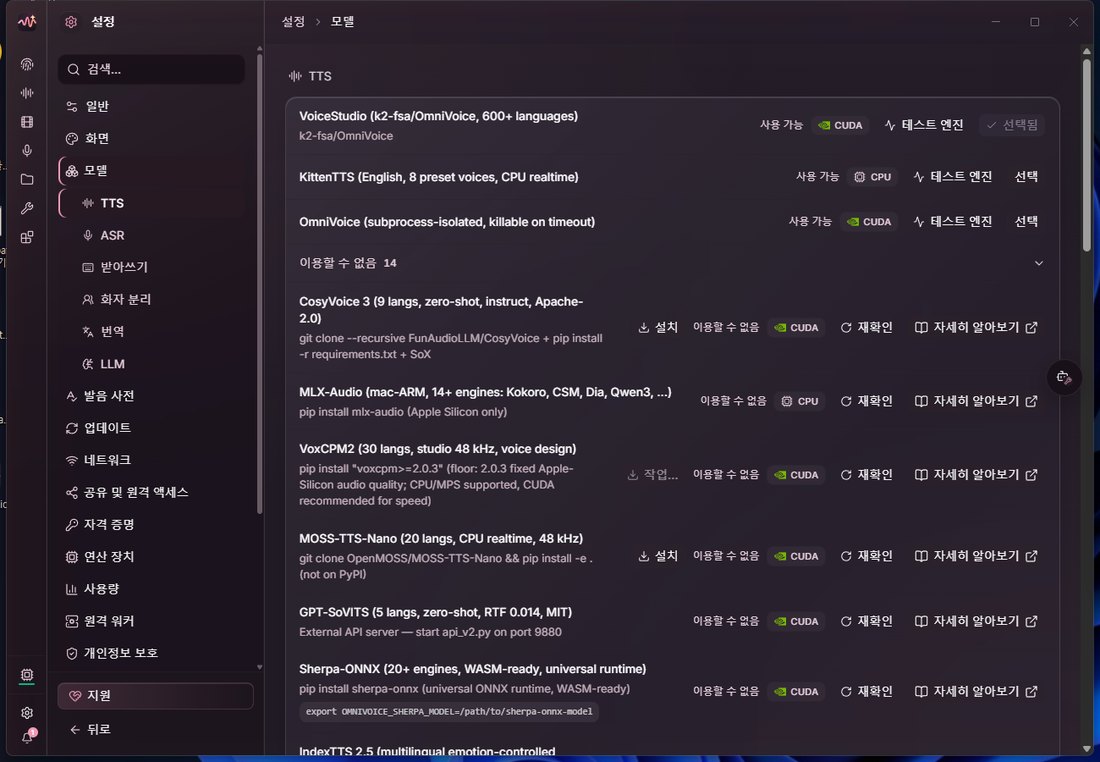
VoxCPM2 줄의 '설치'를 누르면 '작업 중'으로 바뀌고 전용 실행 환경을 만듭니다. 이때 CPU 사용률이 100%까지 올라갔습니다.
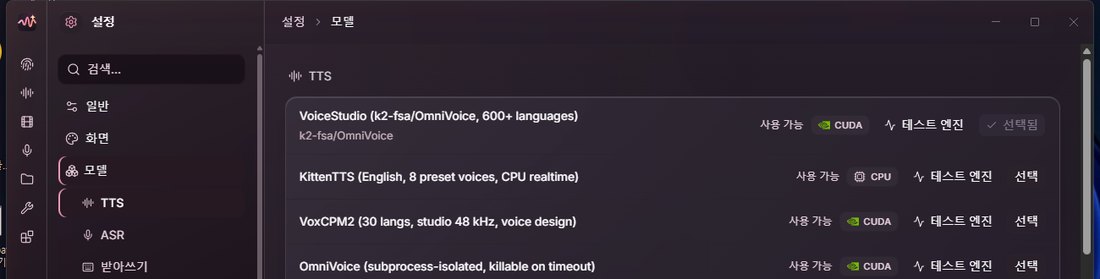
설치가 끝나자 VoxCPM2가 '사용 가능 · CUDA'로 바뀌었습니다.
OmniVoice와 같은 문장으로 쟀습니다.
| 문장 | OmniVoice 걸린 시간 | VoxCPM2 걸린 시간 | VoxCPM2 RTF |
|---|---|---|---|
| 인사 (43자) | 약 2.0초 | 13.5~14.4초 | 2.8~2.9 |
| 숫자·영어 섞인 문장 (63자) | 2.4~2.7초 | 18.9~19.7초 | 2.8 |
| 날짜·시간 (56자) | 2.1~2.4초 | 20.4~21.7초 | 2.8~2.9 |
| 세 문장짜리 문단 (153자) | 3.7~4.7초 | 50.3~51.6초 | 2.8 |
| 긴 문단 (404자) | 10.7~11.6초 | 121.8~137.5초 | 2.7~2.8 |
| 첫 요청(모델 불러오기 포함) | 6.2초 | 69.4초 | - |
| 생성 중 PC 전체 VRAM | 2.8~3.5GB | 8.4~9.3GB | - |
| 틀린 글자 비율(CER) | 3.6% (표기 차이만) | 5.2% | - |
VoxCPM2는 OmniVoice보다 7~12배 느렸습니다. 1초짜리 음성을 만드는 데 2.8초쯤 걸립니다. 그런데 GPU 사용률은 13~56%, 전력은 50W 안팎에 머물렀습니다. 그래픽카드가 바빠서 느린 것은 아니었고, 왜 이렇게 느린지는 이번에 확인하지 못했습니다. VoxCPM2 생성 때 PC 전체 VRAM에는 받아쓰기 모델(약 2GB)도 함께 올라가 있었습니다.
받아쓰기로 확인한 발음도 OmniVoice보다 실수가 조금 많았습니다. "그래픽카드"를 "클리핏카드"처럼, "된장"을 "변장"처럼 읽은 테이크가 있었고, 잰말놀이 한 번은 낱말을 빠뜨렸습니다.
VoxCPM2 기본 목소리로 만든 같은 문단(18.2초). 만드는 데 51초 걸렸습니다.
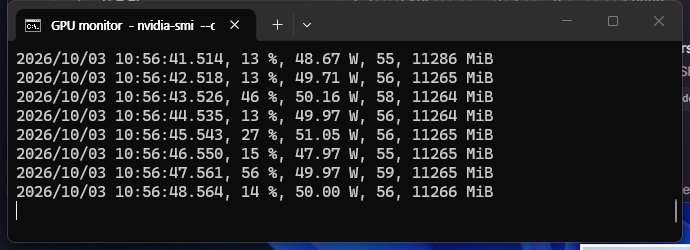
VoxCPM2로 긴 문단을 만드는 동안의 GPU 상태. 사용률 13~56%, 전력 48~51W, 온도 55~59°C, PC 전체 VRAM 약 11.0GB입니다.
VoxCPM2는 영어로 목소리를 설명하면 그대로 새 목소리를 만듭니다(OmniVoice처럼 정해진 특징만 받지 않음). 그래서 뉴스 앵커, 게임 스트리머, 친구와 수다 떠는 20대, 퇴근한 30대 직장인, 브이로거, 옛날이야기를 하는 할머니, 발표하는 대학생까지 설명만 바꿔 19개를 만들어 들어 봤습니다. 한 문장(5~12초)에 12~33초가 걸렸습니다.
| 들어 본 평가 (사람이 직접 들음) | 내용 |
|---|---|
| 가장 사람 같았던 것 | VoxCPM2로 만든 여성 목소리. 같은 문장을 OmniVoice로 만든 것은 AI 느낌이 더 강했음 |
| 여성 목소리 | 앵커, 친구와의 대화, 브이로그, 할머니 이야기 모두 전체적으로 어색한 곳이 없었음 |
| 남성 목소리 | 어색한 것이 많았음. 남성 뉴스 앵커가 그나마 나았음 |
VoxCPM2에 "young female, warm and calm tone, news anchor"라고 설명만 주고 만든 목소리(7.4초). 들어 본 것 중 가장 사람 같았던 목소리입니다.
같은 설명에서 female 을 male 로만 바꾼 목소리(4.5초). 남성 목소리 중에는 이것이 그나마 자연스러웠습니다.
"elderly woman, gentle and slow, telling a story to her grandchild"로 만든 옛날이야기(8.2초).
받아쓰기로 확인했을 때도 대부분은 원래 문장과 같았습니다. 다만 신나게 빨리 말하는 여성 게임 스트리머 목소리는 앞부분 "와, 방금"이 빠지고 "구독이랑"이 "저기랑"으로 받아써져, 틀린 글자 비율이 21%였습니다. 감정을 크게 넣을수록 발음이 흐려질 수 있습니다.
"young female game streamer, energetic and excited, fast talking"으로 만든 목소리(8.0초). 받아쓰기에서 앞부분이 빠지고 "구독이랑"이 "저기랑"으로 적힌 음성입니다.
받아쓰기: '정확함' 모드를 써야 한다
내용을 미리 알고 있는 34초짜리 한국어 음성을 받아쓰게 했습니다. 음성은 윈도우에 들어 있는 한국어 음성(Heami)으로 만들었습니다.
| 모드 | 쓰는 모델 | 걸린 시간 | 틀린 글자 비율(CER) |
|---|---|---|---|
| 빠름 (기본) | Whisper Tiny (CPU, 받아쓰기용) | 3.2~3.9초 | 31.5% |
| 정확함 | Whisper large-v3 Turbo (GPU) | 4.1~4.2초 (첫 요청 35.7초) | 4.9% |
기본 모드인 '빠름'은 "로컬 인공지능"을 "로 인공진"으로 받아쓰고 마지막 문장을 통째로 빠뜨렸습니다. '정확함'으로 바꾸면 거의 그대로 받아썼습니다. 남은 차이는 "빨라집니다"를 "발라집니다"로, "깃허브"를 "기터브"로, "214메가바이트"를 "214MB"로 적은 정도였습니다. 시간 차이는 1초도 안 나니, 한국어라면 '정확함'을 쓰는 편이 낫습니다.
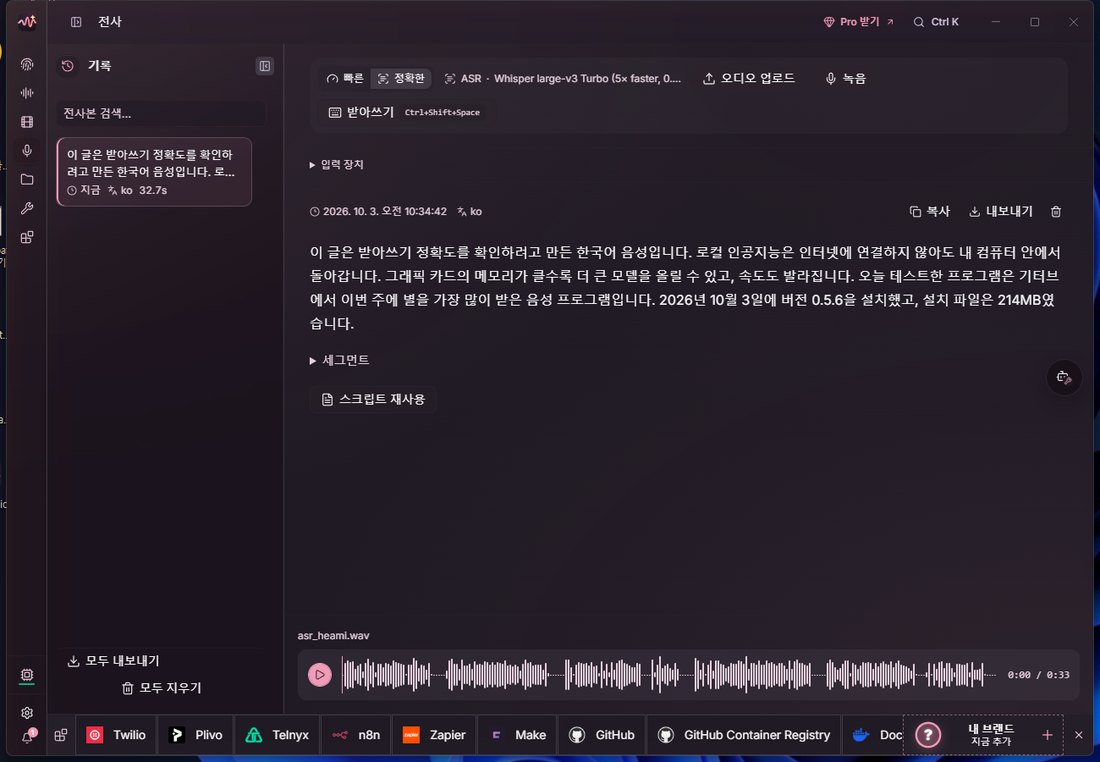
전사 화면에서 '정확함'(Whisper large-v3 Turbo)으로 받아쓴 결과. 날짜와 버전 숫자까지 맞게 받아썼습니다.
디스크는 얼마나 쓰나
| 항목 | 크기 |
|---|---|
| 앱 | 0.9GB |
| Python 실행 환경 | 9.5GB |
| 모델(균형 팩 4.8GB + VoxCPM2 5GB 등) | 11GB |
| VoxCPM2 전용 실행 환경 | 5.3GB |
| 패키지 캐시(uv) | 7.2GB |
| 합계 | 약 33GB (설치 전후 C 드라이브 남은 공간 471.6GB → 438.8GB) |
기본 엔진만 쓰면 약 20GB, VoxCPM2까지 넣으면 30GB를 넘습니다(패키지 캐시는 엔진을 설치할 때 받은 파일을 모아 둔 곳입니다). 모두 C 드라이브에 들어가니 공간을 먼저 확인하세요. 모델 폴더는 설정의 '저장소'에서 다른 드라이브로 옮길 수 있습니다.
무료와 Pro
설정의 '지원' 화면에는 무료와 Pro 비교가 있습니다. 2026년 10월 3일 기준으로 Pro는 "활성화가 아직 구성되지 않았다"고 나오고, 차이는 화면 아래 스폰서 막대 숨기기, 사용 정보 수집 끄기, Pro 배지 정도입니다. 이번 테스트의 기능은 모두 무료로 썼습니다.
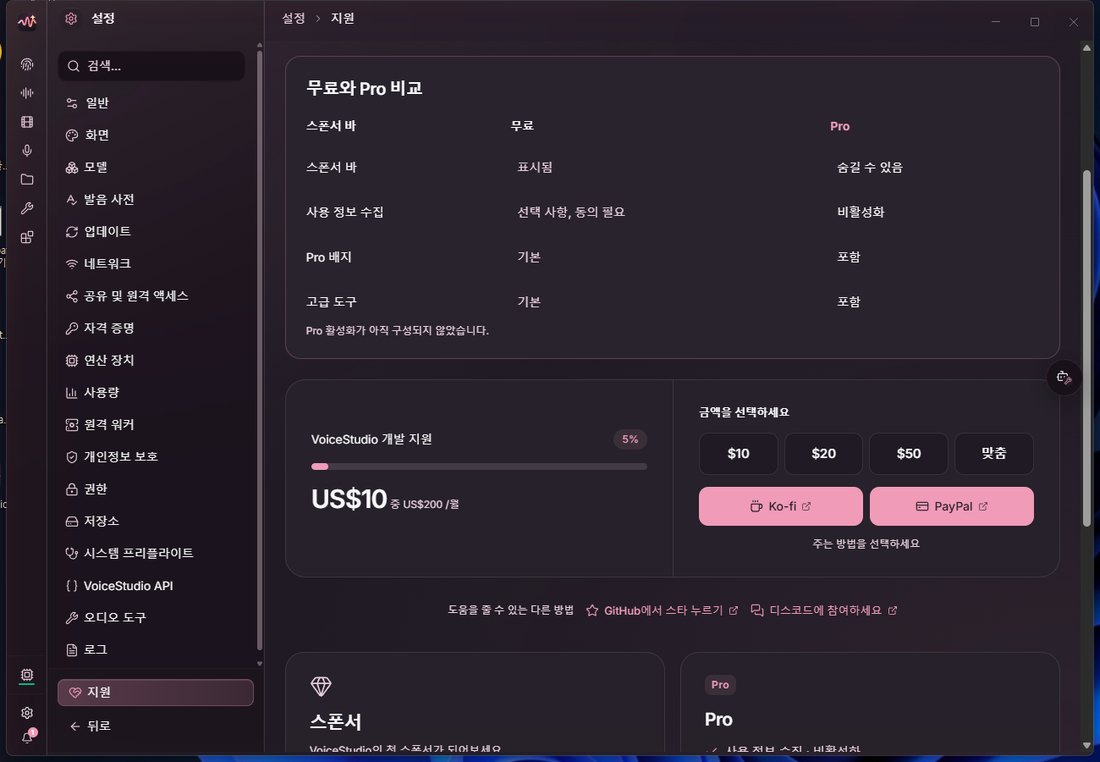
무료와 Pro 비교. 스폰서 막대 숨기기, 사용 정보 수집 비활성화, Pro 배지, 고급 도구가 Pro 항목입니다.
정리
| 항목 | OmniVoice (기본) | VoxCPM2 (추가 설치) |
|---|---|---|
| 설치 | 모델 팩에 포함 | 모델 5GB + 실행 환경 5.3GB, 약 5분 |
| 속도 (50초 분량) | 약 11초 (말하는 속도의 4.5배) | 약 2분 (말하는 속도의 0.36배) |
| VRAM (PC 전체) | 2.8~3.5GB | 8.4~9.3GB |
| 발음 (받아쓰기로 확인) | 표기 차이 말고는 틀린 곳 없음 | 가끔 낱말을 잘못 읽거나 빠뜨림 |
| 들어 본 자연스러움 | AI 느낌이 강함 | 여성 목소리는 사람에 가까움, 남성은 어색한 것이 많음 |
| 목소리 만들기 | 성별·나이·음높이 등 정해진 특징 | 영어 설명을 그대로 받음 |
- 16GB 그래픽카드에서 넉넉합니다. 기본 엔진은 VRAM을 4GB도 쓰지 않았고, VoxCPM2를 써도 10GB 안쪽이었습니다.
- 빨리 많이 만들 때는 OmniVoice입니다. 50초 분량을 11초에 만들고, 받아쓰기로 확인한 발음도 가장 정확했습니다.
- 자연스러운 여성 목소리가 필요하면 VoxCPM2입니다. 대신 말하는 속도보다 3배쯤 느리고, 남성 목소리는 어색한 경우가 많았습니다.
- 받아쓰기는 '정확함' 모드로 바꿔 쓰세요. 기본 '빠름'은 한국어를 많이 틀렸습니다.
- 디스크는 20~33GB를 각오해야 합니다.
내 그래픽카드에서 다른 AI 모델이 어느 정도 속도로 도는지는 GPU 체험에서 볼 수 있습니다.
이 글의 한계
- 2026년 10월 3일, VoiceStudio 0.5.6 기준입니다. 엔진과 앱이 자주 바뀌어 다른 버전에서는 결과가 다를 수 있습니다.
- 자연스러움은 한 사람이 들어 본 평가입니다. 발음 정확도는 받아쓰기 모델로 잰 값이라, 받아쓰기 모델이 틀린 경우도 섞여 있을 수 있습니다.
- 목소리 복제는 실제 사람 목소리가 아니라 앱이 만든 가상 목소리로만 했습니다. 받아쓰기 테스트 음성도 윈도우의 합성 음성이라, 실제 사람 녹음보다 받아쓰기가 쉬웠을 수 있습니다.
- CosyVoice 3(모델 9.6GB), IndexTTS 2.5 등 다른 엔진과 영상 더빙, 오디오북 기능은 재지 않았습니다.
- VoxCPM2가 GPU를 적게 쓰면서 느린 이유는 확인하지 못했습니다.
- 일레븐랩스와 직접 비교하지는 않았습니다.
자주 묻는 질문
VoiceStudio는 한국어를 지원하나요?
네. 기본 엔진 OmniVoice와 추가 엔진 VoxCPM2 모두 한국어 음성을 만들었고, 받아쓰기로 확인했을 때 대부분 정확했습니다. 받아쓰기 기능도 '정확함' 모드에서 한국어를 거의 그대로 받아썼습니다.
그래픽카드 메모리는 얼마나 필요한가요?
RTX 5060 Ti에서 기본 엔진으로 만들 때 PC 전체 VRAM이 2.8~3.5GB였습니다. VoxCPM2는 8.4~9.3GB였습니다. 제작자는 기본 엔진의 최소 VRAM을 6GB로 안내합니다.
설치하면 디스크를 얼마나 쓰나요?
기본 모델 팩까지 약 20GB, VoxCPM2 엔진까지 넣으니 약 33GB였습니다. 앱 0.9GB, 실행 환경 9.5GB, 모델 11GB, VoxCPM2 실행 환경 5.3GB, 패키지 캐시 7.2GB입니다.
목소리 복제에 아무 목소리나 써도 되나요?
안 됩니다. 목소리 주인의 동의가 있어야 합니다. 이 글에서는 실제 사람 목소리를 쓰지 않고, 앱이 설명만 보고 만든 가상 목소리로 복제를 테스트했습니다.
댓글 0개