업스테이지가 10월 1일 소형 언어 모델 솔라 미니 4(Solar Mini 4)를 공개했습니다. 기사 제목마다 "GPU 1장으로 구동"이 붙었습니다. 그래서 집에 있는 그래픽카드로도 돌릴 수 있는지 공식 발표와 평가 기관의 글을 직접 읽어 확인했습니다.
먼저 결론부터 적으면 이렇습니다.
- 내 PC로는 돌릴 수 없습니다. 모델 파일이 공개되지 않았습니다. API나 기업용 설치(온프레미스)로만 쓸 수 있습니다.
- "GPU 1장"은 서버용 H100 80GB 한 장을 뜻합니다. 그것도 양자화(모델을 줄이는 처리)를 한 경우입니다.
- 파일이 공개됐다고 가정하면 4비트로 줄였을 때 약 22GB로, RTX 5090 32GB에는 들어가고 16GB 그래픽카드에는 들어가지 않는 크기입니다(크기가 같은 공개 모델로 가늠한 값).
- 성능은 눈여겨볼 만합니다. 한 번에 30억 개만 계산하는 모델 가운데 평가 점수가 가장 높았습니다. 가격은 입력 100만 토큰에 0.10달러입니다.
이 글은 업스테이지 공식 블로그와 Artificial Analysis의 평가 글, Hugging Face의 파일 정보를 읽고 정리한 것입니다. 솔라 미니 4를 직접 써 보지는 않았습니다.
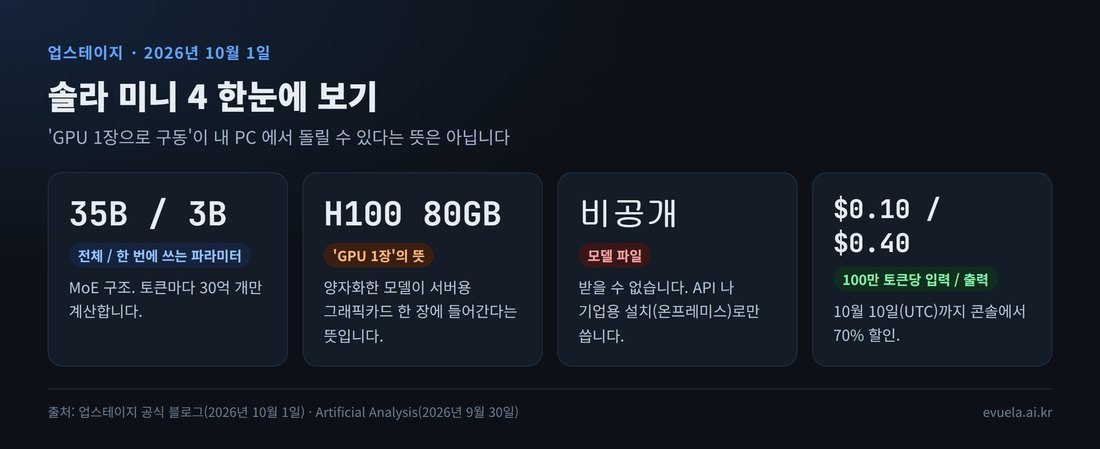
솔라 미니 4의 핵심 네 가지입니다.
솔라 미니 4는 어떤 모델인가
| 항목 | 내용 | 출처 |
|---|---|---|
| 공개일 | 2026년 10월 1일 | 업스테이지 |
| 크기 | 전체 350억(35B) 파라미터, 토큰마다 30억(3B)만 사용 | 업스테이지 |
| 구조 | MoE(여러 전문 부분 중 일부만 골라 계산하는 구조) | 업스테이지 |
| 컨텍스트 | 최대 512K 토큰, 출력 최대 128K 토큰 | 업스테이지 |
| 기능 | 도구 호출(여러 개 동시 호출 포함), JSON 형식 출력, 선택형 생각(reasoning) 기능 | 업스테이지 |
| 입출력 | 글만(이미지 입력 없음) | Artificial Analysis |
| 가격 | 100만 토큰당 입력 0.10달러, 캐시된 입력 0.01달러, 출력 0.40달러 | 업스테이지 |
| 쓰는 방법 | 업스테이지 콘솔 API, 솔라 챗, OpenRouter, 온프레미스 | 업스테이지 |
| 모델 파일 | 비공개 | Artificial Analysis |
이 표가 뜻하는 것은, 솔라 미니 4가 내려받아 쓰는 공개 모델이 아니라 API로 쓰는 상용 모델이라는 점입니다. 용도도 발표문에 분명히 적혀 있습니다. 정보 찾기, 정해진 형식으로 답하기, 도구 쓰기처럼 되풀이되는 일을 싸고 빠르게 처리하는 모델입니다. 복잡한 판단이 이어지는 일은 솔라 프로 라인이 맡습니다.
컨텍스트 길이는 자료마다 다릅니다. 업스테이지 블로그는 512K 토큰으로, Artificial Analysis는 100만 토큰으로 적었습니다. 이 글에서는 만든 곳의 값을 따랐습니다.
"GPU 1장"은 어떤 GPU인가
업스테이지 블로그에는 이 부분이 한 문장으로 적혀 있습니다.
the quantized model can run on a single H100 80GB GPU
업스테이지 공식 블로그 (2026년 10월 1일)
쉽게 말하면 "양자화한 모델을 H100 80GB 한 장에 올릴 수 있다"는 뜻입니다. H100은 데이터센터에서 쓰는 그래픽카드이고 메모리가 80GB입니다. 게임용으로 가장 큰 RTX 5090도 32GB입니다. 그러니 "GPU 1장"은 "서버 한 대에 그래픽카드를 여러 장 꽂지 않아도 된다"는 기업 쪽 이야기입니다. 집 PC에서 된다는 말이 아닙니다.
같은 문단에 이유도 적혀 있습니다. 토큰마다 30억 개만 계산하더라도 350억 개 전체를 메모리에 올려 두어야 한다는 것입니다. 예를 들어 직원 35명 가운데 일마다 3명만 불러 쓰더라도, 35명 모두가 사무실에 앉아 있어야 하는 것과 같습니다. 계산하는 양은 3명 몫으로 줄지만 자리는 35명 몫이 필요합니다.
속도에 대한 숫자도 서버 기준입니다. 업스테이지가 잰 값은 H100 두 장에서 요청 32개를 동시에 처리할 때 요청마다 초당 70토큰 이상입니다(입력 4,000토큰, 출력 1,000토큰 조건). Artificial Analysis는 API에서 초당 208토큰으로 쟀습니다.
파일이 공개됐다면 내 그래픽카드에 들어갔을까
솔라 미니 4의 파일은 받을 수 없어서 직접 재 볼 수 없습니다. 대신 크기가 같은 공개 모델로 가늠해 봤습니다. 알리바바의 Qwen3.6 35B A3B가 전체 35B, 활성 3B로 구조와 크기가 같습니다. 이 모델의 GGUF 파일 크기는 Hugging Face에서 바로 확인할 수 있습니다.
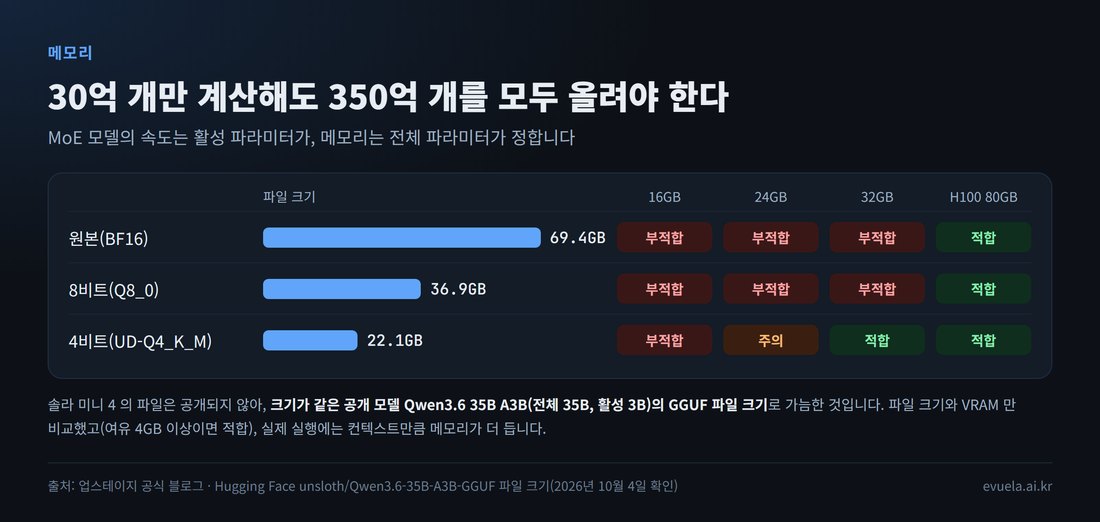
크기가 같은 공개 모델(Qwen3.6 35B A3B)의 파일 크기로 가늠한 것입니다.
| 줄인 정도 | 파일 크기 | 16GB | 24GB | 32GB | H100 80GB |
|---|---|---|---|---|---|
| 원본(BF16) | 69.4GB | 부적합 | 부적합 | 부적합 | 적합 |
| 8비트(Q8_0) | 36.9GB | 부적합 | 부적합 | 부적합 | 적합 |
| 4비트(UD-Q4_K_M) | 22.1GB | 부적합 | 주의 | 적합 | 적합 |
이 표가 뜻하는 것은 두 가지입니다. 첫째, 원본은 69.4GB라 H100 80GB에도 여유가 10GB쯤밖에 남지 않습니다. 발표문이 "양자화한 모델"이라고 적은 까닭을 여기서 짐작할 수 있습니다. 둘째, 4비트까지 줄이면 약 22GB로 RTX 5090에는 들어가는 크기입니다. 16GB 그래픽카드에는 들어가지 않습니다.
다만 이것은 가정입니다. 표는 파일 크기와 VRAM만 견준 것이고, 실제로 돌릴 때는 컨텍스트만큼 메모리가 더 듭니다. 무엇보다 솔라 미니 4는 파일이 공개되지 않아 이 표처럼 해 볼 방법이 없습니다. 같은 크기의 모델을 직접 돌려 보고 싶다면 공개 모델인 Qwen3.6 35B A3B(Apache 2.0)가 그 대상입니다.
성능은 어느 정도인가
업스테이지는 Artificial Analysis의 Intelligence Index 점수를 앞세웠습니다. 여러 시험을 묶어 한 숫자로 낸 종합 점수입니다.
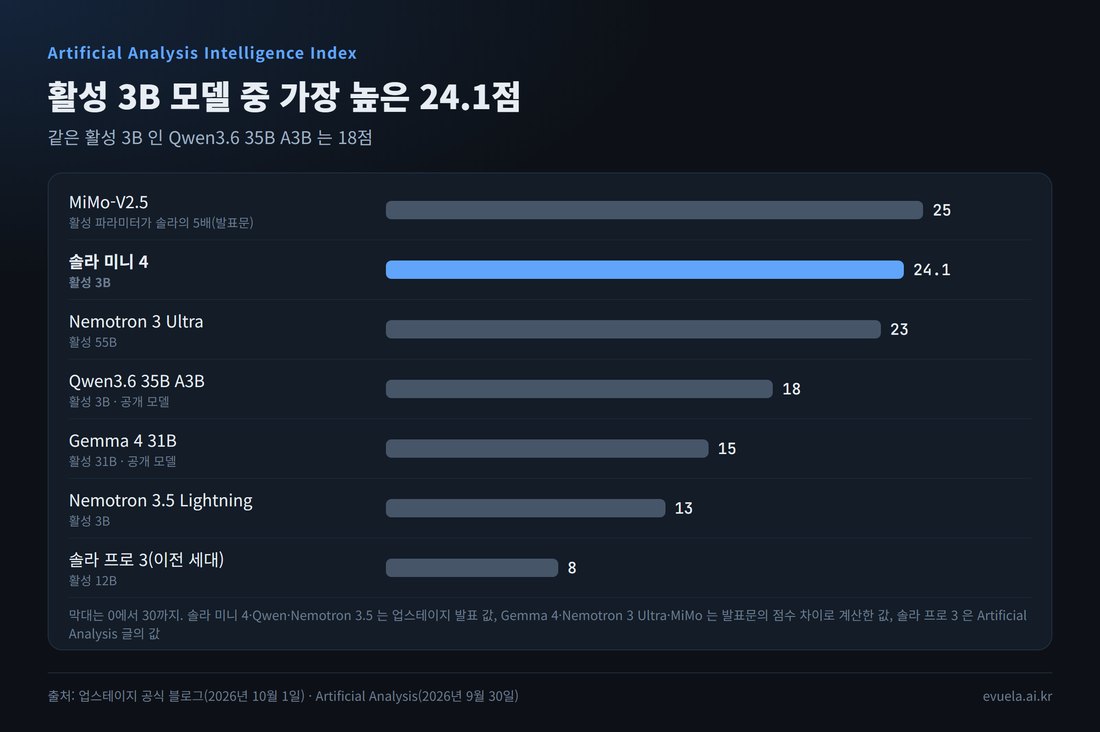
활성 파라미터가 훨씬 많은 모델들과 비슷한 점수를 냈습니다.
| 모델 | 활성 파라미터 | 점수 | 값의 출처 |
|---|---|---|---|
| MiMo-V2.5 | 솔라의 5배 | 25.0 | 발표문의 점수 차이(0.9점)로 계산 |
| 솔라 미니 4 | 3B | 24.1 | 업스테이지 발표 |
| Nemotron 3 Ultra | 55B | 23.0 | 발표문의 점수 차이(1.1점)로 계산 |
| Qwen3.6 35B A3B | 3B | 18 | 업스테이지 발표 |
| Gemma 4 31B | 31B | 15.0 | 발표문의 점수 차이(9.1점)로 계산 |
| Nemotron 3.5 Lightning | 3B | 13 | 업스테이지 발표 |
| 솔라 프로 3(이전 세대) | 12B | 8 | Artificial Analysis |
이 표가 뜻하는 것은, 같은 3B만 쓰는 Qwen3.6 35B A3B보다 6점 높고, 이전 세대 주력 모델 솔라 프로 3의 세 배라는 점입니다. 계산량이 열 배 넘게 큰 Gemma 4 31B보다도 높습니다.
평가 기관이 함께 적은 약점
Artificial Analysis의 글에는 좋은 점만 있지 않습니다. 같은 글에서 이런 점도 짚었습니다.
| 항목 | 결과 | 뜻 |
|---|---|---|
| 긴 글 추론(AA-LCR) | 83% | 강점. 훨씬 큰 상용 모델들과 같은 수준 |
| 틀린 답을 지어내지 않는 비율 | 64% | 강점. 모르면 답하지 않는 편(질문의 절반쯤은 답을 보류) |
| 지식 정확도(AA-Omniscience) | 18% | 약점. 비교 모델 중 가장 낮은 편 |
| 터미널 작업(Terminal-Bench 4.0) | 1% | 약점. 스스로 코드를 고치고 실행하는 일은 거의 못 함 |
| 과제 하나에 쓰는 출력 | 약 8.8만 토큰 | 생각을 길게 해서, 과제 하나에 평균 7.1분 |
| 과제 하나의 비용 | 0.36달러 | 토큰 값은 싸지만, 많이 써서 과제당 비용은 비슷한 가격대 모델의 약 5배 |
이 표가 뜻하는 것은, 토큰 가격이 싸다고 일 하나의 비용까지 싼 것은 아니라는 점입니다. 생각 기능을 켜면 답 하나에 토큰을 많이 씁니다. 또 Artificial Analysis는 모델 파일이 공개되지 않아 "전체 35B, 활성 3B"라는 크기를 따로 확인할 수는 없다고 적었습니다. 크기는 업스테이지가 밝힌 값입니다.
가격을 예로 계산해 보면
발표된 가격은 100만 토큰당 입력 0.10달러, 출력 0.40달러입니다. 예를 들어 하루에 문서 요약 1,000건을 시키고, 한 건에 입력 4,000토큰과 출력 1,000토큰을 쓴다고 해 보겠습니다.
| 항목 | 하루 토큰 | 정가 | 70% 할인(10월 10일 UTC까지) |
|---|---|---|---|
| 입력 | 400만 | 0.40달러 | 0.12달러 |
| 출력 | 100만 | 0.40달러 | 0.12달러 |
| 합계 | 0.80달러 | 0.24달러 |
이 표가 뜻하는 것은, 생각 기능을 쓰지 않는 단순한 일이라면 하루 1,000건에 1달러가 안 든다는 점입니다. 직접 계산한 예시이고, 생각 기능을 켜면 출력 토큰이 크게 늘어 비용도 늘어납니다. 할인은 업스테이지 콘솔에서만 적용되고 조건이 바뀔 수 있다고 발표문에 적혀 있습니다.
로컬 AI를 쓰는 사람에게 뜻하는 것
- "GPU 1장"이라는 말을 보면 어떤 GPU인지 먼저 확인합니다. 이번에는 서버용인 H100 80GB였습니다.
- "활성 3B"는 속도 이야기이고, 메모리는 전체 크기가 정합니다. 35B 모델은 3B만 계산해도 35B만큼의 자리가 필요합니다.
- 받아서 돌릴 수 있는지는 "오픈 웨이트" 여부로 갈립니다. 솔라 미니 4는 비공개입니다. 업스테이지가 공개한 모델로는 Solar Open 계열이 따로 있지만 1,000억 파라미터가 넘는 크기입니다.
- 같은 크기를 내 PC에서 돌려 보고 싶다면 Qwen3.6 35B A3B 같은 공개 모델이 있습니다. 4비트 파일이 22GB쯤입니다.
정리
- 솔라 미니 4는 전체 35B, 활성 3B의 MoE 모델이고 2026년 10월 1일에 공개됐습니다.
- "GPU 1장으로 구동"은 양자화한 모델이 H100 80GB 한 장에 올라간다는 뜻입니다.
- 모델 파일은 공개되지 않아 내 PC에서 돌릴 수 없습니다. API와 온프레미스로 씁니다.
- 활성 3B 모델 가운데 종합 점수가 가장 높았지만(24.1점), 지식 정확도와 터미널 작업은 약했습니다.
- 가격은 100만 토큰당 입력 0.10달러, 출력 0.40달러입니다.
이 글의 한계
- 솔라 미니 4를 직접 써 보지 않았습니다. 성능과 속도는 업스테이지와 Artificial Analysis가 잰 값입니다.
- 그래픽카드별 판정은 크기가 같은 다른 공개 모델의 파일 크기로 가늠한 것입니다. 솔라 미니 4의 실제 파일 크기는 알 수 없습니다.
- 2026년 10월 4일에 확인한 내용입니다. 가격, 할인, 공개 여부는 바뀔 수 있습니다.
자주 묻는 질문
솔라 미니 4를 내 PC에 내려받아 쓸 수 있나요?
없습니다. 모델 파일이 공개되지 않았습니다. 업스테이지 콘솔 API, 솔라 챗, OpenRouter로 쓰거나 기업은 온프레미스 설치를 문의해야 합니다.
"GPU 1장으로 구동"이면 RTX 5090 한 장으로도 되나요?
발표문이 말한 GPU는 H100 80GB입니다. 파일이 공개됐다고 가정하면 4비트로 줄였을 때 약 22GB라 5090 32GB에 들어가는 크기지만, 파일이 없어 실제로 해 볼 수는 없습니다.
활성 파라미터가 3B면 메모리도 3B만큼만 쓰나요?
아닙니다. 토큰마다 3B만 계산할 뿐, 35B 전체를 메모리에 올려 두어야 합니다. 업스테이지 발표문에도 그렇게 적혀 있습니다.
가격은 얼마인가요?
100만 토큰당 입력 0.10달러, 캐시된 입력 0.01달러, 출력 0.40달러입니다. 업스테이지 콘솔에서는 10월 10일(UTC)까지 70% 할인합니다.
비슷한 크기의 공개 모델은 무엇이 있나요?
전체 35B, 활성 3B로 크기가 같은 Qwen3.6 35B A3B가 Apache 2.0으로 공개돼 있습니다. 종합 점수는 솔라 미니 4가 24.1점, Qwen3.6 35B A3B가 18점입니다(업스테이지 발표).
참고: 업스테이지 공식 블로그: Solar Mini 4 · Artificial Analysis: Korean AI Lab Upstage releases Solar Mini 4 · unsloth/Qwen3.6-35B-A3B-GGUF 파일 목록 · ZDNet Korea 기사 · 이 블로그의 GPU 체험, Unsloth Studio로 바꾼 이유, LTX-2.5 영상 테스트
댓글 0개