Perplexity가 10월 1일(미국 시간, 한국은 10월 2일) Decisions API를 열고, 그 뒤에서 돌아가는 모델 pplx-decider-v1-27b를 누구나 받을 수 있게 공개했습니다. 이 모델은 문장을 쓰지 않습니다. 정해 둔 보기 가운데 어느 것이 맞는지를 확률(0~1 사이의 숫자)로만 답합니다.
핵심을 먼저 적으면 이렇습니다.
- Qwen3.8 27B를 고쳐 만든 모델입니다. 이 블로그에서 여러 번 테스트한 그 모델이 바탕입니다. 라이선스는 Apache 2.0이라 상업적으로도 쓸 수 있습니다.
- Perplexity가 잰 11가지 시험에서 85.71%가 나왔습니다. 바탕이 된 Qwen3.8 27B(74.76%)보다 약 11%포인트 높고, 이 분야를 먼저 연 TypeSafe의 Jev(84.51%)보다 조금 높습니다.
- API 요금은 입력 100만 토큰에 0.04달러이고, 출력은 받지 않습니다. 블로그 댓글 1,000개를 스팸인지 가려도 약 0.012달러(약 17원)입니다.
- 내 PC에서 돌리기는 아직 어렵습니다. 원본 파일이 약 52GB이고, LM Studio에서 쓰는 GGUF 파일이 없습니다. 글을 만드는 모델이 아니라서 LM Studio나 Ollama에서 그대로 열리지도 않습니다.
이 글은 Perplexity 개발 문서, 허깅페이스의 모델 카드, 모델과 함께 올라온 실행 코드(inference.py)를 직접 읽고 정리한 것입니다. 모델을 내려받아 직접 돌려 보지는 않았습니다. 벤치마크 점수는 모두 Perplexity가 잰 값입니다.
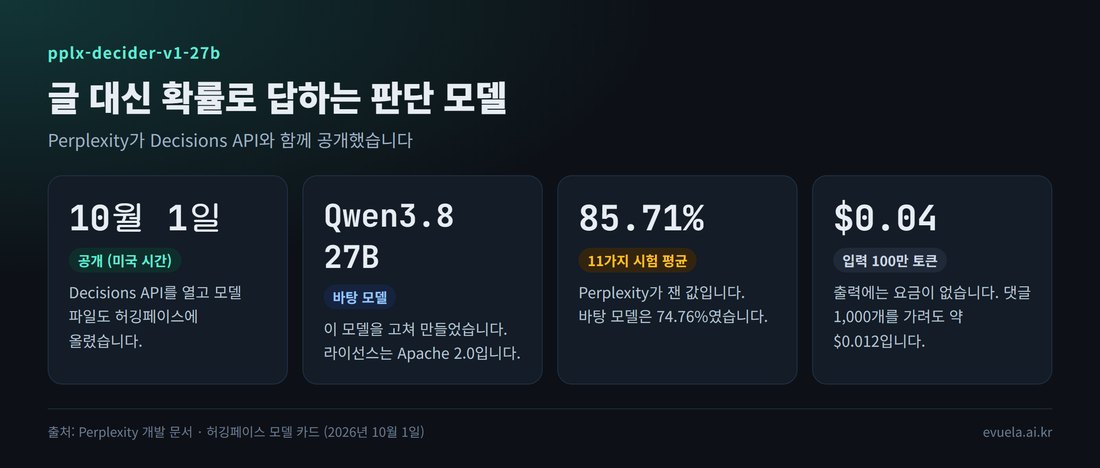
이번 발표의 핵심 네 가지입니다.
판단 모델은 무엇인가
Perplexity 개발자 계정은 이 모델을 소개하면서 이렇게 적었습니다.
“a probability distribution over a fixed set of answers instead of text”
Perplexity Developers, X (2026년 10월 1일)
풀어 쓰면, 글 대신 "정해 둔 답 하나하나가 맞을 확률"을 내놓는다는 말입니다.
보통의 AI 모델은 질문을 받으면 문장을 한 토큰씩 만들어 답합니다. 사람이 읽기에는 좋지만, 프로그램이 그 답을 받아서 다음 일을 하려면 불편합니다. "이 댓글은 스팸인가요?"라고 물었는데 "네, 광고 링크가 있어서 스팸으로 보입니다만…"처럼 답하면, 프로그램은 그 문장에서 "네"를 다시 찾아내야 합니다. 답 모양이 매번 조금씩 다르면 그 부분에서 오류가 납니다.
판단 모델은 처음부터 답의 모양이 정해져 있습니다. 같은 질문에 "스팸일 확률 0.97"처럼 숫자 하나를 돌려줍니다. 프로그램은 "0.9를 넘으면 숨기고, 0.5~0.9면 사람이 확인"처럼 기준선을 정해 두고 그대로 쓰면 됩니다.
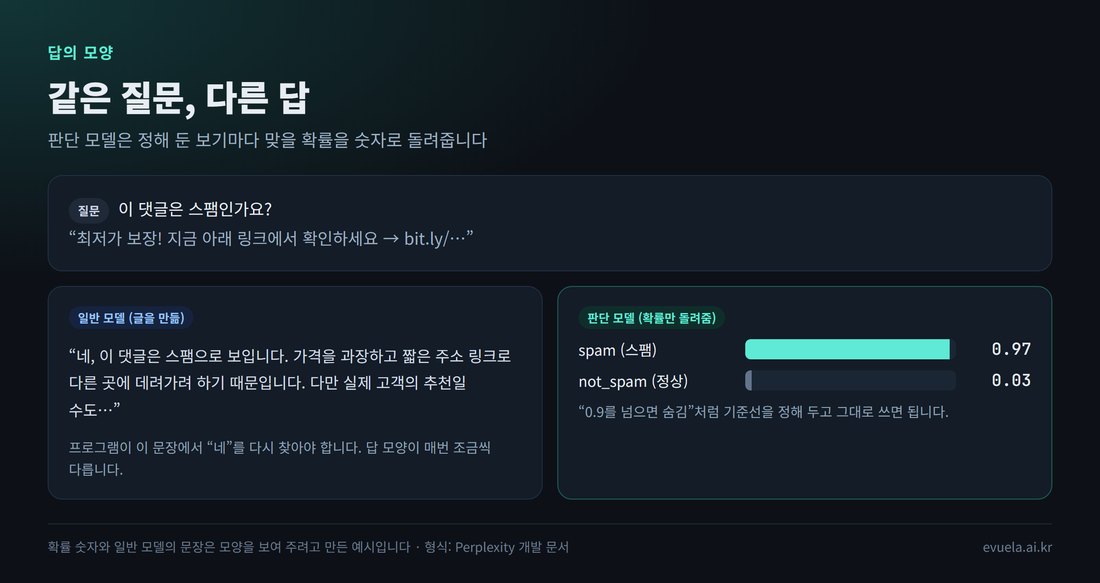
같은 질문을 두 종류의 모델에 물었을 때 돌아오는 답의 모양입니다. 숫자는 모양을 보여 주려고 넣은 예시입니다.
모델 안의 구조도 다릅니다. 허깅페이스에 올라온 파일을 보면, 보통의 모델 파일 말고 readout.safetensors라는 작은 파일(2.61MB)이 따로 있습니다. 실행 코드는 이 파일을 함께 읽어 보기마다 확률을 계산합니다. 문장을 만드는 부분을 쓰지 않고, 이 판단용 부분으로 답을 읽어 내는 구조입니다.
질문하는 방법은 세 가지
Decisions API에는 질문 형식이 세 가지 있습니다.
| 형식 이름 | 무엇을 묻나 | 돌려주는 것 | 쓸 만한 곳 |
|---|---|---|---|
noul | 예/아니오 | "예"일 확률(0~1) | 스팸인가, 급한 요청인가, 답변이 질문에 맞는가 |
choice | 여러 보기 중 하나 | 보기마다 확률 + 가장 높은 보기 | 문의를 어느 팀에 넘길까, 글의 카테고리는 무엇인가 |
score | 정해 둔 기준으로 점수 매기기 | 점수 단계마다 확률 + 기대 점수 | 답변 품질 1~5점, 위험도 1~3단계 |
이 표가 뜻하는 것은, 사람이 체크리스트를 보고 고르던 일을 그대로 맡길 수 있다는 점입니다. 보기는 최대 255개, 점수 단계는 최대 10개까지 둘 수 있습니다.
모델 카드에 실린 예시를 줄이면 이런 모양입니다. 고객 문의 한 줄을 넣고, 어느 팀이 맡을지 세 보기 가운데 고르게 합니다.
from inference import Decider

model = Decider.from_pretrained("perplexity-ai/pplx-decider-v1-27b")
result = model.predict(
    "My Stripe integration keeps failing. Please help ASAP.",
    {
        "type": "choice",
        "instructions": "Which team should handle this request?",
        "criteria": {
            "billing": "Charges and refunds",
            "technical_support": "Integration errors",
            "sales": "Questions about buying a product",
        },
    },
)
문의 내용은 "결제 연동이 계속 실패한다, 급하다"입니다. 보기는 결제(billing), 기술 지원(technical_support), 영업(sales)입니다. 모델은 세 보기에 각각 확률을 붙이고, 가장 높은 것을 고른 답으로 돌려줍니다. 사진도 넣을 수 있어서, 예를 들어 화면 캡처를 넣고 "오류 화면인가"를 물을 수도 있습니다.
벤치마크: 바탕 모델보다 약 11%포인트 높았다
Perplexity는 11가지 시험(문제 7,210개)으로 세 모델을 비교했습니다. 아래 점수는 모두 Perplexity가 잰 값입니다.
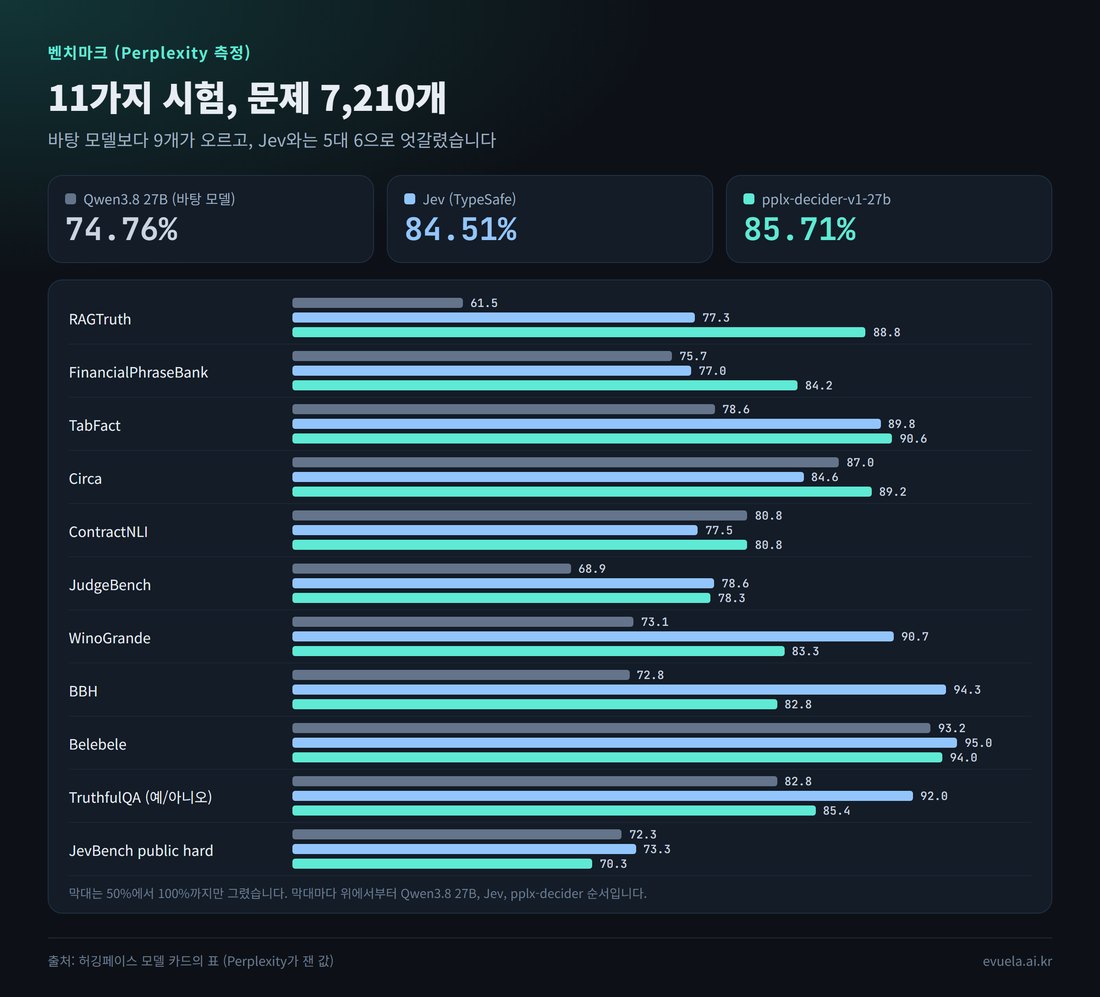
11가지 시험의 평균과 시험별 점수입니다. 청록색이 이번에 공개된 모델입니다.
| 시험 | 무엇을 보나 | Qwen3.8 27B | Jev | pplx-decider |
|---|---|---|---|---|
| RAGTruth | 자료를 보고 쓴 답에 없는 말(환각)이 섞였는지 | 61.53% | 77.27% | 88.80% |
| FinancialPhraseBank | 금융 뉴스 문장이 좋은 소식인지 나쁜 소식인지 | 75.68% | 76.98% | 84.18% |
| TabFact | 표를 보고 문장이 맞는지 | 78.60% | 89.80% | 90.60% |
| Circa | 돌려 말한 대답이 예인지 아니오인지 | 87.00% | 84.60% | 89.20% |
| ContractNLI | 계약서 조항이 어떤 내용을 뜻하는지 | 80.78% | 77.45% | 80.78% |
| JudgeBench | 두 답 가운데 어느 쪽이 나은지 | 68.86% | 78.57% | 78.29% |
| WinoGrande | 문장 속 "그것"이 무엇을 가리키는지(상식) | 73.10% | 90.70% | 83.30% |
| BBH | 여러 단계를 거쳐야 풀리는 추론 문제 | 72.80% | 94.27% | 82.80% |
| Belebele | 여러 언어로 된 글을 읽고 답하기 | 93.20% | 95.00% | 94.00% |
| TruthfulQA (예/아니오) | 흔한 오해에 넘어가지 않는지 | 82.80% | 92.00% | 85.40% |
| JevBench public hard | Jev를 만든 TypeSafe의 판단 시험(어려운 문제) | 72.28% | 73.27% | 70.30% |
| 평균 | 74.76% | 84.51% | 85.71% |
이 표가 뜻하는 것은 두 가지입니다.
- 바탕 모델보다는 거의 모든 시험에서 좋아졌습니다. 11개 가운데 9개가 올랐고, 하나(ContractNLI)는 같고, 하나(JevBench)는 2%포인트 내려갔습니다. 가장 많이 오른 것은 RAGTruth로, 61.53%에서 88.80%로 27%포인트 넘게 올랐습니다. "AI가 자료에 없는 말을 지어냈는지" 가려내는 일에 특히 강해졌다는 뜻입니다.
- Jev와는 시험마다 엇갈립니다. pplx-decider가 5개에서 앞서고, Jev가 6개에서 앞섭니다. 평균은 1.2%포인트 차이입니다. 문서 속 사실 확인(RAGTruth, TabFact)은 pplx-decider가, 상식과 여러 단계 추론(WinoGrande, BBH)은 Jev가 강합니다.
시험 문제도, 채점도 Perplexity가 정했습니다. 다른 곳에서 같은 방법으로 다시 잰 결과는 아직 찾지 못했습니다.
가격: 입력 100만 토큰에 0.04달러, 출력은 무료
요금은 입력 토큰에만 붙습니다. 판단 모델은 답이 숫자 몇 개라서 출력이 거의 없기 때문입니다. 요청 한 번마다 따로 받는 요금도 없습니다. 1달러를 1,400원으로 잡고 계산해 봤습니다.
| 경우 | 입력 토큰 | 요금 |
|---|---|---|
| 블로그 댓글 1,000개를 스팸인지 가리기 (댓글 하나에 300토큰) | 30만 | 약 0.012달러 (약 17원) |
| 고객 문의 메일 1만 통을 담당 팀에 나누기 (한 통에 500토큰) | 500만 | 약 0.2달러 (약 280원) |
| 가장 긴 입력 한 번 (262,144토큰 바로 아래) | 약 26만 | 약 0.01달러 (약 15원) |
이 표가 뜻하는 것은, 분류하는 일만 놓고 보면 요금이 거의 들지 않는다는 점입니다. 대신 이 API로는 요약이나 답장 쓰기 같은 일을 할 수 없습니다. 그런 일은 따로 글을 만드는 모델을 써야 합니다.
개발 문서에 적힌 제한과 응답 시간은 이렇습니다.
| 항목 | 값 |
|---|---|
| 한 번에 넣을 수 있는 입력 | 262,144토큰 미만 |
| 한 요청에 담는 질문 수 | 1~128개 |
| 보기 수 / 점수 단계 | 최대 255개 / 최대 10단계 |
| 요청 횟수 | 조직마다 1초에 10번 |
| 응답 시간 | 입력 수백 토큰은 2초 안, 약 9만 토큰은 5초, 약 19만 토큰은 14초, 한도에 가까우면 23초 |
이 표가 뜻하는 것은, 짧은 글을 가리는 일은 거의 바로 끝나지만 긴 문서를 통째로 넣으면 수십 초가 걸린다는 점입니다. 응답이 1분을 넘으면 요청이 끊깁니다.
내 PC에서 돌릴 수 있나
가중치(모델 파일)는 허깅페이스에 Apache 2.0으로 올라와 있어서 누구나 받을 수 있습니다. 다만 지금은 집에서 쓰는 그래픽카드로 돌리기가 쉽지 않습니다.
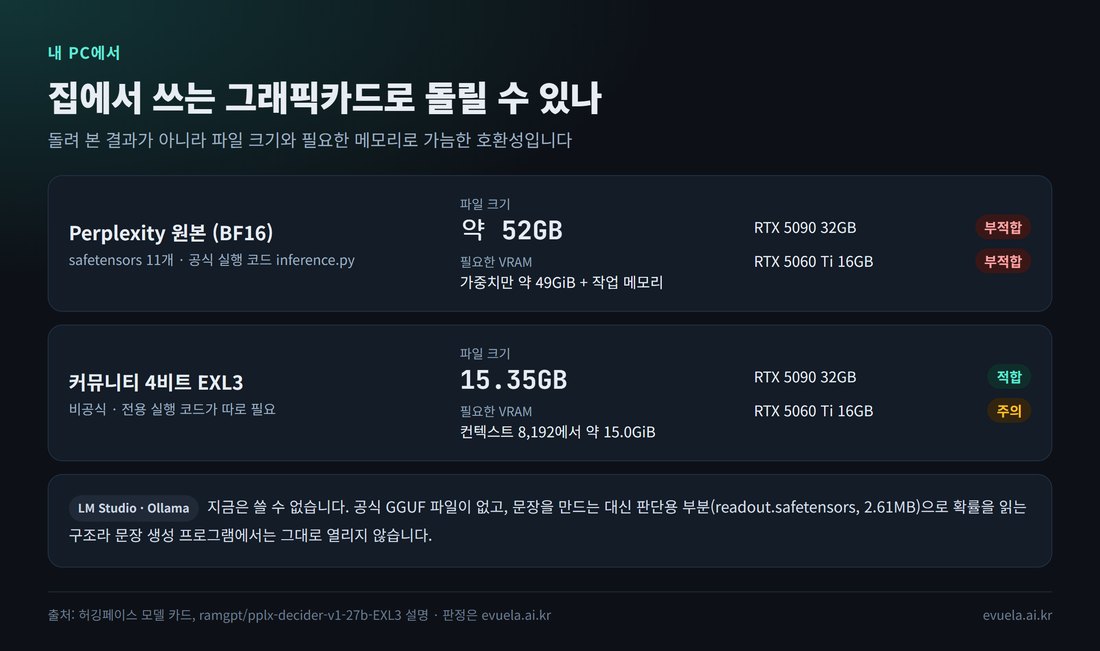
파일 크기와 필요한 VRAM을 이 블로그의 테스트 그래픽카드 두 개와 견줘 본 것입니다. 직접 돌려 본 결과가 아니라 메모리로 가늠한 것입니다.
| 파일 | 크기 | 필요한 VRAM | RTX 5090 32GB | RTX 5060 Ti 16GB |
|---|---|---|---|---|
| Perplexity 원본 (BF16) | 약 52GB (파일 11개) | 가중치만 약 49GiB + 작업 메모리 | 부적합 | 부적합 |
| 커뮤니티 4비트 EXL3 (비공식) | 15.35GB | 컨텍스트 8,192에서 약 15.0GiB | 적합 | 주의 |
이 표가 뜻하는 것은, 원본은 32GB 그래픽카드에도 들어가지 않고, 4비트로 줄인 파일이라야 집에서 쓰는 그래픽카드에 올라간다는 점입니다. 16GB 카드는 약 1GB만 남아서, 모니터 화면 표시에 쓰는 VRAM까지 생각하면 빠듯합니다. 판정은 직접 돌린 것이 아니라 파일 크기와 제작자가 적은 메모리 사용량으로 가늠한 것입니다.
LM Studio에서는 왜 안 되나
- GGUF 파일이 없습니다. 공식 저장소에는 safetensors 파일만 있습니다. LM Studio와 Ollama는 GGUF 파일을 씁니다.
- 글을 만드는 모델이 아닙니다. LM Studio와 Ollama는 모델이 문장을 만들어 내는 것을 전제로 합니다. 이 모델은 앞에서 본 판단용 부분(
readout.safetensors)으로 확률을 읽어야 합니다. 4비트 EXL3 파일을 만든 사람도 같은 이유로 "보통의 문장 생성 서버(TabbyAPI)에서는 쓸 수 없다"고 적어 두었습니다. - 공식 실행 방법은 파이썬 코드입니다. 파이썬 3.12 이상, PyTorch, transformers가 필요하고, Perplexity가 함께 올린
inference.py로 돌립니다.
바탕이 된 Qwen3.8 27B는 4비트 GGUF(Q4_K_M)가 약 17.7GB라서 RTX 5090에서 잘 돌았습니다. 같은 Q4_K_M을 올린 곳에 따라 속도가 얼마나 다른지는 같은 Q4_K_M인데 뭐가 다를까에, 16GB 그래픽카드에서 돌린 결과는 Qwen3.8 27B GSQ-RCO 테스트에 있습니다. pplx-decider도 누군가 LM Studio에서 쓸 수 있는 형태로 바꿔 내놓으면, 같은 그래픽카드에서 비슷한 메모리로 돌릴 수 있을 것으로 보입니다(추정).
같은 주에 나온 판단 모델들
판단 모델은 Perplexity만 내놓은 것이 아닙니다. 이번 주에 비슷한 발표가 이어졌습니다.
| 이름 | 만든 곳 | 공개 여부 | 한 줄 설명 |
|---|---|---|---|
| Jev | TypeSafe | API | 이 방식을 먼저 연 모델입니다. 월스트리트저널 보도로는 미국 500대 기업 가운데 약 25%가 쓰고, 하루 1조 토큰을 처리합니다 |
| Clef, Clef-flash | Cloudflare | 공개 (Apache 2.0) | Cloudflare의 Workers AI에서 돌아갑니다. Clef-flash는 응답 시간 가운데값이 약 39밀리초라고 밝혔습니다 |
| pplx-decider-v1-27b | Perplexity | 공개 (Apache 2.0) | 이 글의 주제입니다. Qwen3.8 27B 바탕이고, 사진도 넣을 수 있습니다 |
| Decisions API | OpenAI | API | OpenAI의 에이전트 도구에 들어간 판단용 API입니다 |
이 표가 뜻하는 것은, "AI에게 글을 쓰게 하지 않고 고르게만 하는" 쓰임이 따로 자리를 잡고 있다는 점입니다. AI 에이전트가 다음에 어떤 도구를 쓸지, 이 요청을 받아도 되는지를 빠르고 싸게 정해야 하기 때문입니다. 9월 29일 OpenAI DevDay에서 나온 에이전트 이야기는 OpenAI dots 소식에 정리했습니다.
누구에게 쓸모 있나
| 이런 경우 | 맞는가 |
|---|---|
| 댓글·리뷰·문의를 많이 받아서 자동으로 나눠야 한다 | 잘 맞습니다. 요금이 거의 들지 않습니다 |
| AI가 쓴 답에 지어낸 내용이 있는지 검사하고 싶다 | 잘 맞습니다. RAGTruth 점수가 가장 많이 올랐습니다 |
| AI 에이전트가 다음 행동을 고르게 하고 싶다 | 맞습니다. 이 용도를 노린 모델입니다 |
| 요약, 번역, 답장 쓰기 | 맞지 않습니다. 글을 만들지 못합니다 |
| LM Studio로 내 PC에서 가볍게 써 보고 싶다 | 지금은 어렵습니다. GGUF가 나오고 LM Studio가 이런 모델을 지원해야 합니다 |
이 표가 뜻하는 것은, pplx-decider가 대화용 AI가 아니라 프로그램 안에 넣는 부품이라는 점입니다.
정리
- pplx-decider-v1-27b는 글 대신 보기마다 확률을 돌려주는 판단 모델입니다. Qwen3.8 27B를 바탕으로 만들었고, Apache 2.0으로 공개됐습니다.
- Perplexity가 잰 11가지 시험에서 85.71%로, 바탕 모델(74.76%)보다 약 11%포인트 높았습니다. 자료에 없는 말을 가려내는 시험(RAGTruth)에서 가장 크게 올랐습니다.
- API 요금은 입력 100만 토큰에 0.04달러이고 출력은 무료입니다. 댓글 1,000개를 가려도 20원이 안 됩니다.
- 원본은 약 52GB라서 집에서 쓰는 그래픽카드에는 4비트로 줄인 파일이라야 올라갑니다. LM Studio와 Ollama에서는 아직 쓸 수 없습니다.
이 글의 한계
- 모델을 내려받아 직접 돌려 보지 않았습니다. 기능, 점수, 응답 시간은 Perplexity가 공개한 내용입니다.
- VRAM 판정은 파일 크기와 4비트 파일 제작자가 적은 메모리 사용량으로 가늠한 것입니다.
- Jev, Clef, OpenAI Decisions API의 내용은 각 회사 발표를 전한 보도를 바탕으로 했습니다.
- 요금과 제한은 2026년 10월 3일에 확인한 값이고 바뀔 수 있습니다.
자주 묻는 질문
pplx-decider-v1-27b는 무료로 쓸 수 있나요?
모델 파일은 허깅페이스에서 무료로 받을 수 있고, Apache 2.0이라 상업적으로도 쓸 수 있습니다. 직접 돌리려면 약 49GiB 넘는 VRAM이 필요합니다. Perplexity의 Decisions API로 쓰면 입력 100만 토큰에 0.04달러를 내고, 출력에는 요금이 없습니다.
ChatGPT처럼 대화할 수 있나요?
아니요. 문장을 만들지 않고, 정해 둔 보기 가운데 무엇이 맞는지 확률로만 답합니다. 예/아니오(noul), 여러 보기 중 고르기(choice), 점수 매기기(score) 세 가지 형식만 있습니다.
LM Studio나 Ollama에서 돌릴 수 있나요?
지금은 어렵습니다. 공식 GGUF 파일이 없고, 문장을 만드는 대신 판단용 부분(readout)으로 확률을 읽는 구조라서 문장 생성 프로그램에서는 그대로 열리지 않습니다. 공식 방법은 파이썬과 함께 올라온 실행 코드(inference.py)입니다.
RTX 5090이나 16GB 그래픽카드로 돌릴 수 있나요?
원본(약 52GB)은 둘 다 들어가지 않습니다. 커뮤니티가 만든 4비트 EXL3 파일(15.35GB)은 컨텍스트 8,192에서 약 15.0GiB를 쓴다고 적혀 있어, RTX 5090 32GB에는 들어가고 16GB 카드는 빠듯합니다.
바탕이 된 Qwen3.8 27B보다 무엇이 나아졌나요?
Perplexity가 잰 11가지 시험의 평균이 74.76%에서 85.71%로 올랐습니다. 특히 AI가 쓴 답에 자료에 없는 말이 섞였는지 가려내는 시험(RAGTruth)이 61.53%에서 88.80%로 크게 올랐습니다.
참고: Perplexity Decisions API 개발 문서 · 허깅페이스 모델 카드: perplexity-ai/pplx-decider-v1-27b · Perplexity Developers 발표 (X, 2026년 10월 1일) · 커뮤니티 4비트 EXL3 파일 · The Neuron: 10월 1일 AI 소식 (Clef, Decisions API) · AI Weekly: Jev 사용 현황 (월스트리트저널 보도 인용)
댓글 0개