AMD의 새 칩 Ryzen AI Max PRO 400 시리즈가 들어간 PC가 팔리기 시작했습니다. 이 칩은 그래픽카드를 따로 달지 않고도 메모리 160GB를 AI 모델에 쓸 수 있다는 점이 핵심입니다. AMD는 3,000억 파라미터(300B) 모델까지 PC 한 대에서 돌릴 수 있다고 밝혔습니다.
이 글은 AMD 공식 발표문을 읽고 정리한 뒤, 이 블로그에서 RTX 5090으로 잰 값을 가져와 "정말 300B가 들어가는지", "들어가면 쓸 만한 속도가 나오는지"를 계산해 본 글입니다. 결과를 먼저 적으면 이렇습니다.
- AI에 쓸 수 있는 메모리가 160GB입니다. RTX 5090(32GB)의 5배이고, 앞 세대(96GB)의 1.67배입니다.
- 300B 모델은 정확히 4비트일 때만 들어갑니다. 흔히 쓰는 GGUF Q4_K_M 방식으로는 약 185GB가 필요해서 넘칩니다. 이 방식으로는 260B 정도가 한계입니다.
- 들어가는 것과 빠른 것은 다릅니다. 이 칩이 메모리를 읽는 속도는 RTX 5090의 약 7분의 1입니다. 300B 모델을 통째로 읽어야 한다면 계산상 초당 2토큰을 넘기 어렵습니다.
- 192GB 제품은 6,799달러부터입니다. Framework Desktop이 6,799달러, HP 노트북이 7,449달러입니다.
이 칩이 들어간 PC를 직접 써 보지는 않았습니다. 사양과 가격은 발표된 값이고, "계산"이라고 적은 숫자는 직접 잰 것이 아니라 공개된 규격으로 계산한 값입니다.
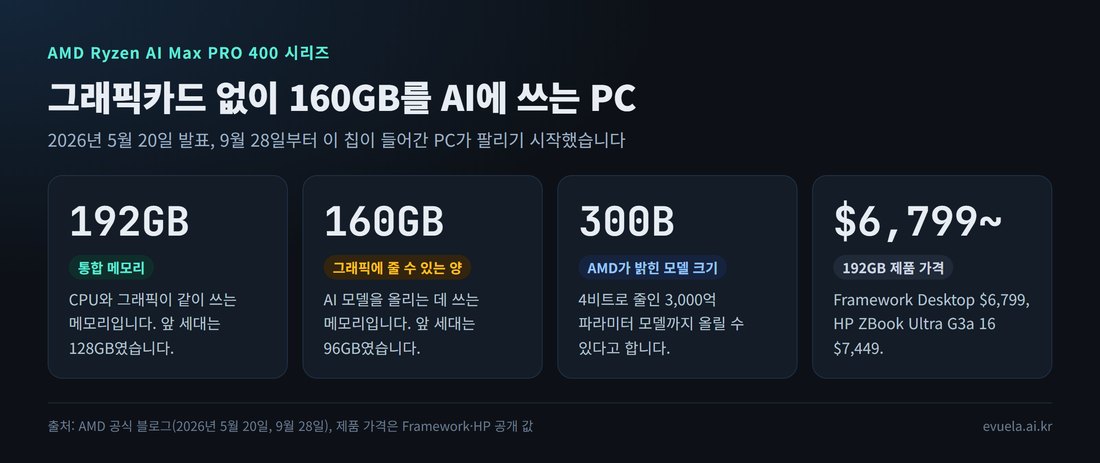
이번 발표의 핵심 숫자 네 가지입니다.
무엇이 나왔나
AMD는 2026년 5월 20일에 Ryzen AI Max PRO 400 시리즈를 처음 공개했고, 9월 28일에 이 칩이 들어간 PC를 파트너 회사들이 팔기 시작했다고 알렸습니다. AMD의 컴퓨팅·그래픽 부문 책임자 Jack Huynh는 발표문에서 이렇게 말했습니다.
“AI is no longer confined to the cloud.”
Jack Huynh, AMD (2026년 5월 20일 발표문)
풀어 쓰면, AI를 꼭 인터넷 너머의 서버에서만 돌릴 필요가 없다는 말입니다. ChatGPT 같은 서비스는 질문을 회사 서버로 보내고 답을 받아 옵니다. 반대로 내 PC 안에서 모델을 돌리면 자료가 밖으로 나가지 않고, 쓴 만큼 요금을 내지도 않습니다. 대신 PC의 메모리가 모델을 담을 만큼 커야 합니다. 이번 칩은 그 메모리를 크게 늘린 제품입니다.
AMD는 이 칩을 300B 모델을 PC 안에서 돌릴 수 있는 첫 x86 PC용 프로세서라고 소개했습니다. x86은 인텔과 AMD의 일반 PC용 칩을 말합니다. 애플의 맥은 다른 종류의 칩을 쓰기 때문에 이 비교에서 빠집니다.
| 날짜 | 내용 |
|---|---|
| 2026년 5월 20일 | AMD가 Ryzen AI Max PRO 400 시리즈를 공개 |
| 2026년 9월 28일 | AMD가 이 칩이 들어간 PC의 판매 시작을 알림 |
| 2026년 10월 | HP ZBook Ultra G3a 16 (16인치 노트북) 출시 예정 |
| 2026년 11월 | Framework Desktop 192GB 모델 첫 물량 배송 예정 |
이 표가 뜻하는 것은, 칩 자체는 넉 달 전에 공개됐고 실제로 살 수 있는 제품이 지금 나오기 시작했다는 점입니다.
세 가지 모델
| 모델 | CPU 코어 | 최고 속도 | 내장 그래픽 | NPU | 통합 메모리 |
|---|---|---|---|---|---|
| Ryzen AI Max+ PRO 495 | 16코어 32스레드 | 5.2GHz | Radeon 8065S (연산 유닛 40개) | 최대 55 TOPS | 192GB |
| Ryzen AI Max PRO 490 | 12코어 24스레드 | 5.0GHz | Radeon 8050S (연산 유닛 32개) | 최대 50 TOPS | 192GB |
| Ryzen AI Max PRO 485 | 8코어 16스레드 | 5.0GHz | Radeon 8050S (연산 유닛 32개) | 최대 50 TOPS | 192GB |
이 표가 뜻하는 것은, 세 모델 모두 메모리는 192GB까지 같고 CPU 코어 수와 내장 그래픽이 다르다는 점입니다. 전력은 세 모델 모두 45~120W로 설정할 수 있습니다. NPU는 AI 계산을 돕는 작은 전용 칩이고, TOPS는 1초에 할 수 있는 계산 횟수를 나타내는 단위입니다.
통합 메모리가 무엇인가
보통 PC에는 메모리가 두 군데 있습니다. 하나는 시스템 램이고, 하나는 그래픽카드 안에 있는 VRAM입니다. AI 모델은 그래픽카드가 계산하므로 VRAM에 들어가야 빠릅니다. 그런데 VRAM은 그래픽카드를 살 때 정해져서 나중에 늘릴 수 없습니다. RTX 5060 Ti는 16GB, RTX 5090은 32GB입니다.
통합 메모리는 이 둘을 나누지 않고 하나로 둔 것입니다. CPU와 내장 그래픽이 같은 메모리를 같이 씁니다. 그래서 192GB 중에서 160GB를 그래픽 몫으로 떼어 주고, 남은 32GB를 운영체제와 프로그램이 쓰는 식으로 나눌 수 있습니다.
예를 들어 책상 두 개를 따로 쓰던 것을 큰 책상 하나로 합친 것과 비슷합니다. 따로 쓸 때는 한쪽이 좁아도 다른 쪽을 빌려 쓸 수 없었는데, 합치고 나면 필요한 쪽에 더 넓게 자리를 줄 수 있습니다.
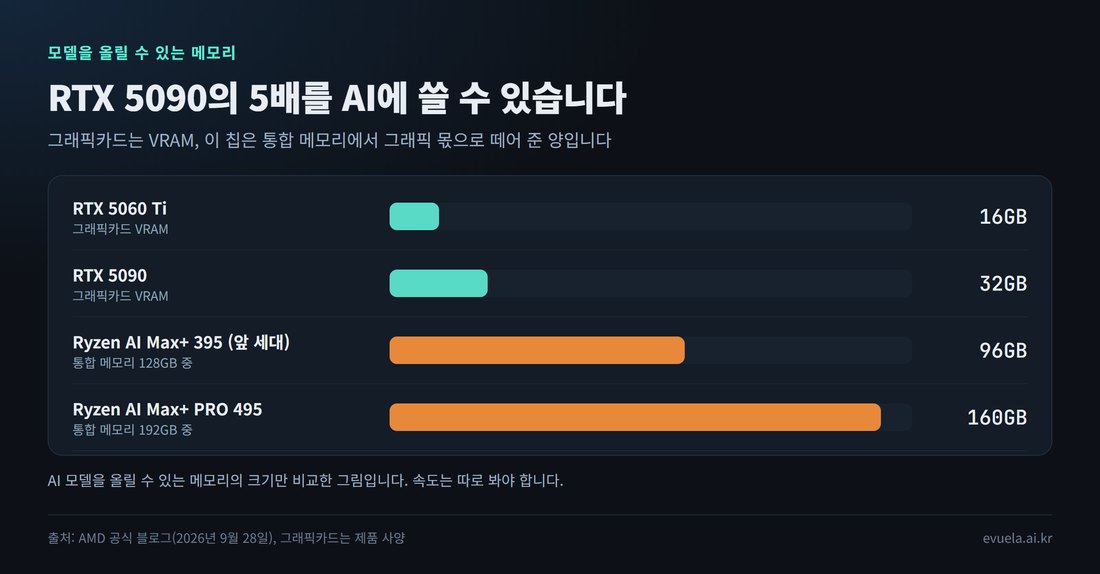
모델을 올릴 수 있는 메모리의 크기입니다. 주황색이 AMD의 통합 메모리 칩입니다.
VRAM이 모자라면 어떻게 되는지는 16GB 그래픽카드에 Qwen3.8 27B를 올려 본 글에 있습니다. 모델이 VRAM에 다 들어가지 않으면 속도가 크게 떨어집니다. 통합 메모리는 처음부터 큰 메모리를 그래픽이 직접 쓰게 해서 이 문제를 피합니다.
300B가 정말 들어가나
AMD는 각주에서 이 주장의 조건을 밝혔습니다. 그래픽 메모리 160GB에 4비트로 양자화한 300B 이상의 모델을 올릴 수 있다는 것입니다. 양자화는 모델의 숫자들을 더 적은 비트로 줄여서 크기를 줄이는 방법입니다.
계산은 간단합니다. 파라미터 300B(3,000억 개)를 하나에 4비트씩 담으면 300 × 4 ÷ 8 = 150GB입니다. 160GB 안에 들어가고 10GB가 남습니다.
그런데 로컬 AI에서 흔히 쓰는 GGUF 파일의 "Q4_K_M"은 이름과 달리 정확히 4비트가 아닙니다. 93번 글에서 Qwen3.8 27B의 Q4_K_M 파일을 직접 읽어 보니, 파라미터 27.32B에 파일이 16.81GB였습니다. 평균 4.92비트입니다. 중요한 부분은 6비트로 남겨 두기 때문입니다.
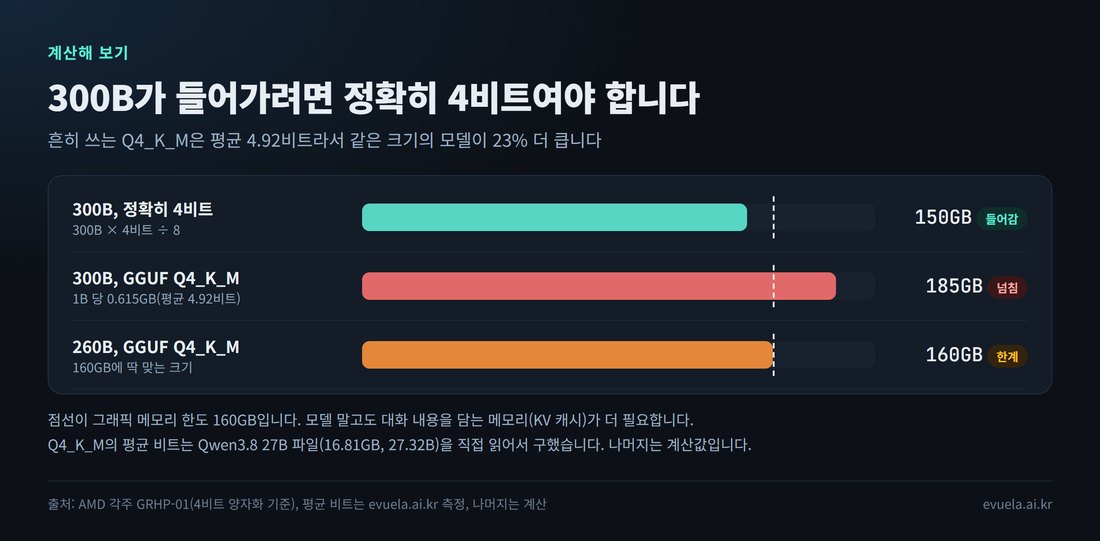
점선이 160GB 한도입니다. 같은 300B라도 양자화 방식에 따라 들어가기도 하고 넘치기도 합니다.
| 경우 | 필요한 메모리 (계산) | 160GB에 들어가나 |
|---|---|---|
| 300B, 정확히 4비트 | 150GB | 들어감 (10GB 남음) |
| 300B, GGUF Q4_K_M (평균 4.92비트) | 약 185GB | 넘침 (약 25GB 모자람) |
| 260B, GGUF Q4_K_M | 약 160GB | 모델만으로 꽉 참 |
이 표가 뜻하는 것은, AMD의 "300B"는 정확히 4비트로 줄인 모델을 기준으로 한 숫자라는 점입니다. 사람들이 많이 받는 Q4_K_M 파일로는 260B 정도가 한계입니다. 그리고 모델만 올린다고 끝이 아닙니다. 대화 내용을 기억하는 메모리(KV 캐시)가 따로 필요해서, 긴 대화를 하려면 이보다 작은 모델을 골라야 합니다.
평균 비트 수는 모델마다 조금씩 다릅니다. 위 계산은 Qwen3.8 27B 파일 하나에서 구한 값을 다른 크기에 그대로 적용한 것이라, 대략의 크기를 가늠하는 용도로 봐 주세요.
들어가는 것과 쓸 만한 것은 다르다
메모리가 크면 큰 모델을 올릴 수 있습니다. 하지만 답이 나오는 속도는 다른 문제입니다. 모델이 토큰 하나를 만들 때마다 메모리에 있는 숫자들을 읽어야 하는데, 이 읽는 속도(메모리 대역폭)가 그래픽카드보다 훨씬 느리기 때문입니다.
이 칩은 LPDDR5X-8533 메모리를 쓰고 대역폭은 초당 273GB입니다. RTX 5090의 VRAM은 초당 1,792GB를 읽습니다. 약 6.6배 차이입니다.
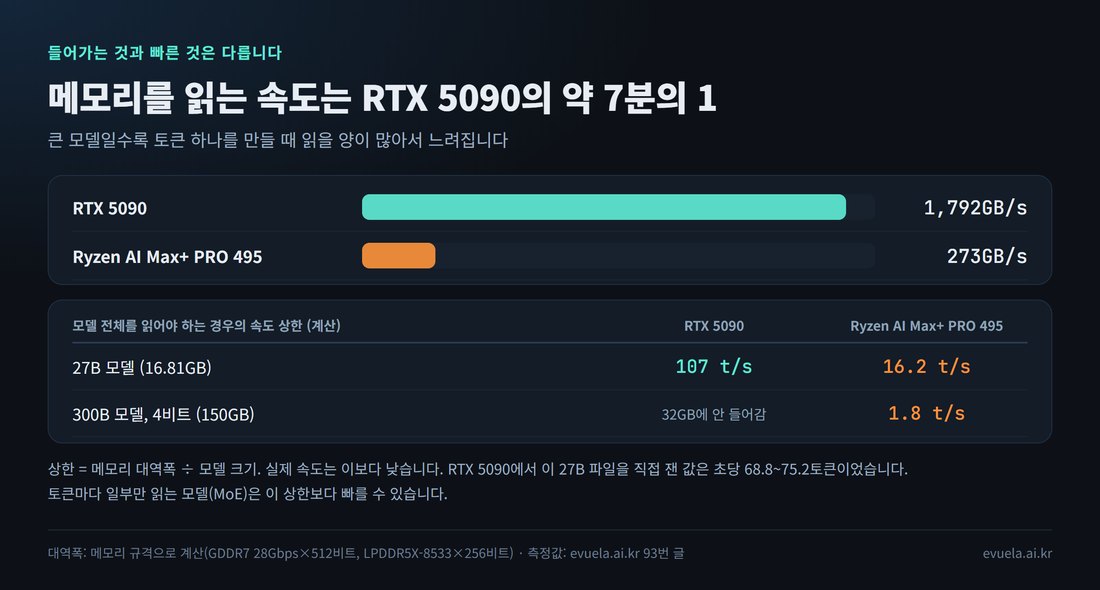
위는 메모리를 읽는 속도, 아래는 그 속도로 계산한 생성 속도의 상한입니다.
모델 전체를 한 번 읽어야 토큰 하나가 나온다고 보면, 속도의 상한은 "대역폭 ÷ 모델 크기"로 계산할 수 있습니다.
| 모델 | RTX 5090 (계산한 상한) | Ryzen AI Max+ PRO 495 (계산한 상한) |
|---|---|---|
| 27B 모델, 16.81GB | 초당 107토큰 | 초당 16.2토큰 |
| 300B 모델 4비트, 150GB | VRAM 32GB에 들어가지 않아 계산하지 않음 | 초당 1.8토큰 |
이 표가 뜻하는 것은, 300B 모델을 올릴 수는 있어도 통째로 읽어야 하는 모델이라면 초당 2토큰을 넘기 어렵다는 점입니다. 한글 한 문장이 나오는 데 수십 초가 걸리는 속도입니다.
이 계산이 실제와 얼마나 맞는지 RTX 5090으로 확인할 수 있습니다. 같은 27B 파일을 RTX 5090에서 직접 쟀을 때 초당 68.8~75.2토큰이 나왔습니다(93번 글, MTP 끔). 계산한 상한 107토큰의 64~70%입니다. 실제 속도는 상한보다 낮게 나옵니다.
그래도 빠른 경우가 있다
모든 모델이 매번 전체를 읽는 것은 아닙니다. MoE(여러 전문가 묶음 가운데 일부만 골라 쓰는 구조) 모델은 토큰마다 일부만 읽어서, 전체 크기가 커도 훨씬 빠릅니다. 큰 메모리의 이점은 이런 모델에서 잘 드러납니다.
AMD가 공개한 숫자도 있습니다. 128GB짜리 개발자용 PC(Ryzen AI Halo, 출시 전 제품)에서 컨텍스트 128K로 초당 36토큰을 냈다고 각주에 적었습니다. LM Studio와 llama.cpp(Vulkan)로 잰 값입니다. 다만 어떤 모델로 잰 것인지는 각주에 적혀 있지 않습니다. 그래서 위 계산과 그대로 비교할 수는 없습니다.
새 칩(495)으로 잰 독립적인 속도 측정은 아직 찾지 못했습니다. 제품이 막 나오기 시작한 때라, 리뷰가 나오면 위 계산이 맞는지 확인할 수 있습니다.
가격과 살 수 있는 제품
| 제품 | 칩과 메모리 | 가격 | 시기 |
|---|---|---|---|
| Framework Desktop (조립형) | Ryzen AI Max+ PRO 495, 192GB | 6,799달러 | 11월 배송. 첫 물량은 예약 몇 시간 만에 매진 |
| Framework Desktop (완제품) | 위와 같음, SSD 2TB, 리눅스(Fedora) | 7,449달러 | 11월 배송 |
| HP ZBook Ultra G3a 16 (노트북) | Ryzen AI Max+ PRO 495, 192GB, SSD 512GB | 7,449달러 | 10월 출시 예정 |
| HP ZBook Ultra G3a 16 | Ryzen AI Max+ PRO 495, 128GB | 5,999달러 | 10월 출시 예정 |
| HP ZBook Ultra G3a 16 | Ryzen AI Max PRO 490, 64GB | 3,899달러 | 10월 출시 예정 |
| AMD Ryzen AI Halo (개발자용 소형 PC) | 앞 세대 Ryzen AI Max+ 395, 128GB | 3,999.99달러 | 미국 Micro Center 매장에서 판매 중 |
이 표가 뜻하는 것은, 192GB 구성은 약 7천 달러대이고, 메모리를 128GB로 낮추면 6천 달러, 앞 세대 칩이면 4천 달러라는 점입니다. HP 가격은 정식 발표가 아니라 HP가 공개한 비용 계산기에 들어 있던 값으로 알려졌습니다. 한국 출시 가격과 시기는 아직 확인되지 않았습니다.
RTX 5090과 무엇이 다른가
| 항목 | RTX 5090 | Ryzen AI Max+ PRO 495 |
|---|---|---|
| AI에 쓸 메모리 | 32GB | 최대 160GB |
| 메모리를 읽는 속도 | 초당 1,792GB | 초당 273GB |
| 27B 모델(16.81GB) 생성 속도 | 초당 68.8~75.2토큰 (직접 잰 값) | 상한 초당 16.2토큰 (계산) |
| 32GB를 넘는 모델 | 일부가 시스템 램으로 넘어가 크게 느려짐 | 160GB까지는 그래픽 메모리에 그대로 올라감 |
| 형태 | 데스크톱에 다는 그래픽카드 | 노트북이나 소형 PC 한 대 |
| 전력 | 카드만 수백 W | 칩 전체 45~120W |
이 표가 뜻하는 것은, 두 제품이 잘하는 일이 다르다는 점입니다. 32GB 안에 들어가는 모델은 RTX 5090이 몇 배 빠릅니다. 32GB를 넘는 큰 모델은 RTX 5090에 다 올라가지 않으니, 느리더라도 통째로 올릴 수 있는 쪽이 낫습니다.
- RTX 5090 같은 그래픽카드가 맞는 경우: 30B 안팎의 모델을 빠르게 쓰려는 사람. 코드 작성처럼 답이 빨리 나와야 하는 일.
- 이 칩이 맞는 경우: 100B가 넘는 큰 모델이나 일부만 읽는 큰 MoE 모델을 한 대에서 돌리려는 사람. 여러 모델을 동시에 올려 두고 쓰려는 사람. 노트북 한 대로 들고 다니려는 사람.
내 그래픽카드에 어떤 모델이 들어가는지는 GPU 체험에서 볼 수 있습니다.
쓸 수 있는 프로그램
AMD는 이 칩에서 쓸 수 있는 도구로 PyTorch, vLLM, llama.cpp, Ollama, ComfyUI, LM Studio를 들었습니다. Windows와 Linux를 모두 지원합니다. 이 블로그에서 쓰는 LM Studio가 그대로 돌아간다는 뜻이라, 지금까지의 테스트 방법을 그대로 적용할 수 있습니다. LM Studio와 Unsloth Studio의 차이는 두 프로그램을 비교한 글에 정리했습니다.
정리
- 이 칩의 의미는 "그래픽카드의 VRAM 한계를 메모리 크기로 넘었다"는 데 있습니다. 32GB에서 막히던 큰 모델을 160GB까지 올릴 수 있습니다.
- 다만 300B라는 숫자는 정확히 4비트일 때의 한계이고, 흔한 Q4_K_M으로는 260B 정도입니다.
- 속도는 메모리 대역폭이 정합니다. 대역폭이 RTX 5090의 약 7분의 1이라, 작은 모델에서는 그래픽카드가 훨씬 빠릅니다.
- 가격이 7천 달러 안팎이라, 큰 모델을 꼭 내 PC에서 돌려야 하는 사람에게 맞는 제품입니다.
이 글의 한계
- 이 칩이 들어간 PC를 직접 써 보지 않았습니다. 사양과 가격은 AMD와 제조사가 공개한 값입니다.
- 속도 상한은 메모리 규격으로 계산한 값입니다. 실제 속도는 모델 구조, 프로그램, 전력 설정에 따라 달라집니다.
- Q4_K_M의 평균 비트는 Qwen3.8 27B 파일 하나에서 구했습니다. 다른 모델은 조금 다를 수 있습니다.
- HP 제품 가격은 정식 발표 전 값이라 바뀔 수 있습니다. 한국 가격은 확인하지 못했습니다.
자주 묻는 질문
Ryzen AI Max PRO 400은 그래픽카드 없이 AI 모델을 돌리나요?
네. 칩 안의 내장 그래픽이 통합 메모리를 직접 씁니다. 192GB 중 최대 160GB를 그래픽 몫으로 줄 수 있어서, 따로 그래픽카드를 달지 않고 큰 모델을 올릴 수 있습니다.
300B 모델이 정말 들어가나요?
정확히 4비트로 줄인 모델은 150GB라서 들어갑니다. 하지만 흔히 쓰는 GGUF Q4_K_M 파일은 평균 4.92비트라서 300B면 약 185GB가 필요하고, 160GB를 넘습니다. Q4_K_M으로는 260B 정도가 한계입니다.
RTX 5090보다 빠른가요?
32GB 안에 들어가는 모델은 RTX 5090이 훨씬 빠릅니다. 메모리를 읽는 속도가 초당 1,792GB와 273GB로 약 6.6배 차이 나기 때문입니다. 32GB를 넘는 큰 모델은 RTX 5090에 다 올라가지 않아서, 그때는 이 칩이 유리합니다.
가격은 얼마인가요?
192GB 구성은 Framework Desktop이 6,799달러부터, HP ZBook Ultra G3a 16 노트북이 7,449달러입니다. 128GB 구성의 HP 노트북은 5,999달러로 알려졌습니다. 한국 가격은 아직 확인되지 않았습니다.
통합 메모리는 나중에 늘릴 수 있나요?
HP 노트북은 메모리가 기판에 붙어 있어서 늘릴 수 없는 것으로 알려졌습니다. 살 때 필요한 용량을 정해야 합니다.
참고: AMD 공식 블로그 (2026년 5월 20일) · AMD 공식 블로그 (2026년 9월 28일) · ServeTheHome · StorageReview · Phoronix · Notebookcheck
댓글 0개