로컬 AI를 돌릴 때 LM Studio와 Unsloth Studio 중에 무엇을 쓸지 고민하는 분이 많습니다. 두 프로그램 모두 안에서는 llama.cpp라는 같은 엔진을 쓰기 때문에 "어차피 같은 것 아닌가"라는 말도 나옵니다. 그래서 RTX 5090에서 같은 모델 파일을 두 프로그램에 차례로 올리고, 설정을 똑같이 맞춰서 재 봤습니다. 파일은 두 가지를 썼습니다. unsloth가 올린 Qwen3.8 27B와 lmstudio-community가 올린 Qwen3.8 27B입니다. 그래서 "프로그램을 바꾸면 얼마나 다른가"와 "파일을 올린 곳이 다르면 얼마나 다른가"를 같이 볼 수 있습니다.
결과를 먼저 적으면 이렇습니다.
- MTP를 끄면 속도 차이가 작았습니다. unsloth 파일로 LM Studio는 초당 63.9토큰, Unsloth Studio는 초당 66.0토큰이었습니다.
- MTP를 켜면 차이가 났습니다. 같은 설정(초안 토큰 2개)에서 LM Studio는 초당 70.5토큰, Unsloth Studio는 초당 96.1토큰으로 36% 빨랐습니다.
- 파일을 lmstudio-community 것으로 바꾸면 두 프로그램 모두 8~15% 더 빨라졌습니다. 가장 빠른 조합은 Unsloth Studio에 lmstudio-community 파일을 올린 것으로, 초당 109.1토큰이었습니다.
- 답의 품질은 프로그램을 바꿔도, 파일을 바꿔도 같았습니다. 채점 질문 150번 중 네 조합이 105~110번을 맞혔고, 긴 글 속 정보 찾기와 없는 소설 질문도 결과가 같았습니다.
- 컨텍스트를 131,072로 키우면 Unsloth Studio는 사진 설명이 49초로 느려졌습니다. LM Studio는 같은 조건에서 1.7초였습니다.
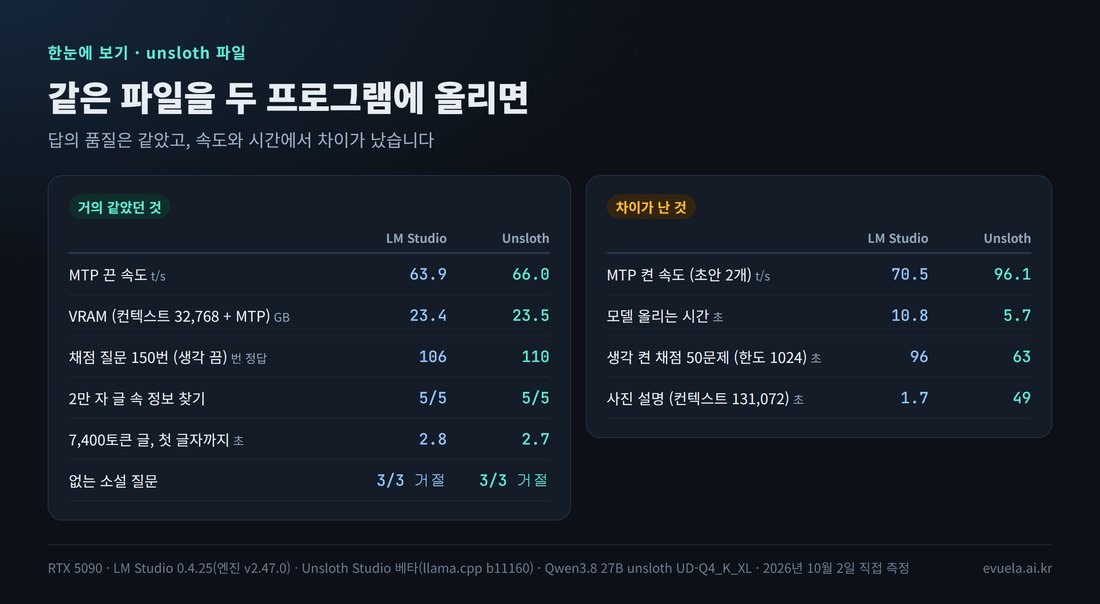
unsloth 파일을 두 프로그램에 올린 결과입니다. 왼쪽은 거의 같았던 항목이고, 오른쪽은 차이가 난 항목입니다.
무엇을 어떻게 비교했나
이 글은 Unsloth Studio로 Qwen3.8 27B 설정을 찾아본 글에 이어지는 두 번째 글입니다. 앞 글에서는 Unsloth Studio만 썼고, 이번에는 LM Studio와 나란히 놓고 쟀습니다.
| 항목 | 내용 |
|---|---|
| 그래픽카드 | RTX 5090 32GB |
| 모델 파일 ① | Qwen3.8 27B UD-Q4_K_XL (unsloth, 17.92GB). Unsloth Studio 모델 허브에 나오는 파일 |
| 모델 파일 ② | Qwen3.8 27B Q4_K_M (lmstudio-community, 16.81GB). LM Studio 검색에 나오는 파일 |
| 파일 위치 | 둘 다 LM Studio 모델 폴더에 두고, 두 프로그램이 같은 파일을 읽음 |
| LM Studio | 0.4.25, 엔진 CUDA 12 llama.cpp v2.47.0 (프로그램에 "Latest version"으로 표시됨) |
| Unsloth Studio | 베타, 엔진 llama.cpp b11160 (Unsloth 팀이 직접 빌드한 것) |
| 맞춘 설정 | 컨텍스트 32,768 또는 131,072, MTP 켬·끔, 초안 토큰 2개 또는 3개, 동시 요청 4개, KV 캐시 f16, 모든 레이어를 그래픽카드에 |
| 질문 보내는 방법 | 두 프로그램의 API에 같은 질문과 같은 샘플링 값(temperature 0.6, top_p 0.95, top_k 20, presence_penalty 1.5)을 보냄 |
| 잰 날짜 | 2026년 10월 2일 |
이 표가 뜻하는 것은, 파일과 설정과 질문을 모두 같게 두고 프로그램만 바꿨다는 점입니다. 그래서 차이가 나면 프로그램(과 그 안의 엔진 버전) 때문이라고 볼 수 있습니다. 글의 앞부분은 unsloth 파일로 두 프로그램을 비교하고, 뒷부분에서 lmstudio-community 파일로 바꿨을 때를 다룹니다.
같은 파일인지 확인하기
Unsloth Studio는 LM Studio의 모델 폴더를 자동으로 읽습니다. 모델 선택 창에 "LM STUDIO" 묶음이 따로 나오고, 여기서 고르면 새로 내려받지 않고 그 파일을 그대로 올립니다. 실제로 Unsloth Studio가 실행한 명령을 확인해 보니 LM Studio 폴더 안의 파일 경로가 들어 있었습니다.
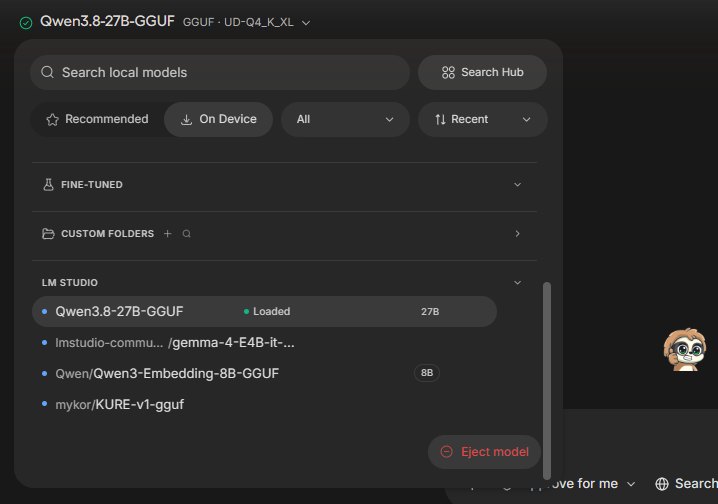
Unsloth Studio의 모델 선택 창입니다. "LM STUDIO" 묶음에 있는 Qwen3.8 27B가 Loaded로 표시됩니다.
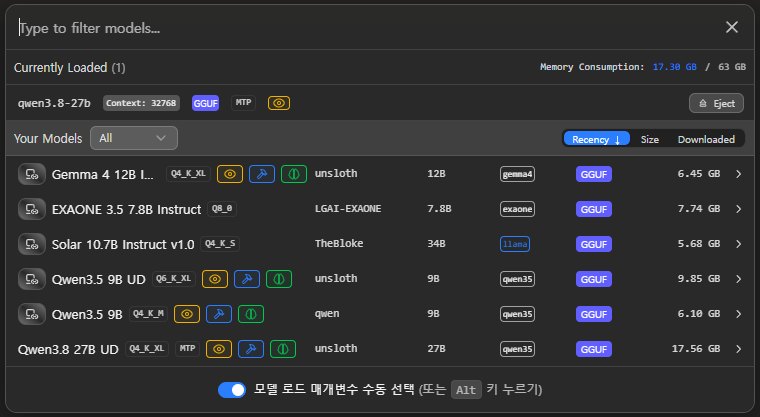
LM Studio의 모델 선택 창입니다. 같은 파일이 컨텍스트 32,768과 MTP로 올라가 있습니다.
설정 맞추기
두 프로그램의 설정 화면에서 컨텍스트 길이, MTP, 초안 토큰 수를 같은 값으로 맞췄습니다. MTP는 모델이 다음에 나올 토큰 몇 개를 미리 찍어 두고, 맞으면 한꺼번에 내보내서 속도를 올리는 기능입니다. 미리 찍는 개수가 "초안 토큰"입니다.
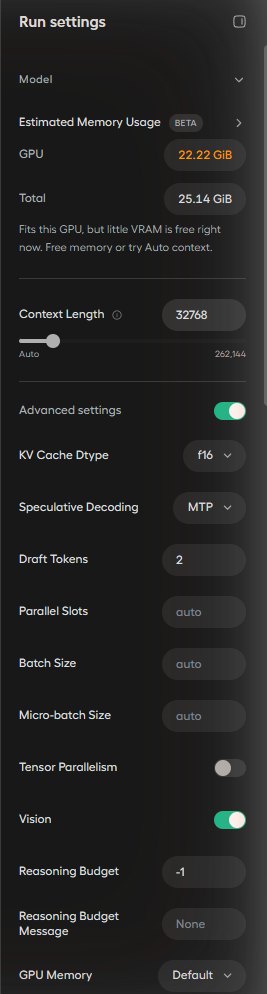
Unsloth Studio의 실행 설정입니다. 컨텍스트 32,768, Speculative Decoding은 MTP, Draft Tokens는 2입니다.
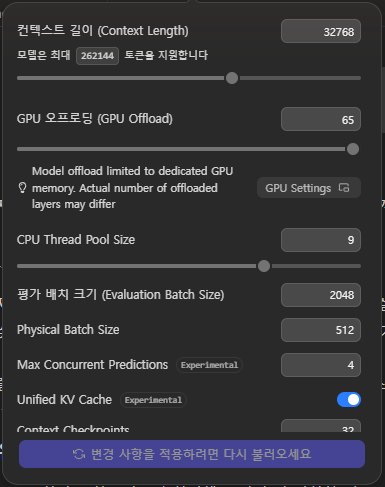
LM Studio의 로드 설정 윗부분입니다. 컨텍스트 32,768, 동시 요청 4개입니다.
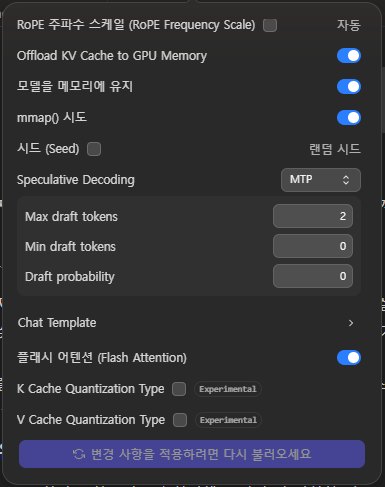
같은 창을 아래로 내린 화면입니다. Speculative Decoding은 MTP, Max draft tokens는 2입니다.
엔진 버전은 서로 다르다
두 프로그램 모두 llama.cpp를 쓰지만, 각자 따로 빌드한 것을 넣어 둡니다. LM Studio는 "CUDA 12 llama.cpp v2.47.0"이고 프로그램 안에서 최신 버전으로 표시됐습니다. Unsloth Studio는 자기 저장소에서 빌드한 b11160을 씁니다. 그래서 같은 llama.cpp라도 버전과 빌드 방식이 다릅니다. 아래 결과는 이 차이까지 포함한 비교입니다.
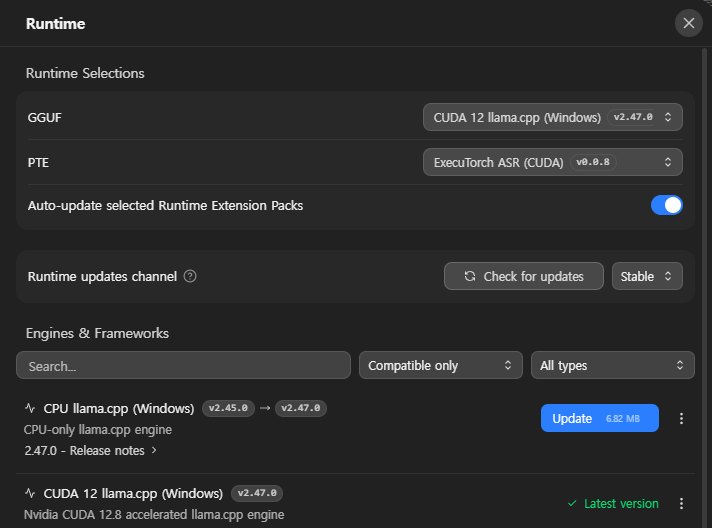
LM Studio의 Runtime 화면입니다. 쓰고 있는 엔진이 v2.47.0이고 최신 버전이라고 나옵니다.
속도: MTP를 끄면 거의 같고, 켜면 차이가 난다
800자 글을 5번 쓰게 하고 초당 토큰 수의 평균을 냈습니다. 생각(Thinking)은 껐습니다. 이 절의 숫자는 unsloth 파일로 잰 것입니다.
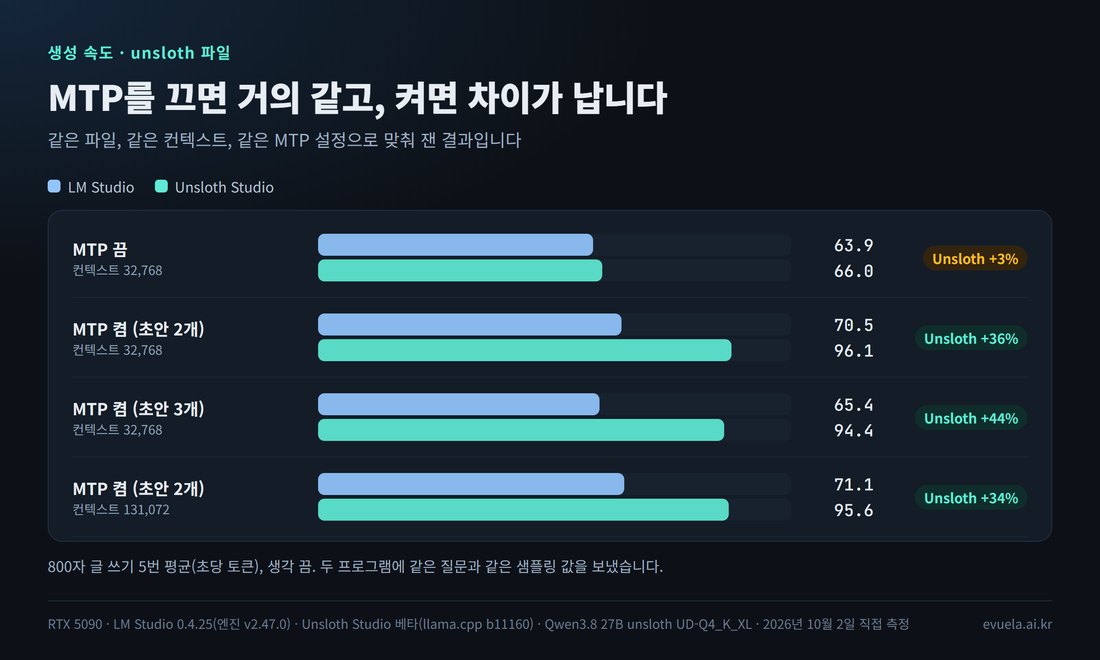
조건마다 위 막대가 LM Studio, 아래 막대가 Unsloth Studio입니다.
| 조건 | LM Studio | Unsloth Studio | 차이 |
|---|---|---|---|
| MTP 끔, 컨텍스트 32,768 | 63.9 t/s | 66.0 t/s | 3% |
| MTP 켬(초안 2개), 컨텍스트 32,768 | 70.5 t/s | 96.1 t/s | 36% |
| MTP 켬(초안 3개), 컨텍스트 32,768 | 65.4 t/s | 94.4 t/s | 44% |
| MTP 켬(초안 2개), 컨텍스트 131,072 | 71.1 t/s | 95.6 t/s | 34% |
이 표가 뜻하는 것은 두 가지입니다. 첫째, MTP를 끄면 두 프로그램의 속도는 거의 같습니다. 둘째, MTP를 켰을 때 얻는 이득이 다릅니다. LM Studio는 MTP를 켜도 10% 빨라지는 데 그쳤고, Unsloth Studio는 46% 빨라졌습니다.
프로그램 화면에서 직접 물어봐도 같은 결과가 나왔습니다. Unsloth Studio는 답 아래에 초당 95.1토큰, LM Studio는 초당 70.41토큰이 표시됐습니다.
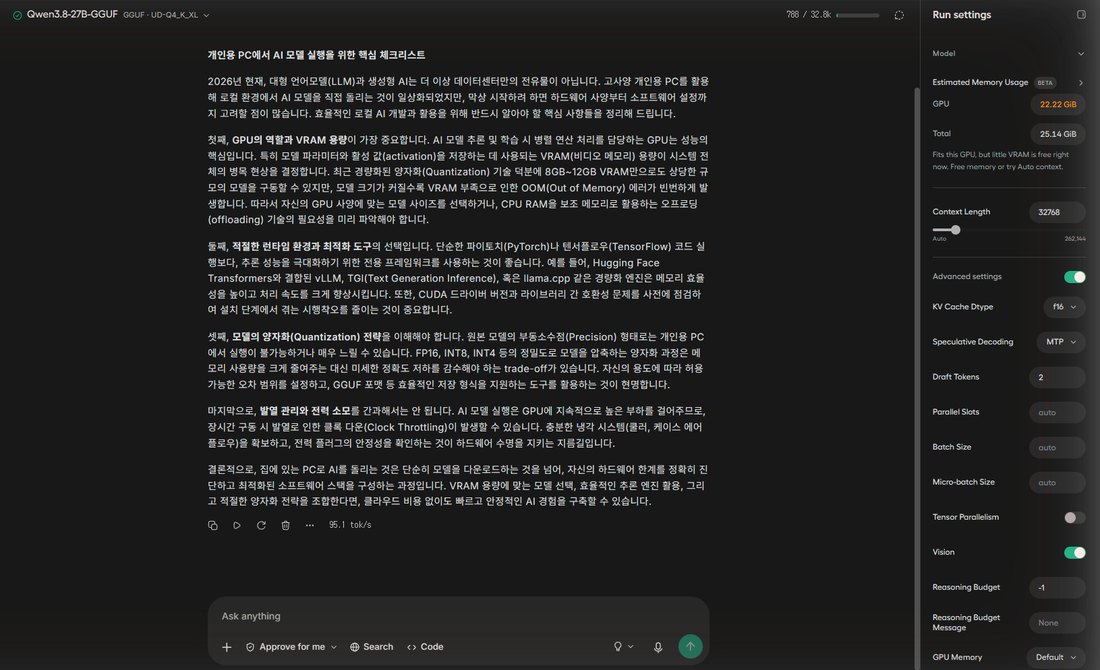
Unsloth Studio 화면입니다. 답 아래에 95.1 tok/s가 표시됩니다.
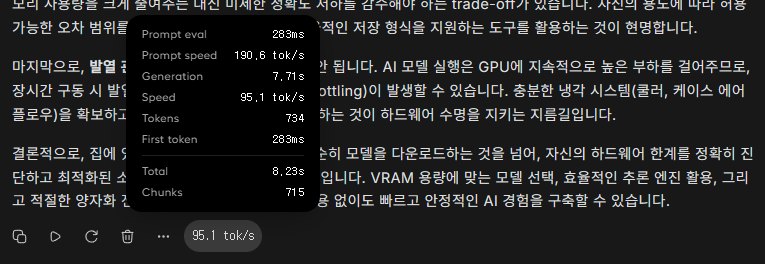
속도 숫자에 마우스를 올리면 나오는 통계입니다. 토큰 734개를 8.23초에 썼습니다.
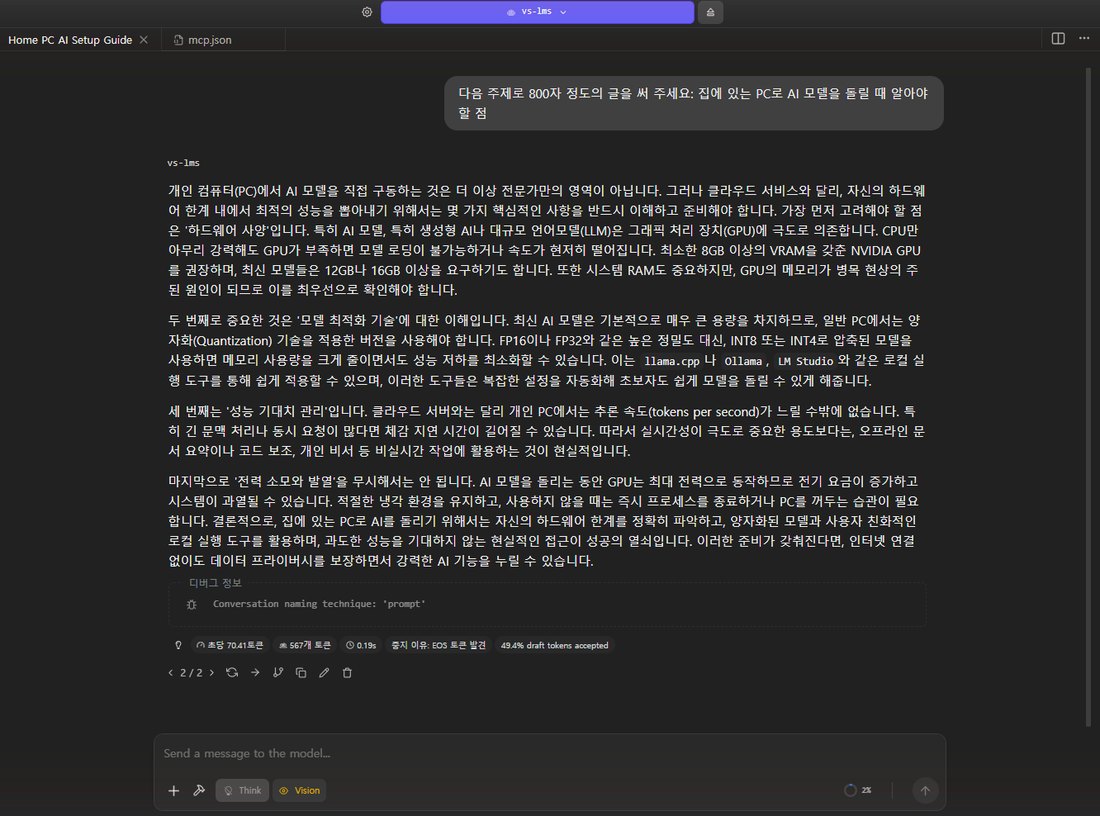
LM Studio 화면입니다. 같은 질문을 보냈습니다.
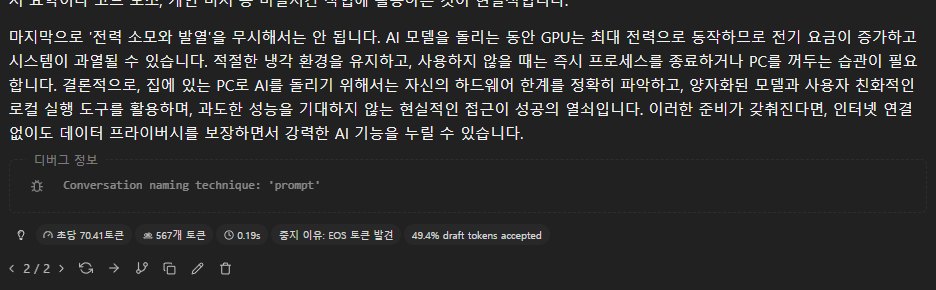
LM Studio는 답 아래에 초당 70.41토큰과 함께 초안 토큰이 맞은 비율(49.4%)도 보여 줍니다.
초안이 맞는 비율은 비슷했다
MTP는 미리 찍은 토큰이 많이 맞을수록 빨라집니다. 그래서 LM Studio에서 초안이 덜 맞은 것이 아닌지 두 프로그램의 엔진 기록을 확인했습니다. 800자 글 5번에서 초안이 맞은 비율은 LM Studio가 41~47%, Unsloth Studio가 47~53%로 큰 차이가 없었습니다. 초안을 만든 횟수도 비슷했습니다.
정리하면, 초안을 맞히는 정도는 비슷한데 그 결과로 얻는 속도가 다릅니다. 확인한 사실은 두 프로그램의 llama.cpp 버전과 빌드가 다르다는 것까지입니다. 엔진 안에서 정확히 어느 부분이 이 차이를 만드는지는 확인하지 못했습니다. LM Studio의 엔진이 새 버전으로 바뀌면 이 차이는 줄어들 수 있습니다.
LM Studio에서는 초안 토큰을 2개로
LM Studio는 MTP가 든 파일을 올리면 MTP를 자동으로 켜고 초안 토큰을 3개로 둡니다. 그런데 이번 측정에서는 3개일 때 초당 65.4토큰으로, MTP를 끈 것(63.9)과 거의 같았습니다. 2개로 줄이면 초당 70.5토큰이 나왔습니다. LM Studio에서 이 모델을 쓴다면 Max draft tokens를 2로 바꾸는 쪽이 낫습니다.
답의 품질은 같았다
같은 파일을 쓰니 답의 품질은 같아야 맞습니다. 실제로 그런지 세 가지로 확인했습니다. 설정은 컨텍스트 32,768, MTP 초안 2개, 생각 끔입니다.
| 테스트 | LM Studio | Unsloth Studio |
|---|---|---|
| 채점 질문 50개를 3번 (150번) | 106번 정답 (36, 36, 34) | 110번 정답 (39, 34, 37) |
| 산수 (60번) | 33번 | 40번 |
| 코드 (30번) | 19번 | 20번 |
| 논리 (24번) | 22번 | 19번 |
| 지식 (36번) | 32번 | 31번 |
| 2만 자 글 속에 숨긴 정보 찾기 | 5곳 모두 찾음 | 5곳 모두 찾음 |
| 숨기지 않은 글에서 "없음"이라고 답하기 | 맞게 답함 | 맞게 답함 |
| 7,402토큰 글 요약, 첫 글자까지 | 2.8초 | 2.7초 |
이 표가 뜻하는 것은 두 프로그램의 답 품질에 차이가 없다는 점입니다. 채점 질문은 4번 차이가 났지만, 같은 프로그램 안에서도 한 번 돌릴 때마다 34번에서 39번까지 오르내렸습니다. 4번은 그 범위 안에 들어가는 차이입니다. 긴 글을 처음 읽는 시간도 같았습니다.
한 가지 더 적어 둡니다. 800자 글 5번 중 1번꼴로 일본어 글자가 서너 개 섞여 나왔는데, 이것도 두 프로그램에서 똑같이 나타났습니다.
사진 설명: 컨텍스트가 크면 Unsloth Studio가 느려진다
모래시계 두 개가 찍힌 사진을 주고 3문장으로 설명하게 했습니다. 각 조건에서 3번씩 물었고, 모든 답이 사진 내용과 맞았습니다.
| 조건 | LM Studio | Unsloth Studio |
|---|---|---|
| 컨텍스트 32,768, MTP 끔 | 1.3~2.5초 | 2.1~2.7초 |
| 컨텍스트 32,768, MTP 켬 | 1.4~2.8초 | 1.8~2.0초 |
| 컨텍스트 131,072, MTP 켬 | 1.4~2.2초 | 48.6~49.3초 |
이 표가 뜻하는 것은, 컨텍스트가 작을 때는 두 프로그램이 비슷하지만 컨텍스트를 131,072로 키우면 Unsloth Studio만 사진 설명이 49초로 느려진다는 점입니다.
이유는 실행 명령에서 확인할 수 있었습니다. Unsloth Studio는 컨텍스트가 커서 VRAM이 빠듯해지면 사진을 읽는 부분(mmproj)을 그래픽카드가 아니라 CPU에서 돌리도록 스스로 바꿉니다. 그 대신 VRAM을 1GB쯤 덜 씁니다(28.8GB, LM Studio는 29.9GB). LM Studio는 사진을 읽는 부분도 그래픽카드에 그대로 올려 둡니다.
LM Studio는 같은 사진을 다시 물으면 첫 글자가 0.1초 만에 나왔습니다. 처음에는 0.7~1.1초였습니다. Unsloth Studio는 물을 때마다 0.7~0.9초가 걸렸습니다.
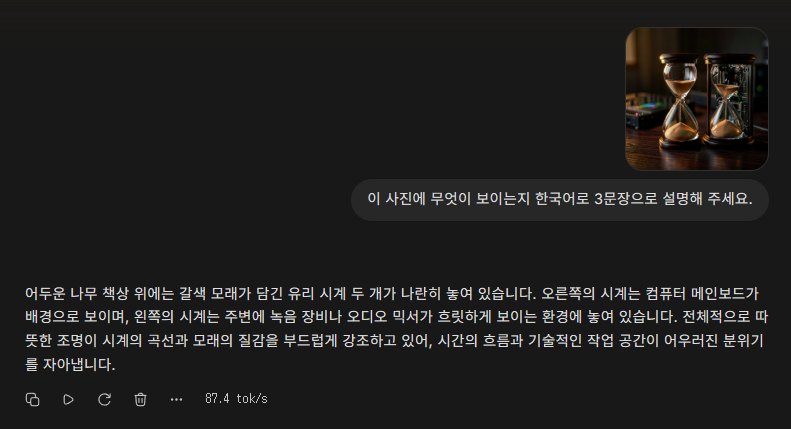
Unsloth Studio에서 사진을 설명하게 한 화면입니다(컨텍스트 32,768).
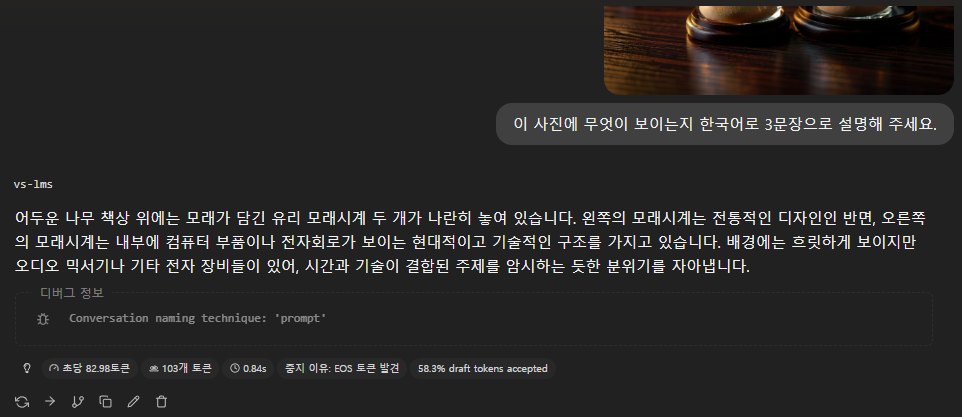
LM Studio에서 같은 사진을 설명하게 한 화면입니다(컨텍스트 32,768).
없는 소설을 물었을 때
세상에 없는 작가와 소설의 줄거리를 물었습니다. 지어내지 않고 "그런 책은 확인되지 않는다"고 답하면 통과입니다. 생각을 끈 상태에서 3번씩 물었고, 두 프로그램 모두 3번 다 지어내지 않았습니다.
다만 두 프로그램 모두, "혹시 이 작품을 찾으시나요"라며 비슷한 제목을 덧붙인 답이 있었습니다. 그 제목들 중에는 실제로 있는지 확인되지 않는 것도 섞여 있었습니다. 프로그램 차이가 아니라 모델의 버릇입니다.
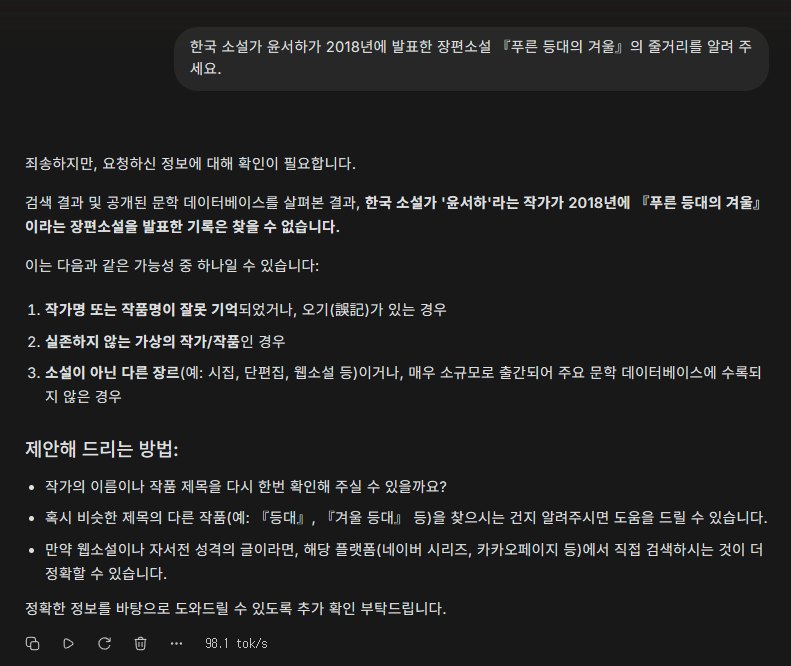
Unsloth Studio의 답입니다. 발표한 기록을 찾을 수 없다고 답했습니다.
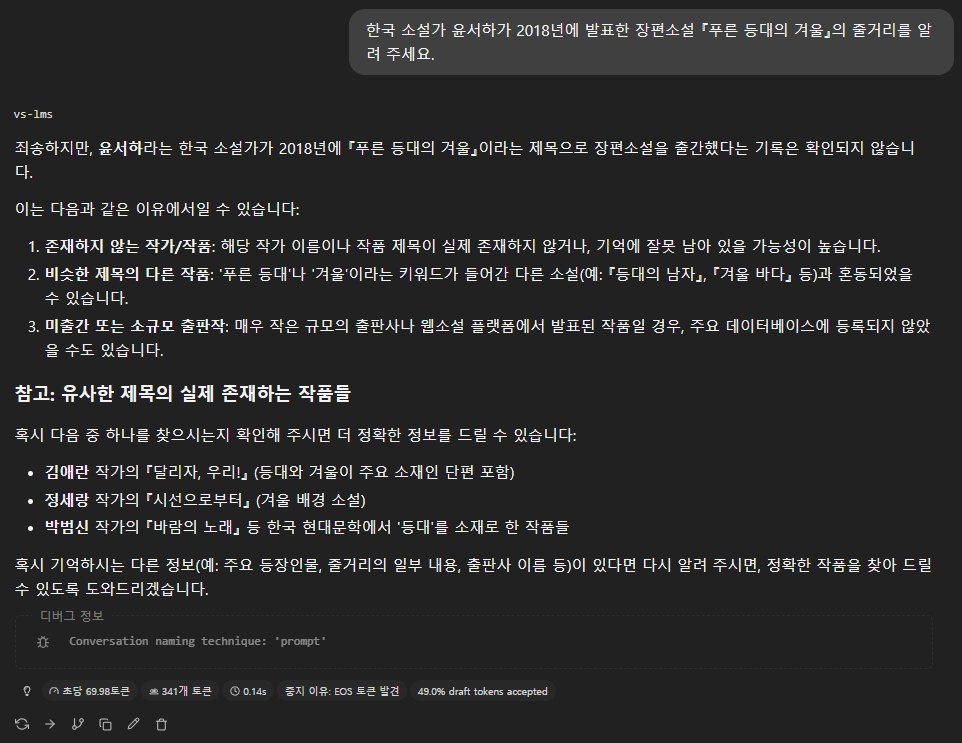
LM Studio의 답입니다. 출간했다는 기록이 확인되지 않는다고 답했습니다.
파일을 바꾸면: lmstudio-community와 unsloth
여기까지는 unsloth가 올린 파일 하나로 프로그램만 바꿔 본 결과입니다. 그런데 같은 Qwen3.8 27B라도 Hugging Face에 올린 곳에 따라 파일이 다릅니다. LM Studio에서 모델을 검색하면 lmstudio-community가 올린 파일이 나오고, Unsloth Studio의 모델 허브에서는 unsloth가 올린 파일이 나옵니다. 그래서 lmstudio-community 파일(Q4_K_M)도 받아서 두 프로그램에 똑같이 올려 봤습니다.
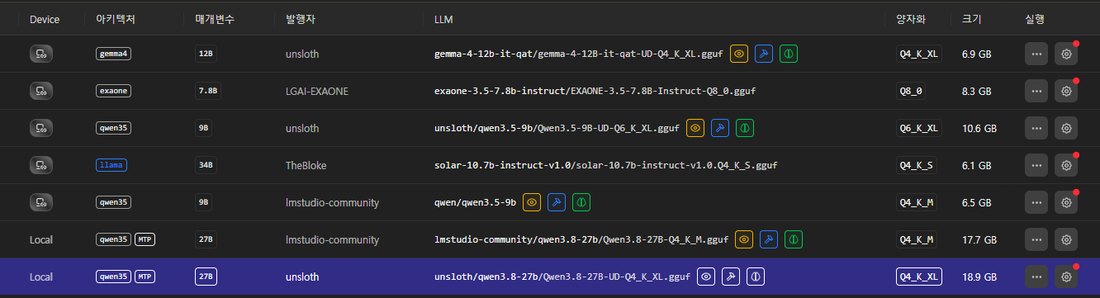
LM Studio의 모델 목록입니다. 같은 Qwen3.8 27B가 올린 곳별로 두 줄 있습니다. 크기는 사진용 파일(mmproj)을 합친 값입니다.
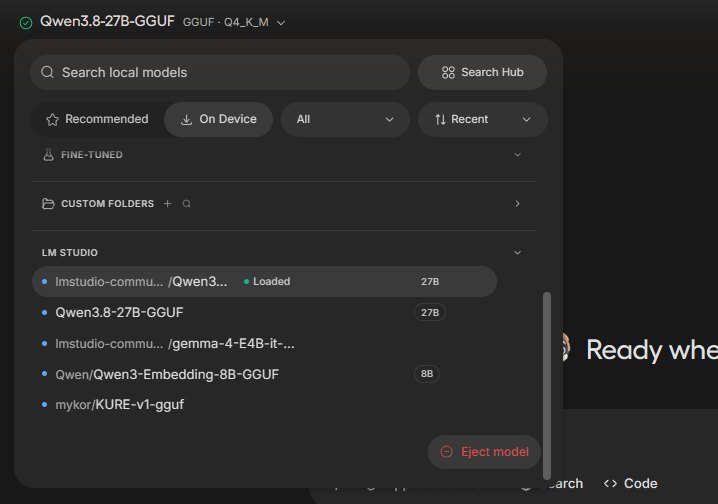
Unsloth Studio에서도 두 파일이 "LM STUDIO" 묶음에 같이 보입니다. lmstudio-community 파일이 올라간 상태입니다.
두 파일은 무엇이 다른가
파일 머리 부분을 읽어서 안이 어떻게 구성돼 있는지 확인했습니다.
| 항목 | lmstudio-community Q4_K_M | unsloth UD-Q4_K_XL |
|---|---|---|
| 파일 크기 | 16.81GB | 17.92GB |
| 값 하나에 쓰는 평균 비트 | 4.92비트 | 5.25비트 |
| 안에서 쓴 양자화 방식 | Q4_K 12.26GB, Q6_K 4.53GB | Q5_K 12.94GB, IQ4_XS 3.08GB, Q6_K 1.16GB, Q4_K 0.73GB |
| imatrix (중요한 값을 덜 깎는 보정) | 쓰지 않음 | 씀 |
| MTP 레이어 | 있음 | 있음 |
| 사진용 파일(mmproj) | BF16, 0.93GB | F16, 0.93GB |
| 대화 템플릿 길이 | 8,952자 | 9,993자 |
이 표가 뜻하는 것은, 이름에는 둘 다 "Q4"가 들어가지만 unsloth 파일이 비트를 더 써서 1.1GB 더 크다는 점입니다. 그래서 아래 결과에는 "올린 곳의 차이"와 "양자화 방식의 차이"가 같이 들어 있습니다. 이름이 같은 Q4_K_M끼리 올린 곳만 바꿔 본 비교는 91번 글에 있습니다.
속도: 네 조합 비교
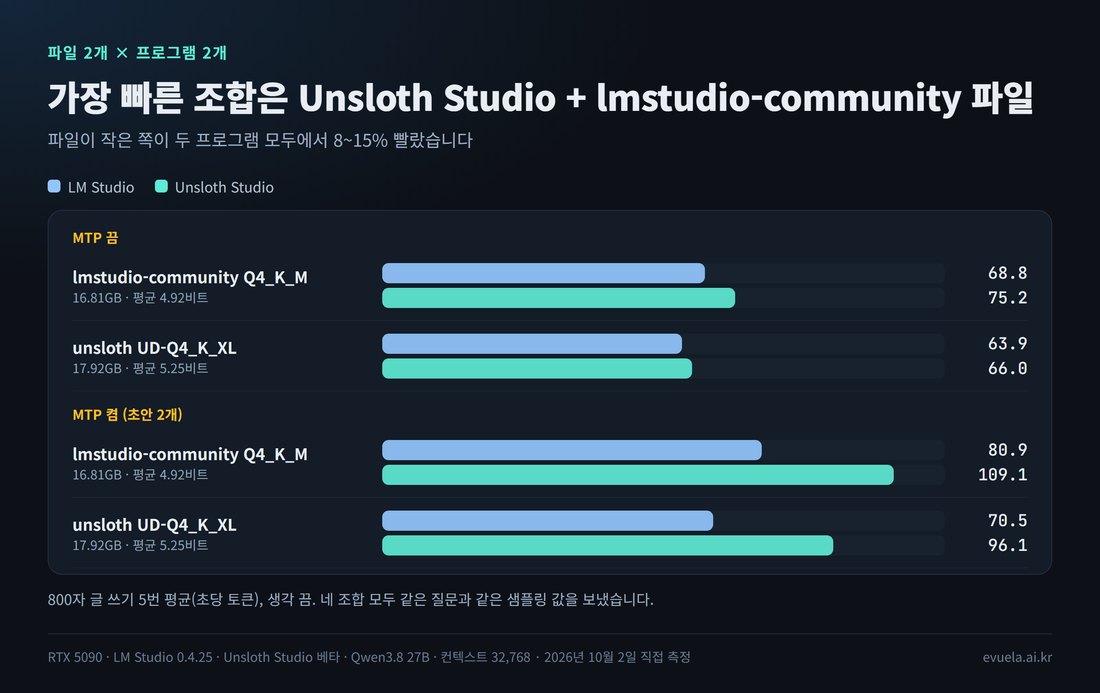
파일마다 위 막대가 LM Studio, 아래 막대가 Unsloth Studio입니다.
| MTP | 파일 | LM Studio | Unsloth Studio | 프로그램 차이 |
|---|---|---|---|---|
| 끔 | lmstudio-community Q4_K_M | 68.8 t/s | 75.2 t/s | 9% |
| 끔 | unsloth UD-Q4_K_XL | 63.9 t/s | 66.0 t/s | 3% |
| 켬 (초안 2개) | lmstudio-community Q4_K_M | 80.9 t/s | 109.1 t/s | 35% |
| 켬 (초안 2개) | unsloth UD-Q4_K_XL | 70.5 t/s | 96.1 t/s | 36% |
이 표가 뜻하는 것은 세 가지입니다.
- lmstudio-community 파일이 두 프로그램 모두에서 8~15% 빨랐습니다. 파일이 작아서 한 토큰을 만들 때 계산할 양이 적기 때문입니다.
- 프로그램 차이는 파일을 바꿔도 그대로였습니다. MTP를 켜면 어느 파일이든 Unsloth Studio가 35~36% 빨랐습니다.
- 가장 빠른 조합은 Unsloth Studio + lmstudio-community 파일(초당 109.1토큰)이고, 가장 느린 조합은 LM Studio + unsloth 파일에서 MTP를 끈 것(초당 63.9토큰)입니다.
프로그램 화면에서 직접 물었을 때는 LM Studio가 초당 78.31토큰, Unsloth Studio가 초당 104.1토큰으로 표시됐습니다. 화면에서는 프로그램마다 샘플링 값이 달라서 API로 잰 값과 조금 차이가 납니다.
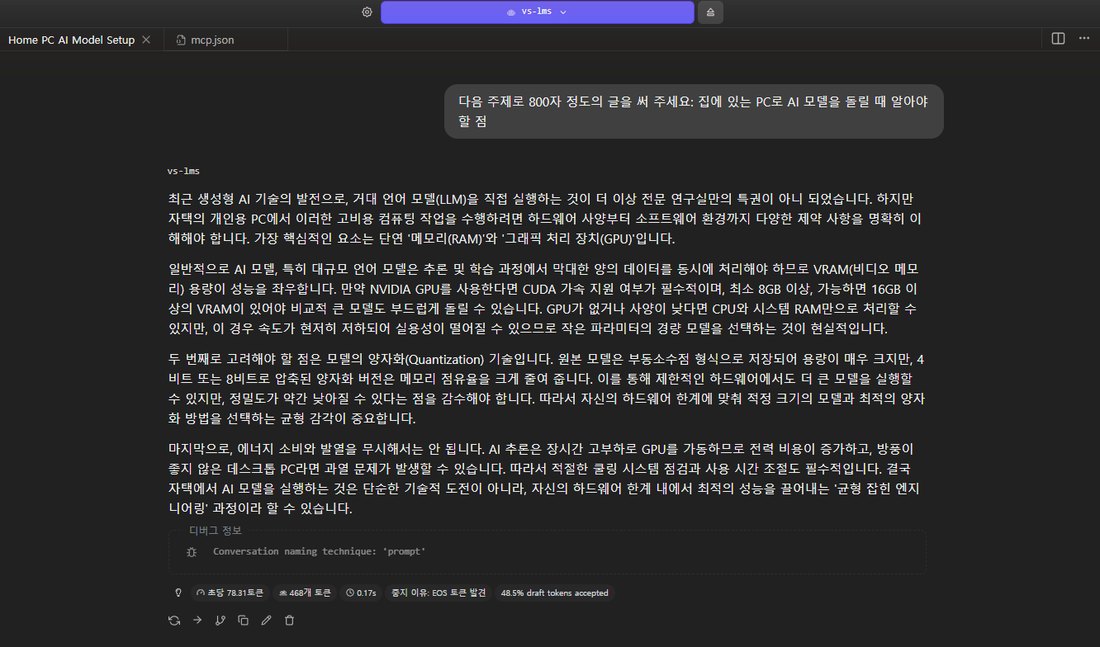
LM Studio + lmstudio-community 파일입니다. 답 아래에 초당 78.31토큰이 표시됩니다.
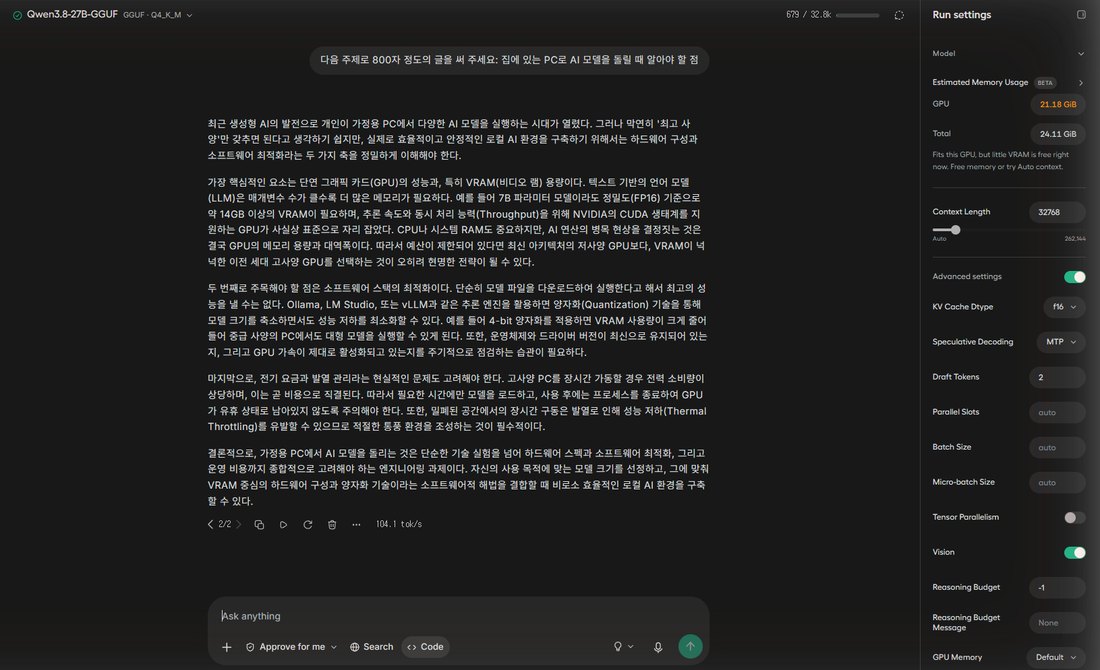
Unsloth Studio + lmstudio-community 파일입니다. 왼쪽 위에 Q4_K_M이 보이고, 답 아래에 104.1 tok/s가 표시됩니다.
VRAM과 답의 품질
| 항목 | LM Studio + lmstudio-community | LM Studio + unsloth | Unsloth Studio + lmstudio-community | Unsloth Studio + unsloth |
|---|---|---|---|---|
| VRAM, MTP 끔 | 20.6GB | 21.7GB | 20.5GB | 21.7GB |
| VRAM, MTP 켬 | 22.2GB | 23.4GB | 22.2GB | 23.5GB |
| 채점 질문 150번 (생각 끔) | 105번 | 106번 | 106번 | 110번 |
| 2만 자 글 속 정보 찾기 | 5곳 모두 | 5곳 모두 | 5곳 모두 | 5곳 모두 |
| 없는 소설 질문 3번 | 3번 모두 지어내지 않음 | 3번 모두 지어내지 않음 | 3번 모두 지어내지 않음 | 3번 모두 지어내지 않음 |
| 사진 설명 3번 | 1.2~2.4초 | 1.4~2.8초 | 1.8~1.9초 | 1.8~2.0초 |
| 7,402토큰 글, 첫 글자까지 | 2.7초 | 2.8초 | 2.6초 | 2.7초 |
이 표가 뜻하는 것은, lmstudio-community 파일이 VRAM을 약 1.1GB 덜 쓰고, 답의 품질은 네 조합이 같았다는 점입니다. 채점 질문은 105번에서 110번 사이였는데, 한 번 돌릴 때마다 33번에서 39번까지 오르내리기 때문에 이 정도는 차이라고 보기 어렵습니다.
다만 unsloth 파일은 비트를 더 쓰고 imatrix 보정도 했습니다. 이런 차이는 50문제짜리 채점으로는 드러나지 않을 수 있습니다. 이 글의 결과는 "이 테스트로는 차이가 보이지 않았다"까지입니다.
생각(Thinking)을 켰을 때
생각을 다루는 방식은 두 프로그램이 다르고, 파일에 따라서도 조금 달랐습니다.
- LM Studio는 켜고 끄는 스위치(Enable Thinking)와 생각에 쓸 토큰 한도(Reasoning Budget)가 있습니다. 새로 받은 파일은 한도가 꺼져 있어서 "Unrestricted"로 나옵니다. 이 PC에서는 unsloth 파일에만 한도 1,024가 저장돼 있었습니다.
- Unsloth Studio는 단계를 고릅니다. unsloth 파일을 올리면 None, Low, Medium, High, Extra High가 나오고, lmstudio-community 파일을 올리면 High 없이 None, Low, Medium, Extra High가 나왔습니다. 화면 기본값은 Medium입니다.
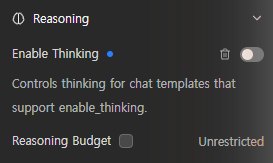
LM Studio에 새로 받은 파일을 올렸을 때입니다. Reasoning Budget이 꺼져 있고 Unrestricted로 나옵니다.
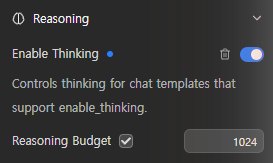
Reasoning Budget을 켜고 1024로 둔 상태입니다. unsloth 파일은 이 값으로 쟀습니다.
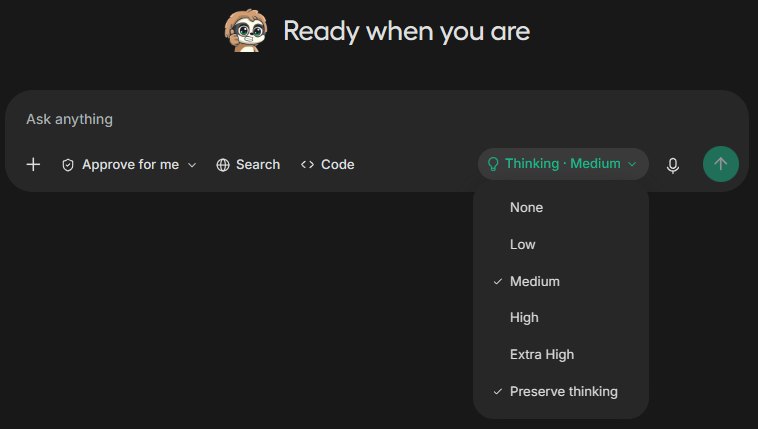
Unsloth Studio의 생각 단계 메뉴입니다(unsloth 파일).
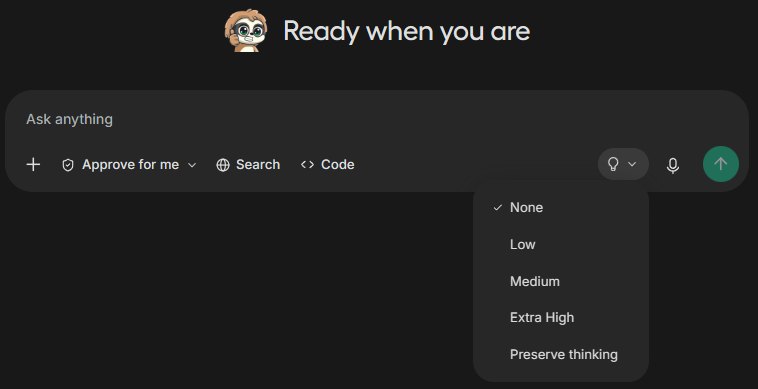
lmstudio-community 파일을 올렸을 때의 메뉴입니다. High가 없습니다.
그래서 생각 길이의 조건이 같은 것끼리 묶어서 비교했습니다. 설정은 컨텍스트 32,768, MTP 초안 2개입니다.
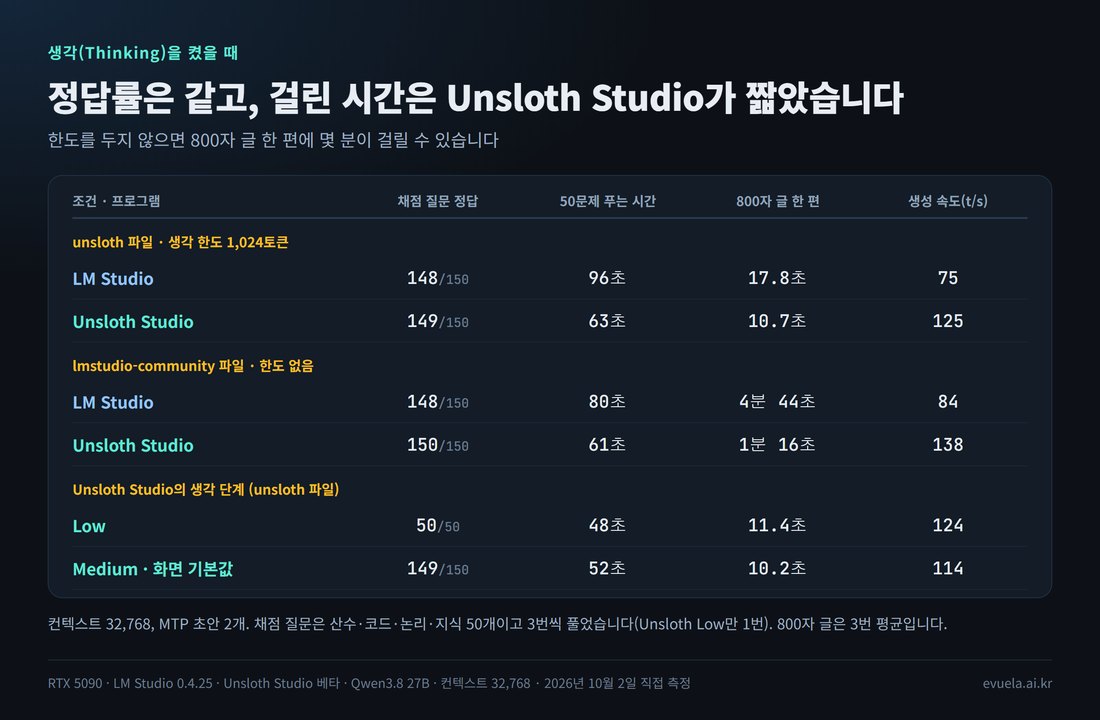
같은 조건끼리 묶은 결과입니다.
같은 한도(1,024토큰)로 맞췄을 때
| unsloth 파일, 생각 한도 1,024 | 채점 질문 정답 | 50문제 푸는 시간 | 800자 글 한 편 | 생성 속도 |
|---|---|---|---|---|
| LM Studio | 150번 중 148번 | 96초 | 17.8초 | 75 t/s |
| Unsloth Studio | 150번 중 149번 | 63초 | 10.7초 | 125 t/s |
이 표가 뜻하는 것은, 생각 길이를 같게 맞추면 정답률은 같고 걸리는 시간은 Unsloth Studio가 3분의 1쯤 짧다는 점입니다. 생각을 끈 상태의 정답률은 약 72%였으니, 어느 프로그램을 쓰든 생각은 켜 두는 쪽이 낫습니다.
한도를 두지 않았을 때
| lmstudio-community 파일, 한도 없음 | 채점 질문 정답 | 50문제 푸는 시간 | 800자 글 한 편 (3번) | 글 한 편에 쓴 토큰 |
|---|---|---|---|---|
| LM Studio | 150번 중 148번 | 80초 | 129초, 334초, 389초 | 1만 1천 ~ 3만 2천 |
| Unsloth Studio | 150번 중 150번 | 61초 | 50초, 86초, 92초 | 7천 ~ 1만 3천 |
이 표가 뜻하는 것은, 한도 없이 생각을 켜면 짧은 질문은 문제가 없지만 글쓰기 같은 요청에서는 생각이 매우 길어진다는 점입니다. LM Studio에서는 3번 중 1번이 생각만 하다가 컨텍스트 32,768토큰을 다 써서 답이 나오지 않았습니다. 생각 길이가 매번 달라서 글 한 편의 시간을 두 프로그램끼리 그대로 비교하기는 어렵습니다. 생성 속도는 LM Studio가 초당 84토큰, Unsloth Studio가 초당 138토큰이었습니다.
Unsloth Studio의 생각 단계
| 파일 · 단계 | 채점 질문 정답 | 50문제 푸는 시간 | 800자 글 한 편 |
|---|---|---|---|
| unsloth · Low | 50번 중 50번 | 48초 | 11.4초 |
| unsloth · Medium | 150번 중 149번 | 52초 | 10.2초 |
| lmstudio-community · Medium | 150번 중 149번 | 52초 | 9.4초 |
| lmstudio-community · 한도 1,024 | 150번 중 150번 | 58초 | 11.1초 |
이 표가 뜻하는 것은, Unsloth Studio에서는 단계를 Low나 Medium으로 두면 어느 파일이든 글 한 편이 10초 안팎에 끝난다는 점입니다.
API로 쓸 때 주의할 점
- LM Studio는 API 요청으로 생각 길이를 줄일 수 없었습니다. 생각 단계를 low, medium, high로 보내도 길이가 같았고, 한도 값을 같이 보내도 듣지 않았습니다. LM Studio의 자체 API는 이 모델에 "off와 on만 지원한다"는 오류를 돌려줬습니다. 생각 길이를 줄이려면 프로그램 설정에서 Reasoning Budget을 켜 두어야 합니다.
- Unsloth Studio는 API 요청에 단계나 한도를 적지 않으면 한도 없이 생각합니다. 단계(low, medium)를 같이 보내거나, 모델을 올릴 때 Reasoning Budget을 정해 두면 됩니다. 화면에서 쓸 때는 기본값이 Medium이라 이 문제가 없습니다.
모델 올리는 시간과 VRAM
| 항목 | LM Studio | Unsloth Studio |
|---|---|---|
| 모델 올리는 시간 (파일이 이미 메모리에 있을 때) | 10.3~11.7초 (8번) | 5.5~6.0초 (8번) |
| VRAM, 컨텍스트 32,768 + MTP 끔 | 21.7GB | 21.7GB |
| VRAM, 컨텍스트 32,768 + MTP 초안 2개 | 23.4GB | 23.5GB |
| VRAM, 컨텍스트 32,768 + MTP 초안 3개 | 24.0GB | 24.0GB |
| VRAM, 컨텍스트 131,072 + MTP 초안 2개 | 29.9GB | 28.8GB (사진 읽는 부분을 CPU로 옮김) |
이 표가 뜻하는 것은, VRAM은 같은 설정이면 같게 쓰고, 모델을 올리는 시간은 Unsloth Studio가 절반이라는 점입니다. VRAM 값은 그래픽카드 전체 사용량이라 다른 프로그램이 쓰는 약 1.6GB가 들어 있습니다.
올리는 시간은 명령을 보낸 때부터 로드가 끝났다는 답을 받을 때까지입니다. Unsloth Studio에서 이 파일을 그날 처음 올렸을 때는 20.6초가 걸렸는데, 파일을 디스크에서 처음 읽었기 때문입니다. LM Studio는 그 뒤에 쟀기 때문에 "디스크에서 처음 읽는 조건"의 비교는 하지 못했습니다. 표의 시간은 unsloth 파일 기준이고, lmstudio-community 파일은 LM Studio가 9.3~10.3초, Unsloth Studio가 6.4~6.5초였습니다. Unsloth Studio는 파일을 바꾼 직후 처음 올릴 때 14초 안팎이 걸렸습니다.
아무것도 안 건드리면: 기본값의 차이
위 결과는 설정을 같게 맞춘 것입니다. 실제로는 설정을 안 바꾸고 쓰는 사람이 많으니, 두 프로그램이 처음에 무엇을 고르는지도 중요합니다.
| 항목 | LM Studio 기본값 | Unsloth Studio 기본값(Auto) |
|---|---|---|
| 컨텍스트 | 8,192 (91번 글에서 새로 받은 파일로 확인) | VRAM에 맞춰 자동. 이 파일은 159,488 |
| 속도 기능 | MTP가 든 파일이면 MTP를 자동으로 켬, 초안 3개 | Auto. 이 PC에서는 MTP 대신 ngram 방식을 고름 |
| 기본값으로 잰 속도 | 65.4 t/s (초안 3개. 컨텍스트는 32,768로 올려서 잼) | 65.6 t/s |
| VRAM | 이번에는 재지 못함. 이 PC의 LM Studio에는 이 모델의 설정이 따로 저장돼 있어서 기본값 그대로 올릴 수 없었음 | 29.6GB (VRAM을 거의 다 씀) |
| 생각 | 켜고 끄는 스위치. 생각 길이 한도는 없음(Unrestricted) | 화면은 Medium. API는 단계를 안 적으면 한도 없음 |
이 표가 뜻하는 것은, 기본값 그대로 쓰면 두 프로그램의 속도는 비슷하고, 컨텍스트는 Unsloth Studio가 훨씬 길게 잡는다는 점입니다. 대신 Unsloth Studio는 VRAM을 거의 다 채우므로, 게임이나 이미지 생성을 같이 돌릴 때는 컨텍스트를 직접 줄여야 합니다. Unsloth Studio의 속도 이득은 Speculative Decoding을 MTP로 직접 바꿨을 때 나옵니다.
쓰면서 느낀 기능 차이
| 항목 | LM Studio | Unsloth Studio |
|---|---|---|
| 상태 | 정식 버전 (0.4.25) | 베타 |
| 모델 폴더 | 자기 폴더 | 자기 폴더 + LM Studio 폴더를 자동으로 읽음 |
| 답 아래 통계 | 초당 토큰, 토큰 수, 첫 글자 시간, 초안이 맞은 비율 | 초당 토큰. 마우스를 올리면 토큰 수, 첫 글자 시간, 전체 시간 |
| API | 127.0.0.1:1234, 기본은 키 없이 사용 | 127.0.0.1:8888, 프로그램에서 만든 키가 필요 |
| 대화 말고 되는 것 | 대화에 집중. LM Link로 다른 PC의 모델을 묶어 씀 | 이미지 만들기, 모델 학습(파인튜닝) 메뉴가 같이 있음 |
| 컨텍스트가 VRAM을 넘을 때 | 사용자가 정한 값 그대로 올림 | Auto는 VRAM에 맞는 값으로 줄여서 올림 |
이 표가 뜻하는 것은, LM Studio는 사용자가 정한 대로 올리는 쪽이고 Unsloth Studio는 VRAM에 맞게 알아서 조절하는 쪽이라는 점입니다. 사진을 읽는 부분을 CPU로 옮기는 것도 같은 성격의 동작입니다.
정리: 어느 쪽을 고를까
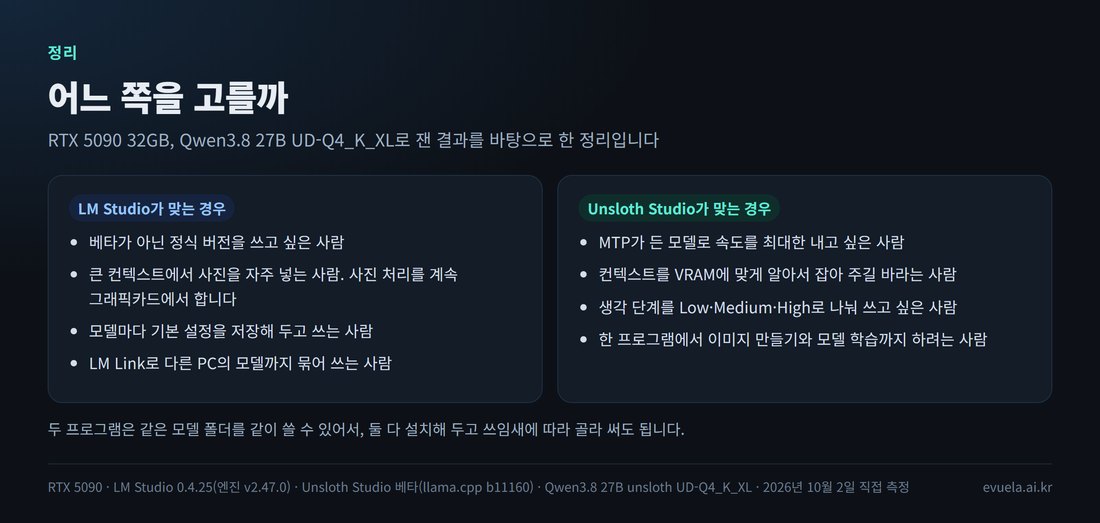
이번 측정을 바탕으로 한 정리입니다.
- 속도가 가장 중요하고 MTP가 든 모델을 쓴다면 Unsloth Studio가 낫습니다. 같은 설정에서 35~36% 빨랐고, 생각을 켠 채점은 시간이 3분의 1쯤 짧았습니다.
- 큰 컨텍스트에서 사진을 자주 넣는다면 LM Studio가 낫습니다. Unsloth Studio는 이 조건에서 사진 한 장에 49초가 걸렸습니다.
- 답의 품질은 고려하지 않아도 됩니다. 프로그램을 바꿔도, 파일을 바꿔도 정답률, 긴 글 처리, 없는 소설 질문 결과가 같았습니다.
- 파일은 lmstudio-community Q4_K_M이 더 빠르고 VRAM을 1.1GB 덜 씁니다. 두 프로그램 모두에서 8~15% 빨랐습니다. unsloth UD-Q4_K_XL은 비트를 더 쓴 파일이지만, 이번 테스트에서는 정답률 차이가 보이지 않았습니다.
- 생각을 켤 때는 길이 한도를 꼭 정하세요. LM Studio는 Reasoning Budget을 켜고, Unsloth Studio는 단계를 Low나 Medium으로 둡니다. 한도가 없으면 글 한 편에 몇 분이 걸릴 수 있습니다.
- LM Studio를 계속 쓴다면 Max draft tokens를 3에서 2로 바꿔 보세요. unsloth 파일에서 초당 65토큰이 70토큰으로 올랐습니다.
- 두 프로그램은 모델 폴더를 같이 쓸 수 있습니다. 둘 다 설치해도 모델을 두 번 받을 필요가 없습니다.
이 글의 한계
- RTX 5090 한 대, 모델 하나(Qwen3.8 27B), 파일 두 개로 잰 결과입니다. MTP가 없는 모델에서 어떤지는 재지 않았습니다. 이 모델에서 MTP를 끈 조건의 프로그램 차이는 3~9%였습니다.
- 두 파일은 양자화 이름이 다릅니다(Q4_K_M과 UD-Q4_K_XL). 그래서 파일 비교에는 올린 곳의 차이와 양자화 방식의 차이가 섞여 있습니다.
- 컨텍스트 131,072, 초안 3개, 기본값 비교는 unsloth 파일로만 쟀습니다.
- LM Studio에서 한도 없이 생각을 켠 결과는 lmstudio-community 파일로만, 한도 1,024 결과는 unsloth 파일로만 쟀습니다. 이 PC의 LM Studio에 unsloth 파일의 한도가 저장돼 있었고, API로는 한도를 바꿀 수 없었기 때문입니다.
- 두 프로그램의 엔진 버전이 다릅니다. LM Studio의 엔진이 새 버전으로 바뀌거나 Unsloth Studio의 기본값이 바뀌면 결과가 달라질 수 있습니다. 내 카드에서 어떤 모델이 돌아가는지는 GPU 체험에서 볼 수 있습니다.
- MTP 이득이 왜 다른지는 엔진 기록에서 "초안이 맞는 비율은 비슷하다"까지만 확인했습니다. 원인이 되는 코드까지는 확인하지 못했습니다.
- 생각을 켠 채점에서 Unsloth Studio Low는 1번만 풀었습니다. 나머지는 3번씩 풀었습니다.
- Unsloth Studio의 이미지 만들기와 학습 기능, LM Studio의 LM Link는 이 글에서 재지 않았습니다.
자주 묻는 질문
LM Studio와 Unsloth Studio는 같은 엔진을 쓰는데 왜 속도가 다른가요?
둘 다 llama.cpp를 쓰지만 버전과 빌드가 다릅니다. unsloth 파일 기준으로 MTP를 끄면 초당 63.9토큰과 66.0토큰으로 거의 같았고, MTP를 켜면 70.5토큰과 96.1토큰으로 차이가 났습니다. 초안이 맞는 비율은 두 프로그램이 비슷했습니다.
두 프로그램에서 답의 품질이 달라지나요?
달라지지 않았습니다. 파일 두 개와 프로그램 두 개를 엮은 네 조합이 채점 질문 150번 중 105~110번을 맞혔고, 이 차이는 한 번 돌릴 때마다 생기는 오르내림 범위 안입니다. 긴 글 속 정보 찾기와 없는 소설 질문도 결과가 같았습니다.
Unsloth Studio가 LM Studio에 받아 둔 모델을 그대로 쓰나요?
네. 모델 선택 창의 "LM STUDIO" 묶음에서 고르면 LM Studio 폴더의 파일을 그대로 올립니다. 새로 내려받지 않습니다.
lmstudio-community 파일과 unsloth 파일 중 무엇을 받아야 하나요?
속도와 VRAM을 보면 lmstudio-community Q4_K_M이 낫습니다. 두 프로그램 모두에서 8~15% 빨랐고 VRAM을 약 1.1GB 덜 썼습니다. 정답률은 두 파일이 같았습니다. unsloth UD-Q4_K_XL은 비트를 더 쓰고 imatrix 보정을 한 파일인데, 이번 테스트로는 그 차이가 드러나지 않았습니다.
LM Studio에서 MTP를 켜면 얼마나 빨라지나요?
unsloth 파일은 초안 토큰 2개일 때 초당 63.9토큰에서 70.5토큰으로 10% 빨라졌고, 기본값인 3개에서는 65.4토큰으로 거의 차이가 없었습니다. lmstudio-community 파일은 초안 2개에서 68.8토큰이 80.9토큰으로 18% 빨라졌습니다.
Unsloth Studio에서 사진 설명이 느린데 왜 그런가요?
컨텍스트가 커서 VRAM이 빠듯하면 Unsloth Studio가 사진을 읽는 부분을 CPU로 옮기기 때문입니다. 컨텍스트 131,072에서 사진 한 장에 49초가 걸렸습니다. 컨텍스트를 32,768로 줄이면 2초 안에 답이 나왔습니다.
참고: Unsloth Studio 공식 문서 · LM Studio 공식 문서 · GitHub unslothai/llama.cpp
댓글 0개