로컬 AI 시작하기 3편, Gemma 4 12B·Qwen3.8 27B 모델 이름은 어떻게 읽을까, Q4_K_M과 IQ2_S는 파일이 8GB 차이였다
모델 이름의 12B, A3B, QAT, GGUF, Q4_K_M이 무슨 뜻인지 조각별로 풀었습니다. 같은 Qwen3.8 27B도 4비트 파일은 17.74GB, 2비트 파일은 9.30GB였고, 같은 Q4_K_M도 올린 곳에 따라 16.46GB에서 18.97GB까지 달랐습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"lmstudio-community" 검색 결과 8건
모델 이름의 12B, A3B, QAT, GGUF, Q4_K_M이 무슨 뜻인지 조각별로 풀었습니다. 같은 Qwen3.8 27B도 4비트 파일은 17.74GB, 2비트 파일은 9.30GB였고, 같은 Q4_K_M도 올린 곳에 따라 16.46GB에서 18.97GB까지 달랐습니다.
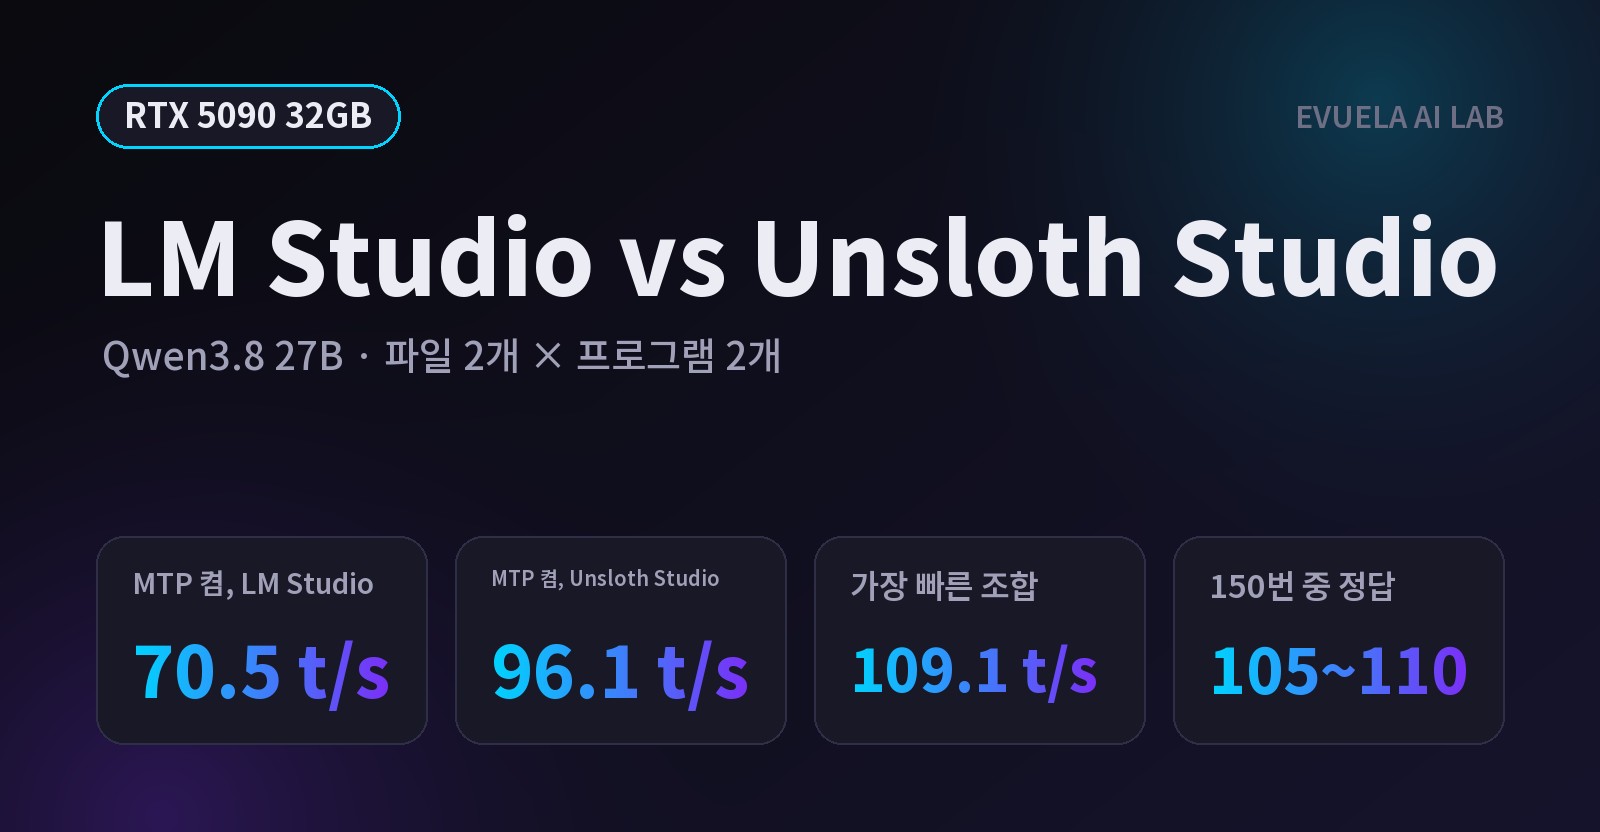
같은 Qwen3.8 27B 파일로 LM Studio와 Unsloth Studio를 비교했습니다. 기본값 속도는 65.4 대 65.6 t/s로 같았고, MTP를 켜면 35~44% 빨랐습니다. 생각 한도, 컨텍스트, 조심할 점과 앞으로의 측정 방법을 정리했습니다.
RTX 5090에서 Qwen3.8 27B 파일 두 개(lmstudio-community Q4_K_M, unsloth UD-Q4_K_XL)를 LM Studio와 Unsloth Studio에 차례로 올리고 설정을 똑같이 맞춰 쟀습니다. MTP를 끄면 두 프로그램의 속도가 거의 같았고, MTP를 켜면 Unsloth Studio가 35~36% 빨랐습니다. lmstudio-community 파일은 두 프로그램 모두에서 8~15% 더 빨랐고, 정답률은 네 조합이 같았습니다. 생각 설정의 차이와 두 프로그램 화면 캡처도 함께 정리했습니다.
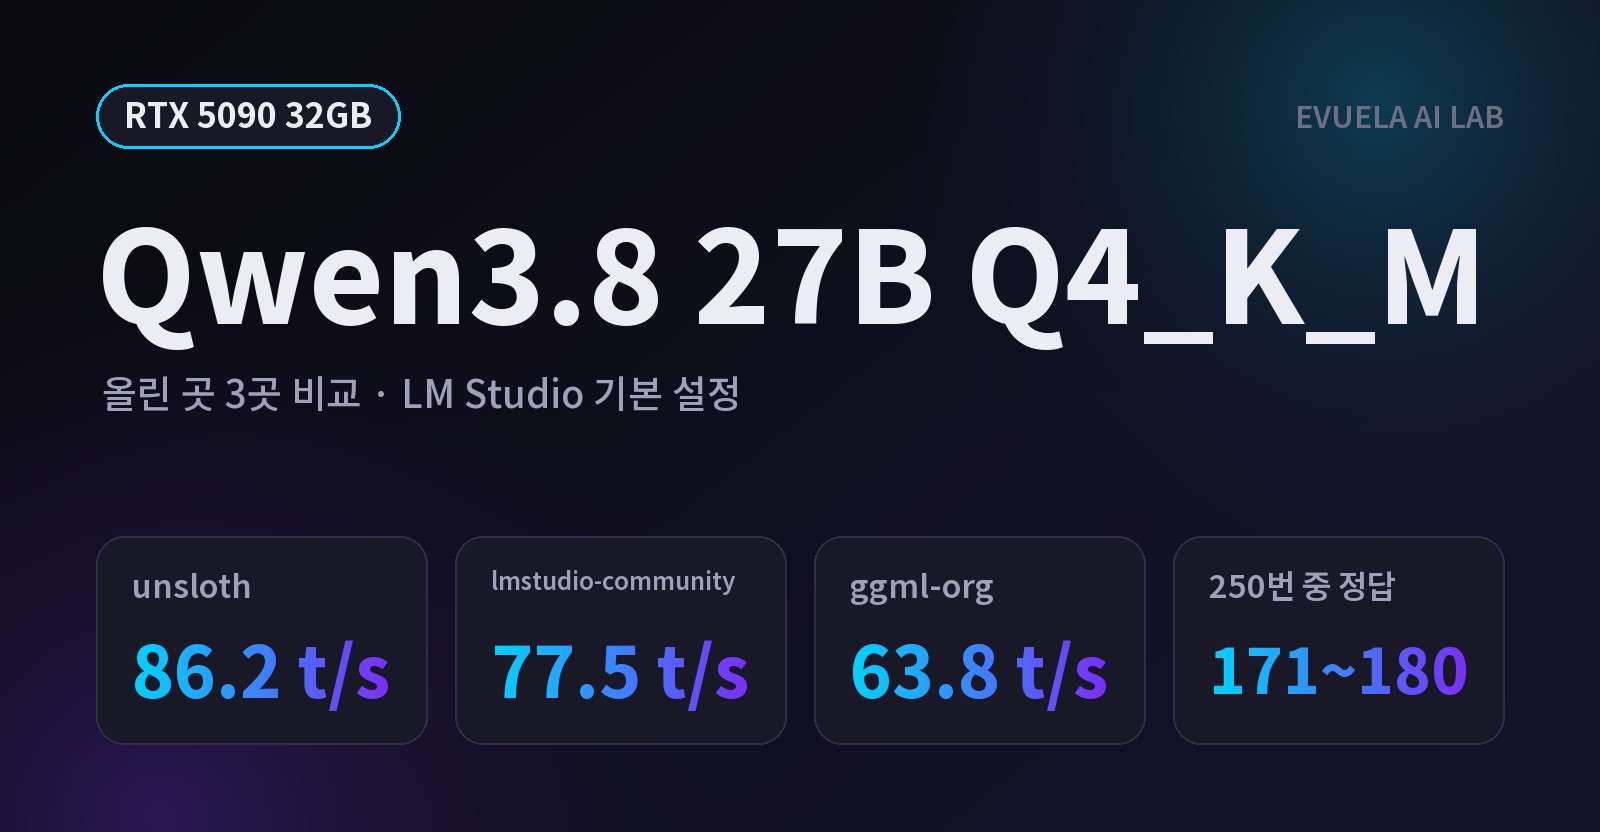
Qwen3.8 27B Q4_K_M 파일을 lmstudio-community, unsloth, ggml-org 세 곳에서 받아 RTX 5090과 LM Studio로 비교했습니다. 채점 질문 250번 중 171~180번을 맞혀 정답률은 거의 같았고, 생성 속도는 초당 63.8~86.2토큰으로 달랐습니다. 차이는 파일 안에 MTP 레이어가 있느냐에서 나왔습니다. 파일 속 양자화 구성, VRAM, MCP 도구 호출 결과와 LM Studio 캡처를 함께 정리했습니다.
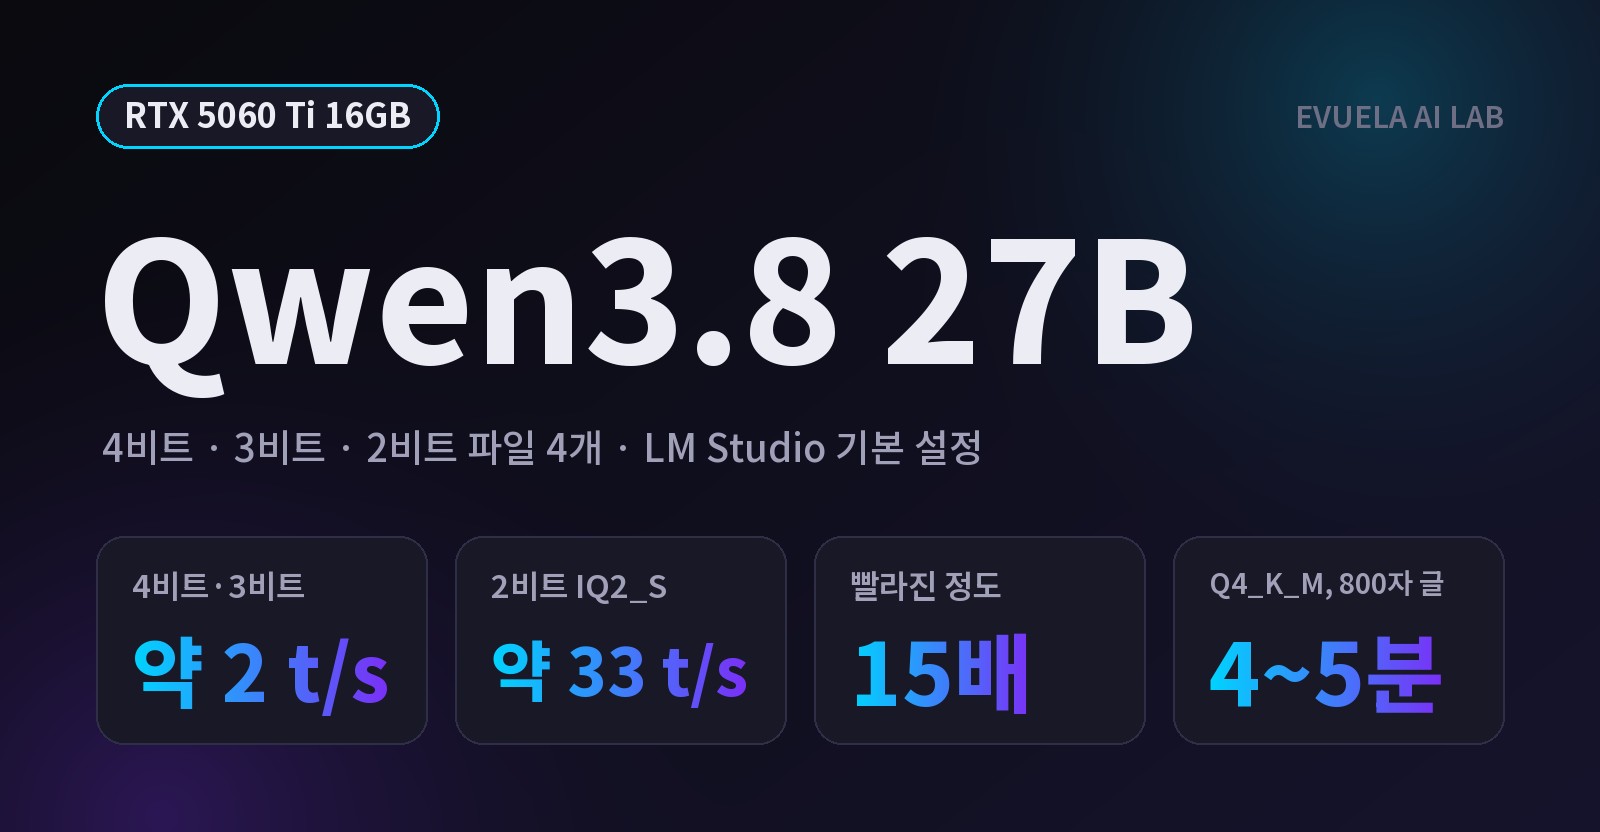
RTX 5060 Ti 16GB PC의 LM Studio에서 Qwen3.8 27B를 양자화 4종(Q4_K_M, Q3_K_XL, IQ3_S, IQ2_S)으로 돌려 봤습니다. 4비트와 3비트는 약 2t/s였고, 2비트 IQ2_S만 약 33t/s로 15배 빨랐습니다. 2비트는 생각을 켜야 정확했고, 컨텍스트는 32K가 알맞았습니다.
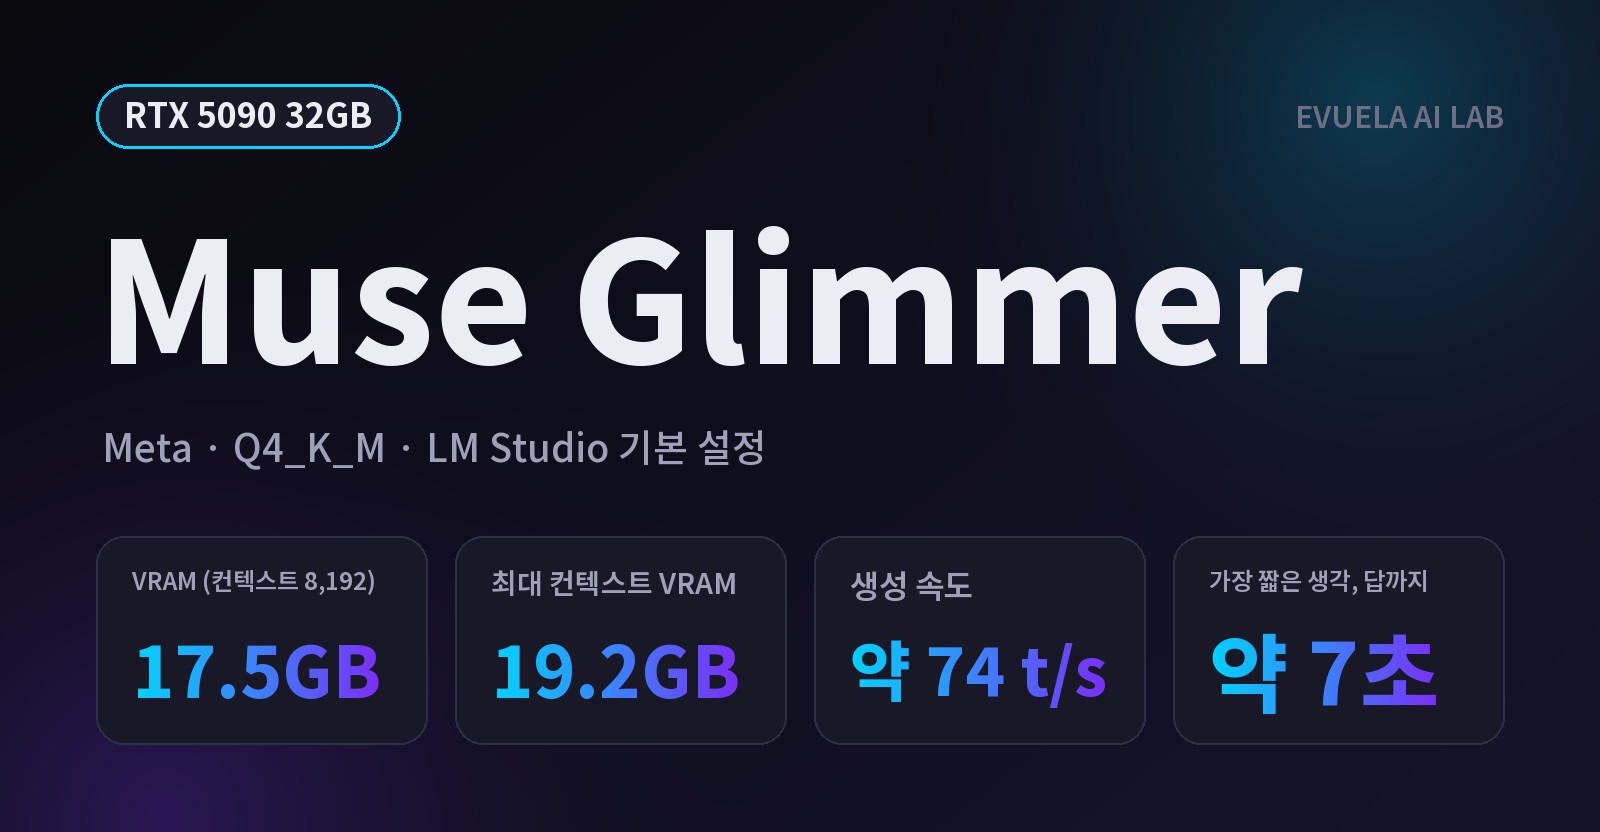
Meta가 공개한 약 300억 파라미터 모델 Muse Glimmer를 RTX 5090의 LM Studio 기본 설정으로 재 봤습니다. 컨텍스트를 16배 늘려도 VRAM은 17.5GB에서 19.2GB로 1.7GB만 늘었고, 기본 설정에서 27번 모두 답했습니다. 속도, 생각 단계, 한국어 품질, 이미지 입력까지 정리했습니다.
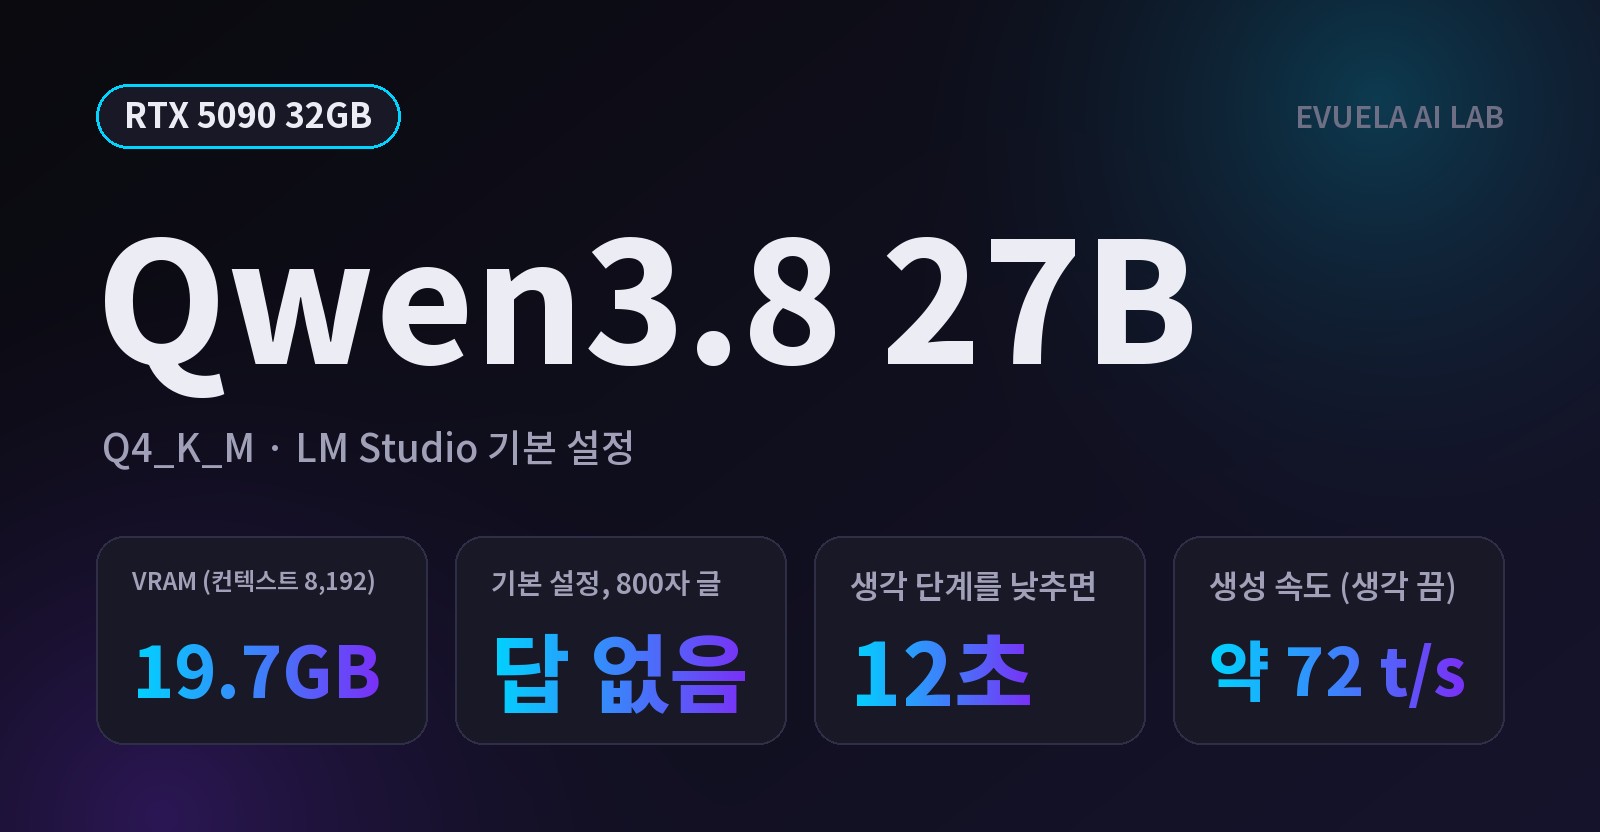
LM Studio 기본 설정으로 Qwen3.8 27B에 800자 글을 부탁하자 1분 넘게 생각만 하다 답 없이 멈췄습니다. 생각 단계를 낮추자 12초 만에 답이 나왔습니다. VRAM 19.7GB, 산수, 없는 소설, 이미지 입력, MTP 속도까지 RTX 5090에서 잰 결과입니다.
AI 뉴스
엔비디아가 2026년 9월 허깅페이스를 약 129억 3천만 달러에 인수하기로 했습니다. SEC 공시와 공식 발표를 바탕으로 인수 조건, 완료 시점(2027년 상반기), 개방성 약속, 규제 심사, 로컬 LLM 사용자가 챙길 점을 정리했습니다.