이 블로그는 10월 4일부터 로컬 AI 테스트에 LM Studio 대신 Unsloth Studio를 씁니다. 두 프로그램에 같은 모델 파일을 올려 직접 비교해 보니, 기본값끼리는 속도가 거의 같았습니다(초당 65.4토큰과 65.6토큰). 차이는 그 다음에 났습니다.
- 속도 기능(MTP)을 켜면 Unsloth Studio가 35~44% 빨랐습니다. 같은 파일에서 초당 70.5토큰과 96.1토큰이었습니다.
- 생각 길이를 제한할 수 있습니다. 생각 한도를 1,024토큰으로 걸었을 때 채점 질문 50개를 푸는 시간이 96초에서 63초로 줄었고, 정답 수는 같았습니다(150번 중 148번과 149번).
- 기본 컨텍스트가 커서 "생각만 하다 답 없이 멈추는" 일이 줄어듭니다. LM Studio 기본 8,192토큰 대신, 그래픽카드 메모리에 맞춰 15만 토큰 넘게 잡았습니다.
- 대신 조심할 점도 있습니다. 아직 베타이고, 컨텍스트를 아주 크게 잡으면 사진을 읽는 속도가 크게 느려졌습니다(1.7초 → 49초).
이 글의 숫자는 모두 RTX 5090 PC에서 Qwen3.8 27B로 직접 잰 값입니다. 자세한 측정은 Unsloth Studio 설정 찾기와 LM Studio vs Unsloth Studio에 있고, 이 글은 그 결과를 "왜 바꾸는가"의 관점에서 다시 묶은 것입니다.
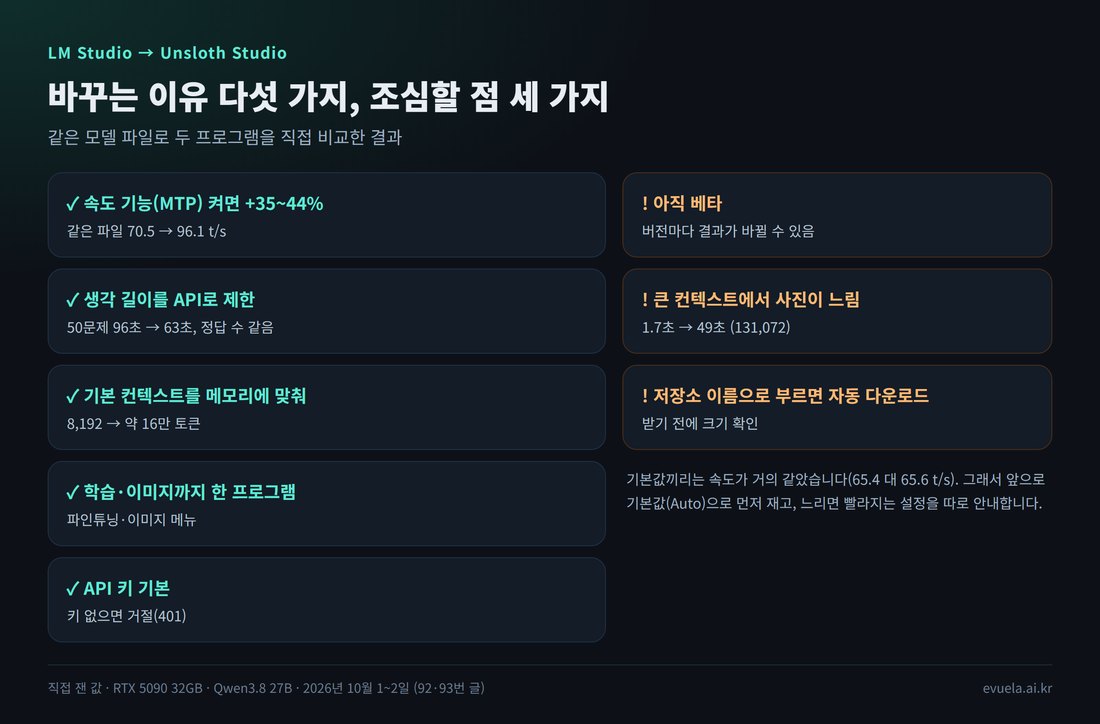
바꾸는 이유와 조심할 점을 한눈에 정리했습니다.
Unsloth Studio는 무엇인가
Unsloth Studio는 AI 모델을 더 빠르고 가볍게 학습시키는 도구로 알려진 Unsloth 팀이 만든 데스크톱 프로그램입니다. LM Studio처럼 내 PC에서 모델을 내려받아 대화하고, OpenAI 형식의 API로 다른 프로그램에 연결할 수 있습니다. 모델을 돌리는 엔진은 두 프로그램 모두 llama.cpp입니다.
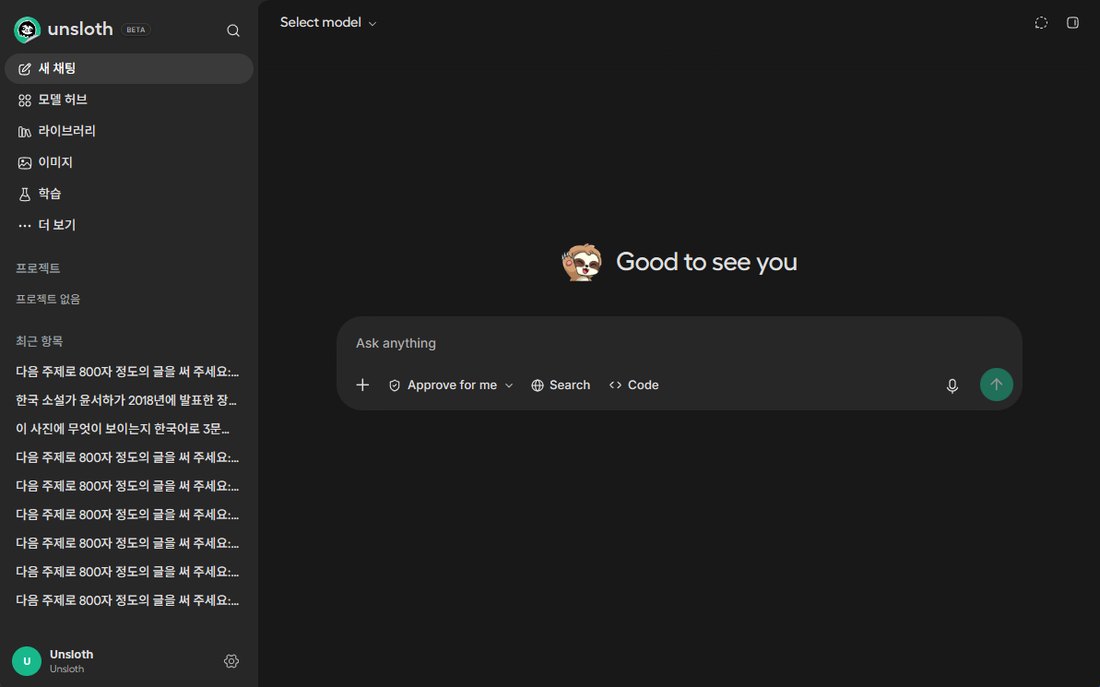
Unsloth Studio 첫 화면입니다. 대화 말고도 이미지 만들기와 학습 메뉴가 한 프로그램 안에 있습니다. API 화면은 더 보기 안에 있습니다.
| 항목 | LM Studio | Unsloth Studio |
|---|---|---|
| 테스트한 버전 | 0.4.25, 엔진 llama.cpp v2.47.0 | 베타(백엔드 2026.9.12), 엔진 llama.cpp b11160 |
| 가격·라이선스 | 무료 | 무료, 오픈소스(Apache 2.0, AGPL-3.0) |
| 대화·API | 있음 | 있음 |
| 모델 학습(파인튜닝)·이미지 만들기 메뉴 | 이 글에서 비교하지 않음 | 있음 |
| LM Studio에서 받은 모델 | - | 그대로 불러올 수 있음(다시 받지 않음) |
이 표가 뜻하는 것은, LM Studio로 하던 대화·API 일을 그대로 하면서, Unsloth Studio 안에서 학습과 이미지 만들기까지 이어서 할 수 있다는 점입니다. 이미 LM Studio로 받아 둔 모델 파일도 다시 받지 않고 씁니다.
이유 1. 기본값은 비슷하고, 속도 기능을 켜면 더 빠르다
같은 Qwen3.8 27B 파일을 두 프로그램에 올리고, 같은 질문을 같은 샘플링 값으로 보냈습니다.
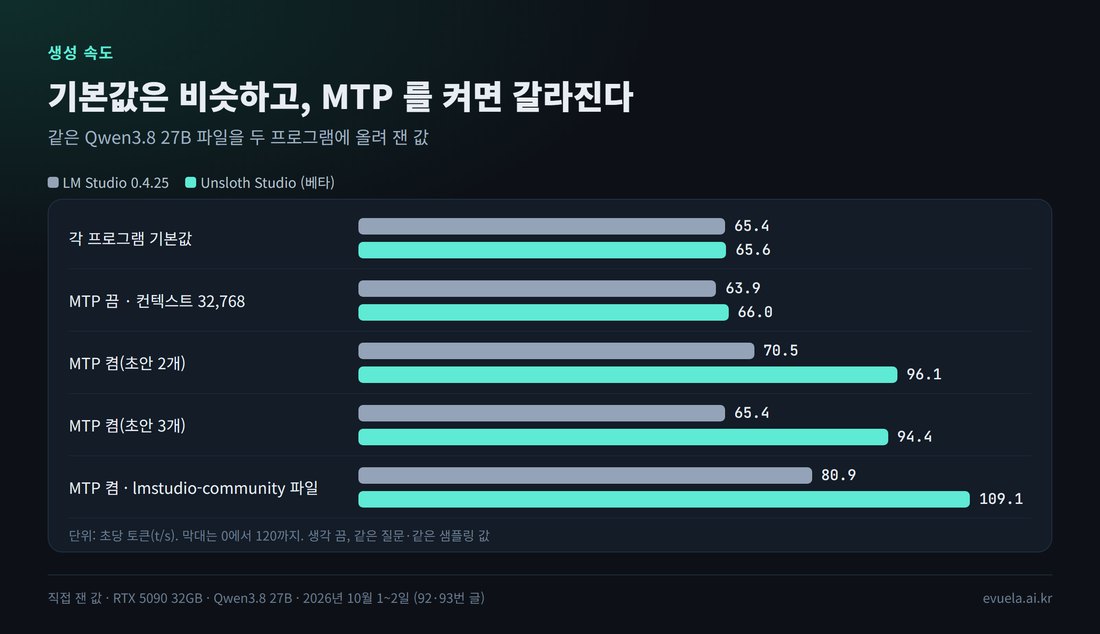
조건별 생성 속도입니다. 회색이 LM Studio, 청록이 Unsloth Studio입니다.
| 조건 (Qwen3.8 27B) | LM Studio | Unsloth Studio | 차이 |
|---|---|---|---|
| 각 프로그램 기본값 | 65.4 t/s | 65.6 t/s | 거의 같음 |
| MTP 끔, 컨텍스트 32,768 | 63.9 t/s | 66.0 t/s | 3% |
| MTP 켬(초안 2개), 컨텍스트 32,768 | 70.5 t/s | 96.1 t/s | 36% |
| MTP 켬(초안 3개), 컨텍스트 32,768 | 65.4 t/s | 94.4 t/s | 44% |
| MTP 켬, lmstudio-community 파일 | 80.9 t/s | 109.1 t/s | 35% |
이 표가 뜻하는 것은, 설정을 손대지 않으면 두 프로그램이 비슷하고, MTP를 켰을 때 Unsloth Studio가 크게 앞선다는 점입니다. MTP는 모델이 다음 몇 토큰을 미리 짐작해 한꺼번에 확인하는 속도 기능입니다. 짐작이 맞는 비율은 두 프로그램이 비슷했으니(약 41~53%), 차이는 엔진 버전과 설정에서 나온 것으로 보입니다(추정).
Unsloth Studio의 기본값(Auto)은 이 PC에서 MTP 대신 다른 방식(ngram)을 골랐습니다. 그래서 기본값만 쓰면 이 차이가 드러나지 않습니다. 앞으로는 기본값(Auto)으로 먼저 재고, 너무 느리면 빨라지는 설정을 따로 안내하겠습니다.
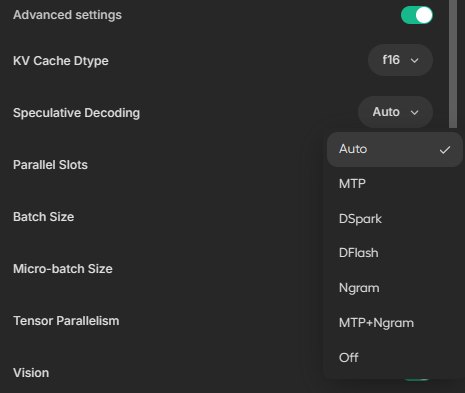
속도 기능 메뉴입니다. 기본은 Auto이고, MTP를 직접 고를 수 있습니다.
이유 2. 생각 길이를 제한할 수 있다
요즘 모델은 답하기 전에 "생각"을 길게 씁니다. 생각이 너무 길어지면 답이 늦게 나오거나, 컨텍스트를 다 써서 답 없이 멈춥니다. 83번 글에서 Qwen3.8 27B가 LM Studio 기본 설정으로 800자 글에 답하지 못한 것도 이 때문이었습니다.
- LM Studio: 화면에서는 Reasoning Budget(생각 한도)을 정할 수 있지만, API로는 한도를 줄 수 없었습니다. 모델마다 화면에 저장해 둔 값을 따릅니다.
- Unsloth Studio: 모델을 올릴 때 API로 생각 한도를 줄 수 있고, 생각 단계(None·Low·Medium·High 등)도 고를 수 있습니다.
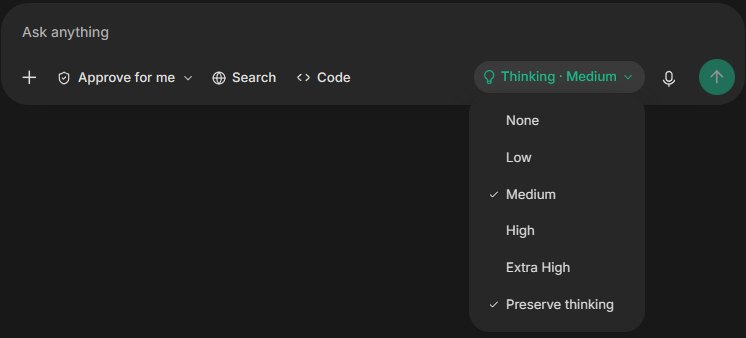
Unsloth Studio의 생각 단계 메뉴입니다.
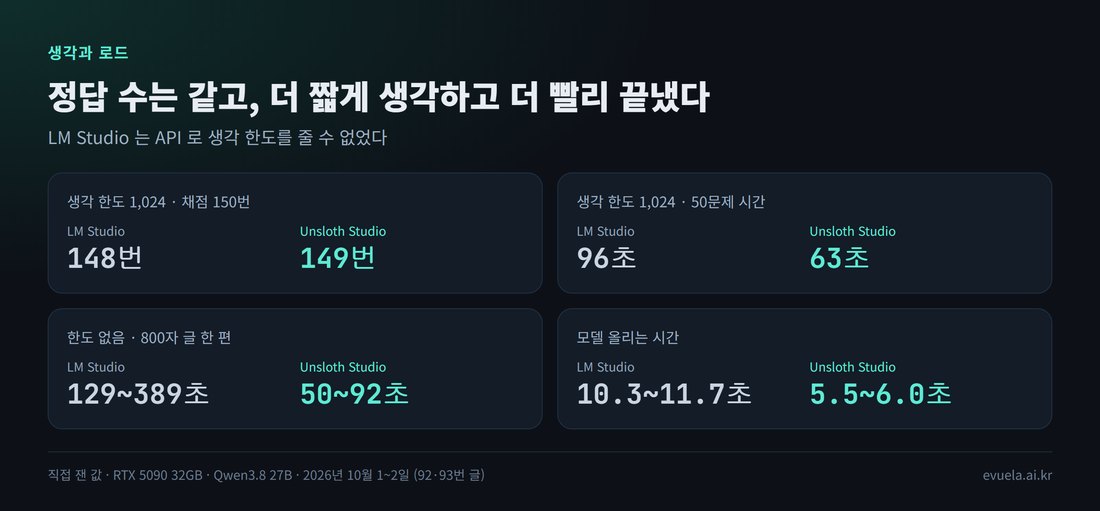
생각 한도와 모델 올리는 시간을 비교했습니다.
| 조건 (Qwen3.8 27B) | LM Studio | Unsloth Studio |
|---|---|---|
| 생각 한도 1,024: 채점 질문 정답 | 150번 중 148번 | 150번 중 149번 |
| 생각 한도 1,024: 50문제 푸는 시간 | 96초 | 63초 |
| 한도 없음: 800자 글 한 편 | 129초, 334초, 389초 | 50초, 86초, 92초 |
| 모델 올리는 시간(8번) | 10.3~11.7초 | 5.5~6.0초 |
이 표가 뜻하는 것은, 정답 수는 같은데 Unsloth Studio가 더 짧게 생각하고 더 빨리 끝냈다는 점입니다. 테스트하는 쪽에서는 모델마다 같은 조건으로 생각 길이를 맞출 수 있어 공정한 비교가 쉬워집니다.
이유 3. 기본 컨텍스트를 메모리에 맞춰 크게 잡는다
컨텍스트는 모델이 한 번에 기억하는 글의 길이입니다. 생각과 답을 합쳐 이 안에 들어가야 합니다.
| 프로그램 | 기본 컨텍스트 (Qwen3.8 27B, RTX 5090) |
|---|---|
| LM Studio | 8,192토큰 |
| Unsloth Studio (Auto) | 그래픽카드 메모리에 맞춰 자동. 이 PC에서 159,488~168,448토큰 |
이 표가 뜻하는 것은, 처음 쓰는 사람이 설정을 몰라도 긴 생각과 긴 문서를 다룰 수 있다는 점입니다. 대신 메모리를 많이 잡아서, 다른 프로그램과 그래픽카드를 함께 쓸 때는 컨텍스트를 줄여야 할 수 있습니다.
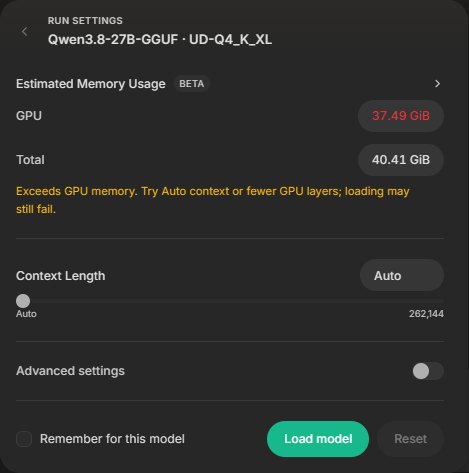
Unsloth Studio의 실행 설정 창입니다. 컨텍스트가 Auto로 되어 있고, 올리기 전에 예상 메모리를 보여 줍니다.
이유 4. 학습과 이미지까지 한 프로그램에서
Unsloth Studio에는 모델 학습(파인튜닝) 화면과 이미지 만들기 화면이 있습니다. 앞으로 "내 데이터로 작은 모델을 학습시키면 어떻게 되나", "이미지 모델을 16GB에서 돌리면 어떤가" 같은 테스트를 같은 프로그램에서 이어서 할 수 있습니다.
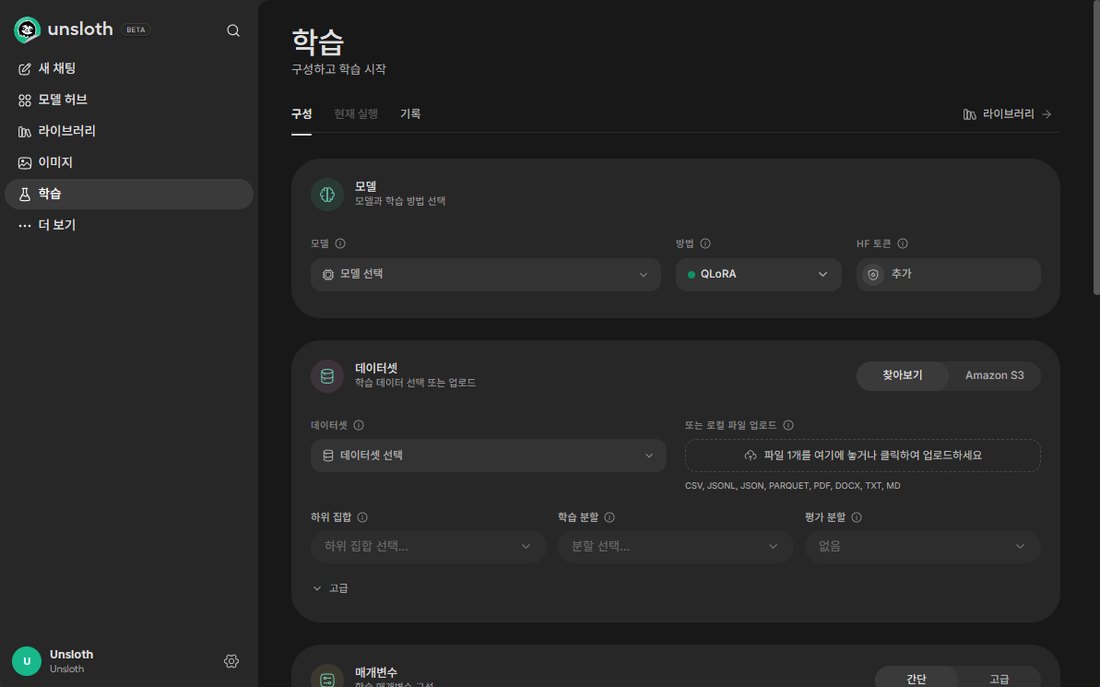
Unsloth Studio의 학습 화면입니다.
이유 5. API에 키가 필요하다
Unsloth Studio의 API는 키 없이 요청하면 거절합니다(이 블로그의 RTX 5060 Ti PC에서 확인, 응답 코드 401). 내 PC에 띄운 AI 서버라도, 다른 기기에서 접속할 수 있게 열어 두면 키가 없는 서버는 누구나 쓸 수 있게 됩니다. 키가 기본으로 켜져 있는 편이 안전합니다. 키는 PC마다 Unsloth Studio에서 따로 만듭니다.
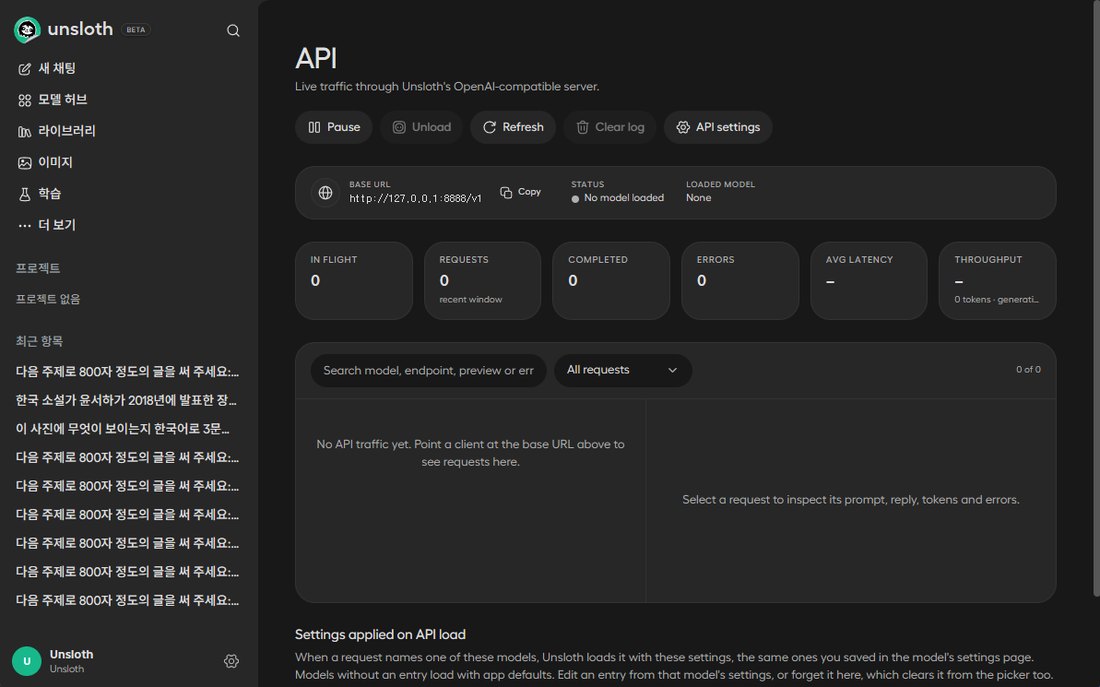
API 화면에서 주소, 요청 수, 처리 속도를 바로 볼 수 있습니다. 이 캡처는 모델을 올리지 않은 상태라 숫자가 모두 0입니다.
조심할 점
| 조심할 점 | 내용 | 이 블로그의 대처 |
|---|---|---|
| 아직 베타 | 프로그램 왼쪽 위에 BETA라고 표시됩니다. 버전이 자주 바뀝니다 | 글마다 Unsloth Studio와 엔진 버전을 적습니다 |
| 큰 컨텍스트에서 사진이 느림 | 컨텍스트 131,072에서는 사진을 읽는 부분(mmproj)을 CPU로 옮겨, 사진 설명이 1.7초에서 49초로 느려졌습니다 | 사진 테스트에는 그때의 컨텍스트를 함께 적습니다 |
| 모델이 저절로 내려받아짐 | 저장소 이름으로 불러오면 Hugging Face에서 바로 받습니다(18.5GB가 받아진 적 있음) | 이미 받은 파일만 쓰고, 새로 받을 때는 크기를 먼저 확인합니다 |
| 예전 결과와 바로 비교하기 어려움 | 같은 파일도 프로그램에 따라 속도가 다릅니다 | 글과 GPU 체험 페이지에 측정 프로그램을 모델마다 적습니다 |
이 표가 뜻하는 것은, Unsloth Studio가 모든 면에서 낫다는 뜻은 아니라는 점입니다. 그래서 LM Studio는 지우지 않고, 비교가 필요할 때 함께 씁니다.
앞으로 테스트 글은 이렇게 바뀝니다
- 기준은 Unsloth Studio 기본값(Auto)입니다. 처음 쓰는 사람이 받는 그대로의 성능을 먼저 보여 줍니다.
- 기본값이 너무 느리면(그래픽카드를 거의 쓰지 않거나 같은 모델의 예전 결과보다 크게 낮으면) 빨라지는 설정을 따로 찾아 "이렇게 바꾸면 빨라진다" 절로 함께 싣습니다.
- 질문과 순서는 지금까지와 같습니다(800자 글, 산수, 긴 글 요약, 없는 소설, 사진, 큰 컨텍스트). 그래서 예전 LM Studio 결과와도 나란히 볼 수 있습니다.
- GPU 체험 페이지에는 모델마다 "LM Studio / Unsloth Studio" 중 어느 것으로 쟀는지 표시합니다.
정리
- 기본값끼리는 두 프로그램의 속도가 거의 같았습니다(65.4 대 65.6 t/s).
- MTP를 켜면 Unsloth Studio가 35~44% 빨랐고, 생각 한도를 걸면 같은 정답 수로 더 빨리 끝냈습니다.
- 기본 컨텍스트를 메모리에 맞춰 크게 잡고, 학습·이미지·API 키까지 한 프로그램에 있습니다.
- 베타이고 큰 컨텍스트에서 사진이 느린 점은 조심해야 합니다.
이 글의 한계
- 비교는 RTX 5090 PC 한 대, 모델 하나(Qwen3.8 27B)로 한 것입니다. 16GB 그래픽카드에서도 같은 차이가 나는지는 앞으로 5060 Ti 테스트에서 확인합니다.
- 측정은 2026년 10월 1~2일에 했고, 두 프로그램 모두 버전이 바뀌면 결과가 달라질 수 있습니다.
자주 묻는 질문
LM Studio를 쓰고 있는데 꼭 바꿔야 하나요?
아니요. 기본값으로 쓰면 두 프로그램의 속도가 거의 같았습니다. MTP 같은 속도 기능을 쓰거나, 생각 길이를 API로 제한하거나, 학습까지 하고 싶다면 Unsloth Studio가 유리합니다.
LM Studio에서 받은 모델을 Unsloth Studio에서 다시 받아야 하나요?
아니요. Unsloth Studio가 LM Studio 모델 폴더의 파일을 목록에 보여 주고, 그대로 불러옵니다. 다만 모델을 저장소 이름으로 불러오면 새로 내려받으니, 목록에서 고르는 것이 안전합니다.
Unsloth Studio는 무료인가요?
네. 무료 오픈소스(Apache 2.0, AGPL-3.0)입니다. 2026년 10월 기준 베타입니다.
속도가 정말 빨라지나요?
같은 Qwen3.8 27B 파일에서 MTP를 켰을 때 초당 70.5토큰(LM Studio)과 96.1토큰(Unsloth Studio)이었습니다. 기본값으로는 65.4토큰과 65.6토큰으로 거의 같았습니다.
참고: 측정 원본은 이 블로그의 92번, 93번, 83번 글 · Unsloth GitHub · LM Studio

댓글 0개