 Tools
로컬 AI 테스트를 LM Studio에서 Unsloth Studio로 바꾼 이유, 기본값은 비슷했고 MTP를 켜면 35% 이상 빨랐다
같은 Qwen3.8 27B 파일로 LM Studio와 Unsloth Studio를 비교했습니다. 기본값 속도는 65.4 대 65.6 t/s로 같았고, MTP를 켜면 35~44% 빨랐습니다. 생각 한도, 컨텍스트, 조심할 점과 앞으로의 측정 방법을 정리했습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"파인튜닝" 검색 결과 5건
Tools
같은 Qwen3.8 27B 파일로 LM Studio와 Unsloth Studio를 비교했습니다. 기본값 속도는 65.4 대 65.6 t/s로 같았고, MTP를 켜면 35~44% 빨랐습니다. 생각 한도, 컨텍스트, 조심할 점과 앞으로의 측정 방법을 정리했습니다.
 RTX-5090
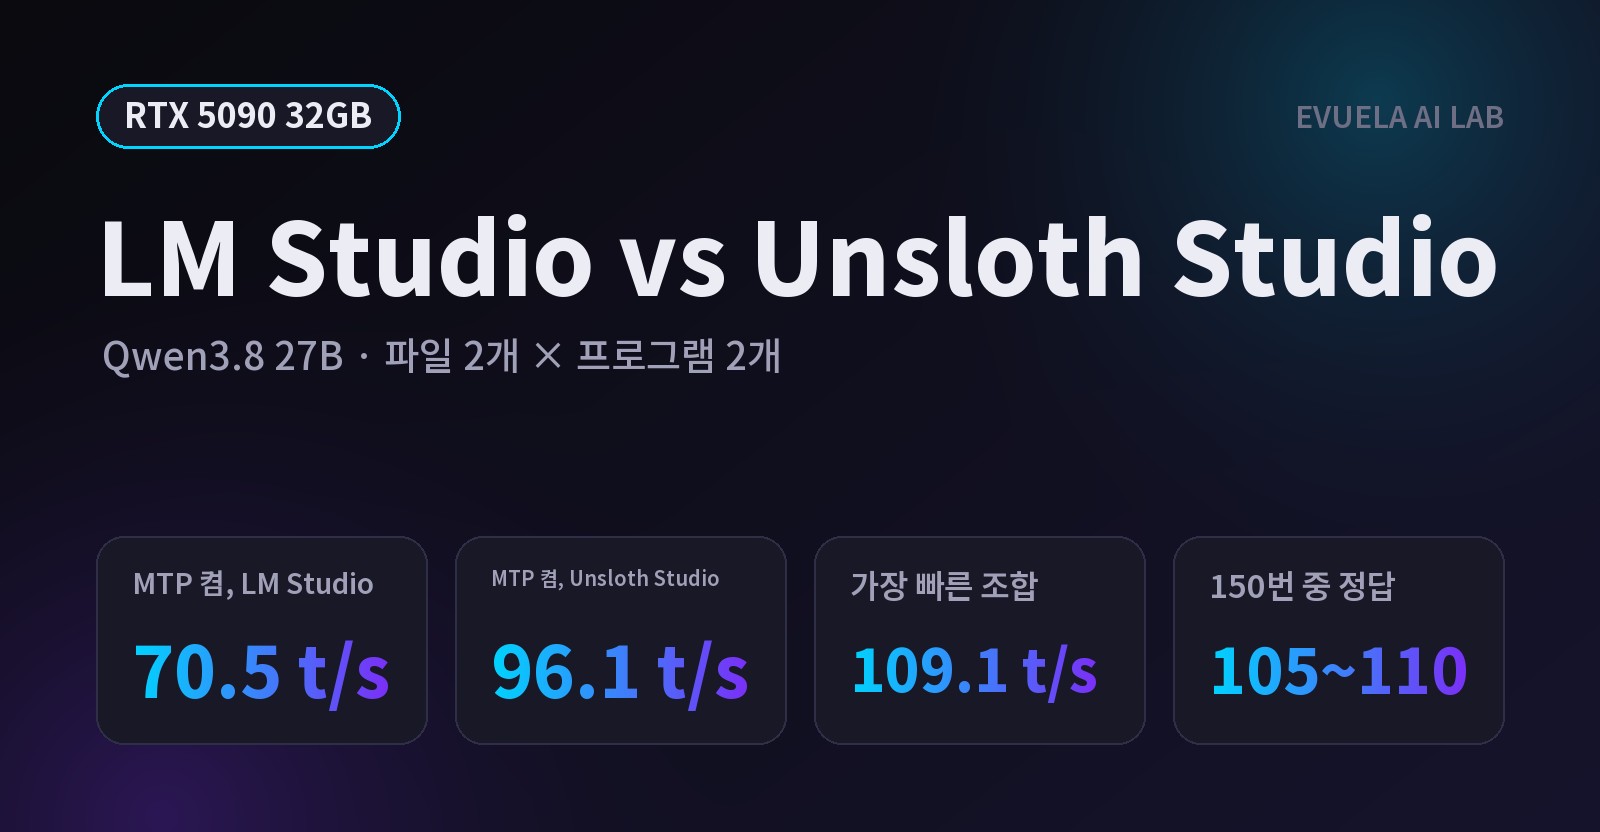
RTX 5090에서 Qwen3.8 27B 파일 두 개(lmstudio-community Q4_K_M, unsloth UD-Q4_K_XL)를 LM Studio와 Unsloth Studio에 차례로 올리고 설정을 똑같이 맞춰 쟀습니다. MTP를 끄면 두 프로그램의 속도가 거의 같았고, MTP를 켜면 Unsloth Studio가 35~36% 빨랐습니다. lmstudio-community 파일은 두 프로그램 모두에서 8~15% 더 빨랐고, 정답률은 네 조합이 같았습니다. 생각 설정의 차이와 두 프로그램 화면 캡처도 함께 정리했습니다.
 RTX-5090
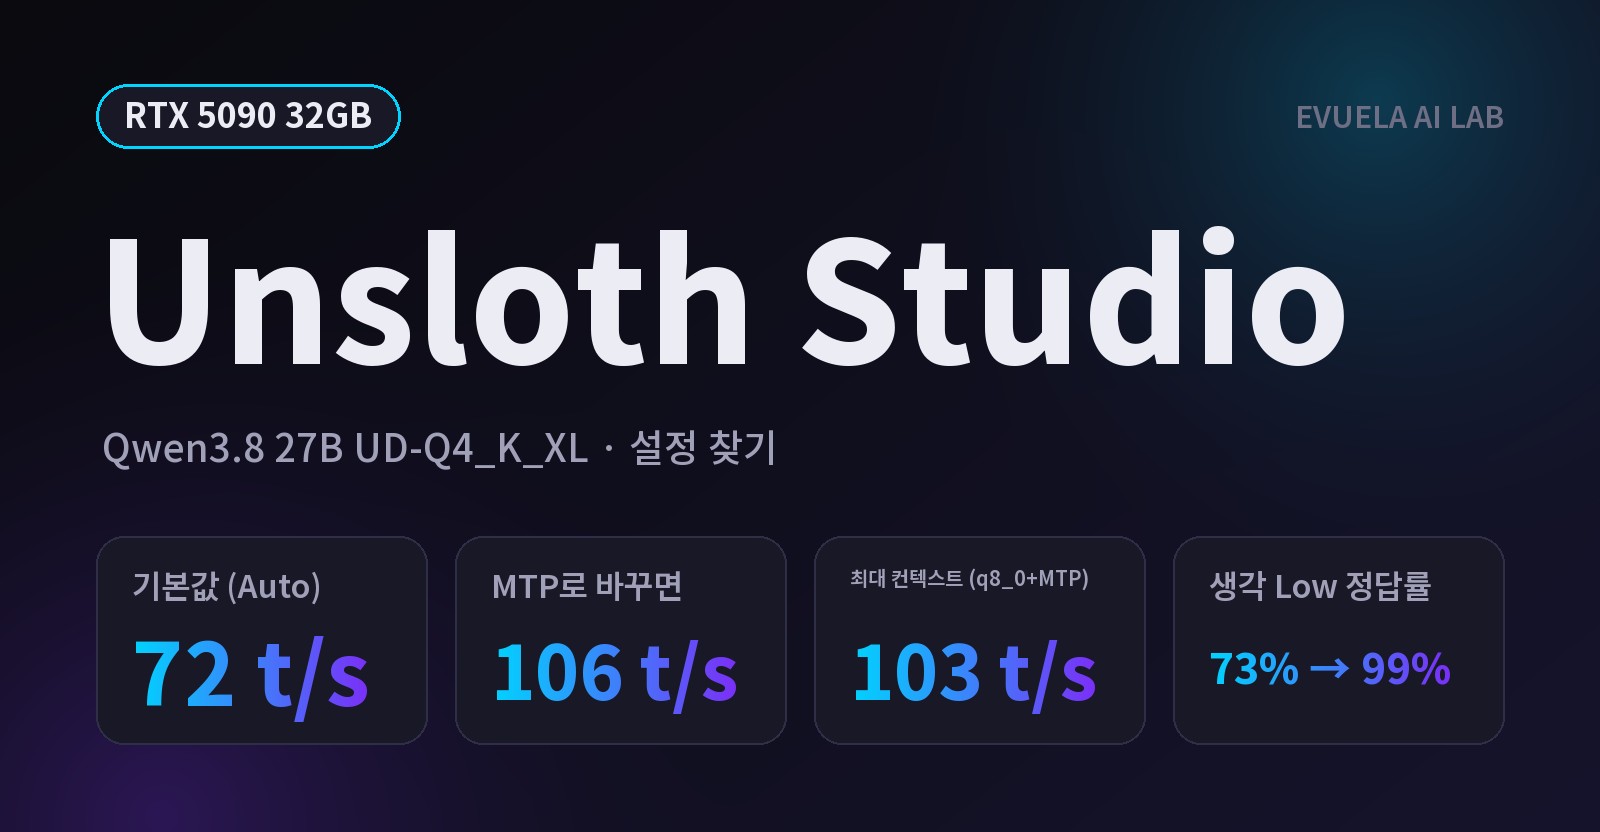
Unsloth Studio를 RTX 5090에 설치하고 Qwen3.8 27B(UD-Q4_K_XL)로 설정을 하나씩 바꿔 가며 쟀습니다. 기본값은 컨텍스트를 16만 8천 토큰으로 알아서 잡았고 초당 72토큰이었습니다. 속도 기능을 MTP로 바꾸면 48% 빨라졌고, KV 캐시를 q8_0으로 줄이면 최대 컨텍스트 262,144에서도 초당 103토큰이 나왔습니다. 생각 단계별 정답률, 화면 캡처, 쓰임새별 추천 설정을 정리했습니다.
 AI 뉴스
2026년 8월 출시된 Qwen3.8-27B는 270억 파라미터의 개방형 멀티모달 모델로, Apache 2.0 라이선스 기반의 강력한 에이전트 코딩 및 실무 작업 성능을 제공한다. 로컬 LLM 환경에서의 VRAM 요구사항과 실무 적용 가능성을 깊이 있게 분석한다.
 AI 뉴스
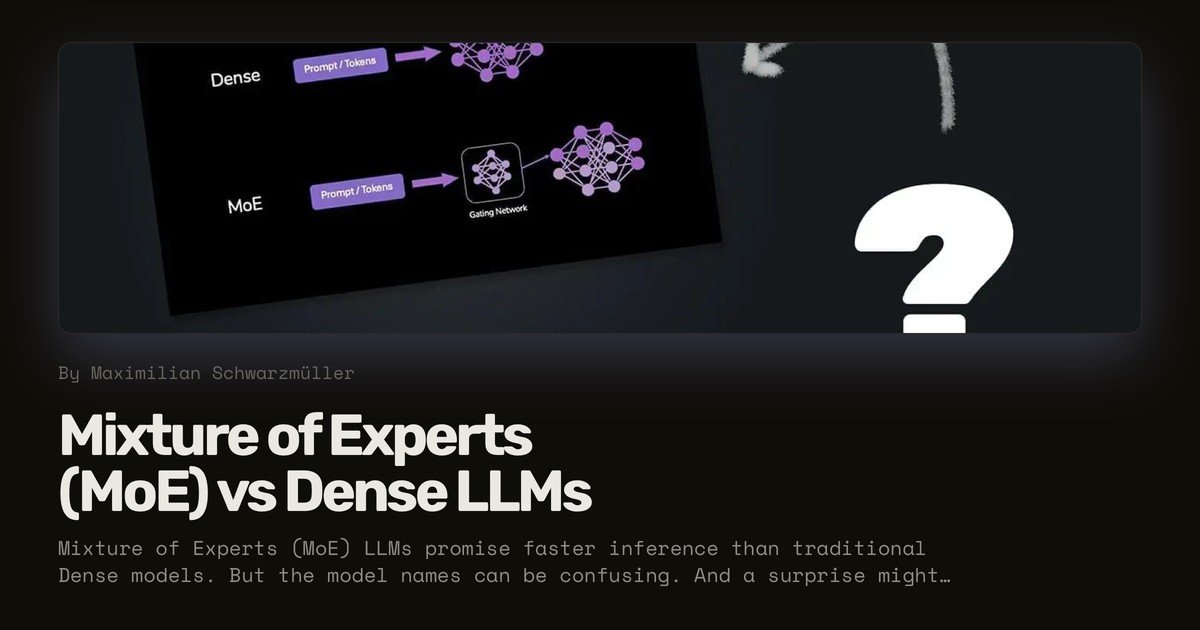
Dense 모델과 Mixture of Experts (MoE) 모델의 차이점을 파악하고, LLM 아키텍처가 실무에 미치는 영향을 기술적 관점에서 분석합니다. 로컬 AI, SI 환경에서의 활용 전략을 다룹니다.