Meta가 2026년 8월 10일 공개한 Muse Glimmer는 "내 PC에서 돌리는 에이전트"를 목표로 만든 약 300억 파라미터 모델입니다. 이미지 입력과 도구 호출을 지원하고, 라이선스는 Apache 2.0입니다. RTX 5090 PC의 LM Studio에서 기본 설정 그대로 돌려 봤습니다. 결과부터 말하면 컨텍스트를 16배 늘려도 VRAM이 1.7GB만 늘었고, 기본 설정에서 27번 물어 27번 모두 답을 냈습니다. 속도는 초당 약 74토큰으로 일정했습니다. 다만 생각 기능을 끌 수 없고, 가장 짧은 생각 단계에서도 답까지 약 7초가 걸렸습니다.
테스트 PC 사양
| 부품 | 사양 |
|---|---|
| GPU | NVIDIA GeForce RTX 5090 (VRAM 32GB), 드라이버 616.92 |
| CPU / 메모리 | Intel Core Ultra 9 285K / DDR5 64GB |
| 운영체제 | Windows 11 Pro (빌드 26200) |
| LM Studio | 0.4.25, llama.cpp CUDA 12 런타임 2.45.0 |
같은 PC에서 앞서 Qwen3.8 27B, Ternary Bonsai 2 27B, Gemma 4 12B QAT를 같은 질문으로 테스트했습니다. 비교가 필요한 부분은 그 결과를 함께 적었습니다.
테스트한 모델: Muse Glimmer (Q4_K_M)
Meta가 Llama 이후 새로 내놓은 공개 모델입니다. 모든 파라미터를 매번 쓰는 dense 모델이고, 글을 만드는 부분(약 28B)과 이미지를 읽는 인코더(약 2B)로 되어 있습니다. 가까운 2,048토큰만 보는 층 3개와 전체를 보는 층 1개를 번갈아 쌓은 구조라서, 긴 입력에도 메모리를 적게 쓰도록 설계됐습니다.
| 항목 | 내용 |
|---|---|
| 만든 곳 | Meta (2026년 8월 10일 공개) |
| 파라미터 | 약 296억 (글 부분 약 28B + 이미지 인코더 약 2B), dense |
| 구조 | 52층, 슬라이딩 윈도(2,048토큰) 3층 + 전체 어텐션 1층 반복 |
| 파일 | Q4_K_M 18.16GB (lmstudio-community) |
| 최대 컨텍스트 | 131,072토큰 |
| 기능 | 이미지 입력, 도구 호출, 생각 단계 조절 (low · medium · high · xhigh) |
| 라이선스 | Apache 2.0 |
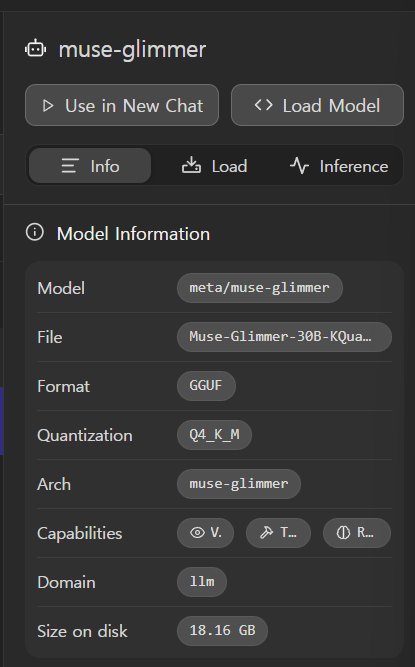
My Models의 모델 정보. 구조 이름은 muse-glimmer, 양자화는 Q4_K_M, 디스크 크기는 18.16GB입니다.
Meta는 모델 카드에서 에이전트 작업 점수 MCP Atlas 75.5점(Gemma 4 31B 54.2점, Qwen3.6-27B 62.5점), SWE-Bench Pro 51.2점, AIME 2026 94.7점을 받았다고 밝혔습니다. 모두 제작사가 잰 값입니다 (Muse Glimmer 모델 카드).
LM Studio 기본 설정값
설정은 바꾸지 않고 LM Studio가 잡아 주는 기본값을 그대로 썼습니다.
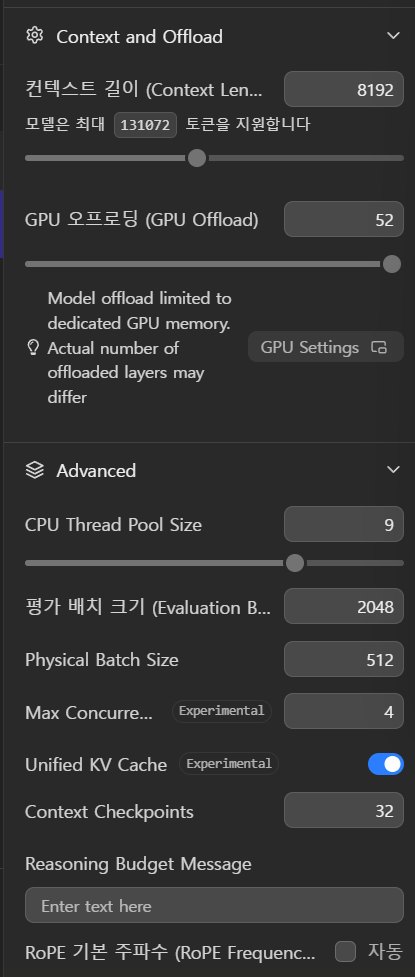
Load 탭. 컨텍스트 8,192, GPU 오프로드 52(전체 층)가 기본값입니다.
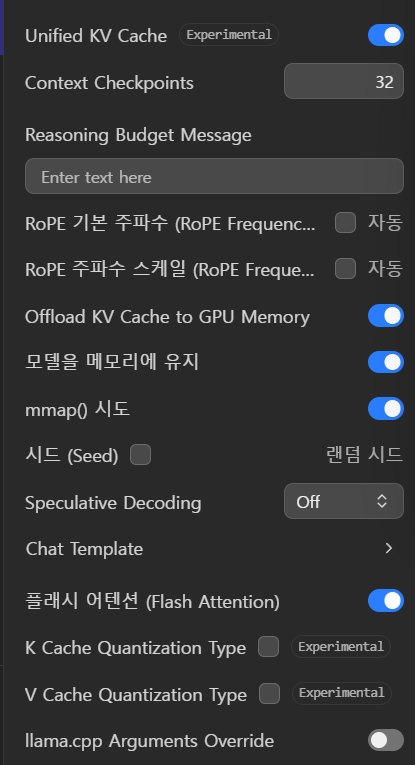
고급 설정. Flash Attention은 켜져 있고, Speculative Decoding은 꺼져(Off) 있습니다.
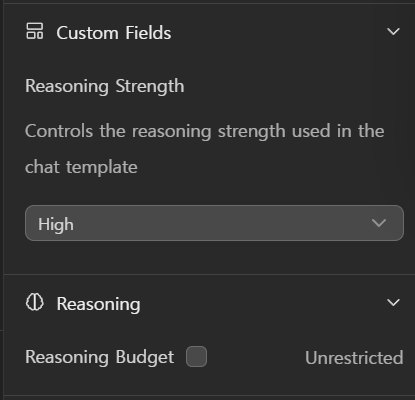
생각 단계(Reasoning Strength) 기본값은 High입니다. 생각 길이 제한은 없습니다(Unrestricted).
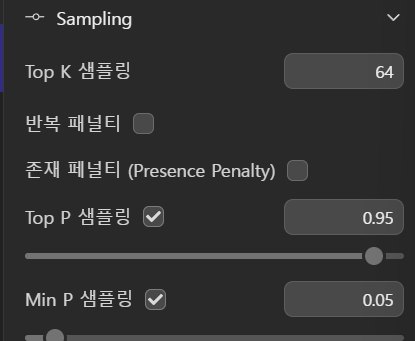
샘플링 기본값. Top K 64, Top P 0.95, Min P 0.05이고 반복 패널티는 꺼져 있습니다.
| 설정 | 기본값 | 뜻 |
|---|---|---|
| 컨텍스트 길이 | 8,192 | 한 번에 기억하는 토큰 수. 최대 131,072 |
| GPU 오프로드 | 52 (전체) | 모델의 모든 층을 GPU에 올립니다 |
| 생각 단계 | High | low · medium · high · xhigh 중 하나. 끄는 선택지는 없습니다 |
| Speculative Decoding | 꺼짐 | 다음 토큰을 미리 짐작해 속도를 올리는 기능 |
| 온도 / Top K / Top P | 1.0 / 64 / 0.95 | 제작사 권장값과 같습니다 |
Meta는 속도를 올리는 보조 모델(DFlash drafter)을 함께 공개했고, RTX 5090에서 최대 3.1배 빨라진다고 밝혔습니다. 하지만 LM Studio 기본 설정에서는 이 기능이 꺼져 있어서, 이번 측정은 보조 모델 없이 잰 속도입니다.
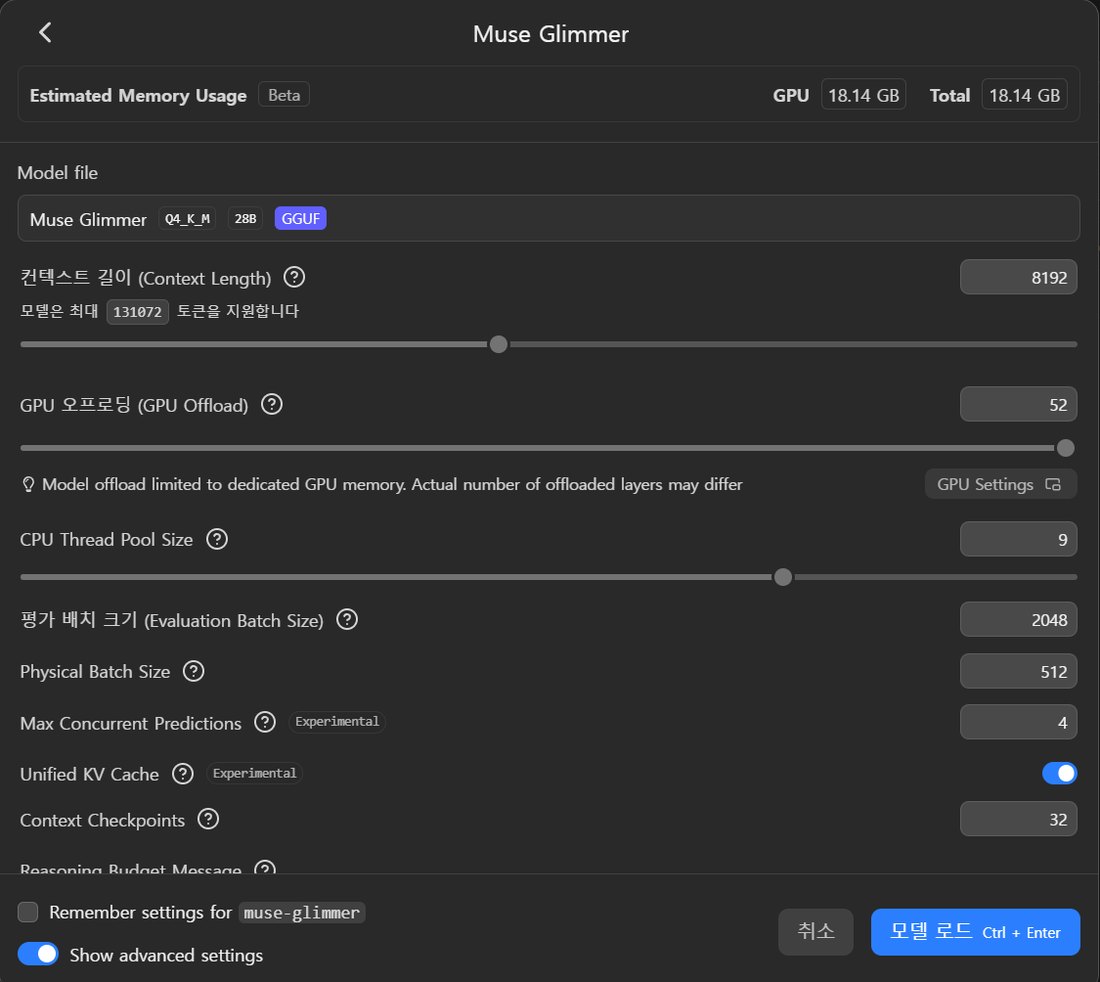
불러오기 창에서 LM Studio가 계산한 예상 메모리는 18.14GB였습니다.
테스트 1. VRAM과 불러오는 시간
컨텍스트 길이만 바꿔 다시 불러오며, 불러오기 직전과 직후의 GPU 메모리 차이를 쟀습니다.
| 컨텍스트 | 모델이 쓴 VRAM | 불러오는 시간 | 참고: Qwen3.8 27B (Q4_K_M) |
|---|---|---|---|
| 8,192 (기본값) | 약 17.5GB | 9.2초 | 약 19.7GB |
| 32,768 | 약 17.8GB | 9.2초 | 약 21.4GB |
| 65,536 | 약 18.3GB | 9.3초 | - |
| 131,072 (최대) | 약 19.2GB | 9.3초 | 약 27.9GB |
눈에 띄는 것은 컨텍스트를 16배(8,192 → 131,072) 늘려도 VRAM이 약 1.7GB만 늘었다는 점입니다. 같은 조건에서 Qwen3.8 27B는 약 8.2GB가 늘었습니다. 가까운 2,048토큰만 보는 층이 4개 중 3개라서, 긴 대화를 기억하는 메모리가 적게 드는 것으로 보입니다. 그래서 24GB 그래픽카드면 최대 컨텍스트까지 들어가는 크기입니다. 반면 기본 설정부터 17.5GB라 16GB 카드에는 들어가지 않습니다. 그래픽카드 크기별 판정은 GPU 체험에서 볼 수 있습니다.
테스트 2. 800자 글쓰기와 속도
"다음 주제로 800자 정도의 글을 써 주세요: 집에 있는 PC로 AI 모델을 돌릴 때 알아야 할 점"을 기본 컨텍스트(8,192)에서 생각 단계별로 물었습니다.
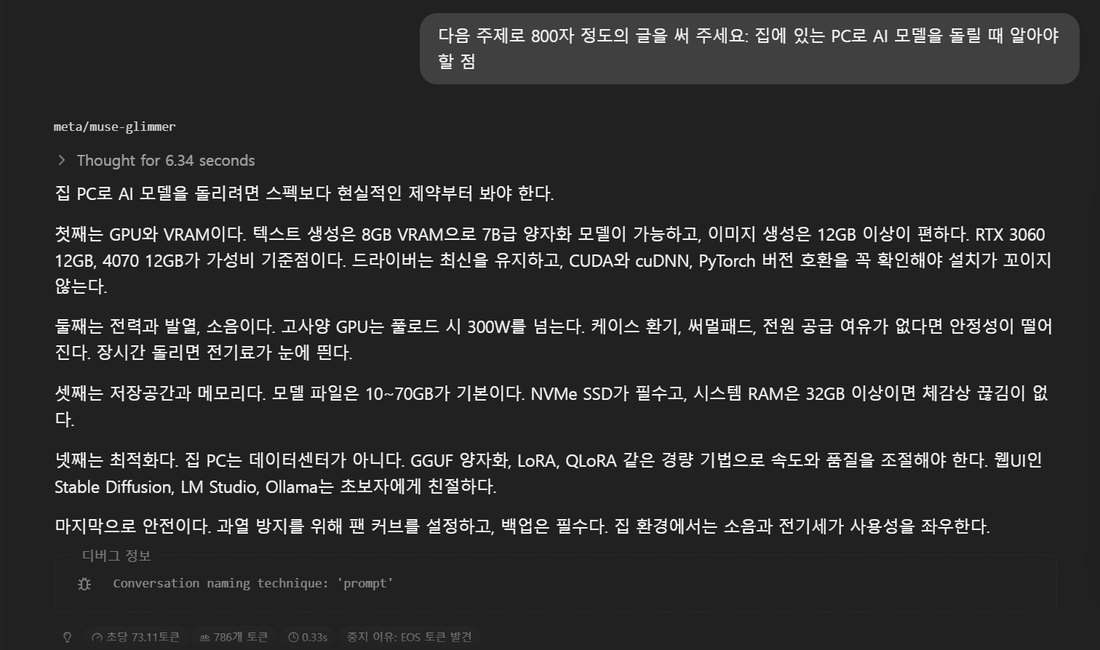
채팅 화면. 6.34초 생각한 뒤 답했고, 초당 73.11토큰으로 786토큰을 만들었습니다. 끝난 이유는 정상 종료(EOS)입니다.
| 생각 단계 | 초당 토큰 | 생각 토큰 | 답 글자 수 | 답이 끝날 때까지 |
|---|---|---|---|---|
| High (기본값) | 74.2~74.4 | 430~895 | 705~720자 | 10.7~17.4초 |
| Medium | 74.6 | 211 / 250 | 731 / 696자 | 8.1 / 8.4초 |
| Low | 74.4~74.5 | 103~115 | 685~848자 | 6.5~7.6초 |
세 단계 모두 800자에 가까운 답을 냈고, 기본 컨텍스트에서도 답이 끊기거나 비는 일이 한 번도 없었습니다. 기본 생각 단계에서 생각이 가장 길었던 경우도 895토큰이었습니다. 같은 조건에서 Qwen3.8 27B는 생각에만 약 8,000토큰을 쓰다가 답을 내지 못했습니다. 컨텍스트 32,768에서 가장 높은 단계(xhigh)로 물어도 생각은 846토큰, 답까지 16.8초였습니다.
속도는 생각 단계와 상관없이 초당 약 74토큰으로 일정했습니다. 같은 PC에서 Qwen3.8 27B가 생각을 끄고 초당 약 72토큰이었으니 비슷한 수준입니다. 12B인 Gemma 4 12B QAT(초당 약 147토큰)의 절반 정도입니다.
테스트 3. 산수 문제
"사과 한 상자에 24개, 3상자를 사서 19개를 먹고, 남은 것을 5명이 똑같이 나누면?"을 물었습니다. 정답은 한 사람당 10개, 3개 남음입니다.
| 생각 단계 | 정답 | 한 번에 걸린 시간 | 생각 토큰 |
|---|---|---|---|
| High (기본값) | 5번 중 5번 | 약 4.5초 | 272~343 |
| Low | 5번 중 5번 | 약 2.4초 | 144~160 |
두 단계 모두 5번 다 맞혔고, "형식으로만 답하라"는 지시도 지켰습니다. 생각을 끌 수 없는 모델이라, 다른 모델들이 생각을 끄면 틀리던 이 문제에서 틀릴 일이 없었습니다. 대신 한 줄짜리 답에도 최소 2초가 걸립니다.
테스트 4. 긴 글 요약
이 블로그의 업데이트 기록을 3,000자, 15,000자, 100,000자로 잘라 넣고 세 문장으로 요약하게 했습니다. 생각을 끌 수 없어서 가장 짧은 low로 쟀습니다.
| 입력 | 입력 토큰 | 첫 글자까지 | 생성 속도 |
|---|---|---|---|
| 3,000자 | 1,499 | 0.43초 | 초당 73.2토큰 |
| 15,000자 | 7,277 | 1.51초 | 초당 69.2토큰 |
| 100,000자 | 43,037 | 11.79초 | 초당 70.0토큰 |
약 4만 3천 토큰을 읽는 데 11.8초, 초당 약 3,650토큰으로 읽었습니다. 요약 세 개 모두 날짜와 고친 내용을 맞게 담았습니다. 100,000자를 넣어도 생성 속도가 초당 70토큰으로 거의 떨어지지 않은 것도 긴 입력에 강한 구조 덕분으로 보입니다.
테스트 5. 한국어 품질
받은 한국어 답 27개를 모두 검사했습니다. 외국어가 섞인 답은 1개였고, "RTX 40系"(중국어로 40 시리즈)라는 한 단어였습니다. 문장은 자연스러웠지만 두 가지는 알아 두면 좋습니다.
- 말투: 따로 요청하지 않으면 "~한다", "~이다"로 끝나는 글말을 주로 씁니다. 존댓말이 필요하면 질문에 적어 주세요.
- 사실 오류: 800자 글에서 "12GB 이상이면 13B~70B Q4가 가능하다"고 썼습니다. 70B 모델은 4비트로 줄여도 40GB 안팎이 필요해서 틀린 설명입니다. 숫자가 들어간 답은 한 번 더 확인하는 편이 좋습니다.
테스트 6. 없는 소설과 이미지
실제로는 없는 작품인 "한국 소설가 윤서하가 2018년에 발표한 『푸른 등대의 겨울』의 줄거리"를 물었습니다.
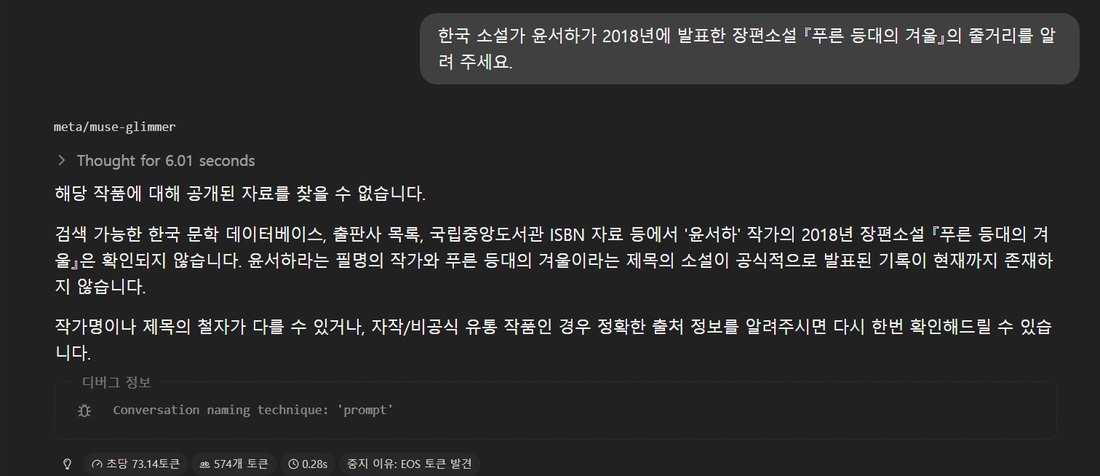
6.01초 생각한 뒤 "공개된 자료를 찾을 수 없다"고 답하고, 제목이나 작가명을 다시 확인해 달라고 했습니다.
High와 Low 모두 줄거리를 지어내지 않았습니다. API로 물었을 때도 각각 8.2초, 3.6초 만에 "확인되지 않는다"고 답했습니다.
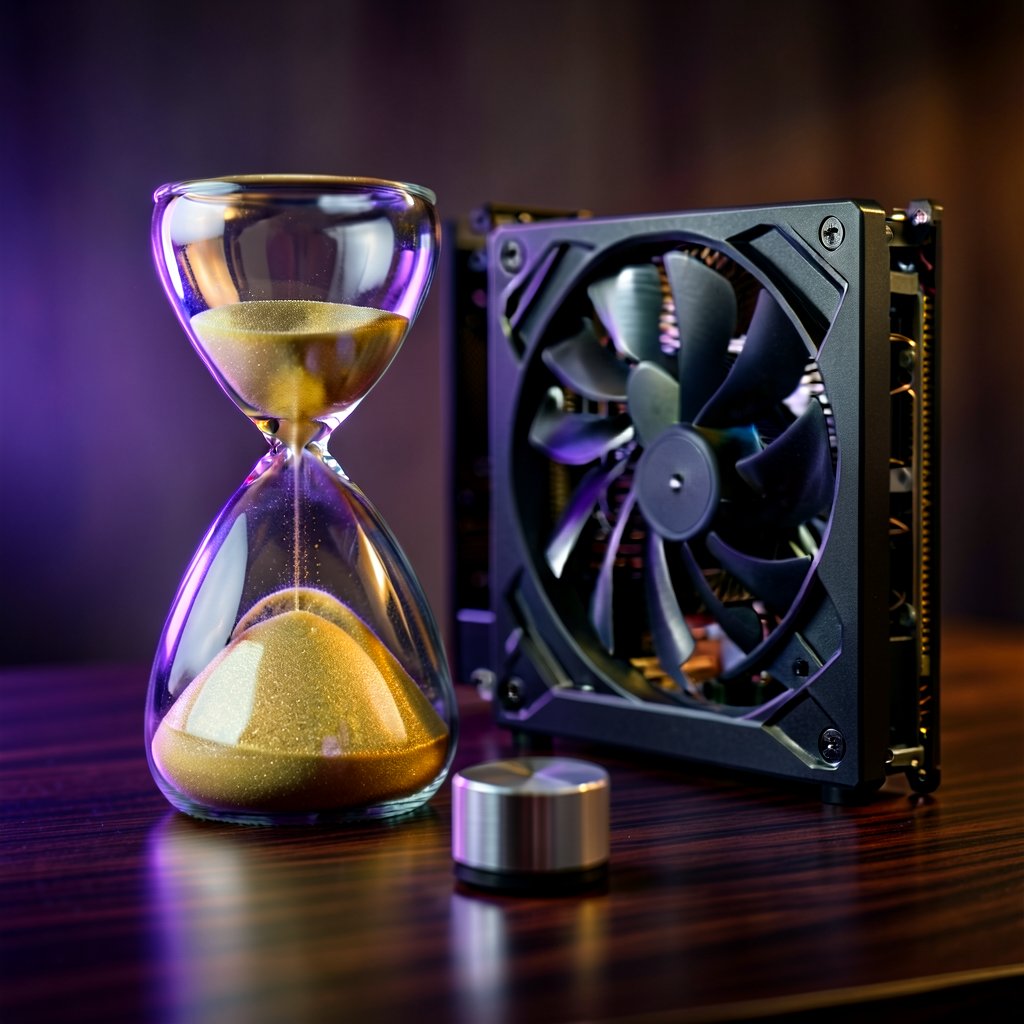
모래시계 두 개가 있는 사진을 넣고 세 문장으로 설명하게 했습니다.
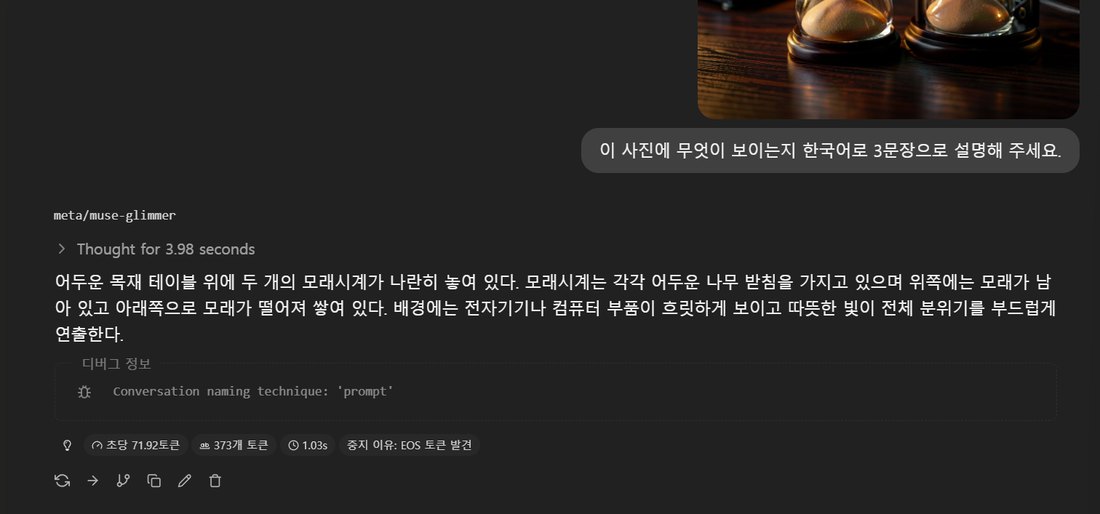
3.98초 생각한 뒤 답했습니다. 초당 71.92토큰입니다.
나무 테이블, 모래시계 두 개, 뒤쪽의 전자 장비와 따뜻한 조명을 알아봤습니다. 채팅 화면에서는 오른쪽 모래시계 안의 컴퓨터 부품을 "배경"으로 설명했지만, API로 물었을 때는 두 번 모두 오른쪽 모래시계 유리 너머로 메인보드와 배선 같은 컴퓨터 부품이 비친다고 짚었습니다. 생각 단계를 Low로 두면 3.5초, 기본값이면 6.1초에 답했습니다.
정리
| 항목 | Muse Glimmer | Qwen3.8 27B | Ternary Bonsai 2 27B |
|---|---|---|---|
| 파일 크기 | 18.16GB | 16.81GB | 5.95GB |
| VRAM (기본 → 최대 컨텍스트) | 17.5 → 19.2GB | 19.7 → 29.5GB | 7.1 → 22.8GB |
| 속도 (RTX 5090) | 초당 약 74토큰 | 초당 약 72토큰(생각 끔) | 초당 약 119토큰* |
| 기본 설정 800자 글 | 11~17초, 모두 답함 | 답 없음(컨텍스트 가득 참) | 답 없음(컨텍스트 8,192일 때) |
| 외국어 섞임 | 27개 중 1개 | 약 40개 중 3개 | 33개 중 3개 |
| 생각 끄기 | 불가 | 가능 | 가능 |
* Ternary Bonsai 2 27B는 LM Studio가 아닌 PrismML llama.cpp로 잰 값입니다.
- 24GB 그래픽카드에 잘 맞습니다. 최대 컨텍스트(131,072)에서도 VRAM이 약 19.2GB라, 긴 문서를 넣어도 메모리 걱정이 적습니다. 16GB 카드에는 들어가지 않습니다.
- 기본 설정 그대로 써도 안정적입니다. 생각이 짧아서 기본 컨텍스트에서도 모든 질문에 답했습니다. 설정을 만지기 싫은 사람에게 편한 모델입니다.
- 대신 생각을 끌 수 없습니다. 한 줄 답에도 2초 이상 걸리고, 빠른 대화용으로는 조금 답답할 수 있습니다.
- 한국어는 자연스럽지만 사실 확인은 필요합니다. 말투는 글말 위주이고, 숫자가 틀린 경우가 있었습니다.
자주 묻는 질문
Muse Glimmer는 VRAM을 얼마나 쓰나요?
LM Studio의 Q4_K_M 판 기준으로 기본 컨텍스트 8,192에서 약 17.5GB, 32,768에서 약 17.8GB, 65,536에서 약 18.3GB, 최대인 131,072에서 약 19.2GB였습니다. 컨텍스트를 늘려도 메모리가 거의 늘지 않습니다. RTX 5090에서 잰 값입니다.
16GB 그래픽카드로 Muse Glimmer를 돌릴 수 있나요?
Q4_K_M 판은 기본 설정에서도 약 17.5GB가 필요해서 16GB 카드의 VRAM에는 다 들어가지 않습니다. 24GB 카드면 최대 컨텍스트까지 들어갑니다.
Muse Glimmer의 생각(thinking) 기능을 끌 수 있나요?
끌 수 없습니다. 생각 단계는 low, medium, high, xhigh 네 가지이고 기본값은 high입니다. 가장 짧은 low로 두면 800자 글은 약 7초, 산수 한 문제는 약 2.4초에 답했습니다.
RTX 5090에서 속도는 얼마나 나오나요?
LM Studio 기본 설정에서 생각 단계와 상관없이 초당 약 74토큰이었습니다. Meta는 보조 모델(DFlash)을 쓰면 RTX 5090에서 최대 3.1배 빨라진다고 밝혔지만, LM Studio 기본 설정에서는 이 기능이 꺼져 있습니다.
댓글 0개