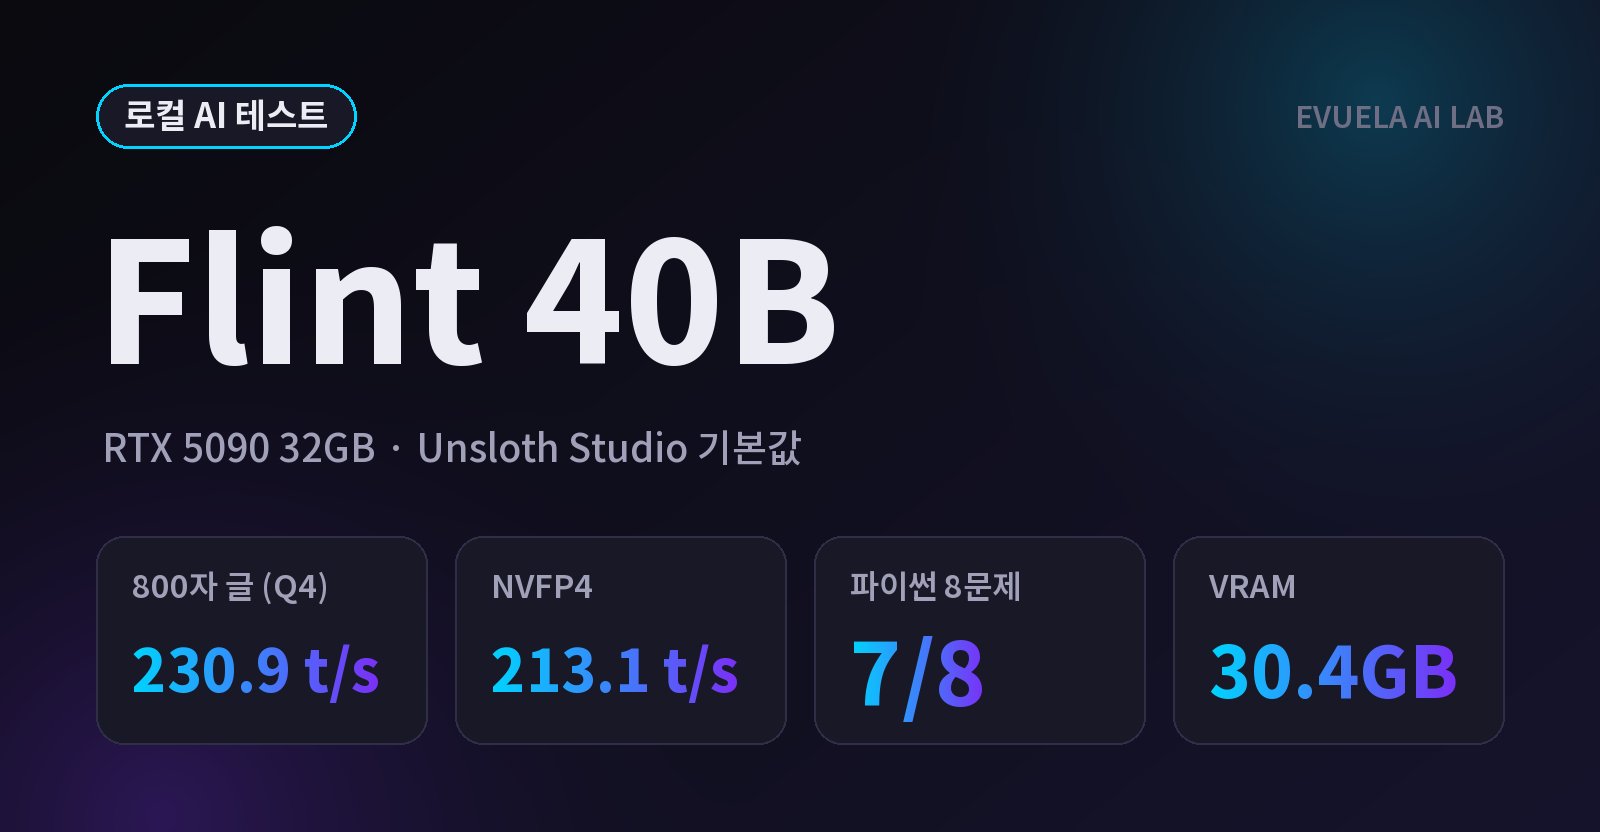
[RTX 5090 32GB] 코딩 AI Flint 40B를 내 PC에서 돌리면, 초당 231토큰에 파이썬 8문제 중 7문제를 풀었다
Recursive SI의 공개 코딩 모델 Flint 40B를 RTX 5090 32GB의 Unsloth Studio에서 Q4와 공식 NVFP4로 쟀습니다. 초당 230.9토큰, VRAM 30.4GB, 파이썬 8문제 중 7문제를 풀었고, 생각은 끌 수 없었으며 37만 8천 원을 3만 7,800원으로 읽었습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"24GB 그래픽카드" 검색 결과 5건
Recursive SI의 공개 코딩 모델 Flint 40B를 RTX 5090 32GB의 Unsloth Studio에서 Q4와 공식 NVFP4로 쟀습니다. 초당 230.9토큰, VRAM 30.4GB, 파이썬 8문제 중 7문제를 풀었고, 생각은 끌 수 없었으며 37만 8천 원을 3만 7,800원으로 읽었습니다.
로컬 AI는 모델을 내 PC의 그래픽카드에서 돌리는 것입니다. 필요한 것 세 가지와 VRAM 확인하는 법을 정리하고, RTX 5060 Ti 16GB와 RTX 5090 32GB에서 직접 잰 속도와 VRAM을 한 표로 모았습니다. 가이드 일곱 편의 첫 편입니다.
영상 생성 모델 LTX-2.5를 RTX 5090에서 ComfyUI로 돌렸습니다. 소리가 든 5초 영상(1280×704)이 약 20초, 풀HD는 50.5초, VRAM은 31.2GB였습니다. 한국어 대사와 한국에서 써도 되는 라이선스도 정리했습니다.
Qwen-Image-2.1을 RTX 5090에서 Unsloth Studio 기본 설정으로 돌렸습니다. 1024×1024 한 장 7.6초, VRAM 21.0GB, 받은 파일 17.2GB였습니다. 한글 글자 정확도와 연구·평가용 라이선스도 정리했습니다.
Meta가 공개한 약 300억 파라미터 모델 Muse Glimmer를 RTX 5090의 LM Studio 기본 설정으로 재 봤습니다. 컨텍스트를 16배 늘려도 VRAM은 17.5GB에서 19.2GB로 1.7GB만 늘었고, 기본 설정에서 27번 모두 답했습니다. 속도, 생각 단계, 한국어 품질, 이미지 입력까지 정리했습니다.