PrismML이 2026년 9월 18일 Ternary Bonsai 2 27B를 공개했습니다. 오늘 아침 리뷰한 Qwen3.8 27B를 가중치 하나당 약 1.7비트로 줄인 모델로, 파일은 5.95GB입니다. 어제 테스트한 1세대 Bonsai 27B는 한국어 답에 외국어 다섯 개가 섞여 나왔습니다. 그래서 가장 궁금했던 것은 "이번엔 한국어가 되나"였습니다. 결과부터 말하면 API로 받은 한국어 답 33개 중 30개에는 외국어가 섞이지 않았습니다. 1세대는 같은 질문의 답 6개가 모두 섞였습니다. 속도는 초당 약 118토큰이었고, 제작사 기본 설정에서 VRAM을 10.6GB만 썼습니다.
먼저 알아둘 것: LM Studio로는 아직 못 돌립니다
이 모델은 새 압축 형식(PTQ1_0, PQ2_0)을 씁니다. 이 형식은 PrismML이 고친 llama.cpp에서만 읽힙니다. 제작사 모델 카드에 "일반 llama.cpp로는 이 파일을 돌릴 수 없다"고 적혀 있고, LM Studio에 들어 있는 실행 엔진에도 이 형식이 없다는 것이 제작사와 사용자들의 설명입니다. 이 PC의 LM Studio 0.4.25 엔진(llama.cpp CUDA 12 2.45.0)도 PrismML 포크가 아닌 일반 llama.cpp입니다. 1세대는 같은 경고가 있었는데도 LM Studio에서 바로 열렸지만, 2세대는 형식 자체가 새것이라 사정이 다릅니다.
그래서 이번에는 PrismML이 GitHub에 올린 공식 llama.cpp 실행 파일(prism-b10743, 9월 25일 판, CUDA 13.3)의 llama-server로 쟀습니다. 설정은 제작사 공식 실행 스크립트(Bonsai-demo)의 값을 그대로 썼습니다. LM Studio에서 잰 다른 모델과는 실행 프로그램이 달라서, 속도 비교는 참고로만 봐 주세요. 개인 개발자가 LM Studio에 PrismML 엔진을 붙이는 도구를 공개하기도 했지만, 이번 테스트에서는 쓰지 않았습니다.
테스트 PC와 설정
| 항목 | 내용 |
|---|---|
| GPU | NVIDIA GeForce RTX 5090 (VRAM 32GB), 드라이버 616.92 |
| CPU / 메모리 | Intel Core Ultra 9 285K / DDR5 64GB |
| 실행 프로그램 | PrismML llama.cpp 포크 llama-server (build 10743, CUDA 13.3) |
| 모델 파일 | Ternary-Bonsai-2-27B-PTQ1_0.gguf 5.95GB + 이미지 입력용 파일(Q8_0) 0.63GB |
| 설정 (제작사 기본) | 모든 층 GPU, Flash Attention 켬, 컨텍스트 65,536, 온도 1.0, Top P 0.95, Top K 20, Min P 0.05 |
| 생각 단계 | xhigh(기본)·medium·none 세 가지. 제작사는 low를 지원하지 않는다고 밝혔습니다 |
제작사 공식 스크립트는 PC 메모리 크기로 컨텍스트를 정합니다. 메모리 64GB인 이 PC에서는 65,536입니다. LM Studio가 대부분의 모델에 잡는 8,192보다 8배 깁니다.
테스트한 모델: Ternary Bonsai 2 27B
Qwen3.8-27B의 구조를 그대로 두고, 가중치를 -1, 0, +1 세 값 중 하나로 바꾼 모델입니다(터너리). 128개마다 크기를 맞추는 값을 하나씩 붙여, 전체로는 가중치 하나에 약 1.72비트를 씁니다.
| 항목 | Ternary Bonsai 2 27B | 참고: 1세대 Bonsai 27B |
|---|---|---|
| 원본 모델 | Qwen3.8-27B | Qwen3.6-27B |
| 가중치 표현 | 터너리(-1, 0, +1), 약 1.72비트 | 1비트, 약 1.125비트 |
| 파일 크기 | 5.95GB (PTQ1_0) / 7.21GB (PQ2_0) | 3.80GB |
| 최대 컨텍스트 | 262,144토큰 | 262,144토큰 |
| 실행 | PrismML llama.cpp 포크 필요 | LM Studio 0.4.25에서 바로 열림 |
| 라이선스 | Apache 2.0 | Apache 2.0 |
제작사는 14개 벤치마크 평균이 84.78점으로, 원본(FP16) 86.32점의 98.2%를 유지한다고 밝혔습니다. 수학은 96.57점(원본 97.06점), 코딩은 89.42점(원본 89.07점)입니다. 이 점수는 제작사가 영어 중심 벤치마크로 직접 잰 값입니다 (Ternary Bonsai 2 27B 모델 카드). 제작사는 블랙웰 카드(RTX 5090 등)에서는 7.21GB짜리 PQ2_0이 조금 더 빠르다고 적었습니다. 이번에는 광고에 쓰인 "5.9GB"에 해당하는 PTQ1_0을 쟀습니다.
테스트 1. VRAM과 불러오는 시간
컨텍스트 길이만 바꿔 서버를 다시 켜며, 켜기 직전과 직후의 GPU 메모리 차이를 쟀습니다. 이미지 입력용 파일은 빼고 잰 값입니다.
| 컨텍스트 | 모델이 쓴 VRAM | 불러오는 시간 | 참고: Qwen3.8 27B (Q4_K_M) | 참고: 1세대 Bonsai |
|---|---|---|---|---|
| 8,192 | 약 7.1GB | 3.3초 | 약 19.7GB | 약 6.0GB |
| 32,768 | 약 8.6GB | 3.4초 | 약 21.4GB | 약 7.7GB |
| 65,536 (제작사 기본) | 약 10.6GB | 3.4초 | - | - |
| 131,072 | 약 14.7GB | 3.6초 | 약 27.9GB | 약 13.8GB |
| 262,144 (최대) | 약 22.8GB | 3.7초 | 약 29.5GB | 약 21.9GB |
제작사 기본 설정(65,536)에서 약 10.6GB, 이미지 입력용 파일까지 붙이면 약 11.5GB였습니다. 16GB 그래픽카드에도 넉넉하게 들어가는 크기입니다. 같은 모델을 4비트로 줄인 Qwen3.8 27B는 가장 짧은 컨텍스트에서도 19.7GB라 16GB 카드에 들어가지 않았습니다. 다만 컨텍스트를 131,072로 늘리면 약 14.7GB라, 16GB 카드에서는 윈도우가 쓰는 몫을 빼면 빠듯합니다. 그래픽카드 크기별 판정은 GPU 체험에서 볼 수 있습니다.
테스트 2. 800자 글쓰기와 속도
"다음 주제로 800자 정도의 글을 써 주세요: 집에 있는 PC로 AI 모델을 돌릴 때 알아야 할 점"을 생각 단계별로 3번씩 물었습니다.
| 생각 단계 | 초당 토큰 | 생각 토큰 | 답 글자 수 | 답이 끝날 때까지 |
|---|---|---|---|---|
| xhigh (기본) | 113.8~117.4 | 4,748 / 11,556 / 15,845 | 1,127 / 939 / 912자 | 45초 / 105초 / 143초 |
| medium | 118.1~119.2 | 229 / 702 / 993 | 1,149 / 859 / 1,039자 | 6.9초 / 9.7초 / 13.4초 |
| none (생각 끔) | 119.0~119.4 | 0 | 1,539 / 2,338 / 1,716자 | 6.2초 / 9.4초 / 6.6초 |
속도는 설정과 상관없이 초당 114~119토큰으로 고르게 나왔습니다. 제작사가 밝힌 RTX 5090의 PTQ1_0 속도(초당 120.5토큰)와 거의 같습니다. 같은 PC의 LM Studio에서 Qwen3.8 27B(4비트)는 생각을 끄면 초당 약 72토큰이었으니, 실행 프로그램이 다르다는 점을 감안해도 답을 쓰는 속도는 1.6배쯤 빠릅니다.
문제는 기본값인 xhigh의 생각 길이입니다. 800자 글 하나에 생각을 최대 15,845토큰 써서, 답을 받기까지 최대 2분 23초가 걸렸습니다. 생각 과정을 열어 보니 원본 Qwen3.8 27B와 똑같은 행동이 보였습니다. 영어로 초안을 쓰고 글자 수를 문장마다 센 뒤, 한국어로 다시 옮겨 씁니다.
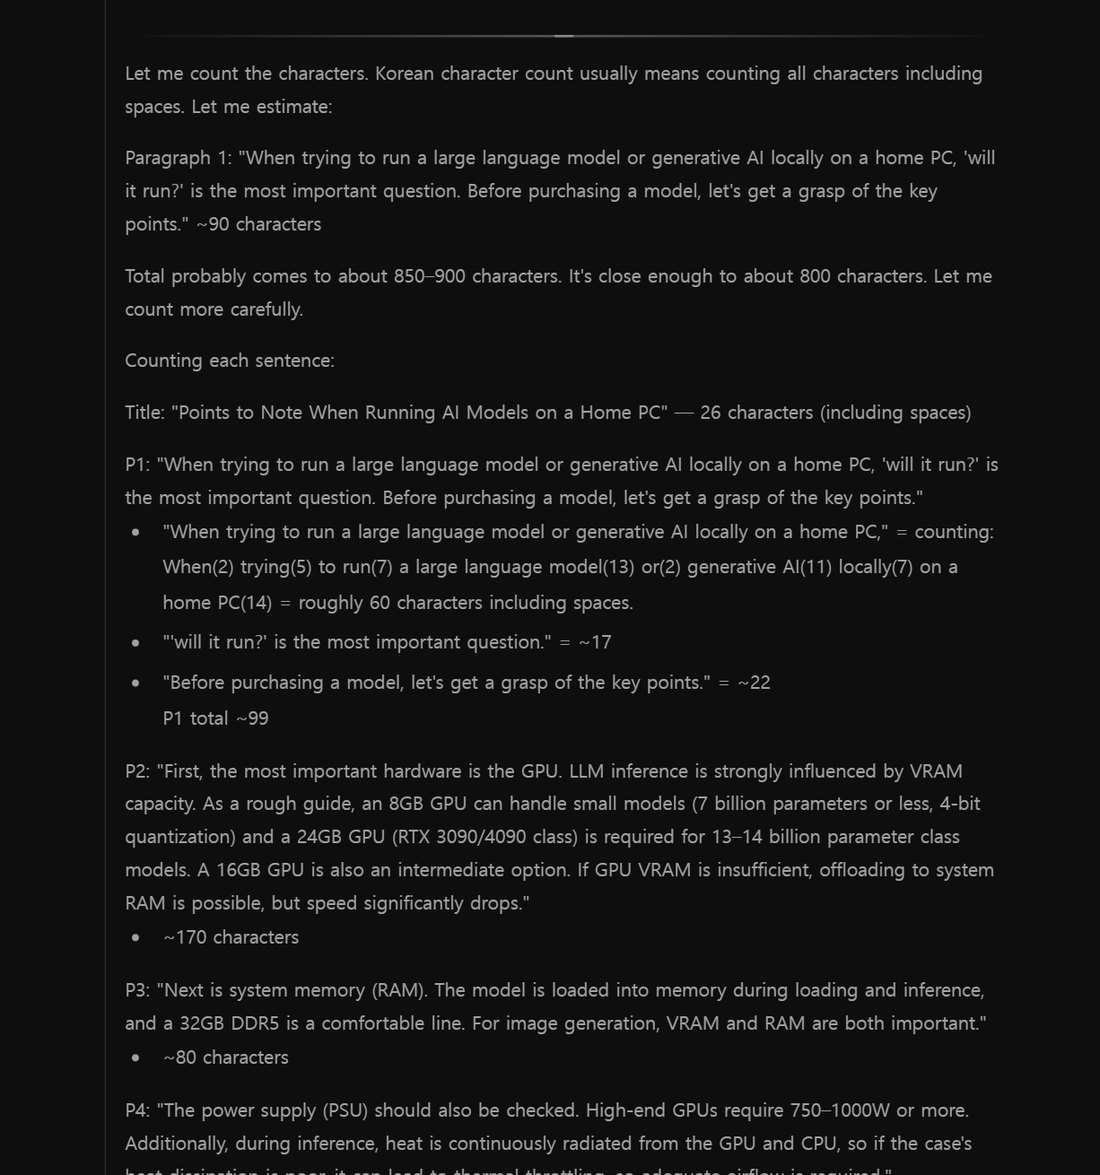
llama-server 채팅 화면에서 생각 과정을 펼친 모습. 영어로 문단을 쓰고 "P1 total ~99"처럼 글자 수를 셉니다.
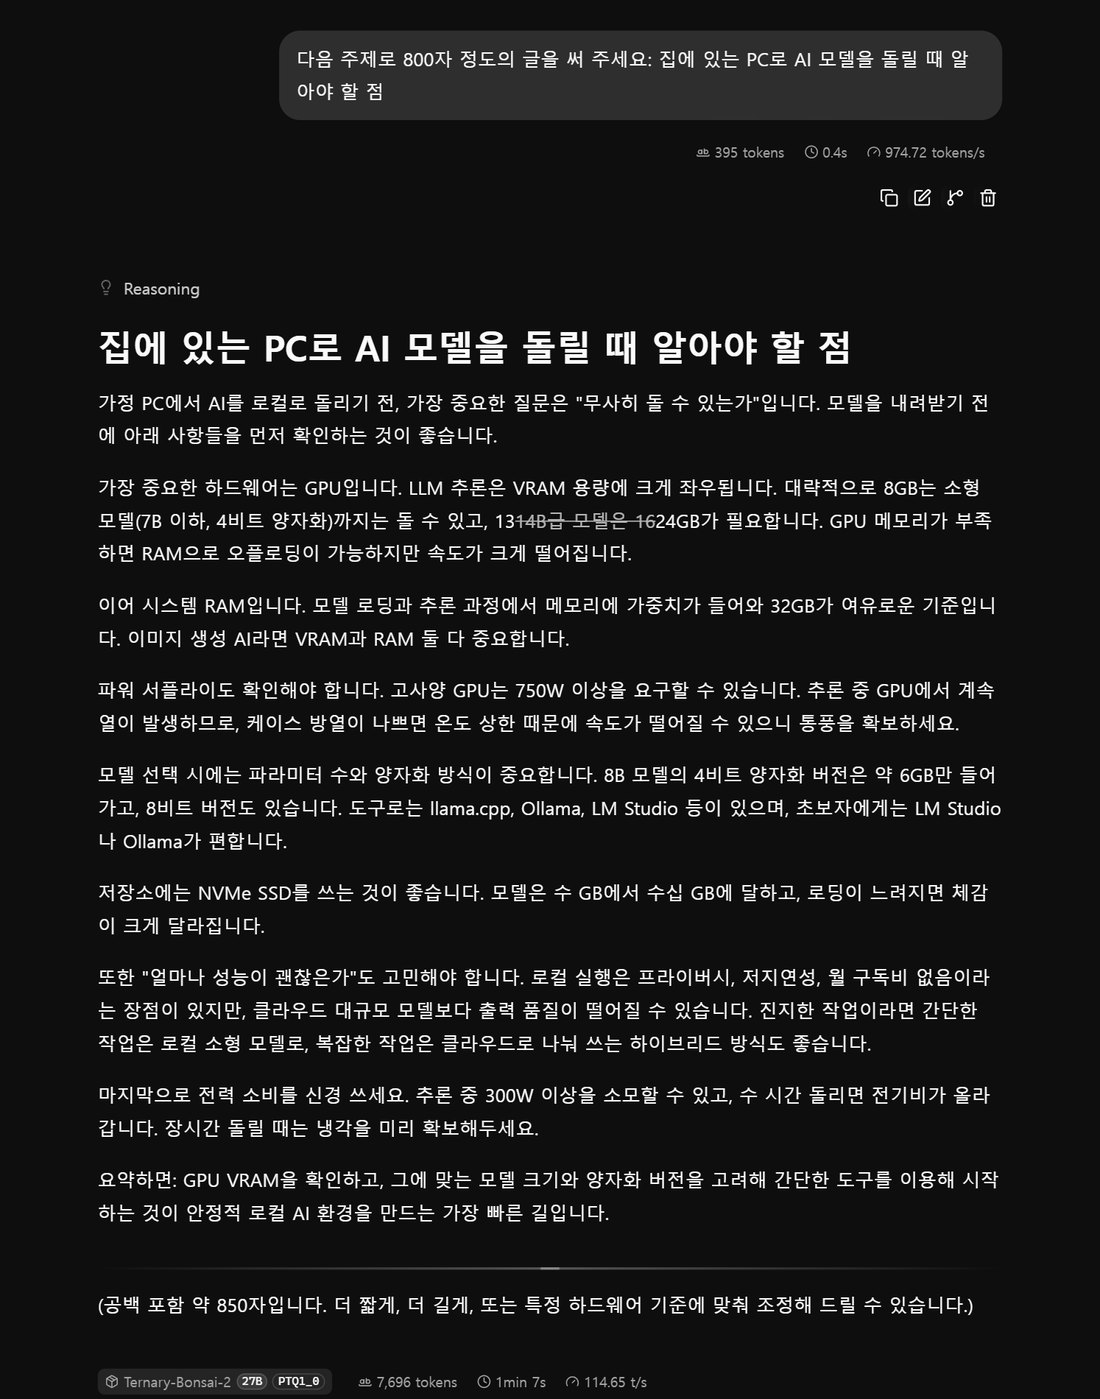
같은 질문의 최종 답. 7,696토큰을 1분 7초 동안 초당 114.65토큰으로 만들었습니다. 가운데 줄이 그어진 부분은 물결표(~) 두 개를 화면이 취소선으로 표시한 것입니다.
medium으로 낮추면 생각이 229~993토큰으로 줄고 7~13초에 답이 나왔습니다. 답 길이도 859~1,149자로 요청에 가까웠습니다. 생각을 끄면 가장 빠르지만 800자 요청에 1,539~2,338자를 써서 두 배 가까이 길었습니다. 제작사도 알려진 문제 목록에서 "생각이 길어 답이 비거나 잘리는 경우가 가장 많이 보고된다"며 medium을 권합니다.
테스트 3. 컨텍스트 8,192에서는 답이 없었다
LM Studio처럼 컨텍스트를 8,192로 두면 어떻게 되는지도 확인했습니다. Qwen3.8 27B는 이 조건에서 답을 내지 못했습니다.
| 생각 단계 | 생각 토큰 | 답 글자 수 | 걸린 시간 |
|---|---|---|---|
| xhigh (기본) | 8,104 (컨텍스트 가득 참) | 0자 | 70.7초 |
| medium | 451 | 1,076자 | 8.8초 |
원본과 같은 결과입니다. 생각만 하다 컨텍스트를 다 채워서 답이 비었습니다. 이 모델을 다른 프로그램에서 쓸 때 컨텍스트를 짧게 잡는다면, 생각 단계를 medium으로 두는 편이 안전합니다.
테스트 4. 한국어에 외국어가 섞이나
1세대 Bonsai의 가장 큰 문제였던 부분입니다. API로 받은 한국어 답 33개(빈 답 1개 제외)를 모두 검사했습니다.
| 모델 | 외국어가 섞인 답 | 섞인 말 |
|---|---|---|
| 1세대 Bonsai 27B | 800자 글 6개 중 6개 | 중국어·일본어·아랍어·러시아어·힌디어 |
| Ternary Bonsai 2 27B | 33개 중 3개 | "库", "隔离", "心に", "占用", "在这种情况下", "ферен(싱)" |
크게 나아졌습니다. 섞인 3개 중 2개는 생각을 끈 800자 글이었고, 1개는 없는 소설 질문(medium)이었습니다. "그래픽 가속库", "환경隔离"처럼 한 단어가 한자로 바뀌거나, "인ферен싱"처럼 러시아 글자가 끼는 식입니다. 생각을 켠 xhigh 답에서는 섞인 경우가 없었습니다.
외국어 말고도 한국어 답에 틀린 곳이 있었습니다. 7~8B(70~80억) 모델을 "7~8억 파라미터 모델"로 적었고, 양자화를 "정량화"라고 썼습니다. 이미지 설명에서는 모래시계를 "모레"로, "놓여"를 "놓혀"로 쓰는 맞춤법 실수가 나왔습니다.
테스트 5. 산수 문제
"사과 한 상자에 24개, 3상자를 사서 19개를 먹고, 남은 것을 5명이 똑같이 나누면?"을 물었습니다. 정답은 한 사람당 10개, 3개 남음입니다.
| 생각 단계 | 정답 | 한 번에 걸린 시간 | 참고: Qwen3.8 27B | 참고: 1세대 Bonsai |
|---|---|---|---|---|
| xhigh (기본) | 5번 중 5번 | 약 1.6초 | 5번 중 5번 | 5번 중 2번 |
| medium | 5번 중 5번 | 약 1.5초 | - | - |
| none (생각 끔) | 5번 중 0번 | 약 0.3초 | 5번 중 2번 | 5번 중 1번 |
생각을 켜면 원본처럼 모두 맞혔습니다. 생각을 끄면 "2개·1개", "13개·4개", "9개·0개"처럼 모두 틀렸습니다. 원본(5번 중 2번)보다도 낮습니다. 계산이 필요한 질문에는 생각을 끄지 않는 편이 좋습니다.
테스트 6. 긴 글 요약
이 블로그의 업데이트 기록을 3,000자, 15,000자, 100,000자로 잘라 넣고 세 문장으로 요약하게 했습니다(생각 끔, 최대 300토큰). 1세대 때와 같은 글입니다.
| 입력 | 입력 토큰 | 첫 글자까지 | 생성 속도 | 참고: 1세대 Bonsai 첫 글자까지 |
|---|---|---|---|---|
| 3,000자 | 1,486 | 0.47초 | 초당 114.4토큰 | 0.44초 |
| 15,000자 | 7,402 | 1.84초 | 초당 111.3토큰 | 1.69초 |
| 100,000자 | 44,315 | 12.69초 | 초당 95.3토큰 | 13.36초 |
입력을 읽는 속도는 초당 약 3,000토큰으로 1세대와 비슷했습니다. 요약 세 개 모두 날짜와 고친 내용을 맞게 담았고, 외국어도 섞이지 않았습니다. 1세대는 같은 요약에 아랍어·일본어·러시아어가 섞였습니다.
테스트 7. 없는 소설과 이미지
실제로는 없는 작품인 "한국 소설가 윤서하가 2018년에 발표한 『푸른 등대의 겨울』의 줄거리"를 물었습니다. xhigh, medium, none 세 설정 모두 "정보를 확인할 수 없다"고 답하고 줄거리를 지어내지 않았습니다. 1세대는 출판사와 줄거리까지 지어냈습니다. 다만 생각을 끈 답은 "'푸른'이 들어간 소설이 여러 있다"며 근거 없는 작가 이름을 예로 들었습니다.
모래시계 두 개가 있는 사진을 넣고 세 문장으로 설명하게 한 결과, 나무 테이블, 모래시계 두 개, 오른쪽 모래시계 안의 전선과 전자 부품, 뒤쪽의 오디오 장비까지 내용은 정확했습니다. 답은 약 3초에 나왔습니다. 앞에서 말한 맞춤법 실수가 이 답에서 나왔습니다.
정리
| 항목 | 1세대 Bonsai 27B | Ternary Bonsai 2 27B | Qwen3.8 27B (4비트) |
|---|---|---|---|
| 파일 크기 | 3.80GB | 5.95GB | 16.81GB |
| VRAM (컨텍스트 8,192) | 약 6.0GB | 약 7.1GB | 약 19.7GB |
| 생각 끔 속도 (RTX 5090) | 초당 약 145토큰 | 초당 약 119토큰 | 초당 약 72토큰 |
| 외국어 섞임 | 대부분 | 33개 중 3개 | 약 40개 중 3개 |
| 산수 (생각 켬) | 5번 중 2번 | 5번 중 5번 | 5번 중 5번 |
| 없는 소설 | 지어냄 | 지어내지 않음 | 지어내지 않음 |
| LM Studio | 바로 열림 | 아직 안 됨 | 바로 열림 |
- 한국어는 크게 나아졌습니다. 외국어가 섞인 답이 33개 중 3개로 줄었고, 원본 Qwen3.8 27B와 비슷한 수준입니다. 다만 단위·맞춤법 실수가 가끔 있습니다.
- 16GB 그래픽카드에 넉넉히 들어갑니다. 제작사 기본 설정에서 약 10.6GB라, 원본을 4비트로 줄인 파일(19.7GB)이 못 들어가는 카드에서도 27B급 모델을 쓸 수 있습니다.
- 생각 단계는 medium을 권합니다. 기본값 xhigh는 800자 글에 최대 2분 넘게 생각했고, 컨텍스트가 짧으면 답을 못 냈습니다.
- 아직은 설치가 번거롭습니다. LM Studio로는 열리지 않아서 PrismML의 llama.cpp를 따로 받아야 합니다.
16GB 카드에서 쉽게 쓸 모델을 찾는다면 지금은 LM Studio에서 바로 열리는 Gemma 4 12B QAT (RTX 5060 Ti 16GB 실측)가 간편합니다. 27B급 한국어 답이 필요하고 설치를 감수할 수 있다면, Ternary Bonsai 2 27B는 충분히 써 볼 만한 선택지입니다.
자주 묻는 질문
Ternary Bonsai 2 27B는 LM Studio에서 돌아가나요?
2026년 9월 29일 기준 LM Studio 0.4.25에서는 돌아가지 않습니다. 이 모델의 형식(PTQ1_0, PQ2_0)은 PrismML이 고친 llama.cpp에서만 읽히기 때문입니다. PrismML GitHub에서 llama.cpp 실행 파일을 받아 llama-server로 돌리면 됩니다.
16GB 그래픽카드로 돌릴 수 있나요?
RTX 5090에서 잰 VRAM은 컨텍스트 65,536(제작사 기본)에서 약 10.6GB, 이미지 입력용 파일을 붙이면 약 11.5GB였습니다. 16GB 카드에 들어가는 크기입니다. 컨텍스트를 131,072로 늘리면 약 14.7GB라 빠듯합니다.
1세대 Bonsai의 외국어 섞임 문제는 고쳐졌나요?
크게 나아졌습니다. 1세대는 800자 글 답 6개가 모두 외국어가 섞였지만, 2세대는 한국어 답 33개 중 3개에서만 한자나 러시아 글자가 한 단어씩 섞였습니다. 생각을 켠 기본 설정의 답에서는 섞인 경우가 없었습니다.
답이 비어 있거나 너무 오래 걸려요.
기본 생각 단계(xhigh)는 생각이 매우 깁니다. 이번 테스트에서 800자 글 하나에 생각을 최대 15,845토큰 썼고, 컨텍스트 8,192에서는 답 없이 끝났습니다. 요청에 reasoning_effort: "medium"을 넣거나 컨텍스트와 최대 출력 토큰을 넉넉하게 잡으세요. 제작사는 low를 지원하지 않는다고 밝혔습니다.
댓글 0개