[RTX 5060 Ti 16GB] Qwen3.8 27B를 7.9GB로 줄인 Saluki 27B, 16GB에서 쓸 만할까, 초당 34토큰이고 생각 단계는 꼭 정해야 했다
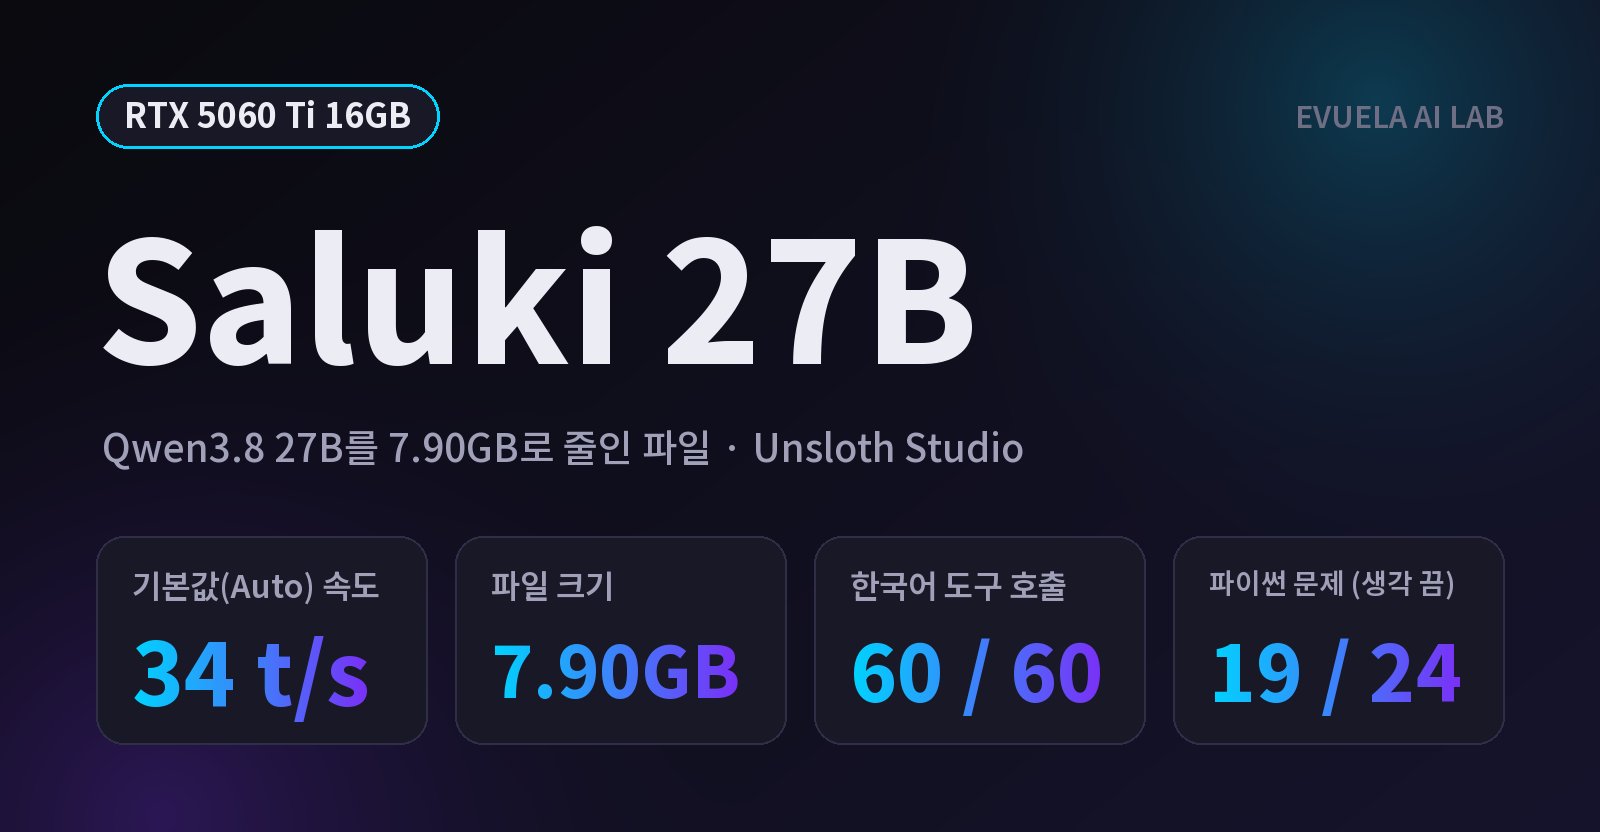
Qwen3.8 27B를 7.90GB로 줄인 Saluki 27B를 RTX 5060 Ti 16GB의 Unsloth Studio에서 쟀습니다. 기본값 초당 34토큰, 한국어 도구 호출 60번 모두 정답이었고, 생각 단계를 정하지 않으면 15번 중 6번은 답이 나오지 않았습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"Ternary Bonsai 2 27B" 검색 결과 6건
Qwen3.8 27B를 7.90GB로 줄인 Saluki 27B를 RTX 5060 Ti 16GB의 Unsloth Studio에서 쟀습니다. 기본값 초당 34토큰, 한국어 도구 호출 60번 모두 정답이었고, 생각 단계를 정하지 않으면 15번 중 6번은 답이 나오지 않았습니다.
모델을 고르는 순서를 VRAM, 컨텍스트, 쓰임새 세 가지로 정리했습니다. RTX 5060 Ti 16GB와 RTX 5090 32GB에서 잰 측정 16건의 파일 크기와 VRAM을 한 표에 모았고, 컨텍스트를 늘리면 VRAM과 속도가 어떻게 바뀌는지도 담았습니다.
RTX 5060 Ti 16GB에 로컬 음성 AI VoiceStudio 0.5.6을 직접 설치해 한국어로 써 봤습니다. 기본 엔진 OmniVoice는 50초 음성을 약 11초에 만들었고 VRAM은 3.5GB 안쪽, 더 사람 같았던 VoxCPM2는 2분 넘게 걸렸습니다.
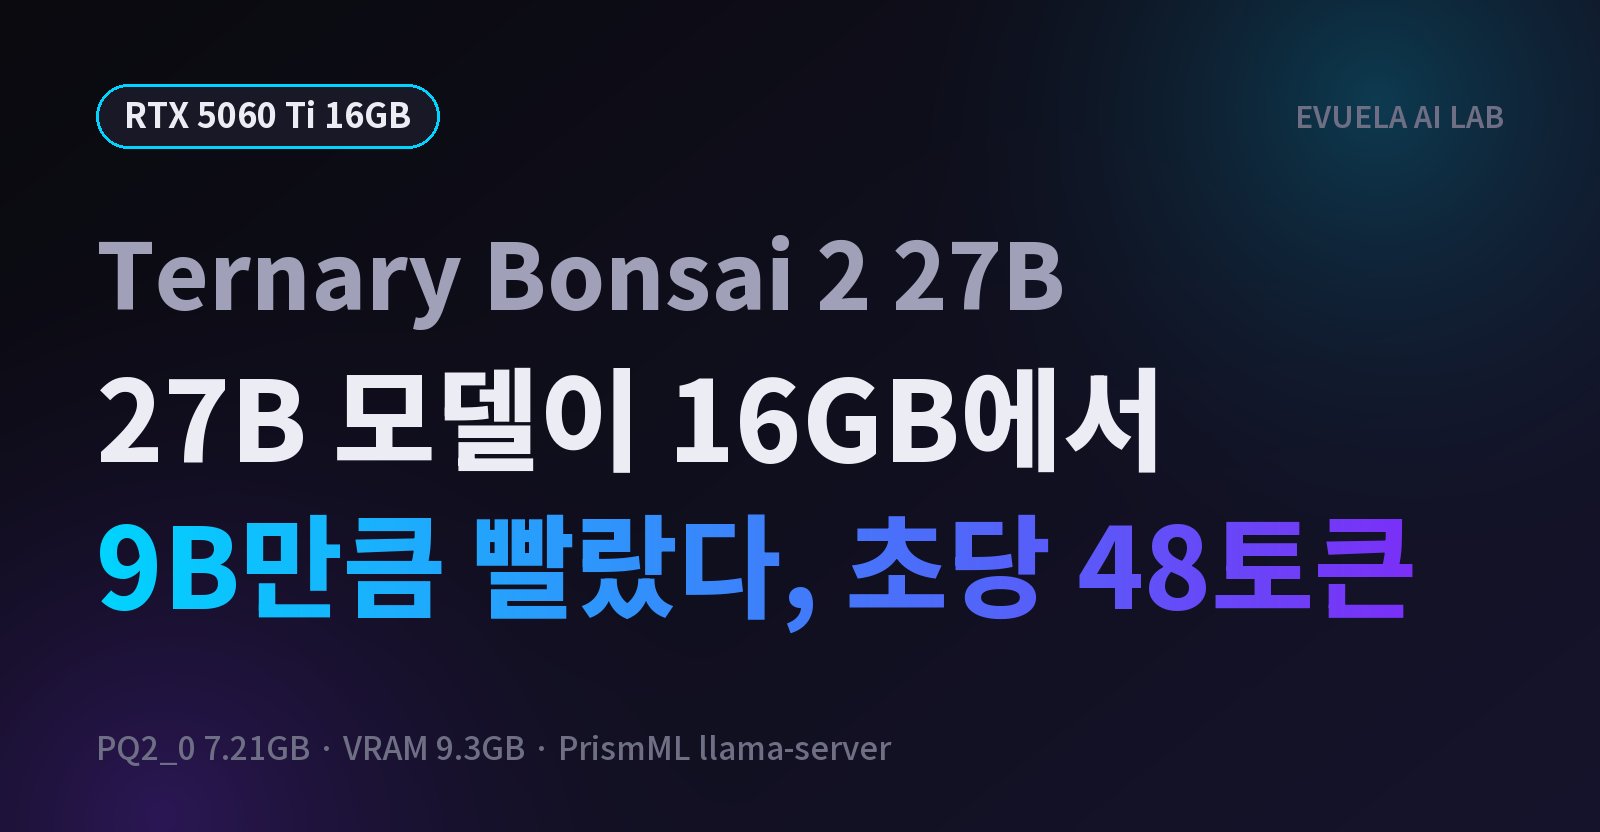
RTX 5060 Ti 16GB에서 Ternary Bonsai 2 27B(PQ2_0)를 PrismML llama-server로 재 봤습니다. VRAM 9.3GB, 생성 속도 약 48t/s였고, 기본 생각 단계 xhigh는 800자 글에 4~7분, medium은 14~21초였습니다.
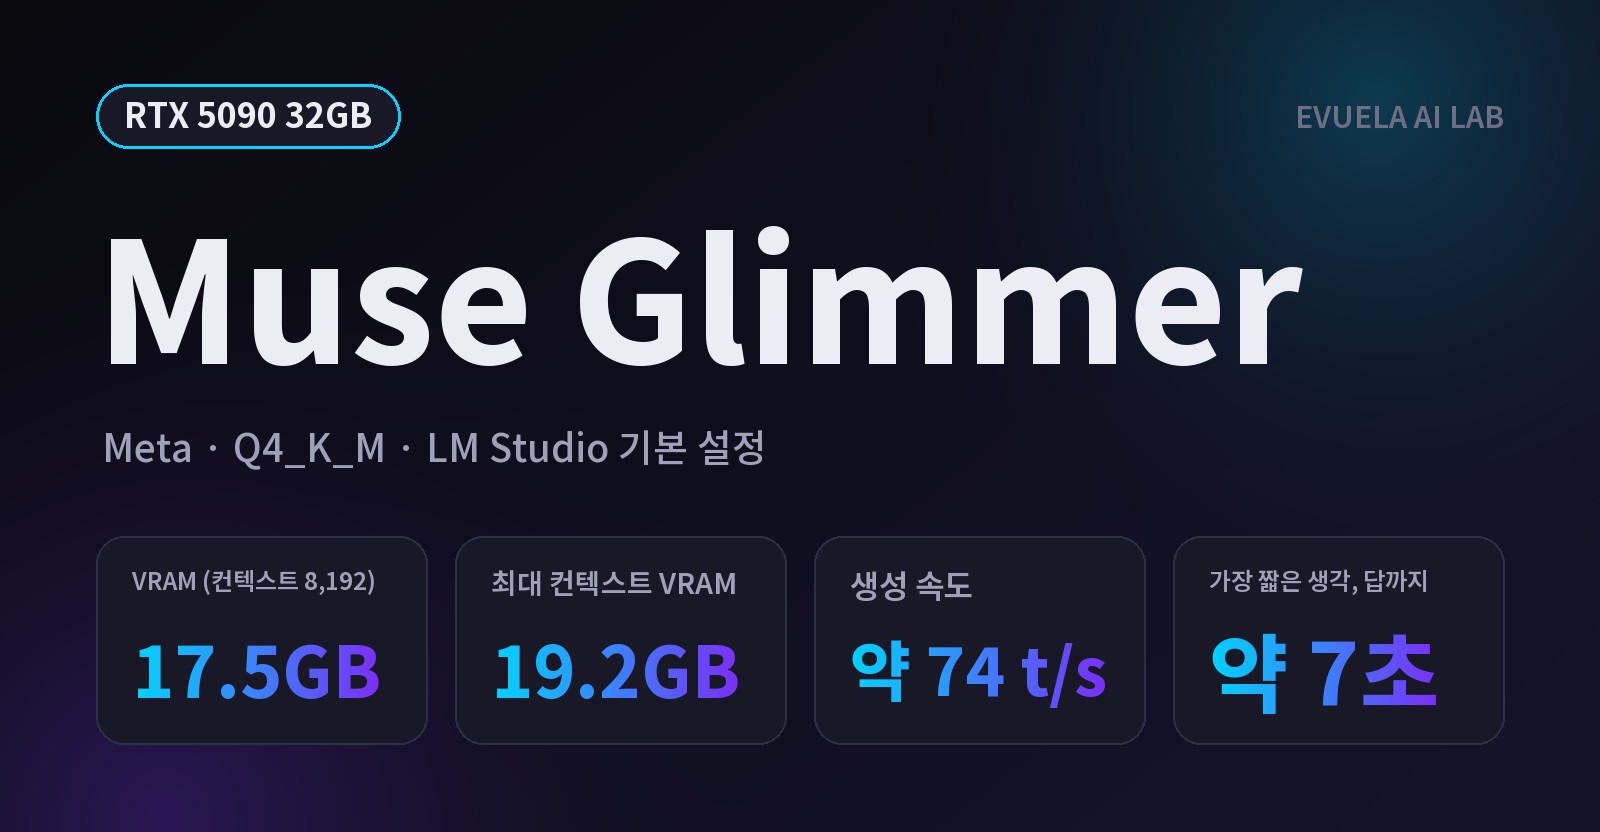
Meta가 공개한 약 300억 파라미터 모델 Muse Glimmer를 RTX 5090의 LM Studio 기본 설정으로 재 봤습니다. 컨텍스트를 16배 늘려도 VRAM은 17.5GB에서 19.2GB로 1.7GB만 늘었고, 기본 설정에서 27번 모두 답했습니다. 속도, 생각 단계, 한국어 품질, 이미지 입력까지 정리했습니다.
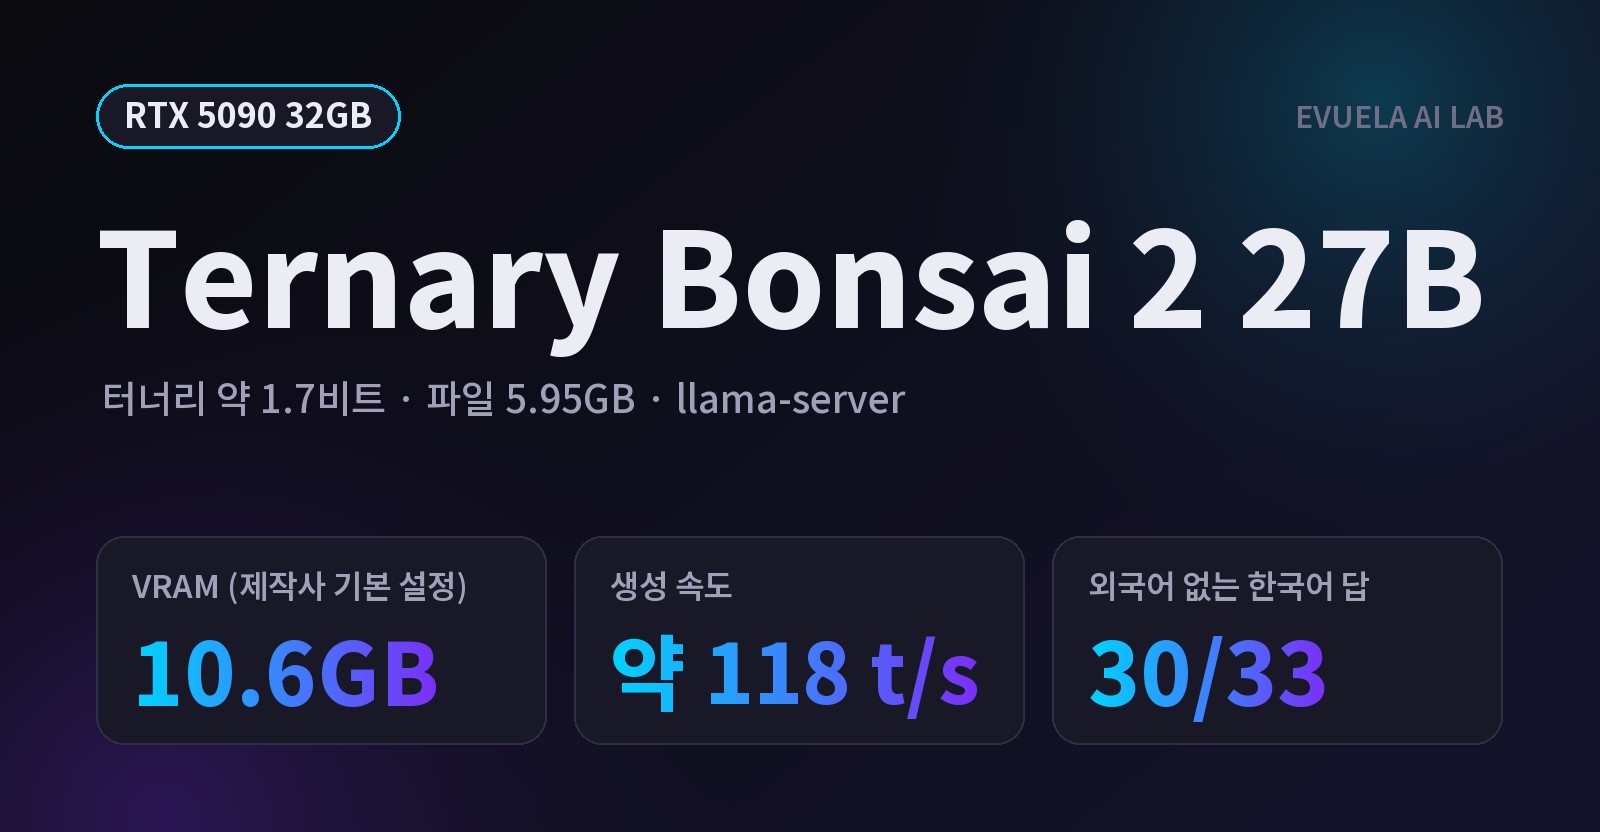
Qwen3.8 27B를 약 1.7비트로 줄인 PrismML Ternary Bonsai 2 27B(5.95GB)를 RTX 5090에서 재 봤습니다. LM Studio로는 아직 열리지 않아 제작사 llama.cpp로 돌렸고, 한국어 답 33개 중 30개에 외국어가 섞이지 않았습니다. VRAM 10.6GB, 약 118 t/s(초당 토큰 수), 생각 단계별 결과를 정리했습니다.