모델을 고를 때는 세 가지를 순서대로 봅니다. 파일이 VRAM에 들어가는지, 얼마나 긴 글을 넣을 것인지, 무엇에 쓸 것인지입니다. RTX 5060 Ti 16GB에서 직접 재 보니 Gemma 4 12B는 VRAM 8.6GB, Qwen3.6 35B A3B의 3비트 파일은 13.2GB를 썼고 둘 다 VRAM에 다 들어갔습니다. 이 글은 로컬 AI 시작하기 가이드의 4편입니다.
- 첫째, VRAM: 파일 크기에 2~3GB를 더한 값이 내 VRAM보다 작은 파일을 고릅니다.
- 둘째, 컨텍스트: 긴 글을 넣으려면 VRAM이 더 필요합니다. 빠듯한 모델은 컨텍스트를 늘리면 느려집니다.
- 셋째, 쓰임새: 일상 대화, 코딩, 긴 문서에 맞는 모델이 다릅니다.
- 16GB라면: 처음에는 Gemma 4 12B, 더 큰 모델은 Qwen3.6 35B A3B, 코딩은 Qwen3-Coder 30B A3B가 맞았습니다.
- 8GB, 12GB, 24GB: 직접 재지 못했습니다. 16GB와 32GB에서 잰 VRAM 값으로 가늠한 것을 따로 적었습니다.
이 글의 VRAM과 속도는 모두 테스트 PC 두 대(RTX 5060 Ti 16GB, RTX 5090 32GB)에서 직접 잰 값이고, 표는 측정 파일에서 그대로 만들었습니다. 재지 않은 그래픽카드에 대한 내용은 "가늠"이라고 밝혔습니다.
이 글의 내용을 20초로 요약한 영상입니다(소리 없음).
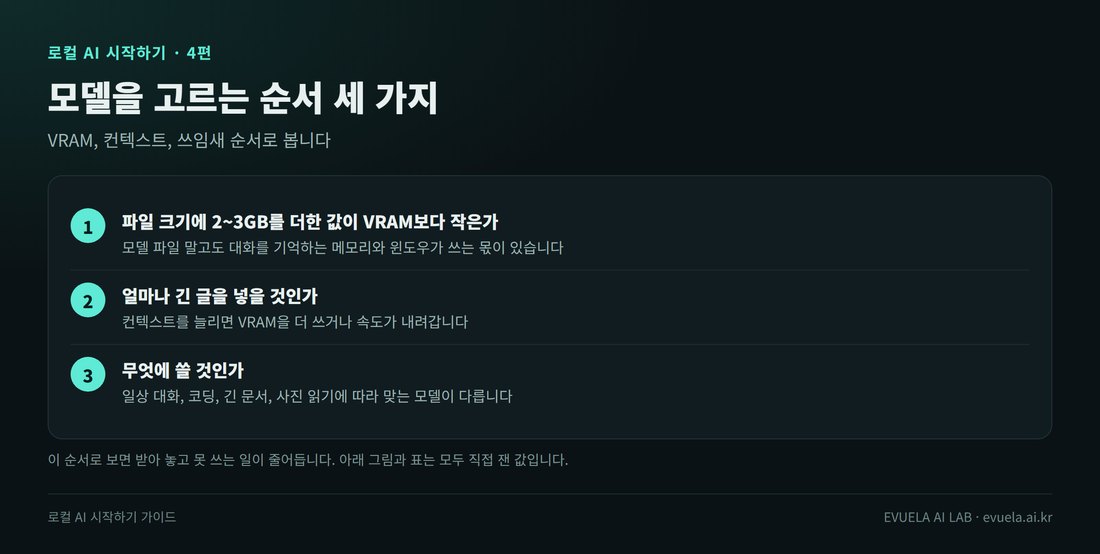
VRAM, 컨텍스트, 쓰임새 순서로 봅니다.
첫째, 파일이 VRAM에 들어가는가
모델을 올리면 파일 크기보다 VRAM을 조금 더 씁니다. 대화를 기억하는 메모리(KV 캐시)와 계산에 쓰는 공간이 더해지기 때문입니다. 16GB 그래픽카드에서 잰 값입니다.
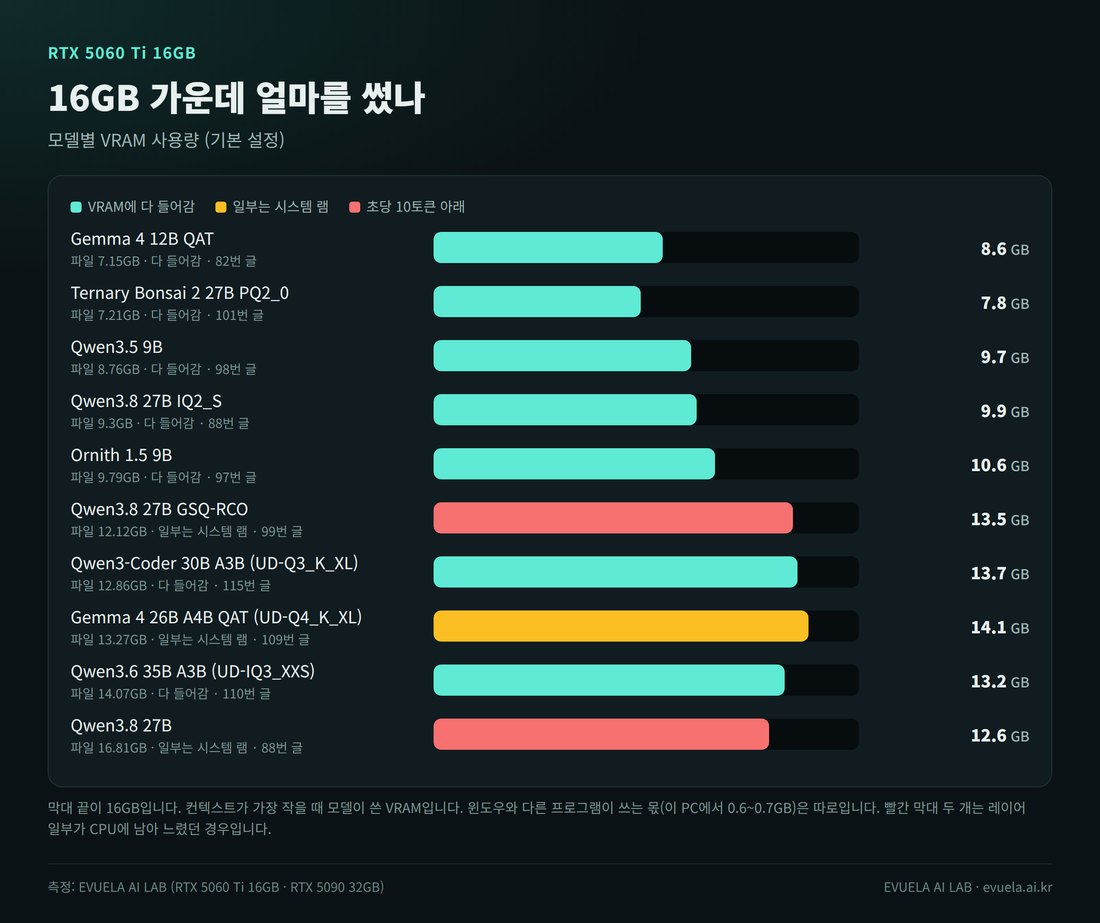
막대 끝이 16GB입니다. 컨텍스트가 가장 작을 때의 값입니다.
| 모델 | 파일 | VRAM | 차이 | VRAM에 다 들어갔나 | 속도 | 프로그램 | 잰 글 |
|---|---|---|---|---|---|---|---|
| Gemma 4 12B QAT | 7.15GB | 8.6GB | +1.4GB | 예 | 44.5 t/s | LM Studio | 82번 |
| Ternary Bonsai 2 27B PQ2_0 | 7.21GB | 7.8GB | +0.6GB | 예 | 48.2 t/s | PrismML llama.cpp | 101번 |
| Qwen3.5 9B | 8.76GB | 9.7GB | +0.9GB | 예 | 46.4 t/s | LM Studio | 98번 |
| Qwen3.8 27B IQ2_S | 9.3GB | 9.9GB | +0.6GB | 예 | 33.5 t/s | LM Studio | 88번 |
| Ornith 1.5 9B | 9.79GB | 10.6GB | +0.8GB | 예 | 49.7 t/s | LM Studio | 97번 |
| Qwen3.8 27B GSQ-RCO | 12.12GB | 13.5GB | +1.4GB | 일부는 시스템 램 | 1.9 t/s | LM Studio | 99번 |
| Qwen3-Coder 30B A3B (UD-Q3_K_XL) | 12.86GB | 13.7GB | +0.8GB | 예 | 140.5 t/s | Unsloth Studio | 115번 |
| Gemma 4 26B A4B QAT (UD-Q4_K_XL) | 13.27GB | 14.1GB | +0.8GB | 일부는 시스템 램 | 94 t/s | Unsloth Studio | 109번 |
| Qwen3.6 35B A3B (UD-IQ3_XXS) | 14.07GB | 13.2GB | -0.9GB | 예 | 90.8 t/s | Unsloth Studio | 110번 |
| Qwen3.8 27B | 16.81GB | 12.6GB | -4.2GB | 일부는 시스템 램 | 2.2 t/s | LM Studio | 88번 |
이 표가 뜻하는 것: VRAM에 다 들어간 모델은 대체로 파일 크기보다 0.6~1.4GB를 더 썼습니다. 여기에 윈도우와 다른 프로그램이 쓰는 몫이 더해집니다. 그래서 파일 크기에 2~3GB를 더한 값이 VRAM보다 작으면 무난합니다. 16GB라면 파일 13GB 안팎까지입니다.
표에서 조심해서 볼 줄이 세 개 있습니다.
- Qwen3.6 35B A3B는 VRAM이 파일보다 작습니다. 파일 크기에 이미지 입력용 파일(0.9GB)이 들어 있는데, 기본값에서는 이 파일을 CPU 쪽에 두기 때문입니다.
- Qwen3.8 27B(16.81GB)는 VRAM이 12.6GB뿐입니다. 모델의 일부만 그래픽카드에 올라갔다는 뜻이고, 그래서 초당 2.2토큰이었습니다.
- Qwen3.8 27B GSQ-RCO는 파일이 12.12GB로 작은데도 1.9토큰이었습니다. 기본 설정이 레이어 일부를 CPU에 남겼기 때문입니다. 설정을 바꾸자 약 29토큰이 됐습니다(99번 글). 6편에서 다룹니다.
32GB에서 잰 값
| 모델 | 파일 | VRAM | 차이 | VRAM에 다 들어갔나 | 속도 | 프로그램 | 잰 글 |
|---|---|---|---|---|---|---|---|
| Bonsai 27B | 3.8GB | 6GB | +2.2GB | 예 | 145.3 t/s | LM Studio | 81번 |
| Ternary Bonsai 2 27B | 5.95GB | 7.1GB | +1.1GB | 예 | 119.1 t/s | PrismML llama.cpp | 85번 |
| Gemma 4 12B QAT (UD-Q4_K_XL) | 6.72GB | 10GB | +3.3GB | 예 | 233.5 t/s | Unsloth Studio | 111번 |
| Gemma 4 12B QAT | 7.15GB | 9GB | +1.8GB | 예 | 147 t/s | LM Studio | 80번 |
| Qwen3.8 27B | 16.81GB | 19.7GB | +2.9GB | 예 | 72.6 t/s | LM Studio | 83번 |
| Muse Glimmer | 18.16GB | 17.5GB | -0.7GB | 예 | 74.5 t/s | LM Studio | 86번 |
이 표가 뜻하는 것: 32GB에서는 27B의 4비트 파일(16.81GB)이 VRAM 19.7GB로 다 들어갑니다. VRAM에 다 들어간 모델의 차이는 대체로 +1.1~3.3GB로, 16GB 때(+0.6~1.4GB)보다 컸습니다.
프로그램이 미리 알려 주는 값
Unsloth Studio는 모델을 올리기 전에 예상 메모리를 보여 줍니다. 오른쪽 Run settings의 Estimated Memory Usage입니다.
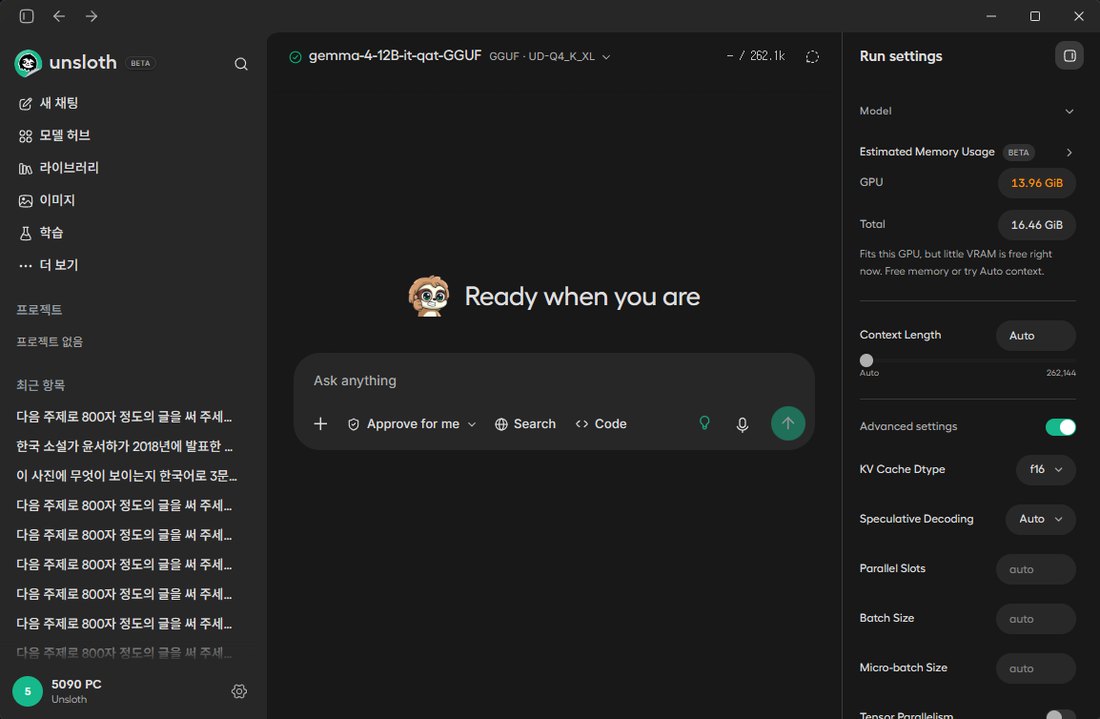
GPU 값이 내 VRAM보다 작은지 봅니다. 아래에 들어가는지 안내 문장도 나옵니다.
이 캡처는 RTX 5090에서 Gemma 4 12B를 기본값(Auto, 컨텍스트 262,144)으로 올린 화면입니다. GPU 13.96GiB가 필요하다고 나옵니다. 이 숫자가 내 VRAM을 넘으면 더 작은 파일을 고르거나 컨텍스트를 줄입니다.
둘째, 얼마나 긴 글을 넣을 것인가
컨텍스트는 모델이 한 번에 기억하는 글의 길이입니다. 질문, 답, 넣은 문서가 모두 여기에 들어갑니다. 컨텍스트를 크게 잡을수록 VRAM을 더 씁니다.
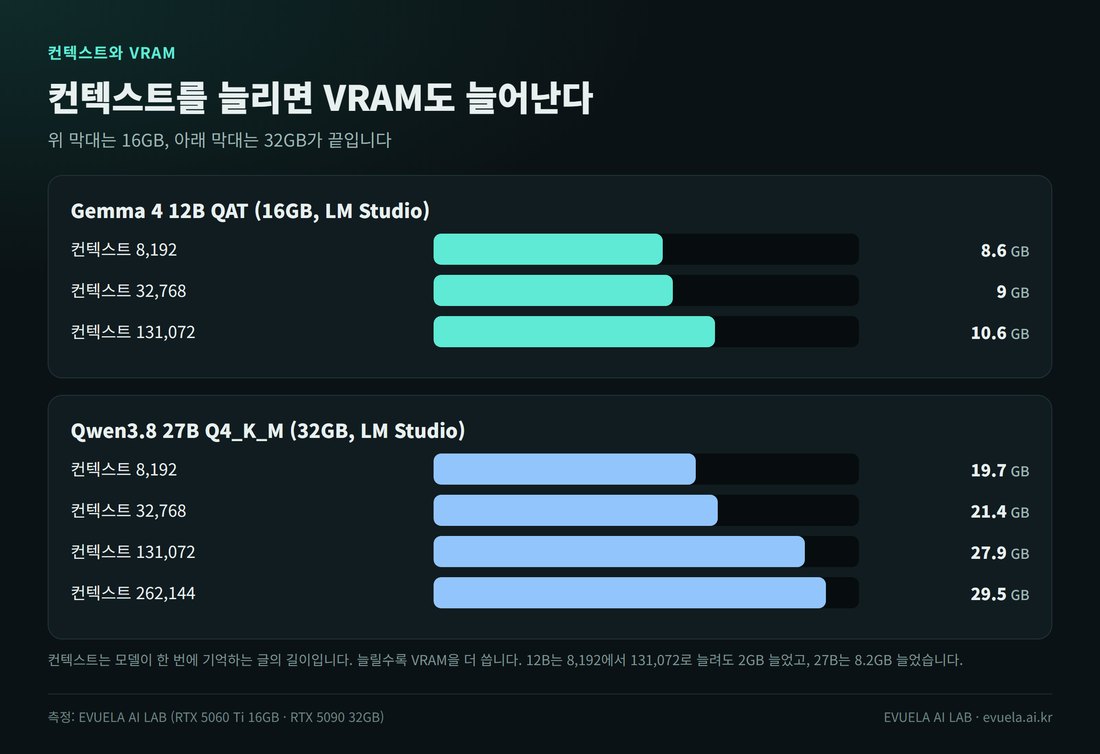
컨텍스트를 늘리면 VRAM이 함께 늘어납니다.
| 모델 | 그래픽카드 | 8K | 32K | 128K | 256K | 잰 글 |
|---|---|---|---|---|---|---|
| Gemma 4 12B QAT | 16GB | 8.6GB | 9GB | 10.6GB | 올리지 못함 | 82번 |
| Qwen3.5 9B | 16GB | 9.7GB | 10.5GB | 13.6GB | 14.7GB | 98번 |
| Ornith 1.5 9B | 16GB | 10.6GB | 11.5GB | 14.8GB | 14.8GB | 97번 |
| Qwen3-Coder 30B A3B (UD-Q3_K_XL) | 16GB | 13.7GB | 13.9GB | 13.9GB | 13.9GB | 115번 |
| Qwen3.6 35B A3B (UD-IQ3_XXS) | 16GB | 13.2GB (9,472) | 13.5GB | 13.6GB | 13.7GB | 110번 |
| Qwen3.8 27B | 32GB | 19.7GB | 21.4GB | 27.9GB | 29.5GB | 83번 |
| Bonsai 27B | 32GB | 6GB | 7.7GB | 13.8GB | 21.9GB | 81번 |
이 표가 뜻하는 것: 컨텍스트를 8K에서 128K로 늘리면 Gemma 4 12B는 2GB, Qwen3.5 9B는 3.9GB, Qwen3.8 27B는 8.2GB가 늘었습니다. 모델마다 늘어나는 폭이 다릅니다. Bonsai 27B는 파일이 3.8GB인데 최대 컨텍스트에서는 21.9GB까지 썼습니다.
VRAM이 빠듯한 모델은 컨텍스트를 늘리면 느려진다
표에서 Qwen3-Coder 30B A3B와 Qwen3.6 35B A3B는 컨텍스트를 늘려도 VRAM이 거의 그대로입니다. VRAM이 이미 꽉 차서, 늘어난 몫이 시스템 램으로 넘어갔기 때문입니다. 올라가기는 하지만 속도가 내려갑니다.
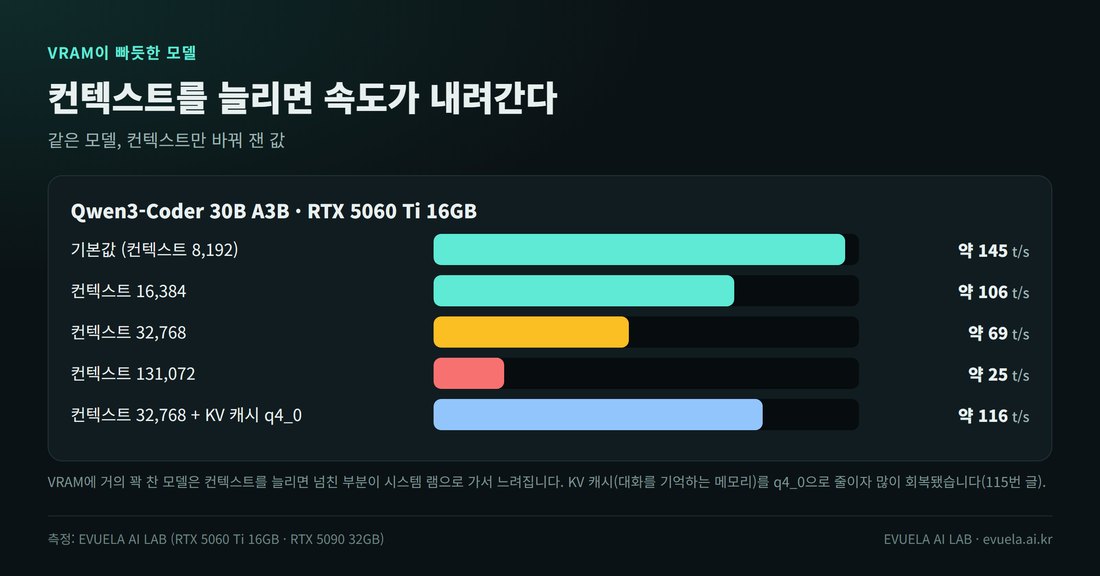
같은 모델인데 컨텍스트에 따라 속도가 여섯 배 가까이 달랐습니다.
| 모델 (16GB) | 기본값 | 컨텍스트 32,768 | 컨텍스트 131,072 | 잰 글 |
|---|---|---|---|---|
| Gemma 4 12B QAT | 속도 그대로 | 속도 그대로 | 속도 그대로 (VRAM 11.5GB) | 109번 |
| Qwen3-Coder 30B A3B | 약 145 t/s | 약 69 t/s | 약 25 t/s | 115번 |
| Qwen3.6 35B A3B | 약 90 t/s | 약 93 t/s | KV 캐시를 줄이면 최대 컨텍스트에서 약 55 t/s | 110번 |
| Gemma 4 26B A4B QAT | 약 94 t/s | 속도를 잃지 않는 선 | 약 63 t/s | 109번 |
이 표가 뜻하는 것: VRAM이 넉넉하게 남는 12B는 컨텍스트를 늘려도 속도가 그대로였습니다. VRAM을 거의 다 쓰는 큰 모델은 32,768까지가 속도를 잃지 않는 선이었고, 모델에 따라서는 그보다 먼저 느려졌습니다. 긴 문서를 자주 넣는다면 VRAM이 남는 작은 모델이 쓰기 편합니다.
셋째, 무엇에 쓸 것인가
| 쓰임새 | 16GB에서 맞았던 모델 | 이유 | 잰 글 |
|---|---|---|---|
| 처음, 일상 대화와 글 쓰기 | Gemma 4 12B QAT | VRAM 8.6GB. 컨텍스트 131,072에서도 속도가 그대로이고 사진도 1초 남짓에 읽었습니다 | 82번, 111번 |
| 더 큰 모델을 쓰고 싶을 때 | Qwen3.6 35B A3B (3비트) | VRAM 13.2GB에 다 들어가고 약 90 t/s. 생각을 켜면 답이 늦게 시작합니다 | 110번 |
| 짧은 코드 작성 | Qwen3-Coder 30B A3B (3비트) | 기본값 약 145 t/s. 파이썬 문제 48개 중 40개 통과. 산수와 일반 질문은 약했습니다 | 115번 |
| 긴 문서 요약 | Qwen3.5 9B | 컨텍스트 131,072까지 VRAM에 다 들어가고, 10만 자 요약이 19초 안에 시작됐습니다 | 98번 |
| 생각을 켜고도 빨리 답하기 | Ornith 1.5 9B | 생각을 켠 상태에서 15~20초에 끝났습니다 | 97번 |
이 표가 뜻하는 것: 가장 큰 모델이 늘 정답은 아닙니다. 16GB에서는 12B가 쓰기 편했고, 큰 모델은 속도나 긴 컨텍스트에서 값을 치렀습니다. 이 블로그의 산수와 코딩 문제에서는 Gemma 4 12B와 26B A4B의 정답 수가 거의 같았습니다. 다만 문제 수가 적어서, 큰 모델이 더 낫지 않다는 뜻은 아닙니다.
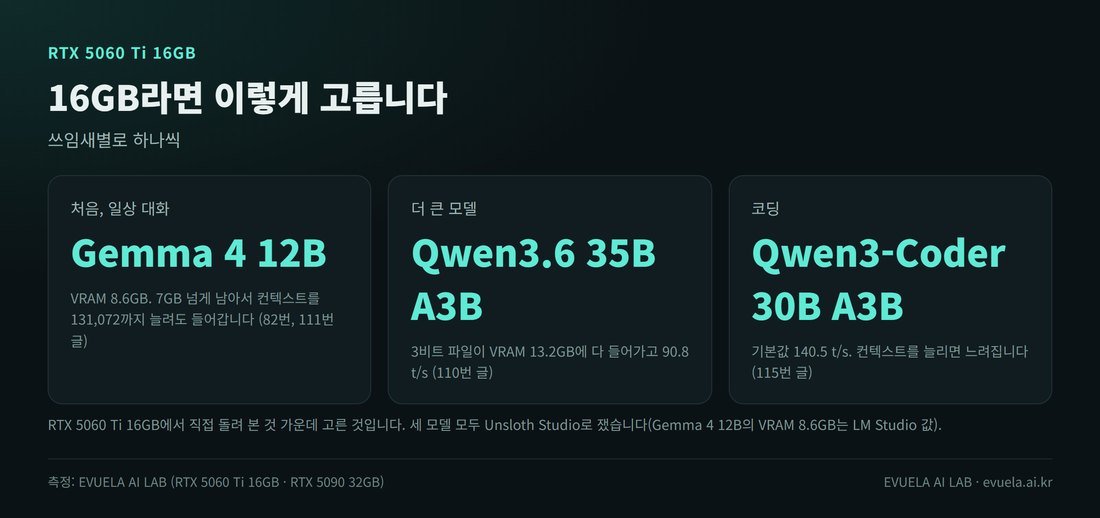
16GB에서 직접 돌려 본 것 가운데 고른 것입니다.
VRAM별로 정리하면
| VRAM | 고를 만한 것 | 근거 |
|---|---|---|
| 8GB | 파일 5GB 안팎까지 (가늠) | 직접 재지 못했습니다. 16GB에서 Gemma 4 12B(파일 7.15GB)가 8.6GB를 써서, 8GB에는 이보다 작은 파일이 맞을 것으로 보입니다 |
| 12GB | 파일 9GB 안팎까지 (가늠) | 직접 재지 못했습니다. 16GB에서 Gemma 4 12B 8.6GB, Qwen3.5 9B 9.7GB였으니 이 두 모델은 들어갈 것으로 보입니다 |
| 16GB | 파일 13GB 안팎까지 | 직접 잰 값. 12B는 넉넉하고, 30B와 35B도 3비트에 A3B가 붙은 것은 들어갔습니다 |
| 24GB | 파일 17GB 안팎까지 (가늠) | 직접 재지 못했습니다. 32GB에서 Qwen3.8 27B 4비트가 19.7GB, Muse Glimmer가 최대 컨텍스트에서 19.2GB였습니다 |
| 32GB | 파일 18GB까지는 직접 확인, 그보다 큰 파일은 가늠 | 직접 잰 가장 큰 파일은 18.16GB입니다. 27B 4비트(16.81GB)를 최대 컨텍스트로 올리면 29.5GB였습니다 |
이 표가 뜻하는 것: "가늠"이라고 적은 줄은 다른 그래픽카드에서 잰 VRAM 값을 옮겨 본 것입니다. 실제로 돌려 본 것이 아니므로, 프로그램의 예상 메모리 표시를 꼭 확인해야 합니다.
내 그래픽카드에서 어떤 모델이 얼마나 빠른지는 GPU 체험에서 볼 수 있습니다. 잰 속도 그대로 답이 나오는 모습을 재생해 줍니다.
정리
- 파일 크기에 2~3GB를 더해 VRAM과 견줍니다. 16GB라면 파일 13GB 안팎까지입니다.
- 프로그램의 예상 메모리를 확인합니다. Unsloth Studio는 올리기 전에 보여 줍니다.
- 긴 글을 넣으려면 VRAM이 남는 모델을 고릅니다. 빠듯한 모델은 컨텍스트 32,768부터 느려졌습니다.
- 쓰임새에 맞춥니다. 일상은 12B, 코딩은 코딩용 모델, 긴 문서는 작은 모델이 맞았습니다.
- 파일이 VRAM보다 작아도 느릴 수 있습니다. 레이어가 모두 그래픽카드에 올라갔는지는 6편에서 봅니다.
앞의 글: 1편, 2편 설치와 첫 대화, 3편 모델 이름 읽는 법. 다음 편(5편)은 꼭 알아야 할 설정 세 가지입니다.
이 글의 한계
- 그래픽카드 두 종류에서만 쟀습니다. 8GB, 12GB, 24GB에 대한 내용은 가늠입니다.
- VRAM 값은 모델이 쓴 몫입니다. 윈도우와 다른 프로그램이 쓰는 VRAM은 따로이고, PC마다 다릅니다.
- 측정한 프로그램이 섞여 있습니다. LM Studio와 Unsloth Studio는 기본 컨텍스트와 속도 기능이 달라서 같은 파일도 VRAM과 속도가 다르게 나옵니다.
- 쓰임새별 추천은 직접 돌려 본 모델 안에서 고른 것입니다. 돌려 보지 않은 모델이 더 나을 수 있습니다.
- 품질 비교는 문제 수가 적습니다. 산수 5문제, 파이썬 8문제 수준입니다.
- 2026년 10월 9일 기준으로 정리했습니다.
자주 묻는 질문
16GB 그래픽카드에는 몇 B 모델까지 되나요?
파일 크기로 13GB 안팎까지였습니다. 12B는 4비트로 넉넉하게 들어갔고, 30B와 35B도 3비트에 A3B가 붙은 파일은 들어갔습니다. 27B의 4비트 파일(16.81GB)은 다 들어가지 않아 초당 2.2토큰이었습니다.
VRAM이 조금 모자라면 못 쓰나요?
올라가기는 합니다. 넘친 부분을 시스템 램에 두고 CPU로 계산해서 많이 느려집니다. 모델 구조에 따라 차이가 커서, Gemma 4 26B A4B는 일부가 시스템 램으로 넘어가도 Unsloth Studio에서 약 94 t/s가 나왔습니다.
시스템 램은 얼마나 필요한가요?
테스트 PC는 32GB와 64GB입니다. 16GB PC에서 Gemma 4 26B A4B를 최대 컨텍스트로 올렸을 때 시스템 램이 31.7GB까지 찼습니다. 모델이 VRAM에 다 들어가면 시스템 램은 많이 쓰지 않았습니다.
큰 모델의 3비트와 작은 모델의 4비트 가운데 무엇을 고르나요?
이 블로그의 측정에서는 정답 수가 거의 같았습니다. 그래서 속도와 컨텍스트로 골랐습니다. 긴 글을 자주 넣는다면 VRAM이 남는 작은 모델이, 짧은 질문에 더 큰 모델을 쓰고 싶다면 3비트 큰 모델이 맞았습니다.
댓글 0개