로컬 AI 시작하기 7편, 대화 다음에는 무엇을 해 볼까, Qwen-Image-2.1 그림 7.6초·LTX-2.5 영상 20초·VoiceStudio 음성 11초였다
대화에 익숙해진 다음에 해 볼 것을 코딩, 도구(MCP), API, 그림, 영상, 음성, 검색으로 정리했습니다. 그림 한 장 7.6초, 5초 영상 약 20초, 50초 음성 약 11초였고, 필요한 VRAM은 음성 3.5GB부터 영상 31.2GB까지 달랐습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"Qwen3.6 35B A3B" 검색 결과 11건
대화에 익숙해진 다음에 해 볼 것을 코딩, 도구(MCP), API, 그림, 영상, 음성, 검색으로 정리했습니다. 그림 한 장 7.6초, 5초 영상 약 20초, 50초 음성 약 11초였고, 필요한 VRAM은 음성 3.5GB부터 영상 31.2GB까지 달랐습니다.
로컬 AI가 느리거나 답이 안 나올 때 볼 것을 증상별로 정리했습니다. 같은 3비트 파일이 레이어를 모두 그래픽카드에 올리자 초당 1.9토큰에서 28.7토큰이 됐고, 답이 멈출 때는 컨텍스트를 늘리거나 생각 단계를 낮추면 풀렸습니다.
처음에 알아야 할 설정을 컨텍스트, 생각(Thinking), 온도 세 가지로 정리했습니다. Qwen3.8 27B는 생각을 Low만 켜도 정답률이 73%에서 99%가 됐고, 16GB에서는 컨텍스트를 숫자로 정하자 초당 약 52토큰이 약 94토큰이 됐습니다.
모델을 고르는 순서를 VRAM, 컨텍스트, 쓰임새 세 가지로 정리했습니다. RTX 5060 Ti 16GB와 RTX 5090 32GB에서 잰 측정 16건의 파일 크기와 VRAM을 한 표에 모았고, 컨텍스트를 늘리면 VRAM과 속도가 어떻게 바뀌는지도 담았습니다.
모델 이름의 12B, A3B, QAT, GGUF, Q4_K_M이 무슨 뜻인지 조각별로 풀었습니다. 같은 Qwen3.8 27B도 4비트 파일은 17.74GB, 2비트 파일은 9.30GB였고, 같은 Q4_K_M도 올린 곳에 따라 16.46GB에서 18.97GB까지 달랐습니다.
로컬 AI는 모델을 내 PC의 그래픽카드에서 돌리는 것입니다. 필요한 것 세 가지와 VRAM 확인하는 법을 정리하고, RTX 5060 Ti 16GB와 RTX 5090 32GB에서 직접 잰 속도와 VRAM을 한 표로 모았습니다. 가이드 일곱 편의 첫 편입니다.
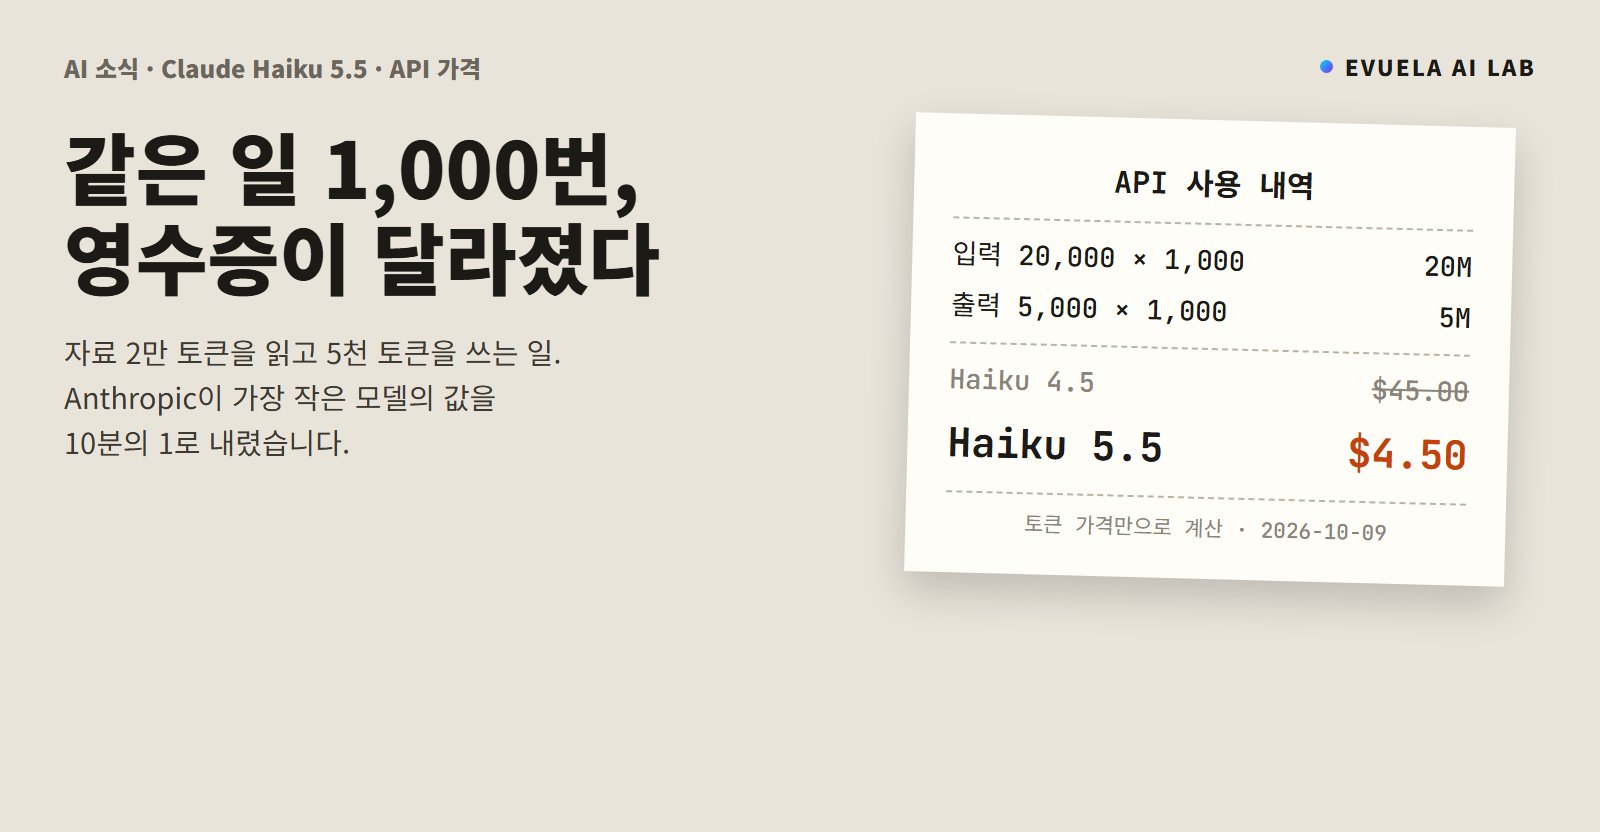
Anthropic이 10월 7일 Claude Haiku 5.5를 냈습니다. 입력 100만 토큰 0.10달러, 출력 0.50달러로 Haiku 4.5의 10분의 1이고 GPT-6 Luna와 같습니다. 프롬프트가 10만 토큰을 넘으면 값이 다섯 배가 되는 규칙과 로컬 AI 전기요금 비교까지 계산했습니다.
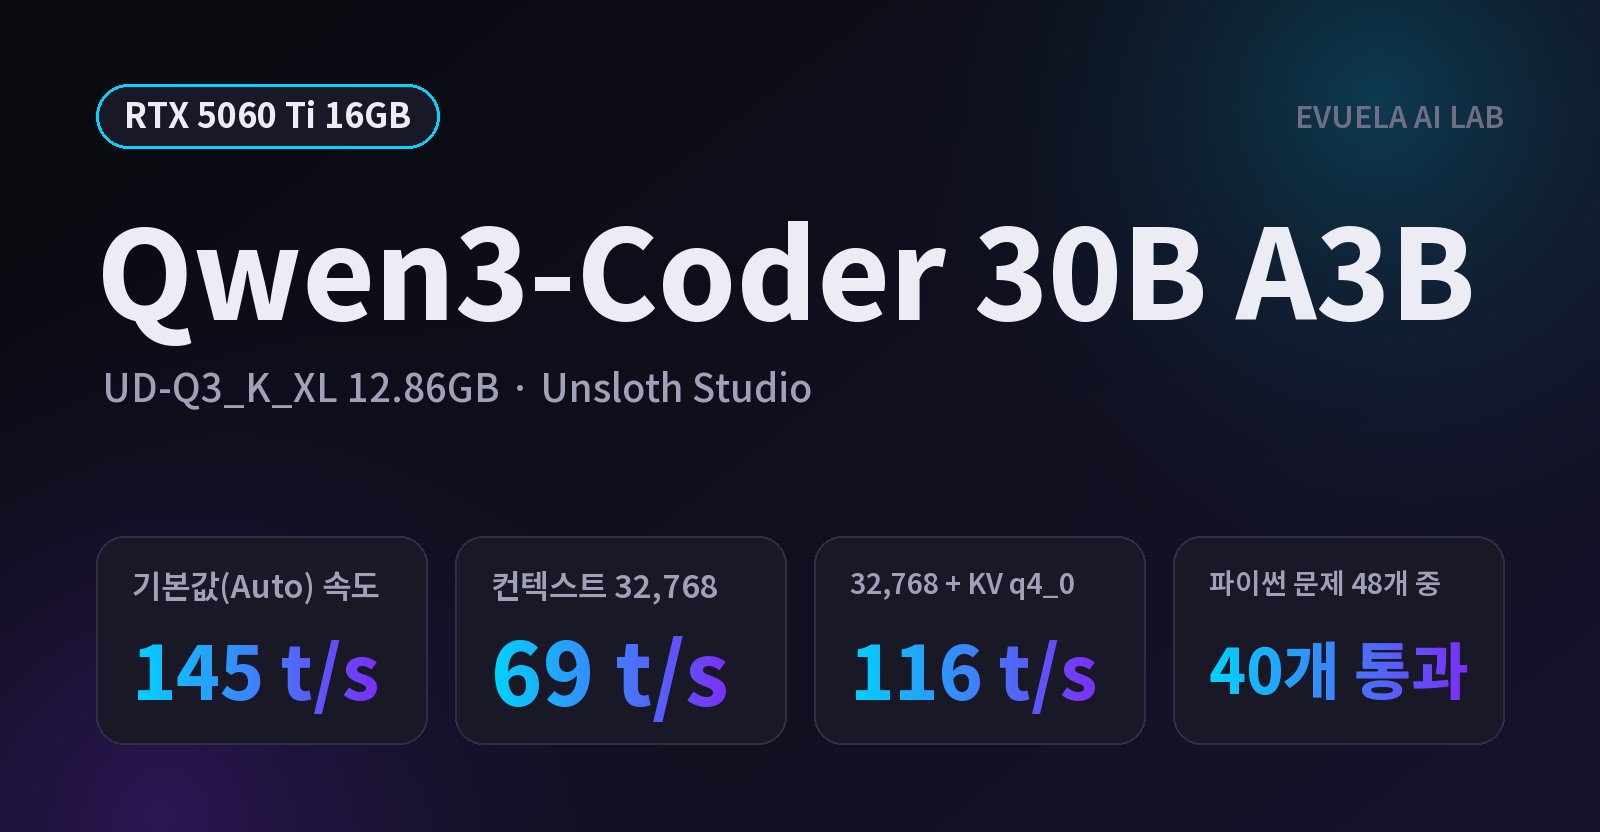
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3-Coder 30B A3B(UD-Q3_K_XL)를 돌렸습니다. 기본값은 초당 약 145토큰, 컨텍스트 32,768에서는 약 69토큰이었고 KV 캐시를 줄이면 116토큰이 됩니다. 파이썬 문제 결과도 담았습니다.
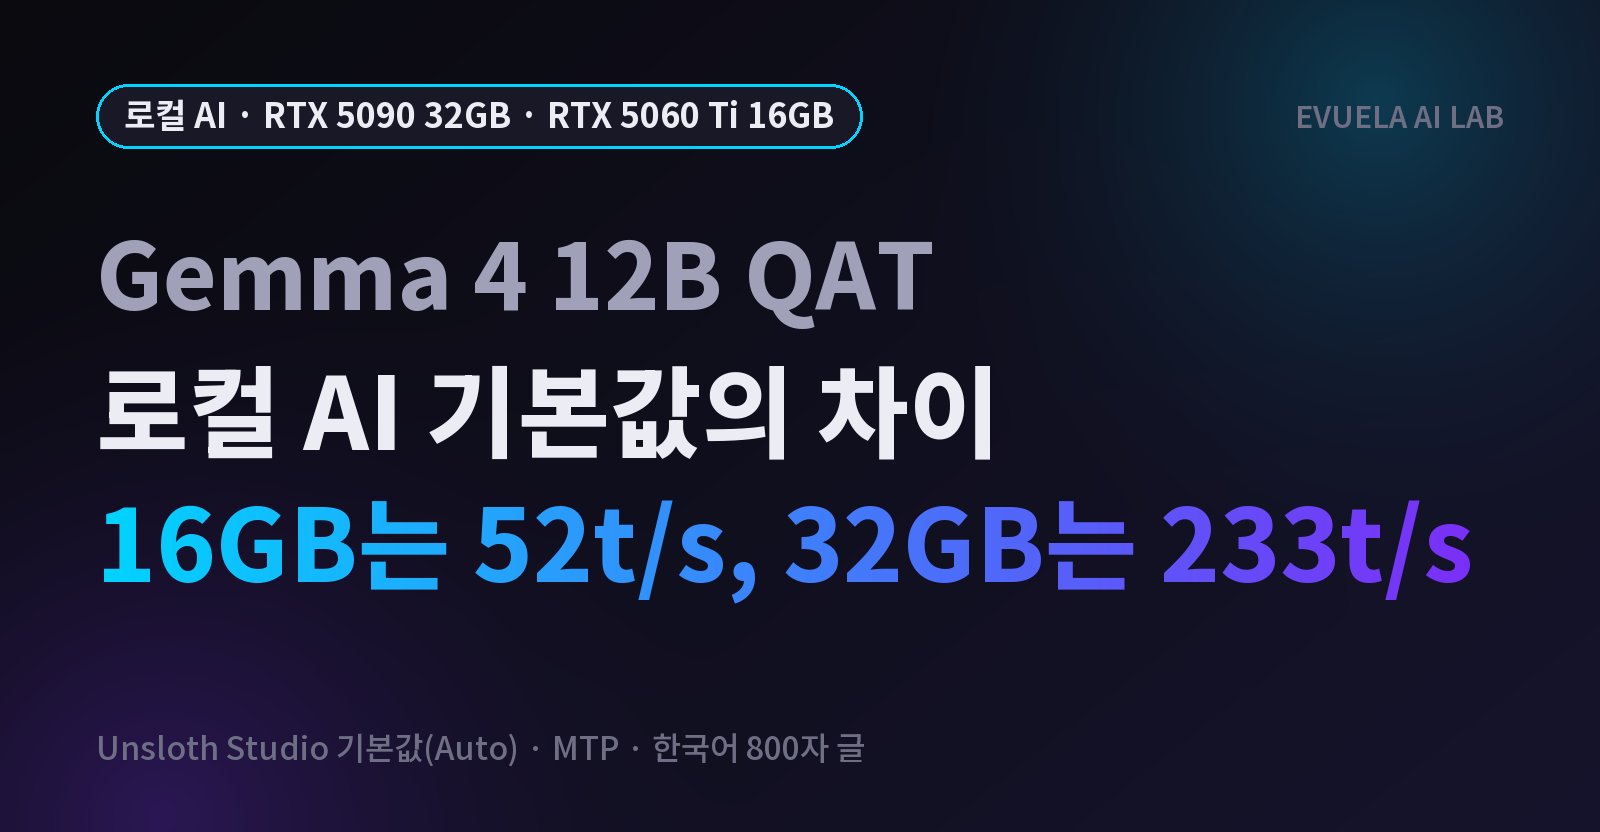
Gemma 4 12B QAT를 RTX 5090 32GB와 RTX 5060 Ti 16GB에서 Unsloth Studio 기본값으로 올렸습니다. 32GB는 MTP가 켜져 초당 233토큰, 16GB는 MTP가 꺼져 52토큰이었습니다. 16GB는 컨텍스트만 지정해도 94토큰이 됩니다.