로컬 AI가 느릴 때 가장 먼저 볼 것은 답하는 동안 그래픽카드가 일하고 있는지입니다. 같은 3비트 파일이 기본 설정에서는 초당 1.9토큰이었고, 레이어를 모두 그래픽카드에 올리도록 설정 세 가지를 바꾸자 28.7토큰이 됐습니다. 느린 동안 그래픽카드 사용률은 7~55%였고 CPU가 대신 바빴습니다. 이 글은 로컬 AI 시작하기 가이드의 6편으로, 테스트하면서 실제로 겪은 문제와 고친 방법을 증상별로 모았습니다.
- 아주 느리다: GPU 사용률이 낮으면 모델 일부를 CPU가 계산하는 것입니다. 더 작은 파일을 쓰거나 레이어를 모두 그래픽카드에 올립니다.
- 생각보다 느리다: 컨텍스트와 속도 기능(MTP)이 어떻게 잡혔는지 봅니다.
- 답이 안 나오고 멈춘다: 생각이 컨텍스트를 다 쓴 것입니다. 컨텍스트를 늘리거나 생각 단계를 낮춥니다.
- 계산을 틀린다: 생각을 켭니다.
- 없는 것을 지어낸다: 설정으로는 못 고칩니다. 웹이나 파일을 읽는 도구를 붙입니다.
여기 적은 증상과 숫자는 모두 이 블로그가 RTX 5060 Ti 16GB와 RTX 5090 32GB에서 직접 겪고 잰 것입니다. 일부는 LM Studio에서 겪은 문제이고, 그런 경우 본문에 프로그램을 적었습니다. 다른 PC에서는 원인이 다를 수 있습니다.
이 글의 내용을 20초로 요약한 영상입니다(소리 없음).
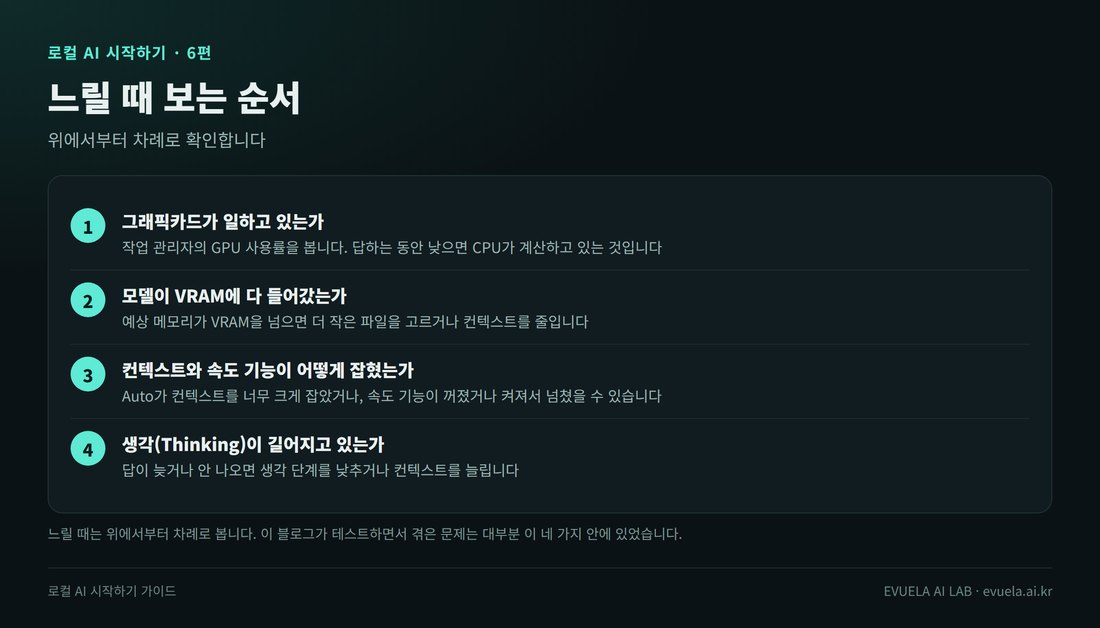
위에서부터 차례로 확인합니다.
증상별로 먼저 볼 것
| 증상 | 먼저 볼 것 | 고치는 방법 |
|---|---|---|
| 초당 몇 토큰밖에 안 나온다 | 답하는 동안 GPU 사용률 | 더 작은 파일, 또는 레이어를 모두 그래픽카드에 |
| 다른 사람의 측정보다 느리다 | 컨텍스트 크기, 속도 기능이 켜졌는지 | 컨텍스트를 숫자로 정함, MTP 확인 |
| 컨텍스트를 늘리자 느려졌다 | VRAM이 꽉 찼는지 | 컨텍스트를 줄이거나 KV 캐시를 줄임 |
| 답이 안 나오고 멈춘다 | 생각 단계, 컨텍스트 | 컨텍스트를 32,768 이상으로, 생각 단계를 낮춤 |
| 답이 너무 늦게 시작한다 | 생각이 켜져 있는지 | 생각을 끄거나 낮춤 |
| 계산을 틀린다 | 생각이 꺼져 있는지 | 생각을 켬 |
| 외국어가 섞인다, 분량을 못 맞춘다 | 파일이 몇 비트인지 | 덜 줄인 파일로 바꿈 |
| 없는 것을 지어낸다 | 모델이 알 수 없는 내용인지 | 웹이나 파일을 읽는 도구를 붙임 |
| 글은 빠른데 사진만 느리다 | 이미지 입력용 파일이 어디에 있는지 | 컨텍스트를 줄이거나 이미지 파일을 GPU에 올림 |
이 표가 뜻하는 것: 아래에서 증상마다 실제로 잰 값과 함께 설명합니다. 급하면 이 표만 봐도 됩니다.
아주 느릴 때: 그래픽카드가 일하고 있는가
작업 관리자(Ctrl + Shift + Esc)의 성능 탭에서 GPU를 고르고, 모델이 답하는 동안 사용률을 봅니다. 이 블로그의 측정에서 빠른 경우에는 93~96%까지 올라갔습니다. 낮게 머문다면 모델의 일부를 CPU가 계산하고 있는 것입니다.
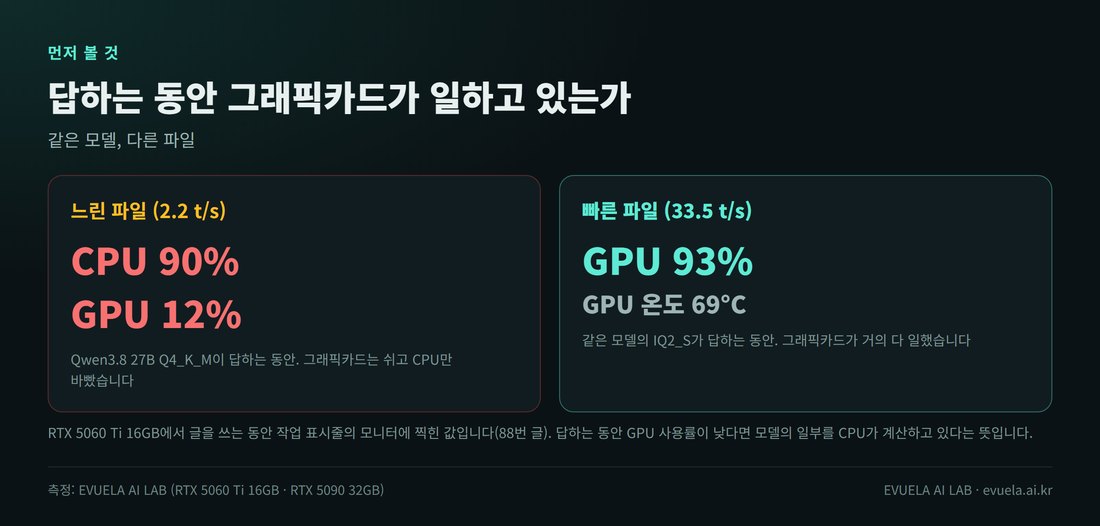
RTX 5060 Ti 16GB에서 글을 쓰는 동안 찍힌 값입니다.
| 경우 | 속도 | GPU 사용률 | CPU | 잰 글 |
|---|---|---|---|---|
| Qwen3.8 27B Q4_K_M, 16GB | 2.2 t/s | 12% | 90% | 88번 |
| Qwen3.8 27B IQ2_S, 16GB | 33.5 t/s | 93% | 기록 없음 | 88번 |
| Gemma 4 26B A4B QAT (Q4_0), 16GB, LM Studio | 21.2 t/s | 평균 31.7~48.0% | 96% | 87번 |
이 표가 뜻하는 것: 느린 경우에는 모두 그래픽카드가 쉬고 CPU가 바빴습니다. 그래픽카드의 전력도 낮았습니다. 87번 글에서는 전력 제한이 180W인 그래픽카드가 글을 쓰는 동안 36W를 넘지 않았습니다.
원인 1. 파일이 VRAM보다 크다
파일이 VRAM에 다 들어가지 않으면 넘친 부분을 시스템 램에 두고 CPU로 계산합니다. 이때는 더 작게 줄인 파일로 바꾸는 것이 가장 쉽습니다. Qwen3.8 27B는 16.81GB 파일에서 9.3GB 파일로 바꾸자 2.2 t/s가 33.5 t/s가 됐습니다. 파일을 고르는 방법은 4편에 있습니다.
원인 2. 파일은 들어가는데 레이어 일부가 CPU에 남았다
파일이 VRAM보다 작아도 느릴 수 있습니다. 모델은 레이어라는 층이 수십 개 쌓인 구조이고, 토큰 하나를 만들려면 모든 레이어를 차례로 지나야 합니다. 레이어 몇 개만 CPU에 남아도 그 몇 개가 끝나기를 기다려야 해서 전체가 느려집니다.
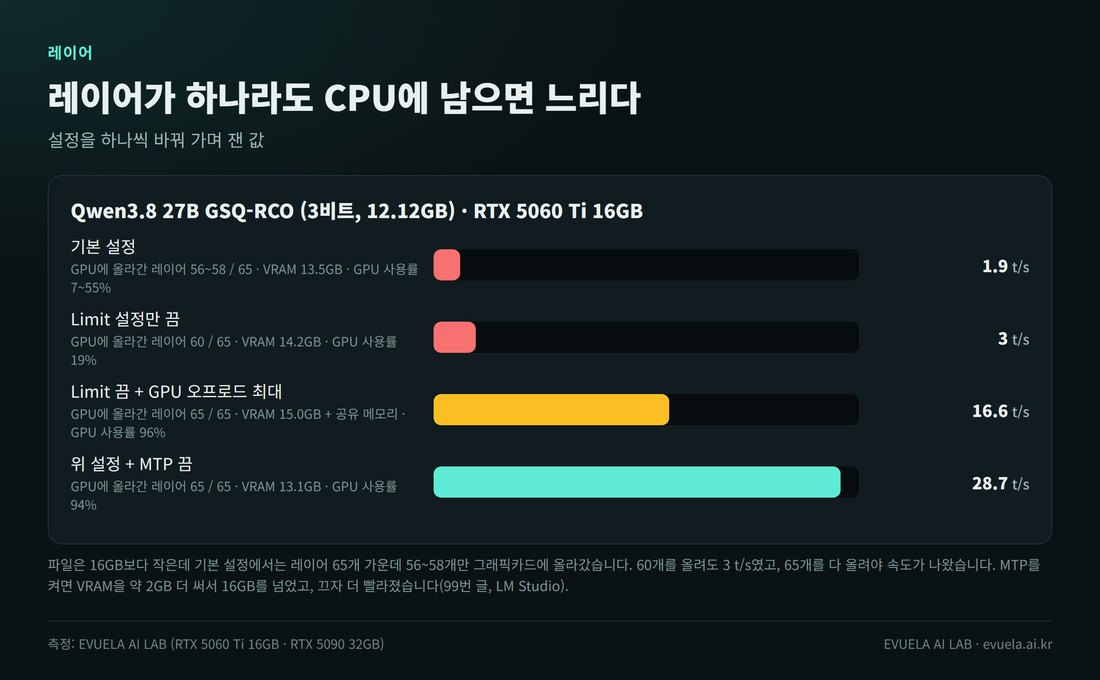
파일은 12.12GB로 16GB보다 작았습니다.
| 설정 | GPU에 올라간 레이어 | 속도 | VRAM | GPU 사용률 |
|---|---|---|---|---|
| 기본 설정 | 56~58 / 65 | 1.86~1.94 t/s | 13.5GB | 7~55% |
| Limit 설정만 끔 | 60 / 65 | 2.88~3.06 t/s | 14.2GB | 19% |
| Limit 끔 + GPU 오프로드 최대 | 65 / 65 | 16.4~16.8 t/s | 15.0GB + 공유 메모리 약 0.5GB | 96% |
| 위 설정 + MTP 끔 | 65 / 65 | 28.6~28.7 t/s | 13.1GB | 94% |
이 표가 뜻하는 것: LM Studio에서 잰 값입니다(99번 글). 레이어 60개를 올려도 3 t/s였고, 65개를 다 올려야 속도가 났습니다. 화면에는 65개로 표시됐지만 실제로는 56개만 올라가 있었습니다. 실제 값은 프로그램의 실행 기록(로그)에서 확인했습니다.
Unsloth Studio에서도 같은 원리가 통했습니다. Gemma 4 26B A4B는 기본값에서 약 94 t/s였는데, 레이어를 모두 그래픽카드에 올리도록 고정하자 약 107 t/s가 됐습니다. 대신 VRAM이 15.6GB까지 차서 다른 프로그램을 닫고 써야 했습니다(109번 글).
생각보다 느릴 때: 컨텍스트와 속도 기능
그래픽카드는 잘 일하는데 다른 사람의 측정보다 느리다면, 프로그램이 컨텍스트와 속도 기능을 어떻게 잡았는지 봅니다.
| 겪은 일 | 원인 | 고친 방법과 결과 | 잰 글 |
|---|---|---|---|
| Gemma 4 12B가 16GB에서 약 52 t/s | Auto가 컨텍스트를 262,144로 잡느라 MTP를 끔 | Context Length를 숫자로 지정 → 약 94 t/s | 111번 |
| Qwen3-Coder 30B가 컨텍스트 32,768에서 약 69 t/s | VRAM이 꽉 차서 늘어난 몫이 시스템 램으로 | KV 캐시를 q4_0으로 → 약 116 t/s | 115번 |
| 3비트 파일이 레이어를 다 올려도 16 t/s대 | MTP가 VRAM을 약 2GB 더 써서 16GB를 넘음 | MTP를 끔 → 28.7 t/s | 99번 |
| Qwen3.8 27B가 32GB에서 초당 72토큰 | 기본값(Auto)에서는 MTP가 켜지지 않음 | Speculative Decoding을 MTP로 → 106 t/s | 92번 |
이 표가 뜻하는 것: MTP는 VRAM이 남을 때는 켜는 쪽이 빨랐고, VRAM이 빠듯할 때는 끄는 쪽이 빨랐습니다. 정해진 답이 없어서, 기본값이 느리면 컨텍스트와 MTP를 하나씩 바꿔 보는 수밖에 없었습니다. 설정이 있는 곳은 5편에 있습니다.
다른 프로그램이 VRAM을 쓰고 있는지도 봅니다. 게임, 영상 편집 프로그램, 브라우저의 영상 재생이 VRAM을 차지하면 모델이 쓸 몫이 줄어듭니다. 테스트 PC에서는 윈도우와 다른 프로그램이 0.6~0.7GB를 쓰고 있었습니다.
답이 안 나오고 멈출 때
질문을 보냈는데 한참 뒤에 답 없이 끝나는 경우입니다. 겪은 것은 두 가지였습니다.
| 모델 | 겪은 일 | 고친 방법 | 잰 글 |
|---|---|---|---|
| Qwen3.8 27B (LM Studio) | 800자 글을 부탁했는데 4번 모두 0자. 생각에만 약 8,000토큰을 써서 컨텍스트 8,192가 다 참 | 컨텍스트 32,768로 늘림, 또는 생각 단계를 Low나 Medium으로 → 12~13초에 답 | 83번 |
| Bonsai 27B (1비트) | 기본 컨텍스트 8,192에서 생각만 하다 답 없이 끝남, 5번 중 2번 | 확인한 방법 없음 | 81번 |
이 표가 뜻하는 것: 생각 과정도 컨텍스트에 들어갑니다. 컨텍스트가 작은데 생각이 길면 답을 쓸 자리가 남지 않습니다. Unsloth Studio는 기본 컨텍스트를 그래픽카드 메모리에 맞춰 크게 잡아서 이 문제가 덜했습니다(105번 글).
답이 늦게 시작하는 것도 같은 원인입니다. Qwen3.6 35B A3B는 800자 글 하나에 생각만 약 3,700~4,600토큰을 써서 답까지 36~45초가 걸렸고, 끄면 5~7초였습니다(110번 글).
답이 이상할 때
계산을 틀린다
생각이 꺼져 있는지 봅니다. 같은 산수 문제를 5번씩 물었을 때 Gemma 4 26B A4B, Qwen3.6 35B A3B, Qwen3.5 9B 모두 생각을 끄면 한 번도 맞히지 못했고, 켜면 모두 맞혔습니다. 온도를 0으로 낮추는 것으로는 고쳐지지 않았습니다(115번 글). 생각 기능이 없는 모델에는 "풀이를 먼저 쓰고 답해 줘"라고 덧붙이는 편이 안전합니다.
외국어가 섞이거나 분량을 못 맞춘다
| 파일 | 본 것 | 잰 글 |
|---|---|---|
| Bonsai 27B (1비트) | 한국어 답 대부분에 외국어가 섞임 | 81번 |
| Qwen3.8 27B IQ2_S (2비트) | 800자를 부탁했는데 2,450~3,155자. 중국어 표현이 한 번 섞임 | 88번 |
| Qwen3.8 27B Q4_K_M (4비트) | 답 약 40개 중 한자나 중국어 낱말이 섞인 것은 3개 | 83번 |
| Gemma 4 26B A4B QAT (4비트) | 한국어 답 21개에 다른 나라 글자가 섞인 것 없음 | 109번 |
이 표가 뜻하는 것: 많이 줄인 파일일수록 이런 일이 잦았습니다. VRAM이 허락하면 덜 줄인 파일로 바꾸는 것이 방법입니다. 2비트 파일은 생각을 켜자 분량을 531~677자로 맞췄습니다. 모델에 따라 4비트에서도 가끔 섞였습니다.
없는 것을 지어낸다
모델은 학습한 뒤의 일과 내 PC의 파일 내용을 알지 못합니다. 그런 것을 물으면 "모른다"고 하기도 하지만, 그럴듯하게 지어내기도 합니다. 이것은 설정으로 고칠 수 없습니다.
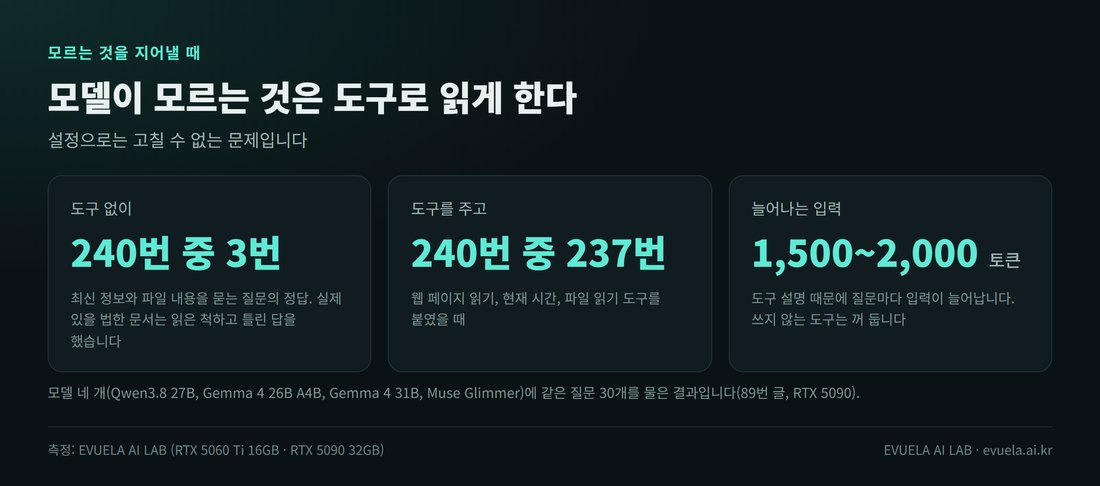
모델 네 개에 같은 질문 30개를 물은 결과입니다.
웹 페이지 읽기, 현재 시간, 파일 읽기 도구(MCP)를 붙이자 240번 중 3번이던 정답이 237번이 됐습니다. 도구가 없을 때는 실제 있을 법한 문서를 읽은 척하고 틀린 답을 자신 있게 말하기도 했습니다(89번 글). 모델마다 차이도 있었습니다. 실제로 없는 소설의 줄거리를 물었을 때 Gemma 4 26B A4B는 2번 모두 그런 작품은 확인되지 않는다고 답했고, Qwen3-Coder 30B는 줄거리를 지어냈습니다.
글은 빠른데 사진만 느릴 때
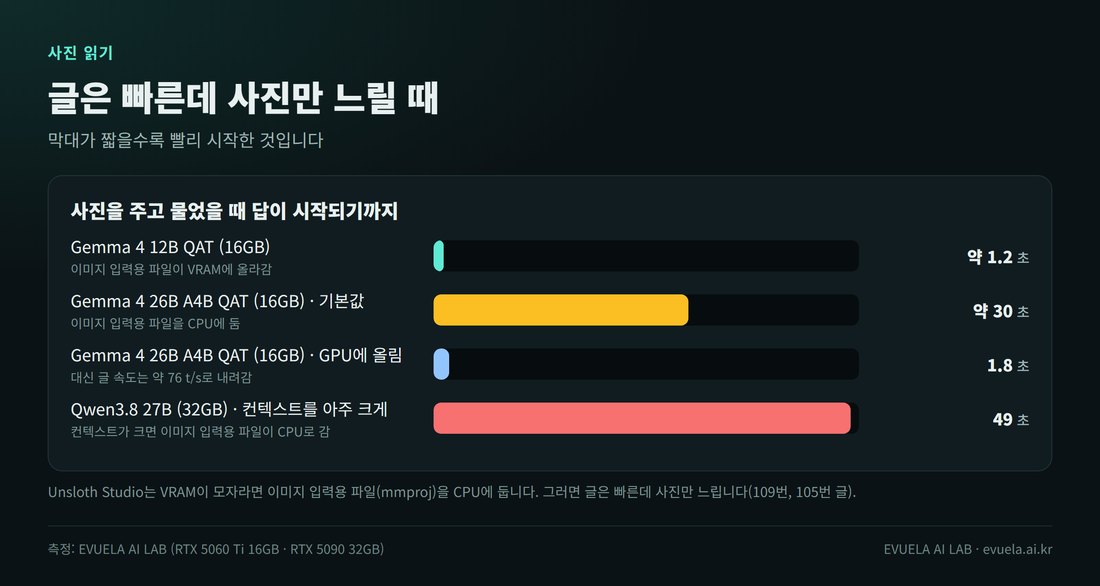
글은 빠른데 사진만 느린 경우입니다.
사진을 읽는 모델은 이미지 입력용 파일(mmproj)을 따로 씁니다. Unsloth Studio는 VRAM이 모자라거나 컨텍스트가 아주 크면 이 파일을 CPU에 둡니다. 그러면 글은 빠른데 사진을 읽을 때만 수십 초가 걸립니다.
| 경우 | 답이 시작되기까지 | 잰 글 |
|---|---|---|
| Gemma 4 12B QAT, 16GB | 약 1.2초 | 109번 |
| Gemma 4 26B A4B QAT, 16GB, 기본값 | 약 30초 | 109번 |
| 같은 모델, 이미지 입력용 파일을 GPU에 올림 | 1.8초 (글 속도는 약 76 t/s로 내려감) | 109번 |
| Qwen3.8 27B, 32GB, 컨텍스트를 아주 크게 | 1.7초에서 49초로 | 105번 |
이 표가 뜻하는 것: 사진을 자주 읽힌다면 VRAM이 남는 작은 모델이 편합니다. 큰 모델에서는 컨텍스트를 줄이거나, 글 속도를 조금 내주고 이미지 입력용 파일을 GPU에 올립니다.
문제가 생겼을 때 적어 두면 좋은 것
- 프로그램과 판: 같은 파일도 프로그램과 판에 따라 기본값이 달랐습니다.
- 모델 파일의 정확한 이름: 올린 곳과 양자화 표기까지 적습니다.
- 컨텍스트 값: Auto라면 실제로 잡힌 숫자를 봅니다. Unsloth Studio는 화면 오른쪽 위에 나옵니다.
- 답하는 동안의 GPU 사용률과 VRAM: 작업 관리자에서 봅니다.
- 속도: 답 아래의 tok/s 값입니다.
이 다섯 가지가 있으면 다른 사람의 측정과 견줄 수 있고, 커뮤니티에 물을 때도 답을 받기 쉽습니다. 이 블로그의 테스트 글도 이 값을 모두 적습니다.
정리
- 느리면 GPU 사용률부터 봅니다. 낮으면 CPU가 계산하고 있는 것입니다.
- 파일이 VRAM보다 작아도 레이어가 다 올라갔는지 봅니다. 1.9 t/s가 28.7 t/s가 됐습니다.
- MTP는 VRAM이 남으면 켜고, 빠듯하면 끕니다.
- 답이 안 나오면 컨텍스트를 늘리거나 생각 단계를 낮춥니다.
- 지어내는 것은 설정이 아니라 도구로 풉니다.
앞의 글: 1편, 2편 설치와 첫 대화, 3편 모델 이름, 4편 모델 고르기, 5편 설정 세 가지. 다음 편(7편)은 대화 다음에 해 볼 것들입니다.
이 글의 한계
- 테스트 PC 두 대에서 겪은 문제만 적었습니다. 드라이버 문제, AMD 그래픽카드, 맥에서 생기는 문제는 다루지 못했습니다.
- 레이어 문제는 LM Studio에서 확인한 것입니다. 지금 쓰는 Unsloth Studio에서는 같은 파일로 다시 재지 않았습니다.
- 16GB PC는 CPU가 오래된 것입니다(6코어 i5-9400F, DDR4). CPU가 빠른 PC에서는 일부가 시스템 램으로 넘어가도 덜 느릴 수 있습니다.
- 외국어 섞임과 지어내기는 문제 수가 적습니다. 모델마다 몇십 개의 답에서 본 것입니다.
- 프로그램의 기본값은 판이 바뀌면 달라집니다. 2026년 10월 9일 기준입니다.
자주 묻는 질문
GPU 사용률은 어디서 보나요?
윈도우 작업 관리자(Ctrl + Shift + Esc)의 성능 탭에서 GPU를 고르면 나옵니다. 모델이 답하는 동안의 값을 봅니다. NVIDIA 그래픽카드는 명령 프롬프트에서 nvidia-smi 명령으로도 볼 수 있습니다.
VRAM이 남는데도 느립니다.
레이어 일부가 CPU에 남았을 수 있습니다. 이 블로그의 측정에서는 VRAM이 2.6GB 남았는데도 모델이 그래픽카드에 다 올라가지 않은 경우가 있었습니다. 프로그램의 GPU 오프로드 설정을 확인합니다.
MTP는 켜는 것이 좋은가요?
VRAM이 남으면 켜는 쪽이 빨랐습니다. Qwen3.8 27B는 32GB에서 초당 72토큰이 106토큰이 됐습니다. VRAM이 빠듯하면 약 2GB를 더 써서 오히려 느려졌습니다.
모델이 틀린 내용을 자신 있게 말합니다.
로컬 모델만의 문제가 아니고, 설정으로 없앨 수도 없습니다. 최신 정보나 내 파일에 대한 질문에는 웹이나 파일을 읽는 도구를 붙이는 것이 효과가 컸습니다.
댓글 0개