 RTX 5090 32GB
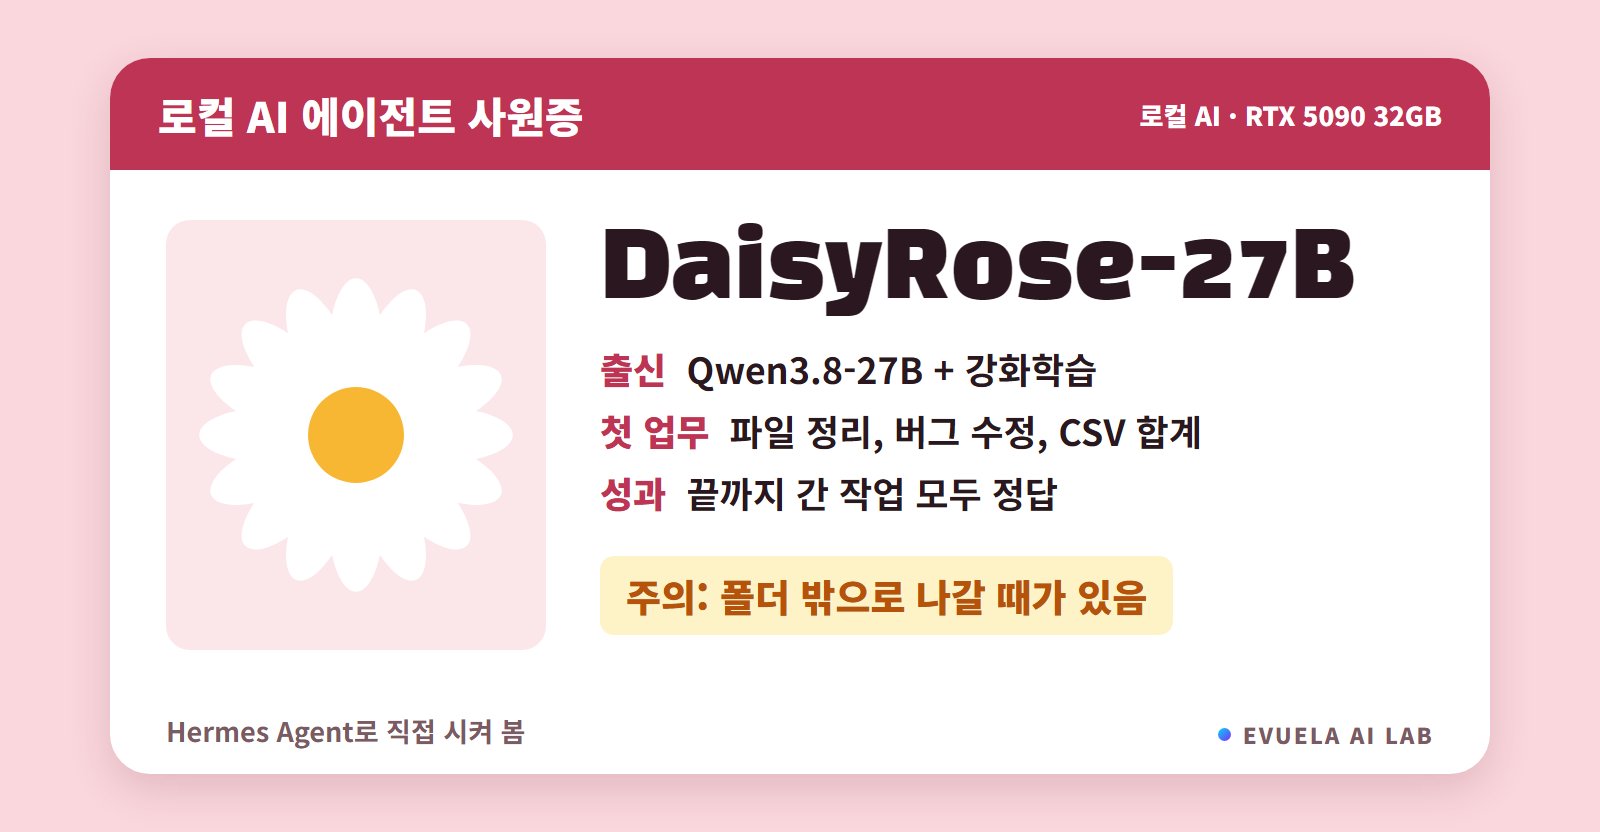
[RTX 5090 32GB] 로컬 AI DaisyRose-27B를 Hermes에 넣어 일을 시켜 봤다, 잘 해냈지만 폴더 밖으로 나갈 때도 있었다
Qwen3.8-27B를 강화학습한 DaisyRose-27B를 RTX 5090의 Hermes Agent에서 써 봤습니다. 끝까지 간 작업은 모두 정답이었고, 설정을 맞추면 일 하나에 23초였습니다. 다만 작업 폴더 밖으로 나갈 때도 있었습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"Thinking" 검색 결과 39건
RTX 5090 32GB
Qwen3.8-27B를 강화학습한 DaisyRose-27B를 RTX 5090의 Hermes Agent에서 써 봤습니다. 끝까지 간 작업은 모두 정답이었고, 설정을 맞추면 일 하나에 23초였습니다. 다만 작업 폴더 밖으로 나갈 때도 있었습니다.
 RTX 5060 Ti 16GB
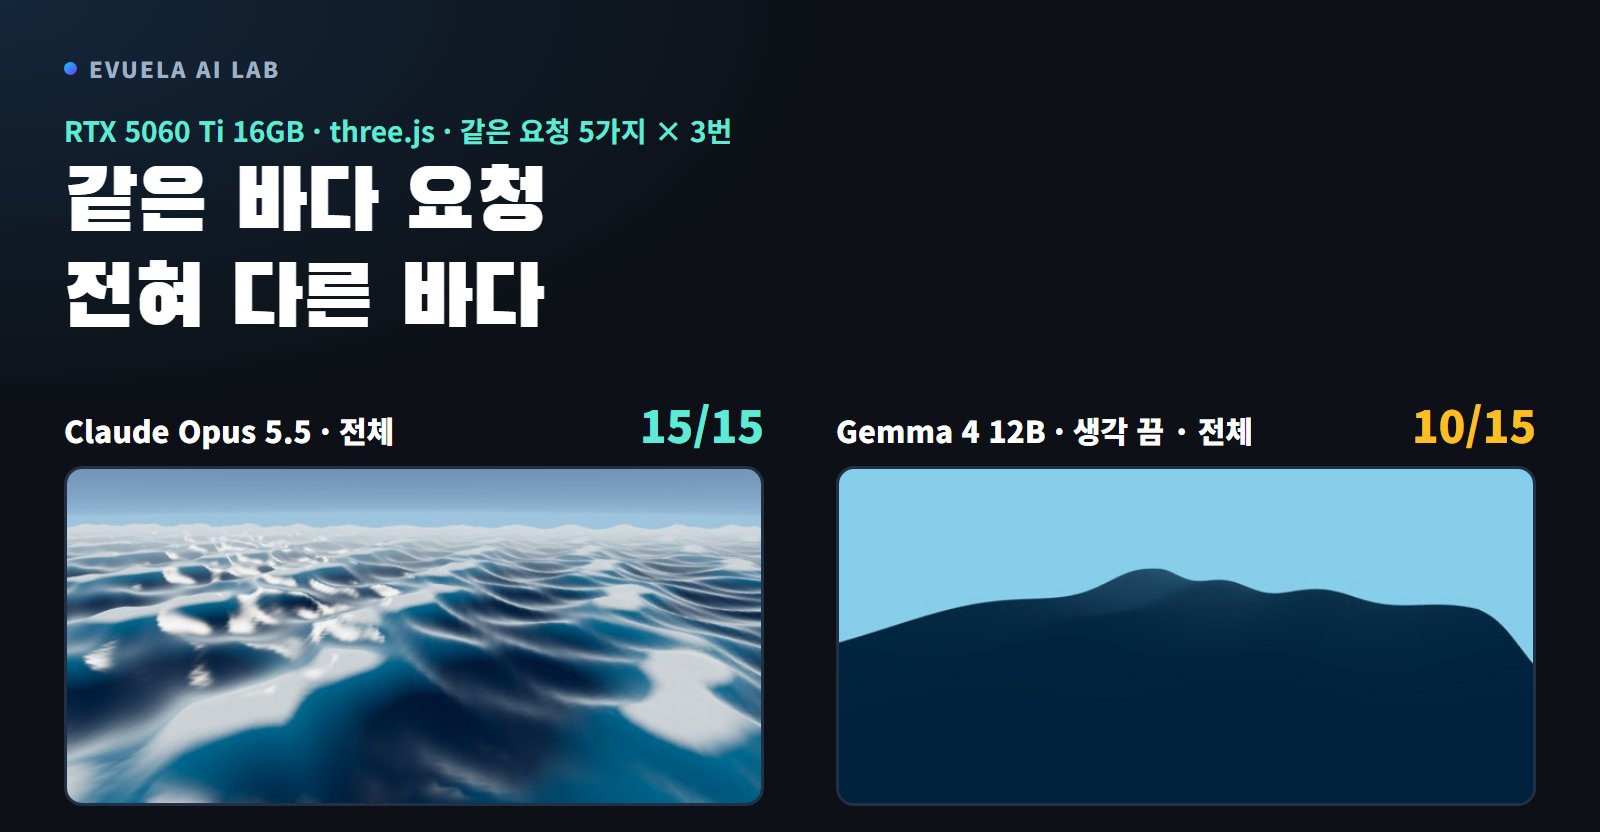
three.js로 3D 장면을 만드는 요청 5가지를 Claude Opus 5.5와 RTX 5060 Ti 16GB의 Gemma 4 12B QAT에 3번씩 똑같이 시켰습니다. Claude는 15번 모두, Gemma는 10번 요청대로 동작했고, 실패한 코드는 원인까지 찾았습니다.
 RTX 5060 Ti 16GB
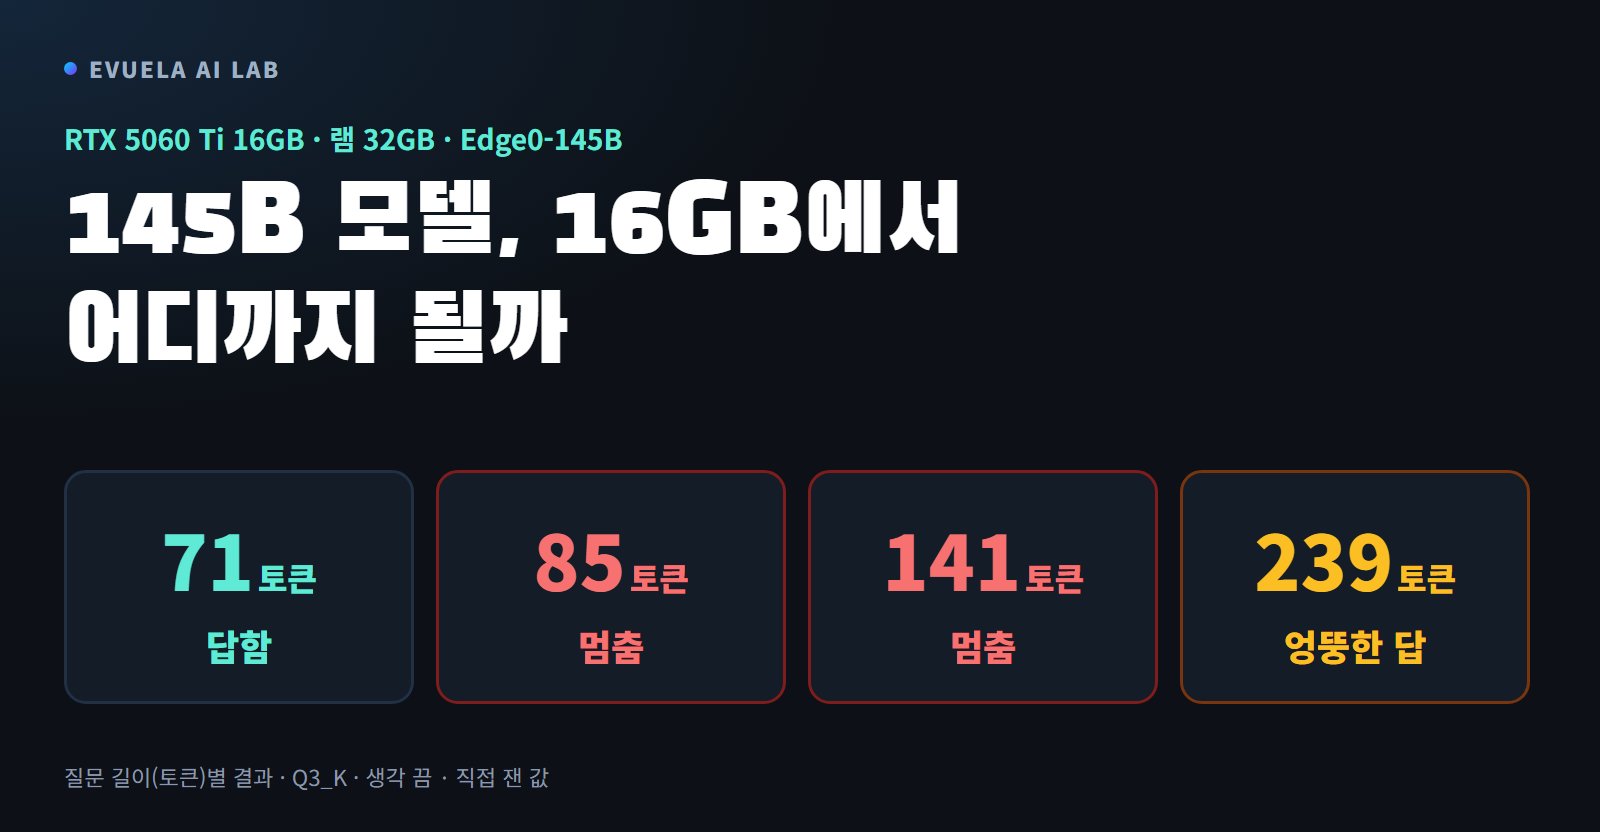
145B MoE 모델 Edge0-145B를 RTX 5060 Ti 16GB, 램 32GB PC에서 돌렸습니다. 짧은 질문에는 초당 17.6토큰으로 답했지만 70토큰을 넘는 질문은 대부분 읽다가 멈췄고, 읽힌 것도 엉뚱하게 답했습니다. 제작사의 16GB 제한 측정(36.8)과 비교했습니다.
 RTX 5060 Ti 16GB
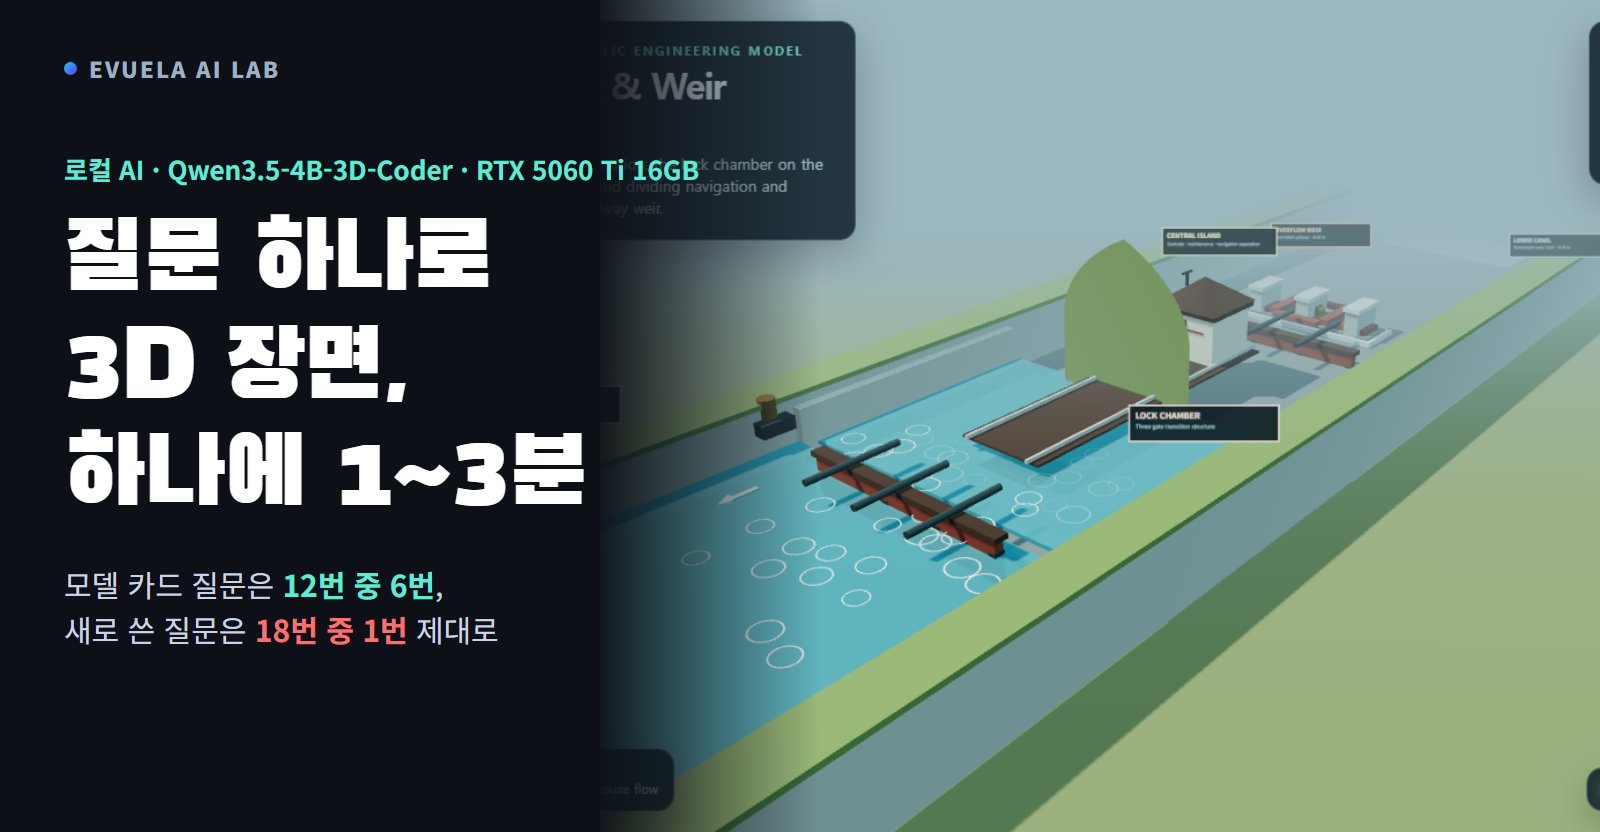
3D 장면용 4B 모델 Qwen3.5-4B-3D-Coder를 RTX 5060 Ti 16GB의 Unsloth Studio에서 돌려 장면 51개를 직접 열어 봤습니다. 제대로 그려진 것은 10개, 장면 하나에 1~3분. 생각을 켜면 6~16분이 걸렸고 결과는 같았습니다.
 RTX 5090 32GB
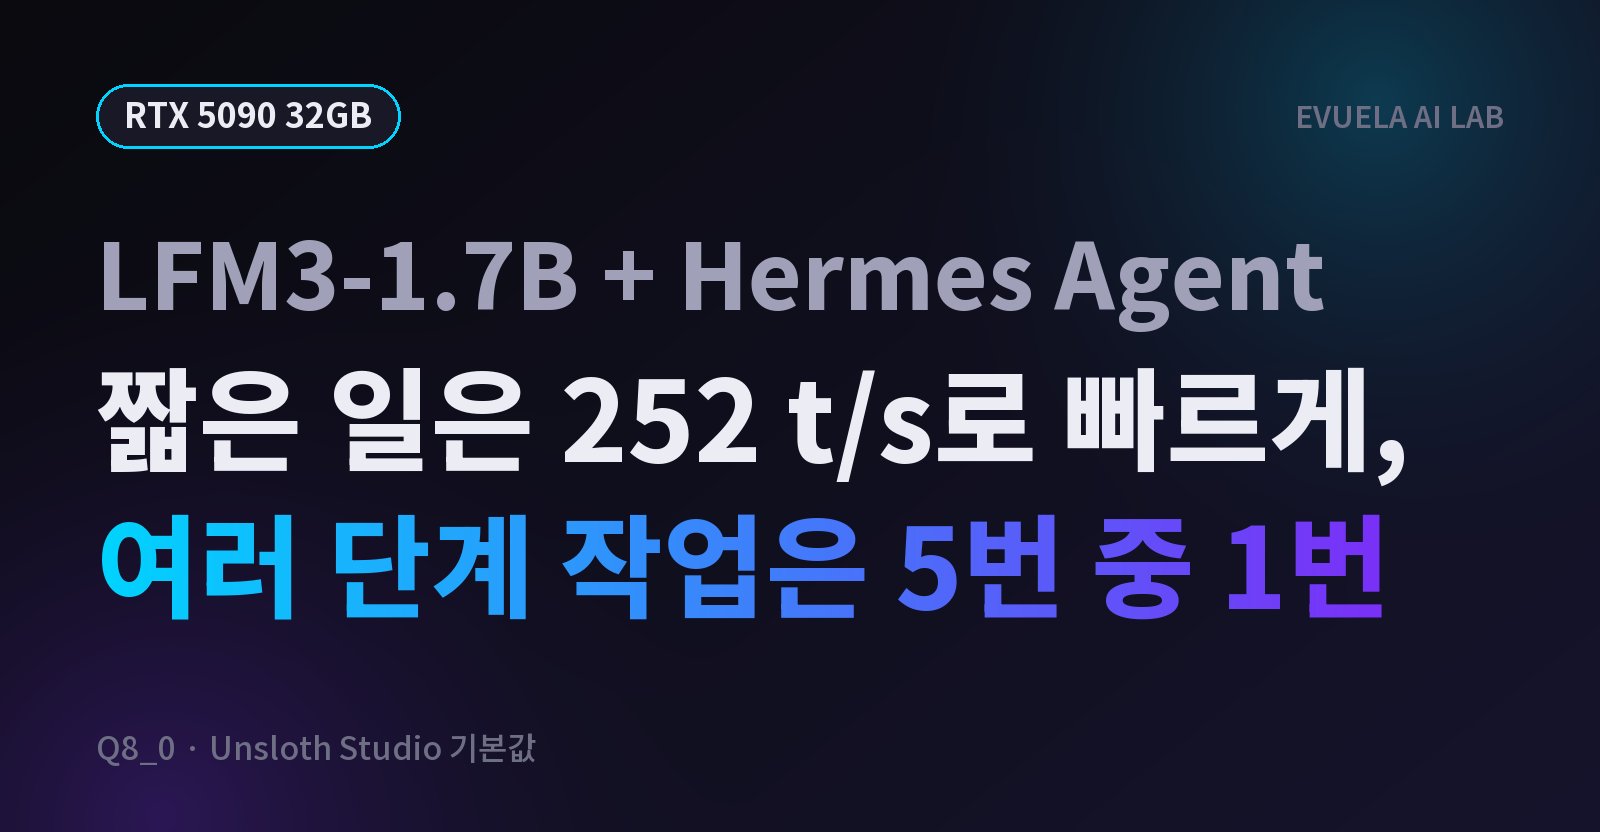
에이전트용 1.7B 모델 LFM3-1.7B를 Hermes Agent에 붙여 RTX 5090에서 과제 7가지를 시켰습니다. 33번 중 28번 성공, VRAM 5.5GB, 초당 252토큰. 짧은 일은 Qwen3.8 27B보다 빨랐지만 여러 단계 작업은 5번 중 1번만 성공했습니다.
 RTX 5090 32GB
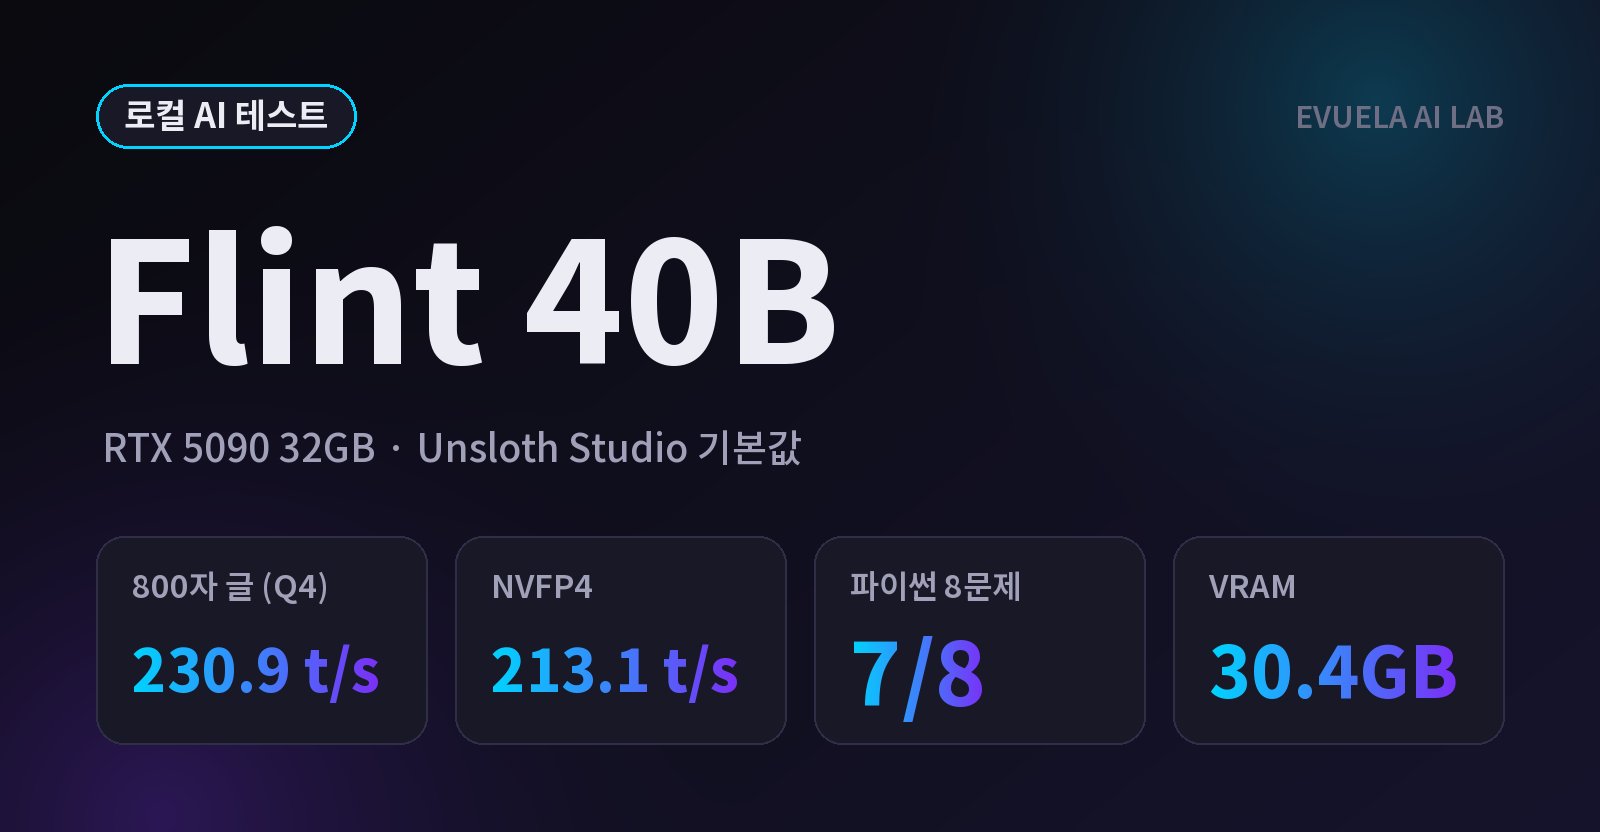
Recursive SI의 공개 코딩 모델 Flint 40B를 RTX 5090 32GB의 Unsloth Studio에서 Q4와 공식 NVFP4로 쟀습니다. 초당 230.9토큰, VRAM 30.4GB, 파이썬 8문제 중 7문제를 풀었고, 생각은 끌 수 없었으며 37만 8천 원을 3만 7,800원으로 읽었습니다.
 RTX 5060 Ti 16GB
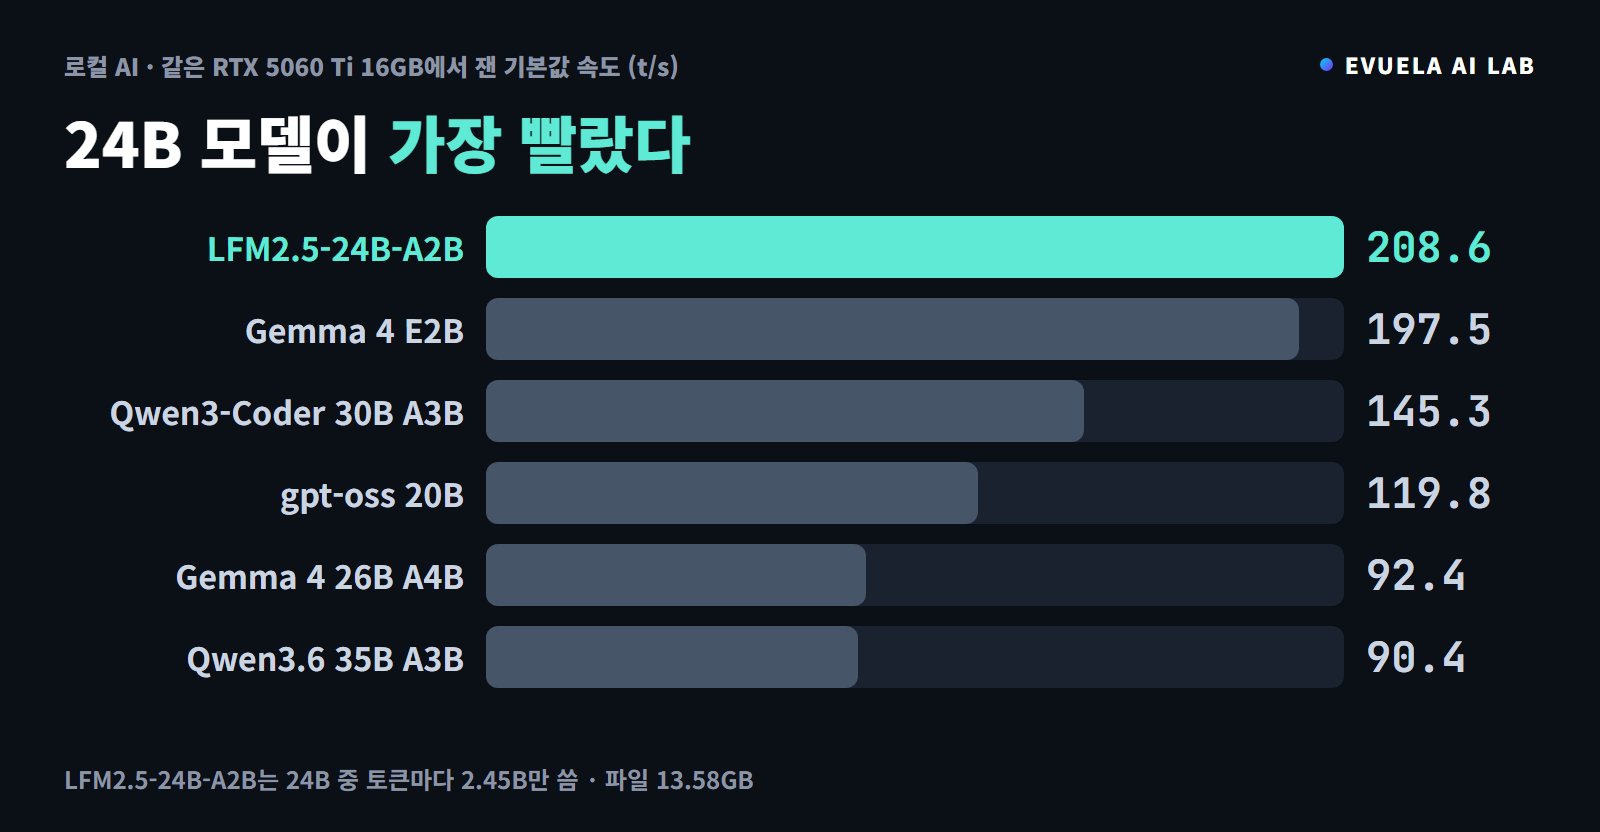
24B 중 토큰마다 2.45B만 쓰는 Liquid AI의 LFM2.5-24B-A2B를 RTX 5060 Ti 16GB의 Unsloth Studio에서 쟀습니다. 기본값 초당 208.6토큰으로 이 PC에서 가장 빨랐고, 100,000자 요약은 20.7초, 생각은 끌 수 없었습니다.
 RTX 5090 32GB
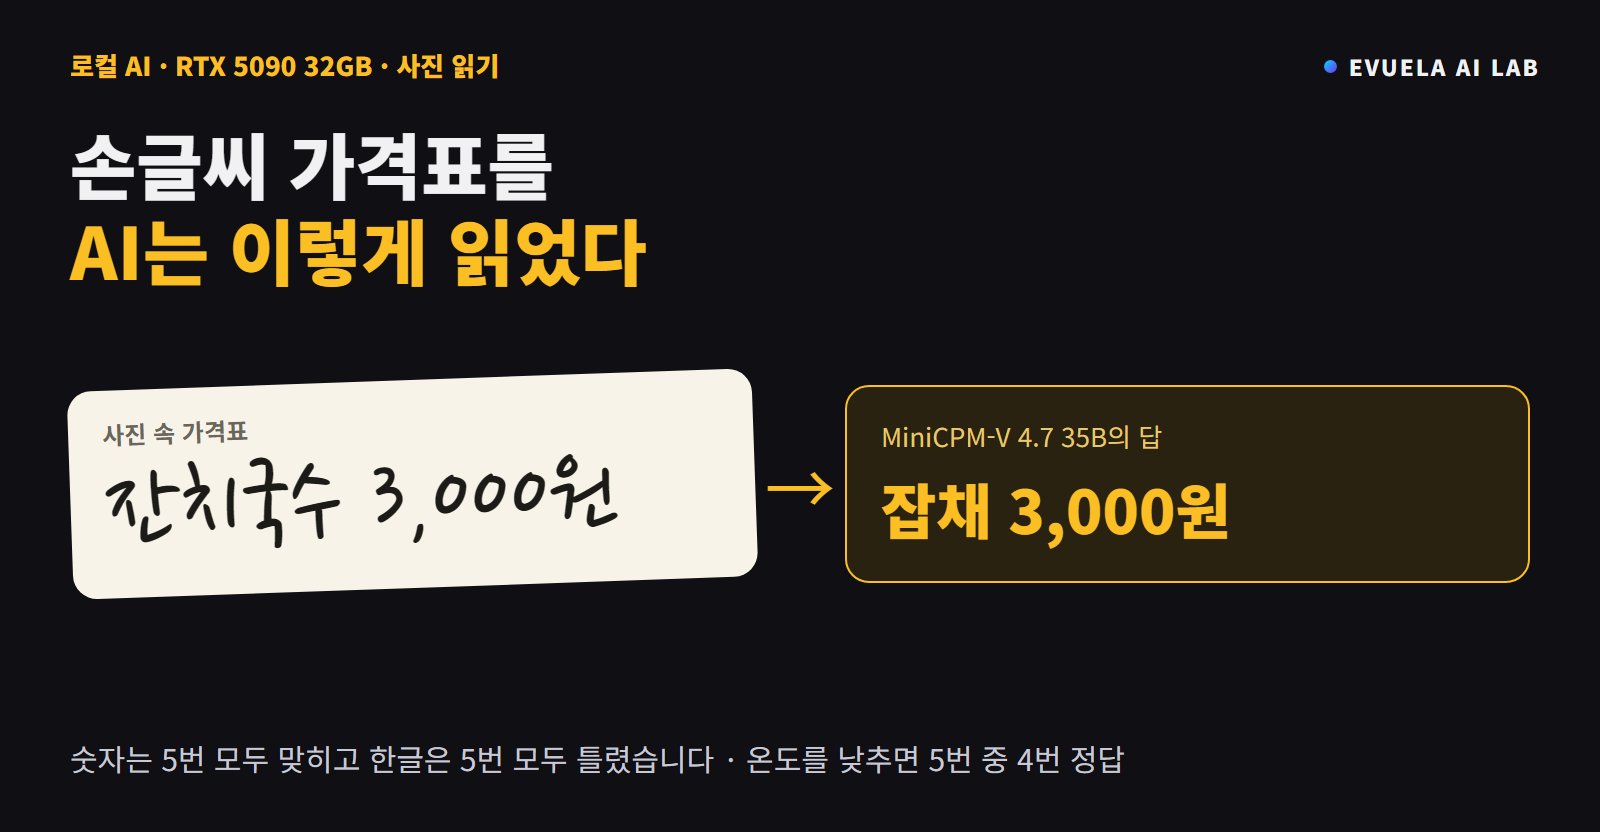
사진과 영상을 읽는 공개 모델 MiniCPM-V 4.7 35B A3B를 RTX 5090에서 쟀습니다. 속도는 초당 269토큰, 표와 화면 캡처는 70번 중 65번, Pixabay 실제 사진은 55번 중 29번 맞혔습니다. Unsloth Studio에서 사진이 안 된 이유와 한글 간판을 틀린 모습, 나아지는 설정도 적었습니다.
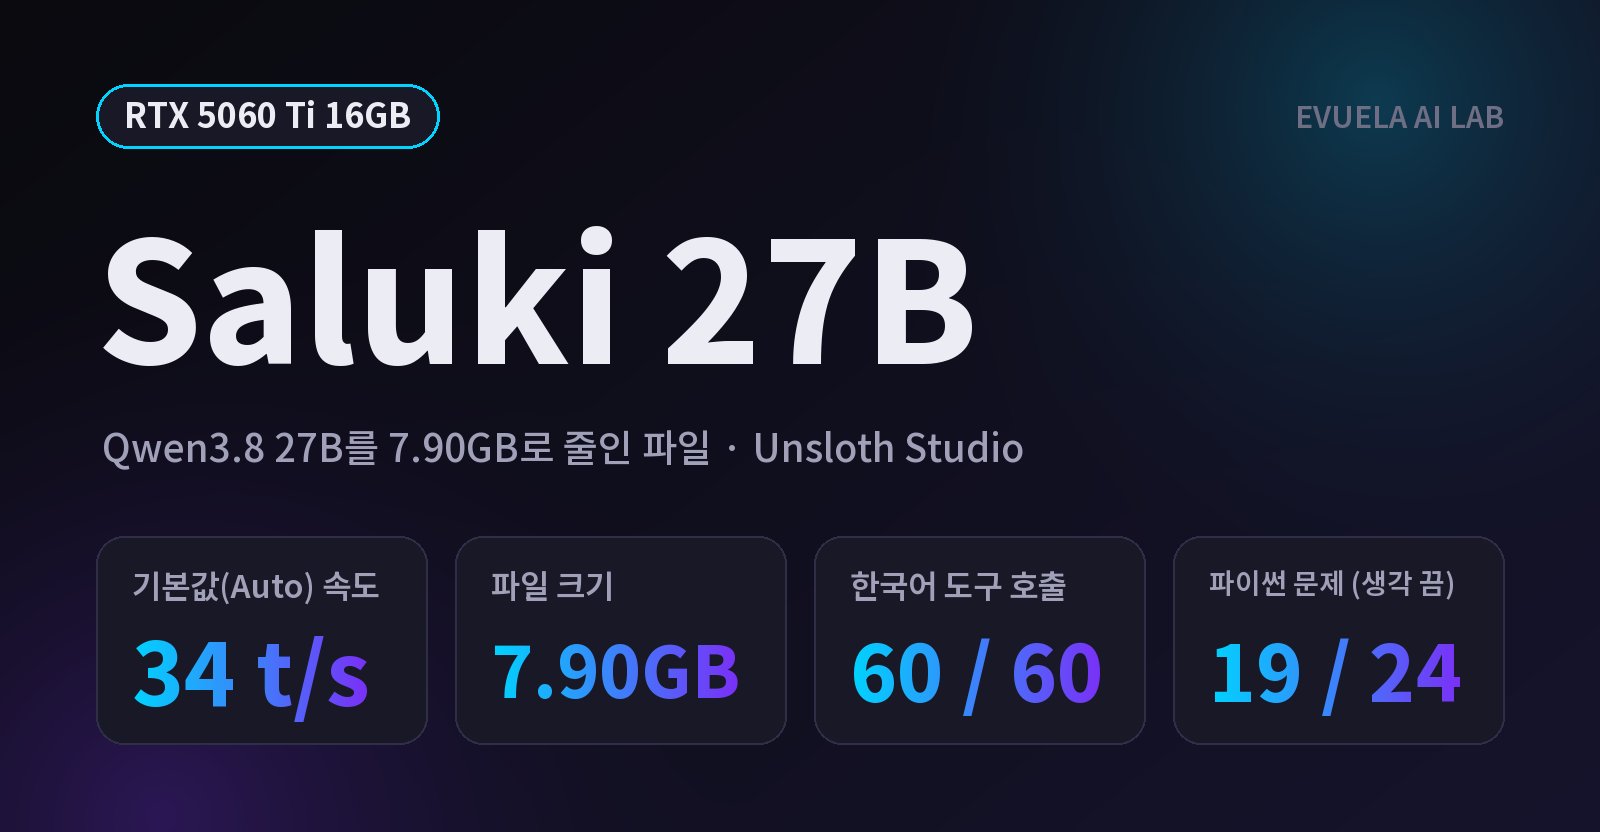 RTX 5060 Ti 16GB
Qwen3.8 27B를 7.90GB로 줄인 Saluki 27B를 RTX 5060 Ti 16GB의 Unsloth Studio에서 쟀습니다. 기본값 초당 34토큰, 한국어 도구 호출 60번 모두 정답이었고, 생각 단계를 정하지 않으면 15번 중 6번은 답이 나오지 않았습니다.