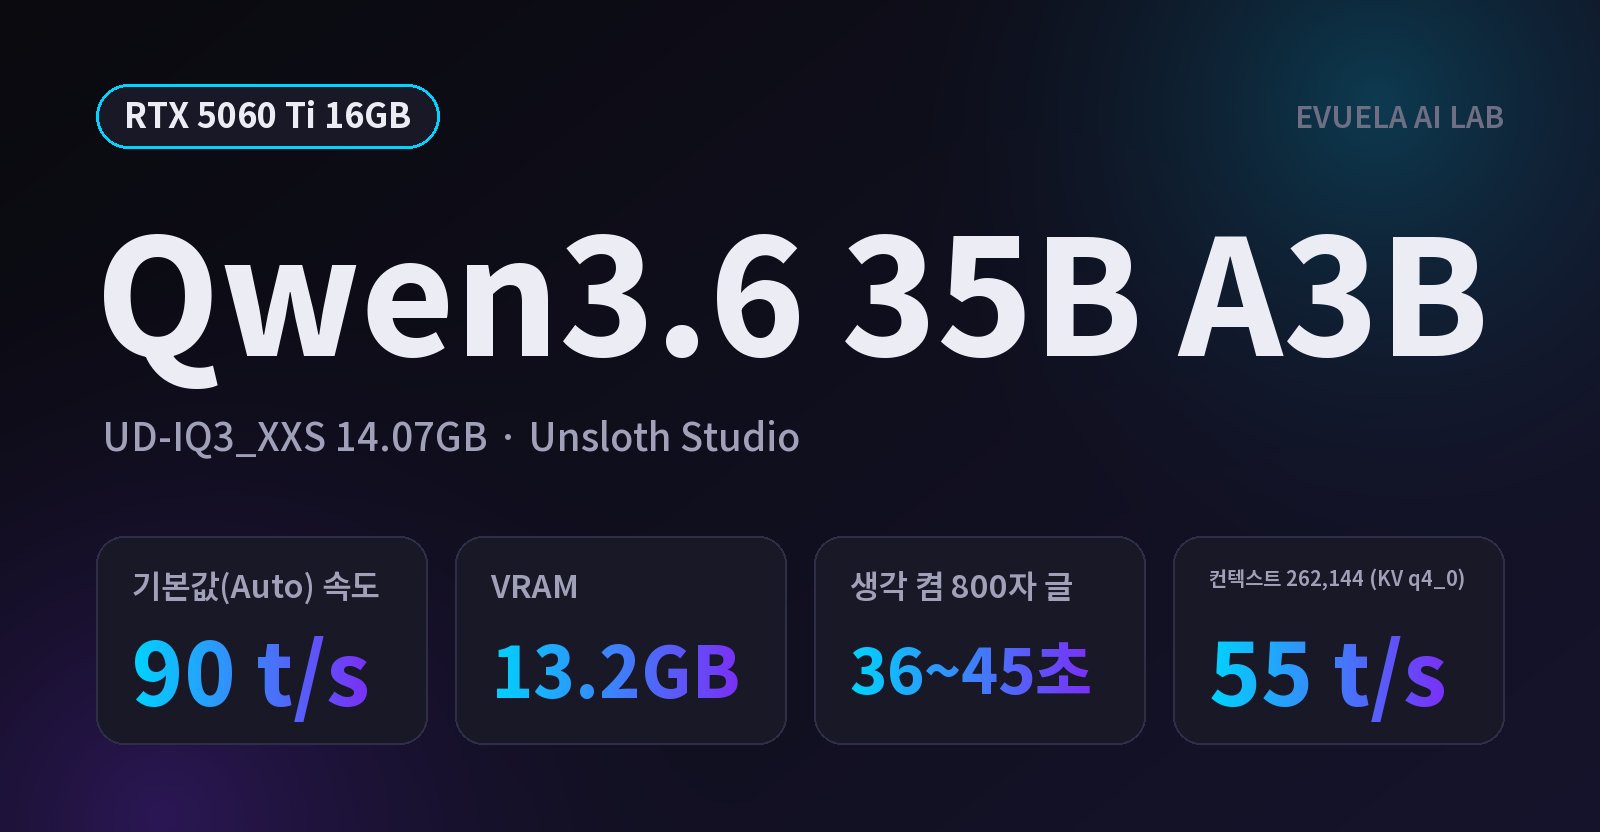
알리바바의 Qwen3.6 35B A3B(unsloth MTP 저장소의 UD-IQ3_XXS, 파일 14.07GB)를 RTX 5060 Ti 16GB PC의 Unsloth Studio에서 기본값(Auto) 그대로 돌려 봤습니다. 결론부터 적으면 모델 전체가 VRAM에 들어갔고, 초당 약 90토큰(t/s)이 나왔습니다. 같은 질문을 5번 잰 평균이 90.4t/s(최소 87.5, 최대 92.7)입니다.
- VRAM은 약 13.2GB를 썼습니다. 윈도우가 쓰는 몫까지 합쳐 16GB 중 13.9GB였습니다.
- MTP용 파일을 받았는데 기본값에서는 MTP가 켜지지 않았습니다. Unsloth Studio가 "MTP용 보조 모델까지는 VRAM에 안 들어간다"며 껐습니다. 그래도 속도는 Gemma 4 26B A4B(약 92t/s)와 비슷했습니다.
- 생각(Thinking)이 깁니다. 800자 글 하나에 생각만 약 3,700~4,600토큰을 써서 답까지 36~45초가 걸렸습니다. 끄면 5~7초입니다.
- 긴 컨텍스트는 잘 버팁니다. 32,768까지 약 93t/s였고, 최대 컨텍스트 262,144도 KV 캐시를 줄이면 약 55t/s가 나왔습니다.
- 산수는 생각을 켜야 맞았습니다. 끄면 5번 모두 틀렸고, 켜면 5번 모두 맞았습니다.
이 글의 숫자는 모두 이 PC에서 직접 잰 값입니다. 속도와 정답 수는 Unsloth Studio의 API로 재고, 화면 캡처와 영상은 측정이 끝난 뒤 따로 찍었습니다. 측정은 2026년 10월 5일에 했습니다. 하루 전에 같은 PC, 같은 방법으로 잰 Gemma 4 26B A4B QAT와 나란히 비교합니다.
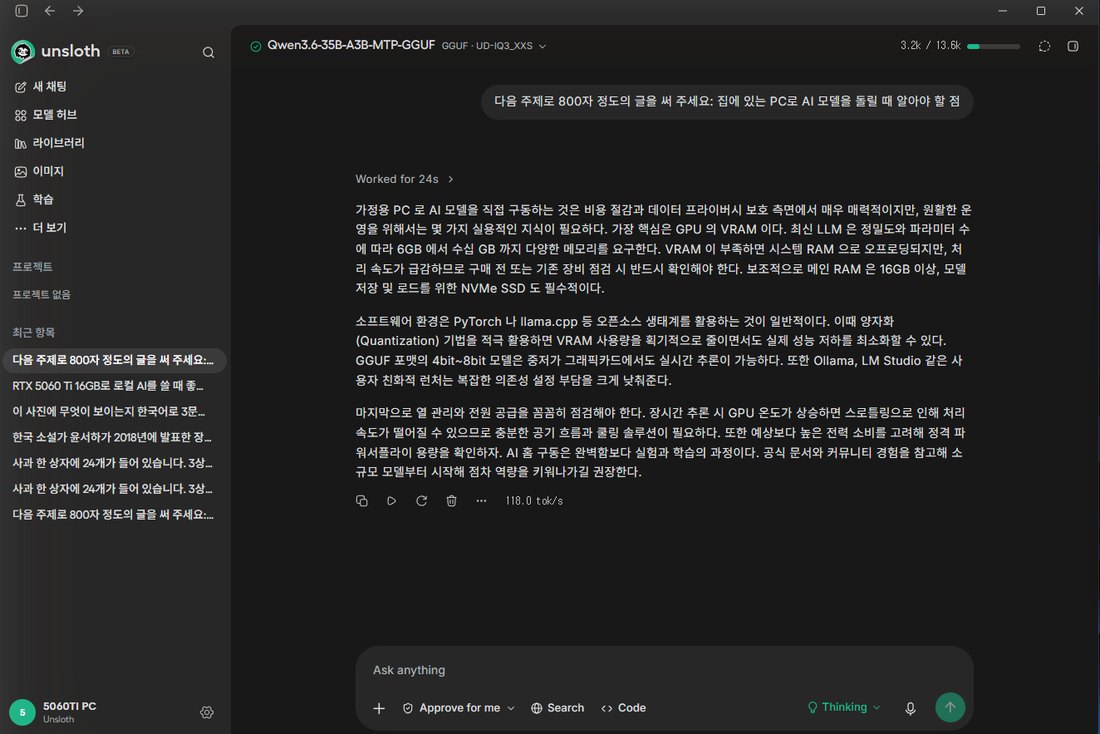
생각을 켠 채 800자 글을 쓰게 한 화면입니다. 생각에 24초를 썼고, 답 아래에 초당 118.0토큰이 표시됩니다.
테스트 PC와 실행 프로그램
| 항목 | 내용 |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti (VRAM 16GB, 전력 제한 180W) |
| GPU 연결 | PCIe 3.0 x8 (메인보드가 PCIe 3.0까지 지원) |
| CPU | Intel Core i5-9400F (6코어 6스레드) |
| 시스템 램 | DDR4 32GB (16GB × 2, 2666MT/s) |
| 저장장치 | Crucial MX500 1TB SATA SSD |
| 운영체제 | Windows 11 Pro, 전원 구성표 균형 조정 |
| 실행 프로그램 | Unsloth Studio 데스크톱(베타) 2026.9.14 |
| 엔진 | llama.cpp 0.5.0-dev (build 11160, commit a3c12db9d, Unsloth가 빌드한 것) |
| GPU 드라이버 | 616.92 |
| 측정 방법 | Unsloth Studio의 OpenAI 호환 API(127.0.0.1:8888)로 같은 질문을 반복해서 보냄. 속도는 첫 토큰이 나온 뒤부터 잰 생성 속도 |
| 측정 스크립트 | Python 3.14.3, requests 2.34.2, psutil 7.2.2 |
| 샘플링 | 따로 지정하지 않음(프로그램 기본값) |
| 측정 날짜 | 2026년 10월 5일 |
테스트 PC 두 대의 사양과 측정 방법은 소개 페이지에 있습니다. 테스트 프로그램을 LM Studio에서 Unsloth Studio로 바꾼 이유는 105번 글에 적었습니다.
테스트한 모델: Qwen3.6 35B A3B
알리바바 Qwen 팀이 2026년 4월에 공개한 모델입니다. MoE(Mixture of Experts) 구조라서 전체 파라미터는 35B이지만, 토큰 하나를 만들 때는 익스퍼트 256개 중 8개와 공용 1개만 씁니다. 그래서 활성 파라미터는 약 3B이고, 이름의 A3B가 이 뜻입니다. 제작사는 코딩 작업에 맞춘 모델이라고 소개합니다.
| 항목 | 내용 |
|---|---|
| 파라미터 | 전체 35B, 활성 약 3B |
| 구조 | MoE, 익스퍼트 256개 중 8개 + 공용 1개, 40레이어 |
| 받은 파일 | unsloth/Qwen3.6-35B-A3B-MTP-GGUF의 UD-IQ3_XXS 14.07GB (3비트 양자화) |
| 함께 받는 파일 | 이미지 입력용 파일(mmproj) 0.9GB. 합쳐서 14.97GB, 받는 데 2분 42초 |
| 최대 컨텍스트 | 262,144토큰 |
| 입력 | 글, 이미지, 영상 |
| 라이선스 | Apache 2.0 |
unsloth가 권하는 파일은 4비트인 UD-Q4_K_M(22.66GB)입니다. 16GB 그래픽카드에는 들어가지 않아서, 3비트 파일 중 가장 작은 UD-IQ3_XXS를 골랐습니다. 양자화(파일을 줄이는 것)를 더 세게 한 파일이라 4비트보다 답의 품질이 낮을 수 있습니다.
아래는 Qwen 팀이 모델 카드에 적은 벤치마크 점수입니다. 제작사가 직접 잰 값이고, 양자화하지 않은 원본 기준입니다.
| 벤치마크 | Qwen3.6 35B A3B | Qwen3.5 35B A3B | Gemma 4 26B A4B |
|---|---|---|---|
| SWE-bench Verified | 73.4 | 70.0 | 17.4 |
| Terminal-Bench 2.0 | 51.5 | 40.5 | 34.2 |
| MMLU-Pro | 85.2 | 85.3 | 82.6 |
| LiveCodeBench v6 | 80.4 | 74.6 | 77.1 |
| AIME26 | 92.7 | 91.0 | 88.3 |
제작사 점수로는 코딩 쪽(SWE-bench, Terminal-Bench)에서 Gemma 4 26B A4B와 차이가 큽니다. 다만 이 글에서 돌린 것은 3비트 파일이고, 이 PC에서 낸 코딩 문제 결과는 아래에 따로 적었습니다.
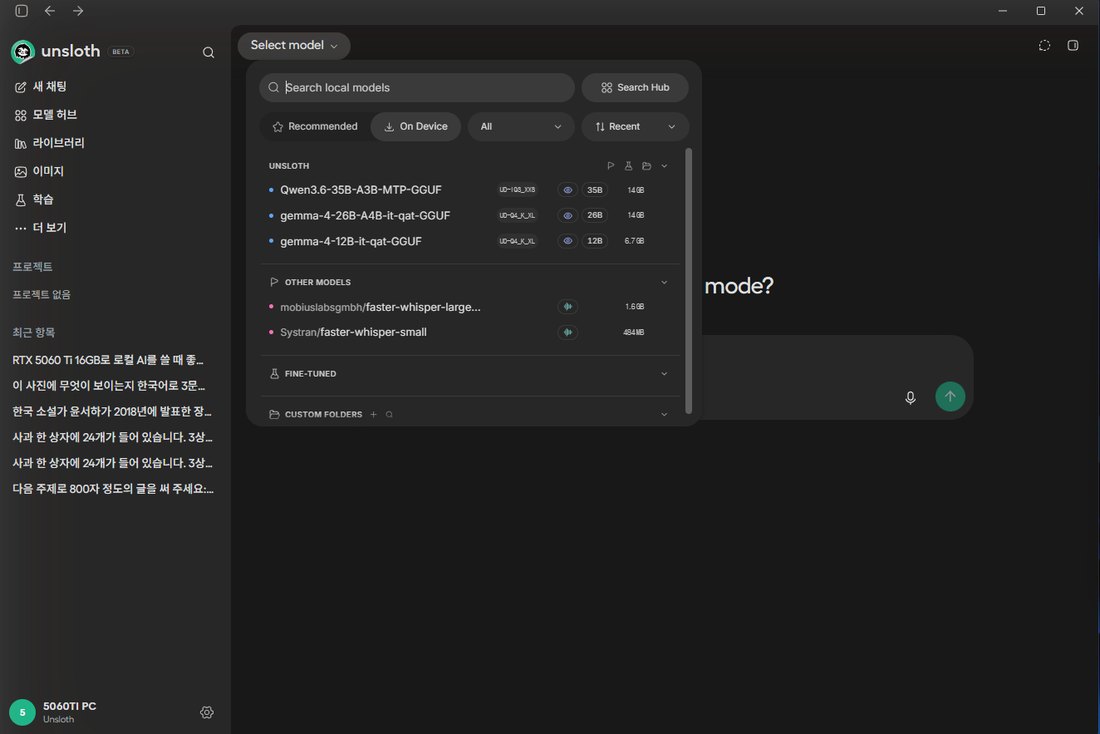
모델 선택 창입니다. 받아 둔 Qwen3.6 35B A3B(14GB)가 맨 위에 보입니다.
Unsloth Studio 기본값(Auto)은 어떻게 올렸나
실행 설정 창을 열면 컨텍스트(모델이 한 번에 기억하는 글의 길이)가 기본으로 Auto입니다. 예상 메모리는 GPU 21.24GiB, 전체 22.71GiB로 나오고 GPU 메모리를 넘는다는 경고가 붙습니다. 최대 컨텍스트 기준으로 계산한 값으로 보이며, Auto는 VRAM에 맞게 컨텍스트를 줄여서 올립니다.
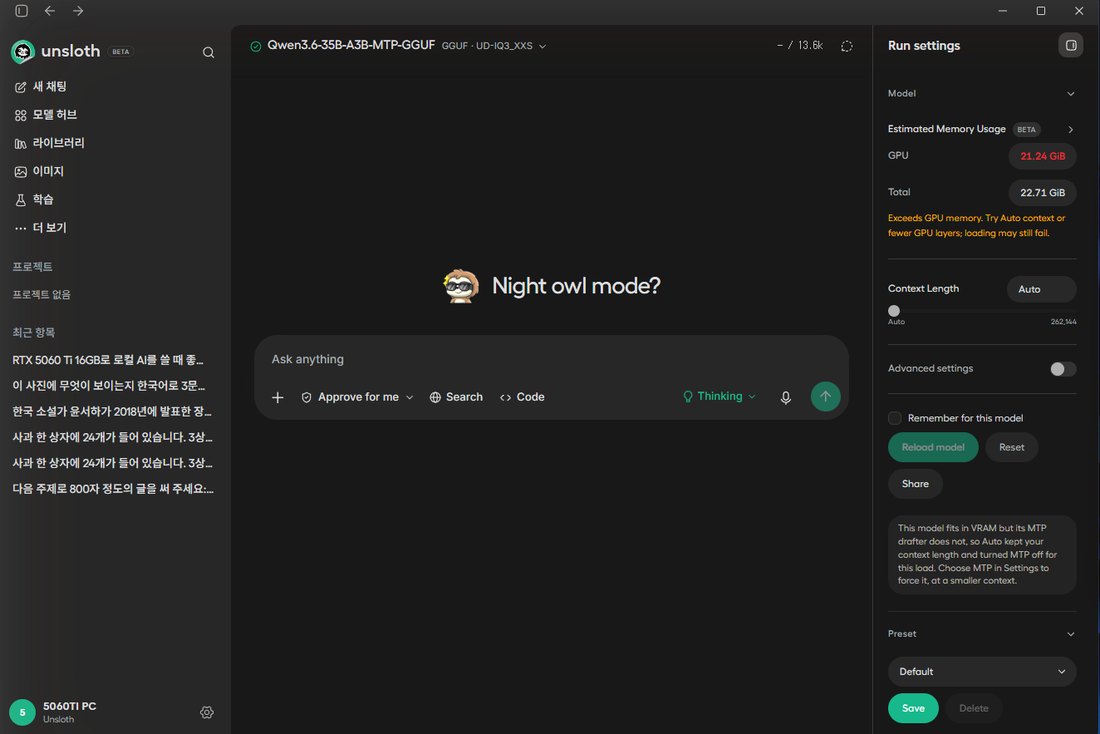
실행 설정 창입니다. 아래쪽 안내문에 "모델은 VRAM에 들어가지만 MTP용 보조 모델은 들어가지 않아서, Auto가 컨텍스트를 지키고 MTP를 껐다"고 적혀 있습니다.
이 창 아래쪽에 Unsloth Studio가 띄운 안내문이 있습니다.
“This model fits in VRAM but its MTP drafter does not”
Unsloth Studio 실행 설정 창
쉽게 말하면, 모델은 그래픽카드에 다 들어가지만 MTP용 보조 모델까지 올릴 자리는 없다는 뜻입니다. MTP는 작은 보조 모델이 다음 토큰을 미리 예측해 속도를 높이는 기능입니다. 저장소 이름에 MTP가 붙어 있어도, 16GB에서는 기본값으로 켜지지 않았습니다. 안내문은 이어서 "설정에서 MTP를 고르면 더 작은 컨텍스트로 강제로 켤 수 있다"고 알려 줍니다.
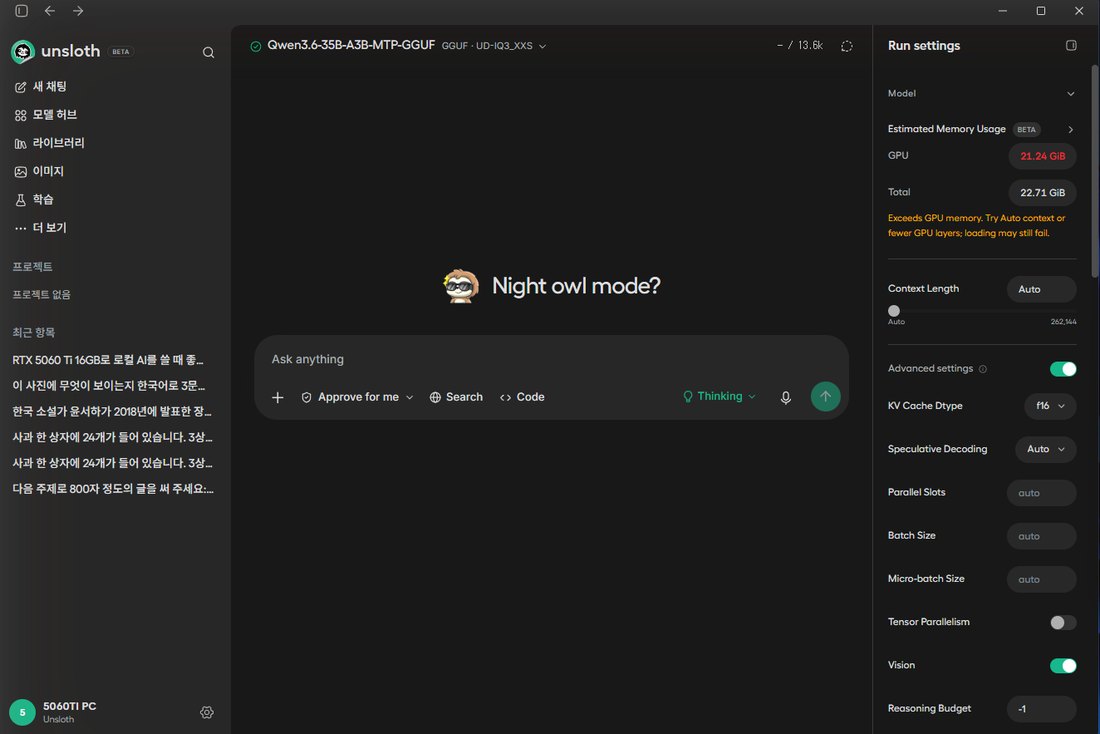
고급 항목의 기본값입니다. KV 캐시 f16, Speculative Decoding Auto, Vision 켬, Reasoning Budget -1(제한 없음)입니다.
Auto로 올렸을 때 실제로 적용된 값은 이렇습니다.
| 설정 | Auto가 고른 값 | 뜻 |
|---|---|---|
| 컨텍스트 | 8,192~16,640 (올릴 때마다 다름) | 그때 남아 있는 VRAM에 맞춰 정하는 것으로 보임. 여러 번 올린 값이 9,472 / 13,312 / 13,568 / 16,128 / 16,384 / 16,640 등 |
| -ngl -1, --fit off | 레이어를 모두 GPU에 | 모델 전체를 그래픽카드에 올림 |
| --spec-type ngram-mod | MTP 대신 ngram 방식 | 앞에 나온 글이 되풀이될 때 그대로 미리 채워 넣는 가속 방식 |
| --no-mmproj-offload | 이미지 입력용 파일은 CPU | VRAM을 아끼는 대신 사진을 읽는 시간이 길어짐 |
| --threads 2 | CPU 스레드 2개 | 모델이 GPU에 다 들어가서 CPU는 적게 씀 |
| KV 캐시 | f16 | 줄이지 않은 기본값 |
Gemma 4 26B A4B QAT 때는 Auto가 컨텍스트 8,192, MTP 켬, --fit on(일부를 시스템 램에)으로 올렸습니다. 같은 Auto라도 모델에 따라 고르는 값이 다릅니다.
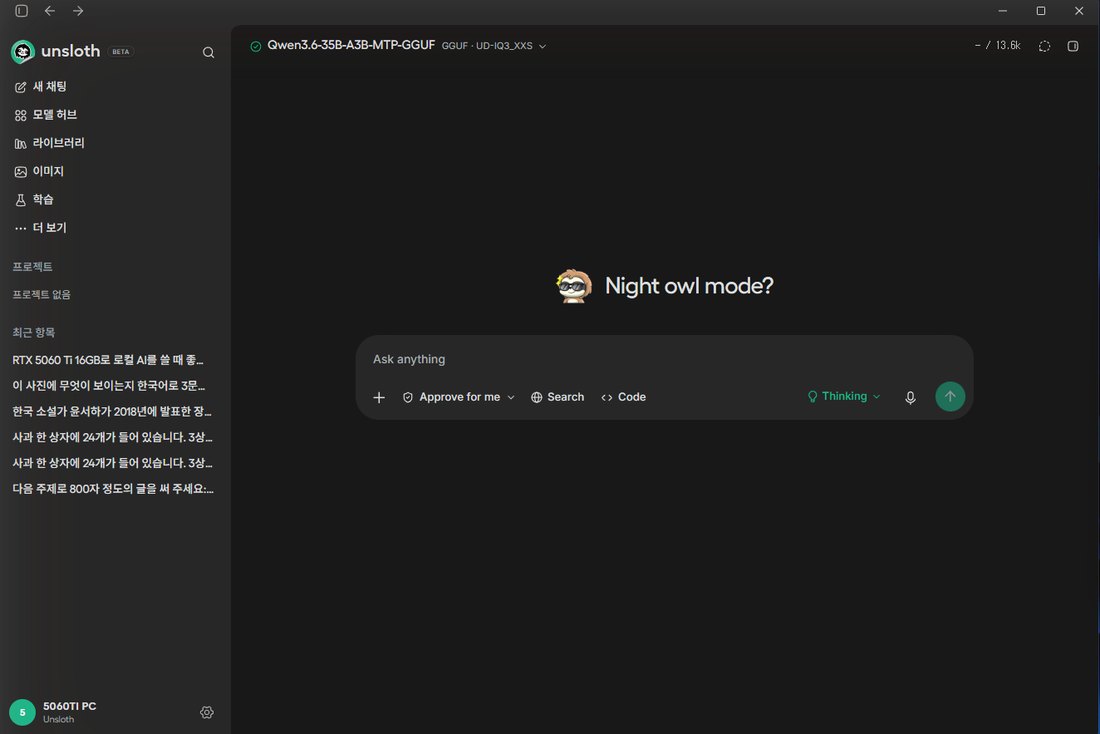
로드가 끝난 화면입니다. 이번에는 컨텍스트가 13.6k로 잡혔습니다.
VRAM과 시스템 램: Auto에서 VRAM 13.2GB, 램 2.1GB
로드 직전과 직후의 GPU 메모리와 PC 전체 램의 차이를 쟀습니다. 로드 전에 윈도우와 다른 프로그램이 VRAM 약 0.7GB, 램 약 9GB를 쓰고 있었습니다.
| 컨텍스트 | 모델이 쓴 VRAM | PC 전체 VRAM | 늘어난 시스템 램 | 로드 시간 | 16GB에서 |
|---|---|---|---|---|---|
| 9,472 (Auto) | 13.2GB | 13.9GB | 2.1GB | 28.1초 (다시 로드 11.6초) | 원활 (남는 VRAM 2.0GB로 경계) |
| 32,768 | 13.5GB | 14.2GB | 1.7GB | 11.7초 | 제한적 |
| 65,536 | 13.7GB | 14.4GB | 2.4GB | 17.5초 | 제한적 |
| 131,072 | 13.6GB | 14.3GB | 3.9GB | 17.9초 | 제한적 |
| 262,144 (최대) | 13.7GB | 14.4GB | 6.6GB | 18.7초 | 제한적 |
Auto와 32,768에서는 시스템 램이 2GB 안팎만 늘었습니다. 이미지 입력용 파일(0.9GB)을 CPU에 두는 몫과 프로그램이 쓰는 몫입니다. 65,536부터는 Unsloth Studio가 --fit on으로 바꿔 올리고, 컨텍스트가 커질수록 시스템 램이 늘었습니다. 넘치는 부분을 시스템 램에 두기 때문이고, 그만큼 속도가 내려갑니다(아래 표).
로드 시간은 디스크에서 처음 읽을 때 28.1초, 모델만 내렸다가 바로 다시 올리면 11.6초였습니다. 이 PC는 SATA SSD라서 NVMe SSD보다 오래 걸립니다.
생성 속도: Auto에서 평균 90.4t/s
"집에 있는 PC로 AI 모델을 돌릴 때 알아야 할 점"으로 800자 글을 쓰게 했습니다. 생각을 끄고 5번 이어서 물었습니다.
| 순서 | 생성 속도 | 첫 토큰까지(TTFT) | 답 토큰 | 전체 시간 |
|---|---|---|---|---|
| 1번째 (로드 직후) | 92.7t/s | 0.65초 | 483 | 5.9초 |
| 2번째 | 90.8t/s | 0.48초 | 614 | 7.2초 |
| 3번째 | 91.3t/s | 0.44초 | 479 | 5.7초 |
| 4번째 | 89.4t/s | 0.46초 | 528 | 6.4초 |
| 5번째 | 87.5t/s | 0.43초 | 425 | 5.3초 |
| 평균 (최소~최대, 표준편차) | 90.4t/s (87.5~92.7, 2.0) | 0.49초 | 506 | 6.1초 |
5번이 고르게 나왔습니다. GPU 사용률은 평균 79%였습니다. Gemma 4 26B A4B QAT는 같은 측정에서 평균 92.4t/s(83.5~96.0), GPU 사용률 42%였습니다. 속도는 비슷한데, 이 모델은 그래픽카드에 다 올라가 있어서 GPU를 더 많이 씁니다.
생각을 켜면: 답까지 36~45초
| 단계 | 생각 끔 | 생각 켬 (3번) |
|---|---|---|
| 모델 로드 (한 번만) | 처음 28.1초, 다시 로드 11.6초 | |
| 질문을 읽고 첫 토큰까지 | 0.4~0.7초 | 약 0.5초 |
| 생각 | 없음 | 약 32~40초 (약 3,700~4,600토큰) |
| 답 쓰기 | 약 5~7초 (425~614토큰) | 약 3~4초 |
| 질문부터 답 끝까지 | 5.3~7.2초 | 36.0 / 35.6 / 44.5초 |
| 생성 속도 | 87.5~92.7t/s | 127.6 / 115.0 / 114.1t/s |
생각을 켜면 걸리는 시간의 90% 가까이가 생각 단계입니다. Gemma 4 26B A4B QAT는 같은 글에 생각을 약 1,300토큰만 써서 17~19초에 끝났습니다. 이 모델은 생각을 세 배쯤 길게 합니다. 생각에 쓴 토큰 수는 프로그램이 따로 알려 주지 않아서 글자 수 비율로 어림한 값입니다.
생각을 켰을 때 속도가 114~128t/s로 더 높게 나온 것은 ngram 가속 때문으로 보입니다(추정). 이 모델은 생각 단계에서 답의 초안을 먼저 쓰고, 답에서 그 글을 거의 그대로 다시 씁니다. 되풀이되는 글은 ngram 방식이 미리 채워 넣습니다.
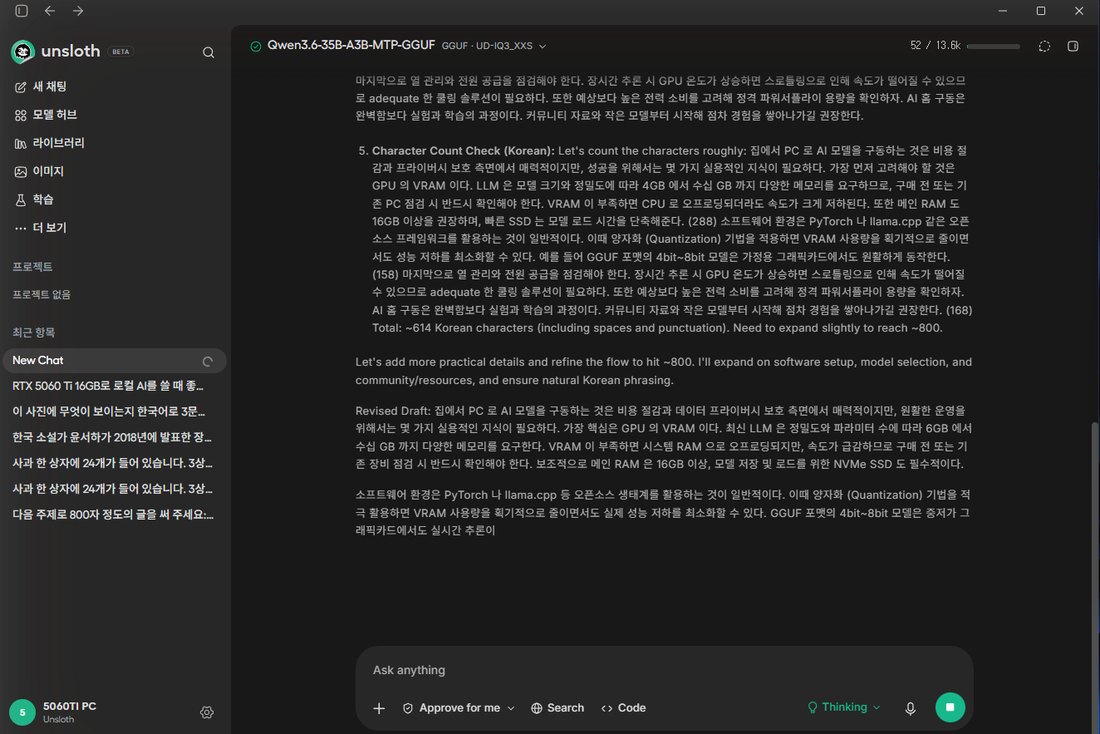
생각하는 중인 화면입니다. 영어로 글의 구조를 짠 뒤, 생각 안에서 한국어 초안을 먼저 씁니다.
컨텍스트를 늘리면: 32,768까지는 그대로
컨텍스트만 바꿔 다시 로드하며 같은 800자 글을 쟀습니다(생각 끔 2번).
| 컨텍스트 | 생성 속도 (생각 끔) | 생각 켬 800자 글 | 15,000자 요약 TTFT | 사진 TTFT |
|---|---|---|---|---|
| 8,192 | 92.6 / 92.5t/s | 19.7초 | 3.8초 | (이 크기에서는 재지 못함) |
| 16,384 | 93.6 / 93.4t/s | 29.7초 | 3.9초 | 27.8초 |
| 32,768 | 93.7 / 93.7t/s | 34.0초 | 3.9초 | 28.1초 |
| 65,536 | 63.9 / 63.4t/s | 82.7초 | 5.1초 | 28.6초 |
| 131,072 | 49.8 / 50.2t/s | 78.2초 | 7.1초 | 29.1초 |
32,768까지는 속도가 그대로이고, 65,536에서 약 32%, 131,072에서 약 47% 느려졌습니다. 긴 문서를 넣어야 한다면 32,768이 속도를 잃지 않는 가장 큰 크기입니다. 그보다 크게 쓰려면 다음 절의 KV 캐시 설정을 함께 바꾸는 편이 낫습니다.
설정을 바꾸면: 빨라지는 설정과 느려지는 조건
기본값(Auto)에서 설정을 하나씩만 바꿔 다시 로드하고, 같은 800자 글을 3번씩 쟀습니다(생각 끔 평균). 설정은 Unsloth Studio API의 로드 옵션으로 바꿨습니다. KV 캐시와 Speculative Decoding은 실행 설정 창의 고급 항목에도 있습니다.
| 설정 | 생성 속도 | 생각 켬 800자 글 | 사진 TTFT | PC 전체 VRAM | 늘어난 시스템 램 |
|---|---|---|---|---|---|
| Auto (기본값, 이때 컨텍스트 13,312) | 88.3t/s | 29.8초 | 69.7초 | 13.9GB | 1.7GB |
| 가속 기능 끔 (Speculative Decoding off) | 86.6t/s | 37.7초 | 69.7초 | 13.8GB | 1.7GB |
| 컨텍스트 8,192 + 레이어 GPU 고정 (MTP가 켜짐) | 96.2t/s | 30.3초 | 10.8초 | 15.6GB | 1.3GB |
이미지 입력용 파일을 GPU에 (--mmproj-offload) | 60.9t/s | 70.3초 | 1.8초 | 14.2GB | 1.5GB |
| 이미지 입력 끔 | 87.2t/s | 24.6초 | - | 14.0GB | 1.0GB |
| 컨텍스트 32,768, KV 캐시 q4_0 | 85.4t/s | 18.5초 | 69.5초 | 13.8GB | 1.7GB |
| 컨텍스트 131,072, KV 캐시 기본(f16) | 약 50t/s | 78.2초 | 29.1초 | 14.3GB | 3.9GB |
| 컨텍스트 131,072, KV 캐시 q4_0 | 66.7t/s | 51.8초 | 28.7초 | 14.2GB | 2.2GB |
| 컨텍스트 262,144, KV 캐시 기본(f16) | 33.4t/s | 75.9초 | 30.2초 | 14.3GB | 6.6GB (최대 17.3GB 사용) |
| 컨텍스트 262,144, KV 캐시 q4_0 | 54.7t/s | 36.0초 | 29.2초 | 14.2GB | 3.4GB |
- MTP를 켜면 약 9% 빨라졌습니다. 컨텍스트를 8,192로 고정하고 레이어를 모두 GPU에 올리자 MTP가 켜졌고, 88.3t/s가 96.2t/s가 됐습니다. 대신 PC 전체 VRAM이 15.6GB까지 찹니다. 모델 카드는 MTP로 1.5~2배 빨라진다고 적었지만, 이 PC에서는 그만큼은 아니었습니다.
- 긴 컨텍스트에는 KV 캐시 q4_0이 효과가 큽니다. KV 캐시는 지금까지 읽은 글을 기억해 두는 공간입니다. 이것을 줄이면 131,072에서 약 50t/s가 66.7t/s로, 262,144에서 33.4t/s가 54.7t/s로 올랐습니다. 줄인 만큼 긴 글에서 답의 정확도가 달라지는지는 재지 않았습니다.
- 최대 컨텍스트 262,144도 쓸 수 있는 속도였습니다. 기본 KV 캐시로도 33.4t/s가 나왔습니다. Gemma 4 26B A4B QAT는 같은 조건에서 9.9t/s였고 시스템 램이 31.7GB까지 찼습니다. 파일은 이 모델이 0.8GB 더 크지만, 긴 컨텍스트에서는 훨씬 잘 버텼습니다.
- 사진을 자주 쓴다면 이미지 입력용 파일을 GPU에 올립니다. 첫 토큰까지 걸리는 시간이 1.8초로 줄었습니다. 대신 글 속도가 60.9t/s로 약 30% 내려갑니다.
- 가속 기능(ngram)을 꺼도 짧은 글 속도는 거의 같았습니다. 생각을 켠 글에서만 29.8초가 37.7초로 늘었습니다.
측정할 때 조심할 점이 하나 있습니다. API로 넘긴 추가 옵션(llama_extra_args)은 그다음 로드에도 남습니다. 그래서 설정마다 빈 목록을 먼저 보내 앞 설정이 섞이지 않게 했습니다.
다른 곳의 측정과 견주기
같은 모델을 잰 다른 글 두 편과 조건을 나란히 놓았습니다. 두 글의 숫자는 각 글쓴이가 잰 값입니다.
| 항목 | 이 글 | njannasch.dev (2026년 4월) | InsiderLLM (2026년 4월, 9월 수정) |
|---|---|---|---|
| 그래픽카드 | RTX 5060 Ti 16GB | RTX 5060 Ti 16GB | RTX 3090 24GB / RTX 3060 12GB |
| 파일 | UD-IQ3_XXS 14.07GB | IQ3_S | UD-Q4_K_M |
| 프로그램 | Unsloth Studio (llama.cpp build 11160) | llama.cpp b8838 | llama-bench, llama-server |
| 컨텍스트 | Auto(약 9,000~17,000) / 262,144 | 262,144 | 빈 상태~8K |
| KV 캐시 | f16 / q4_0 | q4_0 | 적혀 있지 않음 |
| MTP | 꺼짐 (Auto) | 쓰지 않음 | 쓰지 않음 / 3090에서 켬 |
| 생성 속도 | Auto 90.4t/s, 262,144 + q4_0에서 54.7t/s | 짧은 글 97t/s, 500토큰 글 78t/s, 10만 8천 토큰을 채운 뒤 46t/s | 3090: 157.7t/s (MTP 켜면 172.0), 3060: 38.9t/s |
같은 RTX 5060 Ti인 첫 번째 글은 컨텍스트 262,144, KV 캐시 q4_0에서 500토큰 글이 78t/s였습니다. 이 글은 같은 조건에서 54.7t/s였습니다. 차이가 나는 까닭으로 세 가지를 짐작할 수 있습니다. 먼저 Unsloth Studio는 이 크기에서 --fit on으로 일부를 시스템 램에 둡니다. 또 병렬 슬롯을 4개로 잡습니다(--parallel 4). 그리고 이 PC의 CPU는 2018년에 나온 6코어입니다. 어느 것이 얼마나 영향을 주는지는 따로 재지 않았습니다. 두 번째 글은 4비트 파일이 VRAM에 다 들어가는 RTX 3090에서 157.7t/s, 다 들어가지 않는 RTX 3060 12GB에서 38.9t/s였습니다. 16GB에서 3비트 파일로 잰 이 글의 90.4t/s는 그 사이에 있습니다.
화면에서 돌린 영상
새 채팅을 열고 질문 하나를 보낸 영상입니다(13초, 소리 없음, 생각 끔).
영상에는 초당 56.8토큰으로 찍혔습니다. 화면 녹화 프로그램이 CPU를 100% 가까이 쓰는 동안 찍었기 때문에 표의 숫자(약 90t/s)보다 느립니다. 같은 방법으로 찍은 Gemma 4 26B A4B QAT는 초당 15토큰까지 떨어졌습니다. 이 모델은 그래픽카드에 다 올라가 있어서 CPU가 바빠도 덜 느려집니다. 답의 내용에는 확인되지 않은 말이 섞여 있습니다(전력 소모를 다른 그래픽카드와 견준 문장 등). 속도를 보여 주려는 영상이니 내용은 참고하지 마세요. 녹화에 쓴 프로그램은 103번 글에서 소개했습니다.
산수: 생각을 끄면 0/5, 켜면 5/5
"사과 한 상자에 24개가 들어 있습니다. 3상자를 사서 19개를 먹고, 남은 것을 5명이 똑같이 나누면 한 사람당 몇 개이고 몇 개가 남나요? '한 사람당 X개, 남는 것 Y개' 형식으로만 답하세요."를 5번씩 물었습니다. 정답은 한 사람당 10개, 남는 것 3개입니다.
| 생각 | 정답 | 답 | 걸린 시간 |
|---|---|---|---|
| 끔 | 0 / 5 | "4개, 2개" 2번, "4개, 0개", "10개, 9개", "9개, 4개" | 약 0.6초 |
| 켬 | 5 / 5 | "10개, 3개" 5번 | 4.9~10.2초 (생각 약 450~860토큰) |
생각을 끄면 계산 없이 바로 답을 적어서 틀리고, 답도 매번 달랐습니다. 형식을 지키지 않은 답도 3번 있었습니다. 계산이 들어가는 질문에는 생각을 켜야 합니다.
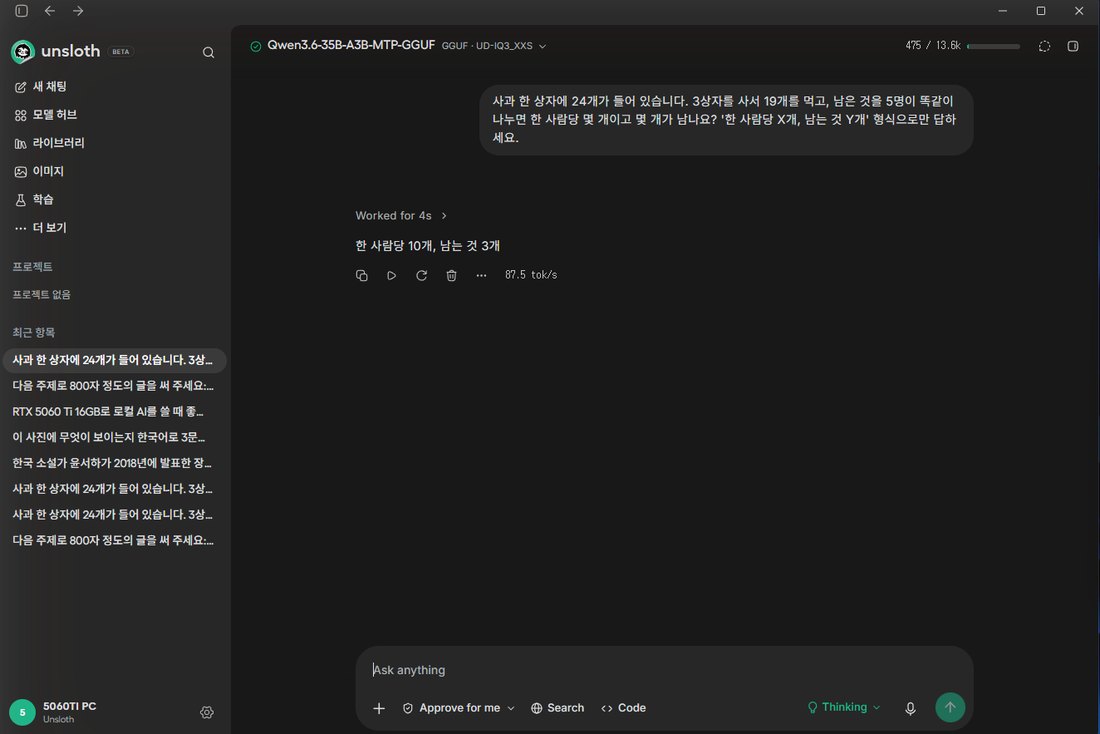
생각을 켠 답입니다. 4초 생각한 뒤 "한 사람당 10개, 남는 것 3개"로 맞혔습니다.
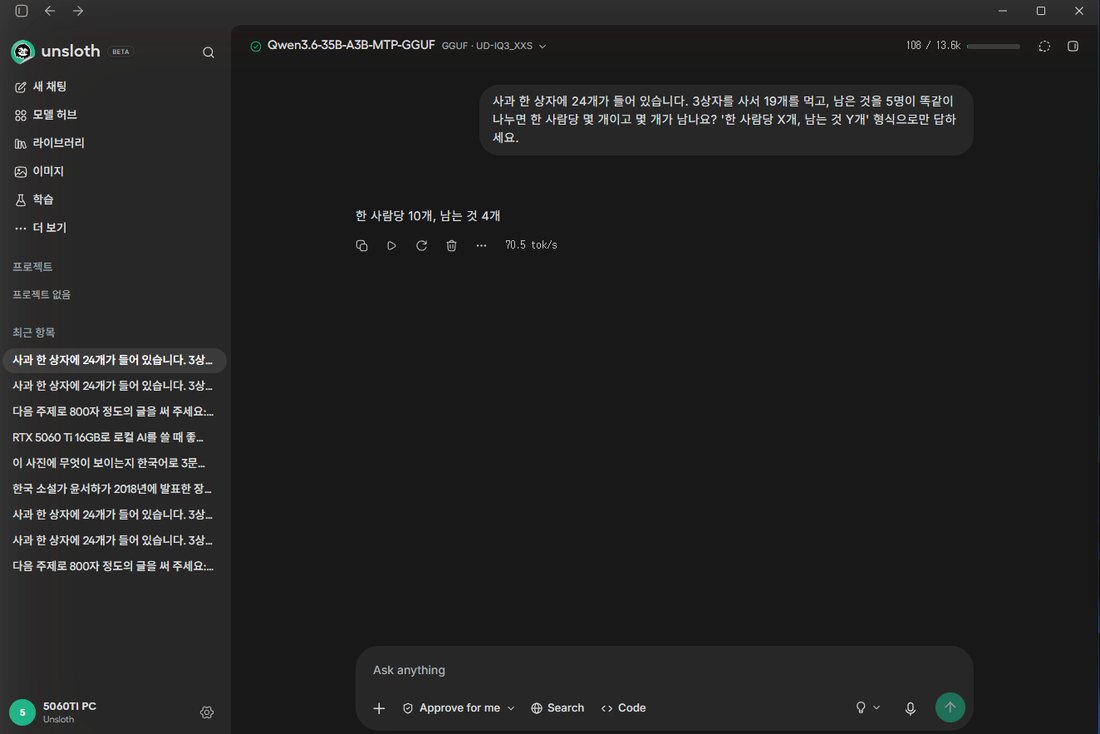
생각을 끈 답입니다. "한 사람당 10개, 남는 것 4개"로 틀렸습니다.
코딩: 파이썬 8문제를 3번씩, 생각 끔 18/24 · 켬 20/24
파이썬 함수 8개를 짜게 하고, 숨겨 둔 테스트로 채점했습니다. 문제는 구간 합치기, 로마 숫자 변환, 수식 계산기, 가장 긴 회문, 다음 영업일, 많이 나온 낱말, 나선 순서, 한글 숫자를 정수로 바꾸기입니다. 컨텍스트는 Auto이고, 8문제를 처음부터 끝까지 3번 풀게 했습니다.
| 생각 | 1회 | 2회 | 3회 | 합계 | 8문제 전체 시간 |
|---|---|---|---|---|---|
| 끔 (답 최대 2,000토큰) | 7 / 8 | 5 / 8 | 6 / 8 | 18 / 24 | 35~49초 |
| 켬 (최대 8,000토큰) | 6 / 8 | 7 / 8 | 7 / 8 | 20 / 24 | 5분 36초~5분 45초 |
| 문제 | 생각 끔 (3번 중) | 생각 켬 (3번 중) |
|---|---|---|
| 구간 합치기, 로마 숫자, 다음 영업일, 나선 순서 | 3번 모두 통과 | 3번 모두 통과 |
| 수식 계산기 | 1번 통과 (2번은 실행 중 오류) | 3번 모두 통과 |
| 많이 나온 낱말 | 2번 통과 | 3번 모두 통과 |
| 가장 긴 회문 | 3번 모두 통과 | 2번 통과 (1번은 길이가 같은 다른 답을 냄) |
| 한글 숫자를 정수로 | 0번 | 0번 (3번 모두 8,000토큰 안에 못 끝냄) |
Gemma 4 26B A4B QAT는 같은 문제에서 생각 끔 19/24, 켬 21/24였습니다. 이 PC에서 낸 8문제로는 두 모델의 차이가 한 문제 안쪽입니다. 제작사 벤치마크의 큰 차이는 여기서 보이지 않았습니다. 다만 이 글은 3비트 파일이고, 문제도 함수 하나를 짜는 짧은 문제입니다. 제작사가 내세우는 저장소 단위 작업(SWE-bench)과는 종류가 다릅니다. 한글 숫자 문제("삼천이백오십일"을 3251로)는 두 모델 모두 여섯 번 다 실패했습니다.
긴 글 요약과 긴 대화
컨텍스트 32,768로 올리고 이 블로그의 업데이트 기록을 넣어 세 문장으로 요약하게 했습니다(생각 끔).
| 넣은 글 | TTFT | 생성 속도 | 결과 |
|---|---|---|---|
| 3,000자 | 1.4초 | 90.7t/s | 세 문단, 내용 맞음 |
| 15,000자 | 3.4초 | 89.2t/s | 세 문단, 게임 이름 '한알한알'을 '한알한글'로 잘못 적음 |
대화가 길어질 때를 보려고, 앞에 긴 글을 두고 한 문장짜리 질문을 붙였습니다.
| 앞에 쌓인 토큰 | TTFT | 생성 속도 |
|---|---|---|
| 1,017 | 1.1초 | 89.0t/s |
| 7,861 | 3.9초 | 87.8t/s |
| 19,123 | 6.2초 | 83.3t/s |
약 1만 9천 토큰이 쌓여도 속도는 83.3t/s로 7%만 내려갔습니다. Gemma 4 26B A4B QAT는 비슷한 길이에서 69.9t/s까지 내려갔습니다.
긴 문서에서 정보 찾기: 5번 모두 찾음
약 9,500토큰짜리 글의 10%, 30%, 50%, 70%, 90% 위치에 "블로그 관리자가 키우는 고양이 보리차는 2019년에 태어났다"는 문장을 하나 숨기고, 고양이 이름과 태어난 해를 물었습니다. 5번 모두 보리차와 2019를 찾았습니다. 한 번은 정해 준 형식 대신 "보리차: 2019"라고만 답했습니다. 문장을 숨기지 않은 글에서는 "없음"이라고 답했습니다.
전력과 온도: 평균 약 94W, 최고 63도
800자 글을 쓰는 동안 0.5초마다 그래픽카드 상태를 읽었습니다(컨텍스트 32,768, 생각 끔, 2번).
| 항목 | Qwen3.6 35B A3B | Gemma 4 26B A4B QAT |
|---|---|---|
| 쉬고 있을 때 전력 | 약 13W | 약 11.5W |
| 글 쓰는 동안 평균 전력 | 91~97W | 60~62W |
| 최고 전력 | 123W | 78W |
| 최고 온도 | 61~63도 | 48~49도 |
| 평균 GPU 사용률 | 72% | 35~36% |
| 토큰 하나에 쓴 전기 | 약 1.1J | 약 0.75J |
그래픽카드가 하는 일이 많은 만큼 전기를 더 씁니다. 그래도 전력 제한 180W의 절반 정도입니다.
없는 소설과 사진
실제로 없는 소설("윤서하의 2018년 장편소설 『푸른 등대의 겨울』")의 줄거리를 2번 물었습니다. 2번 모두 그런 작품은 확인되지 않는다고 답했고 줄거리를 지어내지 않았습니다. 다만 "혹시 이 작품을 찾으시나요" 하며 다른 작가의 책을 예로 들었는데, 그중에는 실제와 다른 제목이 섞여 있었습니다(김애란의 『바깥은 여름』을 『바깥은 겨울』로 적는 식).
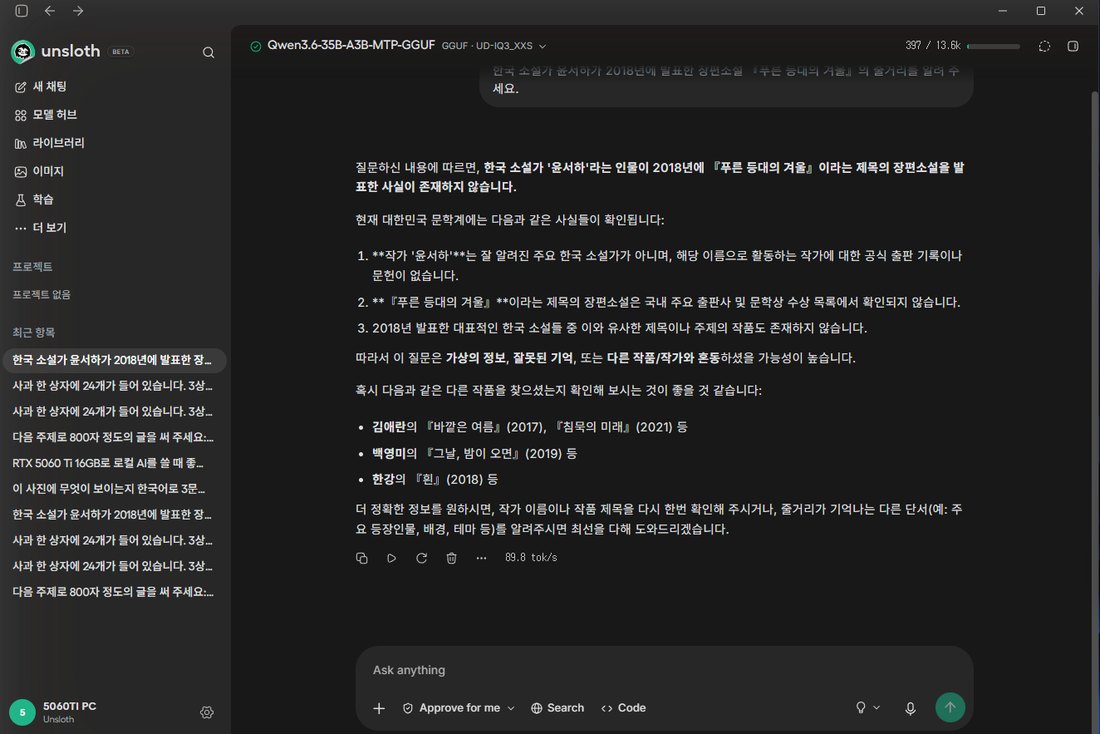
없는 소설을 물은 화면입니다. 존재하지 않는다고 답한 뒤, 찾는 책일 수 있다며 다른 작가의 책을 예로 들었습니다.
모래시계 두 개가 놓인 사진을 주고 무엇이 보이는지 물었습니다. 설정을 바꿔 가며 API로 9번 물었고, 오른쪽 모래시계 안에 "전자 부품"이나 "회로"가 들어 있다고 맞게 말한 것이 7번, "기계 부품과 전선"이라고 한 것이 2번이었습니다. Gemma 4 26B A4B QAT는 13번 중 7번이었습니다.
사진을 읽는 시간은 깁니다. 첫 토큰까지 28~70초가 걸렸습니다. 이미지 입력용 파일을 CPU에 두기 때문입니다. 같은 기본값인데도 28초일 때와 70초일 때가 있었고, 왜 갈리는지는 확인하지 못했습니다. 사진 한 장에 1분을 기다려야 하면 쓰기 어렵습니다. 사진을 쓸 계획이면 위 설정 표처럼 이미지 입력용 파일을 GPU에 올려야 합니다(1.8초).
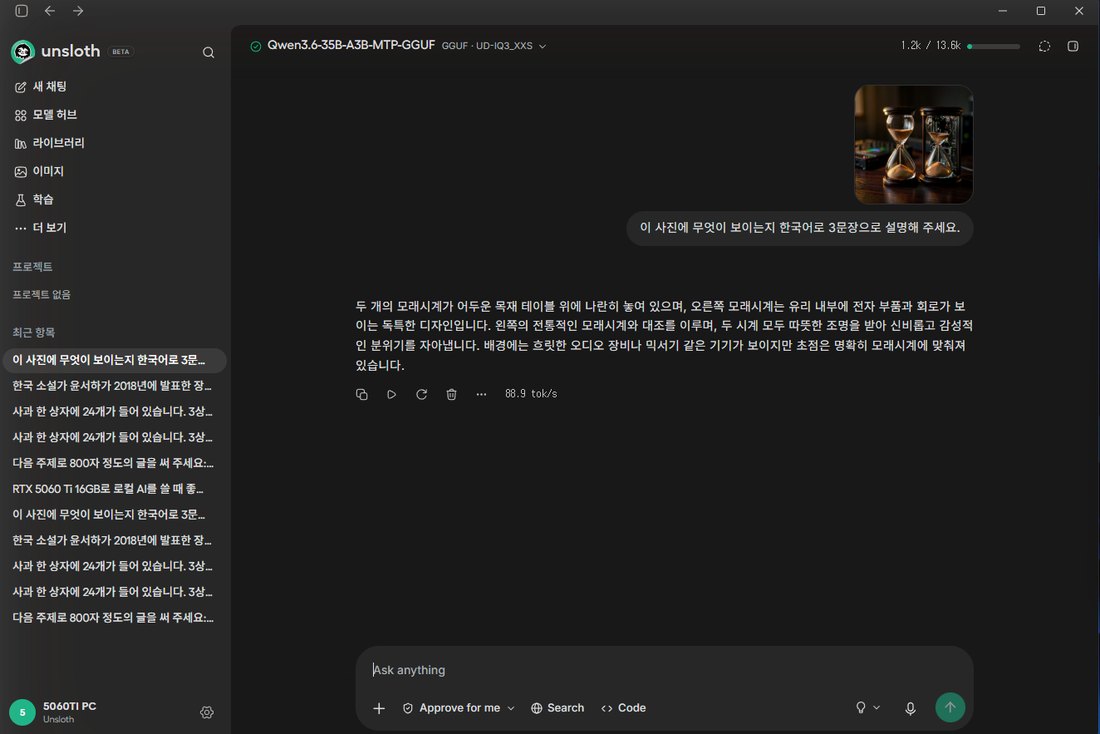
사진을 붙여 넣고 물은 화면입니다. 설명은 맞았지만 답이 시작되기까지 1분 가까이 기다렸습니다.
한국어 답 23개를 모두 확인했는데, 한자나 다른 나라 글자가 섞인 답은 없었습니다. 생각 내용은 영어로 나옵니다.
정리: 같은 PC의 Gemma 4 26B A4B QAT와 비교
하루 차이로 같은 PC, 같은 프로그램, 같은 질문으로 잰 두 MoE 모델입니다.
| 항목 | Qwen3.6 35B A3B | Gemma 4 26B A4B QAT |
|---|---|---|
| 파일 | UD-IQ3_XXS 14.07GB (3비트) | UD-Q4_K_XL 13.27GB (4비트, QAT) |
| Auto 컨텍스트 | 8,192~16,640 | 8,192 |
| Auto에서 MTP | 꺼짐 | 켜짐 |
| Auto 속도 (5번 평균) | 90.4t/s | 92.4t/s |
| VRAM / 늘어난 시스템 램 | 13.2GB / 2.1GB | 14.1GB / 3.5GB |
| GPU 사용률 | 79% | 42% |
| 다시 로드 시간 | 11.6초 | 22.8초 |
| 생각 켬 800자 글 | 36~45초 | 17~19초 |
| 컨텍스트 32,768 | 약 94t/s | 약 92t/s |
| 컨텍스트 131,072 (기본 / KV q4_0) | 약 50 / 66.7t/s | 약 63 / 79.1t/s |
| 컨텍스트 262,144 (기본 / KV q4_0) | 33.4 / 54.7t/s | 9.9 / 62.9t/s |
| 산수 (끔 / 켬) | 0/5, 5/5 | 0/5, 5/5 |
| 코딩 8문제 3번 (끔 / 켬) | 18/24, 20/24 | 19/24, 21/24 |
| 사진 TTFT (기본값) | 28~70초 | 약 30초 |
| 평균 전력 | 91~97W | 60~62W |
| 녹화하면서 돌릴 때 | 56.8t/s | 15.0t/s |
- 16GB에 다 들어가는 35B 모델입니다. 3비트 파일이 VRAM 13.2GB에 올라가고 약 90t/s가 나옵니다. 그래픽카드에 다 올라가 있어서 CPU가 느리거나 바빠도 속도가 덜 흔들립니다.
- 속도는 Gemma 4 26B A4B QAT와 같습니다. 차이는 생각 시간입니다. 생각을 켜면 이 모델이 두 배쯤 오래 걸립니다. 빨리 답을 받는 용도라면 생각을 끄거나 Gemma 쪽이 낫습니다.
- 이 PC에서 낸 문제로는 두 모델의 정답 수가 거의 같았습니다. 산수는 같고, 코딩은 한 문제 차이입니다. 3비트 파일과 4비트 QAT 파일의 비교라는 점도 감안해야 합니다.
- 컨텍스트는 32,768까지가 속도를 잃지 않는 선입니다. 더 길게 쓰려면 KV 캐시를 q4_0으로 줄입니다. 최대 262,144에서도 약 55t/s였습니다.
- 사진은 기본값으로는 쓰기 어렵습니다. 이미지 입력용 파일을 GPU에 올리는 설정으로 바꿔야 합니다.
16GB 그래픽카드에서 Gemma 4 12B를 잰 결과는 82번 글에, 내 그래픽카드에서 다른 모델이 어느 정도 속도로 도는지는 GPU 체험에 있습니다.
이 글의 한계
- 2026년 10월 5일, Unsloth Studio 2026.9.14(llama.cpp build 11160) 기준입니다. 베타 프로그램이라 버전이 바뀌면 Auto가 고르는 값과 속도가 달라질 수 있습니다.
- UD-IQ3_XXS 파일 하나만 쟀습니다. 더 큰 3비트 파일(IQ3_S 15.35GB)이나 4비트 파일은 재지 않았습니다. 3비트와 4비트의 답 품질 차이도 재지 않았습니다.
- 5번 반복은 기본값(Auto)의 생각 끔 800자 글에만 했습니다. 컨텍스트별 표는 2번씩, 설정 비교 표는 3번씩 잰 값이고 사진과 요약은 조건마다 한 번입니다.
- Auto가 고르는 컨텍스트가 올릴 때마다 달랐습니다(8,192~16,640). 표마다 Auto 컨텍스트가 조금씩 다릅니다.
- 사진 TTFT가 28초일 때와 70초일 때가 왜 갈리는지 정확한 원인은 확인하지 못했습니다.
- 설정에서 MTP만 따로 고르는 방법(Speculative Decoding을 MTP로)은 재지 않았습니다. MTP가 켜진 값은 레이어를 GPU에 고정하고 컨텍스트를 8,192로 준 조합 하나입니다.
- 프로그램을 켠 직후의 첫 실행은 따로 재지 않았습니다.
- KV 캐시를 줄였을 때 답의 품질이 달라지는지는 재지 않았습니다.
- 컨텍스트를 실제로 10만 토큰 넘게 채운 상태의 속도는 재지 않았습니다. 가장 길게 채운 것이 약 1만 9천 토큰입니다.
- 코딩 문제는 직접 만든 짧은 8문제입니다. 제작사가 내세우는 저장소 단위 코딩 작업은 시험하지 않았습니다.
- 영상 입력은 시험하지 않았습니다.
- 생각에 쓴 토큰 수는 글자 수 비율로 어림한 값입니다.
자주 묻는 질문
RTX 5060 Ti 16GB에서 Qwen3.6 35B A3B는 몇 t/s인가요?
UD-IQ3_XXS(14.07GB) 파일을 Unsloth Studio 기본값으로 돌렸을 때 800자 글 기준 평균 90.4t/s(87.5~92.7)였습니다. 컨텍스트 32,768까지는 속도가 같고, 131,072에서는 약 50t/s, KV 캐시를 q4_0으로 줄이면 66.7t/s입니다.
16GB 그래픽카드에는 어떤 파일을 받아야 하나요?
4비트 파일(UD-Q4_K_M 22.66GB)은 들어가지 않습니다. 이 글에서는 3비트 UD-IQ3_XXS(14.07GB)를 썼고, VRAM 13.2GB에 다 올라갔습니다. 이미지 입력용 파일 0.9GB를 함께 받습니다.
저장소 이름에 MTP가 있는데 왜 MTP가 안 켜지나요?
Unsloth Studio가 "모델은 VRAM에 들어가지만 MTP용 보조 모델은 들어가지 않는다"며 기본값에서 껐습니다. 컨텍스트를 8,192로 줄이고 레이어를 모두 GPU에 올리자 MTP가 켜졌고, 속도는 88.3t/s에서 96.2t/s가 됐습니다.
Gemma 4 26B A4B와 비교하면 어떤가요?
기본값 속도는 약 90t/s와 약 92t/s로 비슷합니다. Qwen3.6 35B A3B는 VRAM에 다 들어가서 긴 컨텍스트와 CPU가 바쁜 상황에서 더 잘 버텼고, 생각을 켰을 때는 두 배쯤 오래 걸렸습니다. 이 PC에서 낸 산수와 코딩 문제의 정답 수는 거의 같았습니다.
댓글 0개