설정은 많지만 처음에 알아야 할 것은 세 가지입니다. 컨텍스트, 생각(Thinking), 온도입니다. 가장 효과가 컸던 것은 생각입니다. Qwen3.8 27B는 생각을 끄면 채점 질문 정답률이 73%였고, 가장 낮은 단계인 Low만 켜도 99%가 됐습니다. 컨텍스트는 속도를 바꿨습니다. 16GB 그래픽카드에서 컨텍스트를 숫자로 정하자 초당 약 52토큰이 약 94토큰이 됐습니다. 이 글은 로컬 AI 시작하기 가이드의 5편입니다.
- 컨텍스트: 모델이 한 번에 기억하는 글의 길이입니다. 16GB에서는 Auto 대신 32768로 정하면 빨랐습니다.
- 생각(Thinking): 계산과 추론이 필요하면 켭니다. 평소에는 Low로 충분했습니다.
- 온도: 답의 다양함을 정합니다. 기본값 그대로 둡니다. 온도를 바꿔도 틀린 계산은 고쳐지지 않았습니다.
- 생각과 컨텍스트는 서로 얽혀 있습니다. 생각이 컨텍스트를 다 써 버리면 답이 한 글자도 나오지 않았습니다.
이 글의 숫자는 모두 이 블로그가 직접 잰 값이고, 숫자마다 잰 글을 링크했습니다. 화면은 Unsloth Studio 기준이며 2026년 10월 초에 찍은 캡처입니다. 모델과 그래픽카드가 다르면 알맞은 값도 달라집니다.
이 글의 내용을 20초로 요약한 영상입니다(소리 없음).
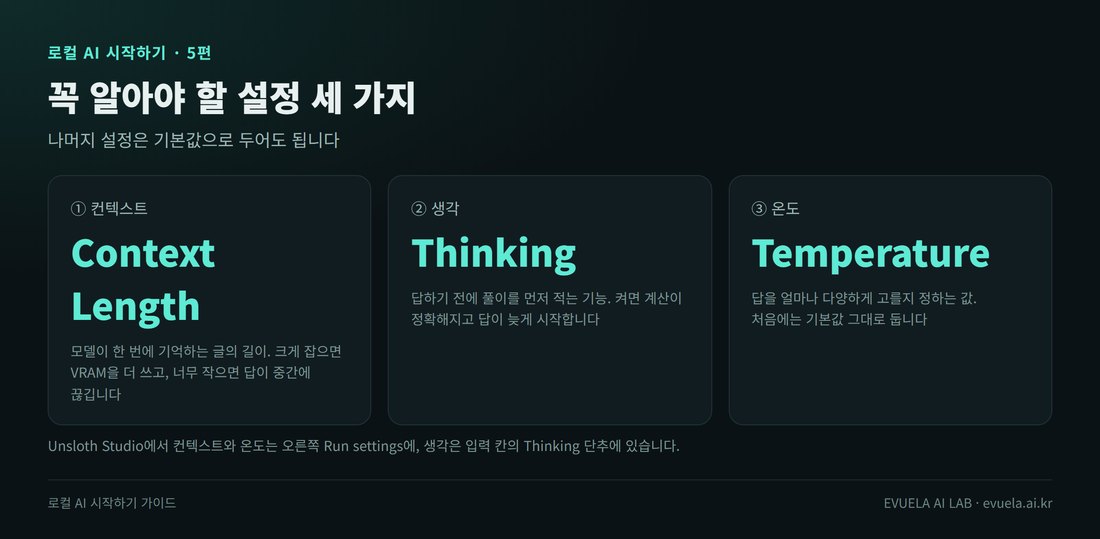
나머지 설정은 처음에는 기본값으로 두어도 됩니다.
① 컨텍스트: 모델이 한 번에 기억하는 길이
컨텍스트는 모델이 한 번에 볼 수 있는 글의 길이이고, 단위는 토큰입니다. 내 질문, 모델의 답, 넣은 문서, 그리고 생각 과정까지 모두 여기에 들어갑니다. 컨텍스트를 넘으면 앞부분을 잊거나 답이 중간에 끊깁니다.
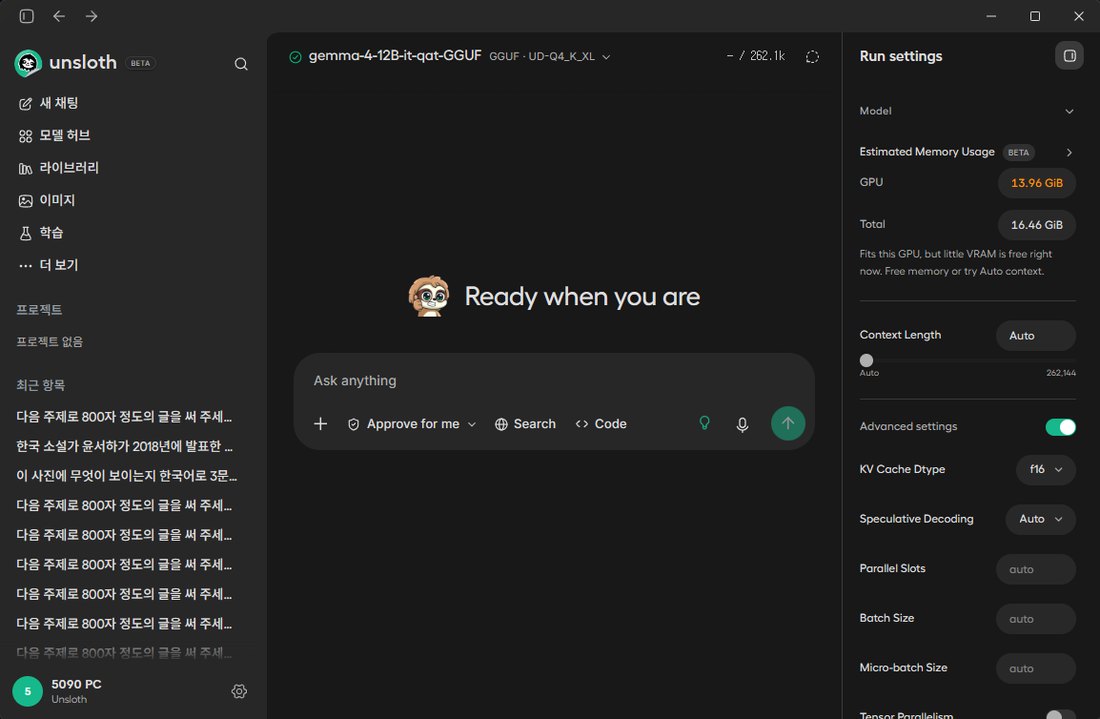
오른쪽 Run settings의 Context Length에서 정합니다. 기본값은 Auto입니다.
| 컨텍스트 | 어느 정도인가 | 맞는 쓰임새 |
|---|---|---|
| 8,192 | 짧은 대화 몇 번 | LM Studio의 기본값이었습니다. 생각을 켜면 모자랄 수 있습니다 |
| 32,768 | 긴 대화, 문서 몇 쪽 | 처음에 권하는 값입니다 |
| 131,072 | 아주 긴 문서 | 긴 문서 요약. VRAM이 남는 모델에서 씁니다 |
| 262,144 | 요즘 모델 다수의 최대값 | VRAM을 많이 씁니다. 꼭 필요할 때만 |
이 표가 뜻하는 것: 컨텍스트는 클수록 좋은 것이 아닙니다. 크게 잡으면 VRAM을 더 쓰고, VRAM이 빠듯한 모델은 느려집니다. 쓸 만큼만 잡습니다. Qwen3.5 9B는 16GB에서 컨텍스트 131,072까지 VRAM에 다 들어갔고, 10만 자 문서의 요약이 19초 안에 시작됐습니다(98번 글).
16GB에서는 숫자로 정하면 빨라졌다
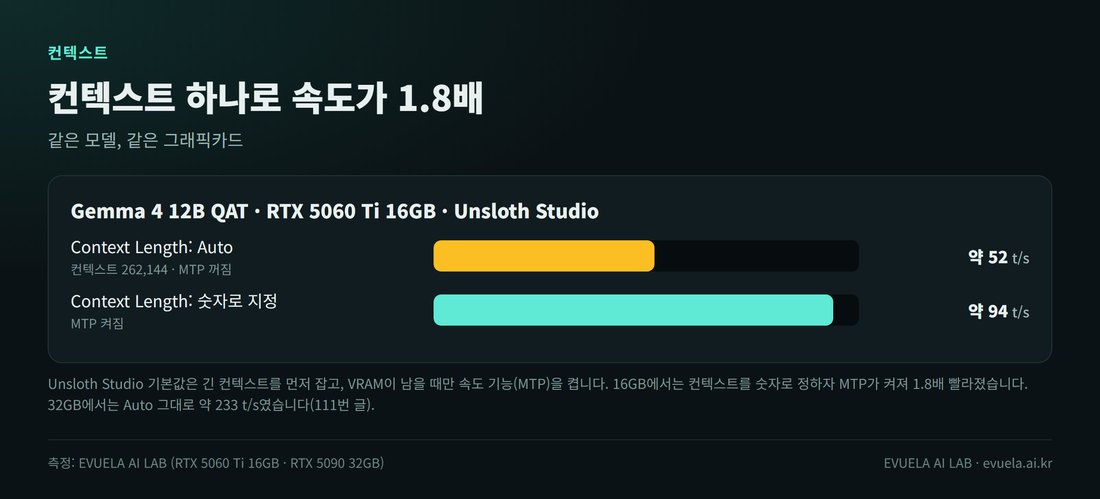
같은 모델인데 컨텍스트 설정 하나로 1.8배 차이가 났습니다.
Unsloth Studio의 Auto는 긴 컨텍스트를 먼저 잡고, VRAM이 남을 때만 속도 기능(MTP)을 켭니다. 32GB에서는 둘 다 들어가서 Auto 그대로 약 233 t/s였습니다. 16GB에서는 Auto가 컨텍스트를 262,144로 잡느라 MTP를 껐고, 약 52 t/s였습니다. Context Length를 숫자로 정하자 MTP가 켜져 약 94 t/s가 됐습니다(111번 글).
모델이 VRAM을 거의 다 쓰는 경우에는 반대로 컨텍스트를 늘릴수록 느려집니다. Qwen3-Coder 30B A3B는 기본값에서 약 145 t/s였는데 컨텍스트 32,768에서 약 69 t/s, 131,072에서 약 25 t/s였습니다(115번 글). 자세한 표는 4편에 있습니다.
② 생각(Thinking): 답하기 전에 풀이를 적는 기능
생각 기능이 있는 모델은 답을 쓰기 전에 풀이를 먼저 적어 봅니다. 사람으로 치면 암산하지 않고 종이에 적어 가며 푸는 것과 같습니다. 그만큼 답이 늦게 시작하지만 계산과 추론이 정확해집니다.
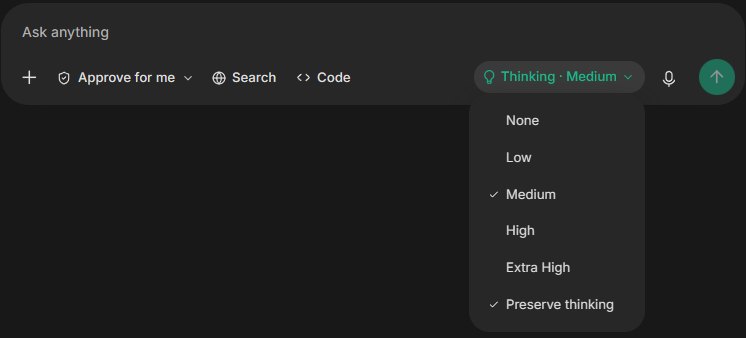
입력 칸의 Thinking 단추를 누르면 단계를 고를 수 있습니다. 모델에 따라 켬과 끔만 있는 것도 있습니다.
Low만 켜도 정답률이 크게 올랐다
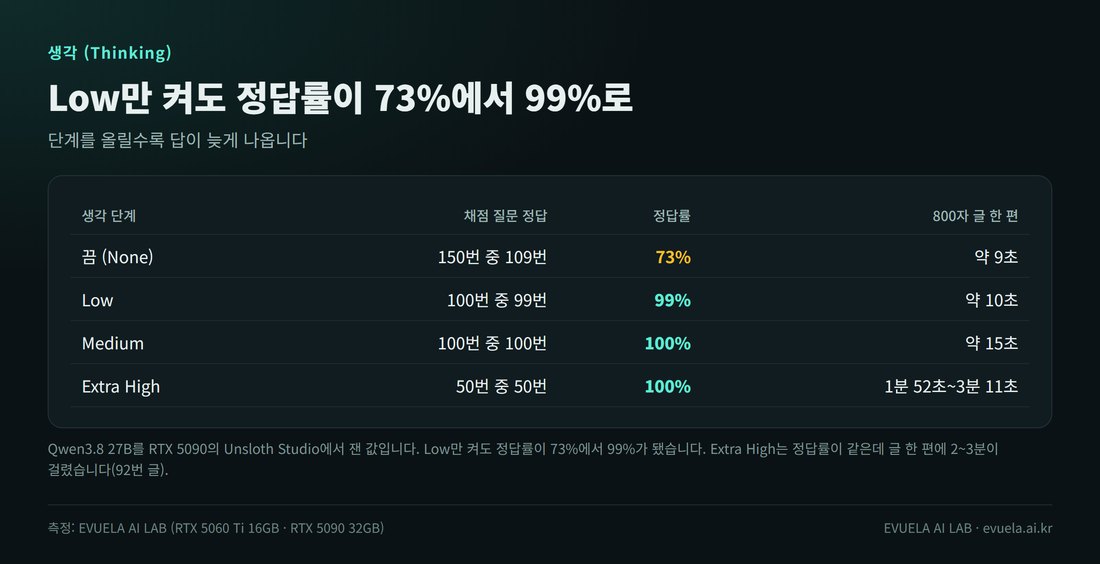
Qwen3.8 27B를 RTX 5090의 Unsloth Studio에서 잰 값입니다.
| 생각 단계 | 채점 질문 정답 | 800자 글 한 편 |
|---|---|---|
| 끔 (None) | 150번 중 109번 (73%) | 약 9초 |
| Low | 100번 중 99번 (99%) | 약 10초 |
| Medium | 100번 중 100번 | 약 15초 |
| Extra High | 50번 중 50번 | 1분 52초~3분 11초 |
이 표가 뜻하는 것: 생각을 끄면 "48,000원에서 25%, 다시 10%를 할인하면 얼마인가" 같은 문제를 자주 틀렸습니다. Low만 켜도 거의 다 맞혔고, 글 한 편에 걸리는 시간은 1초 늘었습니다. Extra High는 정답률이 같은데 글 한 편에 생각만 9천~1만 5천 토큰을 써서 2~3분이 걸렸습니다(92번 글).
다른 모델도 계산은 생각을 켜야 맞았다
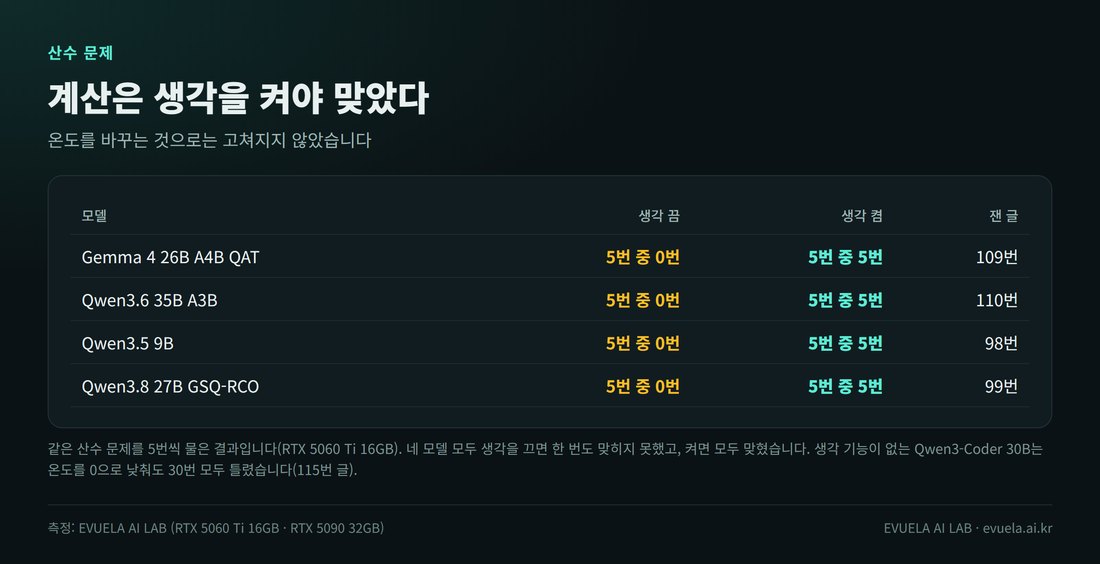
RTX 5060 Ti 16GB에서 같은 산수 문제를 5번씩 물은 결과입니다.
문제는 이것입니다. "사과 한 상자에 24개가 들어 있습니다. 3상자를 사서 19개를 먹고, 남은 것을 5명이 똑같이 나누면 한 사람당 몇 개이고 몇 개가 남나요?" 답만 쓰게 했을 때 네 모델 모두 생각을 끄면 5번 다 틀렸고, 켜면 5번 다 맞혔습니다. Gemma 4 12B도 같았습니다(82번 글).
대신 답이 늦게 시작한다
| 모델 | 생각 끔 | 생각 켬 | 잰 글 |
|---|---|---|---|
| Qwen3.6 35B A3B (16GB) | 800자 글 5~7초 | 36~45초. 생각에만 약 3,700~4,600토큰 | 110번 |
| Qwen3.5 9B (16GB) | 10초 안에 끝남 | 2분 넘게 걸릴 수 있음 | 98번 |
이 표가 뜻하는 것: 생각에 쓰는 시간은 모델마다 많이 다릅니다. 글 쓰기, 요약, 번역처럼 계산이 없는 일은 생각을 끄면 훨씬 빨리 끝납니다. 계산, 논리 문제, 코드의 잘못 찾기처럼 따져 봐야 하는 일에는 켭니다.
생각이 컨텍스트를 다 쓰면 답이 안 나온다
생각 과정도 컨텍스트에 들어갑니다. 그래서 컨텍스트가 작은데 생각 단계가 높으면, 생각만 하다가 컨텍스트가 꽉 차서 답이 한 글자도 나오지 않을 수 있습니다.
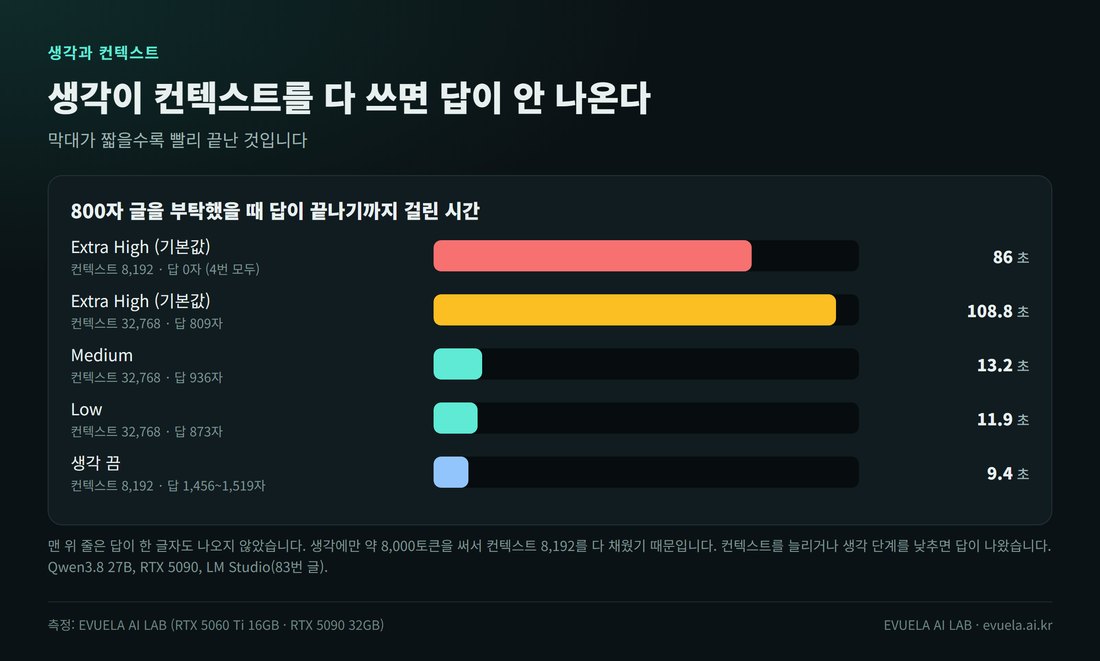
맨 위 줄은 답이 한 글자도 나오지 않았습니다.
| 생각 단계 | 컨텍스트 | 답 | 걸린 시간 |
|---|---|---|---|
| Extra High (그 파일의 기본값) | 8,192 | 0자 (4번 모두) | 76~86초 |
| Extra High | 32,768 | 809자 | 108.8초 |
| Medium | 32,768 | 936자 | 13.2초 |
| Low | 32,768 | 873자 | 11.9초 |
| 끔 | 8,192 | 1,456~1,519자 | 9.2~9.4초 |
이 표가 뜻하는 것: 모델이 "800자"를 맞추려고 초안을 쓰고 글자 수를 세는 일을 되풀이하다가 생각에만 약 8,000토큰을 썼습니다. 컨텍스트 8,192가 그것으로 다 찼습니다. 답이 안 나오면 컨텍스트를 32,768 이상으로 늘리거나 생각 단계를 낮춥니다(83번 글). Unsloth Studio는 기본 컨텍스트를 크게 잡아서 이 문제가 덜합니다.
생각의 길이를 직접 제한할 수도 있습니다. Unsloth Studio에서 생각 한도를 1,024토큰으로 걸었을 때 채점 질문 50개를 푸는 시간이 96초에서 63초로 줄었고, 정답 수는 150번 중 148번과 149번으로 같았습니다(105번 글).
③ 온도: 답을 얼마나 다양하게 고를지
모델은 다음에 올 낱말을 확률로 고릅니다. 온도(Temperature)가 낮으면 가장 확률이 높은 낱말을 주로 골라서 매번 비슷한 답이 나옵니다. 높으면 덜 흔한 낱말도 골라서 답이 다양해집니다. Top P와 Top K는 고를 수 있는 후보의 범위를 정합니다.
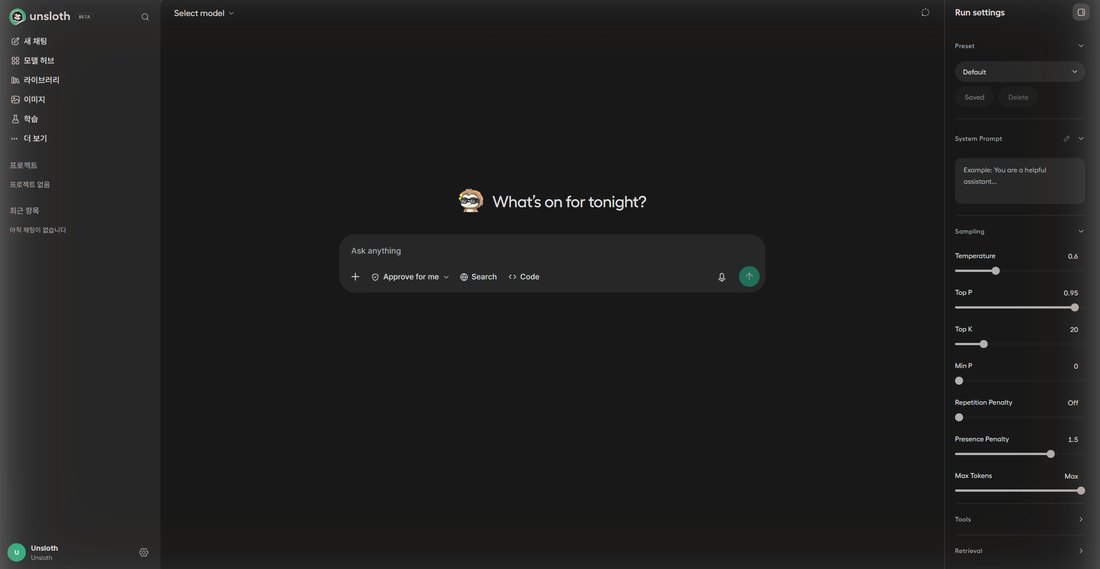
오른쪽 Run settings의 Sampling에 온도와 Top P, Top K가 있습니다. 모델을 고르기 전의 화면입니다.
| 설정 | 뜻 | 처음에는 |
|---|---|---|
| Temperature (온도) | 낮을수록 매번 비슷한 답, 높을수록 다양한 답 | 기본값 그대로 |
| Top P, Top K | 다음 낱말을 고르는 후보의 범위 | 기본값 그대로 |
| Max Tokens | 답 하나의 최대 길이 | 기본값 그대로 |
| System Prompt | 모델에게 미리 주는 지시. 예: "한국어로만 답해 줘" | 필요할 때만 |
이 표가 뜻하는 것: 처음에는 건드리지 않아도 됩니다. 이 블로그의 측정도 모두 기본값으로 했습니다.
기본값을 권하는 까닭은 두 가지입니다. 첫째, 알맞은 값이 모델마다 다르고, 모델 파일에 권장값이 들어 있습니다. 같은 Qwen3.8 27B도 LM Studio에서 한 곳의 파일은 온도 1, 다른 곳의 파일은 0.1로 올라왔습니다(88번 글). 둘째, 온도를 바꿔도 틀린 계산은 고쳐지지 않았습니다. 생각 기능이 없는 Qwen3-Coder 30B에 같은 산수 문제를 샘플링 값 세 가지로 10번씩 물었습니다.
| 보낸 샘플링 값 | 정답 |
|---|---|
| 지정하지 않음 | 10번 중 0번 |
| Temperature 0.7, Top P 0.8, Top K 20 | 10번 중 0번 |
| Temperature 0 | 10번 중 0번 (같은 오답 10번) |
이 표가 뜻하는 것: 온도 0은 답을 똑같이 만들 뿐, 맞게 만들지는 않았습니다(115번 글). 계산이 틀리면 온도가 아니라 생각을 켜거나 풀이를 쓰게 해야 합니다. 온도를 바꿨을 때 글의 품질이 어떻게 달라지는지는 이 블로그에서 따로 재지 않았습니다.
익숙해지면 볼 설정 두 가지
KV 캐시
KV 캐시는 대화 내용을 기억해 두는 메모리입니다. Run settings의 Advanced settings에 KV Cache Dtype으로 있고 기본값은 f16입니다. q8_0이나 q4_0으로 줄이면 긴 컨텍스트에서 VRAM을 덜 씁니다.
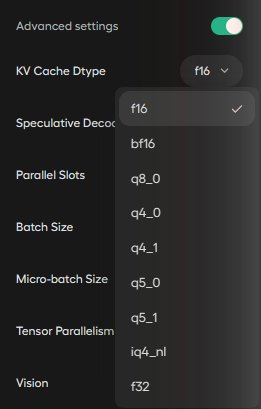
KV Cache Dtype 메뉴입니다. 기본값은 f16입니다.
| 모델과 그래픽카드 | 기본 KV 캐시 | 줄였을 때 | 잰 글 |
|---|---|---|---|
| Qwen3-Coder 30B A3B, 16GB, 컨텍스트 32,768 | 약 69 t/s | q4_0으로 약 116 t/s | 115번 |
| Gemma 4 26B A4B, 16GB, 컨텍스트 131,072 | 약 63 t/s | q4_0으로 약 79 t/s | 109번 |
| Qwen3.8 27B, 32GB, 컨텍스트 262,144 | 약 20 t/s | q8_0과 MTP로 약 103 t/s | 92번 |
이 표가 뜻하는 것: 긴 컨텍스트를 쓰는데 느려졌다면 KV 캐시를 줄여 볼 만합니다. 줄였을 때 답의 품질이 달라지는지는 이 측정들에서 따로 견주지 않았습니다.
Speculative Decoding (MTP)
MTP는 토큰 여러 개를 한꺼번에 예측해 속도를 올리는 기능입니다. Unsloth Studio는 VRAM이 남으면 자동으로 켭니다. Qwen3.8 27B는 MTP로 바꾸자 초당 72토큰이 106토큰이 됐고 정답률은 그대로였습니다(92번 글). 다만 VRAM을 약 2GB 더 써서, 빠듯한 그래픽카드에서는 오히려 느려진 경우도 있었습니다(99번 글).
쓰임새별로 정리하면
| 하려는 일 | 컨텍스트 | 생각 | 온도 |
|---|---|---|---|
| 일상 대화, 글 쓰기 | 32,768 | 끔 또는 Low | 기본값 |
| 계산, 논리 문제 | 32,768 이상 | 켬 (Low나 Medium) | 기본값 |
| 긴 문서 요약 | 문서 길이에 맞춰 크게 | 끔 또는 Low | 기본값 |
| 짧은 코드 작성 | 기본값 | 모델에 있으면 Low | 기본값 |
이 표가 뜻하는 것: 바꿀 것은 컨텍스트와 생각 두 가지이고, 온도는 그대로 둡니다. 이 값은 이 블로그의 측정에서 무난했던 것이고, 모델에 따라 다를 수 있습니다.
정리
- 컨텍스트는 쓸 만큼만 잡습니다. 처음에는 32,768을 권합니다. 16GB에서는 Auto보다 빨랐습니다.
- 계산이 필요하면 생각을 켭니다. Low만으로 정답률이 73%에서 99%가 됐습니다.
- 답이 안 나오면 컨텍스트를 늘리거나 생각 단계를 낮춥니다.
- 온도는 기본값으로 둡니다. 온도를 바꿔도 틀린 계산은 그대로였습니다.
- 긴 컨텍스트에서 느리면 KV 캐시를 줄여 봅니다.
앞의 글: 1편, 2편 설치와 첫 대화, 3편 모델 이름, 4편 모델 고르기. 다음 편(6편)은 느리거나 답이 안 나올 때 무엇을 보는지입니다.
이 글의 한계
- 모델 몇 개에서 잰 결과입니다. 생각 단계별 정답률은 Qwen3.8 27B 하나의 값입니다.
- 온도가 글의 품질에 주는 영향은 재지 않았습니다. 산수 문제 하나에서 본 것이 전부입니다.
- KV 캐시를 줄였을 때의 품질 차이는 견주지 않았습니다.
- 측정한 프로그램이 섞여 있습니다. 83번과 88번 글은 LM Studio, 나머지는 Unsloth Studio입니다.
- 화면 캡처는 2026년 10월 초의 것입니다. Unsloth Studio는 베타라서 설정 이름과 기본값이 바뀔 수 있습니다.
자주 묻는 질문
컨텍스트는 크게 잡을수록 좋은가요?
아닙니다. 크게 잡으면 VRAM을 더 쓰고, VRAM이 빠듯한 모델은 느려집니다. Qwen3-Coder 30B A3B는 16GB에서 기본값 약 145 t/s가 컨텍스트 131,072에서 약 25 t/s가 됐습니다. 쓸 만큼만 잡습니다.
생각은 늘 켜 두는 것이 좋은가요?
계산과 추론에는 켜는 것이 맞았습니다. 글 쓰기나 요약에는 꺼도 됩니다. Qwen3.6 35B A3B는 800자 글 하나에 생각을 켜면 36~45초, 끄면 5~7초가 걸렸습니다.
답이 한 글자도 안 나오고 멈춥니다.
생각이 컨텍스트를 다 썼을 수 있습니다. 컨텍스트를 32,768 이상으로 늘리거나 생각 단계를 Low로 낮춰 봅니다.
온도는 몇으로 두나요?
기본값을 권합니다. 알맞은 값이 모델마다 달라서 모델 파일에 권장값이 들어 있습니다. 이 블로그의 측정도 기본값으로 했습니다.
댓글 0개