 Tools
로컬 AI 시작하기 5편, Qwen3.8 27B·Gemma 4 설정은 무엇부터 바꿀까, 생각을 Low만 켜도 정답률이 73%에서 99%가 됐다
처음에 알아야 할 설정을 컨텍스트, 생각(Thinking), 온도 세 가지로 정리했습니다. Qwen3.8 27B는 생각을 Low만 켜도 정답률이 73%에서 99%가 됐고, 16GB에서는 컨텍스트를 숫자로 정하자 초당 약 52토큰이 약 94토큰이 됐습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"Temperature" 검색 결과 7건
Tools
처음에 알아야 할 설정을 컨텍스트, 생각(Thinking), 온도 세 가지로 정리했습니다. Qwen3.8 27B는 생각을 Low만 켜도 정답률이 73%에서 99%가 됐고, 16GB에서는 컨텍스트를 숫자로 정하자 초당 약 52토큰이 약 94토큰이 됐습니다.
 Tools
Unsloth Studio를 설치하고 Gemma 4 12B를 받아 첫 질문을 하기까지를 네 단계로 정리했습니다. 기본값으로 RTX 5090 32GB는 초당 약 233토큰, RTX 5060 Ti 16GB는 약 52토큰이었고, 16GB는 컨텍스트를 숫자로 정하면 약 94토큰이 됩니다.
 RTX-5060TI 16GB
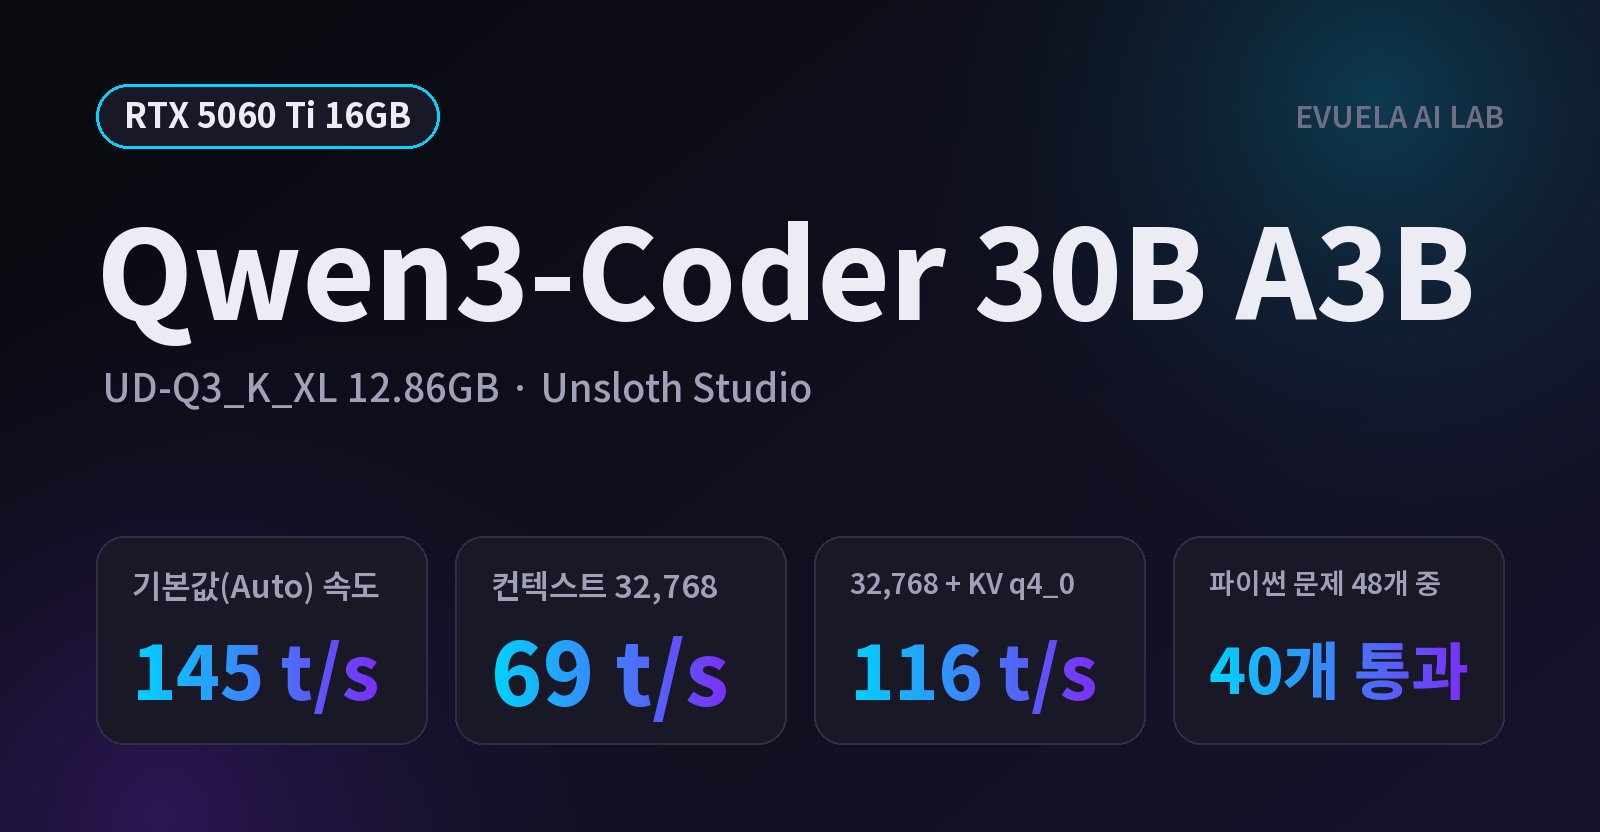
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3-Coder 30B A3B(UD-Q3_K_XL)를 돌렸습니다. 기본값은 초당 약 145토큰, 컨텍스트 32,768에서는 약 69토큰이었고 KV 캐시를 줄이면 116토큰이 됩니다. 파이썬 문제 결과도 담았습니다.
 RTX-5090
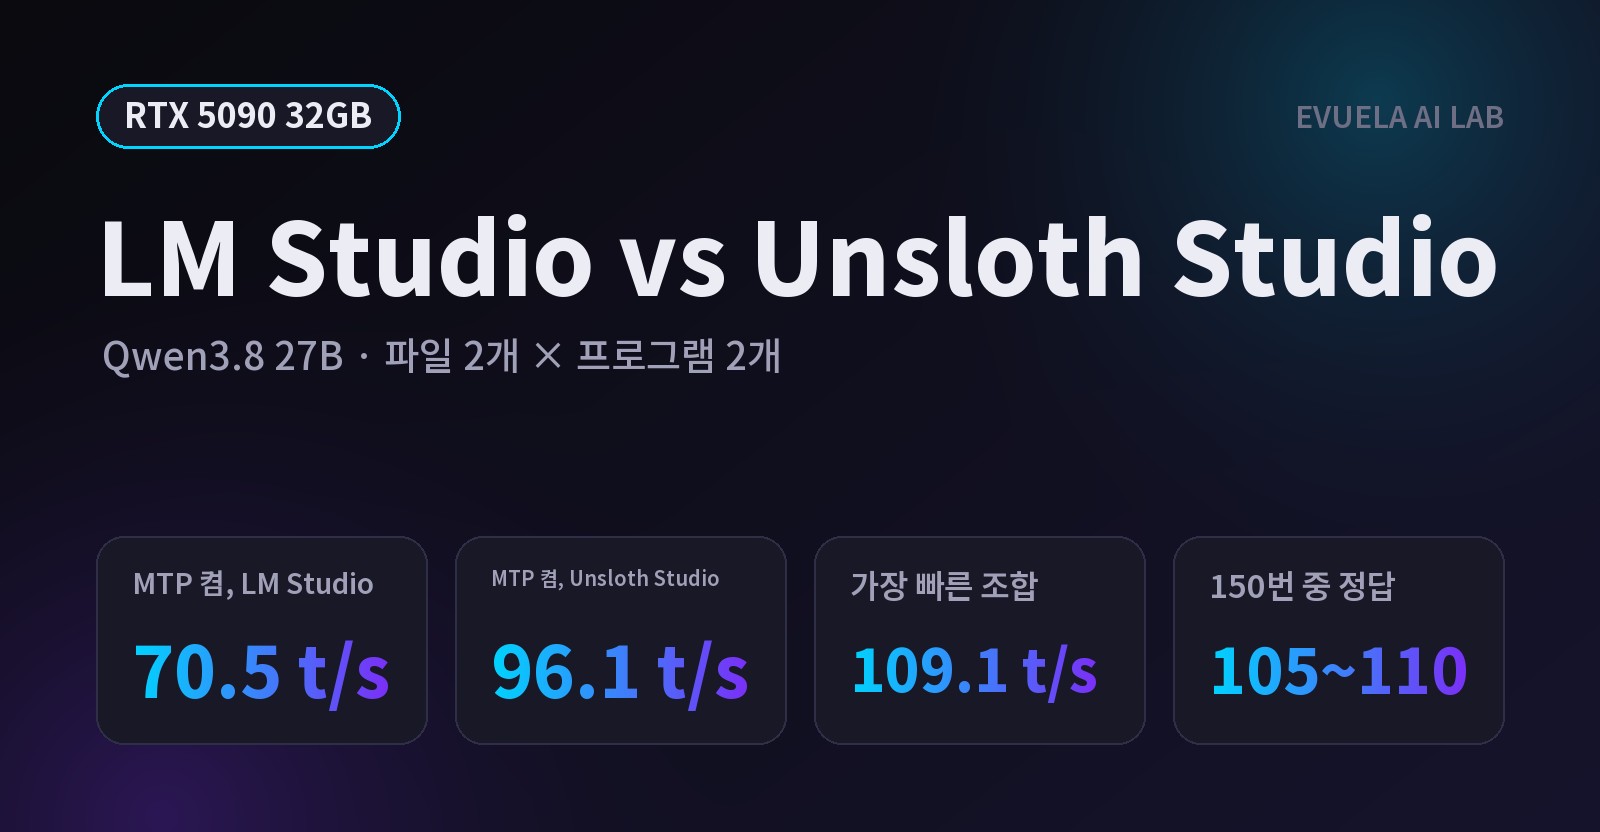
RTX 5090에서 Qwen3.8 27B 파일 두 개(lmstudio-community Q4_K_M, unsloth UD-Q4_K_XL)를 LM Studio와 Unsloth Studio에 차례로 올리고 설정을 똑같이 맞춰 쟀습니다. MTP를 끄면 두 프로그램의 속도가 거의 같았고, MTP를 켜면 Unsloth Studio가 35~36% 빨랐습니다. lmstudio-community 파일은 두 프로그램 모두에서 8~15% 더 빨랐고, 정답률은 네 조합이 같았습니다. 생각 설정의 차이와 두 프로그램 화면 캡처도 함께 정리했습니다.
 RTX-5090
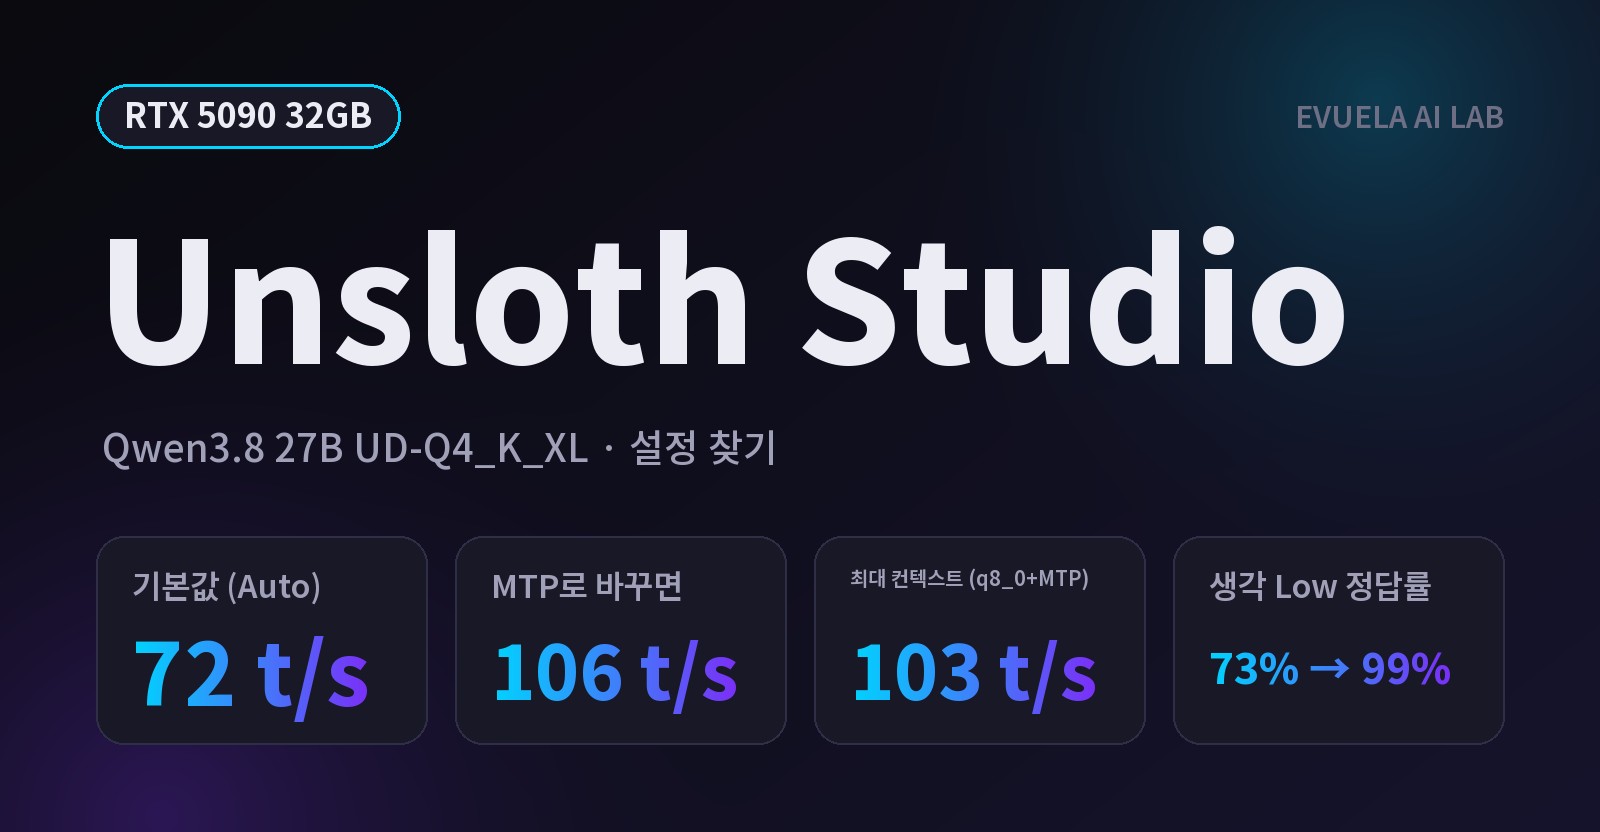
Unsloth Studio를 RTX 5090에 설치하고 Qwen3.8 27B(UD-Q4_K_XL)로 설정을 하나씩 바꿔 가며 쟀습니다. 기본값은 컨텍스트를 16만 8천 토큰으로 알아서 잡았고 초당 72토큰이었습니다. 속도 기능을 MTP로 바꾸면 48% 빨라졌고, KV 캐시를 q8_0으로 줄이면 최대 컨텍스트 262,144에서도 초당 103토큰이 나왔습니다. 생각 단계별 정답률, 화면 캡처, 쓰임새별 추천 설정을 정리했습니다.
 RTX-5090
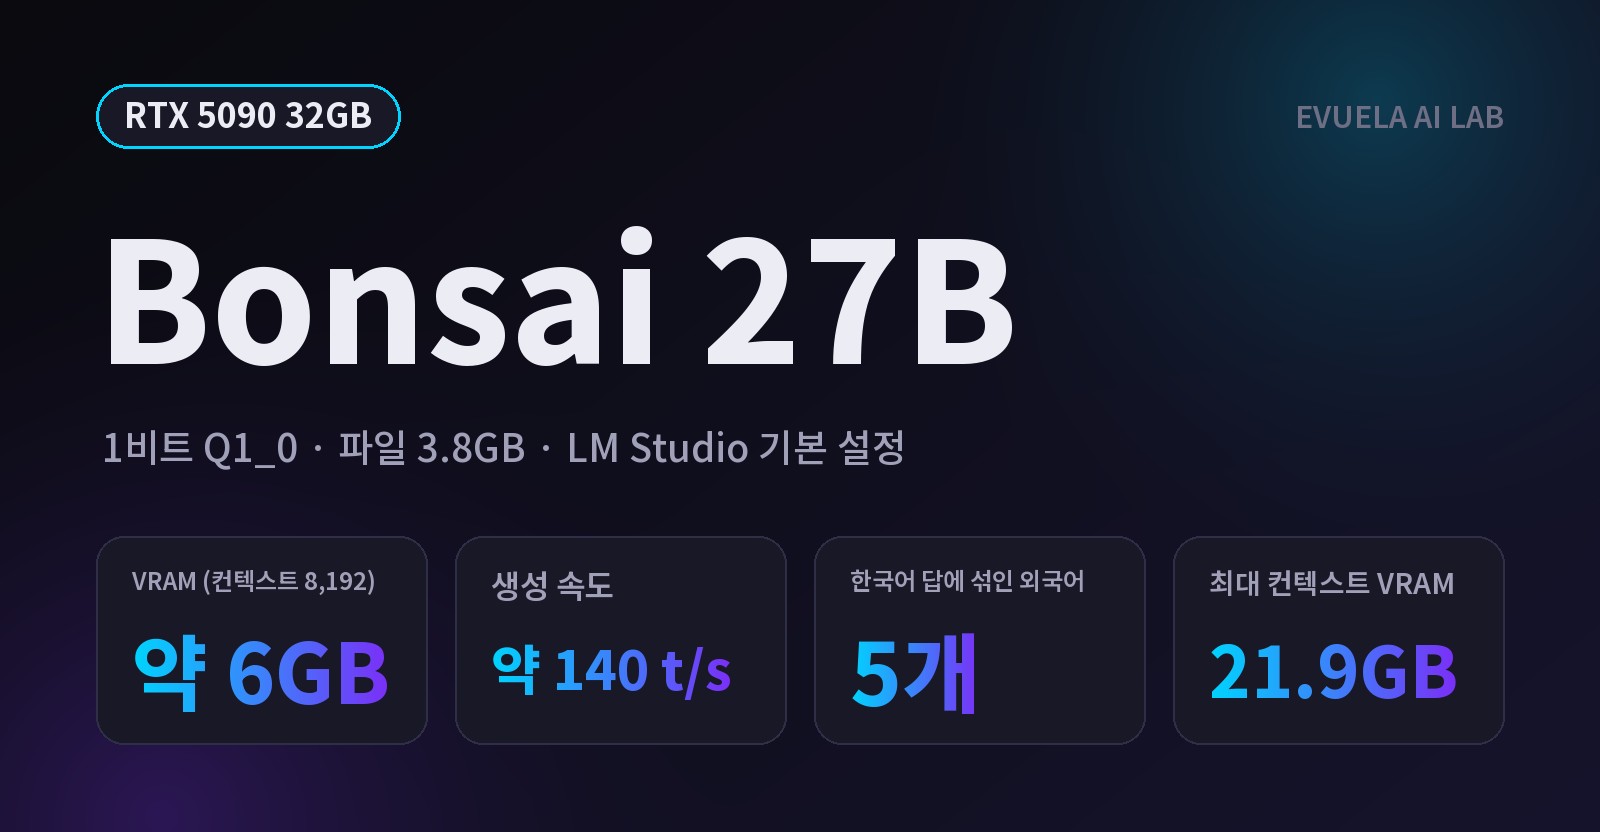
Qwen3.6-27B를 1비트로 줄인 Bonsai 27B를 RTX 5090 PC의 LM Studio에서 기본 설정으로 돌렸습니다. 초당 약 140토큰, 기본 VRAM 약 6GB로 빠르고 가벼웠지만, 한국어 답변에 외국어가 섞이고 산수는 5번 중 2번만 맞혔습니다. 캡처와 실측값으로 정리했습니다.
 Tools
내 PC 속 AI를 전문가로 만드는 비결! 프롬프트 엔지니어링 3대 기술과 AI의 성격을 결정하는 시스템 프롬프트 및 파라미터(온도 등) 설정법을 정리했습니다. 8GB VRAM 환경에서도 고성능 모델 못지않은 답변을 이끌어내는 실전 가이드를 기록합니다.