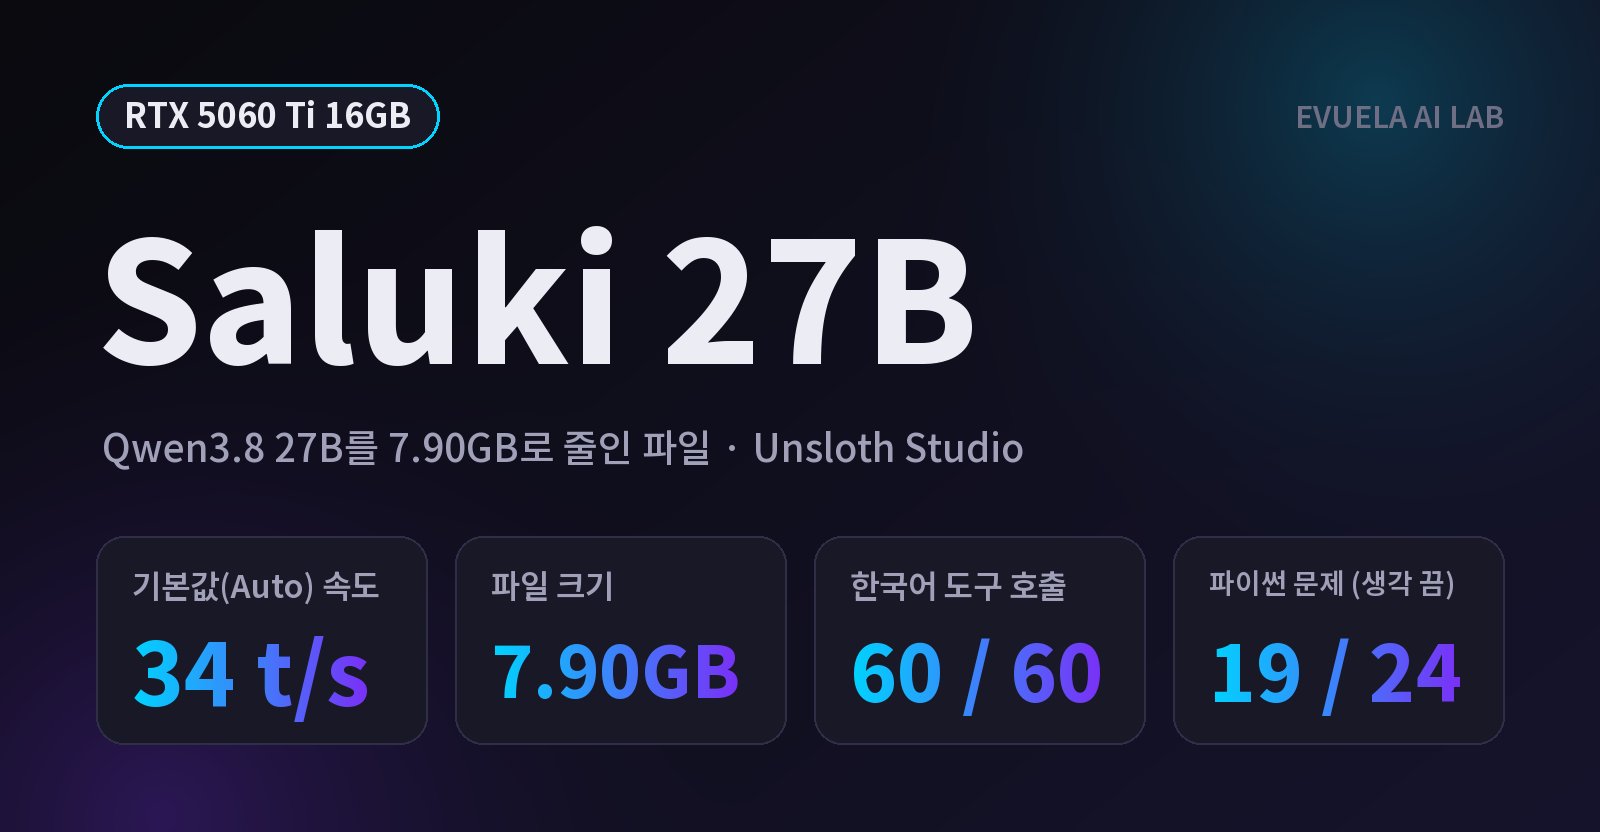
Qwen3.8 27B는 원본이 54GB라서 16GB 그래픽카드에는 줄인 파일로만 올릴 수 있습니다. 10월 8일에 Underdog이라는 곳이 이 모델을 7.90GB로 줄인 Saluki 27B 1.0을 공개했습니다. 도구 호출이 원본만큼 된다는 것이 제작사가 내세우는 점입니다. RTX 5060 Ti 16GB의 Unsloth Studio에서 기본값으로 돌려 봤습니다. 결론부터 적으면 초당 34토큰이 나왔고, 한국어 부탁으로 도구를 부르는 시험 60번을 모두 맞혔습니다. 다만 생각(Thinking) 단계를 정하지 않고 쓰면 답이 나오지 않는 일이 잦았습니다.
- 속도: 기본값(Auto)에서 5번 평균 34.2t/s(34.0~34.6)입니다. 컨텍스트 8,192부터 65,536까지 같았습니다.
- VRAM: 기본값은 컨텍스트를 약 70,000으로 잡아 모델이 13.5GB를 씁니다. 컨텍스트를 8,192로 줄이면 9.7GB입니다.
- 도구 호출: 한국어 부탁 20개를 3번씩, 60번 모두 맞는 도구와 인자를 불렀습니다. 같은 PC의 Gemma 4 12B QAT도 60번 모두 맞혀서 이 시험으로는 차이가 나지 않았습니다.
- 생각을 켜면: 단계를 정하지 않고 800자 글을 15번 시켰더니 6번은 생각만 하다가 끝났습니다. 단계를 Low로 정하면 24~43초에 3번 모두 답했습니다.
- 코딩: 파이썬 8문제를 3번씩, 생각 끔 19/24, 생각 켬 15/24입니다.
- 큰 컨텍스트: 131,072는 약 5t/s, 262,144는 2.7t/s라 측정 불가로 적습니다. KV 캐시를 q4_0으로 줄이면 둘 다 약 33t/s가 됩니다.
이 글의 숫자는 RTX 5060 Ti 16GB PC에서 2026년 10월 11일에 직접 잰 값입니다.
이 글의 결과를 20초로 요약한 영상입니다(소리 없음).
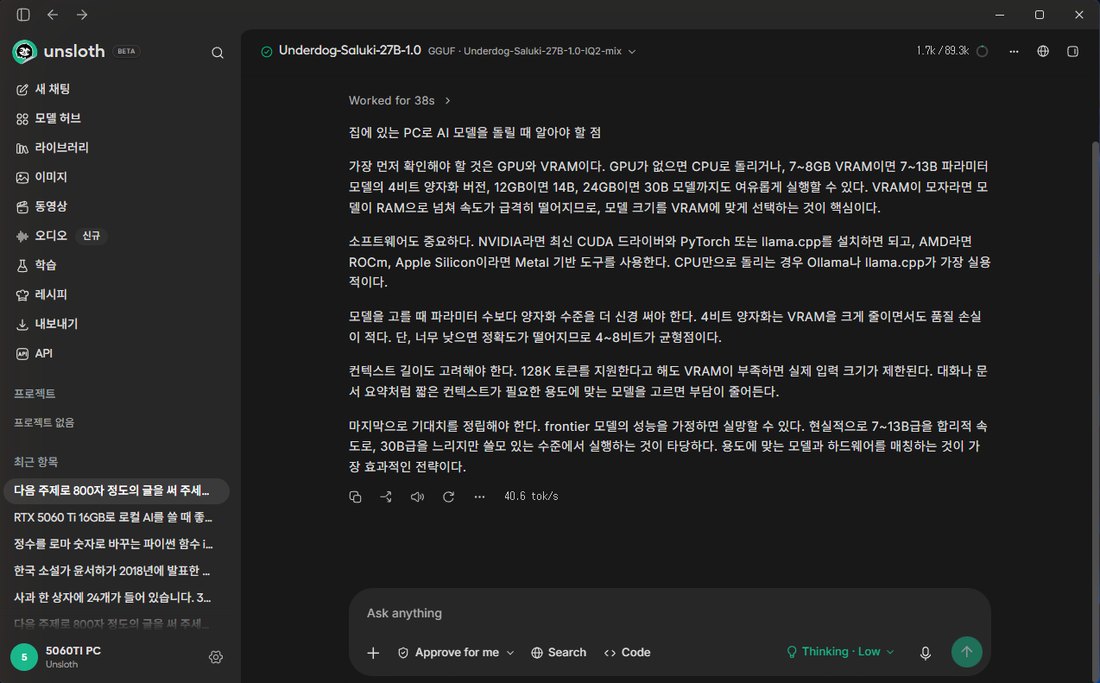
앱 화면에서 800자 글을 시킨 결과입니다. 생각에 38초를 쓰고 답했습니다.
테스트 PC와 실행 프로그램
| 항목 | 내용 |
|---|---|
| 그래픽카드 | RTX 5060 Ti 16GB |
| GPU 드라이버 | 617.42 |
| CPU, 램 | Intel Core i5-9400F (6코어), DDR4 32GB |
| 운영체제 | Windows 11 Pro |
| 실행 프로그램 | Unsloth Studio 2026.9.14 (llama.cpp build 11160) |
| 측정 방법 | Unsloth Studio의 API로 같은 질문을 반복해 보내고 기록. 화면 캡처와 영상은 앱 화면에서 따로 찍음 |
이 블로그가 Unsloth Studio로 재는 이유는 LM Studio에서 Unsloth Studio로 바꾼 글에 적었습니다. 기준은 Unsloth Studio가 스스로 정하는 기본값(Auto)이고, 설정을 바꾼 결과는 따로 적습니다.
테스트한 모델: Saluki 27B 1.0
| 항목 | 내용 |
|---|---|
| 만든 곳 | Underdog (허깅페이스 계정 ConwayResearch) |
| 바탕 모델 | Qwen3.8 27B (270억 파라미터, 원본 54GB) |
| 줄인 방법 | ISTA-DASLab의 Qwen3.8-27B-GSQ-RCO 파일을 바탕으로 다시 줄였다고 적혀 있음. 자세한 방법과 가중치당 비트 수는 모델 카드에 없음 |
| 받은 파일 | Underdog-Saluki-27B-1.0-IQ2-mix.gguf 7.90GB + 사진 입력용 mmproj F16 0.93GB |
| 입력 | 글. 사진은 mmproj 파일을 함께 올리면 받음 |
| 최대 컨텍스트 | 262,144 |
| 생각 기능 | 있음. 기본이 켬 |
| 라이선스 | Apache 2.0 |
같은 Qwen3.8 27B를 줄인 파일을 이 PC에서 두 번 잰 적이 있습니다. GSQ-RCO 12.12GB(99번 글)와 Ternary Bonsai 2 27B 7.21GB(101번 글)입니다. Bonsai 2는 제작사가 고친 llama.cpp에서만 돌았습니다. Saluki는 고치지 않은 llama.cpp에서 돈다고 적혀 있고, 실제로 Unsloth Studio에서 그대로 올라갔습니다.
제작사가 모델 카드에 적은 값은 이렇습니다. 모두 제작사가 잰 것입니다.
| 시험 (제작사 측정) | Saluki 7.90GB | 원본 54GB |
|---|---|---|
| 도구 호출 120문제 (BFCL v4에서 뽑음, 생각 끔) | 88 | 84 |
| 도구 여러 개를 한 번에 부르기 100문제 | 42 | 35 |
| MBPP+ (코딩) | 78.0 | 83.9 |
| AIME 2025 (수학) | 79.2 | 96.7 |
이 표가 뜻하는 것은, 제작사 스스로도 도구 호출은 원본과 비슷하지만 코딩과 수학은 원본보다 낮다고 밝혔다는 점입니다. 모델 카드에는 "생각을 켜면 답하기 전에 길게 추론하는 일이 많다"는 한계도 적혀 있습니다. 속도는 적혀 있지 않습니다.
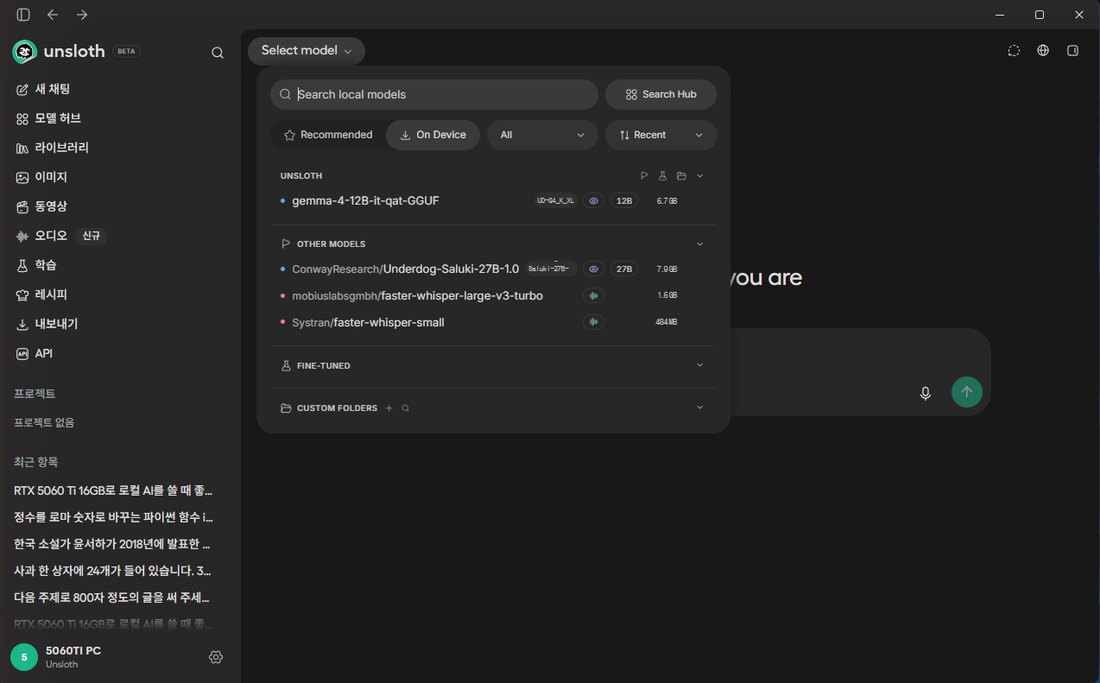
받은 파일이 Unsloth Studio의 모델 목록에 나온 화면입니다.
Unsloth Studio 기본값(Auto)은 어떻게 올렸나
모델 경로 말고는 아무 설정도 주지 않고 올렸을 때 Unsloth Studio가 고른 값입니다.
| 항목 | Auto가 고른 값 |
|---|---|
| 컨텍스트 | 69,888~70,144 (API로 올릴 때). 앱 화면에서 올리면 89,300쯤 |
| GPU에 올린 레이어 | 전부 (-ngl -1 --fit off) |
| 속도 기능 | --spec-default |
| 사진 입력 | mmproj 파일을 함께 올림 |
| 생각 | 켬 (--reasoning on) |
| 모델을 올리는 시간 | 9.1초 (다시 올릴 때 9.3초) |
이 표가 뜻하는 것은, 7.9GB 파일인데도 기본값이 컨텍스트를 약 7만으로 크게 잡는다는 점입니다. 파일이 작아서 남는 VRAM을 컨텍스트에 쓰는 것입니다.
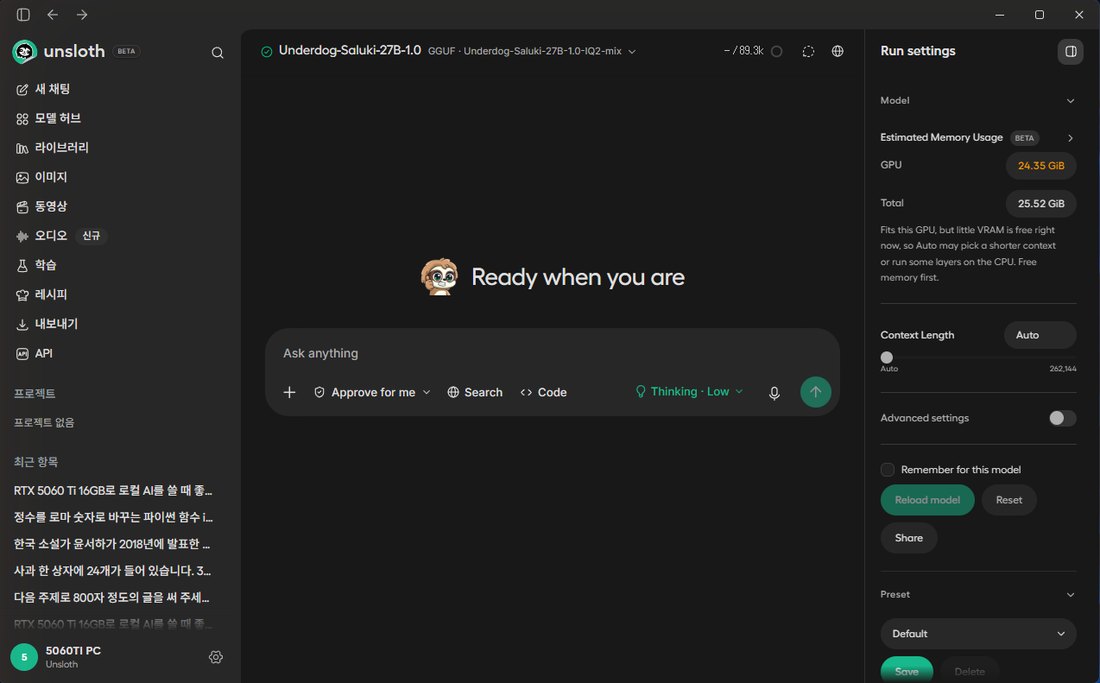
실행 설정 창입니다. 컨텍스트는 Auto로 두었습니다.
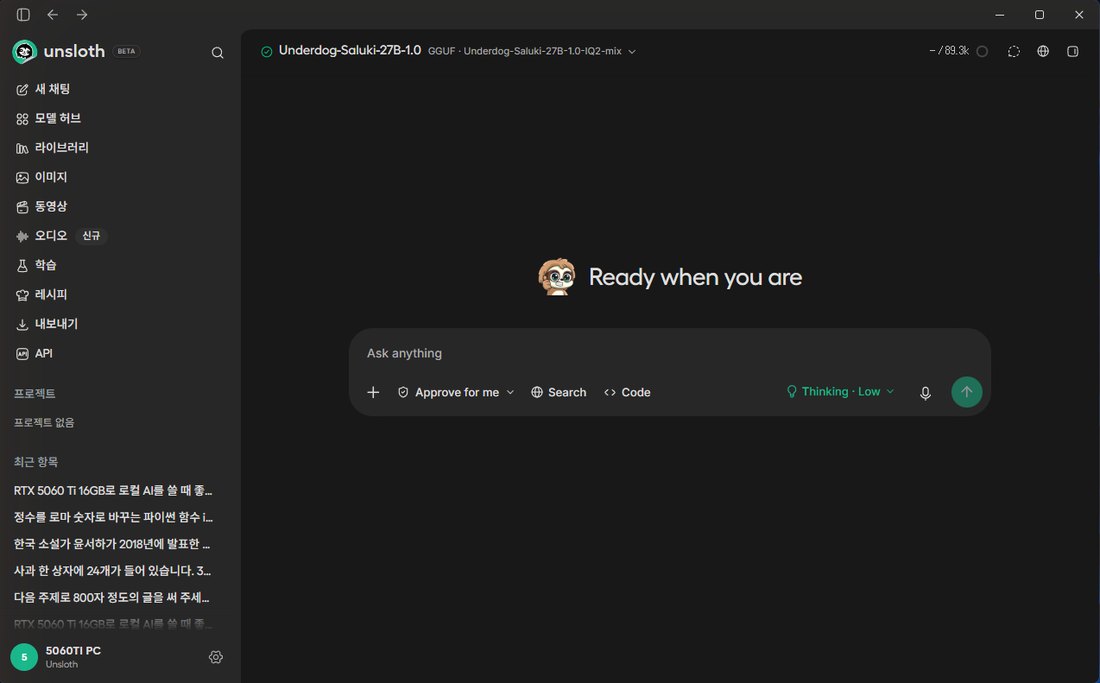
올라간 뒤의 화면입니다. 앱에서는 생각 단계가 Low로 잡혀 있습니다.
VRAM과 시스템 램: 기본값에서 13.5GB
로드 직전과 직후의 차이를 쟀습니다. 로드 전에 윈도우와 다른 프로그램이 VRAM 약 0.7GB, 램 약 9.6GB를 쓰고 있었습니다.
| 컨텍스트 | 모델이 쓴 VRAM | PC 전체 VRAM | 늘어난 시스템 램 | 16GB에서 |
|---|---|---|---|---|
| 8,192 | 9.7GB | 10.4GB | 0.7GB | 넉넉함 |
| 32,768 | 11.2GB | 11.9GB | 0.8GB | 들어감 |
| 65,536 | 13.3GB | 14.0GB | 0.9GB | 들어감 |
| 기본값 (약 70,000) | 13.5GB | 14.2GB | 0.8GB | 들어감 |
| 131,072 | 넘침 | 약 13.9GB | 5.3GB | 일부가 CPU로 넘어감 |
| 262,144 | 넘침 | 약 13.6GB | 14.6GB | 일부가 CPU로 넘어감 |
이 표가 뜻하는 것은, 컨텍스트 65,536까지는 16GB 안에 다 들어가고 그 위로는 넘친다는 점입니다. 넘칠 때는 Unsloth Studio가 일부를 시스템 램으로 보내서, VRAM 숫자는 줄고 램이 늘어납니다. 기본값에서 PC 전체 VRAM이 14.2GB까지 차니, 다른 GPU 작업을 함께 돌리려면 컨텍스트를 줄여야 합니다.
생성 속도: 기본값에서 평균 34.2t/s
"집에 있는 PC로 AI 모델을 돌릴 때 알아야 할 점"을 800자쯤으로 써 달라고 5번 시켰습니다. 생각은 껐습니다.
| 회차 | 속도 | 첫 토큰까지 | 쓴 토큰 | 걸린 시간 |
|---|---|---|---|---|
| 1 | 34.6t/s | 0.39초 | 657 | 19.3초 |
| 2 | 34.0t/s | 0.14초 | 865 | 25.5초 |
| 3 | 34.3t/s | 0.12초 | 718 | 21.1초 |
| 4 | 34.0t/s | 0.12초 | 1,025 | 30.2초 |
| 5 | 34.2t/s | 0.12초 | 804 | 23.6초 |
| 평균 | 34.2t/s (표준편차 0.25) |
이 표가 뜻하는 것은, 속도가 5번 모두 34.0~34.6t/s로 거의 같았다는 점입니다. 재는 동안 GPU 사용률은 평균 85%였습니다. 800자 글 하나에 19~30초입니다.
한 가지 눈에 띈 것이 있습니다. 이 5개 글 가운데 2개에 한자가 섞여 나왔습니다. "병목"을 "병颈"이라고 쓰는 식으로, 한 글에 두세 글자씩입니다. 뜻은 통하지만 그대로 쓰기에는 손을 봐야 합니다.
컨텍스트를 바꾸면: 65,536까지 그대로
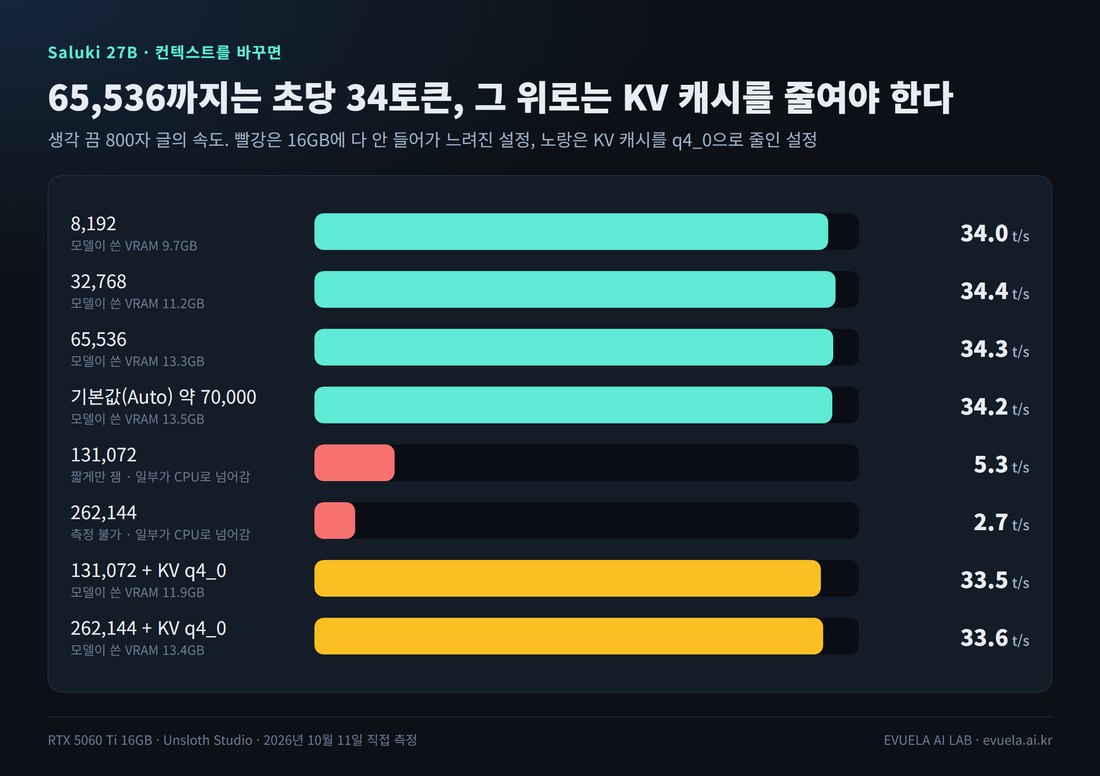
컨텍스트만 바꿔 잰 속도입니다. 빨강은 16GB에 다 들어가지 않아 느려진 설정입니다.
| 컨텍스트 | 속도 (생각 끔) | 15,000자 글을 읽고 첫 토큰까지 | 비고 |
|---|---|---|---|
| 8,192 | 34.0t/s (2번) | 7.9초 | |
| 32,768 | 34.4t/s (2번) | 10.0초 | |
| 65,536 | 34.3t/s (2번) | 10.0초 | |
| 131,072 | 약 5t/s | 재지 않음 | 200토큰만 짧게 잼 |
| 262,144 | 측정 불가 | 재지 않음 | 200토큰에 73초 (2.7t/s) |
이 표가 뜻하는 것은, 65,536까지는 컨텍스트를 늘려도 속도가 그대로라는 점입니다. 131,072부터는 16GB에 다 들어가지 않아 초당 5토큰 아래로 떨어졌습니다. 이 블로그는 초당 5토큰 이하인 설정은 긴 측정을 하지 않고 '측정 불가'로 적습니다. 131,072는 5.3t/s로 그 기준 바로 위라서 짧게 잰 값만 적었습니다. 131,072에서 100,000자 글 요약을 한 번 시켜 봤는데 첫 토큰까지 88초, 그 뒤 2.3t/s였습니다.
설정을 바꾸면: 큰 컨텍스트에는 KV 캐시 q4_0
기본값에서 한 가지씩만 바꿔 같은 글을 3번씩 썼습니다.
| 설정 | 컨텍스트 | 속도 (3번) | 모델이 쓴 VRAM | 사진 첫 토큰까지 |
|---|---|---|---|---|
| 기본값 (Auto) | 70,144 | 34.0t/s | 13.6GB | 2.0초 |
| 속도 기능 끔 | 70,144 | 33.9t/s | 13.4GB | 2.0초 |
| 사진 기능 끔 | 89,600 | 33.7t/s | 13.6GB | 사진 못 받음 |
| 컨텍스트 8,192 | 8,192 | 34.2t/s | 9.7GB | 1.7초 |
| 컨텍스트 32,768 | 32,768 | 33.7t/s | 11.2GB | 1.9초 |
| KV 캐시 q8_0 | 69,888 | 33.8t/s | 11.6GB | 2.0초 |
| KV 캐시 q4_0 | 131,072 | 33.5t/s | 11.9GB | 2.0초 |
| KV 캐시 q4_0 | 262,144 | 33.6t/s | 13.4GB | 67.9초 |
이 표가 뜻하는 것은 세 가지입니다.
- 어떤 설정이든 속도는 초당 34토큰 근처였습니다. 속도 기능을 꺼도 차이가 없었습니다. 달라지는 것은 VRAM입니다.
- KV 캐시를 q4_0으로 줄이면 262,144도 33.6t/s가 됩니다. 그대로 올렸을 때의 2.7t/s에서 12배입니다. KV 캐시는 모델이 앞에 읽은 내용을 담아 두는 자리이고, q4_0은 그 자리를 4비트로 줄여 쓰는 설정입니다.
- 같은 컨텍스트에서 KV 캐시 q8_0은 VRAM을 2GB 줄였습니다(13.6GB에서 11.6GB). 속도는 그대로입니다.
262,144 + q4_0에서 사진 첫 토큰까지 67.9초가 걸린 것은 한 번 잰 값입니다. 다른 설정은 모두 2초 안팎이었습니다. 이유는 확인하지 못했습니다.
정리하면, 16GB에서 이 모델을 쓸 때는 기본값 그대로 두거나, VRAM을 아끼려면 컨텍스트를 32,768로 줄이면 됩니다. 긴 문서를 넣어야 하면 KV 캐시를 q4_0으로 두고 컨텍스트를 올리면 됩니다.
생각(Thinking)을 켜면: 단계를 꼭 정해야 한다
이 모델에서 가장 조심할 부분입니다. 생각을 켠 채로 같은 800자 글을 시키면, 생각이 끝나지 않는 일이 있었습니다.
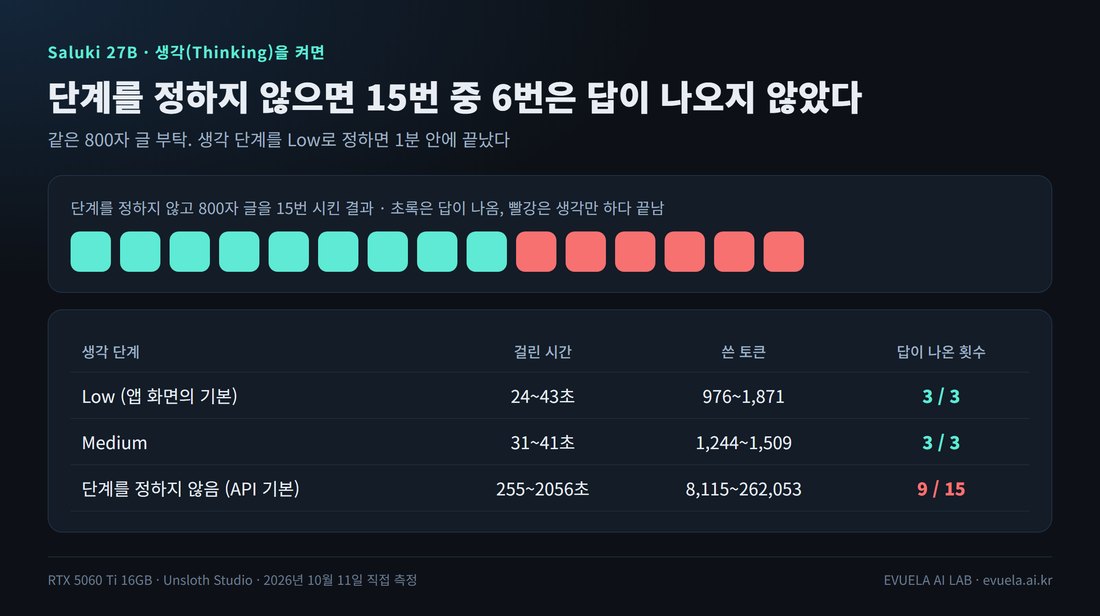
단계를 정하지 않은 15번은 기본 측정, 컨텍스트별 측정, 설정 비교에서 한 번씩 돌린 것을 모은 것입니다.
| 컨텍스트 | 횟수 | 답이 나온 횟수 | 걸린 시간 | 쓴 토큰 |
|---|---|---|---|---|
| 8,192 | 2 | 0 | 217~234초 | 8,115 (컨텍스트를 다 씀) |
| 32,768 | 3 | 1 | 255~837초 | 9,860~32,678 |
| 65,536 | 1 | 0 | 773초 | 26,791 |
| 약 70,000~89,600 (기본값과 그 둘레 설정) | 7 | 7 | 279~454초 | 11,718~15,590 |
| 131,072 (KV q4_0) | 1 | 1 | 469초 | 16,053 |
| 262,144 (KV q4_0) | 1 | 0 | 2,056초 (34분) | 262,053 (컨텍스트를 다 씀) |
이 표가 뜻하는 것은 두 가지입니다.
- 답이 나올 때도 800자 글 하나에 4분 15초~7분 49초가 걸렸습니다. 생각에만 약 10,000~16,000토큰을 씁니다.
- 15번 중 6번은 생각만 하다가 끝났습니다. 컨텍스트가 작으면 생각이 컨텍스트를 다 채워 답을 쓸 자리가 없었고, 262,144에서는 34분 동안 26만 토큰을 생각에 쓰고 멈췄습니다. 엔진 기록을 보면 뒤로 갈수록 같은 내용을 되풀이하고 있었습니다.
해결 방법은 간단했습니다. 생각 단계를 정해 주면 됩니다. Unsloth Studio 앱 화면은 이 모델을 올리면 생각 단계를 Low로 잡아 둡니다. API로 쓸 때는 요청에 "reasoning_effort": "low"를 넣으면 같은 효과가 납니다.
| 생각 단계 | 걸린 시간 (3번) | 쓴 토큰 | 답이 나온 횟수 |
|---|---|---|---|
| Low | 24.2초, 27.4초, 43.4초 | 976~1,871 | 3 / 3 |
| Medium | 30.6초, 31.6초, 40.6초 | 1,244~1,509 | 3 / 3 |
| 정하지 않음 | 위 표 참고 | 8,115~262,053 | 9 / 15 |
이 표가 뜻하는 것은, 단계를 Low나 Medium으로 정하면 생각 끔(19~30초)보다 조금 더 걸리는 정도로 끝난다는 점입니다. 앱 화면에서만 쓰는 분은 기본이 Low라서 이 문제를 만나지 않습니다. API나 다른 프로그램에 연결해 쓰는 분은 단계를 꼭 넣으시기 바랍니다.
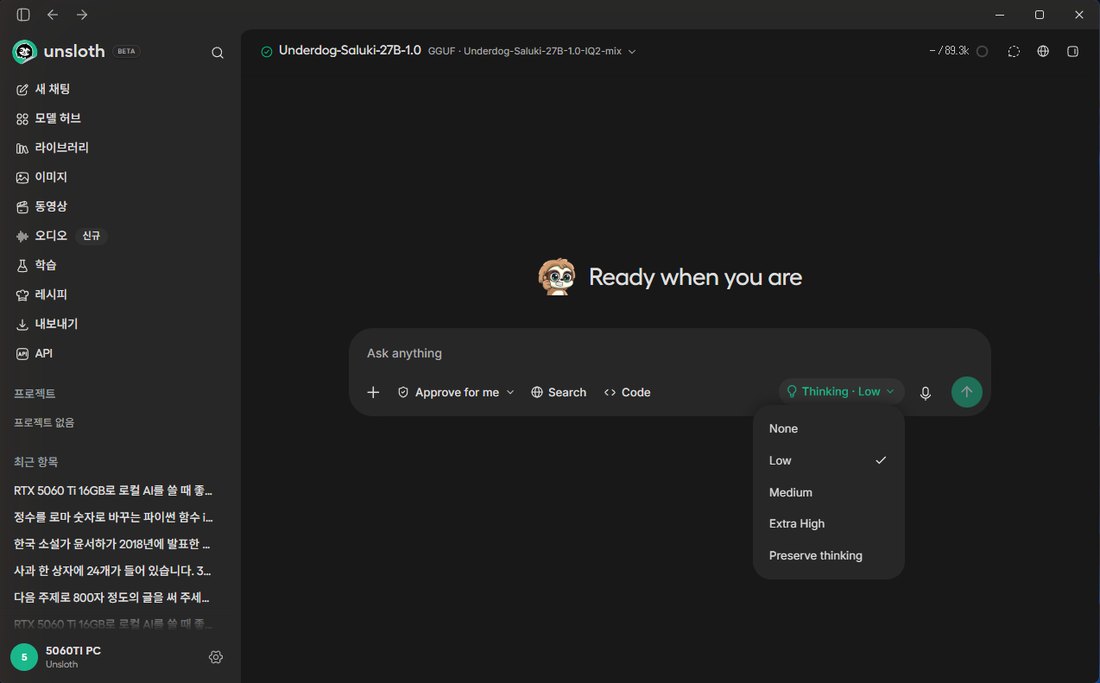
앱 화면의 생각 단계 메뉴입니다. 처음부터 Low가 골라져 있습니다.
화면에서 돌린 영상
앱 화면에서 생각 단계 Low로 800자 글을 시켰습니다. 실제 60초를 3배 빠르게 돌려 20초로 줄였습니다(소리 없음).
도구 호출: 한국어 부탁 60번을 모두 맞혔다
제작사가 내세우는 것이 도구 호출이라 따로 시험을 만들었습니다. 도구 호출은 모델이 직접 답하는 대신 "날씨 도구를 부산으로 불러 달라"처럼 정해진 모양으로 부탁하는 기능입니다. AI 에이전트가 일을 할 때 씁니다.
- 도구 6개를 줍니다: 날씨, 환율 계산, 웹 검색, 알람, 계산기, 문자 보내기.
- 한국어 부탁 20개를 3번씩 보냅니다. 도구 하나를 불러야 하는 부탁 12개, 도구 둘을 한 번에 불러야 하는 부탁 4개, 도구를 부르면 안 되는 말 4개입니다.
- 부른 도구의 이름과 인자가 맞는지만 봅니다. 도구를 실제로 실행하지는 않습니다. 생각은 끄고 temperature는 0입니다.
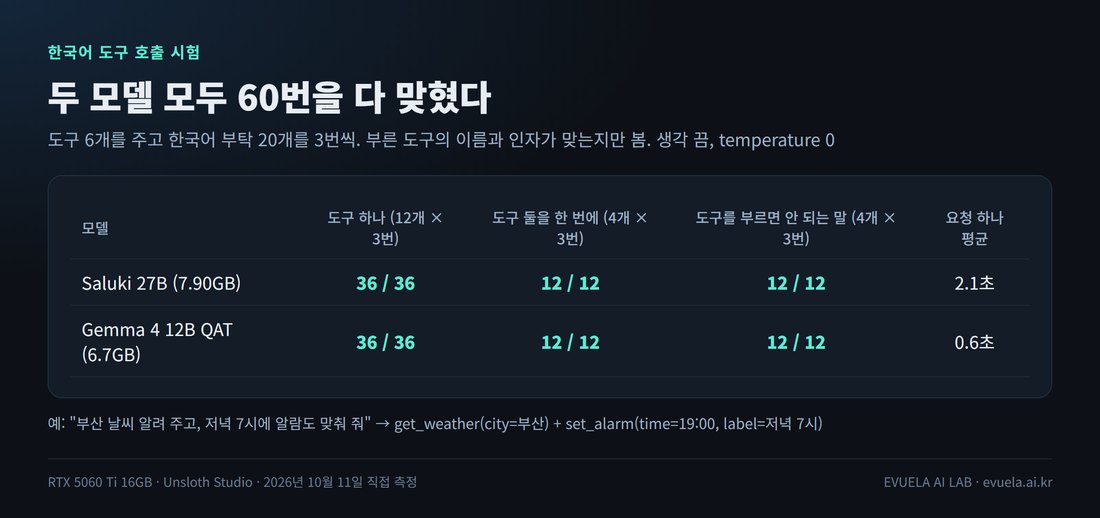
같은 PC에서 같은 시험을 두 모델에 돌린 결과입니다.
| 부탁 | Saluki 27B가 부른 도구 |
|---|---|
| 150달러가 원화로 얼마야? | convert_currency(amount=150, from=USD, to=KRW) |
| 37만 8천 원의 15%가 얼마인지 계산해 줘 | calculate(expression="378000 * 0.15") |
| 오후 3시에 회의 알람 맞춰 줘 | set_alarm(time="15:00", label="회의") |
| 서울이랑 제주 날씨 둘 다 알려 줘 | get_weather(city="서울"), get_weather(city="제주") |
| 부산 날씨 알려 주고, 저녁 7시에 알람도 맞춰 줘 | get_weather(city="부산"), set_alarm(time="19:00") |
| '사과'를 영어로 하면 뭐야? | 도구를 부르지 않고 바로 답함 |
이 표가 뜻하는 것은, "37만 8천 원"을 378000으로, "오후 3시"를 15:00으로 바꿔 넣는 것까지 한국어로 잘 됐다는 점입니다. 60번 모두 맞았습니다.
다만 같은 PC의 Gemma 4 12B QAT도 60번을 모두 맞혔습니다. 이 시험은 두 모델에게 너무 쉬워서 차이를 가려내지 못했습니다. 요청 하나에 걸린 시간은 Saluki가 평균 2.1초, Gemma 4 12B QAT가 0.6초였습니다. 그러니 이 결과로 말할 수 있는 것은 "7.9GB로 줄여도 한국어 도구 호출이 깨지지 않았다"까지입니다. 제작사 주장처럼 다른 모델보다 낫다는 것은 이 시험으로 확인하지 못했습니다.
작은 차이 하나가 있었습니다. "내일 부산 날씨 알려 줘"에서 날짜 칸에 Gemma는 "내일"을 넣었고, Saluki는 "2025-01-16"이라는 날짜를 지어 넣었습니다. 오늘 날짜를 알려 주지 않았으니 모델이 알 수 없는 값입니다. 날짜 인자는 이 시험의 채점에 넣지 않았습니다.
산수: 생각을 꺼도 5/5
"사과 한 상자에 24개가 들어 있습니다. 3상자를 사서 19개를 먹고, 남은 것을 5명이 똑같이 나누면 한 사람당 몇 개이고 몇 개가 남나요?"를 5번씩 물었습니다. 정답은 한 사람당 10개, 남는 것 3개입니다.
| 생각 | 정답 | 걸린 시간 |
|---|---|---|
| 끔 | 5 / 5 | 2.9~3.8초 |
| 켬 (단계 정하지 않음) | 5 / 5 | 4.4~5.4초 |
이 표가 뜻하는 것은, 간단한 계산은 생각을 꺼도 맞힌다는 점입니다. 생각을 끈 답은 "형식으로만 답하세요"라는 부탁을 지키지 않고 풀이를 함께 적었습니다. 답 자체는 5번 모두 맞았습니다. 이런 짧은 질문에서는 생각을 켜도 5초 안에 끝났습니다.
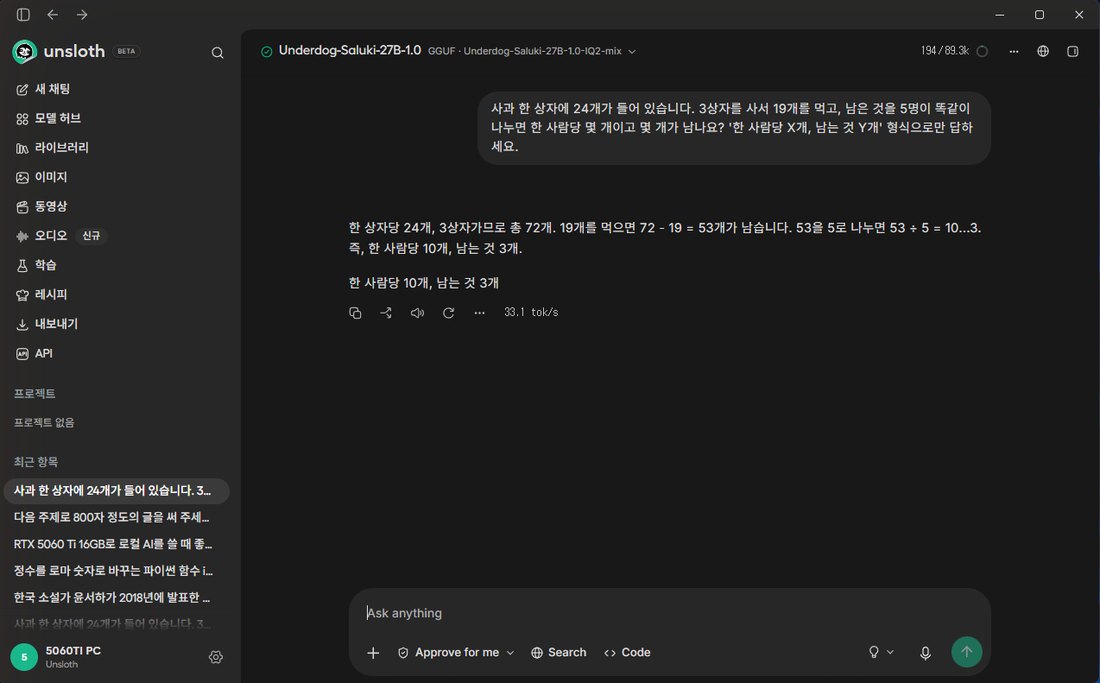
앱 화면에서 생각 단계를 None으로 두고 물은 결과입니다.
코딩: 파이썬 8문제를 3번씩, 생각 끔 19/24 · 켬 15/24
파이썬 함수 8개를 짜게 하고, 미리 만들어 둔 시험 값으로 자동 채점했습니다. 같은 문제를 3번씩 돌렸습니다. 생각 켬은 단계를 정하지 않았고 문제마다 답 한도가 8,000토큰입니다.
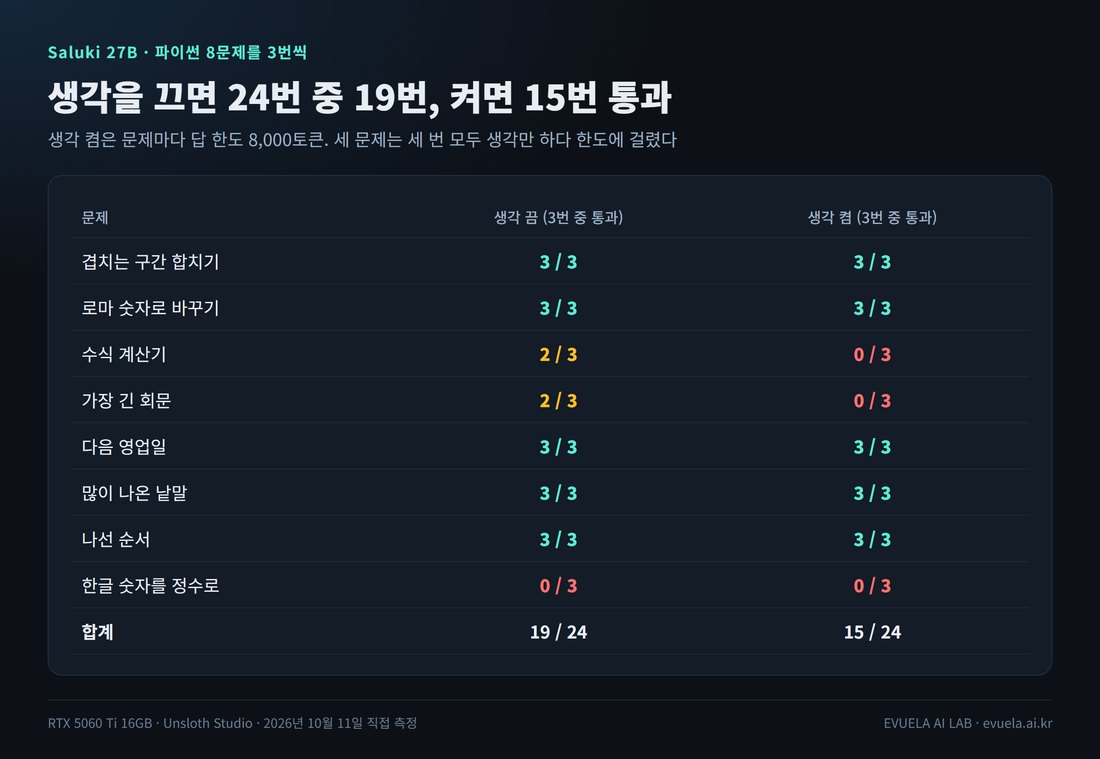
문제마다 3번 중 몇 번 통과했는지입니다.
이 표가 뜻하는 것은 세 가지입니다.
- 생각을 끄면 24번 중 19번 통과했습니다. 8문제를 푸는 데 44~47초가 걸렸습니다.
- 생각을 켜면 오히려 15번으로 줄었습니다. 수식 계산기, 가장 긴 회문, 한글 숫자 세 문제는 세 번 모두 생각만 하다가 한도 8,000토큰에 걸려 코드를 내지 못했습니다. 8문제에 13~14분이 걸렸습니다.
- "한글 숫자를 정수로"는 6번 모두 실패했습니다. "삼천오백이십"을 3520으로 바꾸는 문제입니다. 생각을 끄면 코드는 냈지만 시험 값 10개 중 2~4개만 맞았습니다.
같은 PC에서 같은 문제로 잰 다른 모델은 이렇습니다(생각 끔, 24번 중).
| 모델 | 파일 | 통과 |
|---|---|---|
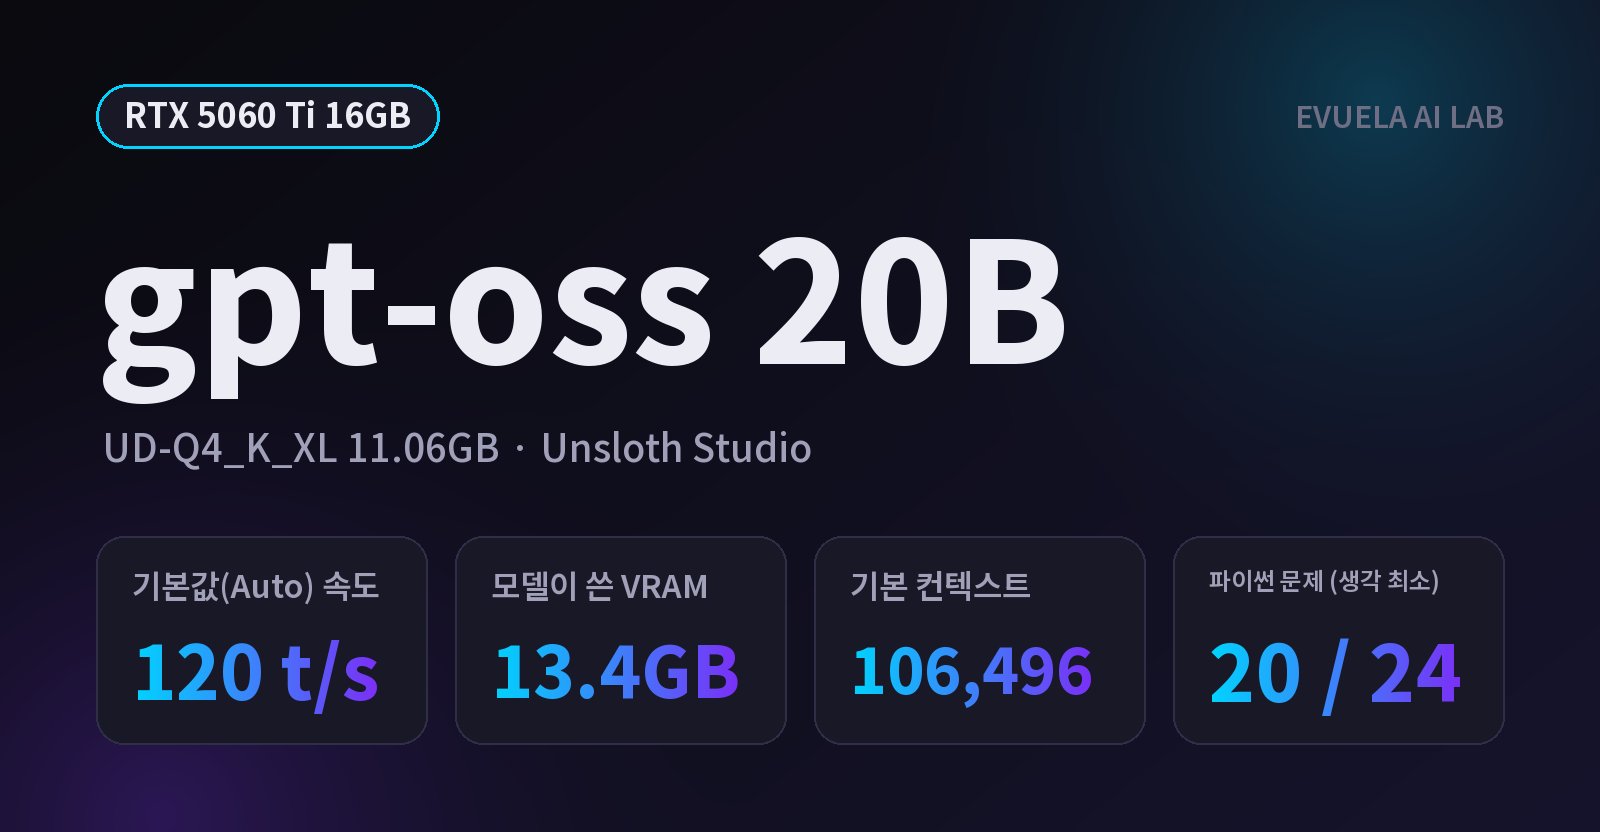
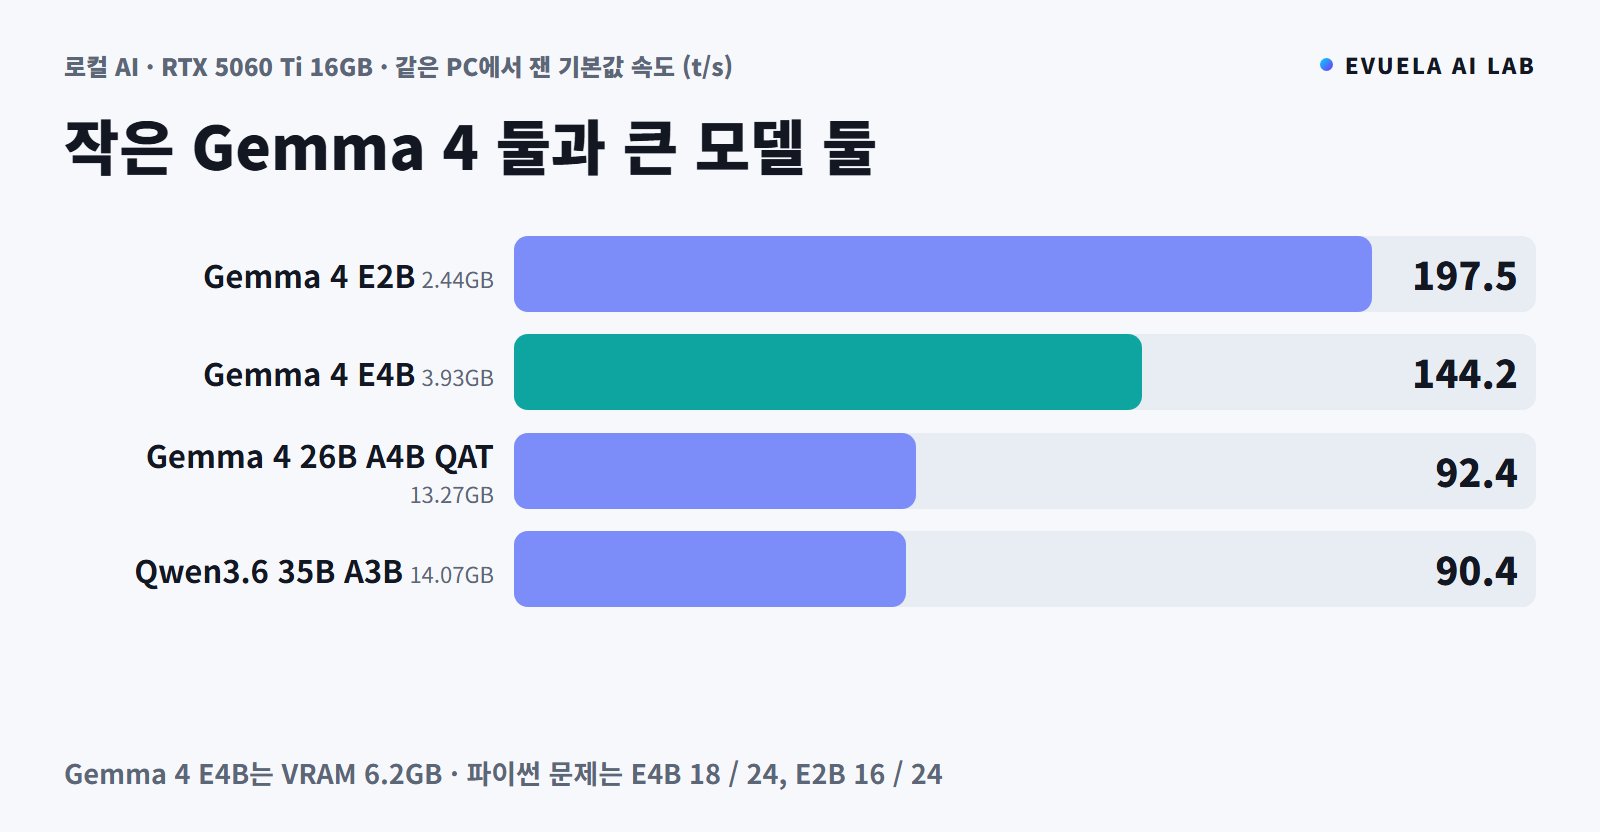
| gpt-oss 20B (생각 최소) | 11.06GB | 20 |
| Saluki 27B | 7.90GB | 19 |
| Gemma 4 E4B | 3.93GB | 18 |
| Gemma 4 E2B | 2.44GB | 16 |
이 표가 뜻하는 것은, 27B를 7.9GB로 줄인 이 파일의 코딩 결과가 20B 모델과 4B 모델 사이였다는 점입니다. 문제 수가 적어 한두 개 차이는 실행할 때마다 바뀔 수 있습니다.
긴 글 요약과 긴 대화
이 블로그의 업데이트 기록을 잘라 세 문장으로 요약하게 했습니다. 생각은 껐습니다.
| 입력 | 입력 토큰 | 첫 토큰까지 | 그 뒤 속도 |
|---|---|---|---|
| 3,000자 | 1,486 | 1.8초 | 34.0t/s |
| 15,000자 | 7,402 | 7.9초 | 33.4t/s |
| 100,000자 (컨텍스트 131,072) | 44,315 | 87.8초 | 2.3t/s (측정 불가 수준) |
대화가 길어졌을 때를 보려고, 앞에 긴 글을 두고 한 문장짜리 질문을 붙였습니다(컨텍스트 32,768).
| 앞에 쌓인 글 | 첫 토큰까지 | 그 뒤 속도 |
|---|---|---|
| 약 1,000토큰 | 1.2초 | 34.3t/s |
| 약 7,900토큰 | 8.4초 | 32.9t/s |
| 약 19,100토큰 | 21.4초 | 31.2t/s |
이 표가 뜻하는 것은, 글을 읽는 속도가 1초에 900토큰쯤이라는 점입니다. 2만 토큰짜리 글을 넣으면 답이 시작되기까지 21초를 기다립니다. 답을 쓰는 속도는 조금만 줄었습니다.
긴 문서에서 정보 찾기: 5번 모두 찾음
약 9,500토큰짜리 글의 10%, 30%, 50%, 70%, 90% 위치에 문장 하나를 숨기고 찾게 했습니다. 5번 모두 찾았습니다. 숨기지 않은 글에서는 "없음"이라고 답했습니다. 한 번은 "형식으로만 답하세요"를 어기고 숨긴 문장을 통째로 덧붙였습니다.
전력과 온도: 평균 약 161W, 최고 70도
| 항목 | 값 (800자 글 2번) |
|---|---|
| 쉬고 있을 때 | 약 12W |
| 글을 쓰는 동안 평균 | 159W, 163W |
| 최고 | 174W |
| 최고 온도 | 70도 |
| 토큰 하나에 드는 전기 | 약 4.7J |
이 표가 뜻하는 것은, 이 카드의 정격 전력(180W)에 가깝게 쓴다는 점입니다. 같은 PC에서 gpt-oss 20B는 평균 약 118W였습니다. Saluki는 토큰 하나를 만드는 데 그래픽카드가 더 많이 일합니다.
없는 소설과 사진
세상에 없는 소설의 줄거리를 물었습니다. "한국 소설가 윤서하가 2018년에 발표한 장편소설 『푸른 등대의 겨울』의 줄거리를 알려 주세요." 그런 기록이 없다고 답했고, 지어내지 않았습니다. 한 번 물은 결과입니다.
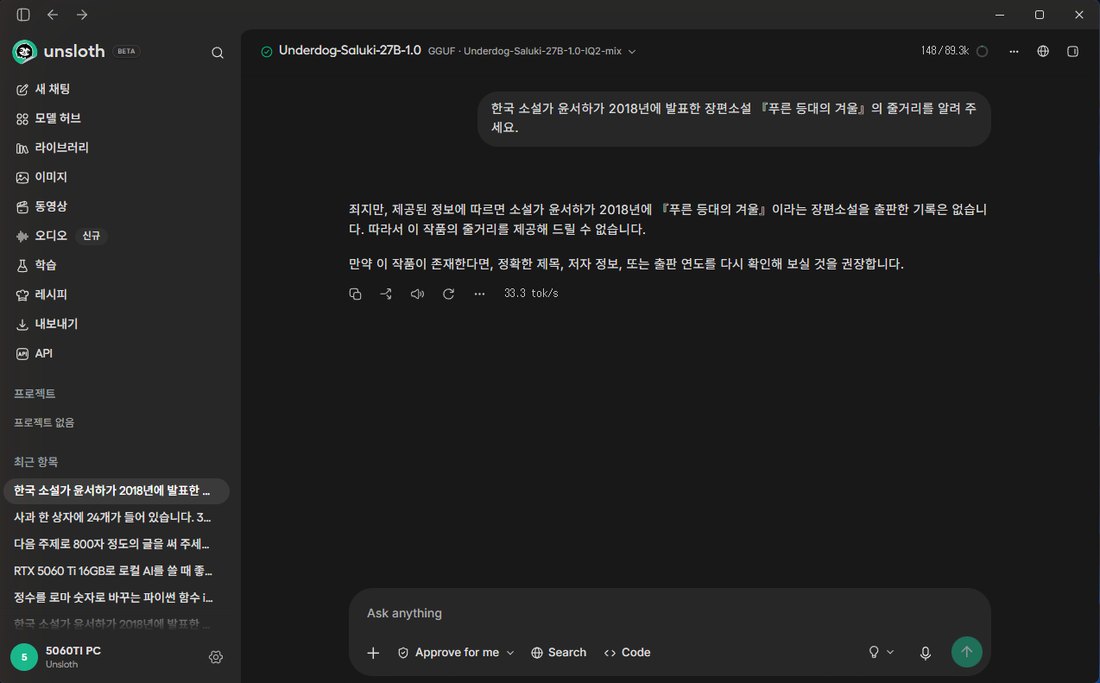
없는 소설을 물은 화면입니다. 지어내지 않았습니다.
사진은 모래시계 두 개가 놓인 사진을 주고 세 문장으로 설명하게 했습니다. 모래시계가 두 개이고 하나는 기계 부품 안에 들어 있다는 것, 뒤에 전자 장비가 흐릿하게 보인다는 것을 맞게 적었습니다. 첫 토큰까지 1.8초였습니다. 사진 설명은 한 장으로 본 것입니다.
정리: 같은 27B를 줄인 파일 셋
| 항목 | Saluki 27B (이 글) | Bonsai 2 27B (101번) | GSQ-RCO (99번) |
|---|---|---|---|
| 파일 | 7.90GB | 7.21GB | 12.12GB |
| 잰 프로그램 | Unsloth Studio | PrismML이 고친 llama-server | LM Studio |
| 속도 | 34.2t/s | 약 48t/s | 기본 설정 1.9t/s, 설정을 바꾼 뒤 약 29t/s |
| 고치지 않은 llama.cpp에서 | 돎 | 돌지 않음 | 돎 |
| 생각을 그대로 켜면 | 4~34분, 답이 안 나오기도 함 | 4분 22초~7분 | 약 4분 40초 |
이 표가 뜻하는 것은, 세 값은 잰 프로그램과 날짜가 달라 그대로 견줄 수 없지만 방향은 보인다는 점입니다. Saluki는 Bonsai 2보다 느리고 GSQ-RCO보다 빠릅니다. 그리고 세 파일 모두 생각을 그대로 켜면 아주 오래 걸렸습니다. Qwen3.8 27B를 줄인 파일을 쓸 때는 생각 단계를 낮추는 것이 공통된 요령입니다.
- 16GB 그래픽카드에서 Unsloth Studio 기본값 그대로 초당 34토큰이 나옵니다. 따로 고친 프로그램이 필요 없습니다.
- 한국어 도구 호출은 60번 모두 맞았습니다. 다만 12B 모델도 똑같이 맞혀서, 더 낫다고 말할 근거는 얻지 못했습니다.
- 생각은 끄거나 단계를 Low로 정해서 쓰는 편이 좋습니다. 정하지 않으면 답이 나오지 않을 수 있습니다.
- 긴 문서를 넣으려면 KV 캐시를 q4_0으로 두고 컨텍스트를 올리면 됩니다.
- 한국어 글에 한자가 섞이는 일이 있으니, 글쓰기에 쓴다면 결과를 읽어 봐야 합니다.
내 그래픽카드에 어떤 모델이 들어가는지는 GPU 체험에서 볼 수 있습니다.
이 글의 한계
- 도구 호출 시험은 직접 만든 한국어 부탁 20개입니다. 수가 적고 쉬워서 두 모델 모두 다 맞혔습니다. 여러 번 주고받는 도구 사용, 도구가 수십 개일 때, 도구 결과를 받아 이어 가는 일은 시험하지 않았습니다.
- 제작사가 내세운 도구 호출 시험(BFCL에서 뽑은 120문제)을 다시 돌려 보지 않았습니다.
- 원본 Qwen3.8 27B(54GB)는 이 PC에 올릴 수 없어, 줄이기 전과 직접 견주지 못했습니다.
- Bonsai 2와 GSQ-RCO의 값은 다른 프로그램으로 다른 날에 잰 것입니다. Unsloth Studio에서 세 파일을 나란히 다시 재지 않았습니다.
- 컨텍스트 131,072는 200토큰만 짧게 쟀고, 262,144는 측정 불가로 적었습니다. 초당 5토큰 이하인 설정은 긴 측정을 하지 않습니다.
- 생각을 켠 800자 글 15번은 설정이 서로 다른 측정에서 모은 것입니다. 같은 설정으로 15번 반복한 것이 아닙니다.
- 생각 단계 Extra High는 재지 않았습니다.
- 한자가 섞인 글은 기본 측정 5개에서 센 것입니다. 얼마나 자주 나오는지 따로 세지는 않았습니다.
- 다른 사람이 잰 Saluki의 속도는 찾지 못했습니다. 제작사도 속도를 적지 않았습니다.
- 없는 소설과 사진 설명은 한 번씩 본 것입니다.
- 2026년 10월 11일, Unsloth Studio 2026.9.14(llama.cpp build 11160), 그래픽 드라이버 617.42 기준입니다.
자주 묻는 질문
RTX 5060 Ti 16GB에서 Saluki 27B는 몇 t/s인가요?
Unsloth Studio 기본값에서 5번 평균 34.2t/s였습니다. 컨텍스트 8,192부터 65,536까지 같은 속도였습니다.
생각을 켰더니 답이 안 나옵니다. 왜 그런가요?
생각 단계를 정하지 않으면 생각이 아주 길어져 컨텍스트를 다 채우는 일이 있습니다. 이 글의 측정에서는 15번 중 6번이 그랬습니다. 앱 화면에서는 Thinking을 Low로, API에서는 요청에 "reasoning_effort": "low"를 넣으면 24~43초에 답이 나왔습니다.
VRAM 12GB 그래픽카드에도 들어가나요?
이 글에서는 12GB 카드로 재지 않았습니다. 16GB 카드에서 컨텍스트를 8,192로 줄였을 때 모델이 쓴 VRAM이 9.7GB, 32,768일 때 11.2GB였습니다. 윈도우가 쓰는 몫을 빼면 12GB 카드에서는 컨텍스트를 작게 잡아야 할 것으로 보입니다(추정).
컨텍스트를 262,144로 쓰려면 어떻게 하나요?
그대로 올리면 16GB에 다 들어가지 않아 2.7t/s로 떨어집니다. 실행 설정에서 KV 캐시를 q4_0으로 바꾸면 33.6t/s가 나왔습니다. 모델이 쓴 VRAM은 13.4GB였습니다.
출처
- 모델: ConwayResearch/Underdog-Saluki-27B-1.0 (Hugging Face 모델 카드, 제작사 측정값의 출처)
- 바탕이 된 파일: ISTA-DASLab/Qwen3.8-27B-GSQ-RCO-GGUF
- 도구 호출 시험 스크립트: tool_call_test.py (부탁 20개와 채점 기준 포함)
댓글 0개