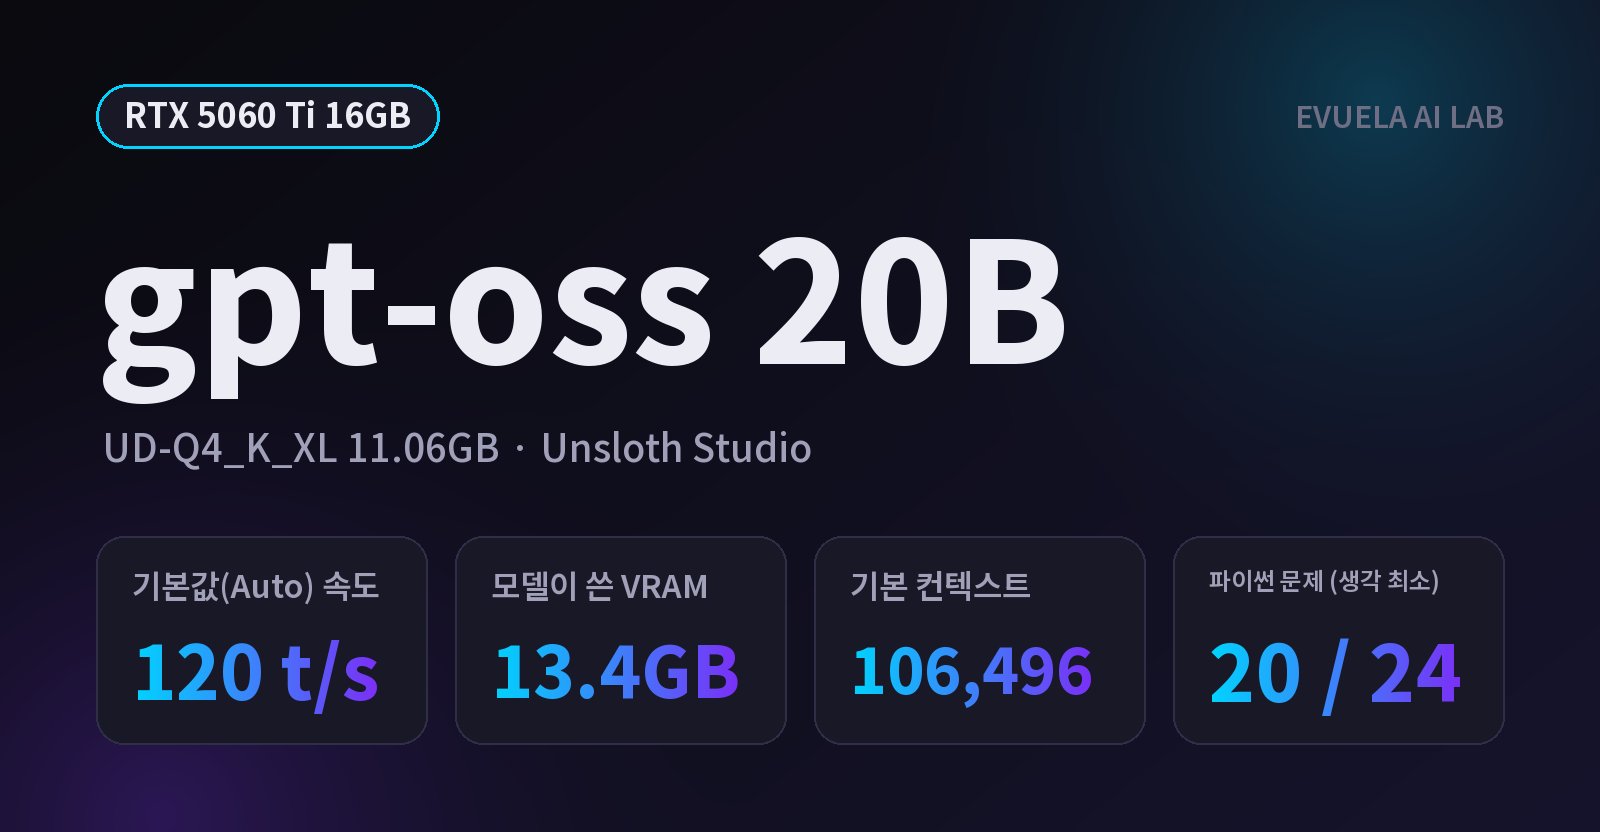
OpenAI가 공개한 gpt-oss 20B(unsloth의 UD-Q4_K_XL, 파일 11.06GB)를 RTX 5060 Ti 16GB PC의 Unsloth Studio에서 기본값(Auto) 그대로 돌려 봤습니다. 결론부터 적으면 4비트 파일이 VRAM에 통째로 들어가 초당 약 120토큰(t/s)이 나왔고, 생각(Thinking)을 가장 짧게 해도 산수 5번을 모두 맞혔습니다. 같은 질문을 5번 잰 평균이 119.8t/s(최소 118.2, 최대 121.6)입니다.
- 컨텍스트를 크게 잡고도 빠릅니다. Auto가 컨텍스트를 약 106,000으로 잡았고, 8,192부터 65,536까지 속도가 약 122t/s로 같았습니다.
- 생각을 끌 수 없는 모델입니다. 단계가 Low, Medium, High 세 가지뿐입니다. High에서는 800자 글 하나에 29초에서 219초까지 걸렸습니다.
- 파이썬 8문제는 생각을 가장 짧게 했을 때 24개 중 20개를 통과했습니다. High로 올리면 16개로 오히려 줄었습니다. 생각이 길어져 답 한도를 넘긴 문제가 많았기 때문입니다.
- 없는 소설을 지어내지 않았습니다. 다만 앱 화면에서는 한국어로 물었는데 영어로 답했습니다.
- 전력을 많이 씁니다. 글을 쓰는 동안 평균 약 118W로, 이 PC에서 잰 모델 중 가장 높았습니다.
이 글의 결과를 20초로 요약한 영상입니다(소리 없음).
이 글의 숫자는 모두 이 PC에서 직접 잰 값입니다. 속도와 정답 수는 Unsloth Studio의 API로 재고, 화면 캡처와 영상은 측정이 끝난 뒤 따로 찍었습니다. 측정은 2026년 10월 10일에 했습니다. 같은 PC에서 잰 Qwen3-Coder 30B A3B, Gemma 4 26B A4B QAT, Qwen3.6 35B A3B와 견줍니다.
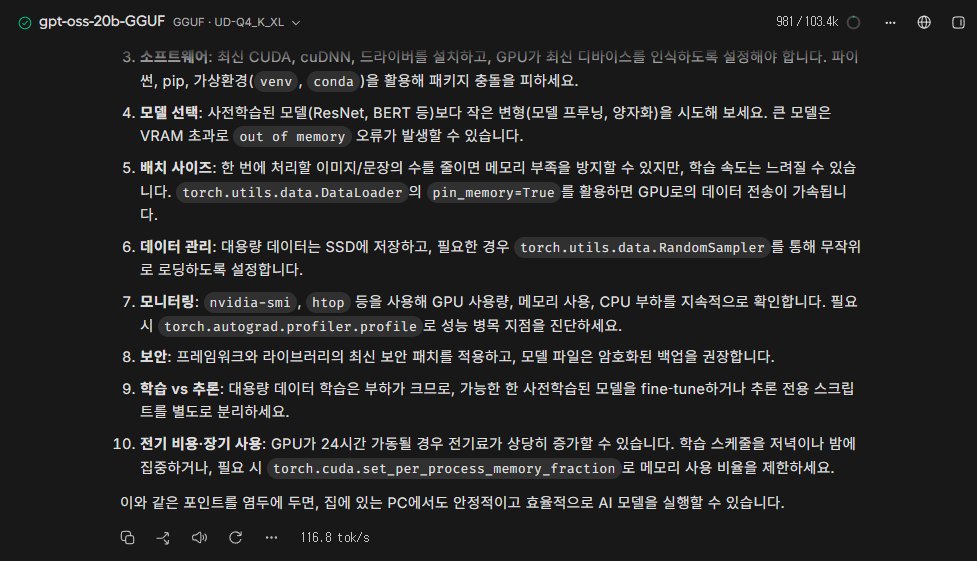
생각 단계 Medium(앱 기본값)으로 800자 글을 쓰게 한 화면입니다. 답 아래에 초당 116.8토큰이 표시됩니다.
테스트 PC와 실행 프로그램
| 항목 | 내용 |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti (VRAM 16GB, 전력 제한 180W) |
| GPU 연결 | PCIe 3.0 x8 (메인보드가 PCIe 3.0까지 지원) |
| CPU | Intel Core i5-9400F (6코어 6스레드) |
| 시스템 램 | DDR4 32GB (16GB × 2, 2666MT/s) |
| 저장장치 | Crucial MX500 1TB SATA SSD |
| 운영체제 | Windows 11 Pro, 전원 구성표 균형 조정 |
| 실행 프로그램 | Unsloth Studio 데스크톱(베타) 2026.9.14 |
| 엔진 | llama.cpp 0.5.0-dev (build 11160, commit a3c12db9d, Unsloth가 빌드한 것) |
| GPU 드라이버 | 617.42 |
| 측정 방법 | Unsloth Studio의 OpenAI 호환 API(127.0.0.1:8888)로 같은 질문을 반복해서 보냄. 속도는 첫 토큰이 나온 뒤부터 잰 생성 속도 |
| 측정 스크립트 | Python 3.14.3, requests 2.34.2, psutil 7.2.2 |
| 샘플링 | 따로 지정하지 않음(프로그램 기본값) |
| 측정 날짜 | 2026년 10월 10일 |
테스트 PC 두 대의 사양과 측정 방법은 소개 페이지에 있습니다. 로컬 AI를 처음 써 본다면 로컬 AI 시작하기 1편부터 보면 됩니다.
테스트한 모델: gpt-oss 20B
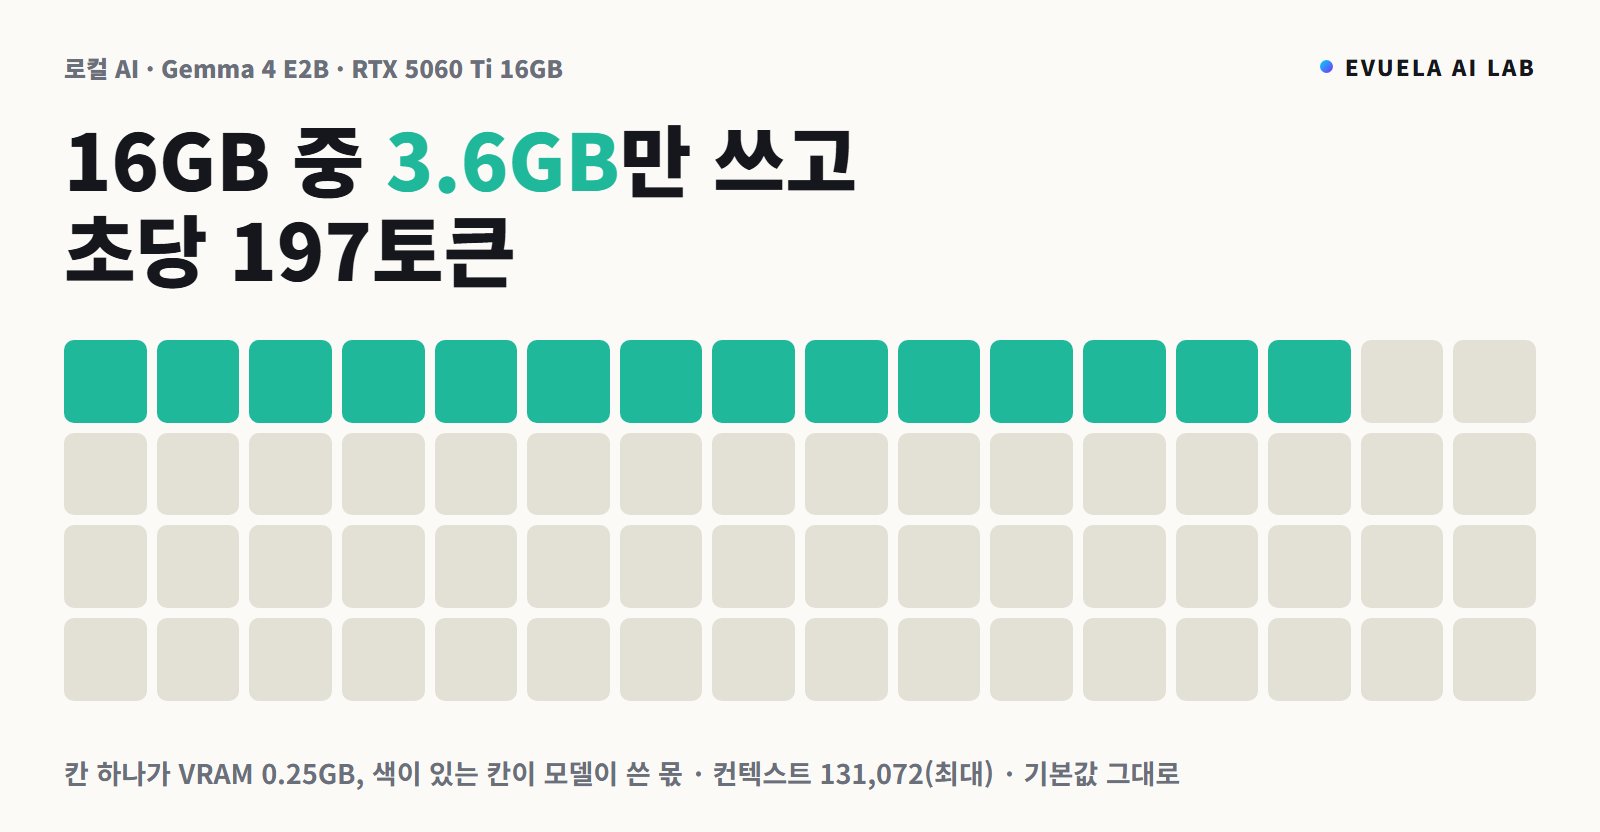
OpenAI가 2025년 8월에 가중치를 공개한 모델입니다. MoE(Mixture of Experts) 구조라서 전체 파라미터는 21B이지만, 토큰 하나를 만들 때 실제로 쓰는 것은 3.6B입니다. 모델 카드에 "16GB 메모리 안에서 돈다"고 적혀 있습니다. 나온 지 1년이 넘었지만 unsloth 저장소 기준으로 내려받기가 약 49만 회입니다.
| 항목 | 내용 |
|---|---|
| 파라미터 | 전체 21B, 활성 3.6B (MoE) |
| 받은 파일 | unsloth/gpt-oss-20b-GGUF의 UD-Q4_K_XL 11.06GB (4비트) |
| 받는 데 걸린 시간 | 4분 42초 |
| 최대 컨텍스트 | 131,072토큰 |
| 입력 | 글만 (사진 입력 없음) |
| 생각(Thinking) | Low, Medium, High 세 단계. 끄는 선택지는 없음 |
| 그 밖의 기능 | 함수 호출, 구조화된 출력 등 에이전트용 기능 (이 글에서는 시험하지 않음) |
| 라이선스 | Apache 2.0 |
이 저장소의 파일은 크기가 10.7GB에서 12.9GB 사이에 몰려 있습니다. 2비트 파일(10.68GB)과 8비트 파일(11.28GB)의 차이가 0.6GB뿐입니다. OpenAI가 처음부터 줄인 형식(MXFP4)으로 공개한 모델이라 그렇습니다. 16GB 그래픽카드에서는 어느 파일을 골라도 들어가고, 이 글에서는 unsloth가 권하는 UD-Q4_K_XL을 썼습니다.
모델 카드에는 벤치마크 점수가 일부만 실려 있어서, 이 글에는 제작사 점수 표를 싣지 않았습니다.
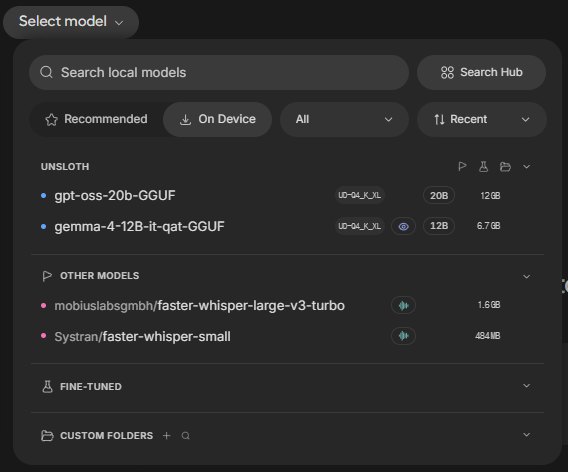
모델 선택 창입니다. 받아 둔 gpt-oss 20B(12GB)가 맨 위에 보입니다. 사진 입력을 뜻하는 눈 모양 표시가 없습니다.
Unsloth Studio 기본값(Auto)은 어떻게 올렸나
실행 설정 창에서 컨텍스트(모델이 한 번에 기억하는 글의 길이)를 기본값인 Auto로 두고 올렸습니다. 예상 메모리는 GPU 14.33GiB, 전체 14.71GiB로 나옵니다.
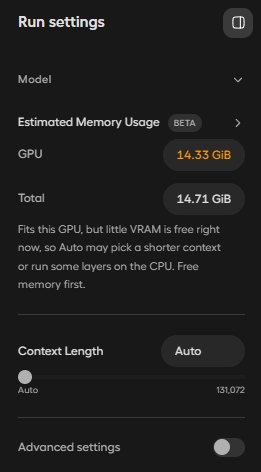
실행 설정 창입니다. 모델을 이미 올린 상태에서 찍어서 "지금은 남은 VRAM이 적다"는 안내가 붙어 있습니다.
| 설정 | Auto가 고른 값 | 뜻 |
|---|---|---|
| 컨텍스트 | 103,000~107,000 (올릴 때마다 조금 다름) | 최대 131,072의 약 80%. VRAM에 다 들어가는 가장 큰 크기로 잡는 것으로 보임 |
-ngl -1 --fit off | 레이어를 모두 GPU에 | 모델 전체를 그래픽카드에 올림 |
--threads 2 | CPU 스레드 2개 | 모델이 GPU에 다 들어가서 CPU는 적게 씀 |
| 생각 단계 | API는 High, 앱 화면은 Medium | API로 아무것도 지정하지 않으면 High로 답함. 앱 입력칸의 기본 표시는 Medium |
| KV 캐시 | f16 | 줄이지 않은 기본값 |
같은 PC에서 잰 30B급 모델들은 Auto가 컨텍스트를 약 8천 토큰으로 줄였습니다. 이 모델은 파일이 11GB라서 16GB에 여유가 있고, Auto가 그 여유를 컨텍스트에 썼습니다.
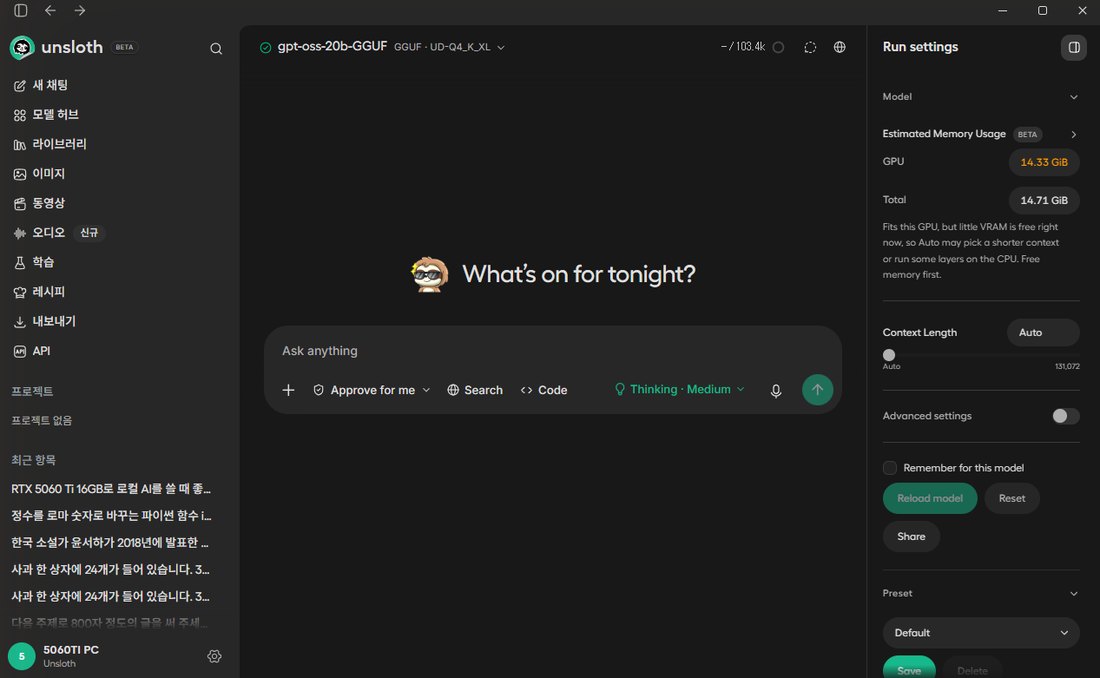
로드가 끝난 화면입니다. 이번에는 컨텍스트가 103.4k로 잡혔고, 입력칸에 Thinking · Medium이 보입니다.
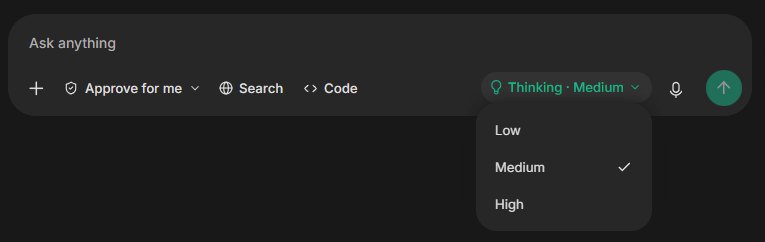
생각 단계 메뉴입니다. Low, Medium, High 세 가지이고, 끄는 선택지는 없습니다.
VRAM과 시스템 램: Auto에서 VRAM 13.4GB
로드 직전과 직후의 GPU 메모리와 PC 전체 램의 차이를 쟀습니다. 로드 전에 윈도우와 다른 프로그램이 VRAM 약 0.6GB, 램 약 9.8GB를 쓰고 있었습니다.
| 컨텍스트 | 모델이 쓴 VRAM | PC 전체 VRAM | 늘어난 시스템 램 | 로드 시간 | 16GB에서 |
|---|---|---|---|---|---|
| 8,192 | 11.0GB | 11.6GB | - | - | 원활 |
| 32,768 | 11.6GB | 12.2GB | 1.1GB | 9.3초 | 원활 |
| 65,536 | 12.4GB | 13.0GB | 1.1GB | 9.3초 | 원활 |
| 106,496 (Auto) | 13.4GB | 14.0GB | 1.1GB | 처음 25.2초, 다시 로드 9.4초 | 원활 (남는 VRAM 1.9GB로 경계) |
| 131,072 (최대) | 13.8GB | 14.4GB | 1.3GB | 15.9초 | 제한적 (일부를 CPU가 맡음) |
기본값에서 PC 전체 VRAM이 14.0GB까지 찹니다. 16GB에서 다른 GPU 작업을 함께 돌릴 자리는 거의 없습니다. 자리를 남기려면 컨텍스트를 줄이면 됩니다. 32,768로 줄이면 12.2GB이고 속도는 그대로입니다.
최대 컨텍스트 131,072에서는 Unsloth Studio가 올리는 방식을 바꿉니다(--fit on). 모델 전체가 VRAM에 들어가지 않아 일부를 CPU가 맡고, 속도가 약 12% 내려갑니다. 로드 시간은 디스크에서 처음 읽을 때 25.2초, 내렸다가 바로 다시 올리면 9.4초였습니다. 이 PC는 SATA SSD입니다.
생성 속도: Auto에서 평균 119.8t/s
"집에 있는 PC로 AI 모델을 돌릴 때 알아야 할 점"으로 800자 글을 쓰게 했습니다. 이 모델은 생각을 끌 수 없습니다. 다른 모델에서 "생각 끔"으로 잰 요청을 그대로 보내면 생각을 13~56토큰만 하고 바로 답합니다. 이 글에서는 이 상태를 "생각 최소"라고 부릅니다. 이 상태로 5번 이어서 물었습니다.
| 순서 | 생성 속도 | 첫 토큰까지(TTFT) | 답 토큰 | 전체 시간 |
|---|---|---|---|---|
| 1번째 (로드 직후) | 121.0t/s | 0.35초 | 1,406 | 12.0초 |
| 2번째 | 119.5t/s | 0.17초 | 1,293 | 11.0초 |
| 3번째 | 118.2t/s | 0.15초 | 961 | 8.3초 |
| 4번째 | 118.8t/s | 0.13초 | 1,396 | 11.9초 |
| 5번째 | 121.6t/s | 0.14초 | 745 | 6.3초 |
| 평균 (최소~최대, 표준편차) | 119.8t/s (118.2~121.6, 1.4) | 0.19초 | 1,160 | 9.9초 |
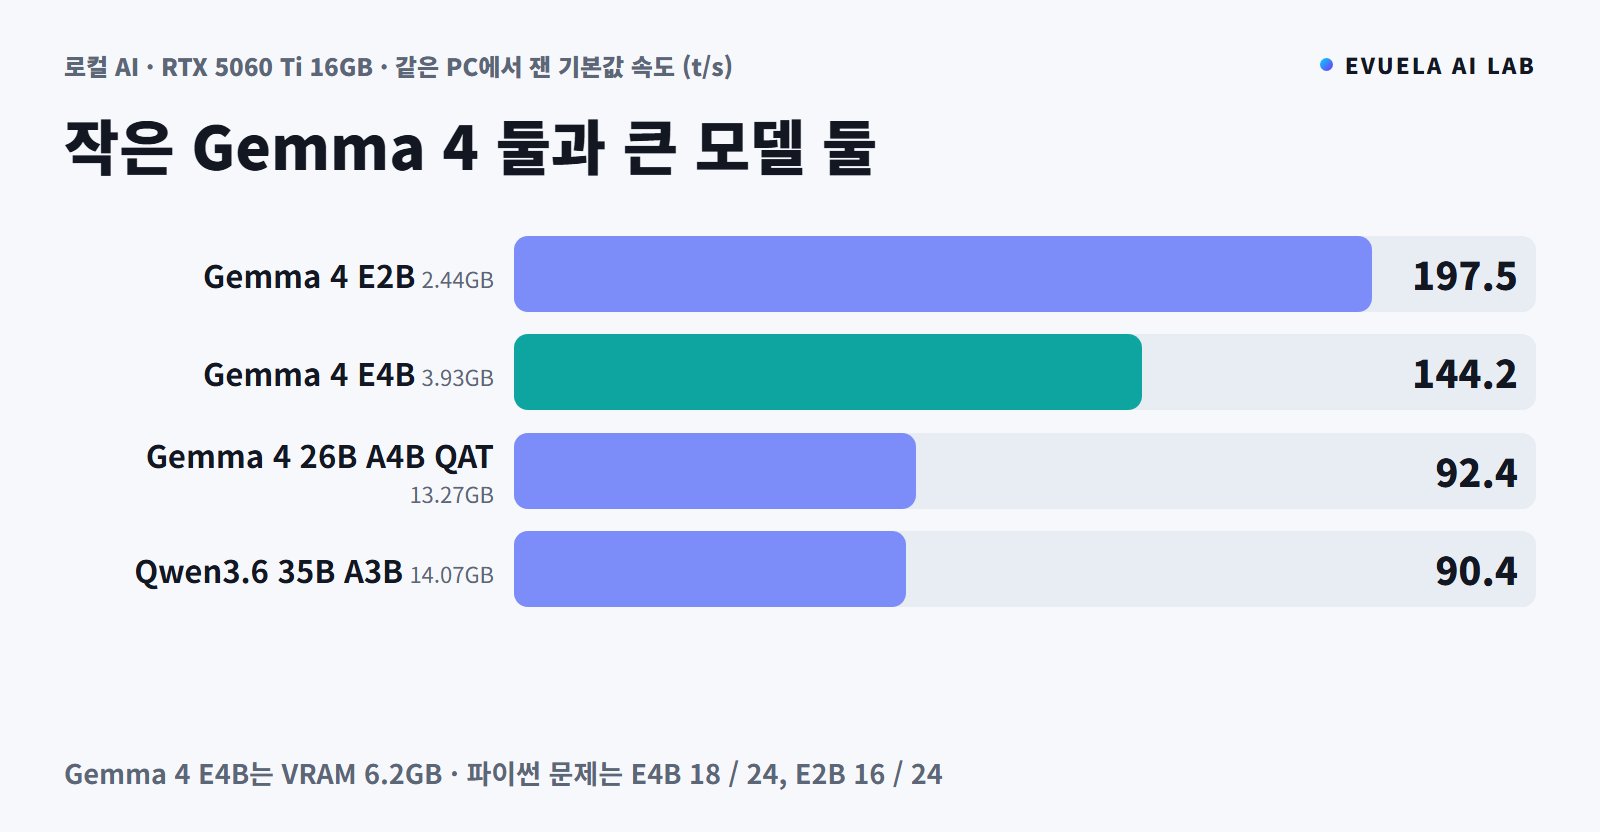
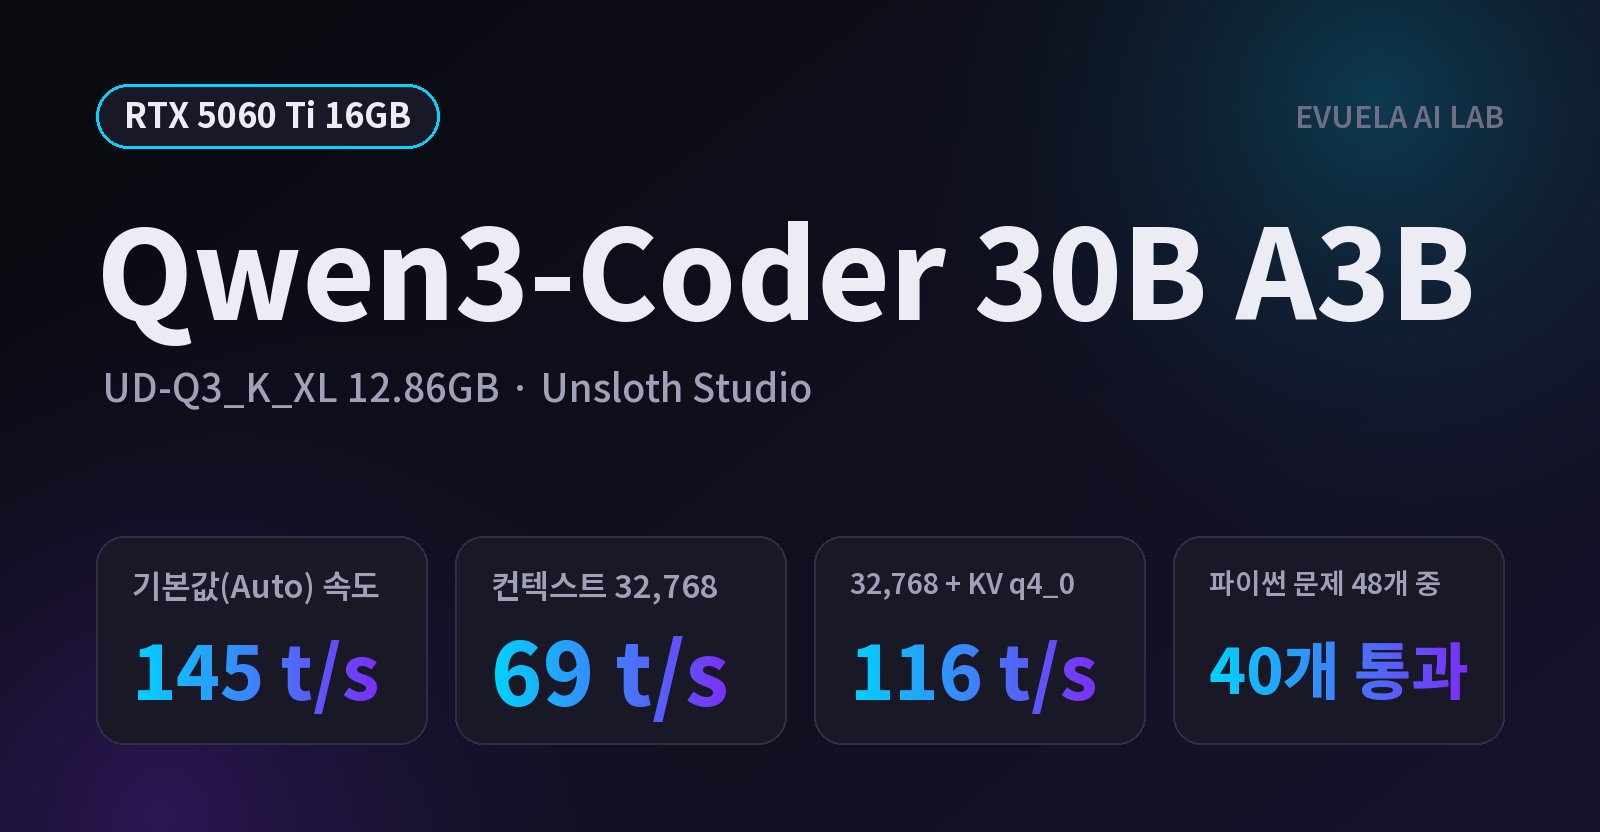
5번이 고르게 나왔고, GPU 사용률은 평균 81%였습니다. 같은 PC에서 Gemma 4 26B A4B QAT가 92.4t/s, Qwen3.6 35B A3B가 90.4t/s였습니다. Qwen3-Coder 30B A3B는 145.3t/s였지만 그때 컨텍스트는 8,192였습니다. 이 모델은 컨텍스트 106,496에서 낸 값입니다. 800자를 써 달라고 했는데 답은 1,438~2,851자로 두세 배 길었습니다.
생각 단계를 High로 두면: 29초에서 219초까지
API로 생각 단계를 지정하지 않으면 Unsloth Studio는 High로 답하게 합니다. 이 상태로 같은 800자 글을 여러 조건에서 16번 받았습니다.
| 단계 | 생각 최소 (5번) | 생각 High (기본 측정 3번) |
|---|---|---|
| 질문을 읽고 첫 토큰까지 | 0.13~0.35초 | 약 0.1초 |
| 생각에 쓴 토큰 | 13~56 | 24,532 / 4,466 / 11,871 |
| 질문부터 답 끝까지 | 6.3~12.0초 | 218.8 / 34.7 / 98.8초 |
| 생성 속도 | 118.2~121.6t/s | 113.5 / 137.3 / 123.4t/s |
| 답의 길이 | 1,438~2,851자 | 726 / 921 / 754자 |
High에서는 걸리는 시간이 들쭉날쭉합니다. 컨텍스트와 설정을 바꿔 가며 받은 16번이 29초에서 219초 사이였습니다. 가장 오래 걸린 때는 생각에만 약 24,500토큰을 썼습니다. 대신 답은 요청한 800자에 가까웠습니다(726~921자). 생각을 최소로 하면 빨리 끝나지만 답이 두세 배 길어집니다.
800자 글처럼 단순한 일에는 High가 지나칩니다. 앱 화면의 기본값인 Medium으로 같은 글을 받았을 때는 40초 안에 끝났습니다(한 번 확인). Medium과 Low의 시간을 API로 따로 재지는 않았습니다.
컨텍스트를 늘리면: 65,536까지 그대로
컨텍스트만 바꿔 다시 로드하며 같은 800자 글을 쟀습니다(생각 최소 2번).
| 컨텍스트 | 생성 속도 (생각 최소) | 15,000자 요약 TTFT | Qwen3-Coder 30B A3B (115번 글) |
|---|---|---|---|
| 8,192 | 121.8 / 121.4t/s | 1.7초 | 145.3t/s |
| 16,384 | 123.1 / 122.2t/s | 2.0초 | 약 106t/s |
| 32,768 | 123.0 / 122.4t/s | 1.8초 | 약 69t/s |
| 65,536 | 121.9 / 122.0t/s | 1.8초 | 약 44t/s |
| 131,072 (최대) | 108.3 / 106.6t/s | 1.8초 | 약 25t/s |
65,536까지 속도가 같고, 최대 컨텍스트에서만 약 12% 내려갑니다. 파일 크기가 비슷한 Qwen3-Coder 30B A3B(12.86GB)는 16,384에서 이미 느려지기 시작해 131,072에서는 약 25t/s였습니다. 긴 컨텍스트에서는 이 모델이 네 배쯤 빠릅니다. 파일이 1.8GB 작아서 컨텍스트에 쓸 VRAM이 그만큼 더 남기 때문으로 보입니다(추정).
설정을 바꾸면: 최대 컨텍스트에는 KV 캐시 q4_0
기본값(Auto)에서 설정을 하나씩만 바꿔 다시 로드하고, 같은 800자 글을 3번씩 쟀습니다(생각 최소 평균). 설정은 Unsloth Studio API의 로드 옵션으로 바꿨습니다. KV 캐시는 실행 설정 창의 고급 항목에도 있습니다.
| 설정 | 생성 속도 (3번 평균) | 15,000자 요약 TTFT | 모델이 쓴 VRAM | 늘어난 시스템 램 |
|---|---|---|---|---|
| Auto (기본값, 이때 컨텍스트 106,752) | 117.6t/s | 1.9초 | 13.4GB | 1.2GB |
| 가속 기능 끔 (Speculative Decoding off) | 117.4t/s | 2.0초 | 13.3GB | 1.1GB |
| 컨텍스트 32,768 | 117.1t/s | 1.8초 | 11.6GB | 1.1GB |
| 컨텍스트 32,768, KV 캐시 q4_0 | 113.8t/s | 1.8초 | 11.1GB | 1.0GB |
| 컨텍스트 131,072, KV 캐시 기본(f16) | 103.0t/s | 1.9초 | 13.8GB | 1.3GB |
| 컨텍스트 131,072, KV 캐시 q8_0 | 115.1t/s | 2.2초 | 12.6GB | 1.2GB |
| 컨텍스트 131,072, KV 캐시 q4_0 | 112.3t/s | 1.8초 | 11.9GB | 1.1GB |
| 컨텍스트 131,072 + 레이어 GPU 고정 | 116.0t/s | 1.8초 | 14.0GB | 11.1GB |
- 최대 컨텍스트를 쓰려면 KV 캐시를 줄입니다. KV 캐시는 지금까지 읽은 글을 기억해 두는 공간입니다. q8_0으로 줄이면 103.0t/s가 115.1t/s로 올라 기본값과 거의 같아지고, VRAM도 1.2GB 줄어듭니다. q4_0은 VRAM을 1.9GB 줄입니다. 줄인 만큼 긴 글에서 답의 정확도가 달라지는지는 재지 않았습니다.
- 레이어를 GPU에 고정하는 방법은 권하지 않습니다. 속도는 116.0t/s로 나왔지만 시스템 램이 11.1GB 늘었습니다. 다른 설정은 1GB 남짓 늘어납니다. 램이 16GB인 PC라면 위험합니다.
- 기본 컨텍스트에서는 손댈 것이 없었습니다. 가속 기능을 끄거나 컨텍스트를 줄여도 속도가 같았습니다. 이 저장소에는 MTP용 파일이 없습니다.
다른 곳의 측정과 견주기
같은 모델을 잰 다른 기록 세 가지와 조건을 나란히 놓았습니다. 숫자는 각 글쓴이가 잰 값입니다.
| 항목 | 이 글 | Hardware Corner (2025년 10월) | arXiv 2601.09527 (2026년 1월) | 엔비디아 블로그 (2025년 8월) |
|---|---|---|---|---|
| 장비 | RTX 5060 Ti 16GB | RTX 3090 24GB | RTX 5060 Ti 16GB | RTX 5090 32GB |
| 파일 | UD-Q4_K_XL 11.06GB | MXFP4 | MXFP4 | 적혀 있지 않음 |
| 프로그램 | Unsloth Studio (llama.cpp build 11160), 윈도우 11 | 리눅스 llama.cpp / 윈도우 11 LM Studio | vLLM 0.12 | 적혀 있지 않음 |
| 컨텍스트 | 106,496 / 131,072 | 2,000~131,000 | 입력·출력 256토큰 | 적혀 있지 않음 |
| 동시 요청 | 1개 | 1개 | 32개 | 적혀 있지 않음 |
| 생성 속도 | 119.8t/s / 약 107t/s | 리눅스: 4,000에서 147.5t/s, 131,000에서 62.2t/s. 윈도우: 2,000에서 35.9t/s | 32개 합쳐서 487.8t/s | 최대 256t/s |
RTX 3090의 리눅스 기록은 짧은 컨텍스트에서 이 글보다 빠르고(147.5t/s), 13만 토큰 근처에서는 느립니다(62.2t/s). 다만 그 표는 컨텍스트를 실제로 그만큼 채운 상태로 보이고, 이 글은 컨텍스트를 크게 잡기만 하고 짧은 글을 쓰게 한 값이라 조건이 다릅니다. 같은 글의 윈도우 LM Studio 기록은 35.9t/s로, 같은 그래픽카드인데 네 배 차이가 납니다. 프로그램과 설정에 따라 속도가 크게 갈린다는 뜻입니다. 같은 RTX 5060 Ti로 잰 논문의 487.8t/s는 요청 32개를 동시에 처리한 합계라서, 한 사람이 쓸 때의 속도와 견줄 수 없습니다.
화면에서 돌린 영상
새 채팅을 열고 질문 하나를 보낸 영상입니다(11초, 소리 없음, 생각 단계 Low).
영상에는 초당 103.4토큰으로 찍혔습니다. 화면 녹화 프로그램이 CPU를 쓰는 동안 찍었기 때문에 표의 숫자(약 120t/s)보다 느립니다. 답의 내용에는 틀린 말이 섞여 있습니다. 이 그래픽카드의 메모리 종류와 소비 전력을 실제와 다르게 적었습니다. 속도를 보여 주려는 영상이니 내용은 참고하지 마세요. 녹화에 쓴 프로그램은 103번 글에서 소개했습니다.
산수: 생각을 최소로 해도 5/5
"사과 한 상자에 24개가 들어 있습니다. 3상자를 사서 19개를 먹고, 남은 것을 5명이 똑같이 나누면 한 사람당 몇 개이고 몇 개가 남나요? '한 사람당 X개, 남는 것 Y개' 형식으로만 답하세요."를 5번씩 물었습니다. 정답은 한 사람당 10개, 남는 것 3개입니다.
| 생각 | 정답 | 답 | 걸린 시간 |
|---|---|---|---|
| 최소 | 5 / 5 | "한 사람당 10개, 남는 것 3개" 5번 | 약 0.6초 (답까지 58~76토큰) |
| High | 5 / 5 | "한 사람당 10개, 남는 것 3개" 5번 | 2.2~4.5초 (생각 289~553토큰) |
이 PC에서 잰 모델 가운데 처음으로 "생각 끔" 요청에서 산수를 모두 맞혔습니다. Gemma 4와 Qwen3.6은 생각을 끄면 5번 모두 틀렸고, 켜야 맞았습니다. 차이는 이 모델이 생각을 완전히 끄지 않는다는 데 있습니다. 답하기 전에 짧게라도 계산을 합니다. 10번 모두 정해 준 형식도 지켰습니다.
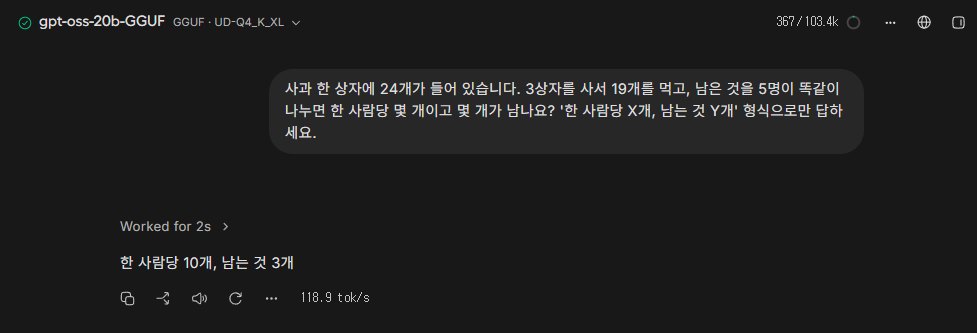
앱 화면에서 물은 답입니다(생각 단계 Medium). 2초 생각한 뒤 "한 사람당 10개, 남는 것 3개"로 맞혔습니다.
코딩: 파이썬 8문제를 3번씩, 생각 최소 20/24 · High 16/24
파이썬 함수 8개를 짜게 하고, 숨겨 둔 테스트로 채점했습니다. 문제는 구간 합치기, 로마 숫자 변환, 수식 계산기, 가장 긴 회문, 다음 영업일, 많이 나온 낱말, 나선 순서, 한글 숫자를 정수로 바꾸기입니다. 8문제를 처음부터 끝까지 3번 풀게 했습니다.
| 생각 | 1회 | 2회 | 3회 | 합계 | 8문제 전체 시간 |
|---|---|---|---|---|---|
| 최소 (답 최대 2,000토큰) | 7 / 8 | 6 / 8 | 7 / 8 | 20 / 24 | 16~27초 |
| High (최대 8,000토큰) | 5 / 8 | 5 / 8 | 6 / 8 | 16 / 24 | 3분 6초~4분 48초 |
| 문제 | 생각 최소 (3번 중) | 생각 High (3번 중) |
|---|---|---|
| 구간 합치기, 로마 숫자, 많이 나온 낱말, 나선 순서 | 3번 모두 통과 | 3번 모두 통과 |
| 수식 계산기 | 3번 모두 통과 | 0번 (3번 모두 8,000토큰 안에 못 끝냄) |
| 가장 긴 회문 | 3번 모두 통과 | 1번 통과 (2번은 8,000토큰 안에 못 끝냄) |
| 다음 영업일 | 2번 통과 | 3번 모두 통과 |
| 한글 숫자를 정수로 | 0번 (2번은 테스트 10개 중 9개까지 맞음) | 0번 (3번 모두 8,000토큰 안에 못 끝냄) |
| 모델 (같은 PC, 같은 문제) | 생각 끔 또는 최소 | 생각 켬 |
|---|---|---|
| gpt-oss 20B (11.06GB) | 20 / 24 | 16 / 24 (High) |
| Gemma 4 26B A4B QAT (13.27GB) | 19 / 24 | 21 / 24 |
| Qwen3.6 35B A3B (14.07GB) | 18 / 24 | 20 / 24 |
| Gemma 4 E4B (3.93GB) | 18 / 24 | 18 / 24 |
| Qwen3-Coder 30B A3B (12.86GB, 생각 기능 없음) | 40 / 48 (24개 기준 20개) | |
- 생각을 최소로 했을 때 가장 잘 풀었습니다. 24개 중 20개로, 코딩용인 Qwen3-Coder 30B A3B와 같은 비율입니다. 다른 모델들이 대부분 실패한 수식 계산기를 3번 모두 통과했습니다. 한글 숫자 문제도 테스트 10개 중 9개까지 맞힌 적이 두 번 있습니다. 이 문제는 지금까지 어느 모델도 통과하지 못했습니다.
- High로 올리자 오히려 4개가 줄었습니다. 실패한 8번 가운데 8번 모두 생각이 길어져 8,000토큰 한도 안에 답을 끝내지 못한 경우입니다. 모델이 문제를 틀리게 푼 것이 아니라 답을 내기 전에 한도가 찼습니다. 한도를 더 주면 결과가 달라질 수 있습니다. 한도를 늘려 다시 재지는 않았습니다.
- 시간 차이가 큽니다. 8문제에 생각 최소는 16~27초, High는 3~5분이었습니다. 함수 하나를 짜는 정도의 일에는 생각을 길게 시킬 이유가 없었습니다.
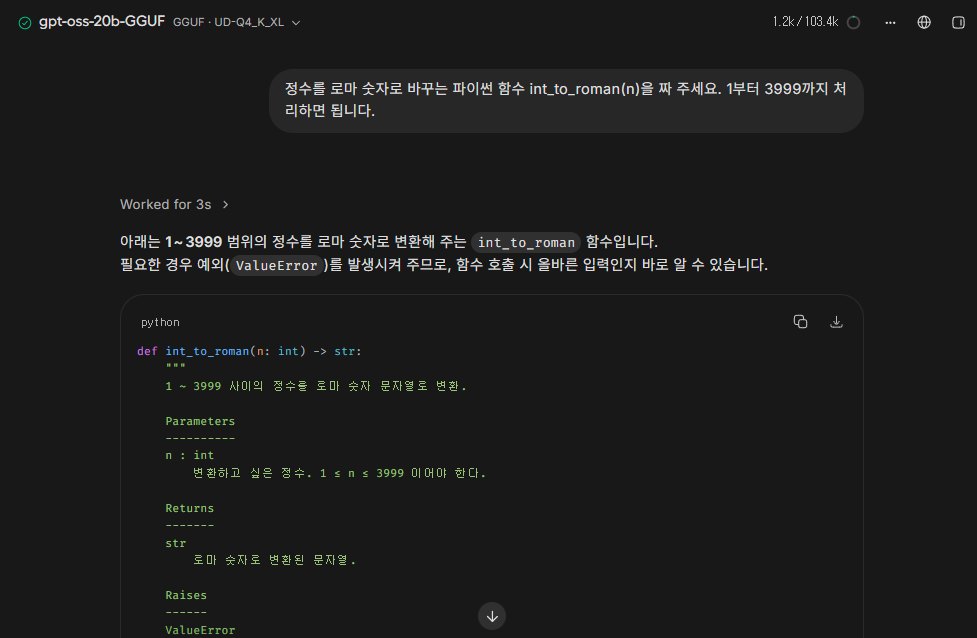
정수를 로마 숫자로 바꾸는 함수를 짜게 한 화면입니다(생각 단계 Medium). 3초 생각한 뒤 코드를 썼습니다.
긴 글 요약과 긴 대화
이 블로그의 업데이트 기록을 넣어 세 문장으로 요약하게 했습니다(생각 최소). 3,000자와 15,000자는 컨텍스트 32,768, 100,000자는 131,072에서 넣었습니다.
| 넣은 글 | 입력 토큰 | TTFT | 생성 속도 | 결과 |
|---|---|---|---|---|
| 3,000자 | 1,646 | 0.8초 | 121.4t/s | 세 문장으로 요약 |
| 15,000자 | 8,036 | 1.4초 | 116.4t/s | 세 문장으로 요약 (날짜별로 한 문장씩) |
| 100,000자 | 46,771 | 16.7초 | 82.6t/s | 세 문장으로 요약 |
세 번 모두 요청한 "세 문장"을 지켰습니다. 하루 전에 잰 Gemma 4 E2B와 E4B는 긴 글에서 문장 수를 지키지 않았습니다. 약 4만 7천 토큰짜리 글은 16.7초 만에 읽고 답을 쓰기 시작했습니다.
대화가 길어질 때를 보려고, 앞에 긴 글을 두고 한 문장짜리 질문을 붙였습니다(컨텍스트 32,768).
| 앞에 쌓인 토큰 | TTFT | 생성 속도 |
|---|---|---|
| 1,127 | 0.8초 | 157.6t/s |
| 8,534 | 1.8초 | 162.5t/s |
| 20,227 | 3.2초 | 134.7t/s |
약 2만 토큰이 쌓여도 첫 토큰까지 3.2초였습니다. 이 표의 속도가 800자 글보다 높게 나온 것은 답이 한 문장으로 짧고, 가속 기능이 앞 글에 나온 표현을 미리 채워 넣기 때문으로 보입니다(추정).
긴 문서에서 정보 찾기: 5번 모두 찾음 (한도를 늘려 다시 잰 값)
약 10,200토큰짜리 글의 10%, 30%, 50%, 70%, 90% 위치에 "블로그 관리자가 키우는 고양이 보리차는 2019년에 태어났다"는 문장을 하나 숨기고, 고양이 이름과 태어난 해를 물었습니다.
처음에는 다른 모델과 똑같이 답 한도를 60토큰으로 두고 쟀는데, 5번 모두 답이 중간에 잘렸습니다("이름: 보리차, 태어난 해: 201"처럼). 이 모델은 생각을 최소로 해도 수십 토큰을 생각에 쓰기 때문에, 60토큰으로는 답을 끝내지 못했습니다. 한도를 600토큰으로 늘려 다시 재자 5번 모두 정해 준 형식대로 보리차와 2019를 답했습니다(답까지 61~136토큰, 2.7~3.2초). 문장을 숨기지 않은 글에서는 "없음"이라고 답했습니다. 잘린 첫 측정에서 한 번은 이름을 "Bora"라고 적기 시작했습니다.
이 모델을 API로 쓸 때는 답 길이 한도를 넉넉하게 줘야 합니다. 생각에 쓰는 토큰이 한도에 함께 들어가기 때문입니다.
전력과 온도: 평균 약 118W, 최고 64도
800자 글을 쓰는 동안 0.5초마다 그래픽카드 상태를 읽었습니다(컨텍스트 32,768, 생각 최소, 2번).
| 항목 | gpt-oss 20B | Qwen3.6 35B A3B | Gemma 4 26B A4B QAT | Gemma 4 E4B |
|---|---|---|---|---|
| 쉬고 있을 때 전력 | 약 12W | 약 13W | 약 11.5W | 약 12W |
| 글 쓰는 동안 평균 전력 | 117~118W | 91~97W | 60~62W | 95~97W |
| 최고 전력 | 141W | 123W | 78W | 113W |
| 최고 온도 | 62~64도 | 61~63도 | 48~49도 | 56~58도 |
| 평균 GPU 사용률 | 77~79% | 72% | 35~36% | 69~70% |
| 토큰 하나에 쓴 전기 | 약 1.0J | 약 1.1J | 약 0.75J | 약 0.7J |
글을 쓰는 동안의 평균 전력이 이 PC에서 잰 모델 중 가장 높습니다. 그래픽카드를 80% 가까이 씁니다. 그래도 전력 제한 180W 안이고, 온도는 64도를 넘지 않았습니다. 생각 단계를 High로 두고 몇 분씩 생각하게 하면 이 전력을 그 시간 내내 씁니다.
없는 소설과 사진
실제로 없는 소설("윤서하의 2018년 장편소설 『푸른 등대의 겨울』")의 줄거리를 API로 한 번, 앱 화면에서 한 번 물었습니다. 2번 모두 그 작품의 자료를 찾을 수 없다고 답했고, 지어내지 않았습니다. 출판사 웹사이트나 도서관에서 찾아보라는 표를 붙였습니다.
다만 앱 화면에서는 한국어로 물었는데 영어로 답했습니다. API로 물었을 때는 한국어로 답했습니다. 앱 화면에서 받은 다른 답 네 개(800자 글, 산수, 코드, 시연 영상)는 한국어였습니다.
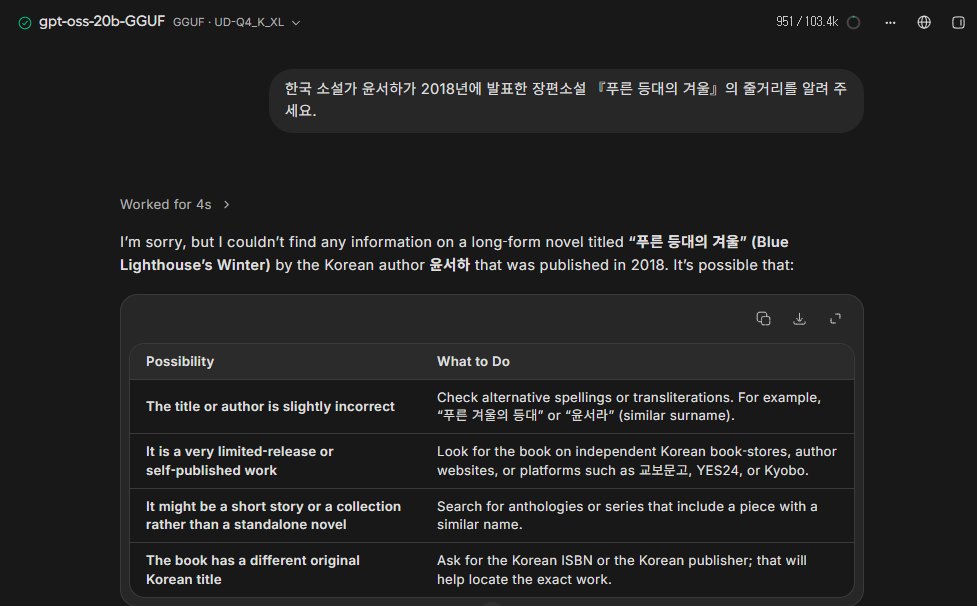
없는 소설을 물은 화면입니다. 지어내지는 않았지만, 한국어 질문에 영어로 답했습니다.
사진 설명은 하지 못했습니다. 이 모델은 글만 입력받고, 저장소에 이미지 입력용 파일이 없습니다. 사진을 붙여 API로 보내면 오류(400)가 돌아옵니다.
API로 받은 한국어 답 72개를 모두 확인했는데, 한자나 다른 나라 글자가 섞인 답은 없었습니다. 코드 설명에 영어 용어가 섞이는 정도입니다.
정리: 같은 PC의 다른 모델과 비교
| 항목 | gpt-oss 20B | Qwen3-Coder 30B A3B | Gemma 4 26B A4B QAT |
|---|---|---|---|
| 파일 | UD-Q4_K_XL 11.06GB (4비트) | UD-Q3_K_XL 12.86GB (3비트) | UD-Q4_K_XL 13.27GB (4비트, QAT) |
| Auto 컨텍스트 | 약 106,000 | 8,192 | 8,192 |
| Auto 속도 (5번 평균) | 119.8t/s | 145.3t/s | 92.4t/s |
| 모델이 쓴 VRAM (Auto) | 13.4GB | 13.7GB | 14.1GB |
| 컨텍스트 32,768 | 약 123t/s | 약 69t/s | 약 92t/s |
| 컨텍스트 131,072 (기본 / KV q4_0) | 약 107 / 112.3t/s | 약 25 / 58.7t/s | 약 63 / 79.1t/s |
| 생각 | Low·Medium·High (끌 수 없음) | 없음 | 켬·끔 |
| 산수 (생각 끔 또는 최소) | 5/5 | 0/10 | 0/5 |
| 코딩 8문제 3번 (끔 또는 최소) | 20/24 | 40/48 | 19/24 |
| 없는 소설 | 모른다고 답함 | 지어냄 | - |
| 사진 입력 | 없음 | 없음 | 있음 |
| 평균 전력 | 117~118W | 54~65W | 60~62W |
- 16GB에서 긴 컨텍스트를 빠르게 쓸 수 있는 20B급 모델입니다. 기본값이 컨텍스트 약 10만 토큰이고, 그 상태에서 약 120t/s입니다.
- 생각은 Low나 Medium이면 충분했습니다. 생각을 최소로 해도 산수와 코딩을 잘 풀었고, High는 시간만 몇 배 들고 코딩에서는 한도에 걸렸습니다. API로 쓸 때는 생각 단계를 직접 지정하는 편이 좋습니다. 지정하지 않으면 High로 답합니다.
- API로 쓸 때는 답 길이 한도를 넉넉히 줍니다. 생각에 쓰는 토큰이 한도에 들어가서, 한도가 작으면 답이 잘립니다.
- 아쉬운 점: 사진을 받지 않고, 전력을 많이 쓰고, 한국어 질문에 영어로 답한 적이 한 번 있습니다. 분량 요청도 생각을 최소로 하면 지키지 않습니다.
내 그래픽카드에서 다른 모델이 어느 정도 속도로 도는지는 GPU 체험에 있습니다.
이 글의 한계
- 2026년 10월 10일, Unsloth Studio 2026.9.14(llama.cpp build 11160), 그래픽 드라이버 617.42 기준입니다. 109·110번 글의 비교 값은 드라이버 616.92에서 잰 것입니다.
- UD-Q4_K_XL 파일 하나만 쟀습니다. OpenAI가 공개한 형식에 가까운 다른 파일과의 속도·품질 차이는 재지 않았습니다.
- "생각 최소"는 다른 모델의 "생각 끔"과 같은 조건이 아닙니다. 이 모델은 같은 요청에도 생각을 13~56토큰 합니다. 산수와 코딩 비교 표는 이 차이를 안고 있습니다.
- 생각 단계 Low와 Medium은 API로 따로 재지 않았습니다. 표의 숫자는 "생각 최소"와 High 두 가지이고, Medium과 Low는 앱 화면에서 한두 번 본 것입니다.
- 코딩의 High 결과는 답 한도 8,000토큰에 걸린 것이 대부분입니다. 한도를 늘려 다시 재지 않았습니다.
- 긴 문서에서 정보 찾기는 다른 모델과 한도가 다릅니다(다른 모델 60토큰, 이 모델 600토큰).
- 5번 반복은 기본값의 800자 글에만 했습니다. 컨텍스트별 표는 2번씩, 설정 비교 표는 3번씩 잰 값이고 요약은 조건마다 한 번입니다.
- Auto가 고르는 컨텍스트가 올릴 때마다 조금 달랐습니다(103,000~107,000).
- 컨텍스트를 실제로 가장 길게 채운 것은 약 4만 7천 토큰입니다.
- 함수 호출, 구조화된 출력 같은 에이전트용 기능은 시험하지 않았습니다.
- 앱 화면에서 영어로 답한 것은 한 번 본 일이고, 얼마나 자주 그러는지는 재지 않았습니다.
- KV 캐시를 줄였을 때 답의 품질이 달라지는지는 재지 않았습니다.
- 프로그램을 켠 직후의 첫 실행은 따로 재지 않았습니다.
자주 묻는 질문
RTX 5060 Ti 16GB에서 gpt-oss 20B는 몇 t/s인가요?
UD-Q4_K_XL(11.06GB) 파일을 Unsloth Studio 기본값으로 돌렸을 때 800자 글 기준 평균 119.8t/s(118.2~121.6)였습니다. 이때 컨텍스트는 약 106,000입니다. 컨텍스트 8,192부터 65,536까지는 약 122t/s, 최대 131,072에서는 약 107t/s입니다.
16GB 그래픽카드에는 어떤 파일을 받아야 하나요?
이 저장소의 파일은 모두 10.7~12.9GB라서 어느 것이든 들어갑니다. 이 글에서는 UD-Q4_K_XL을 썼고, 기본값에서 PC 전체 VRAM이 14.0GB였습니다.
생각(Thinking)을 끌 수 있나요?
끄는 선택지는 없고 Low, Medium, High 세 단계입니다. 생각을 끄라는 요청을 보내면 13~56토큰만 생각하고 답합니다. 이 상태로도 산수 5번을 모두 맞혔고 파이썬 문제는 24개 중 20개를 통과했습니다.
API로 쓰면 답이 중간에 잘리는데 왜 그런가요?
생각에 쓰는 토큰이 답 길이 한도에 함께 들어가기 때문입니다. 이 글에서도 한도를 60토큰으로 두었을 때 답이 5번 모두 잘렸고, 600토큰으로 늘리자 모두 제대로 나왔습니다.
댓글 0개