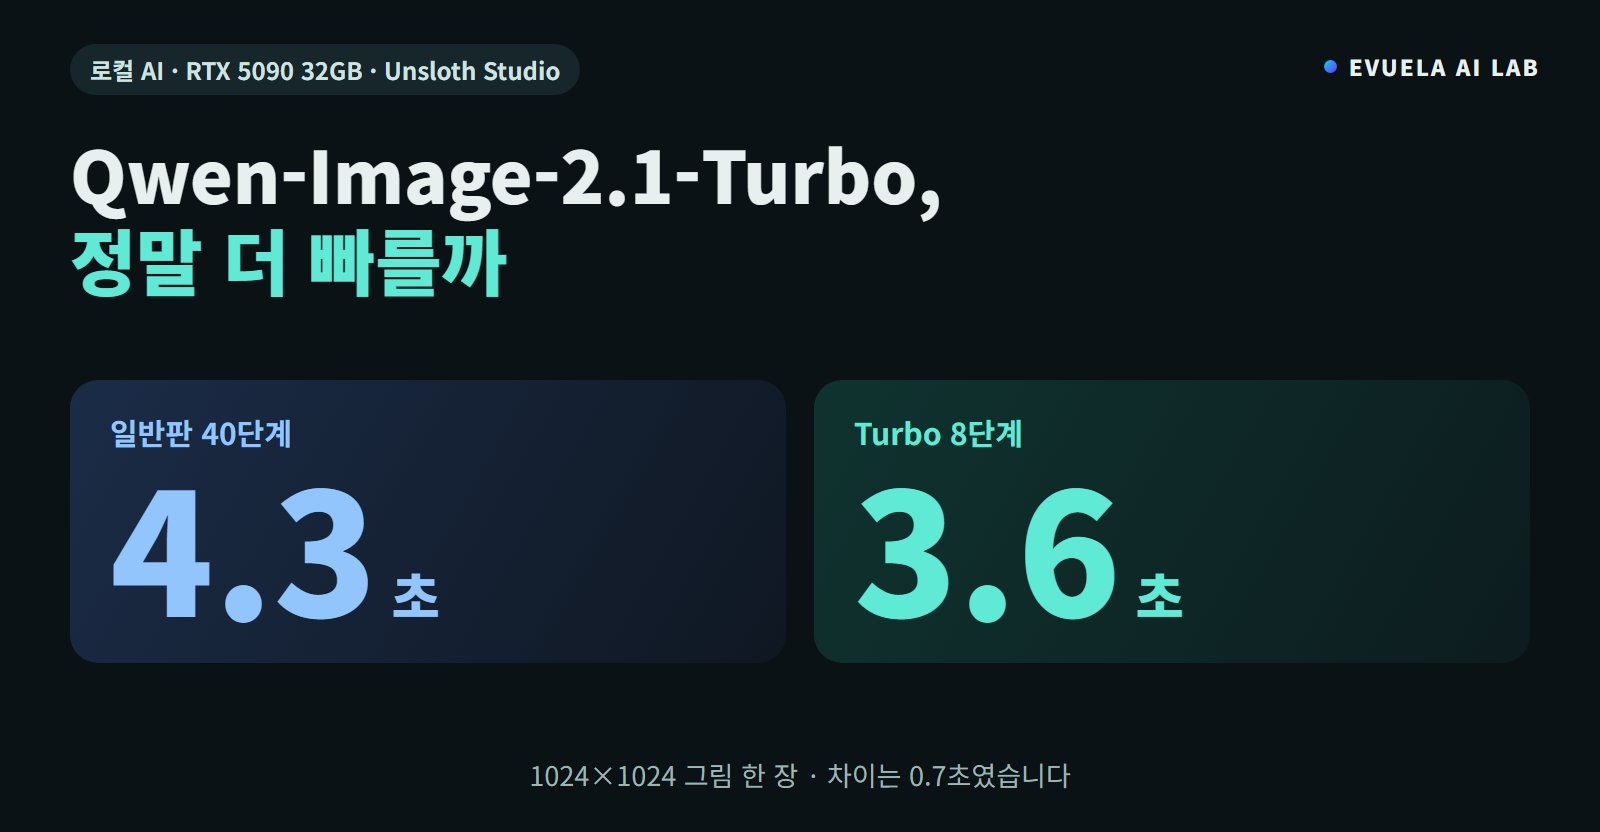
Qwen-Image-2.1-Turbo는 그림을 40단계가 아니라 8단계만에 만드는 빠른 판입니다. RTX 5090 32GB의 Unsloth Studio에서 일반판과 같은 질문으로 비교하니, 1024×1024 한 장에 Turbo는 3.6초, 일반판은 4.3초였습니다. 단계 수는 5분의 1인데 시간은 0.7초만 줄었습니다. 그리고 기본 설정 그대로 Turbo 파일을 올리면 Turbo가 아니라 일반판 가중치로 그림이 만들어졌습니다.
- 속도 차이는 작았습니다. Turbo Q8 8단계 3.58초, 일반판 40단계 4.32초. 같은 질문을 5번 만든 가운데 값입니다.
- 일반판이 생각보다 빨랐습니다. Unsloth Studio가 일반판의 40단계 가운데 18단계를 건너뛰고 22단계만 계산합니다.
- 기본 설정으로 올린 Turbo는 일반판이었습니다. 질문 8개 모두에서 "기본 설정 Turbo 8단계"와 "일반판 8단계"의 그림이 픽셀 하나 다르지 않았습니다.
- 설정 하나를 끄면 Turbo 가중치가 쓰입니다. 올릴 때 계산 방식 자동 선택(transformer_quant)을 끄면 됩니다.
- 이득은 VRAM에 있었습니다. Turbo Q8은 13.9GB, 일반판은 21.3GB를 썼습니다.
- 그림 품질은 비슷했고, 글자는 일반판이 조금 나았습니다. 한글 간판과 메뉴판은 셋 다 한두 글자를 틀렸습니다.
이 글의 숫자는 모두 RTX 5090 32GB PC 한 대에서 2026년 10월 10일에 직접 잰 값입니다. 프로그램은 Unsloth Studio 2026.10.3이고, 화면이 아니라 이미지 API로 같은 질문과 같은 시드를 보내서 쟀습니다. 시간은 요청을 보낸 때부터 그림이 돌아올 때까지입니다. 모델 카드가 안내하는 diffusers 예제 코드로는 재지 않았습니다.
이 글의 내용을 20초로 요약한 영상입니다(소리 없음).
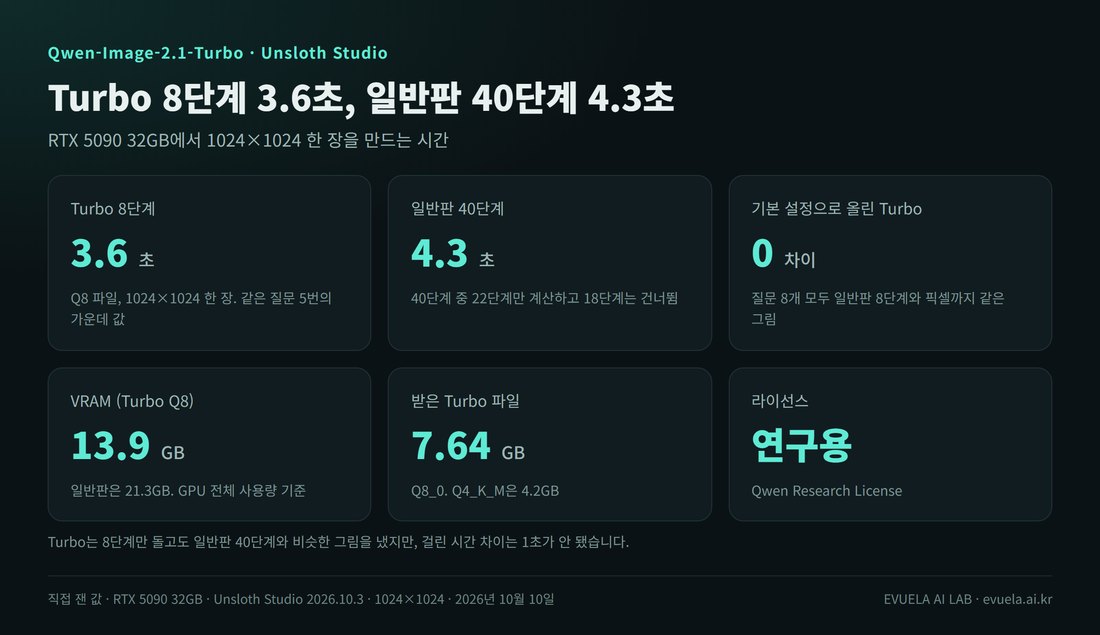
같은 질문, 같은 시드로 잰 결과입니다.
Qwen-Image-2.1-Turbo는 무엇인가요?
Qwen-Image-2.1은 알리바바 Qwen 팀이 공개한 그림 생성 모델입니다. 글을 넣으면 그림을 만들고, 그림 안에 글자를 넣는 데 강한 편입니다. 이 블로그는 일반판을 10월 4일에 테스트했습니다.
Turbo는 그 일반판을 더 적은 단계로 그림을 만들도록 다시 학습시킨 판입니다. 그림 생성 모델은 잡음에서 시작해 여러 단계에 걸쳐 그림을 다듬습니다. 일반판은 보통 40단계를 쓰고, Turbo는 8단계를 쓰도록 만들어졌습니다. 모델 카드는 Turbo를 이렇게 소개합니다.
"an accelerated checkpoint of Qwen-Image-2.1" (Qwen-Image-2.1-Turbo 모델 카드)
풀어 쓰면 일반판과 구조와 크기(7B)는 같고, 가중치만 빠르게 그리도록 바꾼 파일이라는 뜻입니다. 그래서 글을 이해하는 부분과 그림으로 바꾸는 부분(VAE)은 일반판의 것을 그대로 씁니다.
| 항목 | 일반판 | Turbo |
|---|---|---|
| 단계 수 | 40 (Unsloth Studio가 고른 값) | 8 (모델 카드가 정한 값) |
| 크기 | 7B | 7B |
| 이번에 쓴 파일 | Unsloth가 미리 만든 INT8 가중치 | GGUF Q8_0 7.64GB, Q4_K_M 4.2GB |
| 라이선스 | 연구·평가용 | Qwen Research License (연구용) |
이 표가 뜻하는 것: 두 모델의 차이는 단계 수입니다. 단계가 5분의 1이니 시간도 그만큼 줄 것이라고 기대하기 쉽습니다. 실제로 재 보니 그렇지 않았습니다.
테스트 PC와 방법
| 항목 | 내용 |
|---|---|
| 그래픽카드 | NVIDIA GeForce RTX 5090 (VRAM 32GB) |
| 프로그램 | Unsloth Studio 2026.10.3 (이미지 API) |
| Turbo 파일 | unsloth/Qwen-Image-2.1-Turbo-GGUF 의 Q8_0, Q4_K_M |
| 일반판 | unsloth/Qwen-Image-2.1 |
| 질문 | 106번 글과 같은 8개 + 어려운 질문 3개 + 인물 3개, 시드 고정 |
| 크기 | 1024×1024 (해상도 비교는 768부터 2048×1536까지) |
이 표가 뜻하는 것: 프로그램과 질문, 시드를 모두 같게 두고 모델만 바꿨습니다. 설정을 바꿀 때마다 모델을 내리고 VRAM이 빈 것을 확인한 뒤 다시 올렸습니다.
측정은 두 번 했습니다. 첫 번째는 설정을 바꿀 때마다 시작 상태가 달라 VRAM 값이 고르지 않았고, 마지막에 일반판의 큰 그림 한 장이 몇 분 동안 끝나지 않았습니다. 그래서 모두 내리고 순서를 맞춰 처음부터 다시 쟀습니다. 이 글의 숫자는 두 번째 측정입니다. 두 번의 시간은 0.1초 안에서 같았고, 같은 설정으로 만든 그림은 두 번 모두 픽셀까지 같았습니다.
결과 1. 기본 설정으로 올린 Turbo는 일반판이었다
가장 먼저 알려야 할 내용입니다. Unsloth Studio에서 Turbo GGUF 파일을 고르고 아무 설정도 바꾸지 않은 채 올리면, 화면에는 Turbo 파일 이름이 보이지만 그림은 일반판 가중치로 만들어집니다.
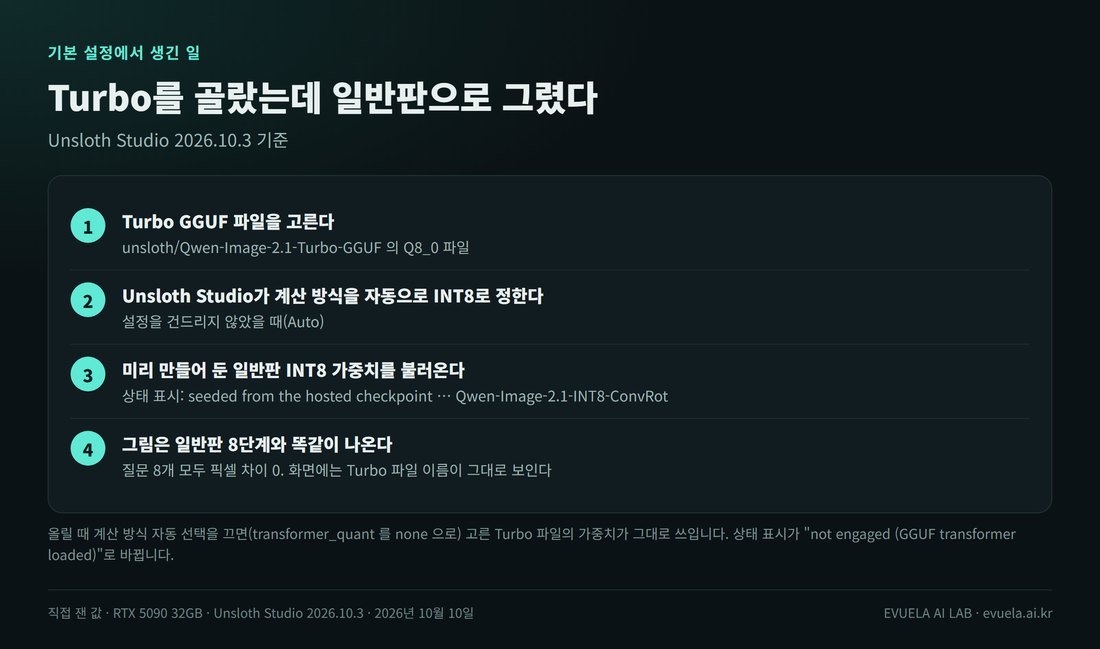
Unsloth Studio 2026.10.3에서 확인한 내용입니다.
Unsloth Studio는 그림 모델을 올릴 때 계산 방식을 자동으로 고릅니다. RTX 5090에서는 8비트 정수 방식(INT8)을 고르는데, 이때 계산을 빨리 시작하려고 미리 만들어 둔 INT8 가중치 파일을 내려받아 씁니다. 그 파일이 일반판의 것입니다. 모델 상태를 조회하면 이유가 이렇게 적혀 있습니다.
gguf_filename      qwen-image-2.1-turbo-Q8_0.gguf
transformer_quant  int8 (auto)
reason             seeded from the hosted checkpoint
                   unsloth/Qwen-Image-2.1-FP8/Qwen-Image-2.1-INT8-ConvRot.safetensors
정말 일반판인지 확인하려고 일반판을 따로 올려 같은 8단계로 그림을 만들고, 두 그림을 픽셀 단위로 비교했습니다.
| 비교 | 질문 8개의 픽셀 차이 |
|---|---|
| 기본 설정 Turbo 8단계와 일반판 8단계 | 8개 모두 0 (완전히 같은 그림) |
| 자동 선택을 끈 Turbo 8단계와 일반판 8단계 | 평균 8.0~35.1 (다른 그림) |
이 표가 뜻하는 것: 기본 설정으로 올린 Turbo는 일반판과 같은 가중치로 그렸습니다. 픽셀 차이는 0부터 255까지의 밝기 값으로 잰 것이고, 0은 한 점도 다르지 않다는 뜻입니다.
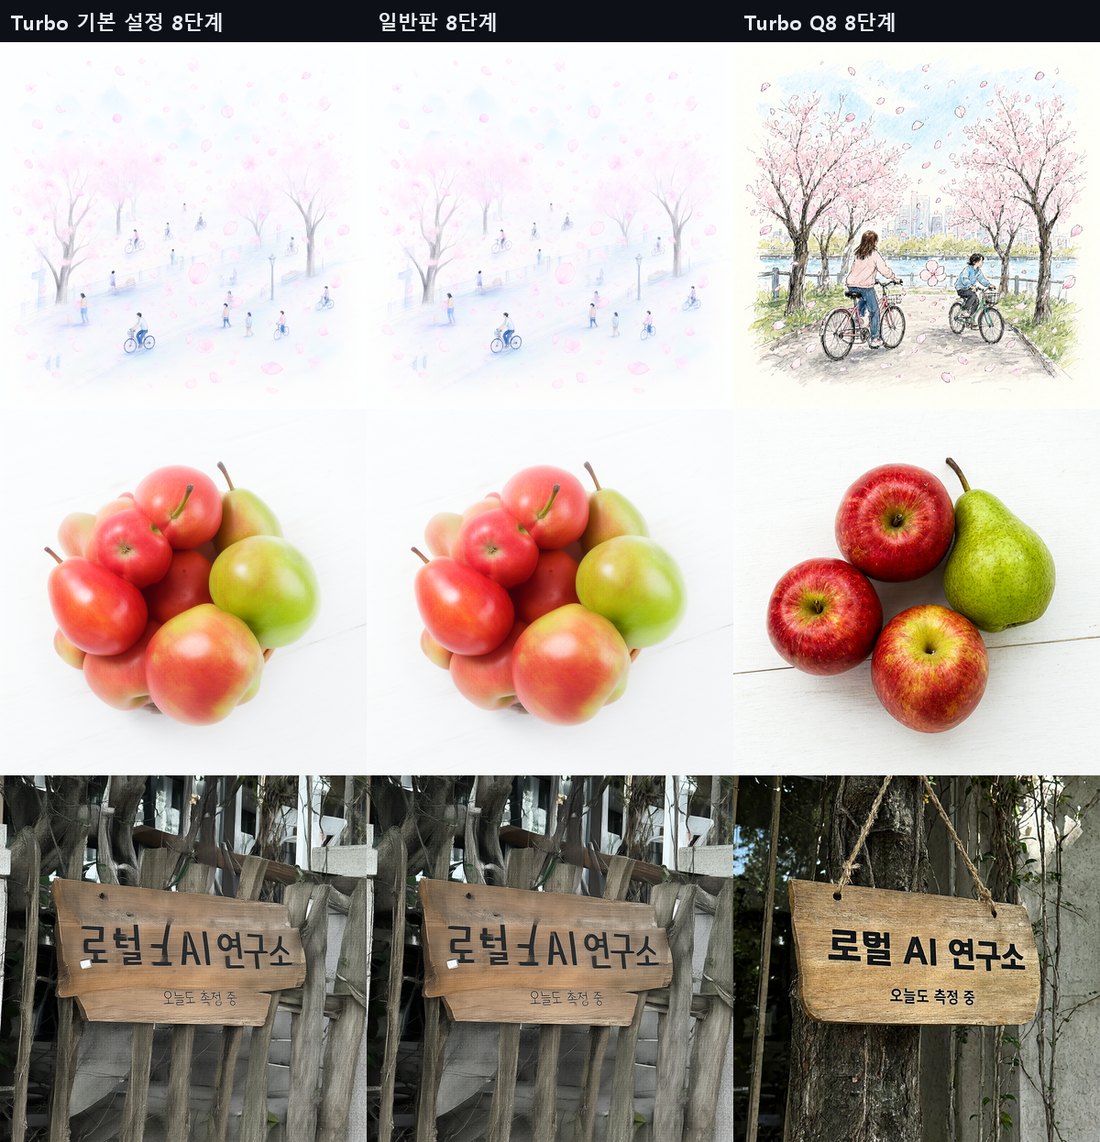
왼쪽과 가운데는 같은 그림입니다. 오른쪽이 실제 Turbo 가중치로 만든 그림입니다.
일반판은 40단계를 쓰도록 만들어진 모델이라 8단계에서는 그림이 덜 만들어집니다. 그래서 기본 설정으로 Turbo를 써 본 사람은 "Turbo는 빠르지만 그림이 흐리다"고 오해하기 쉽습니다. 실제로는 Turbo를 써 보지 못한 것입니다.
해결 방법
올릴 때 계산 방식 자동 선택을 끄면 고른 GGUF 파일의 가중치가 그대로 쓰입니다. 이미지 API로 올린다면 다음 값을 함께 보냅니다.
{
  "model_path": "unsloth/Qwen-Image-2.1-Turbo-GGUF",
  "gguf_filename": "qwen-image-2.1-turbo-Q8_0.gguf",
  "transformer_quant": "none"
}
이렇게 올린 뒤 상태를 조회하면 이유가 "not engaged (GGUF transformer loaded)"로 바뀝니다. 아래 결과에서 "Turbo Q8", "Turbo Q4"라고 적은 것은 모두 이렇게 올린 것입니다. 화면(GUI)에서 같은 설정을 어디서 바꾸는지는 이번에 확인하지 않았습니다.
결과 2. 그림 한 장에 걸린 시간
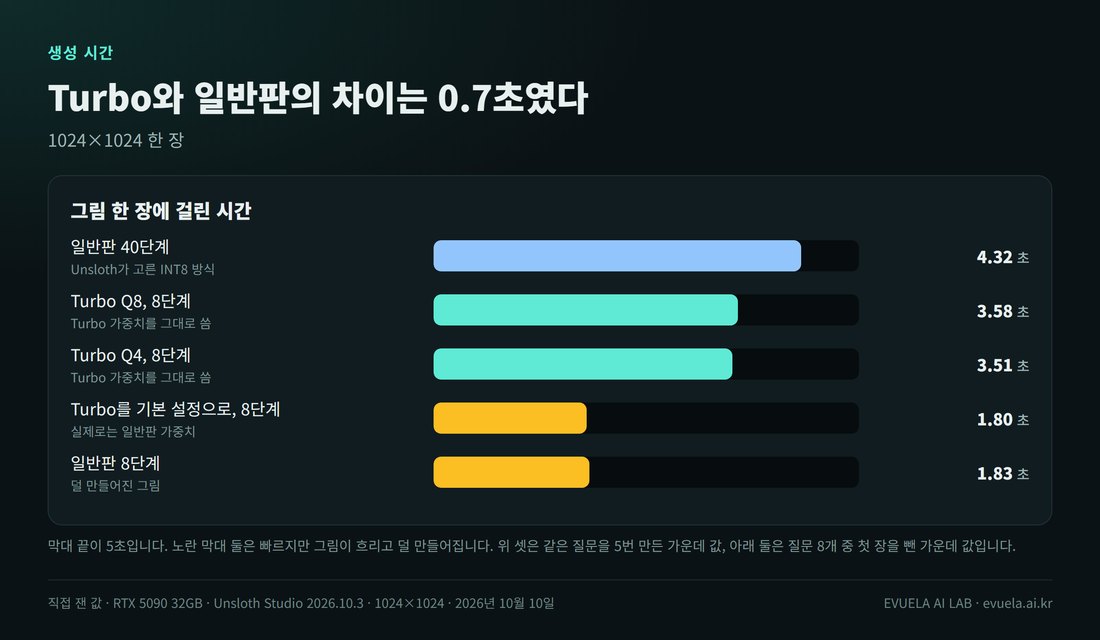
1024×1024 한 장을 만드는 시간입니다.
| 설정 | 같은 질문 5번 | 서로 다른 질문 7개 | 모델을 올린 뒤 첫 장 |
|---|---|---|---|
| 일반판 40단계 | 4.32초 (4.21~4.37) | 4.36초 | 4.87초 |
| Turbo Q8 8단계 | 3.58초 (3.56~3.62) | 4.14초 | 6.68초 |
| Turbo Q4 8단계 | 3.51초 (3.48~3.56) | 3.65초 | 4.87초 |
이 표가 뜻하는 것: 가운데 값이고 괄호는 가장 빠른 때와 가장 느린 때입니다. 같은 질문을 되풀이하면 Turbo가 0.7초 빨랐고, 질문이 매번 바뀌면 차이가 0.2초까지 줄었습니다. 질문이 바뀌면 글을 다시 이해하는 시간이 들어가는데, Turbo Q8 쪽에서 그 시간이 더 길었습니다.
왜 5배 빨라지지 않았나
이유는 두 가지였습니다.
- 일반판이 40단계를 다 계산하지 않습니다. Unsloth Studio는 25단계 이상인 작업에서 세 단계마다 하나씩 계산을 건너뛰고 앞 단계의 결과로 어림합니다. 상태 조회에 40번 가운데 22번 계산, 18번 건너뜀으로 적혀 있습니다. Turbo는 8단계라서 이 기능이 켜지지 않고 8번을 다 계산합니다.
- Turbo는 한 단계가 더 느립니다. 일반판은 빠른 INT8 방식으로 계산하고, Turbo는 GGUF 가중치를 풀어서 계산합니다. 전체 시간을 계산한 단계 수로 나누면 일반판은 한 단계에 약 0.20초, Turbo Q8은 약 0.45초입니다. 이 값에는 글을 이해하는 시간과 그림으로 바꾸는 시간도 섞여 있어 정확한 단계 시간은 아닙니다.
일반판은 엿새 전보다 빨라졌습니다. 10월 4일에 잰 106번 글에서는 같은 그림이 7.5초였고 오늘은 4.3초입니다. 그사이 Unsloth Studio에 단계 건너뛰기를 비롯한 속도 기능이 들어갔습니다.
결과 3. VRAM
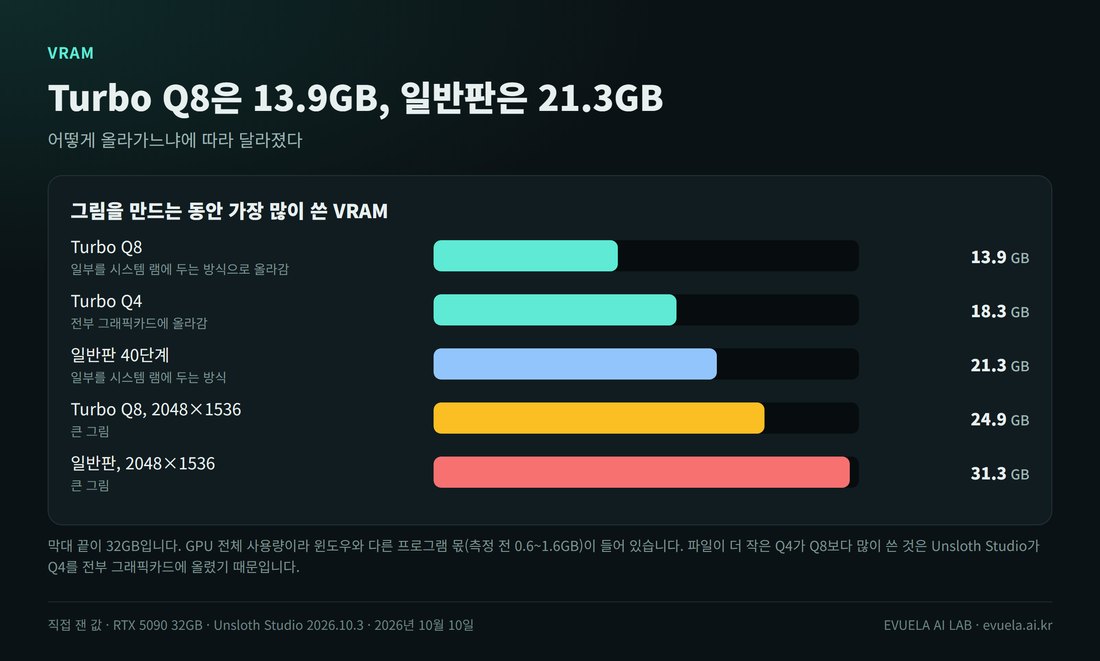
GPU 전체 사용량입니다. 윈도우와 다른 프로그램이 쓰는 0.6~1.6GB가 들어 있습니다.
| 설정 | VRAM 최대 (1024×1024) | Unsloth Studio가 고른 배치 | 모델 올리는 시간 |
|---|---|---|---|
| Turbo Q8 | 13.9GB | 일부를 시스템 램에 둠 | 15.2초 |
| Turbo Q4 | 18.3GB | 전부 그래픽카드에 | 9.8초 |
| 일반판 | 21.3GB | 일부를 시스템 램에 둠 | 10.7초 |
이 표가 뜻하는 것: Turbo Q8은 일반판보다 7.4GB 적게 썼습니다. 파일이 더 작은 Q4가 Q8보다 많이 쓴 것은 Unsloth Studio가 Q4를 전부 그래픽카드에 올렸기 때문입니다. 이 배치는 모델을 올리는 순간에 남아 있는 VRAM을 보고 자동으로 정해집니다. 그래서 같은 파일도 올릴 때마다 값이 달라질 수 있습니다.
이 점은 직접 겪었습니다. 첫 번째 측정에서 VRAM이 많이 비어 있을 때 일반판을 올리니 모델 전체가 그래픽카드에 올라가 31GB를 썼고, 2048×1536 그림 한 장이 몇 분 동안 끝나지 않았습니다. 다시 올린 두 번째 측정에서는 18GB로 올라가 18.7초에 끝났습니다. 큰 그림을 만들 계획이라면 올린 직후의 VRAM 사용량을 먼저 보는 것이 좋습니다.
측정하는 동안 전력은 Turbo Q8이 평균 455W, 일반판이 평균 490W였고, 온도는 71도와 73도까지 올랐습니다.
결과 4. 그림이 커지면 Turbo가 유리했다
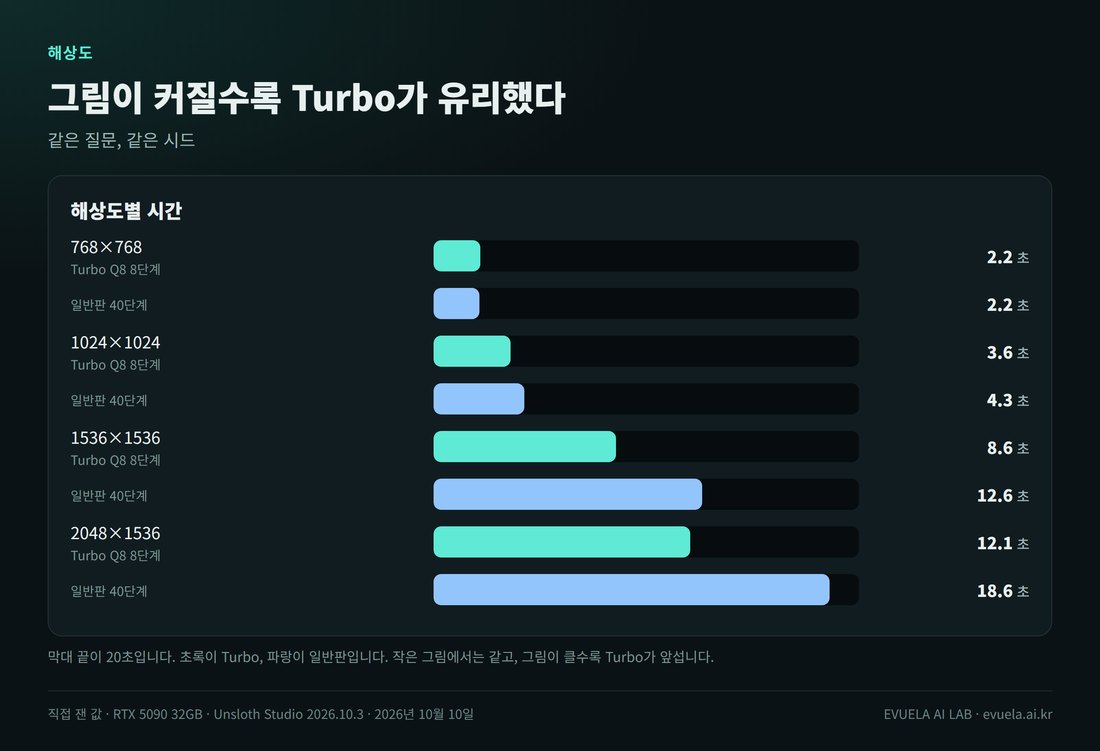
같은 질문과 같은 시드로 크기만 바꿨습니다.
| 크기 | Turbo Q8 8단계 | 일반판 40단계 | Turbo VRAM | 일반판 VRAM |
|---|---|---|---|---|
| 768×768 | 2.2초 | 2.2초 | 14.0GB | 21.4GB |
| 1024×1024 | 3.6초 | 4.3초 | 14.0GB | 21.4GB |
| 1536×1536 | 8.6초 | 12.6초 | 15.1GB | 23.6GB |
| 2048×1536 | 12.1초 | 18.7초 | 24.9GB | 31.3GB |
이 표가 뜻하는 것: 작은 그림에서는 차이가 없고, 그림이 커질수록 Turbo가 앞섰습니다. 2048×1536에서는 6.6초 빨랐습니다. 일반판은 이 크기에서 VRAM을 31.3GB까지 써서 32GB 카드의 끝에 닿았습니다.
결과 5. 그림 품질
같은 질문과 같은 시드로 만든 그림을 나란히 놓았습니다. 왼쪽이 일반판 40단계, 가운데가 Turbo Q8, 오른쪽이 Turbo Q4입니다.
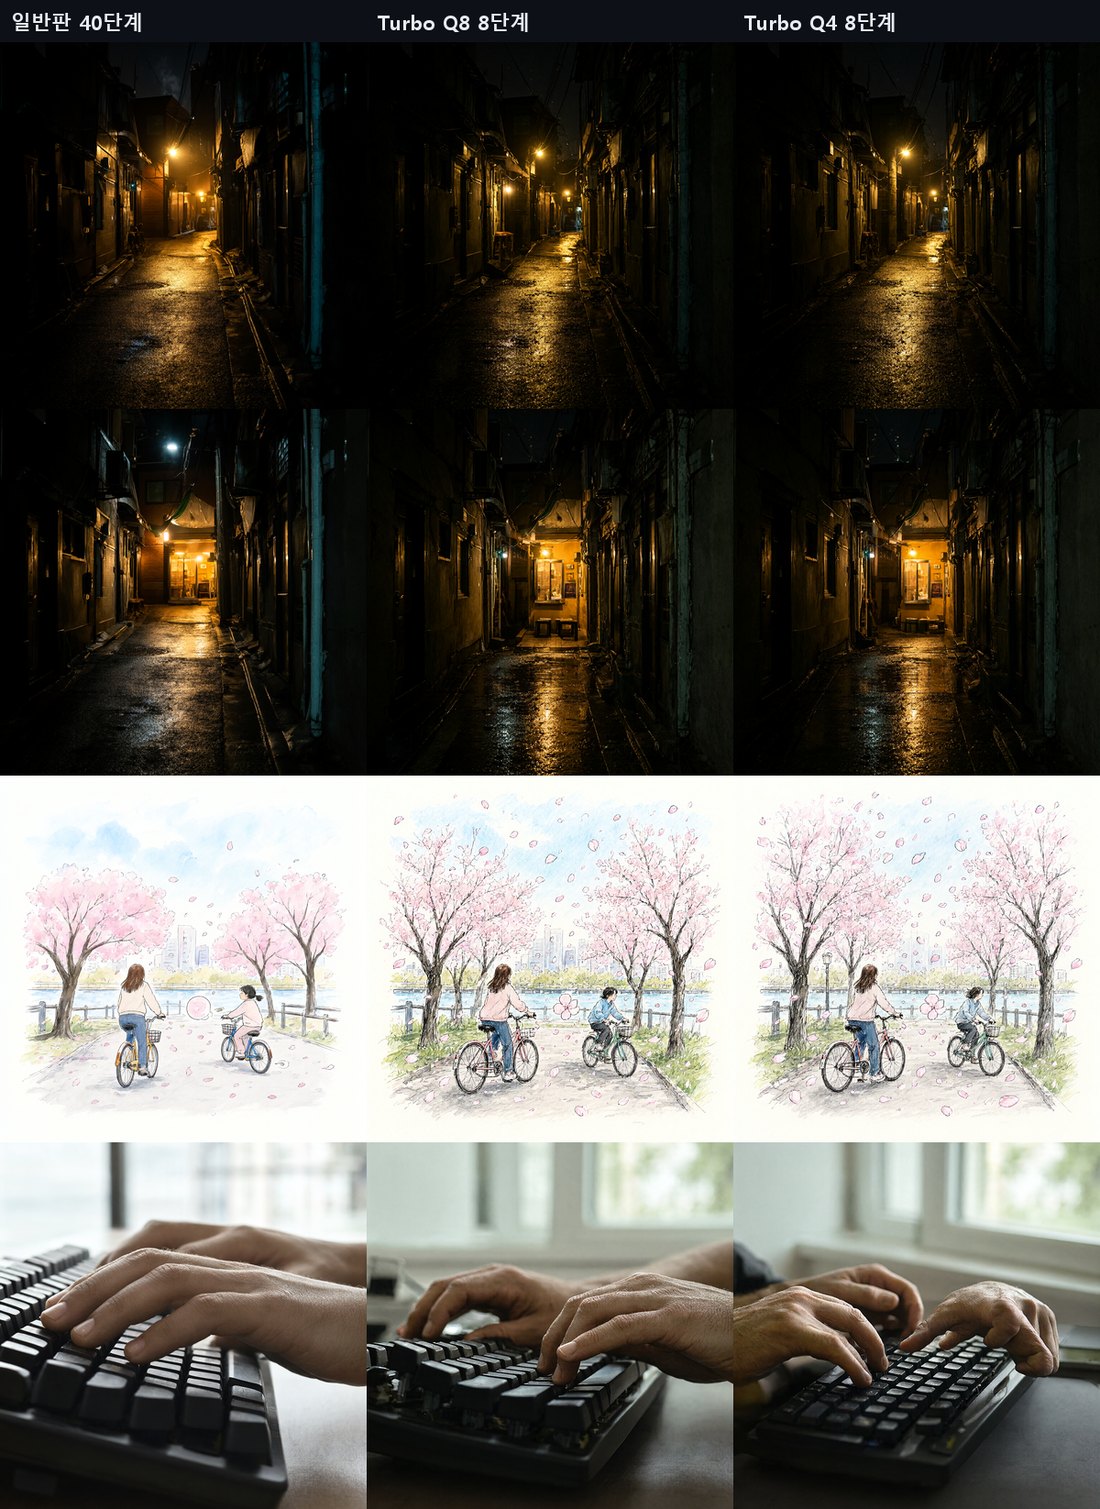
풍경, 수채화, 손 그림입니다.
풍경과 수채화, 손은 세 그림의 선명함이 비슷했습니다. 구도는 조금씩 달랐습니다. Turbo 쪽 수채화는 선이 더 진하고 꽃잎이 많았습니다. 손가락 개수가 어긋난 그림은 없었습니다.
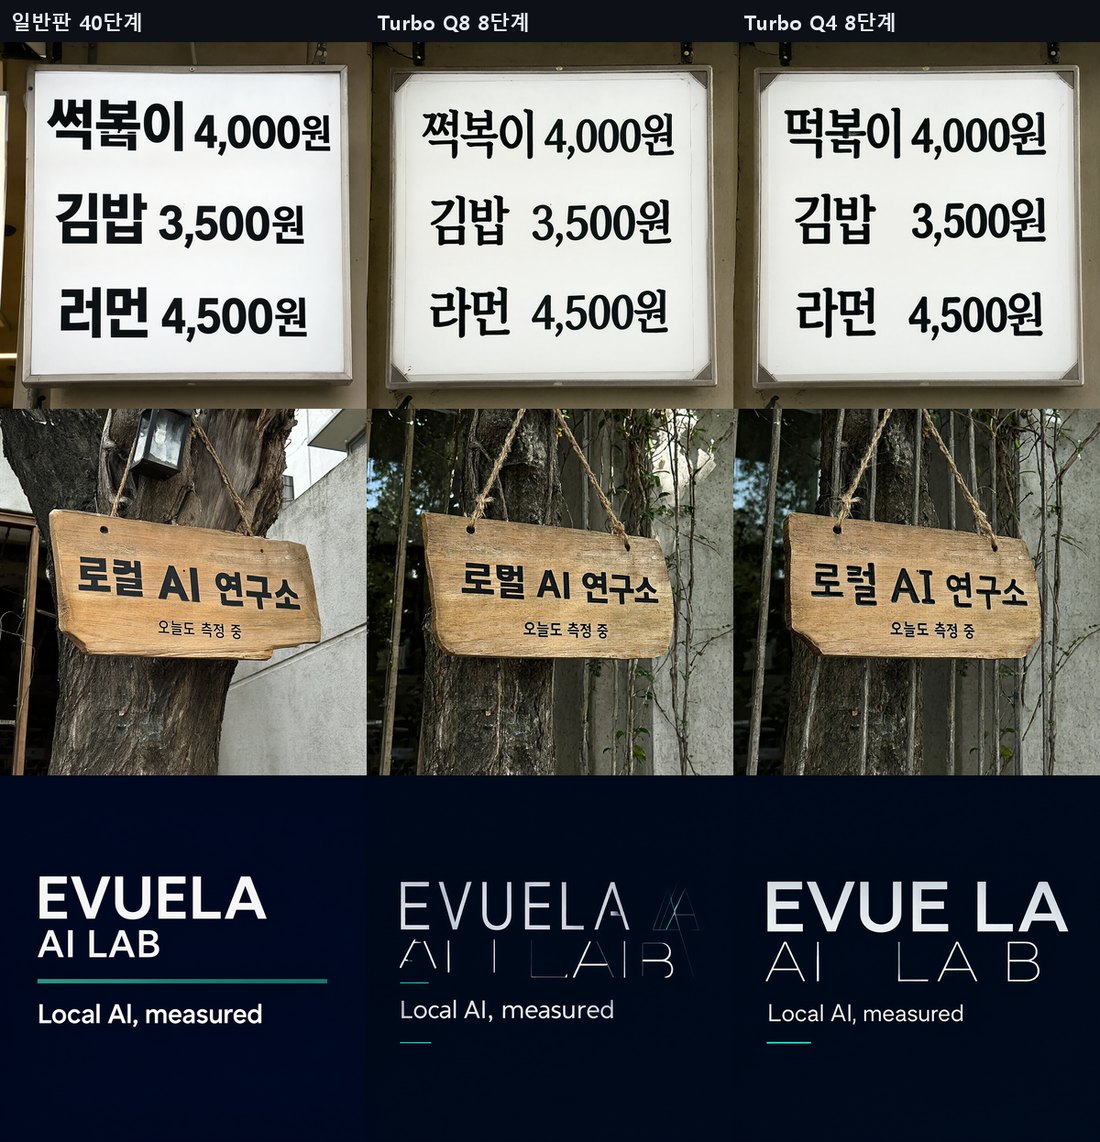
글자를 넣은 그림입니다. 제가 읽은 대로 적었습니다.
| 질문에 넣은 글자 | 일반판 40단계 | Turbo Q8 | Turbo Q4 |
|---|---|---|---|
| 떡볶이 4,000원 | 썩볶이 4,000원 | 쩍복이 4,000원 | 떡볶이 4,000원 |
| 김밥 3,500원 | 맞음 | 맞음 | 맞음 |
| 라면 4,500원 | 러먼 4,500원 | 라먼 4,500원 | 라먼 4,500원 |
| 로컬 AI 연구소 | 로럴 AI 연구소 | 로벌 AI 연구소 | 로럴 AI 연구소 |
| 오늘도 측정 중 | 맞음 | 맞음 | 맞음 |
| EVUELA AI LAB | 맞음, 깔끔함 | 획이 가늘고 끊김 | EVUE LA로 띄어 씀 |
| Local AI, measured | 맞음 | 맞음 | 맞음 |
이 표가 뜻하는 것: 숫자와 쉬운 낱말은 셋 다 맞았고, 받침이 복잡한 한글(떡, 볶, 컬)에서 셋 다 틀렸습니다. 영어 큰 제목은 일반판이 가장 나았습니다. 질문 하나에 그림 한 장씩만 본 결과라서, 어느 쪽이 한글을 더 잘 쓴다고 말하기에는 부족합니다.
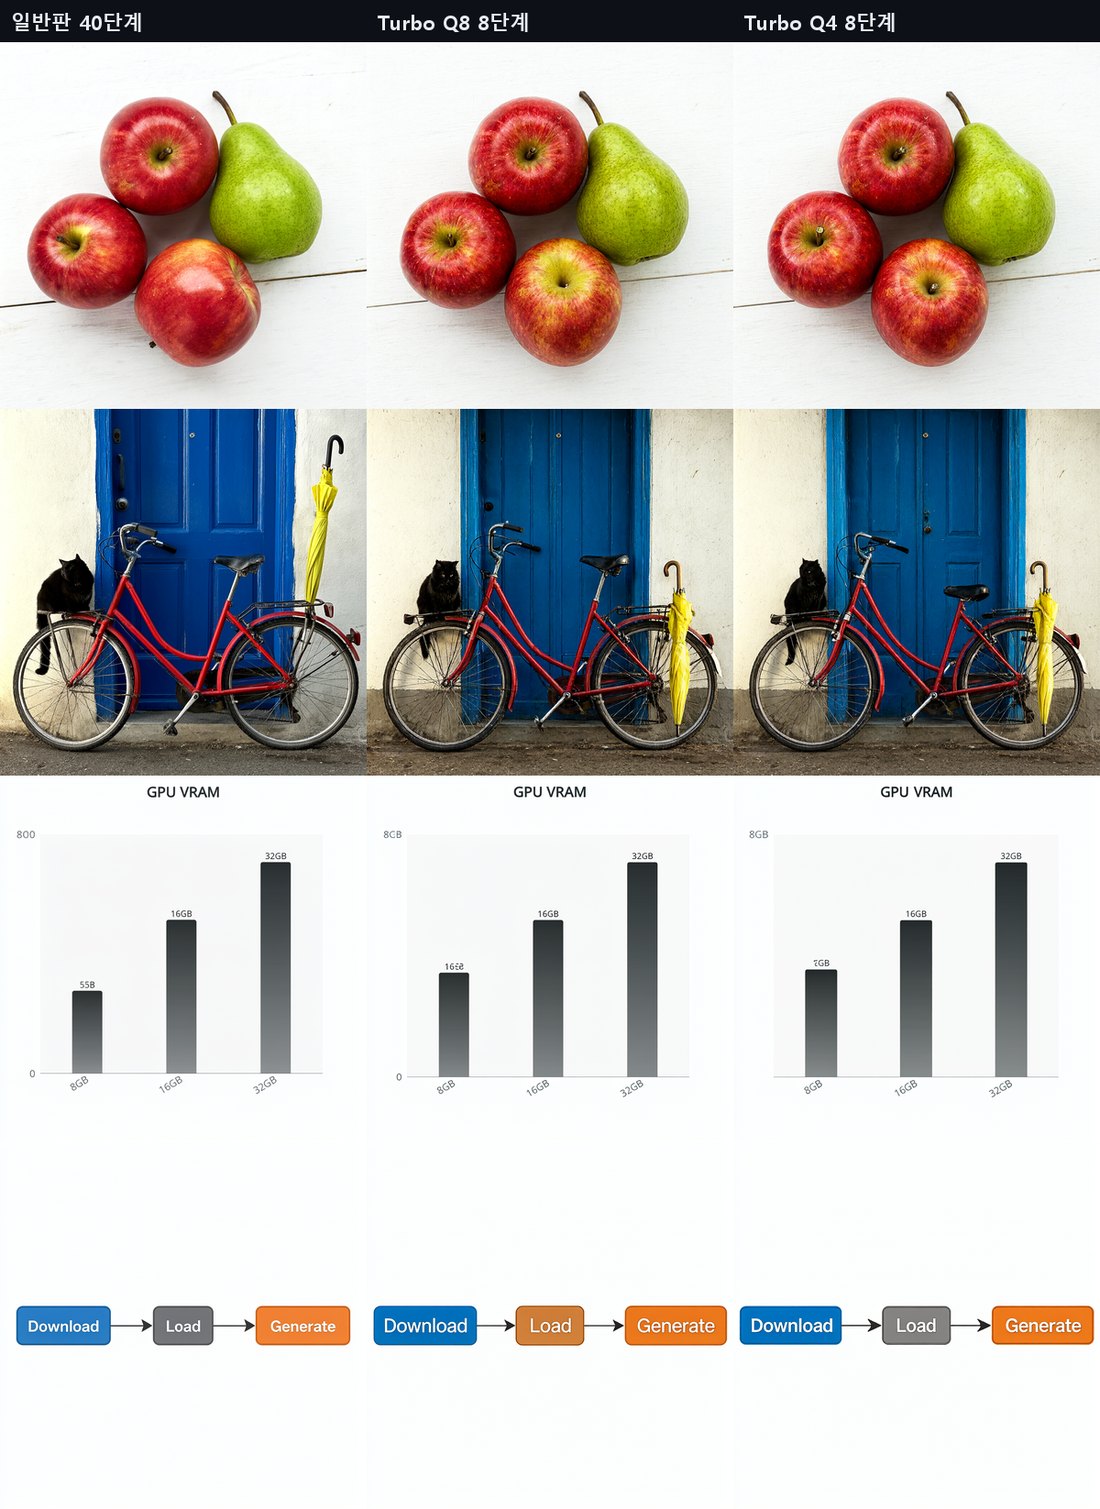
개수, 위치, 도표를 요청한 그림입니다.
- 개수: 사과 세 개와 배 두 개를 요청했는데 셋 다 배를 하나만 그렸습니다.
- 위치: 자전거, 고양이, 우산의 자리는 셋 다 맞았습니다.
- 도표: 막대 세 개와 이름표 16GB, 32GB는 맞았고, 가장 낮은 막대의 이름표(8GB)는 셋 다 깨졌습니다.
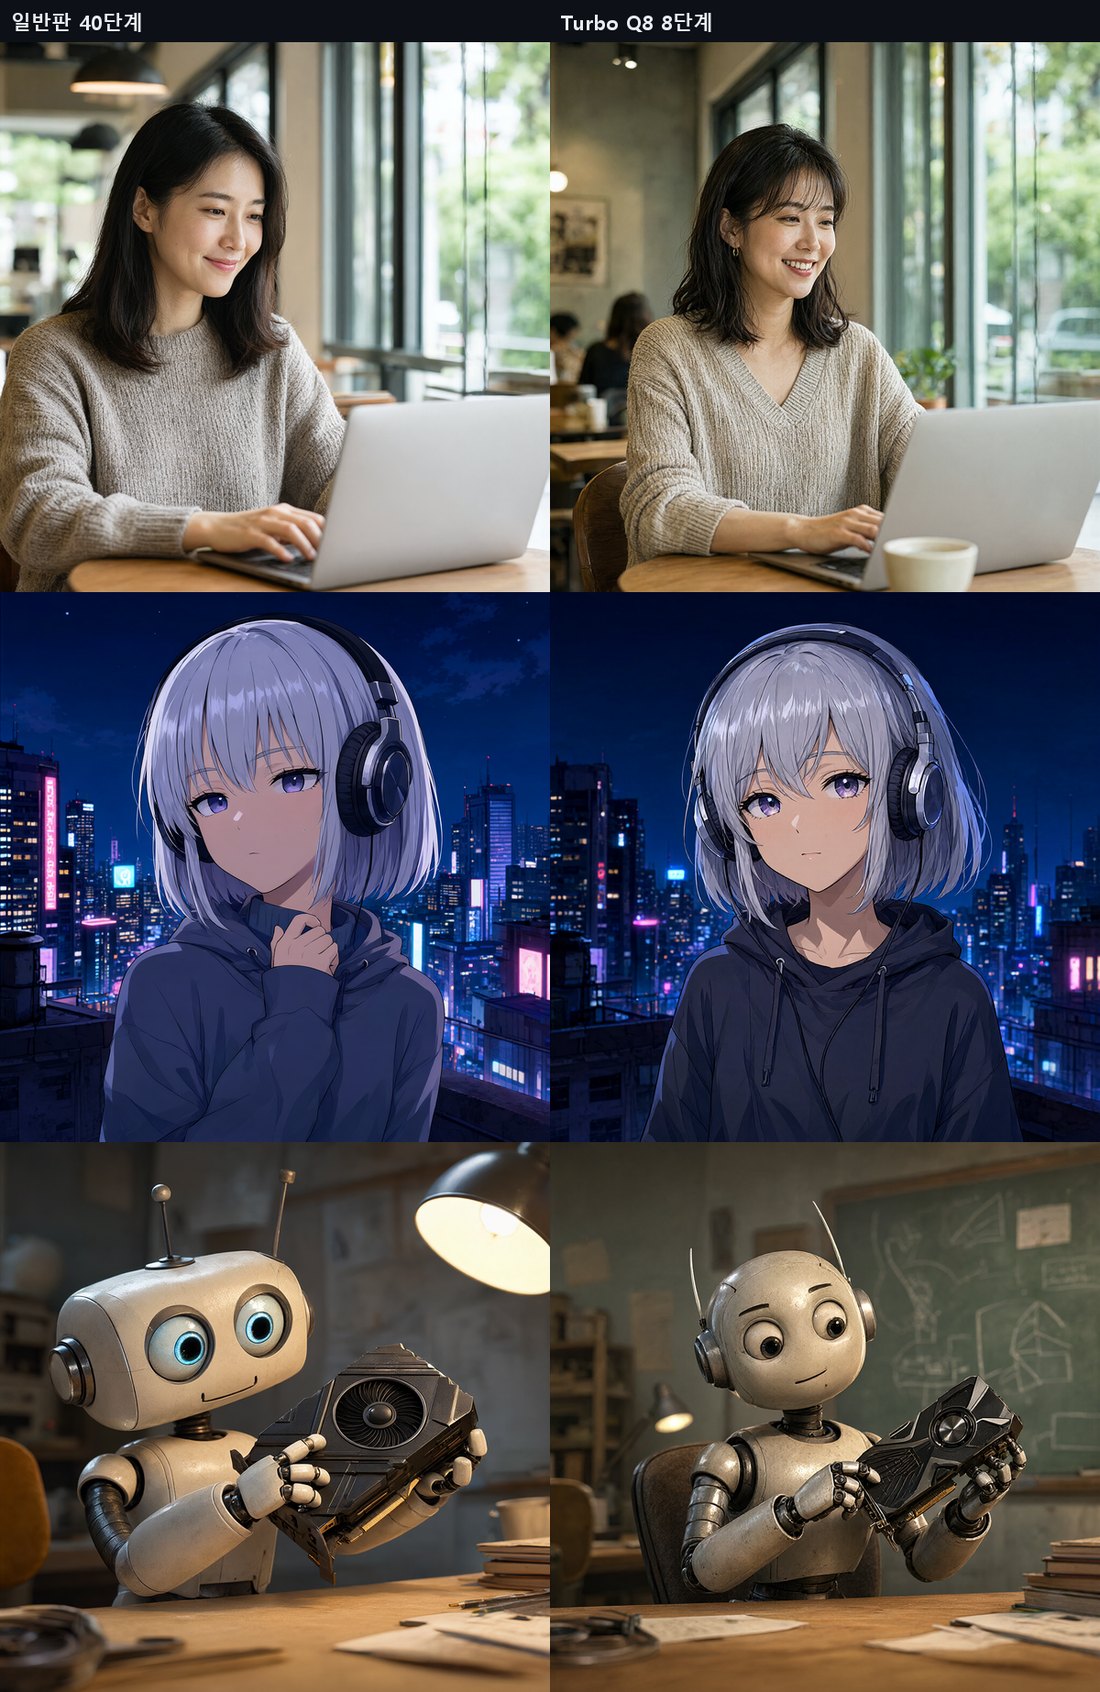
모두 가상의 인물입니다.
인물 사진, 애니메이션, 3D 캐릭터에서도 Turbo와 일반판의 완성도는 비슷했습니다. 얼굴이나 손이 어색한 그림은 없었습니다.
정리: 어느 쪽을 쓸까
| 이런 경우 | 맞는 쪽 | 이유 |
|---|---|---|
| 1024×1024 그림을 주로 만든다 | 어느 쪽이든 | 3.6초와 4.3초로 차이가 작습니다 |
| 1536 이상 큰 그림을 만든다 | Turbo | 2048×1536에서 12.1초와 18.7초였습니다 |
| VRAM을 아껴야 한다 | Turbo Q8 | 13.9GB와 21.3GB였습니다 |
| 영어 제목처럼 큰 글자를 넣는다 | 일반판 | 이번 그림에서는 일반판의 글자가 가장 깔끔했습니다 |
이 표가 뜻하는 것: RTX 5090과 Unsloth Studio 조합에서는 Turbo로 바꿀 이유가 속도보다 VRAM과 큰 그림에 있었습니다.
- Turbo를 쓴다면 올린 뒤 상태를 꼭 확인합니다. 계산 방식이 INT8로 잡혀 있고 이유에 일반판 파일 이름이 보이면 Turbo가 아닙니다.
- 일반판의 단계만 8로 줄이면 안 됩니다. 1.8초에 끝나지만 그림이 흐립니다.
- 두 모델 모두 연구용 라이선스입니다. 만든 그림을 상업적으로 쓰려면 라이선스를 직접 확인해야 합니다. 이 글의 그림은 비교를 위한 예시입니다.
일반판의 설치와 기본 설정은 Qwen-Image-2.1 테스트 글에 있습니다. 같은 PC에서 영상을 만든 기록은 LTX-2.5 글에, Unsloth Studio를 쓰게 된 이유는 프로그램을 바꾼 이유 글에 있습니다. 로컬 AI가 처음이라면 로컬 AI 시작하기 가이드부터 보시면 됩니다.
이 글의 한계
- Unsloth Studio 한 가지로만 쟀습니다. 모델 카드가 안내하는 diffusers 예제 코드나 ComfyUI로는 재지 않았습니다. 다른 프로그램에서는 속도 차이가 다를 수 있습니다.
- Turbo 전용 단계 값이 쓰였는지 확인하지 못했습니다. 모델 카드는 Turbo에 정해진 8단계 값(시그마)을 쓰라고 합니다. Unsloth Studio는 일반판의 설정 저장소를 짝으로 쓰고, 어떤 값이 실제로 쓰였는지는 API로 보이지 않았습니다. 그림은 또렷하게 나왔습니다.
- 일반판과 Turbo의 계산 방식이 다릅니다. 일반판은 INT8, Turbo는 GGUF입니다. Turbo를 INT8로 돌릴 방법은 이 버전에서 찾지 못했습니다. 같은 방식으로 돌리면 Turbo가 더 빨라질 수 있습니다(추정).
- 품질은 질문마다 그림 한 장으로 봤습니다. 시드를 바꿔 여러 장을 만들면 결과가 달라질 수 있습니다.
- PC 한 대의 결과입니다. VRAM이 작은 그래픽카드에서는 Unsloth Studio가 고르는 계산 방식과 배치가 달라집니다.
- 기본 설정 문제는 2026.10.3 버전에서 본 것입니다. Turbo GGUF가 올라온 지 하루가 안 된 때라, 다음 버전에서 고쳐질 수 있습니다.
자주 묻는 질문
Qwen-Image-2.1-Turbo는 일반판보다 얼마나 빠른가요?
RTX 5090의 Unsloth Studio에서 1024×1024 한 장에 Turbo Q8은 3.58초, 일반판은 4.32초였습니다. 2048×1536에서는 12.1초와 18.7초로 차이가 커졌습니다.
Unsloth Studio에서 Turbo 그림이 흐리게 나옵니다. 왜 그런가요?
기본 설정으로 올리면 일반판 가중치로 그림이 만들어집니다. 일반판은 8단계에서 그림이 덜 만들어집니다. 올릴 때 transformer_quant 를 none 으로 주면 Turbo 가중치가 쓰입니다.
VRAM은 얼마나 필요한가요?
이번 측정에서 Turbo Q8은 1024×1024에서 13.9GB, 2048×1536에서 24.9GB를 썼습니다. 일반판은 21.3GB와 31.3GB였습니다. 32GB 카드에서 잰 값이고, 작은 카드에서는 Unsloth Studio가 배치를 다르게 잡습니다.
Q8과 Q4 중 무엇을 받아야 하나요?
속도는 3.58초와 3.51초로 같았습니다. 그림 품질도 눈에 띄는 차이가 없었습니다. 파일은 Q8이 7.64GB, Q4가 4.2GB입니다.
만든 그림을 상업적으로 써도 되나요?
Turbo는 Qwen Research License(연구용)로 공개됐습니다. 상업적으로 쓰려면 라이선스 전문을 직접 확인해야 합니다.
출처
- Qwen-Image-2.1-Turbo 모델 카드: huggingface.co/Qwen/Qwen-Image-2.1-Turbo (2026년 10월 10일 확인)
- Unsloth의 Turbo GGUF 파일과 안내문: huggingface.co/unsloth/Qwen-Image-2.1-Turbo-GGUF (2026년 10월 10일 확인)
- 측정 스크립트와 결과 파일: 이 블로그 저장소의 docs/benchmarks/qwen_image21_turbo
댓글 0개