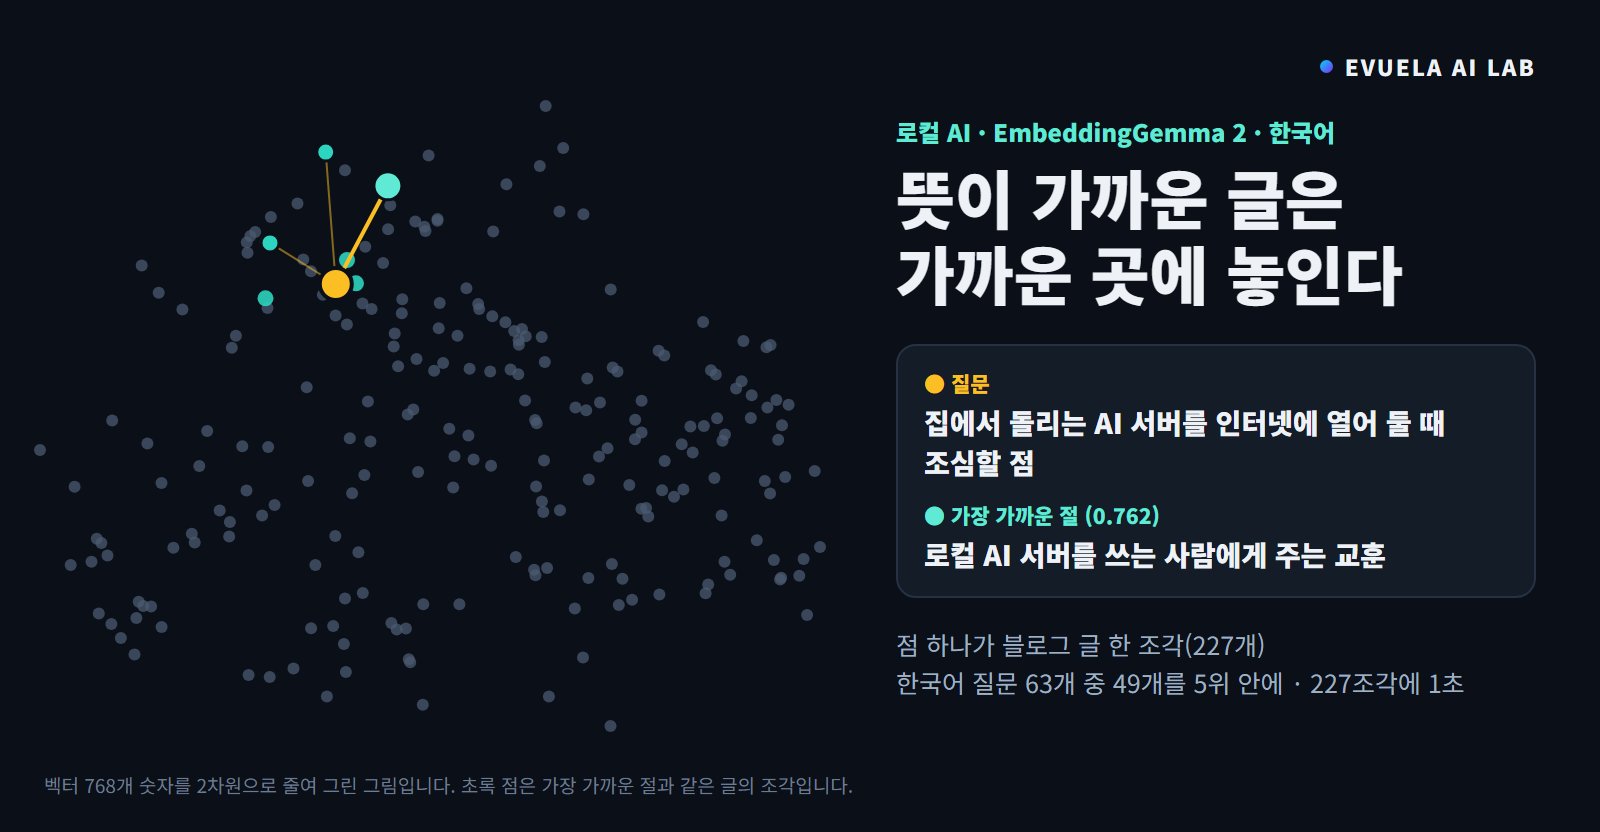
구글이 낸 임베딩 모델 EmbeddingGemma 2를 RTX 5090 32GB에서 직접 돌려, 이 블로그 글을 한국어로 검색하게 해 봤습니다. 임베딩 모델은 글을 쓰는 모델이 아닙니다. 글을 숫자 묶음(벡터)으로 바꿔서, 낱말이 달라도 뜻이 가까운 글을 찾게 해 주는 모델입니다. 결론부터 적으면 다른 낱말로 바꿔 물은 질문과 영어로 물은 질문에서는 낱말 검색보다 뚜렷하게 잘 찾았고, 소제목과 같은 낱말로 물은 질문에서는 낱말 검색이 더 잘 찾았습니다.
- 한국어 질문 63개 가운데 맞는 절을 1위로 찾은 것은 EmbeddingGemma 2가 31개, 낱말 검색(BM25)이 28개였습니다. 5위 안에 든 것은 49개와 41개입니다.
- 다른 낱말로 바꿔 물은 질문 27개에서는 17개와 9개로 차이가 벌어졌습니다. 소제목과 비슷한 말로 물은 질문 20개에서는 7개와 12개로 낱말 검색이 앞섰습니다.
- 같은 질문을 영어로 물어도 한국어 글에서 34개를 1위로 찾았습니다. 낱말 검색은 4개였습니다.
- 속도: 글 227조각(약 9만 3천 토큰)을 벡터로 바꾸는 데 1.06초가 걸렸습니다. 그래픽카드 없이 CPU만으로는 31.8초였습니다.
- VRAM은 글 부분만 올리면 0.5GB입니다. 다만 한 번에 넣는 묶음을 128개로 키우면 24.4GB까지 쓰고 속도는 오히려 절반으로 떨어졌습니다.
이 글의 숫자는 RTX 5090 PC에서 2026년 10월 7일에 직접 잰 값입니다. 질문 63개와 정답 표시는 직접 만들었고, 글 끝에 파일 주소를 적었습니다. 구글이 밝힌 점수는 "구글 측정"이라고 따로 적었습니다.
이 글의 결과를 20초로 요약한 영상입니다(소리 없음).
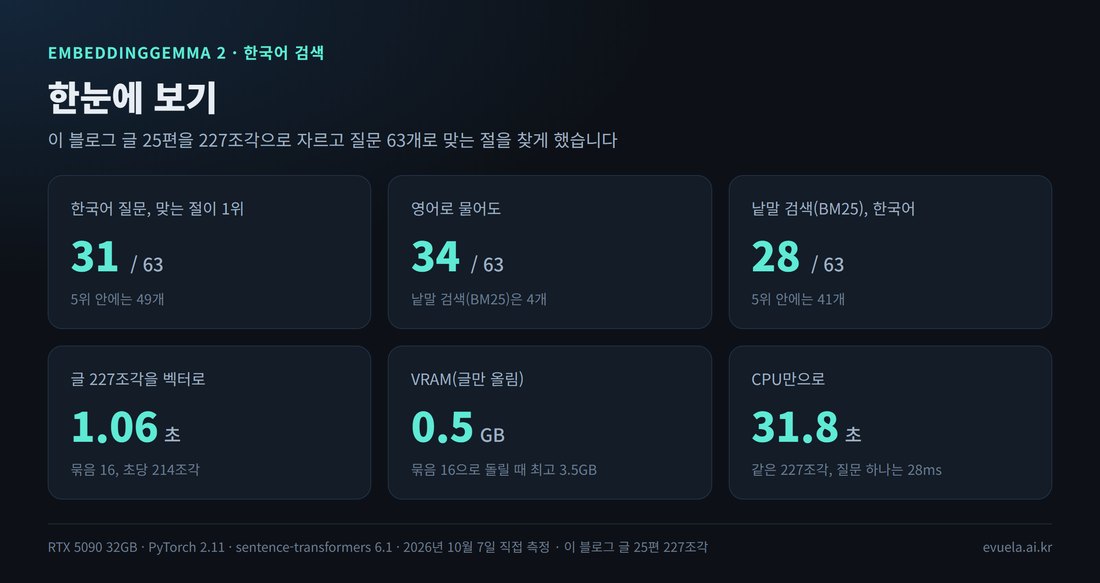
이 글에서 잰 값을 한 장에 모았습니다.
임베딩 모델은 무엇인가
검색창에 "그래픽카드 메모리"라고 치면, 보통의 검색은 그 낱말이 들어 있는 글만 찾습니다. 글에 "VRAM"이라고만 적혀 있으면 찾지 못합니다. 임베딩 모델은 이 문제를 다른 방법으로 풉니다.
- 글 하나를 숫자 수백 개로 된 묶음으로 바꿉니다. 이 묶음을 벡터라고 부릅니다. EmbeddingGemma 2는 숫자 768개로 바꿉니다.
- 뜻이 가까운 글은 숫자 묶음도 서로 가깝게 나오도록 모델이 학습돼 있습니다.
- 질문도 같은 방법으로 숫자 묶음으로 바꾼 뒤, 가장 가까운 글을 고릅니다.
예를 들면 이렇습니다. 이 블로그에 "녹화하면 로컬 AI가 얼마나 느려지나"라는 소제목의 절이 있습니다. 질문을 "화면을 녹화하는 동안 AI 답 속도가 얼마나 떨어지나"로 바꿔도, 두 문장의 숫자 묶음이 가까워서 그 절이 1위로 나옵니다.
이런 검색은 챗봇에 내 문서를 붙여 쓰는 방식(RAG)의 첫 단계로 많이 씁니다. 질문과 가까운 문서 조각을 먼저 찾고, 그 조각을 글 쓰는 모델에 함께 넣어 답하게 하는 방식입니다.
실제 화면: 블로그 글 227조각을 검색하면
숫자를 보기 전에 실제로 도는 모습입니다. 터미널에서 모델을 올리고, 블로그 글 227조각을 벡터로 바꾼 다음, 질문 네 개를 차례로 보냈습니다. 질문마다 가장 가까운 절 세 개와 가까운 정도(1에 가까울수록 가까움)가 나옵니다.
터미널 화면을 녹화한 영상입니다(17초, 소리 없음). 질문 사이에 약 1초씩 쉬는 것은 보기 편하게 넣은 것이고, 화면의 시간 숫자에는 들어가지 않습니다.
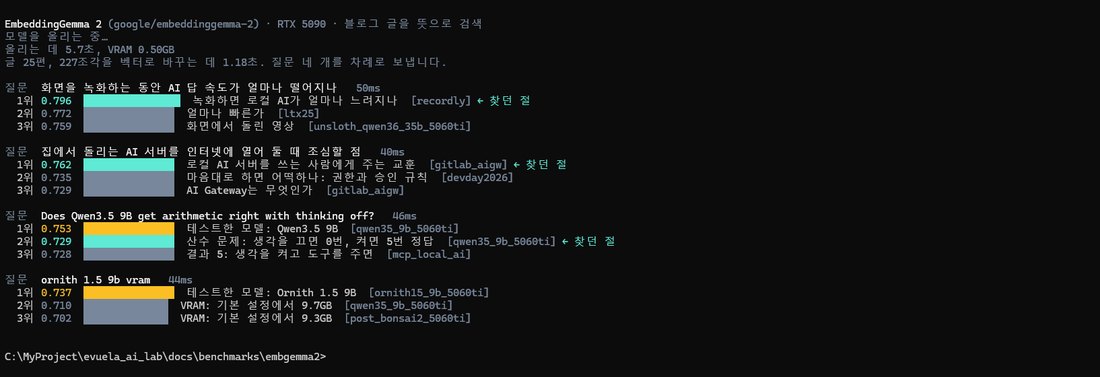
질문 네 개의 결과입니다. 위의 둘은 찾던 절이 1위입니다. 셋째는 영어로 물었는데 찾던 절이 2위로 나왔습니다. 넷째는 3위 안에 찾던 절이 없습니다.
이 화면에 이 글의 결과가 거의 다 들어 있습니다.
- 첫째와 둘째 질문은 소제목에 없는 낱말로 물었는데 찾던 절이 1위로 나왔습니다. 둘째 질문의 "집에서 돌리는 AI 서버"는 본문에 "내 PC에 AI 서버를 띄워"라고 적혀 있습니다.
- 셋째는 영어 질문인데 한국어 글에서 같은 글의 절을 찾았습니다. 다만 1위는 그 모델을 소개하는 절이었고, 찾던 산수 문제 절은 2위였습니다.
- 넷째처럼 모델 이름과 낱말 하나만 친 짧은 검색어에서는 "테스트한 모델" 절이 1위로 올라왔고, 2위와 3위는 다른 모델의 VRAM 절이었습니다. 뒤에서 다시 보겠지만 이 모델이 틀릴 때 가장 자주 나온 모습입니다.
테스트한 모델: EmbeddingGemma 2
| 항목 | 내용 |
|---|---|
| 만든 곳 | Google DeepMind |
| 받은 곳 | Hugging Face google/embeddinggemma-2 (파일 15개, 1.42GB) |
| 라이선스 | Apache 2.0 (약관 동의 없이 받을 수 있었습니다) |
| 크기 | 파라미터 7억 4천만 개. 글 2억 7천만 + 그림 1억 7천만 + 소리 3억 |
| 넣을 수 있는 것 | 글(코드 포함), 그림, 영상, 소리 |
| 벡터 길이 | 768. 512, 256, 128로 줄여 쓸 수 있음 |
| 한 번에 넣는 길이 | 8,192토큰 |
| 언어 | 100개 이상(구글 설명) |
이 표가 뜻하는 것: 글만 쓸 때는 2억 7천만 개짜리 부분만 올리면 됩니다. 요즘 내 PC에서 돌리는 글 쓰는 모델이 90억~350억 개인 것과 견주면 수십 분의 1 크기입니다.
구글은 모델 설명서에서 여러 언어 글 시험(MTEB multilingual v2) 점수가 61.36이고 이전 모델은 61.15였다고 밝혔습니다. 코드 검색 시험은 78.68과 68.76입니다(모두 구글 측정). 글 쪽 점수는 거의 같고, 그림과 소리와 영상을 새로 받게 된 것이 큰 변화입니다.
테스트 PC와 측정 방법
- PC: RTX 5090 32GB, 윈도우 11. 다른 AI 프로그램은 모두 끈 상태에서 쟀습니다.
- 프로그램: Python 3.13, PyTorch 2.11(CUDA 12.8), sentence-transformers 6.1, transformers 5.19. 모델 설명서의 예제대로 불렀습니다. Unsloth Studio는 글 쓰는 모델용이라 이 모델은 올릴 수 없습니다.
- 찾을 글: 이 블로그 글 25편의 본문을 소제목 단위로 잘라 227조각을 만들었습니다. 조각 하나는 평균 693자(408토큰)이고 가장 긴 것이 1,615토큰입니다.
- 뺀 절: 도입, 정리, 자주 묻는 질문은 뺐습니다. 본문 내용을 다시 적은 절이라, 넣으면 같은 답이 여러 조각에 있어서 정답을 하나로 정할 수 없습니다. 처음에는 넣고 돌렸다가 이 문제를 보고 뺐습니다.
- 질문: 63개를 직접 썼습니다. 질문마다 정답 절이 하나씩 있습니다. 말투는 세 가지입니다. 소제목과 비슷한 말 20개, 다른 낱말로 바꿔 물은 것 27개, 검색창에 치는 짧은 낱말 16개입니다. 같은 뜻의 영어 질문도 63개 만들었습니다.
- 넣는 형식: 모델 설명서가 정한 대로 질문 앞에는
task: search result | query:를, 글 앞에는title: 소제목 | text:를 붙였습니다. 숫자 형식은 설명서가 권한 bfloat16입니다. - 견줄 기준: 모델 없이 낱말로 찾는 방법 두 가지를 같은 질문으로 돌렸습니다. BM25(같은 낱말이 얼마나 드물고 자주 나오는지로 점수를 매기는 오래된 검색 방법)와, 글자 두세 개 묶음으로 견주는 TF-IDF입니다.
- 속도: 같은 일을 5번씩 하고 가운데 값(중앙값)을 적었습니다.
정답 표시는 한 번 정한 뒤 바꾸지 않았습니다. 결과를 보고 고친 것은 없습니다.
한국어 검색: 63개 중 31개를 1위로, 49개를 5위 안에
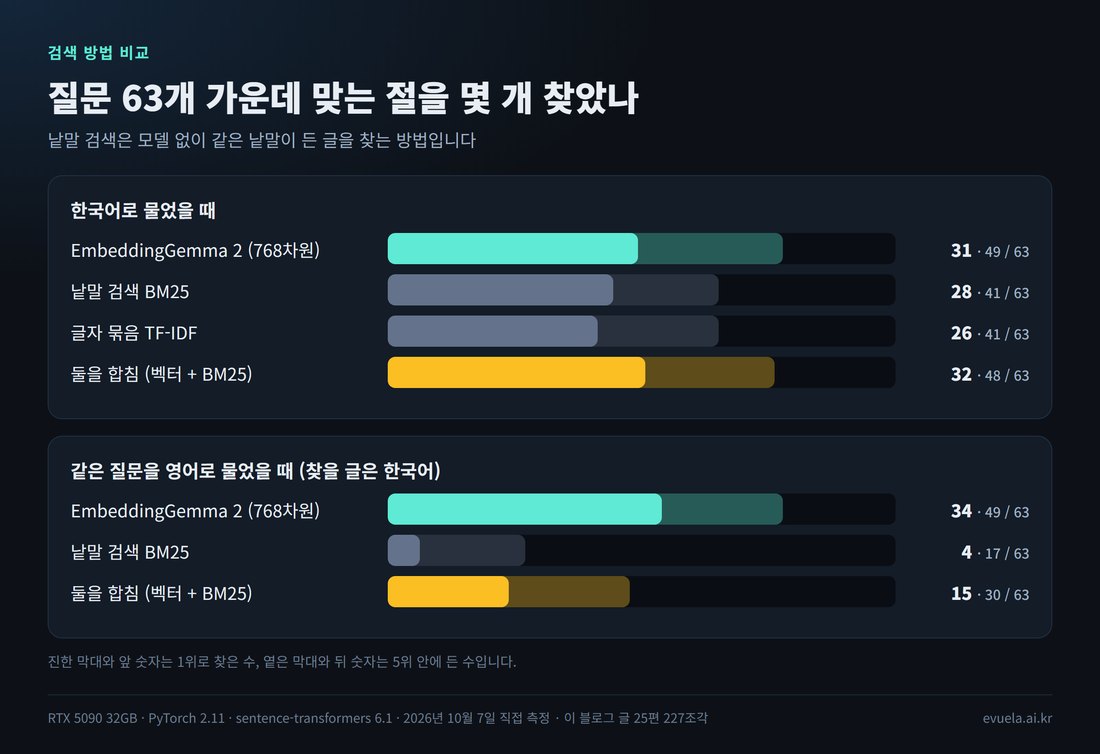
한국어로 물었을 때와 영어로 물었을 때, 검색 방법마다 맞는 절을 몇 개 찾았는지입니다.
| 검색 방법 | 1위로 찾음 | 5위 안 | 10위 안 | 1위가 같은 글 |
|---|---|---|---|---|
| EmbeddingGemma 2 (768차원) | 31 | 49 | 52 | 53 |
| 낱말 검색 BM25 | 28 | 41 | 48 | 40 |
| 글자 묶음 TF-IDF | 26 | 41 | 52 | 46 |
| 벡터와 BM25를 합침 | 32 | 48 | 52 | 53 |
이 표가 뜻하는 것: 질문 63개 기준입니다. "1위가 같은 글"은 절은 달라도 맞는 글 안의 절을 1위로 가져온 수입니다. EmbeddingGemma 2는 63개 중 53개에서 맞는 글까지는 갔고, 그 가운데 31개에서 정확한 절까지 맞혔습니다. 낱말 검색은 맞는 글에 간 것이 40개였습니다.
1위 기준으로는 31개와 28개라 차이가 3개뿐입니다. 5위 안으로 넓히면 49개와 41개로 벌어집니다. 챗봇에 문서를 붙여 쓸 때는 보통 가까운 조각을 여러 개 함께 넣으니, 5위 안 숫자가 실제 쓰임에 더 가깝습니다.
두 방법의 순위를 더해서 합친 검색은 1위 32개로 거의 그대로였습니다. 이 시험에서는 합쳐서 얻은 것이 없었습니다.
말투에 따라 결과가 갈렸다
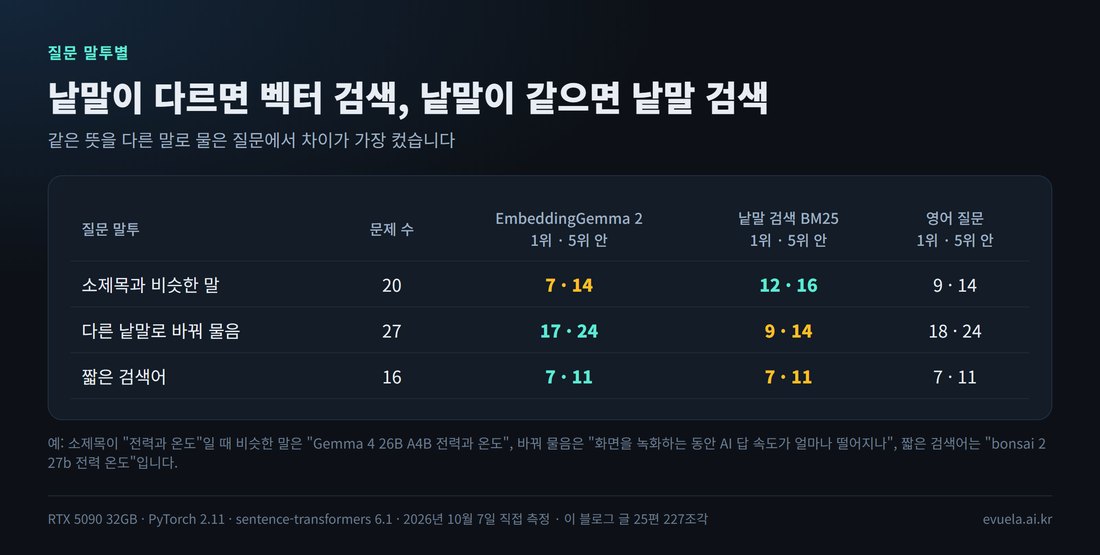
같은 63개를 질문 말투별로 나눈 결과입니다.
| 질문 말투 | 문제 수 | EmbeddingGemma 2 (1위 · 5위 안) | BM25 (1위 · 5위 안) |
|---|---|---|---|
| 소제목과 비슷한 말 | 20 | 7 · 14 | 12 · 16 |
| 다른 낱말로 바꿔 물음 | 27 | 17 · 24 | 9 · 14 |
| 짧은 검색어 | 16 | 7 · 11 | 7 · 11 |
이 표가 뜻하는 것: 임베딩 모델의 쓸모는 둘째 줄에 있습니다. 낱말이 겹치지 않는 질문 27개에서 17개를 1위로, 24개를 5위 안에 찾았습니다. 낱말 검색은 9개와 14개였습니다. 반대로 소제목의 낱말을 그대로 넣은 질문에서는 낱말 검색이 12개로 더 많이 맞혔습니다.
두 방법이 맞힌 문제를 겹쳐 보면 이렇습니다. 둘 다 1위로 맞힌 것이 20개, 임베딩만 맞힌 것이 11개, 낱말 검색만 맞힌 것이 8개, 둘 다 못 맞힌 것이 24개입니다. 서로 다른 문제를 맞히고 있어서, 5위 안에 어느 한쪽이라도 넣은 문제는 53개였습니다.
틀릴 때는 "그 모델을 소개하는 절"을 가져왔다
EmbeddingGemma 2가 1위를 놓친 32개를 하나씩 봤습니다.
- 32개 중 22개는 맞는 글 안의 다른 절을 1위로 가져왔습니다.
- 그 22개 중 20개는 "테스트한 모델: Qwen3.5 9B", "Recordly는 무엇인가"처럼 그 글의 대상을 소개하는 절이었습니다.
- 32개 중 15개는 정답 절이 2위나 3위에 있었습니다.
질문에 모델 이름이나 프로그램 이름이 들어 있으면, 그 이름이 가장 많이 나오는 소개 절이 가장 가깝다고 나온 것입니다. "Gemma 4 26B A4B 전력과 온도"라고 물으면 전력과 온도 절이 아니라 "테스트한 모델: Gemma 4 26B A4B QAT" 절이 1위로 나왔고, 정답 절은 11위였습니다. 낱말 검색에서는 이런 경우가 35개 중 4개뿐이었습니다.
이 블로그의 테스트 글은 글마다 "전력과 온도", "한국어 품질" 같은 같은 이름의 절이 있습니다. 모델 이름과 주제를 함께 맞혀야 하는 이런 글 묶음에서, 이 모델은 이름 쪽에 더 끌려갔습니다. 다른 종류의 글 묶음에서는 결과가 다를 수 있습니다.
영어로 물어도 한국어 글을 찾았다
같은 질문 63개를 영어로 바꿔 물었습니다. 찾을 글은 그대로 한국어입니다.
| 검색 방법 | 1위로 찾음 | 5위 안 | 1위가 같은 글 |
|---|---|---|---|
| EmbeddingGemma 2, 영어 질문 | 34 | 49 | 59 |
| EmbeddingGemma 2, 한국어 질문 | 31 | 49 | 53 |
| 낱말 검색 BM25, 영어 질문 | 4 | 17 | 26 |
이 표가 뜻하는 것: 영어로 물어도 한국어로 물은 것과 같은 수준으로 찾았습니다. 1위는 오히려 3개 많습니다. 문제 수가 63개라 3개 차이로 영어가 더 낫다고 말하기는 어렵고, 떨어지지 않았다고 읽는 것이 맞습니다.
낱말 검색이 4개라도 맞힌 것은 글에 모델 이름 같은 영어 낱말이 그대로 있어서입니다. 맞힌 넷은 "hyperframes install size and time", "gpt-6.1 sol price performance"처럼 제품 이름이 든 질문이었습니다.
한국어 글만 있는 사이트에서 영어 질문을 받거나, 영어 문서를 한국어로 찾아야 하는 쓰임이라면 낱말 검색으로는 안 되고 임베딩 모델이 있어야 한다는 것을 숫자로 확인했습니다.
설정을 바꾸면: 벡터 길이와 머리말
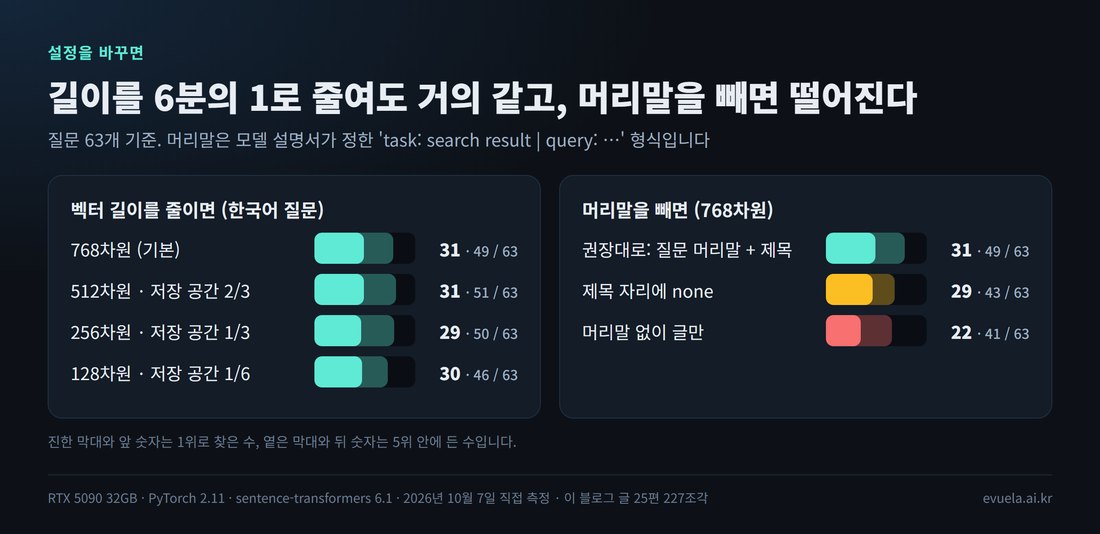
왼쪽은 벡터 길이를 줄였을 때, 오른쪽은 머리말을 뺐을 때입니다.
벡터 길이를 6분의 1로 줄여도 거의 같았다
EmbeddingGemma 2의 벡터는 숫자 768개인데, 앞에서부터 512개, 256개, 128개만 잘라 써도 되도록 학습돼 있습니다. 길이가 짧으면 저장 공간이 줄고 견주는 속도가 빨라집니다.
| 벡터 길이 | 저장 공간 | 한국어 1위 · 5위 안 | 영어 1위 · 5위 안 |
|---|---|---|---|
| 768 (기본) | 1 | 31 · 49 | 34 · 49 |
| 512 | 3분의 2 | 31 · 51 | 33 · 48 |
| 256 | 3분의 1 | 29 · 50 | 33 · 49 |
| 128 | 6분의 1 | 30 · 46 | 28 · 49 |
이 표가 뜻하는 것: 256까지는 차이가 한두 개라 구별되지 않습니다. 128에서는 한국어 5위 안이 49개에서 46개로, 영어 1위가 34개에서 28개로 내려갔습니다. 구글도 설명서에서 256까지는 품질이 거의 같고 128은 직접 확인하고 쓰라고 적었는데, 이 시험에서도 같은 모습이었습니다.
잘라 쓸 때는 자른 뒤에 벡터 길이를 다시 1로 맞춰야 합니다. sentence-transformers에서는 encode(..., truncate_dim=256, normalize_embeddings=True)로 한 번에 됩니다.
머리말을 빼면 31개가 22개로 떨어졌다
| 넣는 형식 | 1위로 찾음 | 5위 안 |
|---|---|---|
권장대로: 질문에 task: search result | query:, 글에 title: 소제목 | text: | 31 | 49 |
글의 제목 자리에 none | 29 | 43 |
| 머리말 없이 질문과 글만 | 22 | 41 |
이 표가 뜻하는 것: 머리말을 빼도 오류는 나지 않고 결과가 나옵니다. 그런데 1위로 찾는 수가 31개에서 22개로 줄었습니다. 낱말 검색(28개)보다 못한 결과입니다. 이 모델을 쓰면서 "생각보다 못 찾는다"고 느낀다면 머리말부터 확인해야 합니다.
소제목을 제목 자리에 넣는 것도 효과가 있었습니다. 5위 안이 43개에서 49개로 늘었습니다. 문서에 제목이 있으면 버리지 말고 넣는 편이 좋습니다.
속도와 메모리
| 조건 | 227조각을 벡터로 | 초당 조각 수 | 질문 하나 | 올린 뒤 VRAM |
|---|---|---|---|---|
| GPU, bfloat16, 글 부분만 (묶음 32) | 1.06초 | 214 | 32ms | 0.5GB |
| GPU, float32, 글 부분만 (묶음 32) | 1.87초 | 121 | 26ms | 1.0GB |
| GPU, bfloat16, 그림·소리 부분까지 (묶음 32) | 1.10초 | 206 | 34ms | 1.4GB |
| CPU만, float32, 글 부분만 (묶음 8) | 31.8초 | 7 | 28ms | 쓰지 않음 |
이 표가 뜻하는 것: 글 227조각은 약 9만 3천 토큰, 한글로 16만 5천 자입니다. 이것을 1초 남짓에 벡터로 바꿨습니다. 블로그 글 25편을 통째로 다시 색인하는 데 1초면 된다는 뜻입니다. 모델을 올리는 데는 5.7초가 걸렸습니다.
- bfloat16이 float32보다 약 1.8배 빨랐고 VRAM은 절반이었습니다. 찾은 결과도 거의 같았습니다. float32로 다시 돌려도 1위 31개, 5위 안 49개였고 63개 중 62개에서 1위로 고른 절이 같았습니다.
- 질문 하나를 벡터로 바꾸는 시간은 GPU와 CPU가 거의 같았습니다(32ms와 28ms). 짧은 글 하나는 계산보다 준비에 드는 시간이 더 커서입니다. 이미 벡터로 바꿔 둔 글을 검색만 하는 서버라면 그래픽카드가 없어도 됩니다.
- 많은 글을 한꺼번에 바꿀 때는 차이가 큽니다. CPU는 31.8초로 GPU의 30배였습니다. CPU는 24코어입니다.
- 시스템 램은 글 부분만 올렸을 때 프로그램 하나가 약 1.1GB를 썼습니다.
묶음을 키우면 느려지고 VRAM만 늘었다
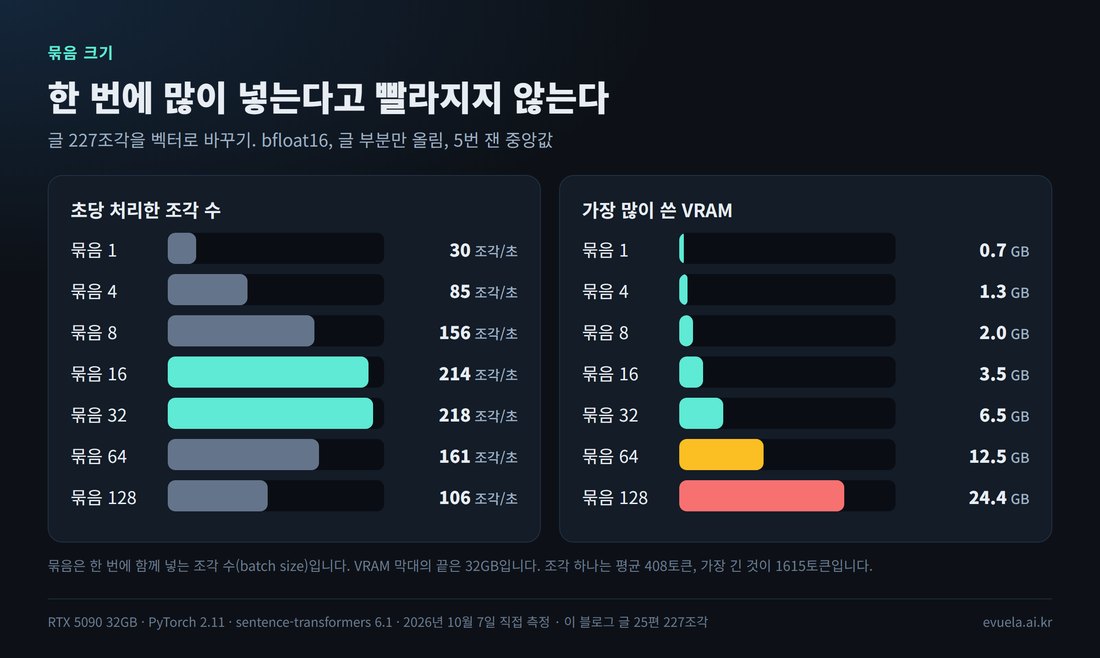
한 번에 함께 넣는 조각 수(묶음)를 바꿔 가며 잰 속도와 VRAM입니다.
| 묶음 크기 | 227조각에 걸린 시간 | 초당 조각 수 | 가장 많이 쓴 VRAM |
|---|---|---|---|
| 1 | 7.48초 | 30 | 0.7GB |
| 4 | 2.67초 | 85 | 1.3GB |
| 8 | 1.46초 | 156 | 2.0GB |
| 16 | 1.06초 | 214 | 3.5GB |
| 32 | 1.04초 | 218 | 6.5GB |
| 64 | 1.41초 | 161 | 12.5GB |
| 128 | 2.15초 | 106 | 24.4GB |
이 표가 뜻하는 것: 묶음 16과 32가 가장 빨랐고 둘의 속도는 같았습니다. VRAM은 16이 3.5GB, 32가 6.5GB라서 묶음 16이 가장 알맞았습니다. 128로 키우면 속도는 절반이 되고 VRAM은 24.4GB까지 올라갑니다.
모델 자체는 0.5GB인데 VRAM이 이렇게 늘어나는 까닭은, 한 묶음 안의 글을 가장 긴 글 길이에 맞춰 함께 계산하기 때문입니다. 묶음에 긴 글(1,615토큰)이 하나 들어가면 나머지도 그 길이만큼 자리를 차지합니다. 16GB 그래픽카드라면 묶음 64(12.5GB)까지는 들어가겠지만 128은 넘칩니다(이 숫자를 바탕으로 한 추정이고, 16GB 카드에서 직접 돌려 보지는 않았습니다).
float16으로 돌리면 오류 없이 결과가 깨졌다
구글은 설명서에서 float16을 쓰지 말라고 적었습니다. 직접 해 보니 오류 메시지는 나오지 않았고, 227조각 중 5조각의 벡터가 숫자가 아닌 값(NaN)으로 나왔습니다. 나머지 222조각은 정상처럼 보입니다. 검색 결과에서 그 5조각만 찾지 못하게 되니 알아차리기 어려운 고장입니다. bfloat16이나 float32를 써야 합니다.
글 한 편을 통째로 넣으면
글을 조각으로 자르지 않고 한 편을 통째로 넣어도 됩니다. 이 블로그 글 25편은 한 편이 1,627~6,786토큰(평균 3,659토큰)이라 모두 8,192토큰 안에 들어갔습니다. 25편을 벡터로 바꾸는 데 1.4초, VRAM은 최고 3.7GB(묶음 4)였습니다.
이렇게 넣고 "어느 글인가"만 맞히게 하면 한국어 질문 63개 중 50개, 영어 질문 중 51개를 맞혔습니다. 조각으로 잘랐을 때는 53개와 59개였습니다. 글 하나를 통째로 넣는 것보다 소제목 단위로 자르는 쪽이 글도 더 잘 찾았고, 어느 절인지까지 알 수 있었습니다.
글로 그림 찾기
EmbeddingGemma 2는 그림도 같은 벡터로 바꿉니다. 그래서 글로 그림을 찾을 수 있습니다. 이 블로그의 그림 161장으로 해 봤습니다. 글에 넣은 그래프와 화면 캡처 141장, 갤러리의 사진풍 그림 20장입니다.
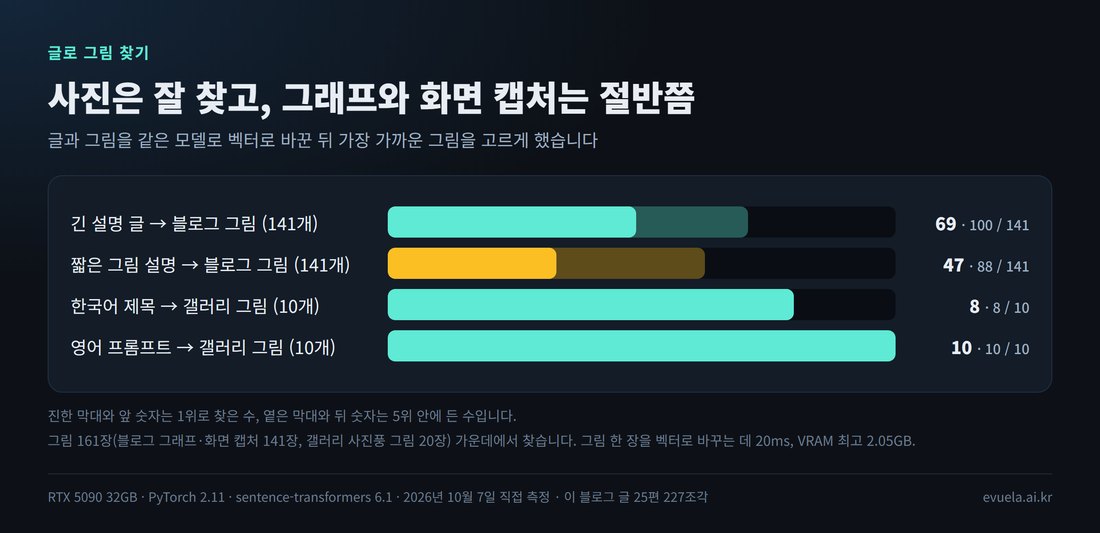
그림 161장 가운데 글로 맞는 그림을 찾게 한 결과입니다.
| 질문으로 넣은 글 | 찾을 그림 | 문제 수 | 1위 | 5위 안 |
|---|---|---|---|---|
| 영어 프롬프트 (그림을 만들 때 쓴 것) | 갤러리 사진풍 그림 | 10 | 10 | 10 |
| 한국어 제목 ("비 오는 골목, 등불 아래 고양이") | 갤러리 사진풍 그림 | 10 | 8 | 8 |
| 그림 내용을 숫자까지 적은 긴 한국어 설명 | 블로그 그래프·화면 캡처 | 141 | 69 | 100 |
| 그림 아래에 붙인 짧은 한국어 설명 | 블로그 그래프·화면 캡처 | 141 | 47 | 88 |
이 표가 뜻하는 것: 사진풍 그림은 한국어 제목만으로 10개 중 8개를 찾았습니다. 같은 장면을 두 모델로 그린 그림이 한 쌍씩 있어서, 둘 중 하나가 1위면 맞힌 것으로 셌습니다. 못 찾은 둘은 제목이 "영어 간판 글자 시험", "한글 포스터 글자 시험"입니다. 그림에 보이는 것이 아니라 시험의 이름을 적은 제목이라 찾지 못한 것이 자연스럽습니다.
그래프와 화면 캡처는 훨씬 어려운 문제입니다. 비슷하게 생긴 어두운 바탕의 표와 막대 그림이 141장 있고, 그 안의 한글과 숫자를 읽어야 구별됩니다. 긴 설명으로 141개 중 69개를 1위로, 100개를 5위 안에 찾았습니다. 그래프 그림 37장만 보면 24장, 화면 캡처와 만든 이미지 104장은 45장을 1위로 찾았습니다. 그래프 쪽이 더 잘 맞았습니다.
그림 한 장을 벡터로 바꾸는 데는 20ms가 걸렸고(161장에 3.3초), 그림 부분까지 올렸을 때 VRAM은 최고 2.1GB였습니다.
다른 곳의 측정과 견주면
- 구글의 점수와 이 글의 점수는 서로 견줄 수 없습니다. 구글의 61.36은 여러 언어, 여러 종류의 시험을 평균한 값이고, 이 글은 한국어 블로그 글 한 묶음에서 잰 값입니다.
- 겹치는 것은 방향입니다. 구글은 256차원까지 품질이 거의 같고 128차원에서 떨어진다고 했는데, 이 글에서도 256까지는 한두 개 차이였고 128에서 더 내려갔습니다. float16에서 결과가 조용히 깨진다는 설명도 그대로 확인했습니다.
- 이전 모델과 직접 견주지는 못했습니다. 구글 표에서 글 쪽 점수는 61.15에서 61.36으로 거의 같으니, 글 검색만 쓴다면 이전 모델에서 바꿔도 큰 차이는 없을 것으로 보입니다(구글 숫자를 바탕으로 한 추정).
정리
- 어디에 쓸모가 있나: 사람이 문서와 다른 낱말로 물을 때, 그리고 질문과 문서의 언어가 다를 때입니다. 이 두 경우에서 낱말 검색과의 차이가 가장 컸습니다(17개와 9개, 34개와 4개).
- 낱말 검색을 버릴 까닭은 없습니다. 모델 이름이나 제품 이름처럼 정확한 낱말로 찾는 질문은 낱말 검색이 더 잘 맞혔습니다. 두 방법이 맞히는 문제가 서로 달랐습니다.
- 1위 하나만 믿기보다 5위까지 가져와 쓰는 편이 좋습니다. 1위는 63개 중 31개, 5위 안은 49개였습니다. 틀릴 때는 같은 글의 소개 절을 가져오는 일이 많았습니다.
- 설정 세 가지: 머리말을 꼭 넣고, bfloat16으로 돌리고, 묶음은 16쯤으로 둡니다. 벡터 길이는 256으로 줄여도 이 시험에서는 차이가 없었습니다.
- 그래픽카드가 꼭 있어야 하는 것은 아닙니다. 질문 하나를 바꾸는 시간은 CPU도 28ms였습니다. 글을 많이 색인할 때만 차이가 납니다.
글을 쓰지 않는 작은 모델을 다룬 것은 이번이 두 번째입니다. 보기 가운데 답을 고르는 모델은 판단 전용 모델 Strands Decider 2B와 Clef-Flash 9B 비교에 정리했습니다. 이 글 맨 위의 요약 영상을 만드는 방법은 hyperframes로 블로그 요약 영상 만들기에 있고, 같은 PC에서 글 쓰는 모델의 속도를 잰 결과는 Gemma 4 12B와 Unsloth 기본값 글에 있습니다.
이 글의 한계
- 문제 수가 적습니다. 질문 63개, 글 227조각입니다. 두세 개 차이는 우연일 수 있습니다. 큰 차이(17개와 9개, 34개와 4개, 31개와 22개)만 결론으로 삼았습니다.
- 글 묶음이 한 종류입니다. 이 블로그의 테스트 글과 소식 글입니다. 글마다 같은 이름의 절이 있어서 이 모델에 불리한 면이 있었습니다. 법률 문서나 상품 설명 같은 다른 글에서는 결과가 다를 수 있습니다.
- 질문을 직접 썼습니다. 본문을 다 읽지 않고 소제목과 앞부분을 보고 썼고, 정답은 질문마다 절 하나로 정했습니다. 다른 절에도 답이 일부 들어 있는 질문이 있을 수 있습니다.
- 다른 임베딩 모델과 견주지 않았습니다. 이전 EmbeddingGemma나 다른 회사의 모델을 같은 문제로 돌려 보지 않았습니다. 견준 것은 낱말 검색뿐입니다.
- 소리와 영상은 넣어 보지 않았습니다. 글과 그림만 쟀습니다.
- RTX 5090 한 대에서만 쟀습니다. 16GB 카드에 대한 내용은 VRAM 숫자로 미루어 적은 것입니다.
- 기준 날짜는 2026년 10월 7일입니다.
자주 묻는 질문
EmbeddingGemma 2는 챗봇처럼 답을 써 주나요?
써 주지 않습니다. 글이나 그림을 숫자 768개로 바꿔 줄 뿐입니다. 그 숫자로 가까운 글을 찾는 일은 따로 계산해야 하고, 찾은 글로 답을 쓰는 일은 글 쓰는 모델이 합니다.
한국어 문서 검색에 써도 되나요?
이 글의 시험에서는 한국어 질문 63개 중 49개에서 맞는 절이 5위 안에 들었습니다. 다른 낱말로 물은 질문에서 특히 잘 찾았습니다. 정확한 이름으로 찾는 질문은 낱말 검색이 더 잘 맞혔으니, 낱말 검색과 함께 쓰는 것을 권합니다.
그래픽카드가 없어도 돌릴 수 있나요?
돌릴 수 있습니다. 질문 하나를 바꾸는 데 CPU로 28ms였습니다. 글 227조각을 한꺼번에 바꾸는 데는 31.8초가 걸렸습니다(24코어 CPU). 글이 아주 많지 않으면 CPU만으로도 쓸 수 있습니다.
VRAM은 얼마나 필요한가요?
글 부분만 올리면 0.5GB, 그림과 소리 부분까지 올리면 1.4GB입니다. 돌릴 때는 한 번에 넣는 묶음 크기에 따라 늘어납니다. 묶음 16에서 최고 3.5GB였습니다.
출처와 자료
- 모델과 설명서: google/embeddinggemma-2 (Hugging Face). 파라미터 수, 벡터 길이, 머리말 형식, float16 주의, 구글이 잰 점수는 이 설명서에서 가져왔습니다.
- 구글 개발 문서: EmbeddingGemma
- 이 글의 질문 63개와 정답, 조각 목록: embgemma2-testset.json (한국어와 영어, JSON 파일)
댓글 0개