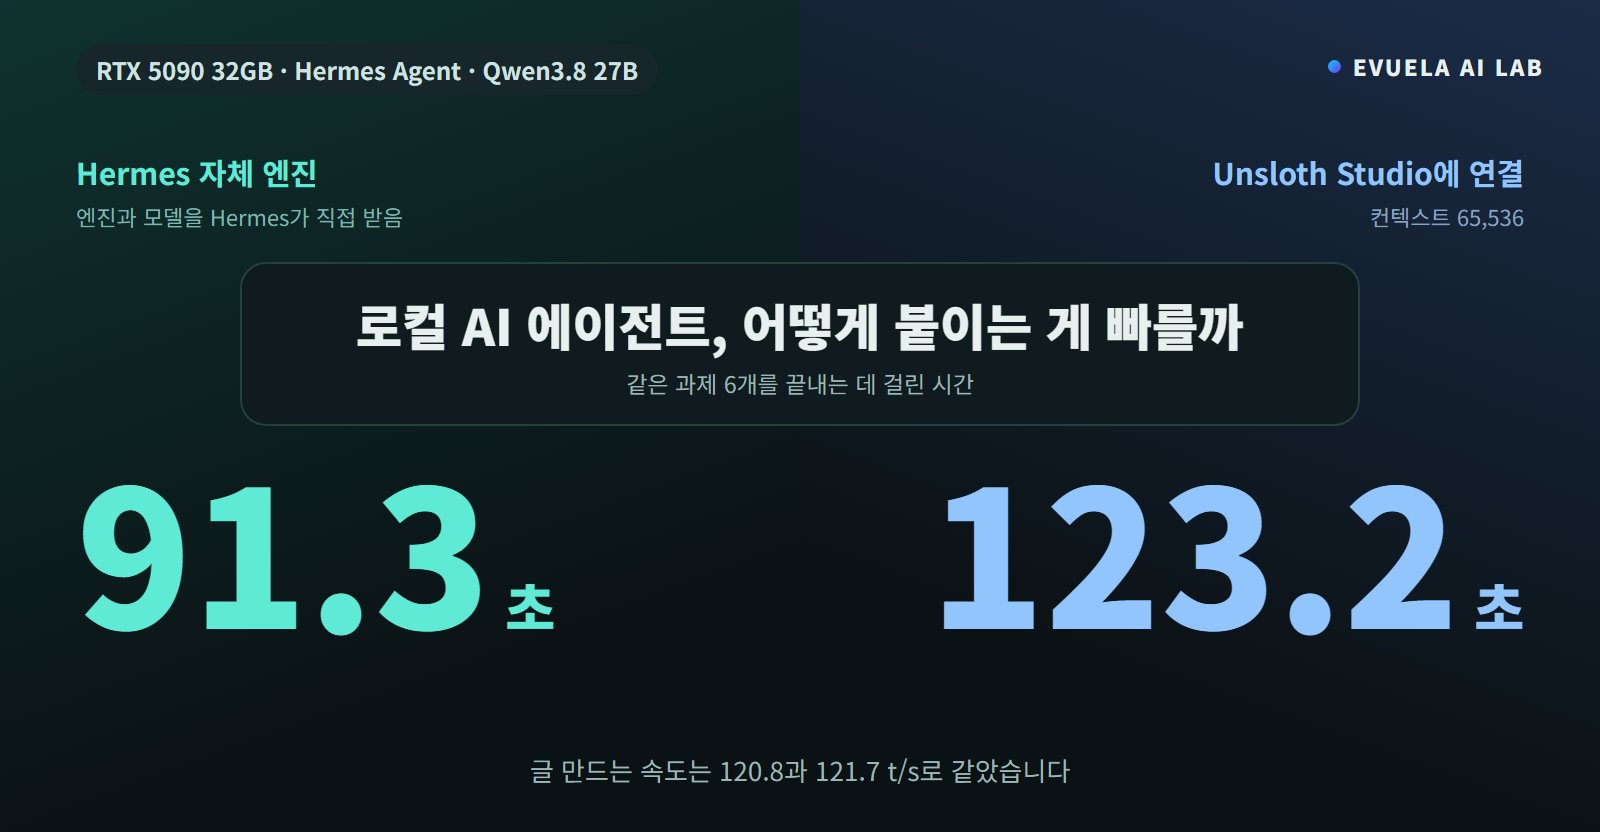
Hermes Agent를 로컬 모델에 붙이는 방법은 두 가지입니다. Hermes가 엔진과 모델을 직접 받아서 돌리는 방법과, 이미 쓰고 있는 Unsloth Studio에 연결하는 방법입니다. RTX 5090 32GB에서 Qwen3.8 27B로 같은 과제 7개를 시켜 보니, 글을 만드는 속도는 초당 120.8토큰과 121.7토큰으로 같았습니다. 그런데 과제 6개를 끝내는 데 걸린 시간은 자체 엔진 91.3초, Unsloth 연결 123.2초였습니다. 차이는 속도가 아니라, 도구를 쓸 때마다 앞의 긴 지시문을 다시 읽느냐에서 났습니다.
- 글 만드는 속도는 같습니다. 자체 엔진 120.8 t/s, Unsloth 연결(컨텍스트 65,536) 121.7 t/s. 둘 다 같은 엔진(llama.cpp)과 같은 속도 기능(MTP)을 씁니다.
- 일이 끝나는 시간은 자체 엔진이 빨랐습니다. 파일 하나 만들기가 9.5초와 14.0초, 문서 읽고 숫자 찾기가 15.6초와 25.0초였습니다.
- 이유는 프롬프트를 다시 읽는 양입니다. 파일 하나를 만드는 동안 자체 엔진은 입력 148토큰을, Unsloth 쪽은 8,378토큰을 읽었습니다.
- Unsloth 기본값으로 붙이면 더 느렸습니다. 컨텍스트가 169,216으로 잡히면서 속도 기능이 MTP가 아닌 것으로 바뀌어 66.9 t/s였습니다.
- 성공률은 비슷했습니다. 자체 엔진 33번 중 33번, Unsloth 65,536은 33번 중 32번, Unsloth 기본값은 33번 중 33번.
- 자체 엔진은 17.7GB를 새로 받아야 합니다. 이미 받아 둔 모델 파일이 있어도 그렇습니다.
이 글의 숫자는 모두 RTX 5090 32GB PC 한 대에서 직접 잰 값입니다. 숫자는 명령줄에서 같은 과제를 5번씩 되풀이해서 쟀고, 영상과 화면 캡처는 Hermes 데스크톱 판(GUI)에서 찍었습니다. 두 가지는 같은 엔진과 같은 설정을 씁니다. 속도와 토큰 수는 화면이 아니라 엔진의 실행 기록에서 읽었습니다.
이 글의 내용을 20초로 요약한 영상입니다(소리 없음).
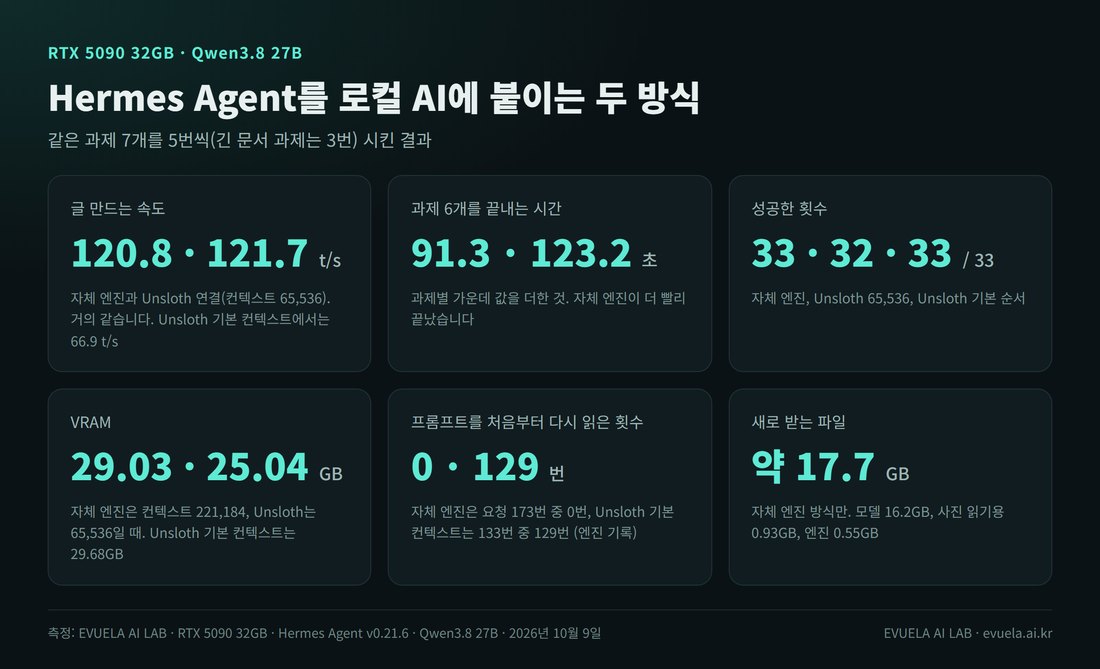
같은 과제를 세 가지 설정으로 돌린 결과입니다.
Hermes Agent와 두 가지 연결 방식
Hermes Agent는 Nous Research가 공개한 에이전트 프로그램입니다. 채팅만 하는 것이 아니라 파일을 만들고, 명령을 실행하고, 코드를 돌리는 일을 모델에게 시킵니다. 모델은 인터넷 서비스의 것을 쓸 수도 있고, 내 PC에서 도는 로컬 모델을 쓸 수도 있습니다. 로컬 모델을 쓰면 질문과 파일이 PC 밖으로 나가지 않습니다.
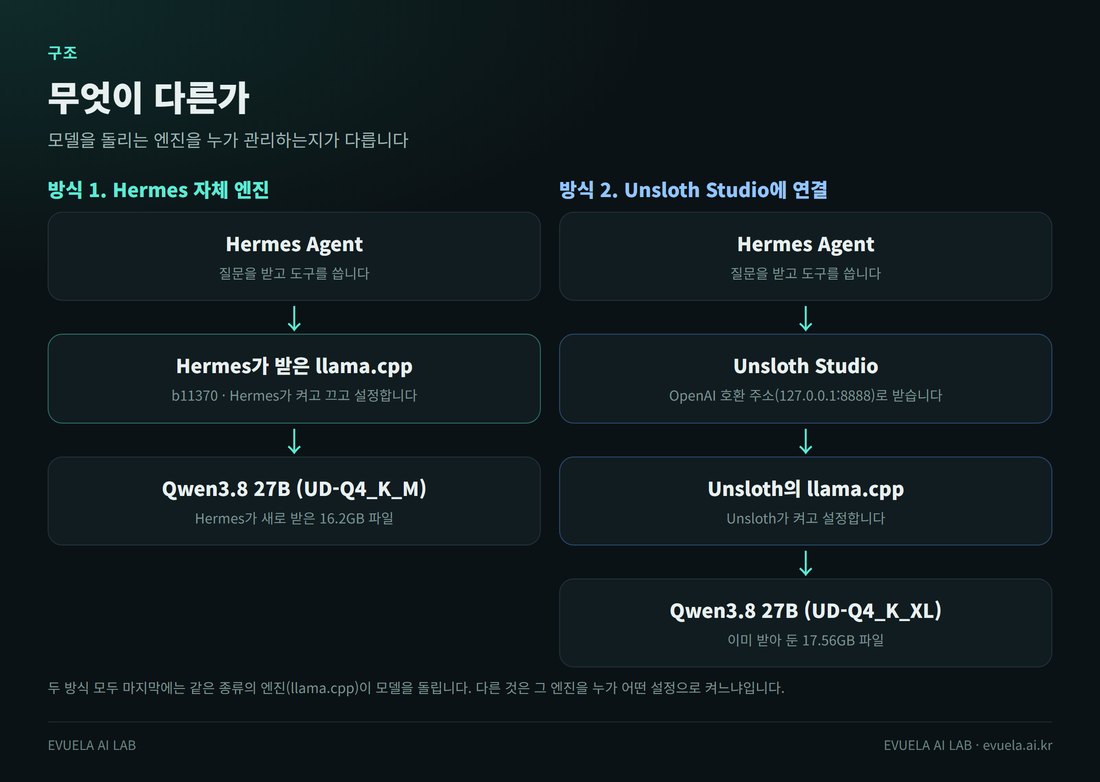
두 방식 모두 마지막에는 llama.cpp가 모델을 돌립니다. 그 엔진을 누가 켜고 설정하느냐가 다릅니다.
| 항목 | 방식 1. 자체 엔진 | 방식 2. Unsloth 연결 |
|---|---|---|
| 엔진을 관리하는 곳 | Hermes | Unsloth Studio |
| 모델 파일 | Hermes가 새로 받음 | Unsloth에 받아 둔 것을 그대로 씀 |
| 설정 | 손댈 곳이 없음. Hermes가 정함 | 컨텍스트, KV 캐시, 속도 기능을 직접 고를 수 있음 |
| 모델을 올리고 내리기 | 쓸 때 알아서 올리고, 15분 안 쓰면 내림 | 직접 올려 두어야 하고, 내릴 때까지 VRAM을 차지함 |
| 연결하는 방법 | 설정의 Local Models에서 Download 단추 | unsloth start hermes 명령 |
이 표가 뜻하는 것: 자체 엔진은 편한 대신 설정을 맡겨야 하고, Unsloth 연결은 설정을 쥐는 대신 손이 갑니다. 어느 쪽이 실제로 나은지 비교한 자료는 찾지 못해서 직접 쟀습니다. 두 방식의 설정 방법은 각각 공식 문서에 있습니다.
테스트 PC와 프로그램
| 항목 | 내용 |
|---|---|
| 그래픽카드 | NVIDIA GeForce RTX 5090 (VRAM 32GB) |
| CPU, 시스템 램 | Intel Core Ultra 9 285K, DDR5 64GB |
| 운영체제 | Windows 11 Pro |
| Hermes Agent | v0.21.6 (2026년 9월 24일 판), 윈도우 데스크톱 판 |
| Hermes가 받은 엔진 | llama.cpp b11370 (CUDA) |
| Unsloth Studio | 2026.10.3 |
| 모델 | Qwen3.8 27B. 자체 엔진은 UD-Q4_K_M(16.2GB), Unsloth는 UD-Q4_K_XL(17.56GB) |
| 생각(Thinking) | 두 방식 모두 Medium (Hermes 기본값) |
| 날짜 | 2026년 10월 9일 |
이 표가 뜻하는 것: 모델 파일이 서로 다릅니다. Hermes의 목록에는 Qwen3.8 27B가 UD-Q4_K_M 한 가지만 있고, Unsloth에 받아 둔 것은 UD-Q4_K_XL이었습니다. 둘 다 4비트이고 같은 곳(unsloth)이 올린 파일이지만 같은 파일은 아닙니다. 결과를 볼 때 이 점을 감안해야 합니다.
방식 1. Hermes가 직접 받아서 돌리기
Hermes 데스크톱 판의 설정에서 Providers → Local Models로 들어가면 이 PC에서 돌릴 수 있는 모델 목록이 나옵니다. Hermes가 그래픽카드를 읽고 모델마다 맞는지 표시해 줍니다.
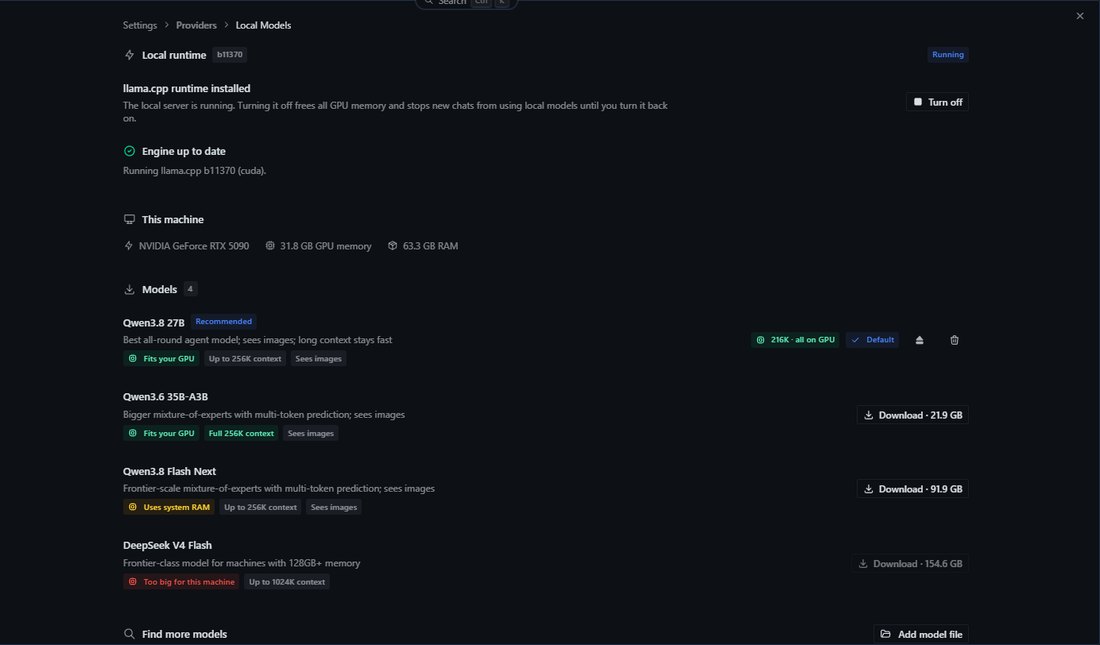
Local Models 화면입니다. 모델마다 이 그래픽카드에 맞는지 표시가 붙습니다.
| 화면에 나온 모델 | 표시 | 크기 |
|---|---|---|
| Qwen3.8 27B | Recommended, Fits your GPU, 216K 모두 GPU에 | 16.2GB |
| Qwen3.6 35B-A3B | Fits your GPU, Full 256K context | 21.9GB |
| Qwen3.8 Flash Next | Uses system RAM (시스템 램을 씀) | 91.9GB |
| DeepSeek V4 Flash | Too big for this machine (이 PC에는 너무 큼) | 154.6GB |
이 표가 뜻하는 것: 목록이 네 개뿐입니다. 고를 수 있는 폭은 좁지만, 내 그래픽카드에 들어가는지를 받기 전에 알려 줍니다. 목록에 없는 모델은 화면 아래의 Find more models로 찾거나, Add model file로 이미 있는 GGUF 파일을 연결할 수 있습니다. 이번에는 이 두 기능을 써 보지 않았습니다.
받기부터 쓸 수 있을 때까지
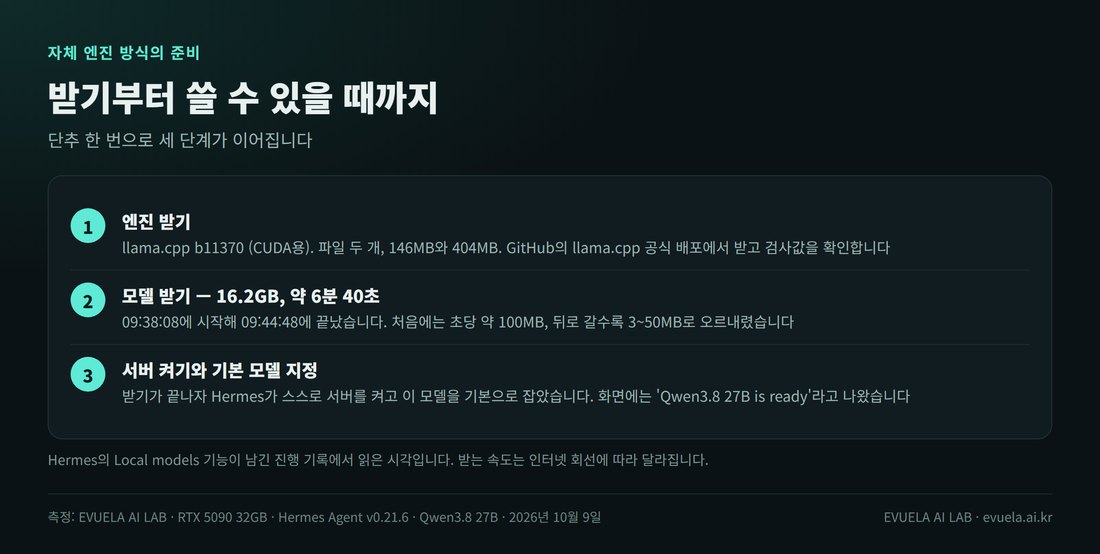
Download 단추를 누른 뒤의 과정입니다.
Download를 누르면 엔진을 먼저 받고, 이어서 모델을 받고, 끝나면 스스로 서버를 켜서 기본 모델로 잡습니다. 모델 16.2GB를 받는 데 약 6분 40초가 걸렸습니다. 처음에는 초당 약 100MB였고 뒤로 갈수록 3~50MB로 오르내렸습니다. 받는 속도는 인터넷 회선에 따라 다릅니다.
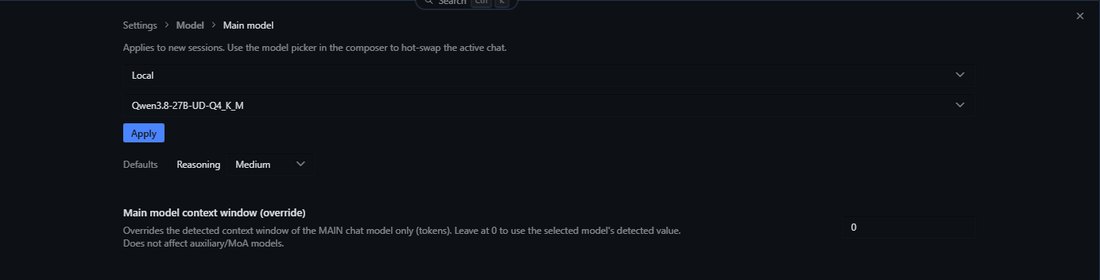
받기가 끝난 뒤의 기본 모델 설정입니다. 공급자가 Local로 바뀌어 있습니다.
받은 뒤에 Hermes가 실제로 엔진을 어떤 설정으로 켰는지는 Hermes가 만든 설정 파일(presets.ini)에서 확인했습니다.
| 설정 | Hermes가 정한 값 |
|---|---|
| 컨텍스트 | 221,184 |
| 속도 기능 | MTP (draft-mtp, 한 번에 2토큰까지 미리 예측) |
| KV 캐시 | q8_0 |
| Flash Attention | 켬 |
| 샘플링 | 온도 1.0, Top P 0.95, Top K 20 |
| 생각 단계 | medium |
이 표가 뜻하는 것: Hermes가 고른 값은 이 블로그가 Qwen3.8 27B 설정 찾기 글에서 직접 찾았던 좋은 설정과 같은 방향입니다. 그 글에서는 KV 캐시를 q8_0으로 줄이고 MTP를 켜면 최대 컨텍스트에서도 초당 103토큰이 나왔습니다. 설정을 만질 수 없다는 단점이 실제로는 문제가 되지 않았습니다.
방식 2. Unsloth Studio에 연결하기
Unsloth Studio에 모델을 올려 둔 상태에서 터미널에 아래 명령을 넣으면 Hermes가 Unsloth에 붙은 채로 열립니다.
unsloth start hermes이 명령은 Hermes를 따로 만든 임시 설정으로 띄웁니다. 이미 설치한 Hermes의 설정은 건드리지 않습니다. 데스크톱 판의 모델 목록에 Unsloth를 더하려면 --app을 붙입니다.
unsloth start hermes --app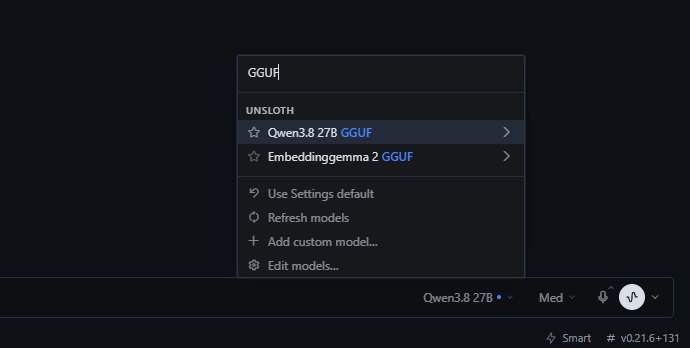
--app으로 연결한 뒤 모델 고르는 창에 UNSLOTH 항목이 생겼습니다.
연결할 때 겪은 것이 두 가지 있습니다.
- 컨텍스트가 저절로 바뀌었습니다. 모델을 65,536으로 올려 두었는데, 컨텍스트를 지정하지 않고 연결 명령을 부르자 166,912로 바뀌어 있었습니다. VRAM이 25.7GB에서 30.4GB로 늘었습니다. 컨텍스트를 지키려면
--max-seq-length 65536을 붙여야 했습니다. - 모델을 바꾸면 연결 명령을 다시 실행해야 합니다. Unsloth에서 다른 모델을 올린 뒤에는
--app명령을 한 번 더 돌려야 Hermes에 반영됩니다.
실제로 돌아간 설정은 어떻게 달랐나
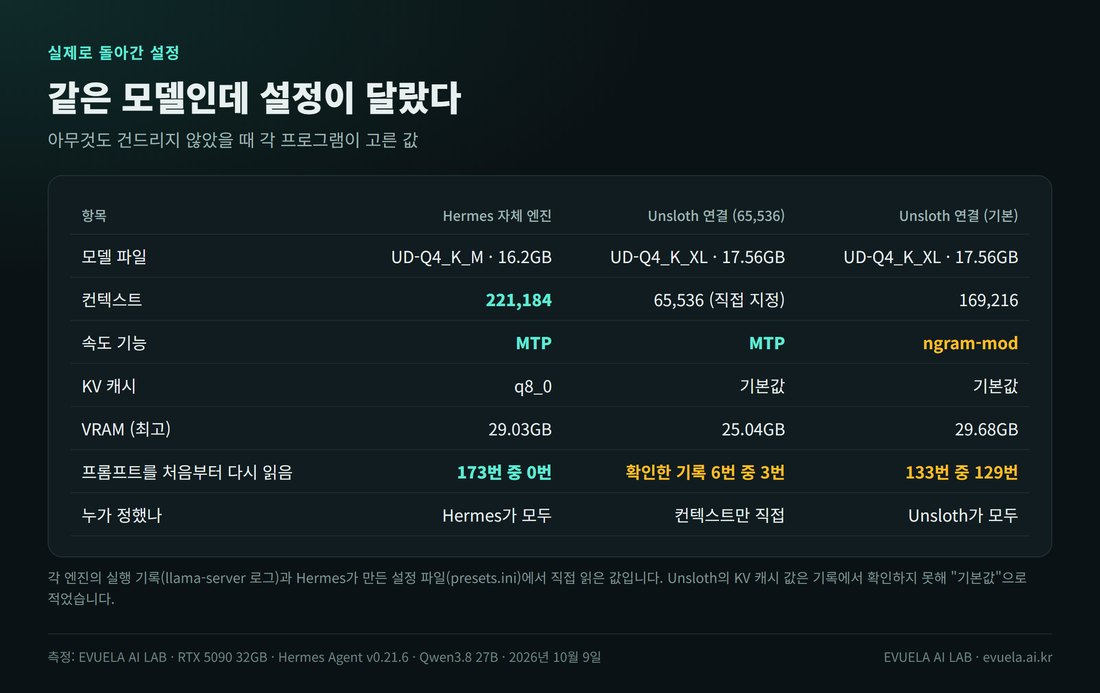
각 엔진의 실행 기록에서 직접 읽은 값입니다.
측정은 세 가지 설정으로 했습니다. 자체 엔진은 기본값 그대로이고, Unsloth 연결은 컨텍스트를 65,536으로 직접 정한 것과 Unsloth가 알아서 정하게 둔 것 두 가지입니다.
| 항목 | 자체 엔진 | Unsloth 연결 (65,536) | Unsloth 연결 (기본) |
|---|---|---|---|
| 컨텍스트 | 221,184 | 65,536 | 169,216 |
| 속도 기능 | MTP | MTP | ngram-mod |
| VRAM (최고) | 29.03GB | 25.04GB | 29.68GB |
| 프롬프트를 처음부터 다시 읽음 | 173번 중 0번 | 확인한 기록 6번 중 3번 | 133번 중 129번 |
이 표가 뜻하는 것: 같은 모델인데 프로그램이 고른 설정이 달랐습니다. 눈여겨볼 줄은 두 개입니다. Unsloth 기본값은 컨텍스트를 크게 잡느라 MTP를 켜지 못했고, Unsloth 쪽 엔진은 요청이 올 때마다 프롬프트를 처음부터 다시 읽었습니다. 이 두 가지가 아래 결과를 만들었습니다.
어떻게 쟀나
과제마다 작업 폴더를 비우고 Hermes에 일을 하나 시킨 뒤, 끝날 때까지의 시간과 엔진 기록을 모았습니다. 성공 여부는 모델의 말이 아니라 파일이 실제로 맞게 만들어졌는지로 봤습니다.
| 과제 | 시킨 일 | 성공으로 본 조건 |
|---|---|---|
| 1. 한 문장 대답 | 지금 어떤 모델인지 한 문장으로 답하기 | 답에 모델 이름이 있음 |
| 2. 파일 하나 만들기 | hello.txt를 만들고 한 줄 적기 | 파일 내용이 정확히 일치 |
| 3. 여러 단계 파일 작업 | 폴더와 파일 3개를 만들고, 읽어서 한 줄씩 합친 파일 만들기 | 파일 4개의 내용이 모두 일치 |
| 4. 800자 글 쓰기 | 도구 없이 800자 정도의 글 쓰기 | 500~1,300자 |
| 5. 코드 짜고 실행하기 | FizzBuzz 파이썬 파일을 만들고 실행해서 출력을 저장 | 저장한 출력 15줄이 정답과 일치 |
| 6. 문서 읽고 숫자 찾기 | 7,684자 문서에서 숫자 두 개를 찾아 파일에 적기 | 두 숫자가 맞음 |
| 7. 긴 문서에서 숫자 찾기 | 97,441자 문서를 끝까지 읽고 숫자 두 개 찾기 | 두 숫자가 맞음 |
이 표가 뜻하는 것: 1~6번은 5번씩, 7번은 3번씩 돌렸습니다. 설정 세 가지에 33번씩, 모두 99번입니다. 켠 도구는 파일 도구이고 3번과 5번에서만 터미널을 더 켰습니다. 웹과 브라우저 도구는 껐습니다. 속도와 토큰 수는 llama.cpp가 남기는 실행 기록의 값입니다.
결과 1. 글 만드는 속도는 같았다
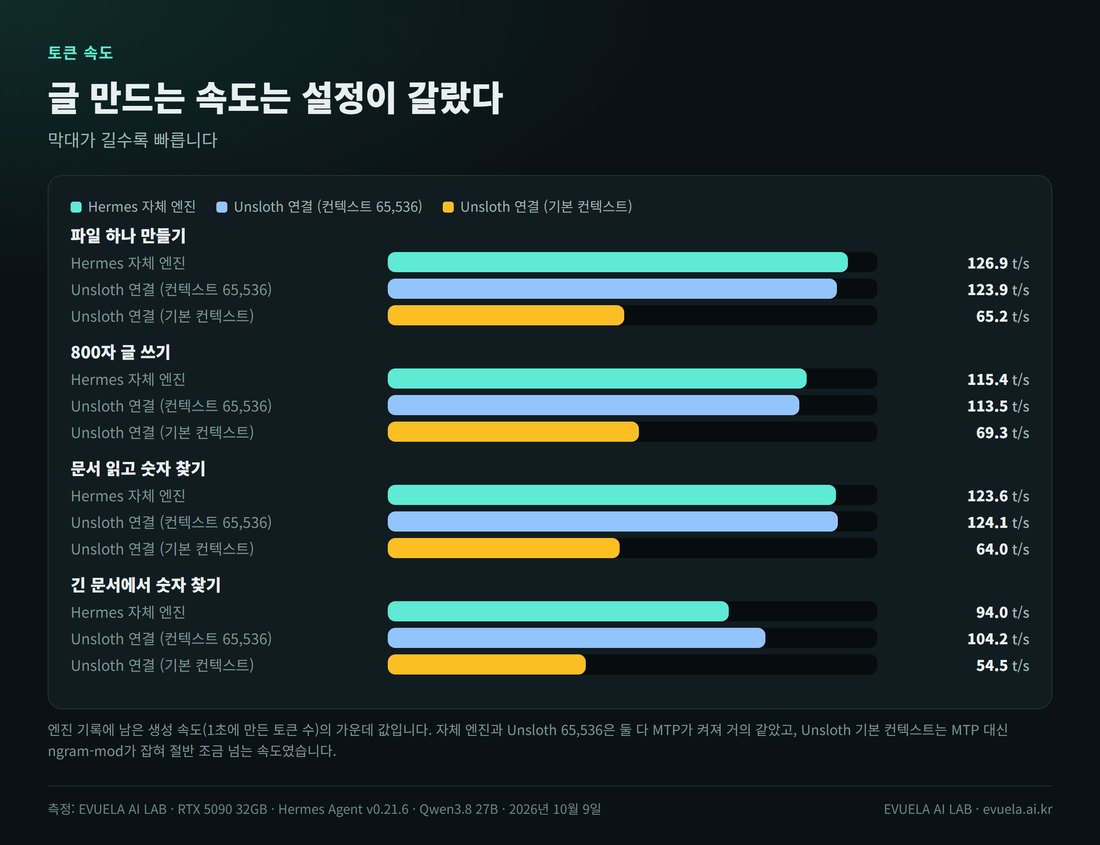
엔진 기록에 남은 생성 속도의 가운데 값입니다.
| 과제 | 자체 엔진 | Unsloth 연결 (65,536) | Unsloth 연결 (기본) |
|---|---|---|---|
| 한 문장 대답 | 115.1 t/s | 113.6 t/s | 65.7 t/s |
| 파일 하나 만들기 | 126.9 t/s | 123.9 t/s | 65.2 t/s |
| 여러 단계 파일 작업 | 117.3 t/s | 115.2 t/s | 68.7 t/s |
| 800자 글 쓰기 | 115.4 t/s | 113.5 t/s | 69.3 t/s |
| 코드 짜고 실행하기 | 128.8 t/s | 126.6 t/s | 83.0 t/s |
| 문서 읽고 숫자 찾기 | 123.6 t/s | 124.1 t/s | 64.0 t/s |
| 긴 문서에서 숫자 찾기 | 94.0 t/s | 104.2 t/s | 54.5 t/s |
이 표가 뜻하는 것: 자체 엔진과 Unsloth 65,536은 과제마다 2~3 t/s 안에서 같습니다. 둘 다 MTP가 켜져 있기 때문입니다. Unsloth 기본값은 컨텍스트를 169,216으로 잡으면서 MTP 대신 ngram-mod가 켜졌고, 속도가 절반 조금 넘는 수준이었습니다. 긴 문서 과제에서 자체 엔진이 Unsloth 65,536보다 느린 것은 한 번에 7만 토큰을 넘게 물고 있었기 때문으로 보입니다(추정).
아래는 GUI에서 800자 글을 시킨 영상입니다. 화면 아래에 그 영상을 찍을 때의 엔진 기록 속도를 적었습니다.
Unsloth 연결, 컨텍스트 65,536. 엔진 기록으로 108.3 t/s입니다.
Unsloth 연결, 기본 컨텍스트. 엔진 기록으로 70.7 t/s입니다. 글자가 나오는 속도 차이가 눈으로 보입니다.
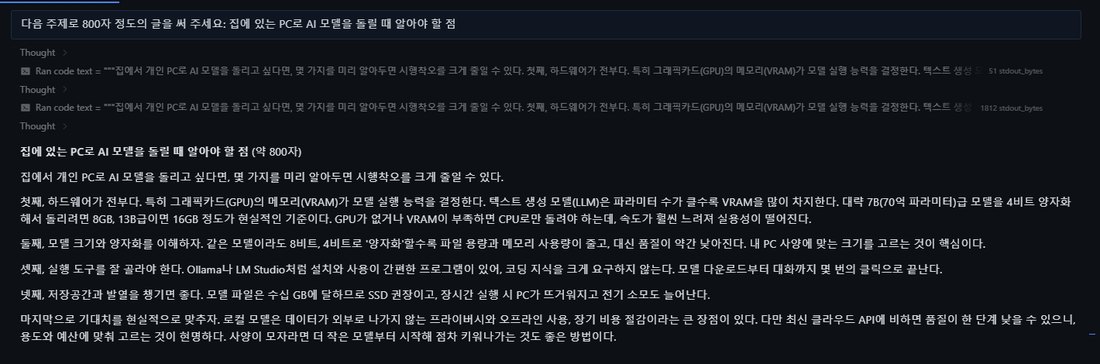
Unsloth 기본 컨텍스트에서 끝난 화면입니다.
결과 2. 일이 끝나는 시간은 자체 엔진이 빨랐다
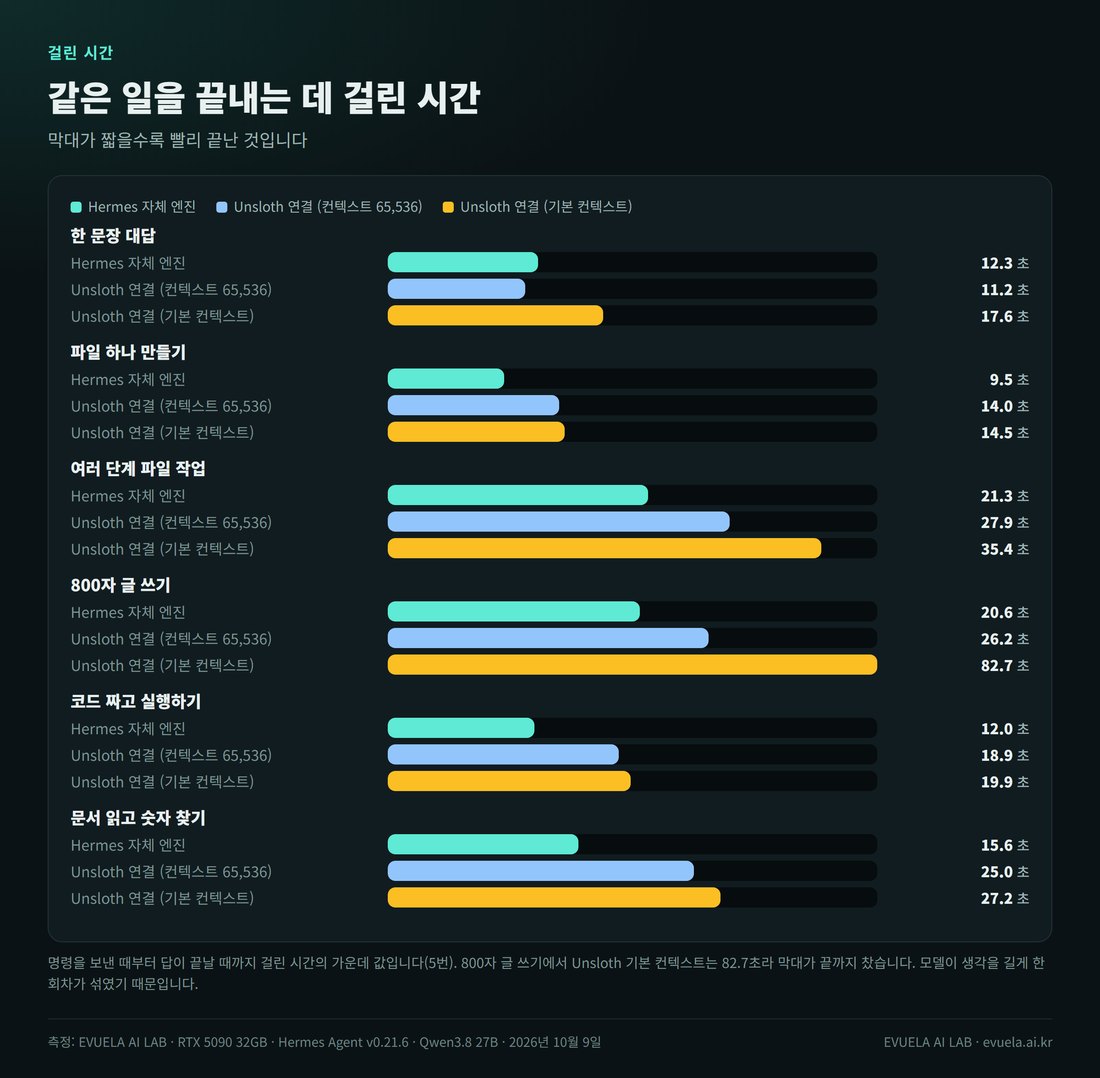
명령을 보낸 때부터 답이 끝날 때까지의 시간입니다.
| 과제 | 자체 엔진 | Unsloth 연결 (65,536) | Unsloth 연결 (기본) |
|---|---|---|---|
| 한 문장 대답 | 12.3초 (7.3~28.4) | 11.2초 (10.4~18.9) | 17.6초 (15.0~21.3) |
| 파일 하나 만들기 | 9.5초 (9.4~9.6) | 14.0초 (13.6~14.1) | 14.5초 (14.3~16.7) |
| 여러 단계 파일 작업 | 21.3초 (12.0~25.7) | 27.9초 (22.8~30.4) | 35.4초 (31.7~35.9) |
| 800자 글 쓰기 | 20.6초 (14.9~23.2) | 26.2초 (19.0~34.7) | 82.7초 (19.0~142.0) |
| 코드 짜고 실행하기 | 12.0초 (10.7~12.2) | 18.9초 (18.6~22.2) | 19.9초 (18.8~22.7) |
| 문서 읽고 숫자 찾기 | 15.6초 (14.9~17.6) | 25.0초 (24.2~25.4) | 27.2초 (26.0~31.2) |
| 여섯 과제 합 | 91.3초 | 123.2초 | 197.3초 |
이 표가 뜻하는 것: 5번 잰 가운데 값이고 괄호는 가장 빠른 때와 가장 느린 때입니다. 글 만드는 속도가 같은 자체 엔진과 Unsloth 65,536 사이에서도 여섯 과제 합이 32초 차이 났습니다. 도구를 쓰는 과제일수록 차이가 컸고, 도구를 쓰지 않는 한 문장 대답은 같았습니다. 800자 글 쓰기에서 Unsloth 기본값이 82.7초인 것은 모델이 생각을 길게 한 회차가 섞여서입니다. 가장 긴 회차는 출력만 10,080토큰이었습니다.
같은 파일 작업을 두 방식으로 시킨 영상을 위아래로 붙였습니다. 두 영상은 같은 시각에 시작합니다.
위는 자체 엔진, 아래는 Unsloth 연결(기본 컨텍스트)입니다. 위가 끝난 뒤에도 아래는 한참 이어집니다.
자체 엔진으로 파일 작업을 하는 모습입니다. 만든 파일의 내용이 화면에 바로 나옵니다.
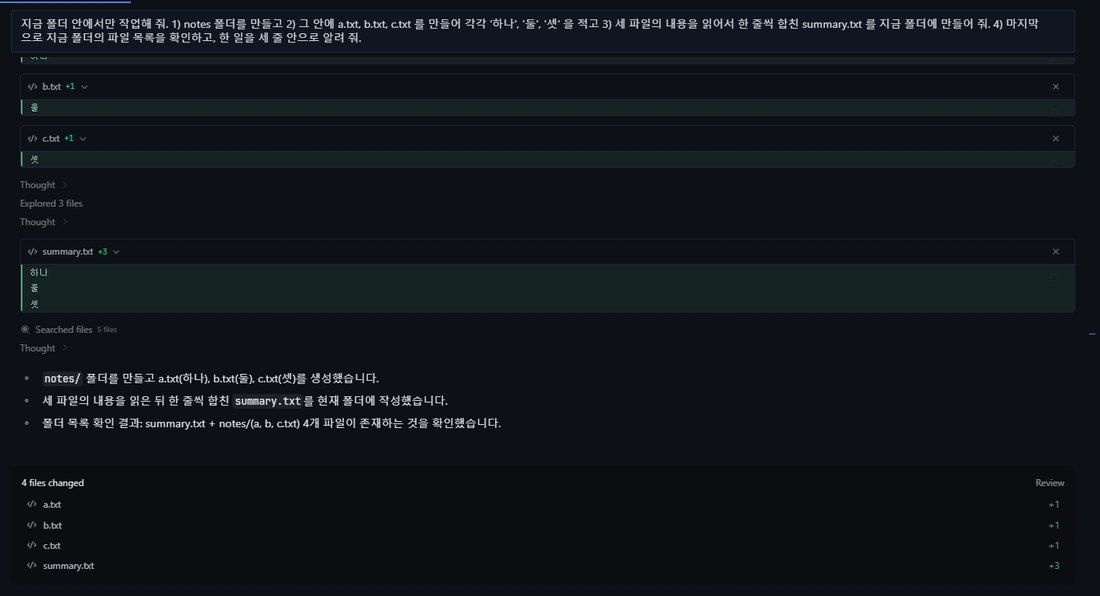
끝난 화면입니다. 바뀐 파일 네 개가 목록으로 나옵니다.
결과 3. 차이는 프롬프트를 다시 읽는 데서 났다
속도가 같은데 왜 걸린 시간이 다를까요. 엔진 기록에서 과제 하나를 하는 동안 실제로 읽어 들인 입력 토큰을 세어 보니 답이 나왔습니다.
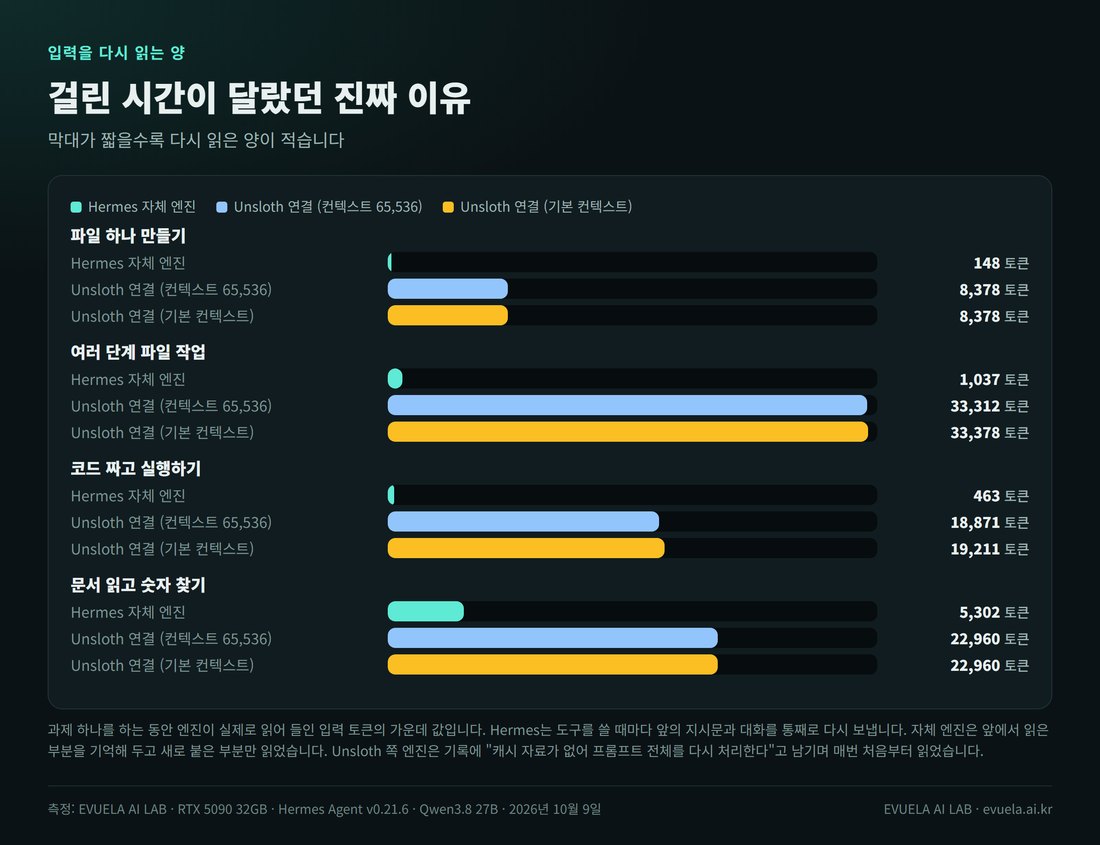
막대가 짧을수록 다시 읽은 양이 적습니다.
| 과제 | 도구 호출 | 자체 엔진이 읽은 입력 | Unsloth 연결이 읽은 입력 |
|---|---|---|---|
| 한 문장 대답 | 0번 | 4토큰 | 4,100토큰 |
| 파일 하나 만들기 | 1번 | 148토큰 | 8,378토큰 |
| 여러 단계 파일 작업 | 4번 | 1,037토큰 | 33,312토큰 |
| 코드 짜고 실행하기 | 2~3번 | 463토큰 | 18,871토큰 |
| 문서 읽고 숫자 찾기 | 2번 | 5,302토큰 | 22,960토큰 |
이 표가 뜻하는 것: Hermes는 도구를 한 번 쓸 때마다 앞의 지시문과 대화 전체를 다시 보냅니다. 지시문만 약 4,100토큰입니다. 자체 엔진은 앞에서 읽은 부분을 기억해 두고 새로 붙은 부분만 읽었습니다. Unsloth 쪽은 요청마다 처음부터 다시 읽었습니다. 도구를 4번 쓰는 과제에서 33,312토큰이 된 까닭입니다.
엔진 기록에 원인이 적혀 있었습니다. Unsloth 쪽 엔진은 요청마다 이런 줄을 남겼습니다.
forcing full prompt re-processing due to lack of cache data
Unsloth Studio가 켠 llama-server의 실행 기록 (2026년 10월 9일)
쉽게 말하면 "기억해 둔 것이 없어서 프롬프트 전체를 다시 처리한다"는 뜻입니다. 같은 기록에 "context checkpoints disabled"(컨텍스트 체크포인트가 꺼져 있음)라는 줄도 있었습니다. Hermes가 받은 엔진의 기록에는 이 줄이 한 번도 없었습니다.
| 엔진 | 요청 수 | 전체를 다시 읽은 횟수 |
|---|---|---|
| Hermes 자체 엔진 | 173번 | 0번 |
| Unsloth 연결 (기본 컨텍스트) | 133번 | 129번 |
이 표가 뜻하는 것: 두 엔진은 같은 llama.cpp인데 켜는 방식이 달랐고, 그 차이가 에이전트처럼 요청을 여러 번 주고받는 일에서 드러났습니다. 한 번 묻고 한 번 답하는 채팅에서는 이 차이가 거의 보이지 않습니다. 왜 Unsloth 쪽에서 체크포인트가 꺼져 있는지는 확인하지 못했습니다.
한 가지 밝혀 둘 점이 있습니다. 이 측정은 같은 질문을 5번 되풀이했기 때문에, 자체 엔진은 앞 회차에서 읽은 지시문까지 기억하고 있었습니다. 한 문장 대답에서 4토큰만 읽은 것이 그래서입니다. 새 대화를 처음 열면 자체 엔진도 지시문 약 4,100토큰을 한 번은 읽습니다. 그 뒤로 도구를 쓸 때 다시 읽지 않는다는 점이 차이입니다.
결과 4. 긴 문서를 읽혔을 때
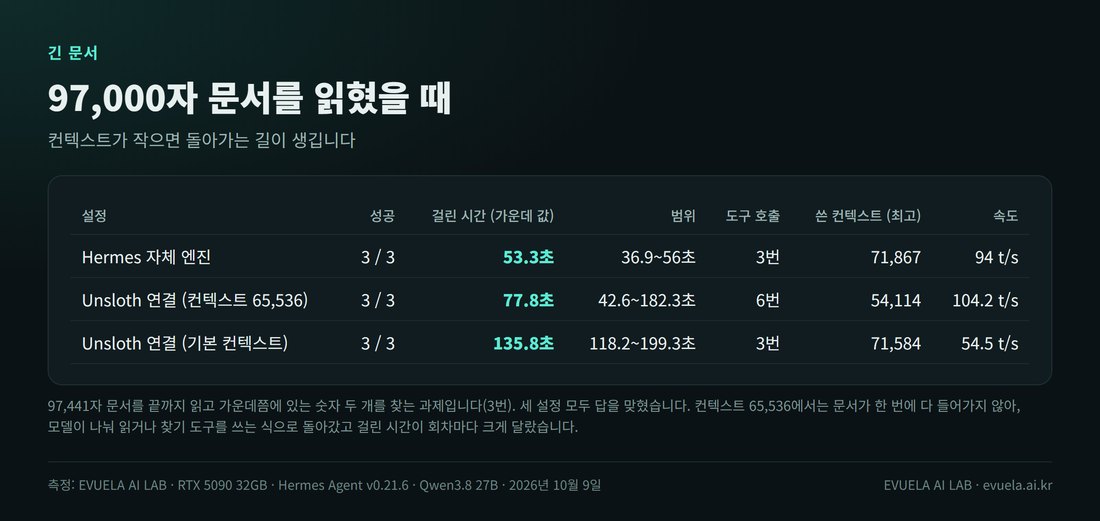
97,441자 문서에서 숫자 두 개를 찾는 과제입니다.
| 설정 | 성공 | 걸린 시간 | 도구 호출 | 쓴 컨텍스트 (최고) |
|---|---|---|---|---|
| 자체 엔진 (컨텍스트 221,184) | 3번 중 3번 | 53.3초 (36.9~56.0) | 3번 | 71,867토큰 |
| Unsloth 연결 (65,536) | 3번 중 3번 | 77.8초 (42.6~182.3) | 6번 | 54,114토큰 |
| Unsloth 연결 (기본, 169,216) | 3번 중 3번 | 135.8초 (118.2~199.3) | 3번 | 71,584토큰 |
이 표가 뜻하는 것: 세 설정 모두 답을 맞혔습니다. 문서가 7만 토큰을 넘어서 컨텍스트 65,536에는 한 번에 다 들어가지 않는데도, 모델이 나눠 읽거나 찾기 도구를 쓰는 식으로 돌아가서 답을 찾았습니다. 대신 걸린 시간이 42.6초에서 182.3초까지 회차마다 크게 달랐습니다. 컨텍스트가 넉넉한 자체 엔진은 36.9~56.0초로 고르게 끝났습니다.
자체 엔진으로 긴 문서를 읽는 모습입니다. 파일을 두 번에 나눠 읽고 답을 적습니다.
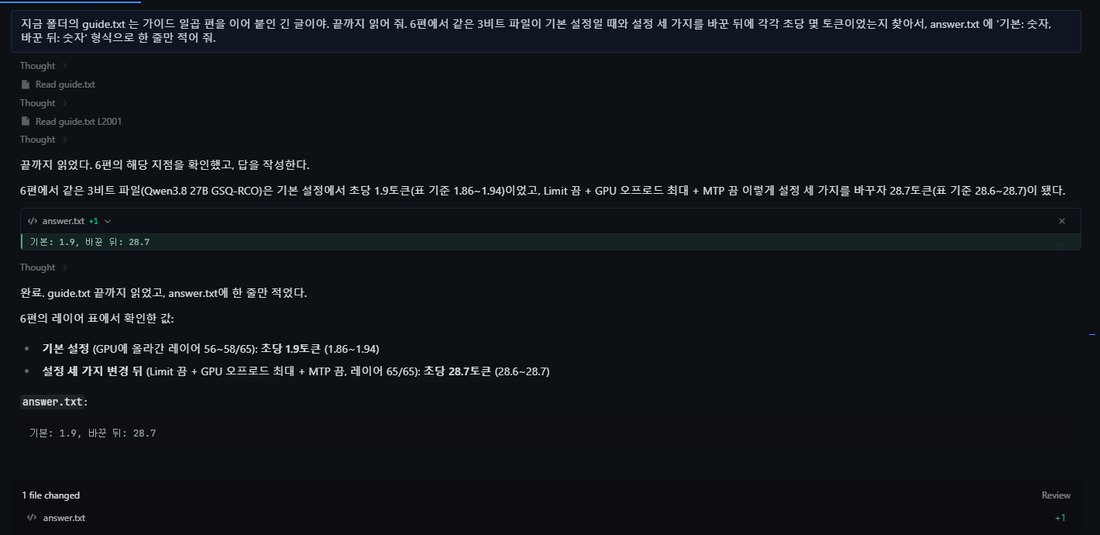
문서의 표에 있던 범위(1.86~1.94)까지 정확히 읽어 냈습니다.
결과 5. 성공률, 전력과 온도
| 항목 | 자체 엔진 | Unsloth 연결 (65,536) | Unsloth 연결 (기본) |
|---|---|---|---|
| 성공 | 33번 중 33번 | 33번 중 32번 | 33번 중 33번 |
| 평균 전력 (그래픽카드) | 231W | 269W | 300W |
| 최고 온도 | 68도 | 70도 | 71도 |
| VRAM (최고) | 29.03GB | 25.04GB | 29.68GB |
| 답에 한자가 섞인 횟수 | 1번 | 1번 | 0번 |
이 표가 뜻하는 것: 실패 한 번은 Unsloth 65,536의 여러 단계 파일 작업에서 나왔습니다. "한 줄씩 합친" 파일을 만들라고 했는데 "하나 둘 셋"을 한 줄에 적었습니다. 지시를 다르게 읽은 것이고, 방식의 차이라기보다 모델이 가끔 내는 실수로 보입니다(추정). 평균 전력은 Unsloth 쪽이 높았습니다. 같은 일을 하면서 프롬프트를 다시 읽느라 그래픽카드가 더 오래 일했기 때문으로 보입니다(추정).
자체 엔진은 엔진이 꺼진 상태에서 첫 질문을 하면 모델을 올리는 시간이 더해집니다. 엔진을 끄고 한 문장을 물었을 때 답까지 31초가 걸렸습니다(한 번 잰 값). 엔진이 켜져 있을 때는 7~12초였습니다.
GUI에서 본 것: 실행 전에 허락을 묻는다
데스크톱 판에서 800자 글을 부탁했을 때 예상하지 못한 장면이 나왔습니다. 모델이 글자 수를 정확히 세겠다며 코드를 실행하려 했고, Hermes 화면이 실행하기 전에 허락을 물었습니다.
800자 글을 부탁하자 코드를 실행하려 했고, 화면이 먼저 물었습니다.
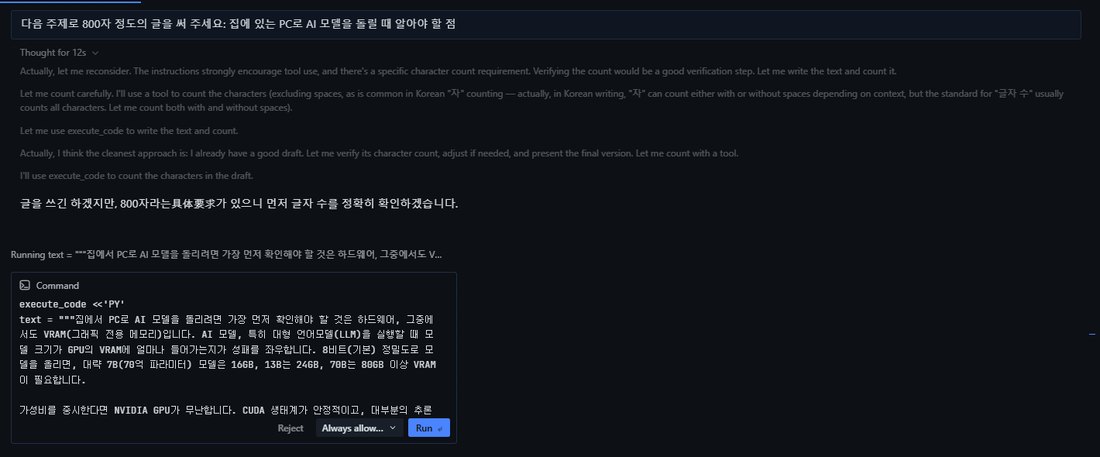
Reject(거절), Always allow(늘 허락), Run(실행) 가운데 고르게 합니다.
Reject를 누르자 모델은 "스크립트 실행이 거부되어 코드 없이 직접 작성했습니다"라고 적고 글을 썼습니다.
거절한 뒤 코드 없이 글을 쓰는 모습입니다.
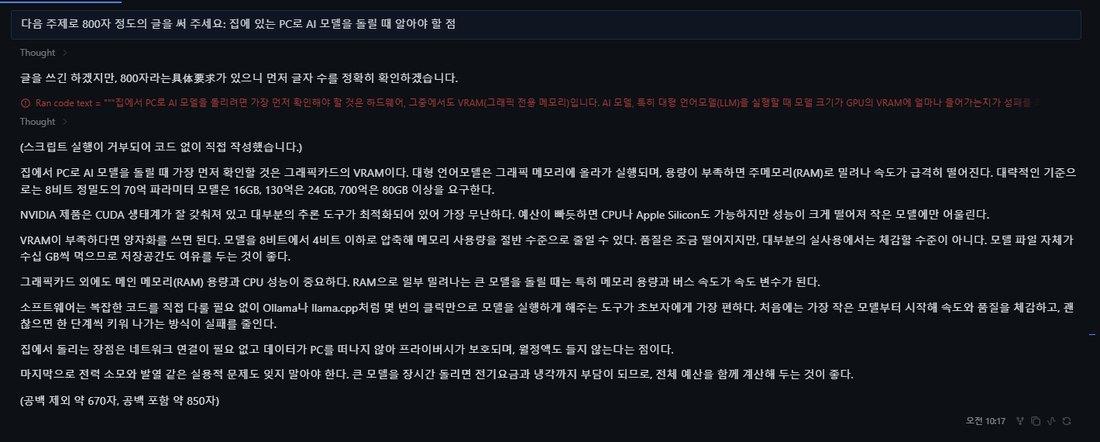
거절해도 일은 끝까지 했습니다.
눈에 띈 점이 세 가지 있습니다.
- 늘 묻는 것은 아니었습니다. 같은 800자 글을 Unsloth 연결로 시켰을 때는 코드를 두 번 실행했는데 묻지 않았습니다. 파일을 만들거나
python fizz.py를 실행할 때도 묻지 않았습니다. 어떤 때 묻는지는 이번 테스트로는 알아내지 못했습니다. - 한자가 섞였습니다. 위 화면의 "800자라는具体要求가 있으니"처럼 중국어 낱말이 한 번 들어갔습니다. 명령줄 측정에서도 세 설정 99번 가운데 2번에서 한자가 섞였습니다.
- GUI는 명령줄보다 컨텍스트를 더 씁니다. 같은 파일 작업에서 명령줄은 최고 7,805토큰, GUI는 13,859토큰을 썼습니다. GUI에서 켜진 도구가 더 많기 때문으로 보입니다(추정).
코드를 짜고 실행하는 일은 10초 안팎에 끝났습니다.
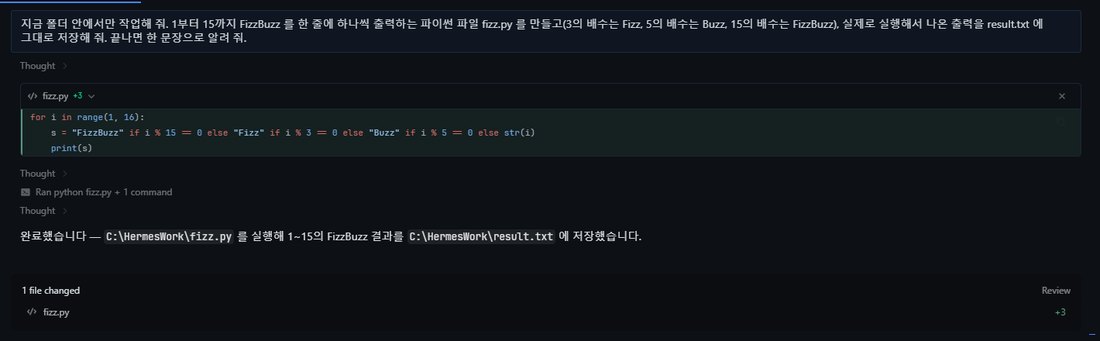
만든 코드와 실행 기록이 화면에 남습니다.
안전하게 쓰려면: 기본 설정에서 바꾼 것
Hermes를 설치한 그대로 두면 켜져 있는 도구가 많습니다. 웹 검색, 브라우저 조작, PC 화면 조작, 예약 작업까지 켜진 채로 시작합니다. 로컬 모델을 쓰는 까닭이 자료를 밖으로 내보내지 않으려는 것이라면 먼저 꺼 두는 편이 맞습니다.
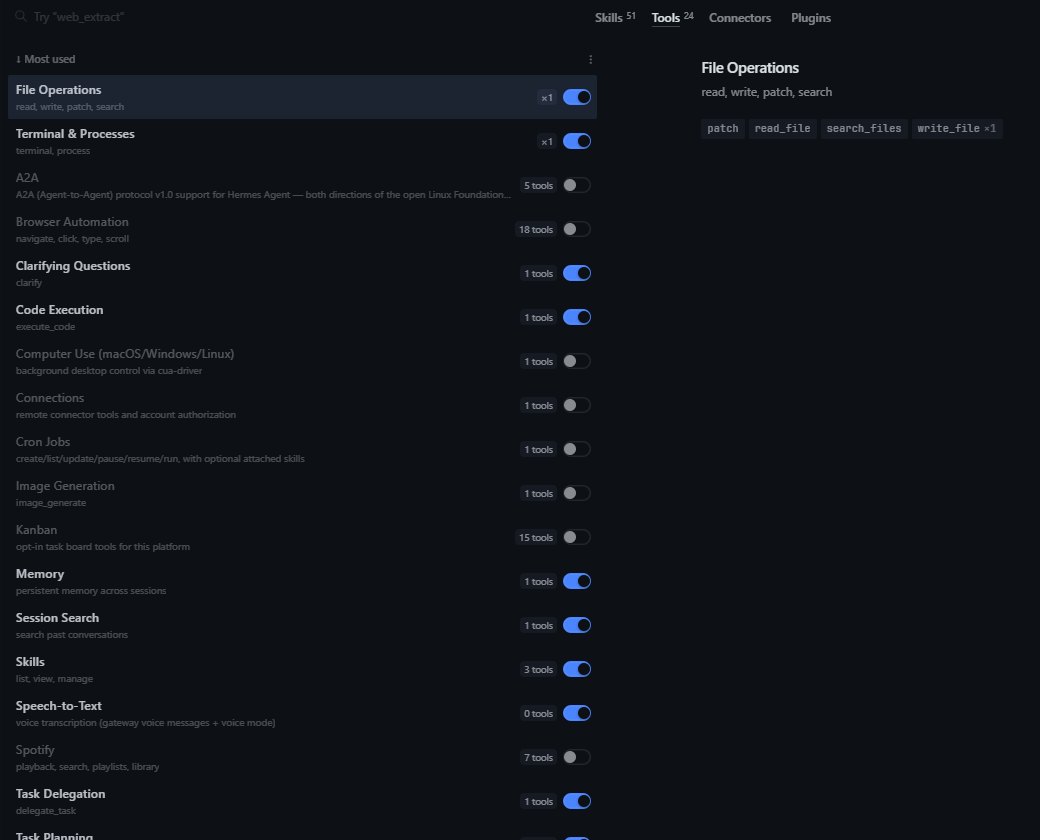
Capabilities → Tools 화면입니다. 도구를 하나씩 켜고 끕니다.
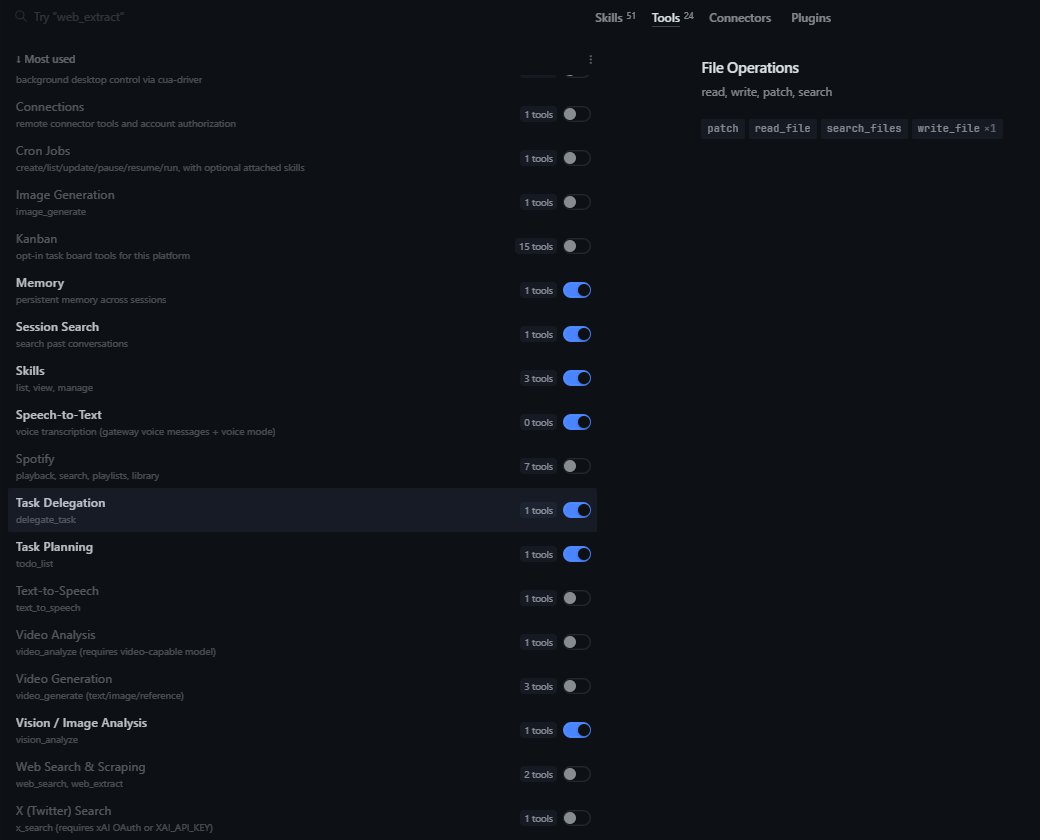
웹 검색(Web Search & Scraping)도 꺼 둔 상태입니다.
| 바꾼 것 | 설치한 그대로 | 바꾼 값 |
|---|---|---|
| 웹 검색, 브라우저 조작 | 켜짐 | 끔 |
| PC 화면 조작 (Computer Use) | 켜짐 | 끔 |
| 예약 작업 (Cron Jobs) | 켜짐 | 끔 |
| 그림 만들기, 음성 만들기, 외부 계정 연결 | 켜짐 | 끔 |
| 같은 실패를 되풀이할 때 | 경고만 | 강제로 멈춤 |
| 한 번에 할 수 있는 단계 | 500 | 60 |
| 기본 작업 폴더 | 실행한 위치 | 비어 있는 전용 폴더 |
이 표가 뜻하는 것: 도구는 아래 명령으로 끕니다. 이 글의 측정은 모두 이렇게 바꾼 상태에서 했습니다.
hermes tools disable web browser computer_use cronjob image_gen tts connections그래도 남는 구멍이 있습니다. 터미널 도구가 켜져 있으면 모델이 curl 같은 명령으로 인터넷 주소 하나를 가져올 수 있습니다. 모델에게 물어보니 스스로도 그렇게 답했습니다. 그리고 명령은 격리 없이 이 PC에서 그대로 실행됩니다. 민감한 자료를 다룰 때는 터미널까지 끄고 파일 도구만 쓰거나, 도커 같은 격리된 곳에서 명령을 실행하게 설정하는 방법이 있습니다. 격리 실행은 이번에 해 보지 않았습니다.
정리: 어느 쪽을 쓸까
| 이런 경우 | 맞는 방식 | 이유 |
|---|---|---|
| Hermes로 에이전트 일만 시킨다 | 자체 엔진 | 같은 속도에 일이 더 빨리 끝났고, 올리고 내리는 것을 신경 쓸 필요가 없습니다 |
| 긴 문서를 자주 읽힌다 | 자체 엔진 | 컨텍스트 221,184를 MTP가 켜진 채로 씁니다 |
| VRAM을 다른 일과 나눠 쓴다 | Unsloth 연결 (컨텍스트 직접 지정) | 65,536으로 두면 25.04GB였습니다. 자체 엔진은 29.03GB를 씁니다 |
| 모델과 설정을 직접 고르고 싶다 | Unsloth 연결 | 자체 엔진의 목록에는 모델이 네 개뿐입니다 |
| 디스크를 아끼고 싶다 | Unsloth 연결 | 자체 엔진은 같은 모델을 17.7GB 더 받습니다 |
이 표가 뜻하는 것: 에이전트로 쓴다면 자체 엔진이 나았습니다. Unsloth 연결을 쓴다면 컨텍스트를 꼭 직접 정해야 합니다. 기본값으로 붙이면 속도가 절반 조금 넘는 수준으로 떨어졌습니다.
- 글 만드는 속도만 보면 두 방식은 같습니다. 초당 약 120토큰입니다.
- 에이전트는 속도보다 프롬프트 캐시가 중요했습니다. 도구를 쓸 때마다 수천 토큰을 다시 읽으면 그 시간이 쌓입니다.
- 두 방식을 함께 켜면 VRAM이 모자랍니다. 29.03GB와 25.04GB라서 32GB에 같이 들어가지 않습니다.
- 도구는 쓸 것만 켭니다. 설치한 그대로는 웹과 화면 조작까지 켜져 있습니다.
로컬 AI가 처음이라면 로컬 AI 시작하기 가이드부터 보시면 됩니다. 로컬 모델에 도구를 붙였을 때 정답이 얼마나 달라지는지는 MCP 도구 테스트 글에, LM Studio와 Unsloth Studio의 차이는 프로그램을 바꾼 이유 글에 있습니다. 다른 그래픽카드의 속도는 GPU 체험에서 볼 수 있습니다.
이 글의 한계
- PC 한 대, 모델 하나로 잰 결과입니다. RTX 5090 32GB와 Qwen3.8 27B입니다. VRAM이 작은 그래픽카드에서는 Hermes가 고르는 설정이 달라집니다.
- 두 방식의 모델 파일이 다릅니다. 자체 엔진은 UD-Q4_K_M, Unsloth는 UD-Q4_K_XL입니다. 같은 파일로 맞춰서 재지 않았습니다. Hermes의 Add model file로 같은 파일을 연결하면 맞출 수 있지만 해 보지 않았습니다.
- 숫자는 명령줄, 영상은 GUI입니다. 같은 엔진과 설정을 쓰지만 GUI는 켜진 도구가 더 많아 컨텍스트를 더 씁니다. GUI 영상의 속도는 한 번씩 찍은 값입니다.
- 같은 질문을 되풀이해서 쟀습니다. 자체 엔진은 앞 회차의 지시문을 기억한 채로 시작했습니다. 처음 여는 대화에서는 그만큼 유리하지 않습니다.
- 과제가 쉽습니다. 파일 몇 개와 짧은 코드입니다. 큰 프로젝트를 맡기는 일이나 며칠씩 이어지는 일은 재지 않았습니다.
- Unsloth 쪽에서 프롬프트를 다시 읽는 까닭은 확인하지 못했습니다. 엔진 기록에 적힌 것까지만 봤습니다. Unsloth Studio의 판이 바뀌면 달라질 수 있습니다.
- 실행 허락을 어떤 때 묻는지 알아내지 못했습니다.
- Hermes Agent v0.21.6, Unsloth Studio 2026.10.3 기준입니다. 2026년 10월 9일에 쟀습니다.
자주 묻는 질문
Hermes Agent를 로컬 모델에 붙이려면 무엇이 필요한가요?
자체 엔진 방식은 Hermes만 있으면 됩니다. 설정의 Local Models에서 모델을 고르고 Download를 누르면 엔진과 모델을 받아 줍니다. Unsloth 연결 방식은 Unsloth Studio에 모델을 올려 두고 unsloth start hermes 명령을 실행합니다.
두 방식 가운데 어느 쪽이 더 빠른가요?
글을 만드는 속도는 같았습니다. 초당 120.8토큰과 121.7토큰이었습니다. 다만 도구를 쓰는 일은 자체 엔진이 더 빨리 끝났습니다. 과제 여섯 개의 합이 91.3초와 123.2초였습니다.
Unsloth Studio에 이미 모델이 있는데 Hermes가 또 받나요?
자체 엔진 방식에서는 그렇습니다. 이번에 모델 16.2GB, 사진 읽기용 파일 0.93GB, 엔진 0.55GB를 새로 받았습니다. 이미 있는 파일을 연결하는 Add model file 기능이 있지만 이번에는 써 보지 않았습니다.
VRAM은 얼마나 쓰나요?
자체 엔진은 컨텍스트 221,184에서 29.03GB를 썼습니다. Unsloth 연결은 컨텍스트 65,536에서 25.04GB, 기본 컨텍스트 169,216에서 29.68GB였습니다. 24GB 이하 그래픽카드에서는 재지 못했습니다.
로컬 모델로 쓰면 자료가 밖으로 나가지 않나요?
모델은 내 PC에서 돕니다. 하지만 Hermes의 웹 검색이나 브라우저 도구가 켜져 있으면 그쪽으로 내용이 나갈 수 있습니다. 설치한 그대로는 이 도구들이 켜져 있으니 먼저 꺼 두어야 합니다. 터미널 도구도 명령으로 인터넷에 나갈 수 있습니다.
출처
- Hermes Agent 공식 문서: Local models, Quickstart (2026년 10월 9일 확인)
- Unsloth 공식 문서: How to Run Local AI Models with Hermes Agent (2026년 10월 9일 확인)
- 엔진: llama.cpp 저장소
- 이 블로그의 Qwen3.8 27B 글: Unsloth Studio 설정 찾기, RTX 5090 테스트
댓글 0개