"Q4_K_M" 검색 결과 26건

[RTX 5090 32GB] MiniCPM-V 4.7 35B 한국어 사진 읽기 테스트, 0.6초 만에 답하지만 붓글씨와 손글씨는 틀렸다 RTX 5090 32GB

[RTX 5090 32GB] MiniCPM-V 4.7 35B 한국어 사진 읽기 테스트, 0.6초 만에 답하지만 붓글씨와 손글씨는 틀렸다

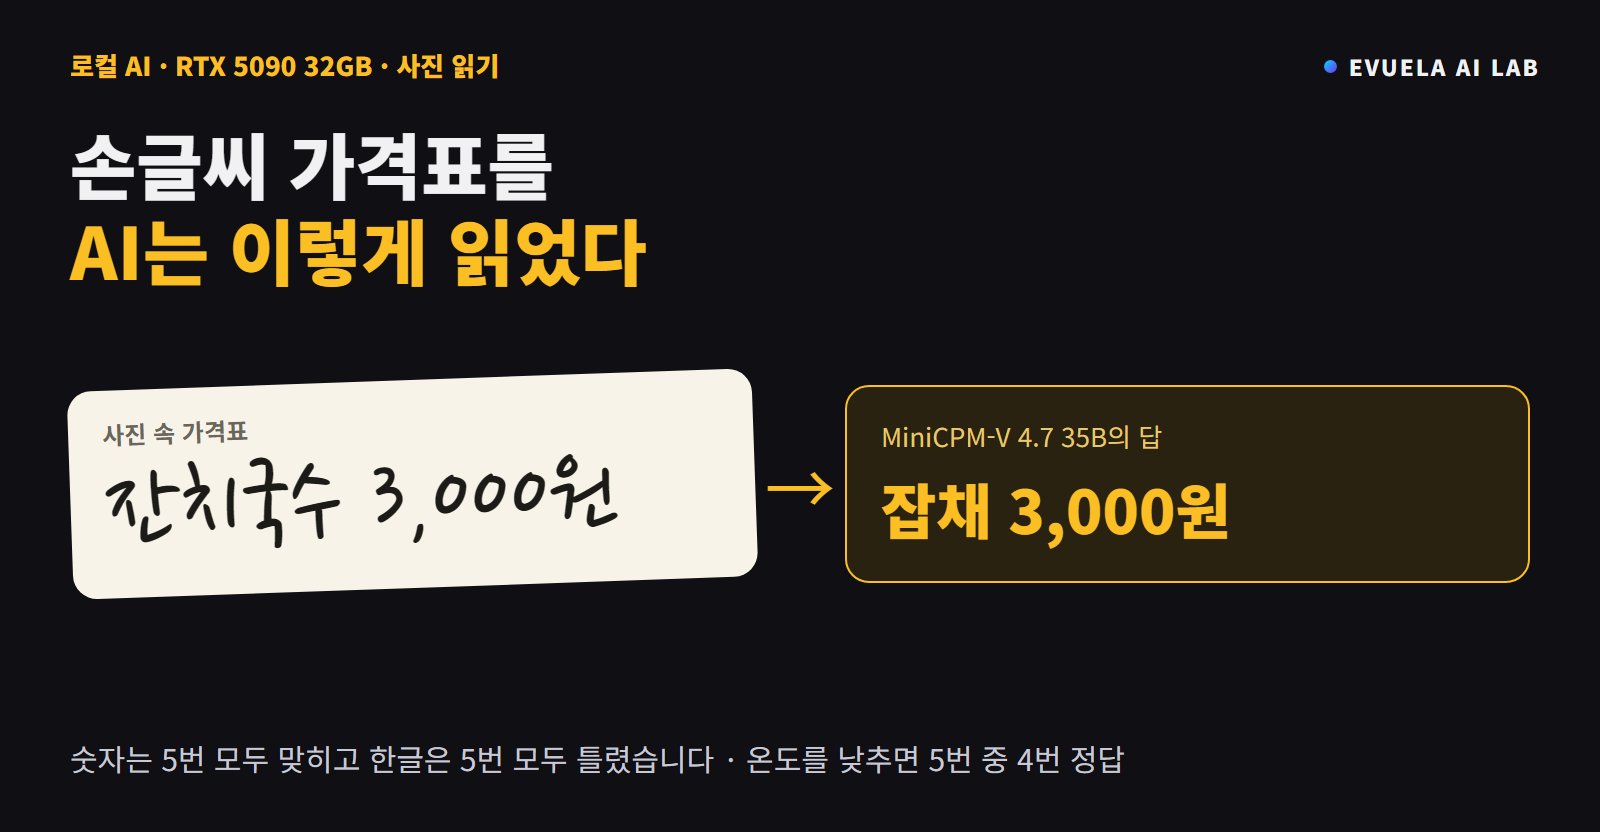
사진과 영상을 읽는 공개 모델 MiniCPM-V 4.7 35B A3B를 RTX 5090에서 쟀습니다. 속도는 초당 269토큰, 표와 화면 캡처는 70번 중 65번, Pixabay 실제 사진은 55번 중 29번 맞혔습니다. Unsloth Studio에서 사진이 안 된 이유와 한글 간판을 틀린 모습, 나아지는 설정도 적었습니다.

2026.10.13 187
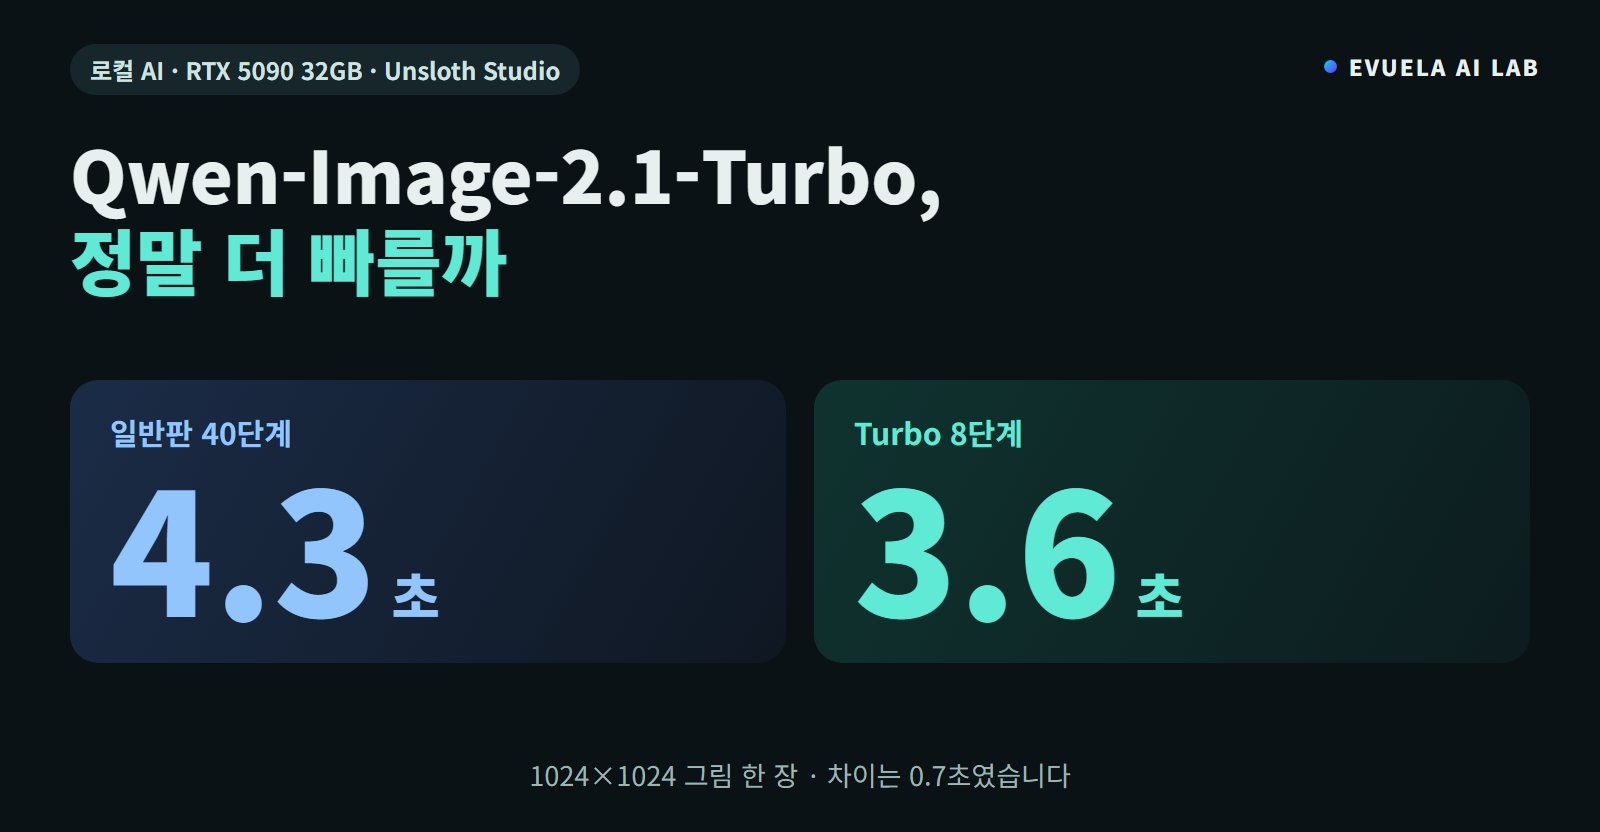
[RTX 5090 32GB] 로컬 AI 그림 모델 Qwen-Image-2.1-Turbo는 정말 더 빠를까, 8단계 3.6초와 40단계 4.3초였고 기본 설정으로는 일반판이 돌았다 RTX 5090 32GB

[RTX 5090 32GB] 로컬 AI 그림 모델 Qwen-Image-2.1-Turbo는 정말 더 빠를까, 8단계 3.6초와 40단계 4.3초였고 기본 설정으로는 일반판이 돌았다

Qwen-Image-2.1-Turbo를 RTX 5090의 Unsloth Studio에서 일반판과 비교했습니다. 1024×1024 한 장에 Turbo 8단계 3.6초, 일반판 40단계 4.3초였고 VRAM은 13.9GB와 21.3GB였습니다. 기본 설정으로 올리면 일반판 가중치로 그려지는 문제와 해결 방법도 적었습니다.

2026.10.10 193
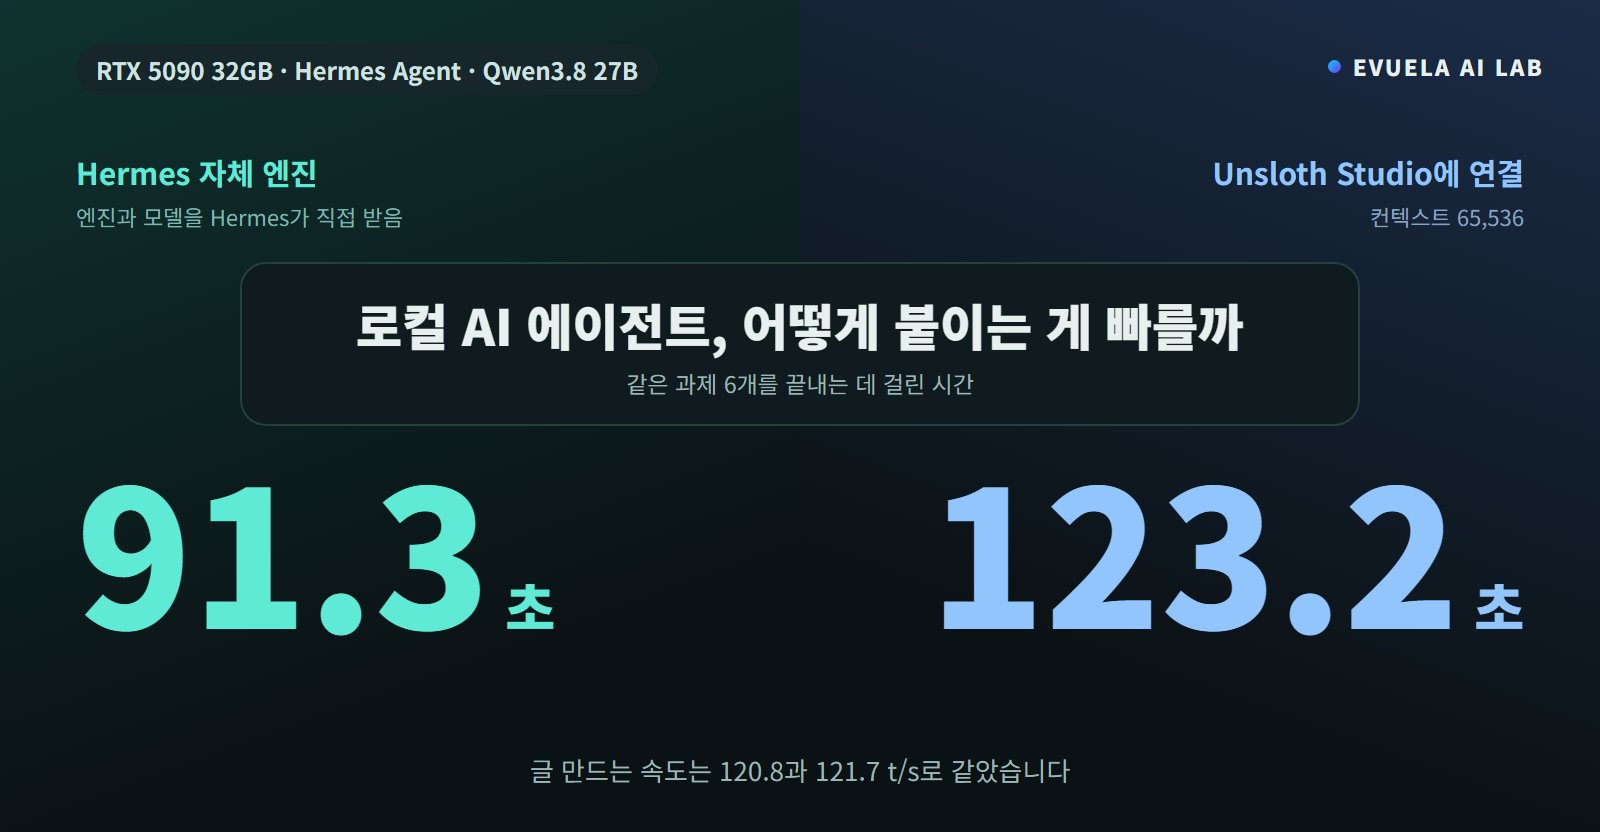
[RTX 5090 32GB] 로컬 AI 에이전트 Hermes Agent, Qwen3.8 27B는 직접 받는 쪽과 Unsloth 연결 중 무엇이 빠를까, 속도는 같았는데 끝나는 시간은 91초와 123초였다 RTX 5090 32GB

[RTX 5090 32GB] 로컬 AI 에이전트 Hermes Agent, Qwen3.8 27B는 직접 받는 쪽과 Unsloth 연결 중 무엇이 빠를까, 속도는 같았는데 끝나는 시간은 91초와 123초였다

Hermes Agent를 로컬 모델에 붙이는 두 방식을 RTX 5090에서 Qwen3.8 27B로 비교했습니다. 글 만드는 속도는 120.8과 121.7 t/s로 같았지만 과제 6개는 91.3초와 123.2초였습니다. 차이는 프롬프트를 다시 읽는 양에서 났습니다.

2026.10.09 122
로컬 AI 시작하기 6편, 로컬 AI가 느리거나 답이 안 나올 때 무엇을 볼까, Qwen3.8 27B는 설정 세 가지로 1.9토큰이 28.7토큰이 됐다 로컬 AI 시작하기

로컬 AI 시작하기 6편, 로컬 AI가 느리거나 답이 안 나올 때 무엇을 볼까, Qwen3.8 27B는 설정 세 가지로 1.9토큰이 28.7토큰이 됐다

로컬 AI가 느리거나 답이 안 나올 때 볼 것을 증상별로 정리했습니다. 같은 3비트 파일이 레이어를 모두 그래픽카드에 올리자 초당 1.9토큰에서 28.7토큰이 됐고, 답이 멈출 때는 컨텍스트를 늘리거나 생각 단계를 낮추면 풀렸습니다.

2026.10.09 34