개인 개발자 CCORE가 10월 말에 공개한 Qwen3.5-4B-3D-Coder는 Qwen3.5-4B를 다시 학습시켜, 질문 하나로 3D 장면(Three.js 웹 페이지)을 만들게 한 모델입니다. RTX 5060 Ti 16GB의 Unsloth Studio에서 장면 51개를 만들게 하고, 만든 페이지를 크롬으로 열어 하나씩 봤습니다. 결론부터 적으면 장면 하나에 1~3분이 걸렸고, 모델 카드에 실린 예시 질문은 12번 중 6번 제대로 그려졌지만, 새로 쓴 한국어 질문은 18번 중 1번이었습니다.
- 속도: 기본값(Auto)에서 생각 끔 800자 글 5번 평균 72.5t/s(초당 토큰, 66.7~74.2)입니다.
- VRAM: 기본값이 컨텍스트를 262,144로 잡아 모델이 13.7GB를 씁니다. 32,768로 줄이면 6.6GB입니다.
- 3D 장면: 생각 끔으로 51개를 만들어 '됨' 10개, '일부'(깨짐·오류) 14개, '실패'(빈 화면·멈춤) 27개였습니다. 질문을 모델 카드처럼 쓰느냐가 영어냐 한국어냐보다 크게 갈랐습니다.
- 생각(Thinking): Unsloth Studio는 이 모델을 생각 끔으로 띄웁니다. 생각을 켜면 장면 하나에 6~16분이 걸렸고 결과는 나아지지 않았습니다.
- 그 밖의 일: 산수는 생각을 켜야 10번 모두 맞혔고, 파이썬 8문제는 3번씩 풀어 24번 중 6~7번만 통과했습니다.
이 글의 숫자는 RTX 5060 Ti 16GB PC에서 2026년 11월 8일에 직접 잰 값입니다.
이 글의 결과를 20초로 요약한 영상입니다(소리 없음).
테스트 PC와 실행 프로그램
| 항목 | 내용 |
|---|---|
| 그래픽카드 | RTX 5060 Ti 16GB |
| GPU 드라이버 | 621.14 |
| CPU, 램 | Intel Core i5-9400F (6코어), DDR4 32GB |
| 운영체제 | Windows 11 Pro |
| 실행 프로그램 | Unsloth Studio 2026.11.3 (앱 v0.1.916-beta), llama.cpp b12176 |
| 장면 확인 | Google Chrome(헤드리스, GPU 사용)으로 만든 HTML을 열고 5.5초 뒤 화면을 찍음 |
프로그램 버전은 측정 스크립트가 측정을 시작할 때와 끝날 때 Unsloth Studio에 물어 결과 파일에 남긴 값입니다. 측정 도중 바뀌지 않았습니다.
테스트한 모델: Qwen3.5-4B-3D-Coder
| 항목 | 내용 |
|---|---|
| 만든 곳 | CCORE(개인 개발자). Qwen 공식 모델이 아님 |
| 바탕 모델 | Qwen/Qwen3.5-4B |
| 목적 | 코딩 전반, 특히 Three.js로 움직이는 3D 장면 만들기 |
| 학습 자료 | Three.js 장면 예시 4,146개(질문, 생각 과정, 완성한 HTML). MIT 라이선스로 공개 |
| 받은 파일 | Qwen3.5-4B-3D-Coder-Q8_0.gguf 4.48GB + 사진을 읽는 부품 mmproj 0.68GB (10월 27일 판) |
| 라이선스 | Apache-2.0 |
| 제작자가 권하는 설정 | temperature 0.6~0.8, top_p 0.90~0.95, top_k 20~40, repeat penalty 1.0 |
제작자는 아직 학습 중인 '미리보기'라고 적었습니다. 점수표는 없고, 최근 판에서 "한 번에 성공하는 비율이 크게 나아졌다"는 말과 장면 사진만 있습니다. 그래서 그 비율을 직접 재 보는 것이 이 글의 목적입니다.
Three.js는 웹 브라우저에서 3D 그림을 그리는 자바스크립트 라이브러리입니다. 이 모델에게 장면을 시키면 HTML 파일 하나를 통째로 써 줍니다. 그 파일을 브라우저로 열면 바로 장면이 나와야 합니다.
Unsloth Studio 기본값(Auto)은 어떻게 올렸나
| 항목 | Auto가 고른 값 |
|---|---|
| 컨텍스트 | 262,144 (모델 최대치) |
| GPU에 올린 레이어 | 전부 (-ngl -1 --fit off) |
| 생각 | 끔 (--reasoning off) |
| 속도 기능 | --spec-default |
| 모델 로드 시간 | 7.4초 (다시 올릴 때 5.4초) |
이 표가 뜻하는 것은, 파일이 작아서 Auto가 컨텍스트를 최대로 잡고, 생각은 꺼 둔 채 띄운다는 점입니다. 생각을 끈 채 띄운 것이 뒤에 나오는 산수 결과를 갈랐습니다.
VRAM은 얼마나 쓰나
| 컨텍스트 | 모델이 쓴 VRAM | 16GB에서 |
|---|---|---|
| 32,768 | 6.6GB | 원활 |
| 65,536 | 7.7GB | 원활 |
| 131,072 | 9.7GB | 원활 |
| 262,144 (기본값) | 13.7GB | 원활 |
이 표가 뜻하는 것은, 모델 최대 컨텍스트에서도 16GB에 다 들어간다는 점입니다. 32,768로 줄이면 8GB 그래픽카드에도 들어갈 크기입니다(8GB 카드에서는 재 보지 않았습니다). 값은 로드 전후 nvidia-smi의 차이이고, 사진 부품과 Unsloth가 잡는 동시 처리 4칸이 포함돼 있습니다.
허깅페이스 토론 게시판에는 Q8_0이 64K 컨텍스트에서 약 7.4GB가 필요하다는 계산표가 있습니다. 실제로 잰 값은 아니고 계산입니다. 65,536에서 잰 7.7GB와 비슷합니다.
3D 장면은 얼마나 제대로 나오나
질문 하나에 HTML 파일 하나를 만들게 하고, 고치지 않고 그대로 열었습니다. 질문은 네 묶음입니다.
| 묶음 | 질문 |
|---|---|
| 모델 카드의 예시 질문(영어) | 코끼리 보호 구역, 바위섬 위 용 기수 둥지, 운하 갑문, 관제탑 |
| 새로 쓴 한국어 질문 | 눈 내린 한옥 마을, 책상 위 게임용 PC, 지하철 승강장, 태양계, 남산 케이블카, 복셀 등대 |
| 같은 질문을 영어로 | 위 한국어 질문 6개를 영어로 옮긴 것 |
| 사진을 보고 만들기 | 모래시계 사진 + "create this scene using voxels 3d"(모델 카드 예시 문장) |
모두 생각 끔, 모델 카드가 권하는 설정(temperature 0.6, top_p 0.95, top_k 20)과 시스템 프롬프트로 질문마다 3번씩 만들었습니다. 판정은 세 단계입니다. 오류 없이 질문한 장면이 알아볼 수 있게 그려지면 '됨', 그려지지만 깨지거나 오류가 있거나 중요한 부분이 빠지면 '일부', 빈 화면이나 검은 화면, 오류로 멈추면 '실패'입니다. 오류는 크롬이 낸 것을 그대로 모았고, 그림은 화면을 직접 보고 판정했습니다.
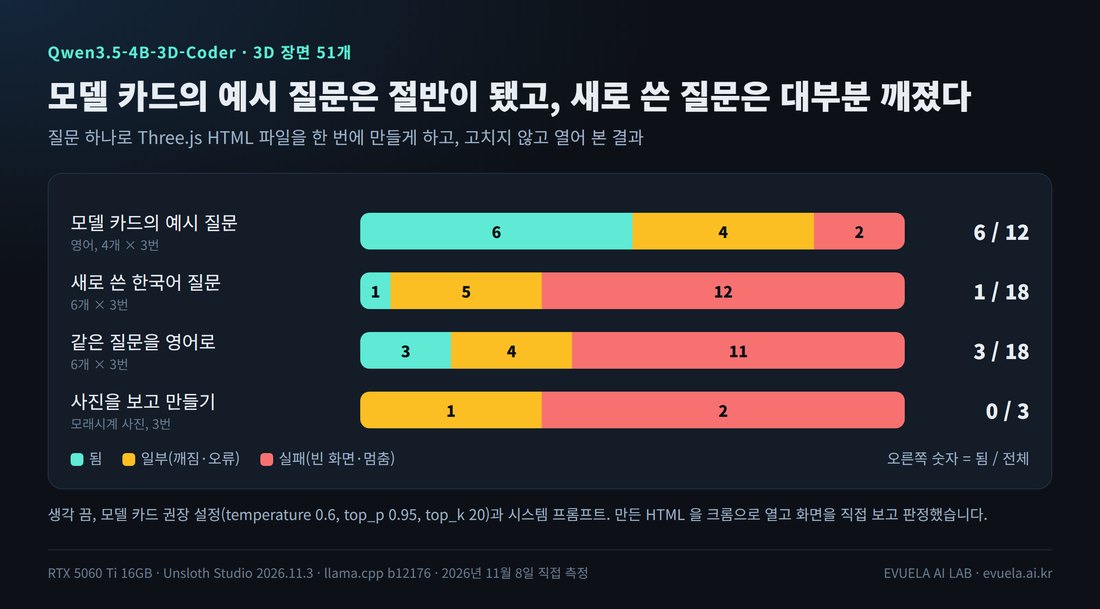
질문 묶음별 결과입니다. 오른쪽 숫자는 '됨'의 개수입니다.
이 그림이 뜻하는 것은, 모델 카드에 실린 질문은 절반이 제대로 나왔지만 처음 쓰는 질문은 대부분 깨졌다는 점입니다. 한국어 질문을 영어로 옮기면 '됨'이 1개에서 3개로 늘었습니다. 언어보다는 질문의 형식이 더 크게 갈랐습니다. 모델 카드의 질문은 장면을 자세히 묘사하고, 끝에 "보이는 정육면체 블록으로 만든 복셀 모델로" 같은 문단이 붙어 있습니다. 학습 자료의 질문도 이런 모양입니다.
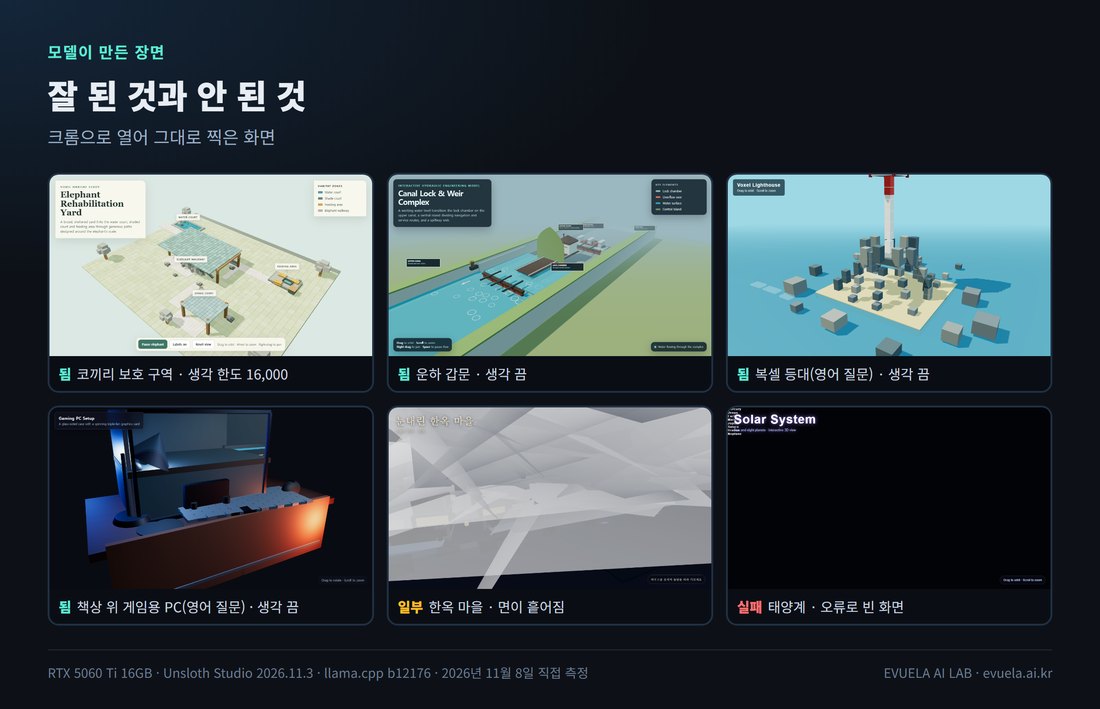
잘 된 장면과 안 된 장면입니다. 크롬으로 열어 그대로 찍었습니다.
잘 된 장면을 돌려 본 영상입니다(소리 없음). 장면마다 만드는 데 걸린 시간을 적었습니다.
실패는 대부분 자바스크립트 오류였습니다. 같은 이름의 변수를 두 번 만들거나(Identifier 'planetLights' has already been declared), 만들지 않은 변수를 쓰거나(renderer is not defined), 괄호가 맞지 않았습니다. 제작자도 모델 카드에 "지금까지 본 버그는 주로 변수 이름이 겹치는 것"이라고 적었습니다. 오류가 한 줄만 나도 장면 전체가 멈춥니다.
| 질문 (생각 끔, 3번씩) | 됨 | 일부 | 실패 | 평균 시간 |
|---|---|---|---|---|
| 코끼리 보호 구역 | 3 | 0 | 0 | 1분 58초 |
| 바위섬 위 용 기수 둥지 | 0 | 1 | 2 | 2분 35초 |
| 운하 갑문 | 2 | 1 | 0 | 2분 16초 |
| 관제탑 | 1 | 2 | 0 | 1분 37초 |
| 한옥 마을 (한국어 / 영어) | 0 / 0 | 1 / 0 | 2 / 3 | 1분 24초 / 1분 34초 |
| 책상 위 게임용 PC | 0 / 2 | 0 / 0 | 3 / 1 | 1분 32초 / 2분 1초 |
| 지하철 승강장 | 0 / 0 | 1 / 1 | 2 / 2 | 1분 40초 / 1분 48초 |
| 태양계 | 0 / 0 | 0 / 1 | 3 / 2 | 51초 / 51초 |
| 남산 케이블카 | 1 / 0 | 2 / 2 | 0 / 1 | 1분 33초 / 1분 38초 |
| 복셀 등대 | 0 / 1 | 1 / 0 | 2 / 2 | 1분 14초 / 1분 15초 |
| 사진 보고 만들기(모래시계) | 0 | 1 | 2 | 1분 52초 |
이 표가 뜻하는 것은, 같은 질문도 3번 중 결과가 달라서 한 번 실패했다고 버리기는 이르다는 점입니다. 코끼리 보호 구역만 3번 모두 됐습니다. 태양계는 6번 모두 제대로 나오지 않았습니다. 사진을 보고 만든 장면은 모래시계 두 개와 나무 책상을 알아봤지만, 모양은 상자였습니다.
생각을 켜면 나아지나요?
학습 자료에는 생각 과정이 들어 있습니다. 100개를 뽑아 보니 생각이 중간값 약 5만 2천 자, 답(코드)이 약 2만 9천 자였습니다. 그래서 생각을 켜면 나아질지 시험했습니다. 시간이 오래 걸려 질문 4개를 1번씩만 쟀습니다.
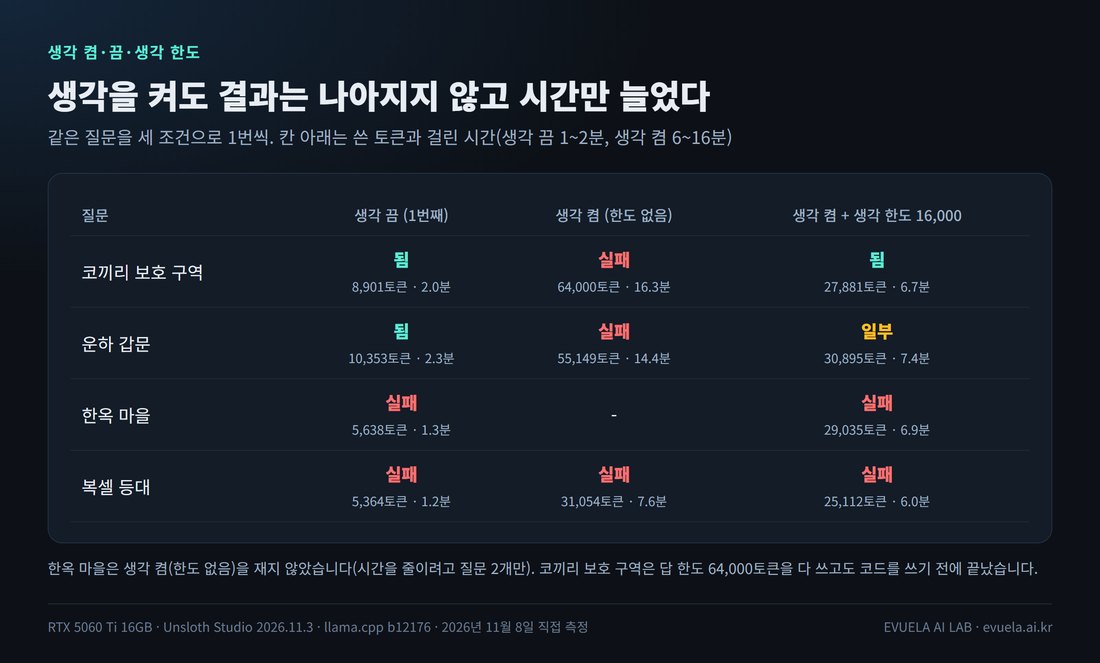
같은 질문을 생각 끔, 생각 켬, 생각 한도를 건 생각 켬으로 1번씩 만든 결과입니다.
이 그림이 뜻하는 것은, 생각을 켜도 결과가 나아지지 않았고 시간만 3~8배 늘었다는 점입니다. 코끼리 보호 구역은 생각을 켜자 답 한도 64,000토큰을 모두 생각에 쓰고 코드를 쓰기 전에 끝났습니다. 생각 글이 23만 자였고, 끝부분에서는 같은 문장 두 줄이 38번씩 되풀이됐습니다. 운하 갑문은 14분 만에 코드를 냈지만 문법 오류로 열리지 않았습니다.
생각 한도(reasoning_budget, 생각에 쓸 수 있는 토큰 수의 상한)를 16,000으로 걸면 생각을 거기서 끊고 코드를 씁니다. 장면 하나가 6~7분으로 줄었고, 코끼리 보호 구역은 4개 중 가장 잘 그려졌습니다. 그래도 4개 중 됨 1개, 일부 1개로, 생각 끔(됨 2개)보다 낫다고 하기 어렵습니다.
기본 측정: 속도, 산수, 코딩
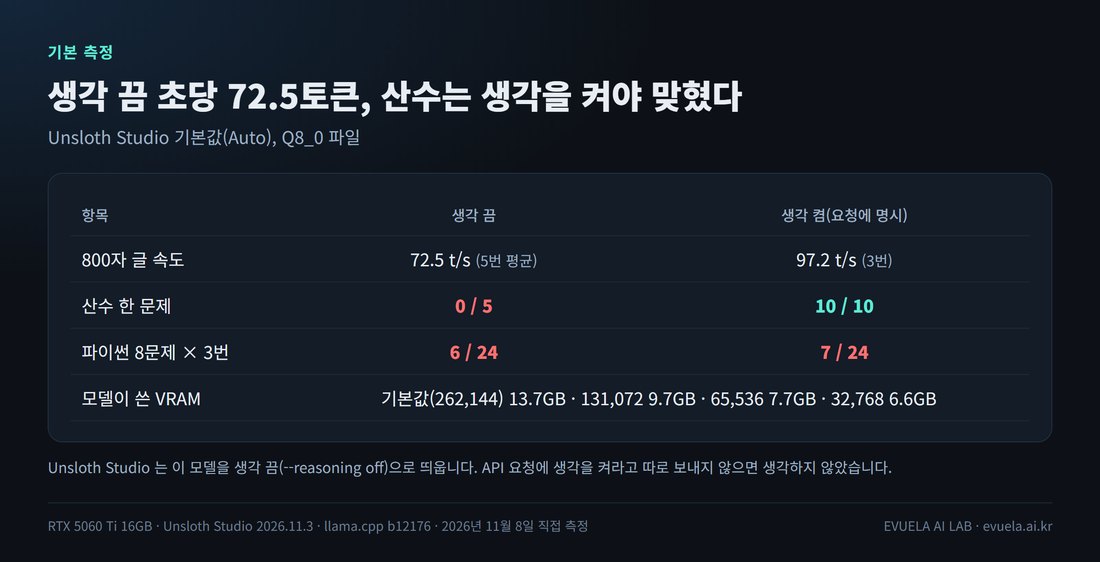
다른 모델과 같은 질문으로 잰 기본 측정입니다.
산수는 "사과 24개짜리 3상자에서 19개를 먹고 5명이 나누면" 문제입니다(정답 한 사람당 10개, 남는 것 3개). 기본값에서는 5번 모두 틀렸습니다. API로 생각을 끄는 값을 보내지 않고 물어도(다른 모델에서는 이것이 '생각 켬'입니다) 생각을 하지 않아 역시 5번 모두 틀렸습니다. 요청에 enable_thinking: true를 넣거나 reasoning_effort: "medium"을 넣으면 생각을 했고, 10번 모두 맞혔습니다.
생각을 켠 800자 글이 더 빠른 것은 답이 길어서입니다(생각 포함 2,700~4,900토큰). 속도 기능(--spec-default)은 긴 답에서 더 잘 듣습니다.
파이썬 8문제는 3D가 아닌 일반 코딩입니다. 겹치는 구간 합치기, 로마 숫자, 많이 나온 낱말 세기는 매번 풀었지만 수식 계산기, 다음 영업일, 한글 숫자를 정수로 바꾸기는 한 번도 풀지 못했습니다. 같은 PC에서 잰 Gemma 4 E4B는 같은 문제에서 24번 중 18번이었습니다(126번 글).
긴 글, 전력, 한국어 답
| 항목 | 결과 |
|---|---|
| 긴 글 요약 (3,000자 / 15,000자 / 100,000자) | 2.1초 / 2.9초 / 11.4초, 세 문장으로 요약함 |
| 대화가 길어지면 (앞 대화 약 1천 / 8천 / 2만 토큰) | 72.8 / 70.7 / 74.5 t/s, 첫 토큰까지 0.33 / 1.34 / 3.42초 |
| 약 1만 토큰 글 속 정보 찾기 (10·30·50·70·90% 위치) | 5곳 중 3곳(앞쪽 10·30·50%). 숨기지 않은 글에는 '없음'이라고 답함 |
| 전력·온도 (800자 글을 쓰는 동안) | 평균 약 105W, 최고 57°C, 토큰 하나에 1.45J (쉴 때 약 12W) |
| 사진 설명 (모래시계 사진) | 모래시계 두 개, 나무 책상, 뒤의 장비까지 맞게 설명, 12.1초 |
| 없는 소설 『푸른 등대의 겨울』 | 없다고 하지 않고 줄거리를 지어냄 |
| 한국어 답에 섞인 외국 글자 | 14개 답 중 4개에 한자(예: 相依为命, 在这种情况下) |
이 표가 뜻하는 것은, 긴 글을 읽는 일은 빠르지만 글 뒤쪽에 있는 정보는 놓친다는 점입니다. 한국어 글쓰기에는 한자가 섞이고 없는 사실을 지어내는 일이 있어, 일반 대화 모델로 쓰기에는 맞지 않습니다.
답이 안 나오거나 느릴 때 무엇을 바꾸면 되나요?
| 겪은 일 | 까닭 | 바꿀 설정 | 바꾸기 전 → 바꾼 뒤 |
|---|---|---|---|
| 장면이 빈 화면으로 나온다 | 코드에 오류가 한 줄이라도 있으면 멈춤. 같은 질문도 3번 중 결과가 다름 | 같은 질문으로 다시 만들기. 질문을 모델 카드처럼 자세히 쓰고 끝에 복셀 문단을 붙이기 | 새로 쓴 한국어 질문 1/18 → 모델 카드 예시 6/12 (같은 질문을 다시 쓴 시험은 아님) |
| 한국어로 물으면 잘 안 된다 | 학습 자료가 영어 | 질문을 영어로 | 1/18 → 3/18 |
| 산수를 틀린다, 생각을 켰는데 생각하지 않는다 | Unsloth가 이 모델을 생각 끔으로 띄움 | 요청에 enable_thinking: true 또는 reasoning_effort | 산수 0/5 → 10/10 |
| 생각을 켜면 장면이 끝나지 않는다 | 생각을 수만 토큰씩 씀 | 모델을 올릴 때 생각 한도(reasoning_budget) 16,000, 또는 생각 끔 | 14~16분·코드 없음 → 6~7분·코드 나옴 |
| VRAM이 모자라다 | Auto가 컨텍스트를 262,144로 잡음 | 컨텍스트를 32,768로 | 13.7GB → 6.6GB |
이 표가 뜻하는 것은, 3D 장면에는 생각을 끄고 여러 번 만들어 보는 쪽이 시간 대비 나았다는 점입니다. 오류 문구를 모델에게 다시 보여 주고 고치게 하는 방법은 이 글에서 시험하지 않았습니다.
이 글의 한계
- 장면 판정은 크롬 화면을 보고 사람이 했습니다. '됨'과 '일부'의 경계에는 판단이 들어갑니다. 장면마다 판정과 이유는 결과 파일에 남겼습니다.
- 생각 켬과 생각 한도는 시간이 오래 걸려 질문 4개(생각 켬 한도 없음은 3개)를 1번씩만 쟀습니다.
- Q8_0 파일만 쟀습니다. Q4_K_M(2.71GB)과 바탕 모델 Qwen3.5-4B는 재지 않아, 다시 학습시킨 효과가 얼마인지는 이 글로 알 수 없습니다.
- 오류를 보여 주고 고치게 하는 대화, 마우스로 돌리는 조작이 제대로 되는지는 시험하지 않았습니다. 영상의 회전은 헤드리스 크롬에서 마우스 끌기를 흉내 낸 것입니다.
- 다른 사람이 이 모델을 그래픽카드에서 잰 값은 찾지 못했습니다. 기준 날짜는 2026년 11월 8일입니다.
정리
- RTX 5060 Ti 16GB에서 기본값 72.5t/s, 최대 컨텍스트에서도 VRAM 13.7GB로 다 들어갑니다.
- 3D 장면은 생각 끔으로 하나에 1~3분입니다. 모델 카드의 예시 질문은 절반이 제대로 나왔고, 새로 쓴 질문은 대부분 깨졌습니다.
- 생각을 켜면 장면 하나에 6~16분이 걸리고 결과는 나아지지 않았습니다.
- 일반 코딩과 한국어 글은 약합니다. 3D 장면 전용 미리보기로 보는 것이 맞습니다.
같은 PC에서 잰 다른 모델은 LFM2.5-24B-A2B, Gemma 4 E2B, gpt-oss 20B 글에 있습니다. 내 그래픽카드에서 얼마나 빠를지는 GPU 체험에서 볼 수 있습니다.
자주 묻는 질문
8GB 그래픽카드에서도 돌릴 수 있나요?
이 PC에서 컨텍스트 32,768로 올리면 모델이 6.6GB를 썼습니다. 8GB 카드에 들어갈 크기지만, 8GB 카드에서 직접 돌려 보지는 않았습니다. Q4_K_M(2.71GB)을 쓰면 더 작아집니다.
한국어로 질문해도 되나요?
됩니다. 다만 새로 쓴 한국어 질문은 18번 중 1번만 제대로 그려졌고, 같은 질문을 영어로 바꾸면 3번이었습니다. 모델 카드의 예시처럼 장면을 자세히 묘사하는 편이 언어를 바꾸는 것보다 효과가 컸습니다.
만든 장면이 빈 화면이면 어떻게 하나요?
브라우저 개발자 도구(F12)의 콘솔에 오류가 나옵니다. 이 시험에서는 대부분 변수 이름이 겹치거나 없는 변수를 쓴 오류였습니다. 같은 질문으로 다시 만들면 다른 결과가 나옵니다. 코끼리 보호 구역은 3번 모두 됐지만 태양계는 6번 모두 안 됐습니다.
출처
- 모델 카드: https://huggingface.co/ccore/Qwen3.5-4B-3D-Coder
- 학습 자료: https://huggingface.co/datasets/ccore/ThreeJS-3D-Scenes
- 허깅페이스 토론 #8(메모리 계산표), #11(Q8 파일 되풀이 보고): https://huggingface.co/ccore/Qwen3.5-4B-3D-Coder/discussions
- 측정 스크립트와 결과: 이 블로그 저장소의 docs/benchmarks/qwen35_3dcoder_5060ti
댓글 0개