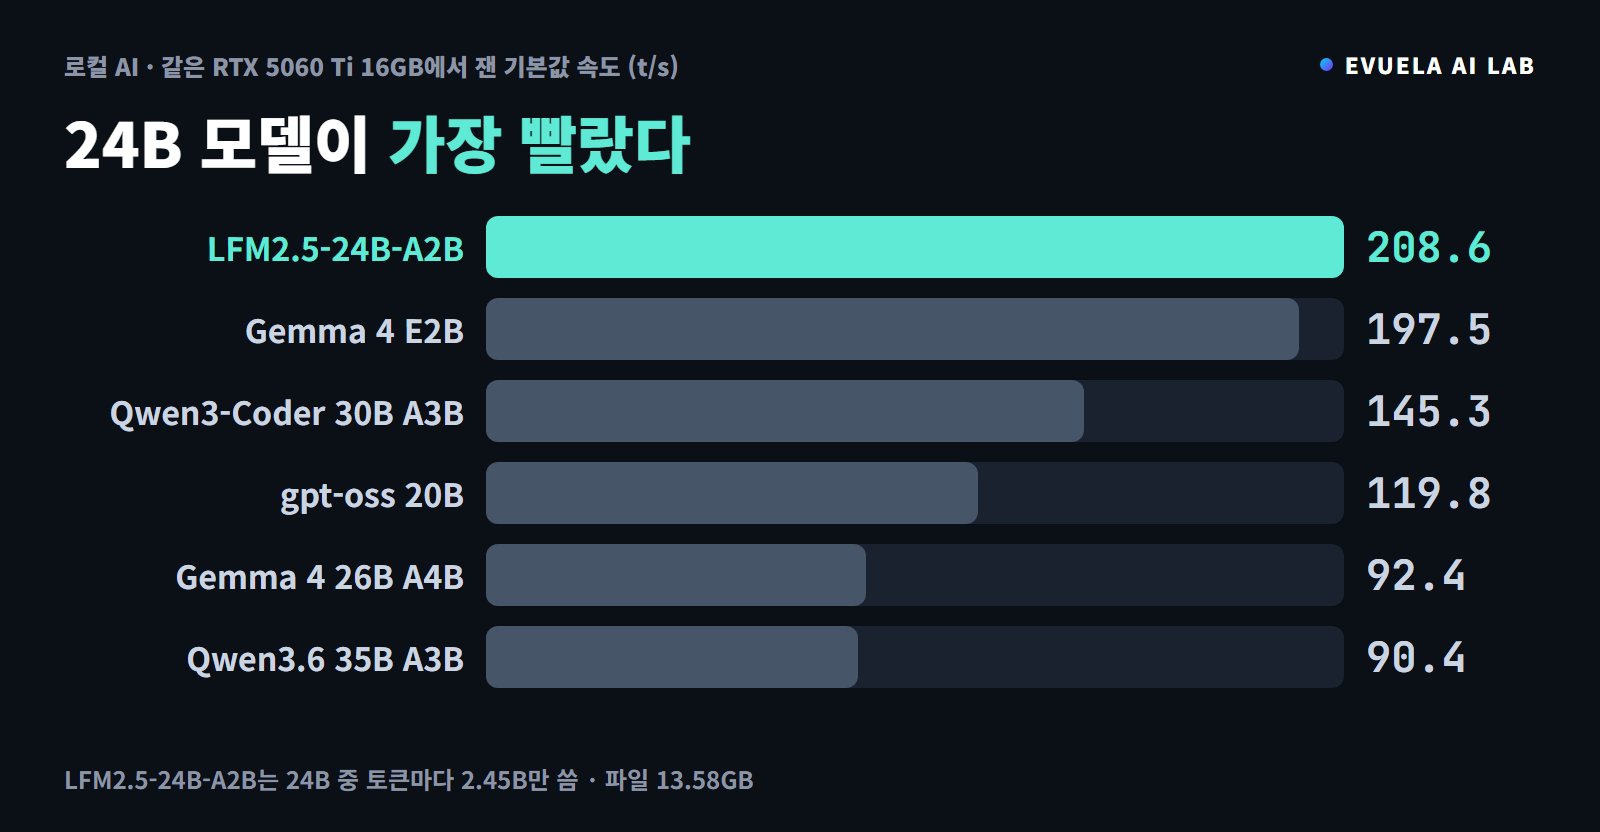
Liquid AI가 10월 둘째 주에 공개한 LFM2.5-24B-A2B는 24B(240억 파라미터) 모델이지만, 글자 하나를 만들 때마다 그중 2.45B만 씁니다. RTX 5060 Ti 16GB의 Unsloth Studio에서 기본값으로 돌려 봤습니다. 결론부터 적으면 초당 208.6토큰으로, 이 PC에서 잰 모델 가운데 가장 빨랐습니다. 2.44GB짜리 Gemma 4 E2B(197.5토큰)보다도 빠릅니다.
- 속도: 기본값(Auto)에서 5번 평균 208.6t/s(200.3~230.7)입니다.
- VRAM: 13.58GB 파일을 올리면 모델이 13.6GB를 씁니다. 16GB에 거의 꽉 찹니다.
- 긴 글: 100,000자(47,921토큰) 글을 세 문장으로 요약하는 데 20.7초였습니다. 문서 속에 숨긴 문장도 5번 모두 찾았습니다.
- 생각을 끌 수 없습니다: 항상 생각한 뒤 답합니다. 답 한도를 짧게 주면 생각만 하다 끝나서, 한도를 넉넉히 줘야 합니다.
- 코딩: 파이썬 8문제를 3번씩, 한도 8,000토큰에서 24번 중 18번 통과했습니다.
- 도구 호출: 도구 하나를 부르는 한국어 부탁은 36번 중 33번 맞혔지만, 도구 둘을 한 번에 불러야 하는 부탁은 12번 중 1번이었습니다.
이 글의 숫자는 RTX 5060 Ti 16GB PC에서 2026년 10월 20~21일에 직접 잰 값입니다.
이 글의 결과를 20초로 요약한 영상입니다(소리 없음).
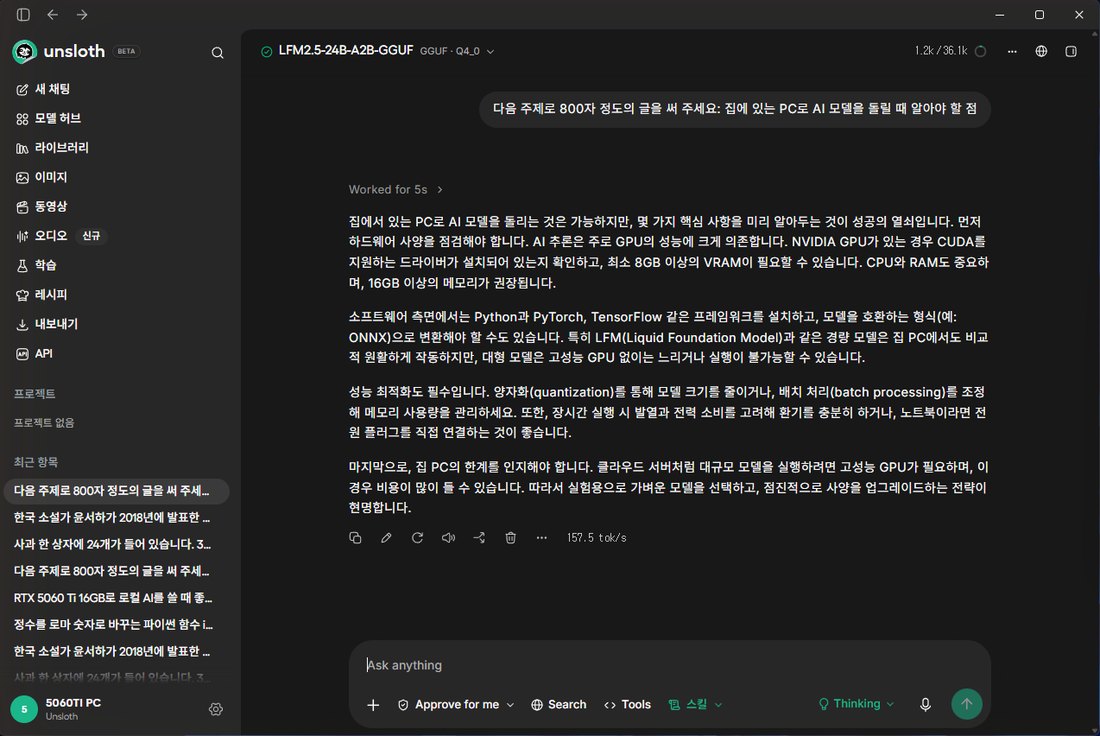
앱 화면에서 800자 글을 시킨 결과입니다. 5초 생각하고 답했습니다.
테스트 PC와 실행 프로그램
| 항목 | 내용 |
|---|---|
| 그래픽카드 | RTX 5060 Ti 16GB |
| GPU 드라이버 | 617.42 |
| CPU, 램 | Intel Core i5-9400F (6코어), DDR4 32GB |
| 운영체제 | Windows 11 Pro |
| 실행 프로그램 | Unsloth Studio 2026.10.7 (앱 v0.1.909-beta), llama.cpp b11734 |
| 측정 방법 | Unsloth Studio의 API로 같은 질문을 반복해 보내고 기록. 화면 캡처와 영상은 앱 화면에서 따로 찍음 |
프로그램 버전은 측정 스크립트가 측정을 시작할 때와 끝날 때 Unsloth Studio에 물어 결과 파일에 남긴 값입니다. 이 PC에서 잰 다른 모델(10월 4~11일)은 Unsloth Studio 이전 버전에서 잰 것이라, 아래 비교에는 프로그램 버전 차이가 섞여 있습니다.
테스트한 모델: LFM2.5-24B-A2B
| 항목 | 내용 |
|---|---|
| 만든 곳 | Liquid AI |
| 파라미터 | 전체 24.0B, 글자 하나에 쓰는 것 2.45B |
| 구조 | 40층(짧은 합성곱 30층 + 어텐션 10층), 층마다 전문가 64개 중 4개를 고르는 MoE |
| 최대 컨텍스트 | 131,072 |
| 지원 언어 | 16개, 한국어 포함 |
| 생각 기능 | 항상 켜짐. 끌 수 없음 |
| 받은 파일 | LFM2.5-24B-A2B-QAD-Q4_0.gguf 13.58GB |
| 라이선스 | LFM Open License v1.0 (연 매출 1천만 달러 이상인 회사의 상업적 사용은 허락하지 않음) |
MoE는 모델 안에 작은 전문가 여러 개를 두고 글자마다 몇 개만 골라 쓰는 구조입니다. 모델 전체는 VRAM에 올려야 하지만, 계산은 고른 전문가만큼만 합니다. 그래서 24B 모델이 3B 모델처럼 빠를 수 있습니다.
받은 파일은 QAD-Q4_0입니다. 4비트로 줄이면서 생기는 손실을 줄이도록 따로 학습시킨 판이라고 모델 카드에 적혀 있습니다. 4비트 파일 가운데 가장 작아서(13.58GB) 이것을 골랐습니다. 같은 저장소의 Q4_K_M은 14.53GB입니다.
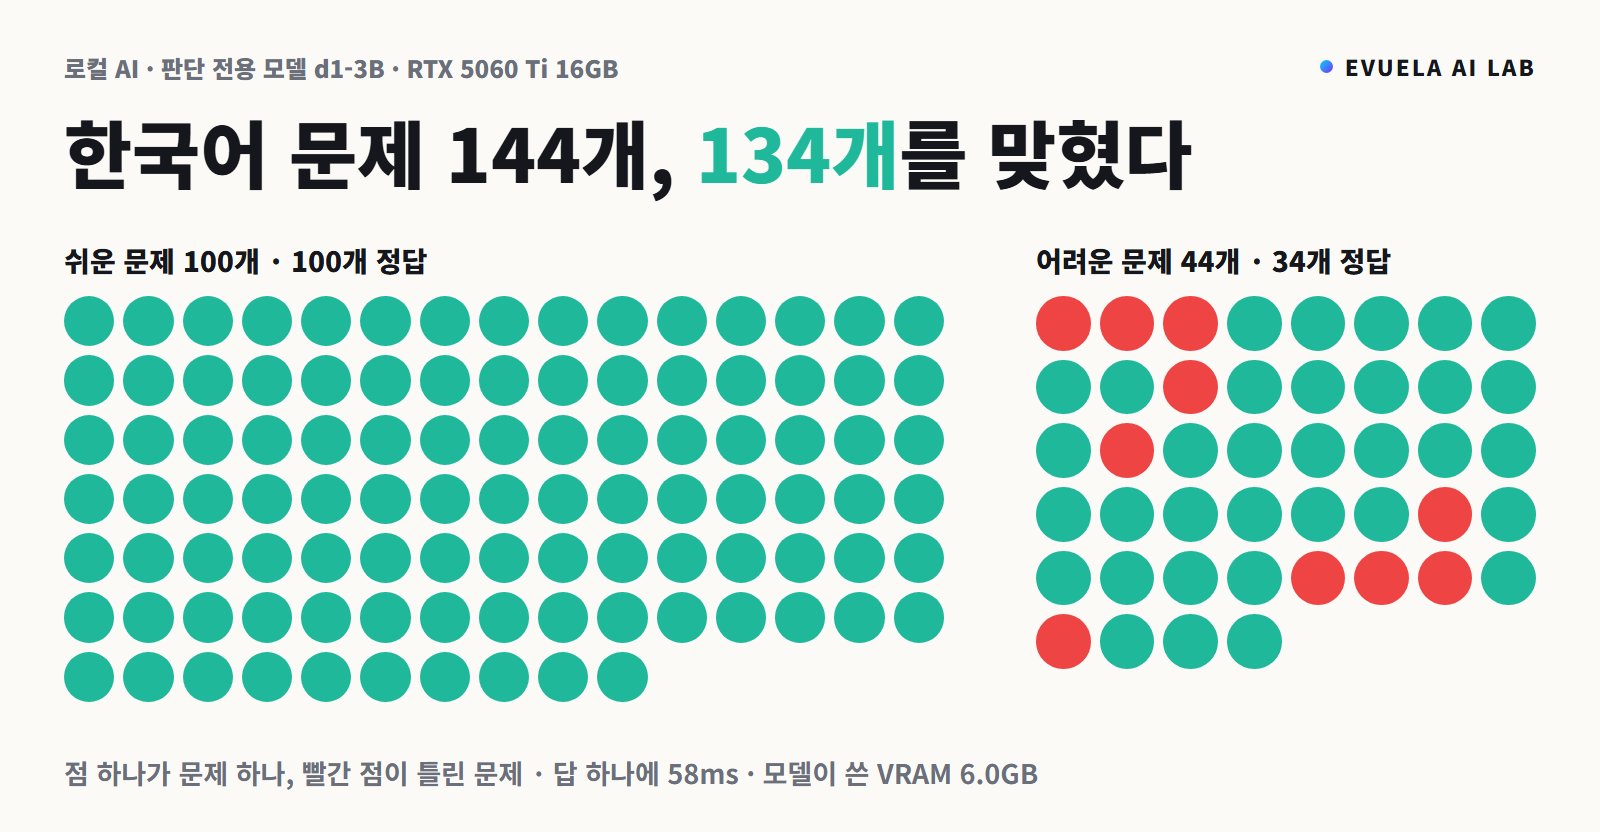
같은 회사의 판단 전용 모델 d1-3B는 지난 글에서 이 PC로 쟀습니다. 라이선스가 같습니다.
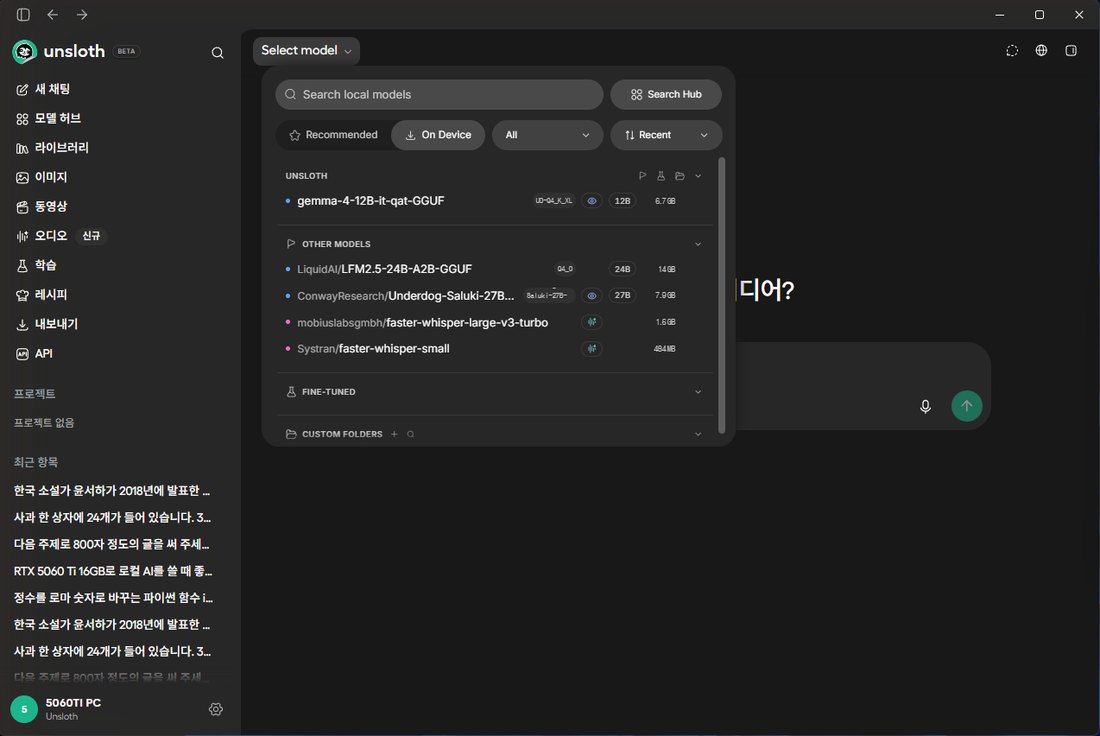
받은 파일이 Unsloth Studio의 모델 목록에 나온 화면입니다.
Unsloth Studio 기본값(Auto)은 어떻게 올렸나
| 항목 | Auto가 고른 값 |
|---|---|
| 컨텍스트 | 37,376~38,400 (앱 화면에서 올리면 36,100쯤) |
| GPU에 올린 레이어 | 전부 (-ngl -1 --fit off) |
| 속도 기능 | --spec-default |
| 모델을 올리는 시간 | 9.4초 (다시 올릴 때 9.1초) |
이 표가 뜻하는 것은, 파일이 커서 기본값이 컨텍스트를 약 37,000으로 작게 잡는다는 점입니다. 모델 최대치(131,072)의 3분의 1이 안 됩니다. 남는 VRAM에 맞춰 잡은 값입니다.
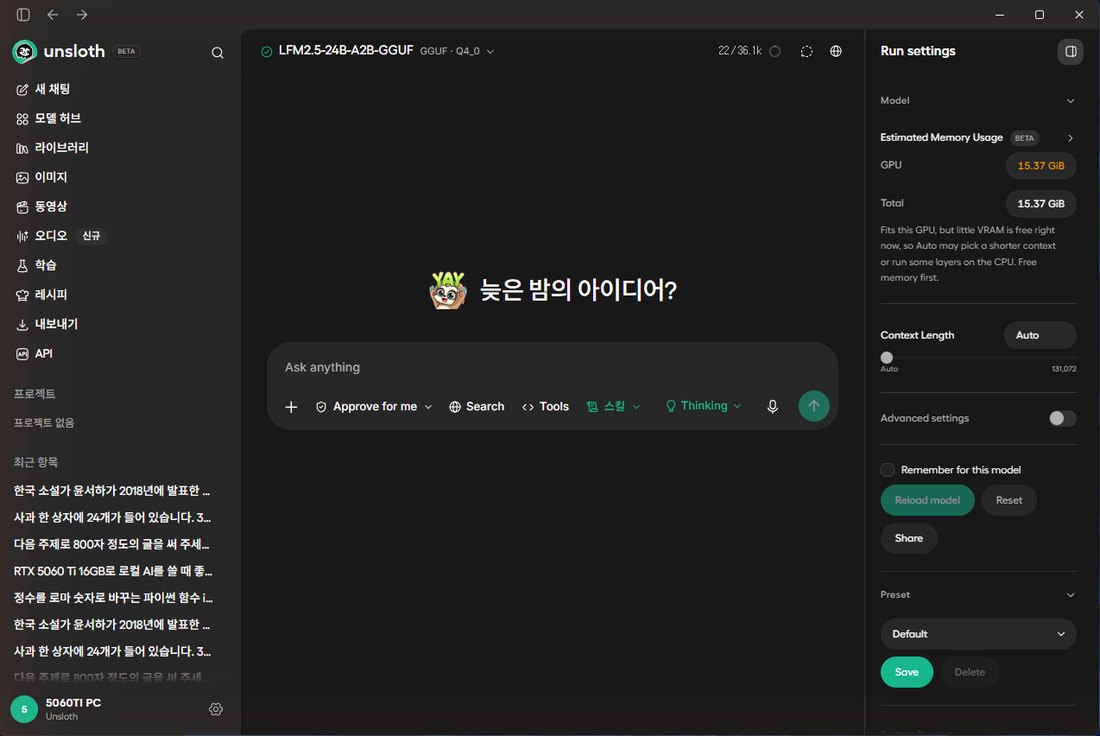
실행 설정 창입니다. 예상 메모리가 15.37GB로 16GB에 거의 찹니다.
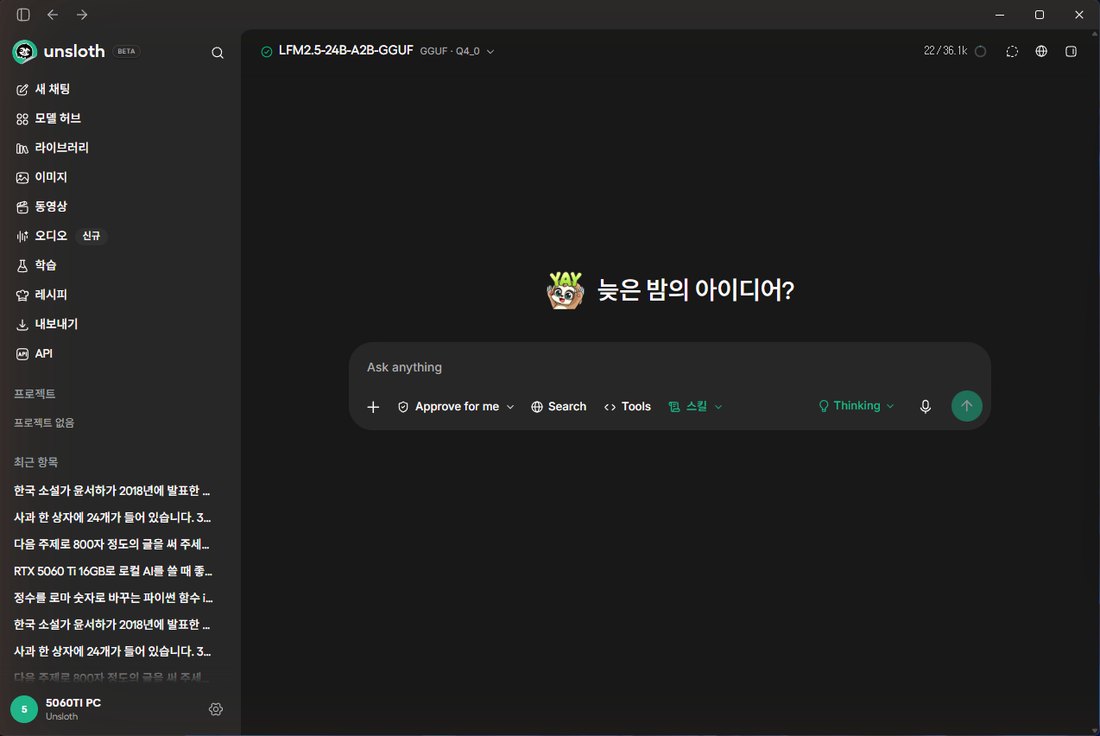
올라간 뒤의 화면입니다.
생성 속도: 기본값에서 평균 208.6t/s
"집에 있는 PC로 AI 모델을 돌릴 때 알아야 할 점"을 800자쯤으로 써 달라고 5번 시켰습니다. 생각을 끄라는 요청(enable_thinking: false)을 함께 보냈지만, 이 모델은 그래도 생각을 합니다.
| 회차 | 속도 | 쓴 토큰 (그중 생각) | 답 글자 수 | 걸린 시간 |
|---|---|---|---|---|
| 1 | 203.7t/s | 2,820 (2,447) | 1,055자 | 14.1초 |
| 2 | 200.3t/s | 7,412 (7,029) | 913자 | 37.1초 |
| 3 | 201.4t/s | 6,252 (5,902) | 836자 | 31.1초 |
| 4 | 206.7t/s | 4,498 (4,152) | 795자 | 21.8초 |
| 5 | 230.7t/s | 2,158 (1,916) | 705자 | 9.4초 |
| 평균 | 208.6t/s |
이 표가 뜻하는 것은 두 가지입니다. 글자를 만드는 속도는 초당 200토큰을 넘어 빠릅니다. 그런데 쓴 토큰의 87~95%가 생각이라서, 800자 글 하나에 9~37초가 걸렸습니다. 생각 길이가 회차마다 크게 달라 걸린 시간도 4배까지 차이 났습니다. 첫 토큰까지는 0.07~0.3초였습니다.
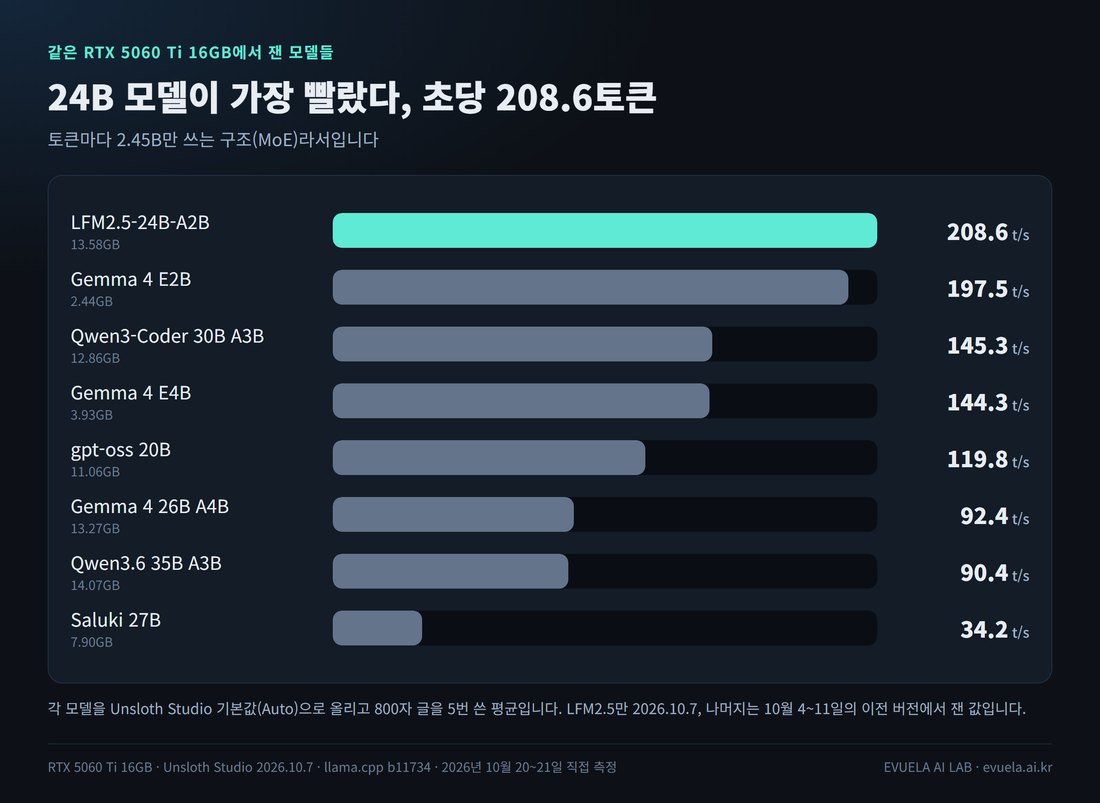
이 PC에서 잰 모델의 기본값 속도입니다. 모두 800자 글을 5번 쓴 평균입니다.
같은 PC에서 잰 모델과 견주면 차이가 큽니다. 비슷하게 일부만 쓰는 MoE인 Gemma 4 26B A4B(4B 사용)와 Qwen3.6 35B A3B(3B 사용)가 초당 90토큰대였으니, 두 배가 넘습니다. 쓰는 파라미터가 2.45B로 더 적고, 층의 4분의 3이 어텐션보다 가벼운 합성곱이라서로 보입니다(추정). 프로그램 버전이 다른 때 잰 값이 섞여 있다는 점은 위에 적었습니다.
생각을 켜도 거의 같다
생각을 켜라는 요청으로 같은 글을 3번 더 썼습니다. 14.5~31.1초, 3,592~5,862토큰이었습니다. 끄라는 요청과 큰 차이가 없습니다. 이 모델에는 생각을 켜고 끄는 스위치가 없다는 뜻입니다. 앱 화면의 Thinking 메뉴에도 끄는 항목 없이 'Preserve thinking' 하나만 있습니다.
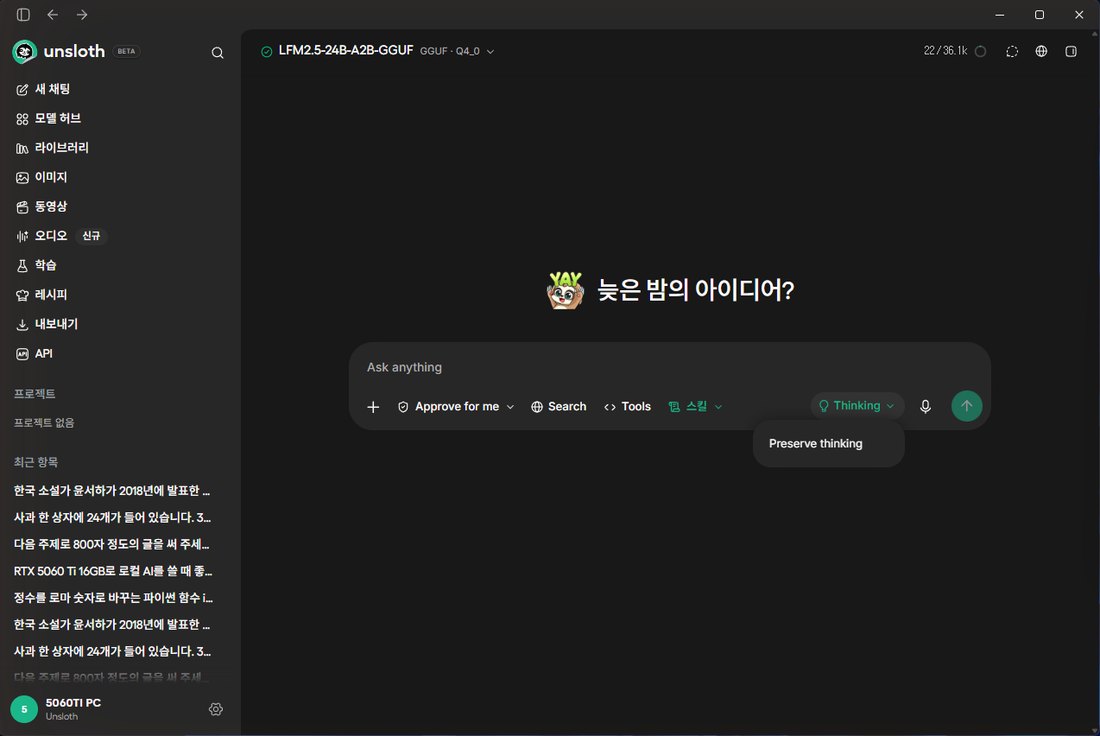
앱 화면의 Thinking 메뉴입니다. 끄는 항목이 없습니다.
VRAM과 컨텍스트: 37,000 넘게 잡으면 CPU가 거든다
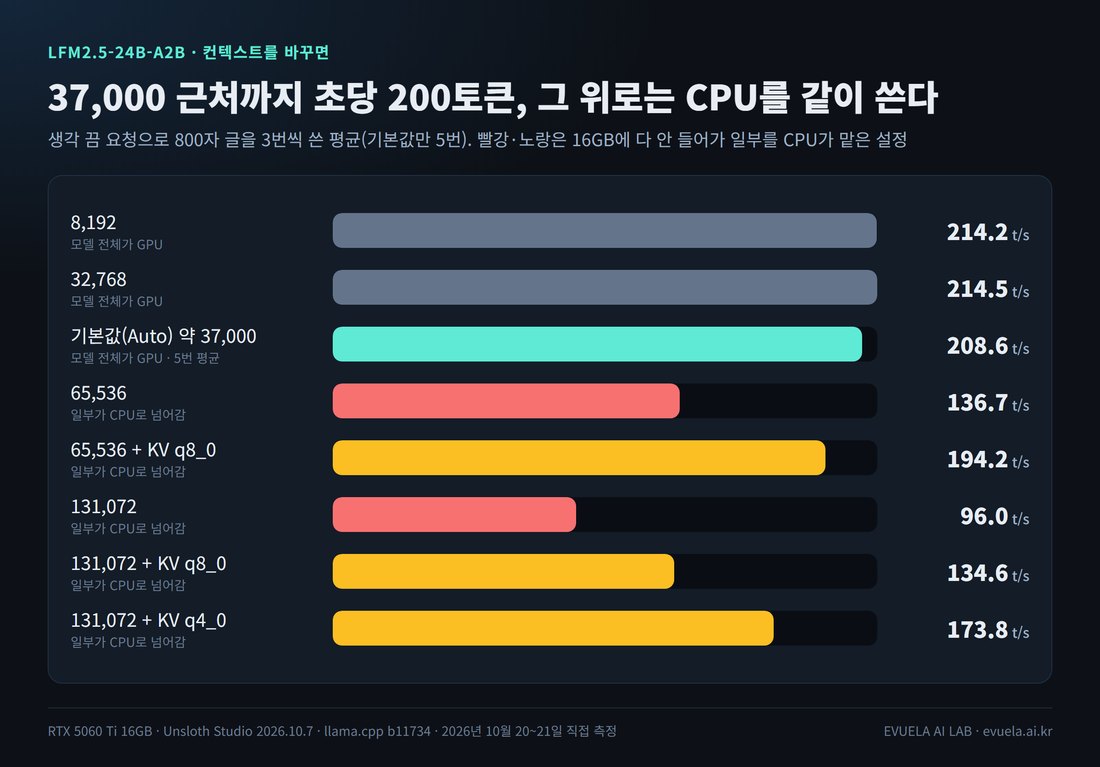
컨텍스트를 바꿔 800자 글을 3번씩 쓴 평균입니다. 빨강과 노랑은 16GB에 다 들어가지 않아 일부를 CPU가 맡은 설정입니다.
| 설정 | 속도 (3번) | 모델이 쓴 VRAM | GPU 사용률 | 모델 전체가 GPU에 |
|---|---|---|---|---|
| 컨텍스트 8,192 | 214.2t/s | 13.1GB | 약 80% | 예 |
| 컨텍스트 32,768 | 214.5t/s | 13.6GB | 약 80% | 예 |
| 기본값 (38,400) | 215.3t/s | 13.7GB | 약 80% | 예 |
| 속도 기능 끔 | 181.9t/s | 13.6GB | 약 85% | 예 |
| 컨텍스트 65,536 | 136.7t/s | 13.9GB | 약 62% | 아니오 |
| 65,536 + KV q8_0 | 194.2t/s | 13.9GB | 약 69% | 아니오 |
| 컨텍스트 131,072 | 96.0t/s | 13.9GB | 약 49% | 아니오 |
| 131,072 + KV q8_0 | 134.6t/s | 13.9GB | 약 56% | 아니오 |
| 131,072 + KV q4_0 | 173.8t/s | 13.9GB | 약 65% | 아니오 |
이 표가 뜻하는 것은 세 가지입니다.
- 컨텍스트를 65,536 이상 잡으면 16GB에 다 들어가지 않습니다. Unsloth Studio가 모델 일부를 CPU로 보내(
--fit on) 속도가 떨어지고, 시스템 램을 최대 3.5GB 더 씁니다. 이때 GPU 사용률이 절반으로 내려가고 CPU는 거의 100%로 일했습니다. - KV 캐시를 줄이면 그만큼 GPU에 더 남아 빨라집니다. 131,072에서 q4_0으로 바꾸면 96.0에서 173.8t/s로 1.8배가 됐습니다. KV 캐시는 모델이 앞에 읽은 내용을 담아 두는 자리입니다.
- 속도 기능(
--spec-default)은 이 모델에서 18% 빠르게 해 줬습니다(181.9에서 215.3t/s).
정리하면, 긴 문서를 다룰 일이 없으면 기본값 그대로 두면 됩니다. 긴 문서를 넣으려면 컨텍스트를 올리면서 KV 캐시를 q4_0으로 바꾸는 편이 좋습니다. 모든 설정이 초당 5토큰을 넘어서 '측정 불가'로 뺀 설정은 없습니다.
화면에서 돌린 영상
앱 화면에서 800자 글을 시켰습니다. 빨리 돌리지 않은 실제 속도입니다(16초, 소리 없음).
긴 글 요약과 문서 속 정보 찾기
이 블로그의 업데이트 기록을 잘라 세 문장으로 요약하게 했습니다. 처음에는 답 한도를 300토큰으로 줬는데, 생각에 한도를 다 써서 세 번 모두 답이 비어 나왔습니다. 한도를 6,000토큰으로 늘려 컨텍스트 65,536에서 다시 쟀습니다.
| 입력 | 입력 토큰 | 쓴 토큰 (생각 포함) | 걸린 시간 |
|---|---|---|---|
| 3,000자 | 1,594 | 805 | 7.8초 |
| 15,000자 | 7,964 | 1,071 | 10.9초 |
| 100,000자 | 47,921 | 948 | 20.7초 |
이 표가 뜻하는 것은, 100,000자 글도 21초 안에 요약한다는 점입니다. 세 번 모두 업데이트의 실제 내용(캐시 무효화 누락, 관리자 화면 문제)을 짚었습니다. 컨텍스트를 131,072로 잡고 같은 글을 처음 쟀을 때는 첫 토큰까지 16.5초, 그 뒤 66t/s였습니다. 모델 일부가 CPU로 넘어간 설정이라 느렸습니다.
약 10,000토큰짜리 글의 10%, 30%, 50%, 70%, 90% 위치에 문장 하나를 숨기고 찾게 했습니다. 이것도 처음 한도(60토큰)에서는 모두 비어 나와서, 한도를 4,000토큰으로 늘려 다시 쟀습니다. 5번 모두 찾았고, 숨기지 않은 글에서는 "없음"이라고 답했습니다. 한 번에 4.3~6.5초였습니다.
산수와 없는 소설
"사과 한 상자에 24개가 들어 있습니다. 3상자를 사서 19개를 먹고, 남은 것을 5명이 똑같이 나누면 한 사람당 몇 개이고 몇 개가 남나요?"를 10번 물었습니다. 10번 모두 "한 사람당 10개, 남는 것 3개"로 맞혔고, 형식도 지켰습니다. 한 번에 0.6~2.1초였습니다.
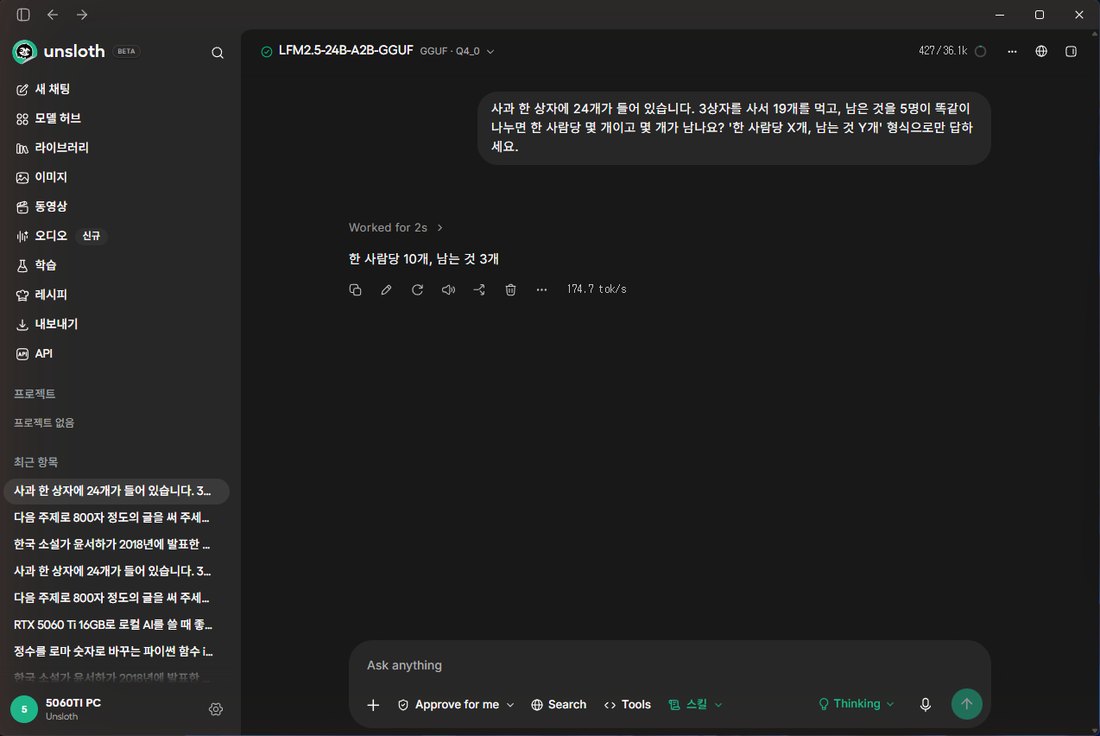
앱 화면에서 사과 문제를 물은 결과입니다.
세상에 없는 소설의 줄거리를 물었을 때는 줄거리를 지어내지 않았습니다. 다만 "그 작품의 구체적인 줄거리 정보를 가지고 있지 않다"는 식으로 답해, 소설이 있기는 한 것처럼 읽힙니다. 없는 책이라고 짚지는 못했습니다. 한 번씩 물은 결과입니다.
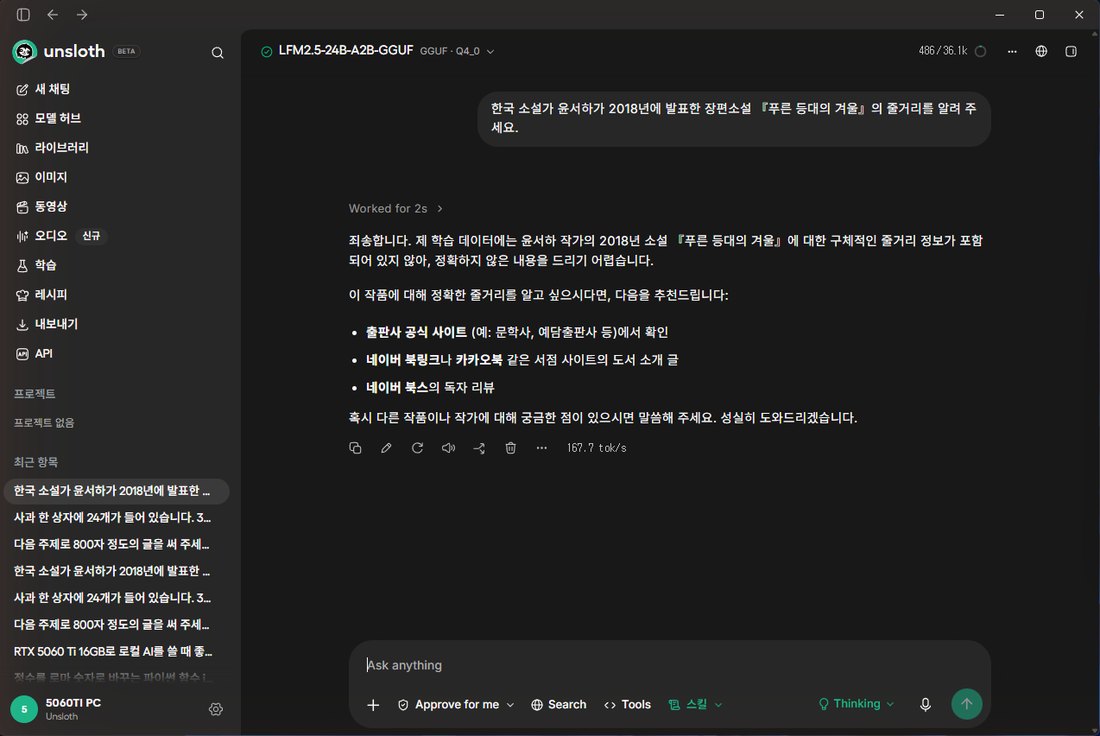
없는 소설을 물은 화면입니다. 지어내지는 않았지만 없는 책이라고 말하지도 않았습니다.
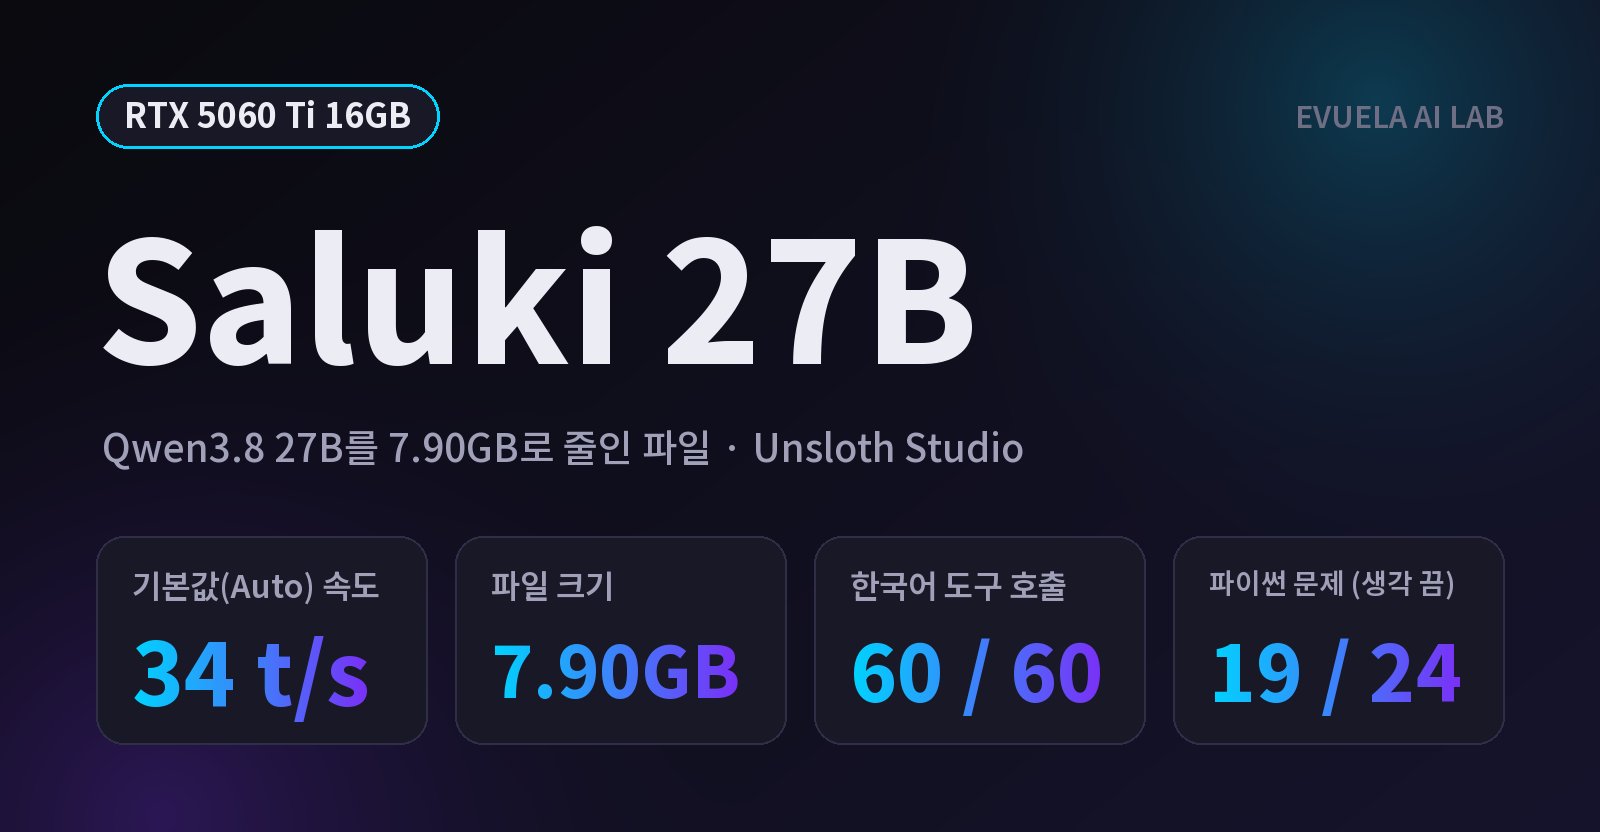
한국어 글 8개(800자 글)에 한자가 섞여 나온 곳은 없었습니다. Saluki 27B는 5개 중 2개에 한자가 섞였습니다.
코딩: 한도에 따라 9/24와 18/24
파이썬 함수 8개를 짜게 하고 미리 만든 시험 값으로 자동 채점했습니다. 같은 문제를 3번씩 돌렸습니다. 이 블로그는 보통 '생각 끔'(한도 2,000토큰)과 '생각 켬'(한도 8,000토큰)으로 나눠 재는데, 이 모델은 생각을 끌 수 없어서 사실상 답 한도만 다른 두 번입니다.
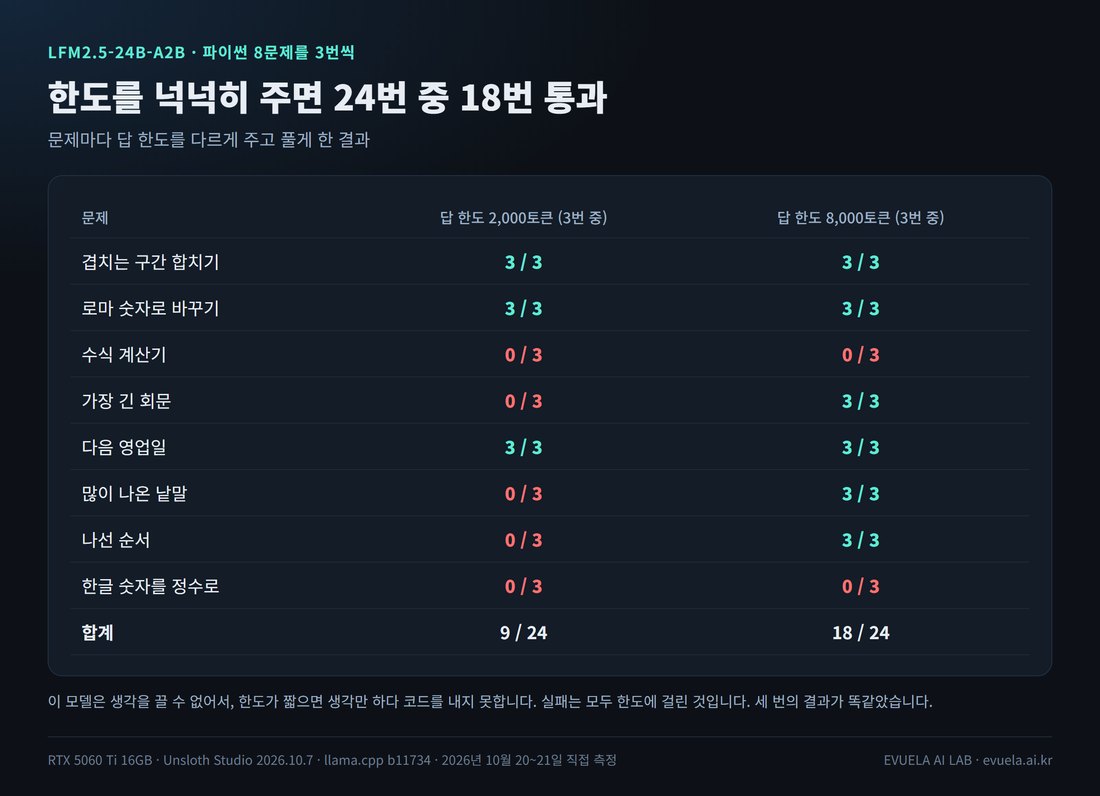
문제마다 3번 중 몇 번 통과했는지입니다.
이 표가 뜻하는 것은 세 가지입니다.
- 실패는 모두 한도에 걸린 것입니다. 한도 2,000토큰에서 실패한 5문제는 생각만 하다 코드를 내지 못했습니다. 한도를 8,000토큰으로 늘리자 그중 3문제를 풀었습니다.
- 수식 계산기와 한글 숫자 바꾸기는 8,000토큰으로도 모자랐습니다. 같은 문제를 다른 모델도 자주 틀렸습니다.
- 세 번의 결과가 똑같았습니다. 모델 파일에 들어 있는 권장 설정(temperature 0.1)이 낮아서 매번 거의 같은 답을 냅니다.
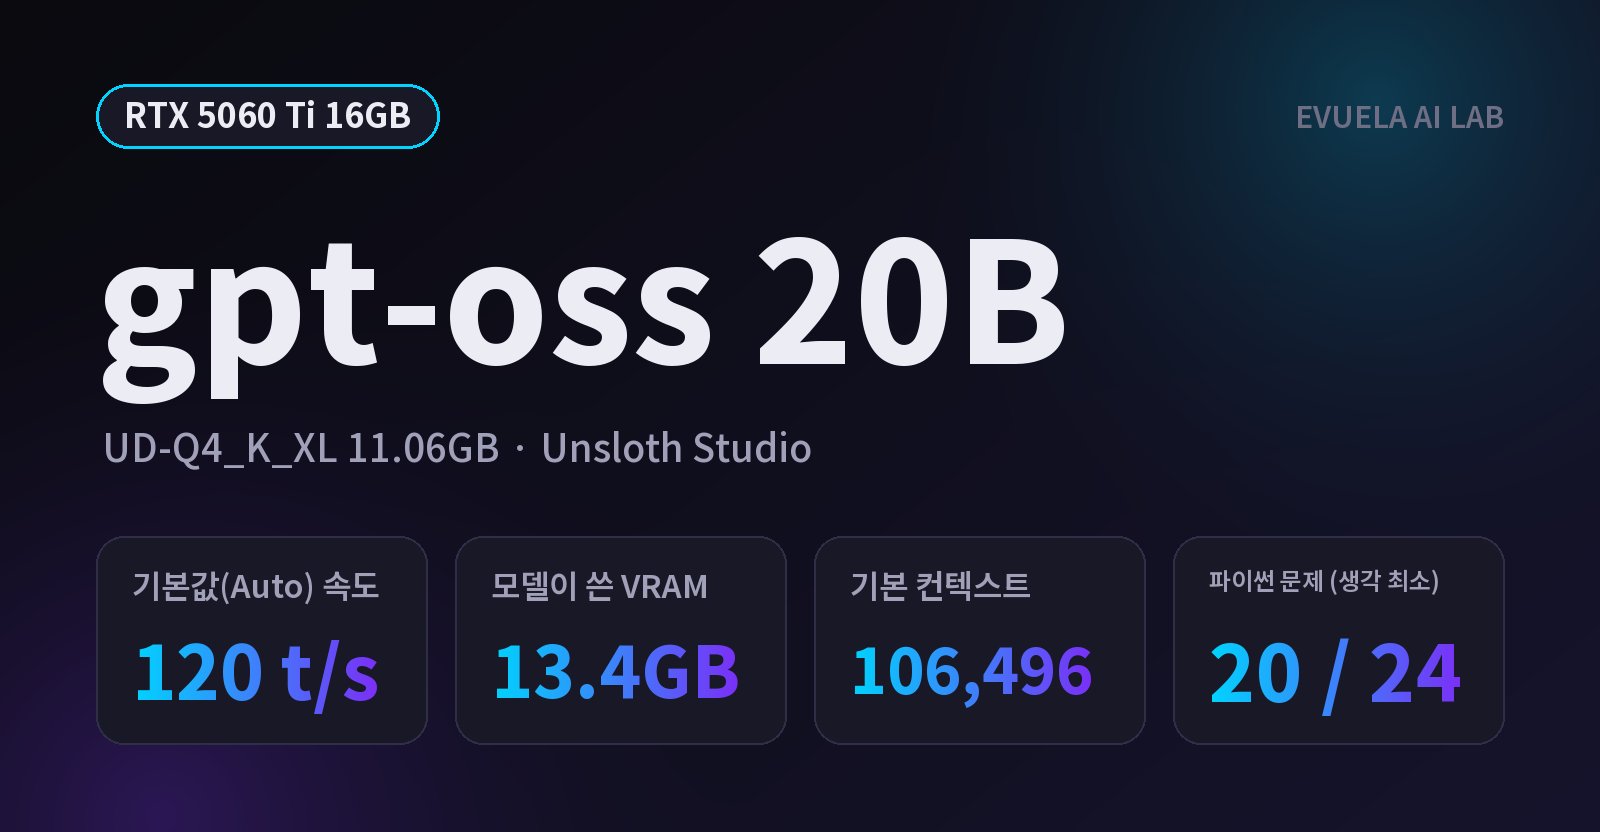
같은 PC에서 같은 8문제를 3번씩 푼 다른 모델과 견주면, gpt-oss 20B(생각 최소) 20개, Saluki 27B(생각 끔) 19개, Gemma 4 E4B 18개, Gemma 4 E2B 16개였습니다. LFM2.5는 한도를 넉넉히 주면 18개로 이 가운데쯤입니다. 8문제를 푸는 데 3분 17초가 걸렸습니다.
도구 호출: 하나씩은 잘 부르고, 둘을 한 번에는 못 했다
모델 카드는 도구 호출 시험(BFCLv4, ToolSandbox)에서 Qwen3.6 35B A3B, Gemma 4 26B A4B보다 높다고 적었습니다. Saluki 27B 글에서 만든 한국어 도구 호출 시험을 그대로 돌렸습니다. 도구 6개(날씨, 환율, 검색, 알람, 계산기, 문자)를 주고 한국어 부탁 20개를 3번씩 보내, 부른 도구의 이름과 인자가 맞는지만 봅니다.
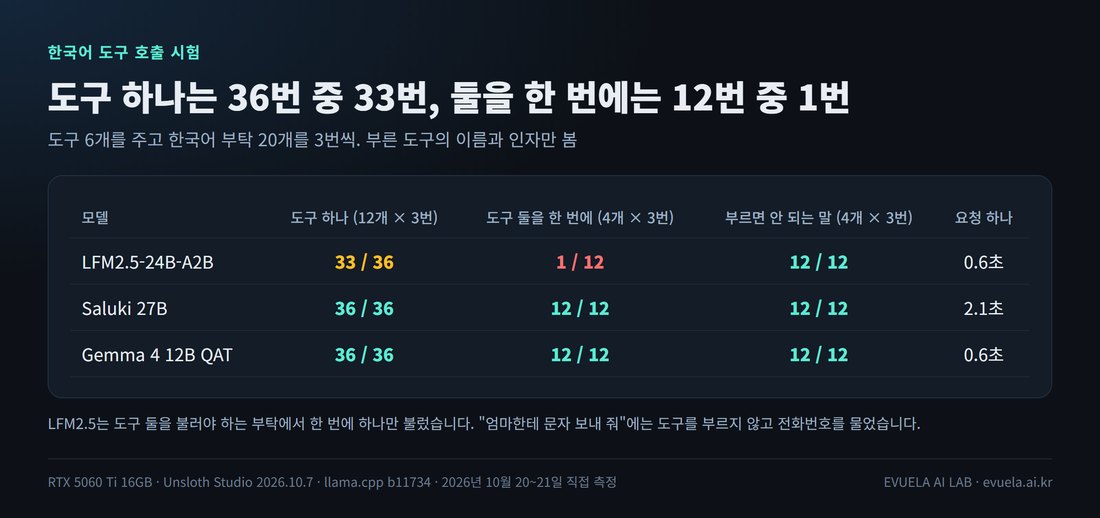
같은 PC에서 같은 시험을 세 모델에 돌린 결과입니다.
| 부탁 | LFM2.5가 한 것 | 판정 |
|---|---|---|
| 150달러가 원화로 얼마야? | convert_currency(amount=150, from=USD, to=KRW) | 맞음 |
| 오후 3시에 회의 알람 맞춰 줘 | set_alarm(time="15:00", label="회의") | 맞음 |
| 엄마한테 '오늘 늦어요'라고 문자 보내 줘 | 도구를 부르지 않고 "엄마의 전화번호를 알려 주시면 보내 드리겠습니다" | 틀림 (3번 모두) |
| 서울이랑 제주 날씨 둘 다 알려 줘 | get_weather(city="Seoul") 하나만 | 틀림 (3번 모두) |
| 부산 날씨 알려 주고, 저녁 7시에 알람도 맞춰 줘 | get_weather(city="부산") 하나만 | 틀림 (3번 모두) |
| 아침 6시와 6시 10분에 알람을 하나씩 맞춰 줘 | set_alarm 두 번 | 3번 중 1번 맞음 |
이 표가 뜻하는 것은 두 가지입니다. 도구 둘을 한 번에 불러야 할 때 하나만 부르고 멈췄습니다. 이 시험은 한 번 묻고 한 번 받는 방식이라, 결과를 받은 뒤 다음 도구를 부르는 식으로 쓰면 결과가 달라질 수 있습니다. 그렇게 여러 번 주고받는 방식은 시험하지 않았습니다. 문자 부탁에서 전화번호를 되물은 것은 틀렸다고 셌지만, 받는 사람이 '엄마'뿐이라 번호를 묻는 것도 말이 되는 행동입니다.
같은 시험에서 Saluki 27B와 Gemma 4 12B QAT는 60번을 모두 맞혔습니다. 제작사 표의 순위와 이 시험의 결과가 다르게 나온 셈입니다. 시험 방식과 언어가 달라서일 수 있습니다(추정).
전력과 온도: 평균 약 111W
| 항목 | 값 (800자 글 2번) |
|---|---|
| 쉬고 있을 때 | 약 12W |
| 글을 쓰는 동안 평균 | 109W, 113W |
| 최고 | 124W |
| 최고 온도 | 64도 |
| 토큰 하나에 드는 전기 | 약 0.5J |
이 표가 뜻하는 것은, 초당 200토큰을 내면서도 전력은 카드 정격(180W)의 3분의 2쯤이라는 점입니다. 토큰 하나에 드는 전기는 같은 PC의 Saluki 27B(약 4.7J)의 10분의 1입니다.
다른 곳의 측정과 견주면
| 측정 | 장비 | 파일 | 속도 |
|---|---|---|---|
| 이 글 | RTX 5060 Ti 16GB | QAD-Q4_0 | 208.6t/s (컨텍스트 약 37,000) |
| Liquid AI (모델 카드) | Apple M5 Max | Q4_K_M | 184t/s (입력 4,000토큰) |
| Liquid AI (모델 카드) | AMD Ryzen AI Max+ 395 | Q4_K_M | 114t/s (입력 4,000토큰) |
이 표가 뜻하는 것은, 16GB 그래픽카드 한 장이 제작사가 잰 고급 노트북·미니 PC 칩보다 빠르게 돌렸다는 점입니다. 다만 파일 종류와 입력 길이가 다릅니다. 다른 사람이 그래픽카드에서 잰 값은 찾지 못했습니다.
정리
- 16GB 그래픽카드에서 Unsloth Studio 기본값으로 초당 208.6토큰이 나옵니다. 이 PC에서 잰 모델 가운데 가장 빠릅니다.
- VRAM은 13.6GB로 거의 꽉 찹니다. 컨텍스트를 65,536 넘게 잡으려면 KV 캐시를 q4_0으로 바꿔야 빠릅니다.
- 생각을 끌 수 없습니다. API나 다른 프로그램에 연결할 때는 답 한도를 넉넉히(수천 토큰) 줘야 합니다. 그러지 않으면 답이 비어 나옵니다.
- 긴 글 요약과 문서 속 정보 찾기는 빠르고 정확했습니다. 100,000자 요약이 20.7초입니다.
- 도구를 하나씩 부르는 일은 잘했지만, 여러 개를 한 번에 부르는 일은 거의 못 했습니다.
내 그래픽카드에 어떤 모델이 들어가는지는 GPU 체험에서 볼 수 있습니다. 같은 PC의 주력 모델 이야기는 Gemma 4 12B 글에 있습니다.
이 글의 한계
- 같은 PC에서 잰 다른 모델은 Unsloth Studio 이전 버전(10월 4~11일)에서 잰 값입니다. 그 모델들을 같은 버전으로 다시 재지 않았습니다.
- 4비트 파일(QAD-Q4_0) 하나만 쟀습니다. 더 큰 파일은 16GB에 들어가지 않거나(Q5_K_M 17.03GB 이상) 재지 않았습니다(Q4_K_M 14.53GB).
- 생각을 끌 수 없어서, 이 블로그의 '생각 끔' 측정은 모두 '생각한 채로 잰 값'입니다.
- 긴 글 요약과 문서 속 정보 찾기는 답 한도를 늘려 다시 잰 값입니다. 처음 측정(한도 60~300토큰)에서는 답이 비어 나왔습니다.
- 도구 호출은 한 번 묻고 한 번 받는 방식만 시험했습니다. 결과를 돌려주며 여러 번 주고받는 방식은 시험하지 않았습니다. 부탁 20개는 직접 만든 것이라 수가 적습니다.
- 사진 입력이 없는 모델이라 사진 시험은 하지 않았습니다.
- 없는 소설은 한 번 물은 결과입니다.
- 2026년 10월 20~21일, Unsloth Studio 2026.10.7(앱 v0.1.909-beta), llama.cpp b11734, 그래픽 드라이버 617.42 기준입니다.
자주 묻는 질문
RTX 5060 Ti 16GB에서 LFM2.5-24B-A2B는 몇 t/s인가요?
Unsloth Studio 기본값에서 5번 평균 208.6t/s였습니다. 컨텍스트 32,768까지는 214t/s 안팎이고, 65,536부터는 16GB에 다 들어가지 않아 느려집니다.
생각(Thinking)을 끌 수 있나요?
끌 수 없습니다. 모델 카드에 항상 생각하는 모델이라고 적혀 있고, 끄라는 요청을 보내도 생각했습니다. 800자 글 하나에 생각으로 1,900~7,000토큰을 썼습니다. 답 한도를 짧게 주면 답이 비어 나오니 넉넉히 주세요.
12GB 그래픽카드에도 들어가나요?
이 글의 파일(13.58GB)은 12GB 카드에 다 들어가지 않습니다. 일부가 CPU로 넘어가서 느려질 것으로 보입니다(추정). 12GB 카드에서는 재지 않았습니다.
한국어로 써도 되나요?
지원 언어 16개에 한국어가 들어 있고, 이 글의 시험에서 한국어 글과 요약, 산수는 자연스러웠습니다. 한국어 글에 한자가 섞여 나온 곳도 없었습니다.
출처
- 모델: LiquidAI/LFM2.5-24B-A2B, LiquidAI/LFM2.5-24B-A2B-GGUF (Hugging Face, 제작사 측정값의 출처)
- Liquid AI 블로그: LFM2.5-24B-A2B
- 도구 호출 시험 스크립트: tool_call_test.py
댓글 0개