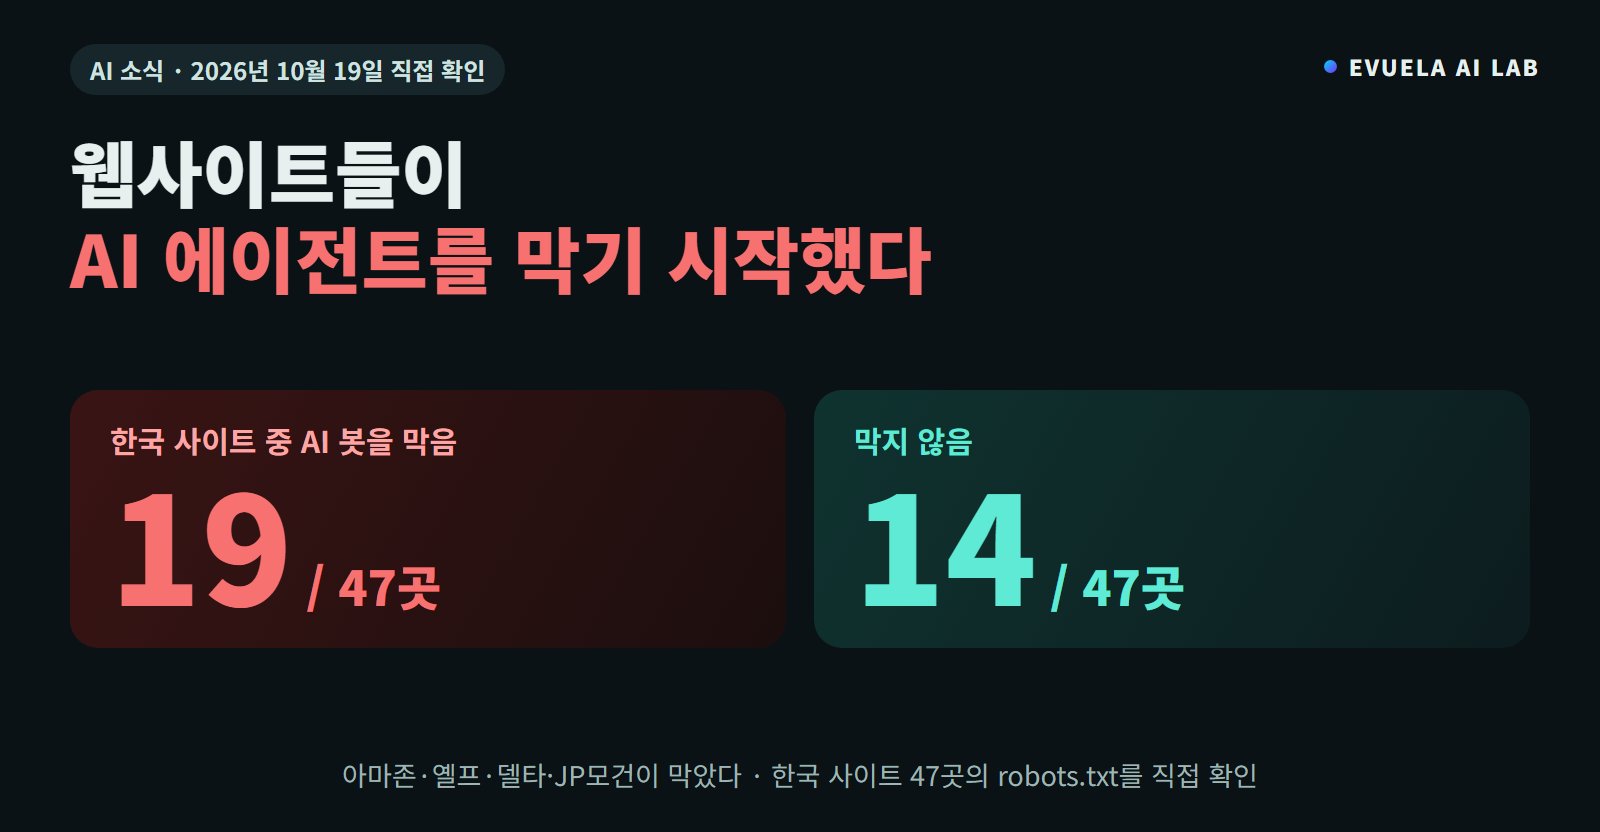
사람 대신 쇼핑하고 예약하는 AI 에이전트가 미국의 큰 사이트들에서 막히고 있습니다. 아마존, 옐프, 델타항공, JP모건체이스가 막았다고 보도됐습니다. 한국 사이트는 어떤지 보려고 47곳의 robots.txt를 직접 받아 읽어 보니, 19곳이 AI 봇을 따로 막는다고 적어 두었고 14곳은 막지 않았습니다.
- 미국에서는 쇼핑, 예약, 은행에서 막혔습니다. 옐프는 돈을 낸 에이전트만 받고, 델타항공은 에이전트의 항공권 예매를 막습니다. JP모건체이스는 보안을 이유로 계좌 접근을 막습니다.
- 일부러 막은 곳도 있고, 함께 걸린 곳도 있습니다. 월마트는 에이전트와 협력하는데도 "사람인지 확인" 단추 때문에 에이전트가 막혔습니다.
- 한국 사이트 47곳 중 19곳은 robots.txt로 AI 봇을 막습니다. 구글 검색 봇은 들여보내면서 AI 봇만 따로 막은 곳입니다.
- 가장 많이 막힌 것은 학습용 봇입니다. 구글이 들어갈 수 있는 33곳 중 19곳이 GPTBot 같은 학습 봇을 막았고, 사람 대신 오는 봇(ChatGPT-User 등)은 12곳이 막았습니다.
- robots.txt만으로는 알 수 없는 차단도 있습니다. 기사에서 에이전트를 막는다고 한 델타항공과 JP모건체이스의 robots.txt에는 AI 봇 규칙이 하나도 없었습니다.
미국 사례는 The Verge(10월 17일), TechCrunch(10월 6일)의 보도와 Cloudflare 개발 문서를 읽고 정리했습니다. 한국 사이트 47곳은 2026년 10월 19일에 이 블로그가 직접 각 사이트의 robots.txt를 받아, 구글이 안내하는 방식대로 읽어서 셌습니다. 에이전트를 직접 써서 사이트에 들어가 보지는 않았습니다.
이 글의 내용을 20초로 요약한 영상입니다(소리 없음).
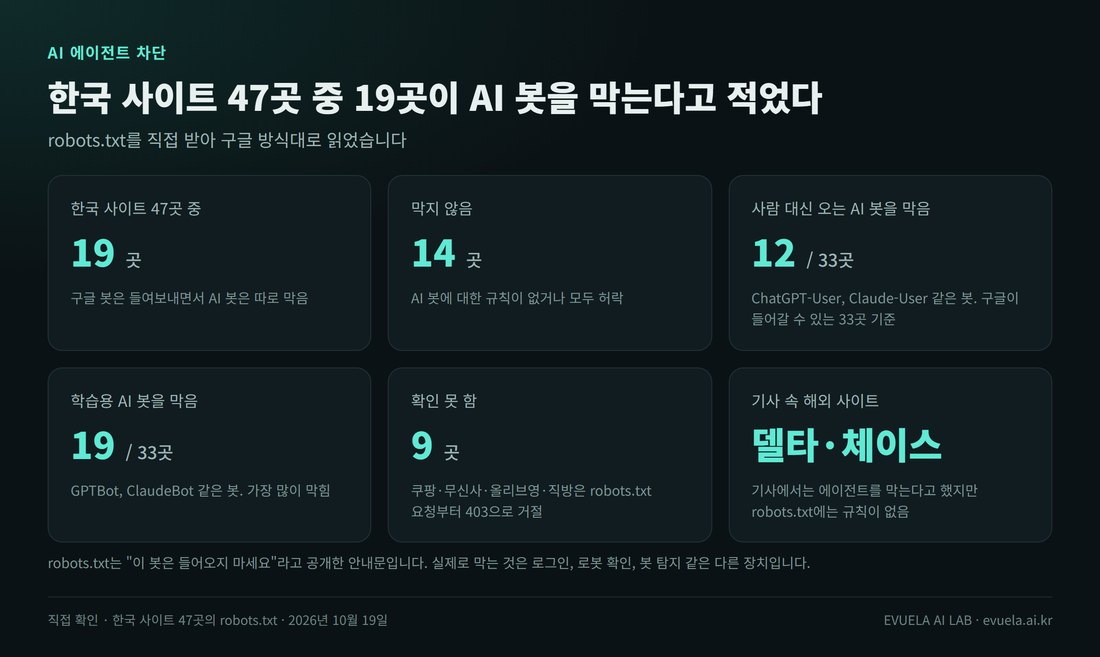
2026년 10월 19일에 직접 확인한 결과입니다.
AI 에이전트는 무엇이고, 왜 막히나요?
AI 에이전트는 사람이 시킨 일을 웹사이트에 직접 들어가서 대신 해 주는 AI입니다. "다음 주 화요일 저녁 식당 예약해 줘", "이 운동화 제일 싼 곳에서 사 줘" 같은 일을 맡깁니다. 메타의 Muse, OpenAI의 Dots, xAI의 Grok, Instinct 같은 서비스가 이런 기능을 내세웁니다.
문제는 에이전트가 들어가는 사이트가 그것을 원하지 않을 수 있다는 점입니다. The Verge는 이렇게 정리했습니다.
"Websites are closing their doors to AI agents" (The Verge, 10월 17일)
사이트가 에이전트를 막는 이유는 크게 세 가지로 보도됐습니다. 첫째는 돈입니다. 사람이 직접 오지 않으면 광고를 볼 사람이 줄고, 데이터를 가져가는 데 값을 받고 싶어 합니다. 둘째는 보안입니다. 은행은 밖의 프로그램이 고객 계좌에 들어오는 것을 위험하다고 봅니다. 셋째는 원래 있던 스팸 봇 막기 장치입니다. 이 장치는 나쁜 봇과 사람이 시킨 에이전트를 잘 구분하지 못합니다.
미국에서는 어디가 막았나요?
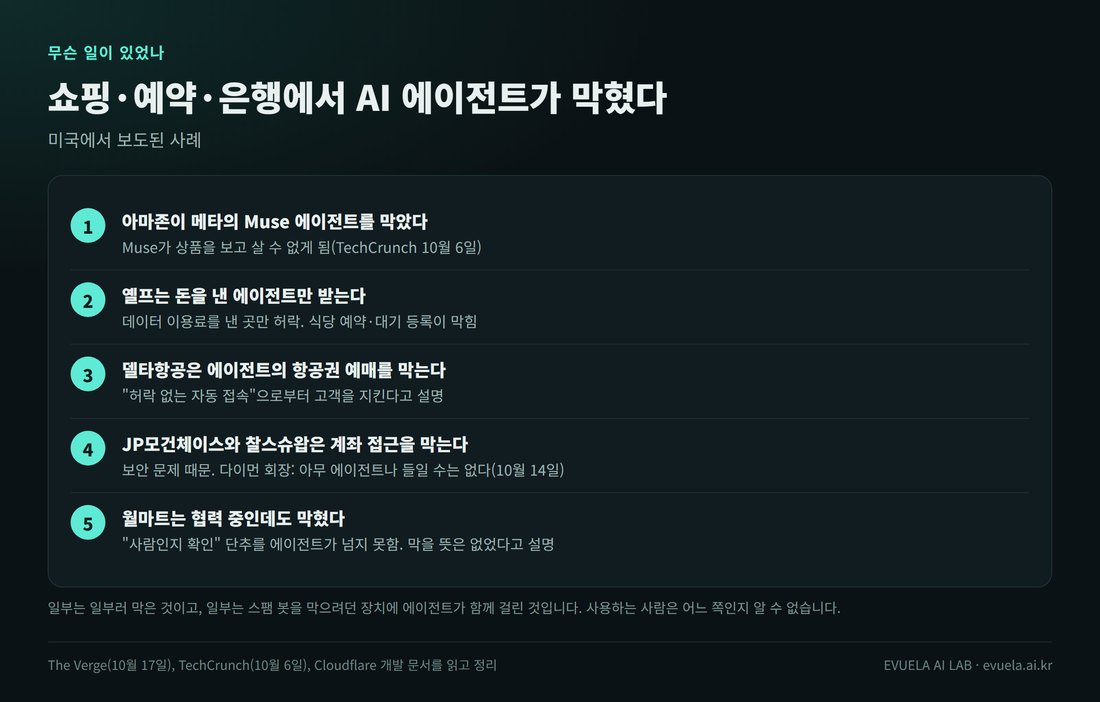
미국에서 보도된 사례입니다.
| 회사 | 무엇을 막았나 | 밝힌 이유 |
|---|---|---|
| 아마존 | 메타 Muse가 상품을 보고 사는 것 | 사이트 정책 위반이라고 함. 작년에는 Perplexity의 쇼핑 에이전트도 막고 소송을 냄 |
| 옐프 | 식당 견적, 대기 등록, 예약 | 데이터 이용 계약을 맺고 돈을 낸 에이전트만 받음 |
| 델타항공 | 에이전트의 항공권 예매 | 허락 없는 자동 접속으로부터 고객을 지키려고 |
| 유나이티드항공 | 뚜렷이 밝히지 않음 | 이용 약관에 "허락 없이 로봇·자동 장치로 사이트를 쓰지 말 것"이 있다고 안내 |
| JP모건체이스, 찰스슈왑 | 고객 계좌에 들어오는 것 | 보안. 다이먼 회장은 "아무 에이전트나 들일 수 없다"고 말함 |
| 월마트 | 막을 뜻은 없었음 | 메타와 협력 중. 사람 확인 단추를 에이전트가 넘지 못해 생긴 일이라고 설명 |
이 표가 뜻하는 것: 쇼핑, 식당, 항공, 은행처럼 돈이 오가는 곳에서 먼저 막혔습니다. 막는 이유는 회사마다 다릅니다.
이 밖에 이베이, 질로, 피자헛, 아디다스, Cars.com, 암트랙에서 막혔다는 사용자 글도 있었습니다. 이베이는 "모든 쇼핑 에이전트를 막는 것은 아니고 허락 없는 수집과 모델 학습을 막는다"고 했고, 질로는 "에이전트를 허락하지만 수집을 막는 장치에 가끔 걸린다"고 답했습니다. 나머지는 답하지 않았습니다.
이런 흐름에는 Cloudflare의 설정 변경도 영향을 준 것으로 보입니다. Cloudflare는 많은 사이트 앞에서 봇을 걸러 주는 회사입니다. 9월 15일부터 새로 들어온 사이트에는 "광고가 있는 페이지에서 학습 봇과 에이전트를 막는" 설정이 기본으로 켜집니다. 다만 Cloudflare는 TechCrunch에 개인용 에이전트가 막힌 일에 대해 따로 내놓을 자료는 없다고 답했습니다.
AI 봇은 어떻게 나뉘나요?
robots.txt에 적히는 AI 봇의 이름을 보면 하는 일이 세 가지로 나뉩니다. 이 글은 이 세 가지로 나눠 셌습니다.
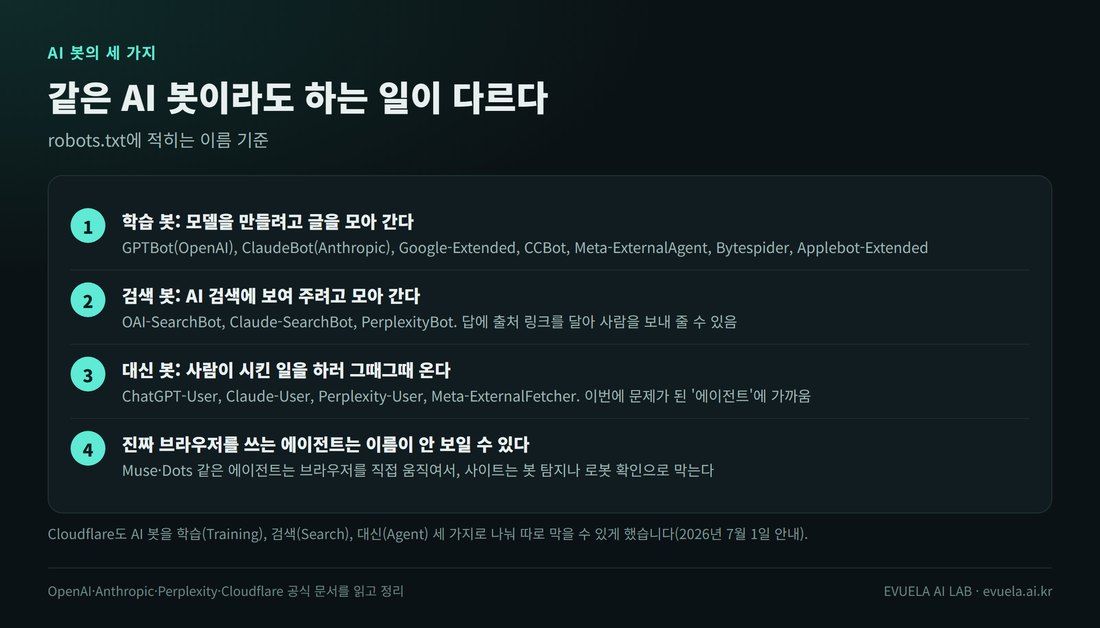
AI 봇을 하는 일에 따라 나눈 것입니다.
| 종류 | 하는 일 | 이 글에서 확인한 이름 |
|---|---|---|
| 학습 봇 | AI 모델을 만들 글을 모음 | GPTBot, ClaudeBot, Google-Extended, CCBot, Meta-ExternalAgent, Bytespider, Applebot-Extended (7개) |
| 검색 봇 | AI 검색 답에 쓸 글을 모음 | OAI-SearchBot, Claude-SearchBot, PerplexityBot (3개) |
| 대신 봇 | 사람이 물을 때 그 페이지를 바로 가져옴 | ChatGPT-User, Claude-User, Perplexity-User, Meta-ExternalFetcher (4개) |
이 표가 뜻하는 것: 같은 회사의 봇이라도 이름마다 하는 일이 달라서, 사이트는 학습은 막고 검색은 받는 식으로 골라서 막을 수 있습니다.
이번에 문제가 된 Muse나 Dots 같은 에이전트는 진짜 브라우저를 직접 움직이는 경우가 많습니다. 그러면 사이트에는 보통 사람의 크롬처럼 보여서 robots.txt의 이름으로는 막을 수 없습니다. 이런 에이전트는 봇 탐지, 로봇 확인, 로그인 보안에서 막힙니다. 그래서 아래 robots.txt 조사는 "사이트가 AI 봇을 어떻게 대하겠다고 공개했는가"를 보여 주는 것이지, 모든 차단을 보여 주지는 않습니다.
한국 사이트는 AI 봇을 막고 있나요?
포털, 쇼핑, 여행, 배달, 금융, 뉴스, 커뮤니티, 책, 구직 사이트 47곳의 robots.txt를 받아 봤습니다. 기사에 나온 해외 사이트 7곳도 함께 봤습니다.
읽는 방법은 이렇습니다. robots.txt에는 "이 이름의 봇은 이 주소에 들어오지 마세요"가 적혀 있습니다. 봇 이름이 따로 적혀 있으면 그 규칙을 쓰고, 없으면 모든 봇(*)에 대한 규칙을 씁니다. 주소가 여러 규칙에 걸리면 가장 길게 맞는 규칙을 씁니다. 구글이 안내하는 방식 그대로입니다. 첫 화면은 따로 열어 두는 곳이 많아서, 보통 페이지 주소(/sample-page) 하나를 넣어 봤습니다. 그리고 구글 검색 봇(Googlebot)과 결과를 견줘서, 구글은 들어가는데 AI 봇은 못 들어가면 "AI 봇을 따로 막음"으로 셌습니다.
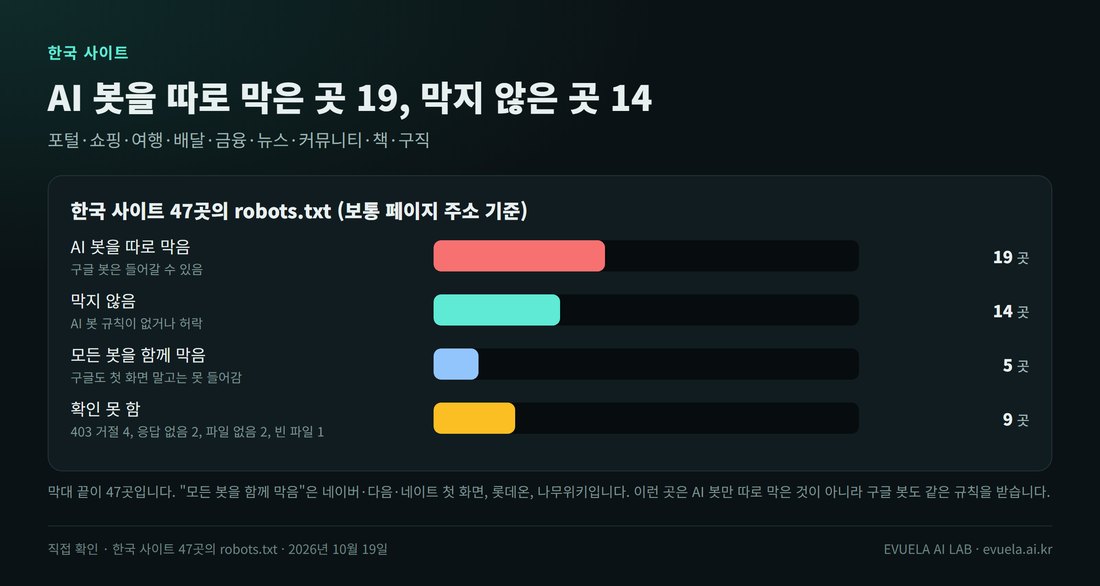
47곳 가운데 19곳이 AI 봇을 따로 막는다고 적었습니다.
| 결과 | 곳 수 | 예 |
|---|---|---|
| AI 봇을 따로 막음 | 19 | 배달의민족, 당근, 카카오뱅크, 지마켓, 중앙일보, 한겨레, 연합뉴스, 알라딘, 잡코리아 |
| 막지 않음 | 14 | 컬리, 다나와, 코레일, 야놀자, 토스, 동아일보, 벨로그, 교보문고, 마이리얼트립 |
| 모든 봇을 함께 막음 | 5 | 네이버, 다음, 네이트(첫 화면 말고 모두 막음), 롯데온, 나무위키 |
| 확인 못 함 | 9 | 쿠팡, 무신사, 올리브영, 직방(403 거절), 대한항공, 아시아나(응답 없음), 우리은행, 티스토리(파일 없음), 신한은행(빈 파일) |
이 표가 뜻하는 것: 확인할 수 있었던 38곳 중 절반이 AI 봇을 따로 막았습니다. 포털처럼 모든 봇을 막는 곳은 AI만 막은 것이 아니라 구글 봇도 같은 규칙을 받습니다.
쿠팡, 무신사, 올리브영, 직방은 robots.txt를 달라는 요청부터 403으로 거절했습니다. 이 블로그의 확인 도구는 이름에 "EVUELA-robots-check"를 밝히고 요청했는데, 봇 이름을 밝힌 요청 자체를 받지 않는 것으로 보입니다. 대한항공과 아시아나항공은 15초 안에 답이 오지 않았습니다.
어떤 종류의 봇이 많이 막혔나요?
구글 봇이 들어갈 수 있는 33곳만 놓고, 세 종류의 봇을 하나라도 막은 곳을 셌습니다.
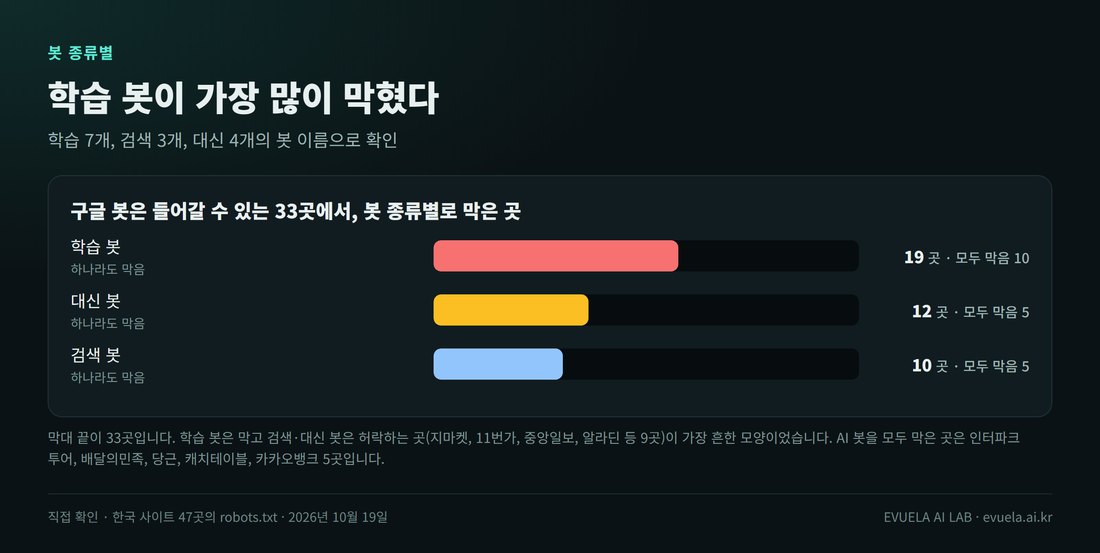
학습 봇이 가장 많이 막혔습니다.
| 봇 종류 | 하나라도 막은 곳 | 모두 막은 곳 |
|---|---|---|
| 학습 봇 (7개) | 33곳 중 19곳 | 10곳 |
| 대신 봇 (4개) | 33곳 중 12곳 | 5곳 |
| 검색 봇 (3개) | 33곳 중 10곳 | 5곳 |
이 표가 뜻하는 것: 한국 사이트는 "내 글로 AI를 학습시키지는 말라"는 쪽에 가장 많이 반응했습니다. 사람 대신 오는 봇은 그보다 덜 막았습니다.
모양으로 나누면 세 가지가 보였습니다.
- AI 봇을 모두 막음 (5곳): 인터파크 투어, 배달의민족, 당근, 캐치테이블, 카카오뱅크. 대부분 "구글과 네이버 같은 검색 봇만 들어오고 나머지는 모두 막음"으로 적어 두었습니다.
- 학습만 막고 검색·대신은 받음 (9곳): 지마켓, 11번가, 조선일보, 중앙일보, 매일경제, 예스24, 알라딘, 사람인, 잡코리아. 11번가와 중앙일보는 ChatGPT-User, Claude-User 같은 봇의 이름을 적어 들어오라고 열어 두었습니다.
- 이름을 적어 반겨 줌 (2곳): 마이리얼트립, 교보문고. 마이리얼트립은 학습 봇까지 이름을 적어 모두 허락했습니다.
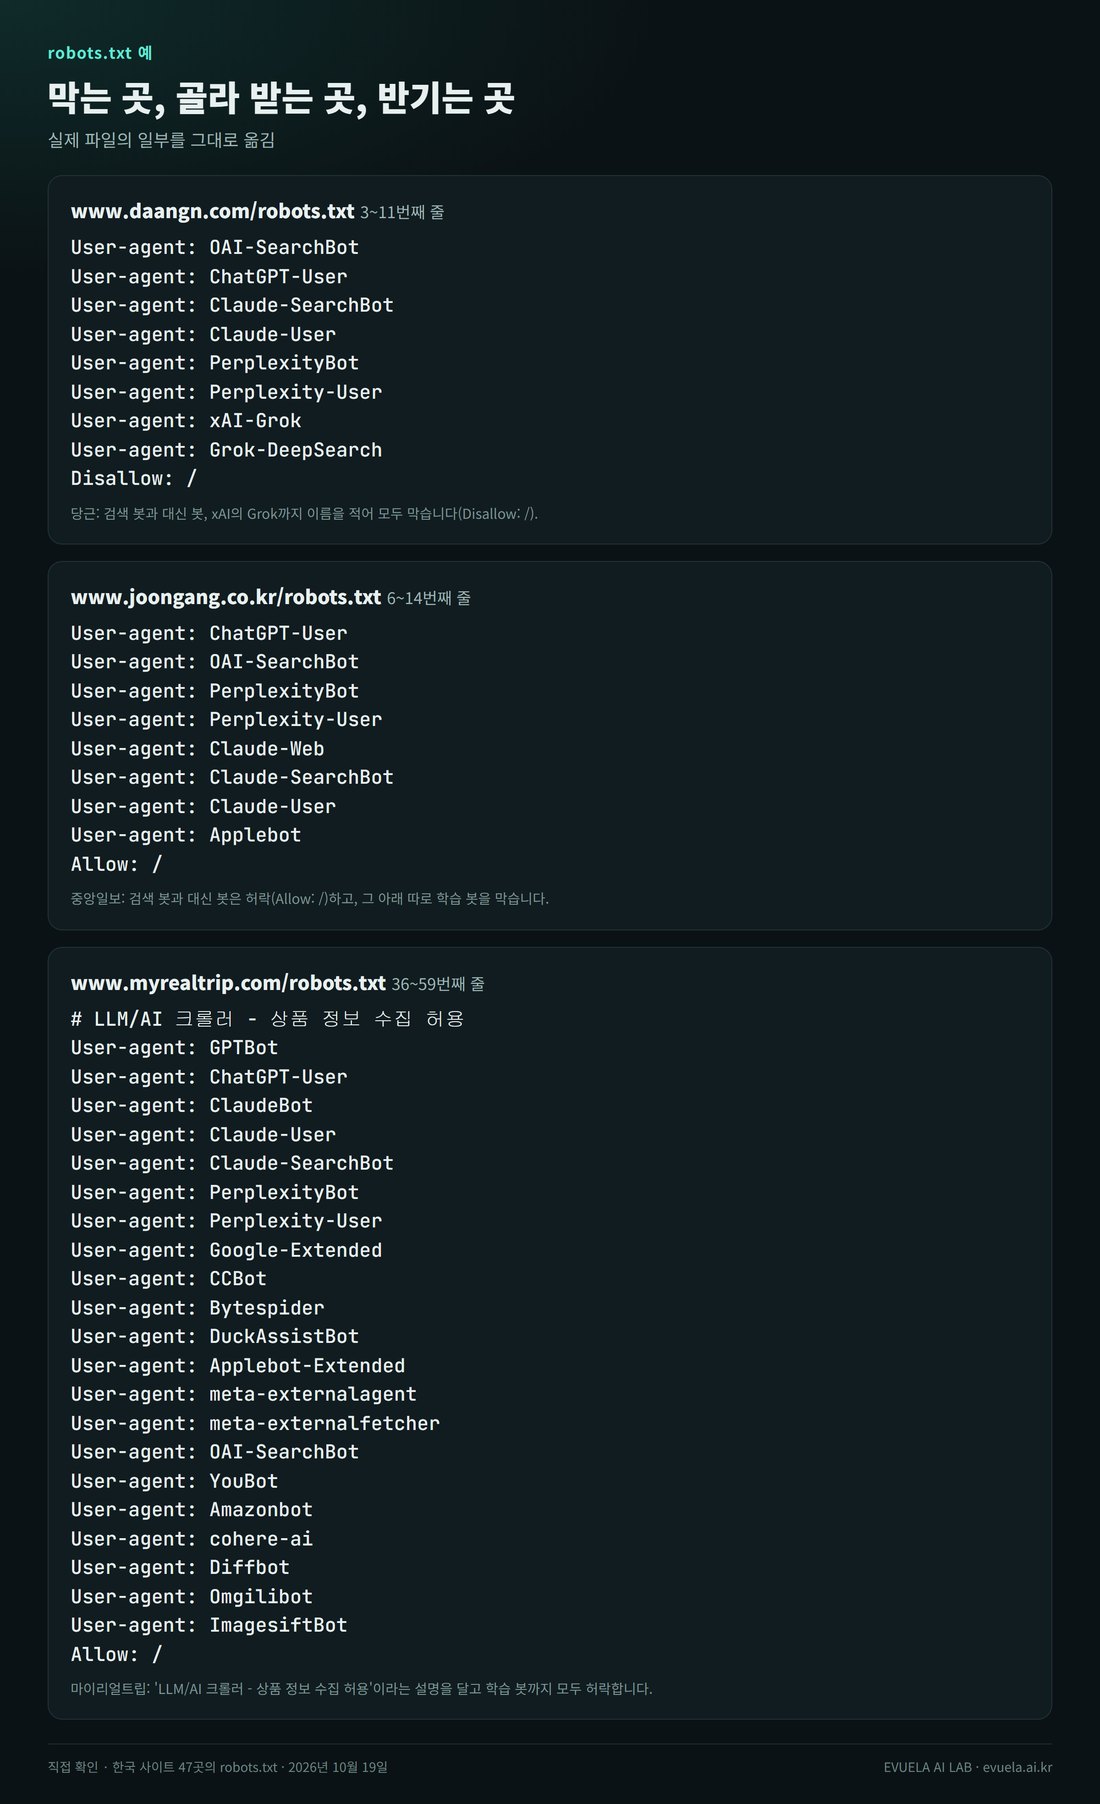
세 사이트의 robots.txt 원문 일부입니다.
당근은 xAI의 Grok 봇 이름까지 적어서 막았습니다. 중앙일보는 검색·대신 봇을 받는 묶음 바로 아래에 GPTBot, ClaudeBot 같은 학습 봇을 막는 묶음을 따로 두었습니다. 마이리얼트립은 주석에 "상품 정보 수집 허용"이라고 이유까지 적었습니다. 여행 상품이 AI 검색 답에 나오기를 바라는 것으로 보입니다.
기사 속 해외 사이트의 robots.txt는 어땠나요?
| 사이트 | 기사 내용 | robots.txt |
|---|---|---|
| 아마존 | Muse 등 에이전트를 막음 | 학습 6, 검색 3, 대신 4개를 막음 |
| 옐프 | 돈 낸 에이전트만 받음 | 학습 7, 검색 3, 대신 4개를 모두 막음 |
| 이베이 | 허락 없는 수집과 학습을 막음 | 학습 6, 검색 1개를 막음, 대신 봇은 막지 않음 |
| 질로 | 에이전트를 허락함 | 학습 2개만 막음 |
| 델타항공 | 에이전트의 예매를 막음 | AI 봇 규칙 없음 |
| JP모건체이스 | 계좌 접근을 막음 | AI 봇 규칙 없음 |
| 월마트 | 에이전트와 협력 | AI 봇 규칙 없음 |
이 표가 뜻하는 것: 아마존, 옐프, 이베이, 질로는 기사에서 말한 태도와 robots.txt가 맞았습니다. 델타항공과 JP모건체이스는 robots.txt에는 아무 규칙이 없는데 에이전트를 막고 있습니다.
델타항공과 JP모건체이스가 막는 곳은 robots.txt가 다루지 않는 예매 단계와 로그인 뒤 계좌 화면입니다. 이런 곳은 로그인, 보안 확인, 봇 탐지로 막습니다. robots.txt가 비어 있다고 에이전트가 쓸 수 있는 사이트라고 볼 수는 없습니다.
앞으로 어떻게 될까요?
막는 쪽과 함께 길을 여는 쪽도 있습니다. 메타는 월마트, 갭, 세포라, 베스트바이와 협력해 Muse가 들어갈 수 있게 했고, 쇼피파이는 상품 목록을 AI 에이전트에 열었습니다. 메타, 월마트, 스트라이프, Sierra 등은 에이전트가 기업과 주고받는 방식을 정하는 공개 표준을 함께 만들기 시작했습니다. 좋은 에이전트와 나쁜 봇을 가려내려는 것입니다.
메타는 이렇게 말했습니다.
"Turning away a personal agent means turning away the customer behind it." (메타, TechCrunch 인용)
에이전트를 막으면 그 뒤에 있는 손님도 함께 돌려보내는 셈이라는 주장입니다. 반대로 옐프처럼 "데이터에 값을 내면 받겠다"는 곳도 있어서, 앞으로는 협력하거나 돈을 낸 에이전트만 들어가는 쪽으로 갈 가능성이 큽니다.
에이전트를 쓰는 분께 드릴 수 있는 말은 두 가지입니다. 에이전트가 일을 못 끝냈다면 그 사이트가 막았을 수 있으니 직접 들어가서 해 보시기 바랍니다. 은행과 증권 계좌는 회사가 허락한 연결이 아니면 에이전트에게 맡기지 않는 편이 안전합니다.
이 블로그는 AI 봇을 막지 않습니다. 학습, 검색, 대신 봇 모두 robots.txt에서 허락해 두었습니다. 이 블로그의 글은 직접 잰 값이 중심이라, AI 검색 답에 출처로 나오는 편이 독자에게 도움이 된다고 보았습니다.
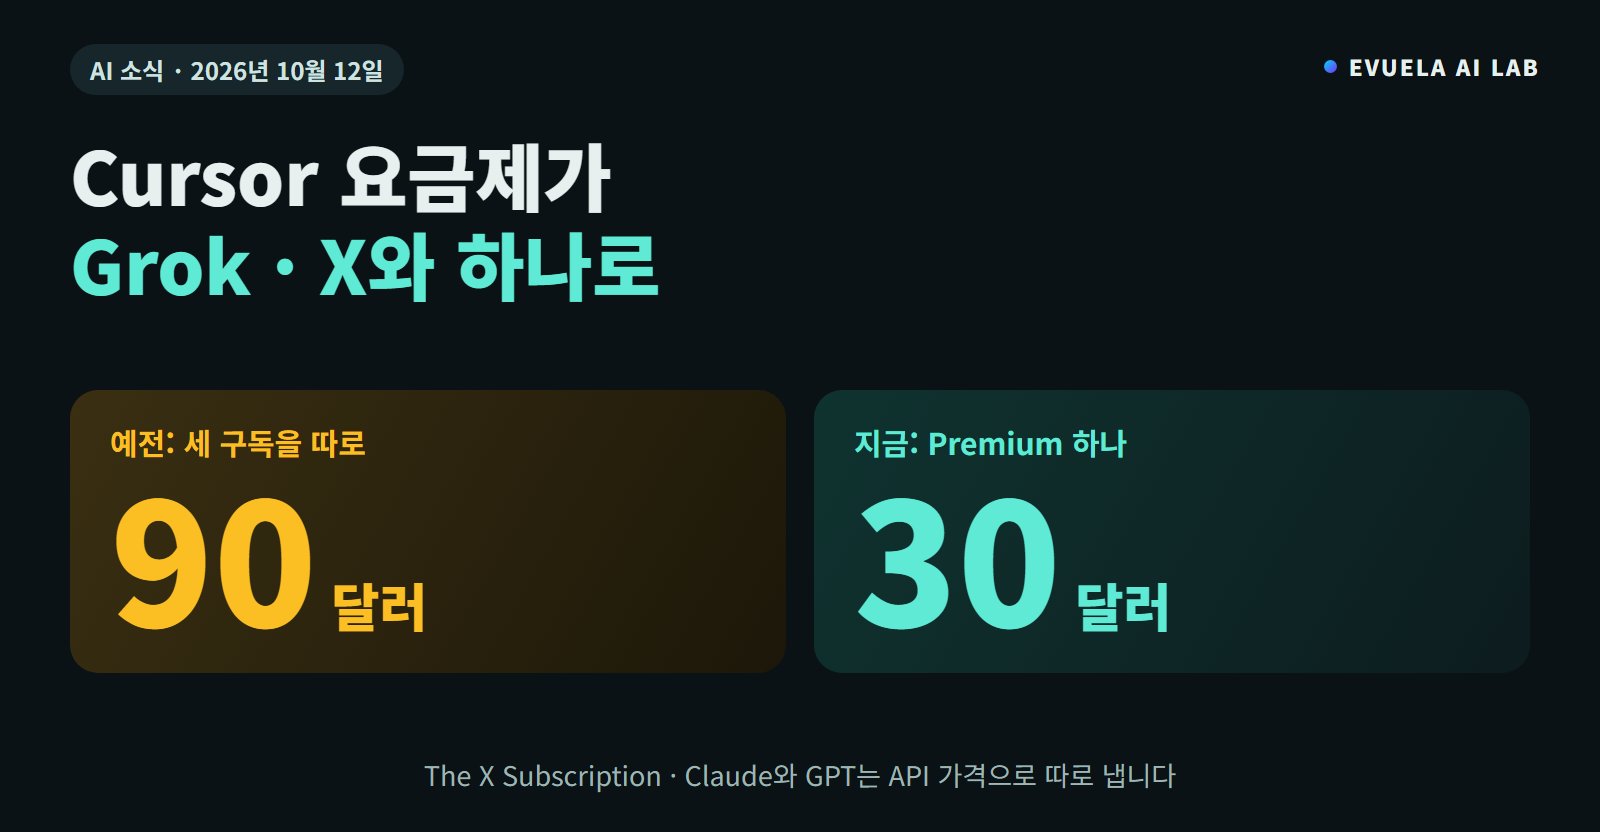
AI 에이전트를 내 PC에서 직접 돌려 본 이야기는 Hermes Agent를 로컬 AI에 연결한 글에 있습니다. 같은 시기의 AI 서비스 소식으로는 Cursor 요금제가 Grok·X와 합쳐진 글이 있고, AI가 글 대신 확률로 판단하는 모델은 Perplexity pplx-decider 글에서 다뤘습니다.
이 글의 한계
- 에이전트를 직접 써서 막히는지 확인하지 않았습니다. 미국 사례는 보도와 각 회사의 답변을 옮긴 것입니다.
- robots.txt는 안내문입니다. 실제 차단(로그인, 로봇 확인, 봇 탐지)은 보지 못했습니다. robots.txt에 규칙이 없어도 에이전트가 막힐 수 있습니다.
- 보통 페이지 주소 하나(/sample-page)로만 판단했습니다. 상품, 예약, 검색 결과처럼 주소마다 규칙이 다른 사이트는 다르게 나올 수 있습니다.
- 봇 이름은 14개(학습 7, 검색 3, 대신 4)만 확인했습니다. 이 밖의 이름(xAI, 바이두 등)을 막은 것은 세지 않았습니다.
- 47곳은 이 블로그가 고른 사이트입니다. 한국 사이트 전체를 대표하지 않습니다.
- 9곳은 확인하지 못했습니다. 403 거절 4곳은 다른 방법(보통 브라우저처럼 꾸민 요청)으로 다시 받지 않았습니다.
- The Verge 기사는 앞부분만 읽었습니다. 나머지는 구독해야 볼 수 있어서, 회사별 내용은 TechCrunch 기사와 다른 보도로 확인했습니다.
- 기준 날짜는 2026년 10월 19일입니다. robots.txt는 언제든 바뀝니다.
자주 묻는 질문
robots.txt로 막으면 AI 에이전트가 정말 못 들어오나요?
robots.txt는 지킬지 말지를 봇이 정하는 안내문입니다. AI 회사들은 자기 봇이 이 안내를 어떻게 따르는지 각자 문서에 적어 둡니다. 그리고 진짜 브라우저를 움직이는 에이전트는 이름이 드러나지 않을 수 있어서, 사이트는 로그인과 봇 탐지로 따로 막습니다.
내 사이트에서 AI 봇을 막으려면 어떻게 하나요?
robots.txt에 "User-agent: GPTBot"처럼 봇 이름을 적고 아래에 "Disallow: /"를 적습니다. 학습만 막고 검색은 받고 싶다면 학습 봇 이름(GPTBot, ClaudeBot, Google-Extended 등)만 적습니다. 이름을 적은 봇은 모든 봇(*)에 대한 규칙을 무시하니, 막고 싶은 다른 경로도 그 묶음에 다시 적어야 합니다.
네이버는 AI 봇을 막나요?
www.naver.com의 robots.txt는 첫 화면 말고는 모든 봇을 막습니다. 구글 봇도 같은 규칙을 받습니다. AI 봇만 따로 막은 것은 아닙니다. 블로그, 뉴스처럼 다른 주소를 쓰는 서비스는 이 글에서 확인하지 않았습니다.
은행 일을 AI 에이전트에게 맡겨도 되나요?
JP모건체이스와 찰스슈왑은 보안 때문에 밖의 에이전트가 계좌에 들어오는 것을 막는다고 밝혔습니다. 은행이 허락한 연결이 아니라면 맡기지 않는 편이 안전합니다.
출처
- The Verge, Websites are closing their doors to AI agents (2026-10-17): https://www.theverge.com/ai-artificial-intelligence/1013195/ai-agents-blocked-web
- TechCrunch, The next hurdle for AI agents: getting websites to let them in (2026-10-06): https://techcrunch.com/2026/10/06/the-next-hurdle-for-ai-agents-getting-websites-to-let-them-in/
- The Verge, JPMorgan Chase is keeping AI agents out (2026-10-14): https://www.theverge.com/ai-artificial-intelligence/1010962/jpmorgan-chase-is-keeping-ai-agents-out
- Cloudflare 변경 기록, AI 트래픽 설정(2026-07-01): https://developers.cloudflare.com/changelog/post/2026-07-01-ai-traffic-options/
- Cloudflare 개발 문서, Block AI Bots: https://developers.cloudflare.com/bots/additional-configurations/block-ai-bots/
- 긱뉴스, 웹사이트들이 AI 에이전트에 문을 닫고 있음: https://news.hada.io/topic?id=35590
한국 사이트 47곳과 해외 사이트 7곳의 robots.txt 원문, 확인 스크립트, 결과 표는 2026년 10월 19일에 받은 그대로 보관하고 있습니다.
댓글 0개