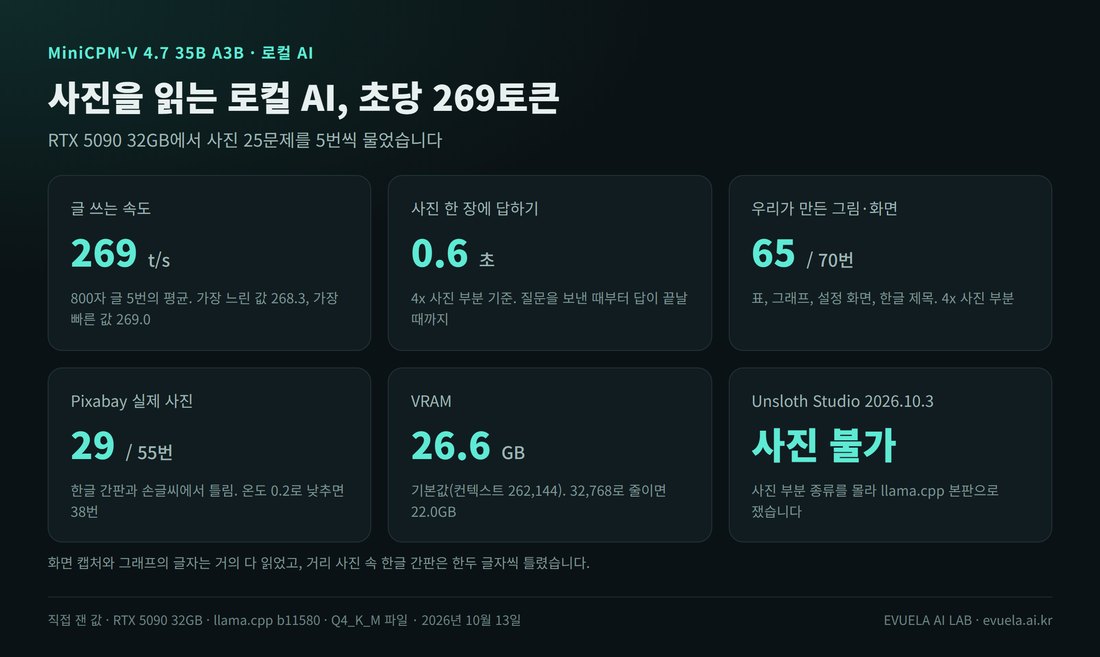
MiniCPM-V 4.7 35B A3B는 사진과 영상을 읽고 글로 답하는 공개 모델입니다. RTX 5090 32GB에서 사진 25문제를 5번씩 물어보니 표, 그래프, 화면 캡처는 70번 중 65번 맞혔고, Pixabay에서 받은 실제 사진은 55번 중 29번 맞혔습니다. 속도는 초당 269토큰이고, 사진 한 장을 넣고 답을 다 받는 데 0.6초쯤 걸렸습니다.
- Unsloth Studio 2026.10.3에서는 사진을 넣을 수 없었습니다. 사진 부분의 종류(minicpmv4_7)를 아직 모릅니다. 그래서 llama.cpp 본판 b11580으로 쟀습니다.
- 작은 글자는 "4x" 사진 부분으로 바꿔야 읽습니다. 기본 사진 부분은 "Unsloth Studio"를 "Unslot Studio"로, "Qwen3.8"을 "Qwen3-8"로 읽었습니다. 4x로 바꾸면 5번 모두 맞혔습니다.
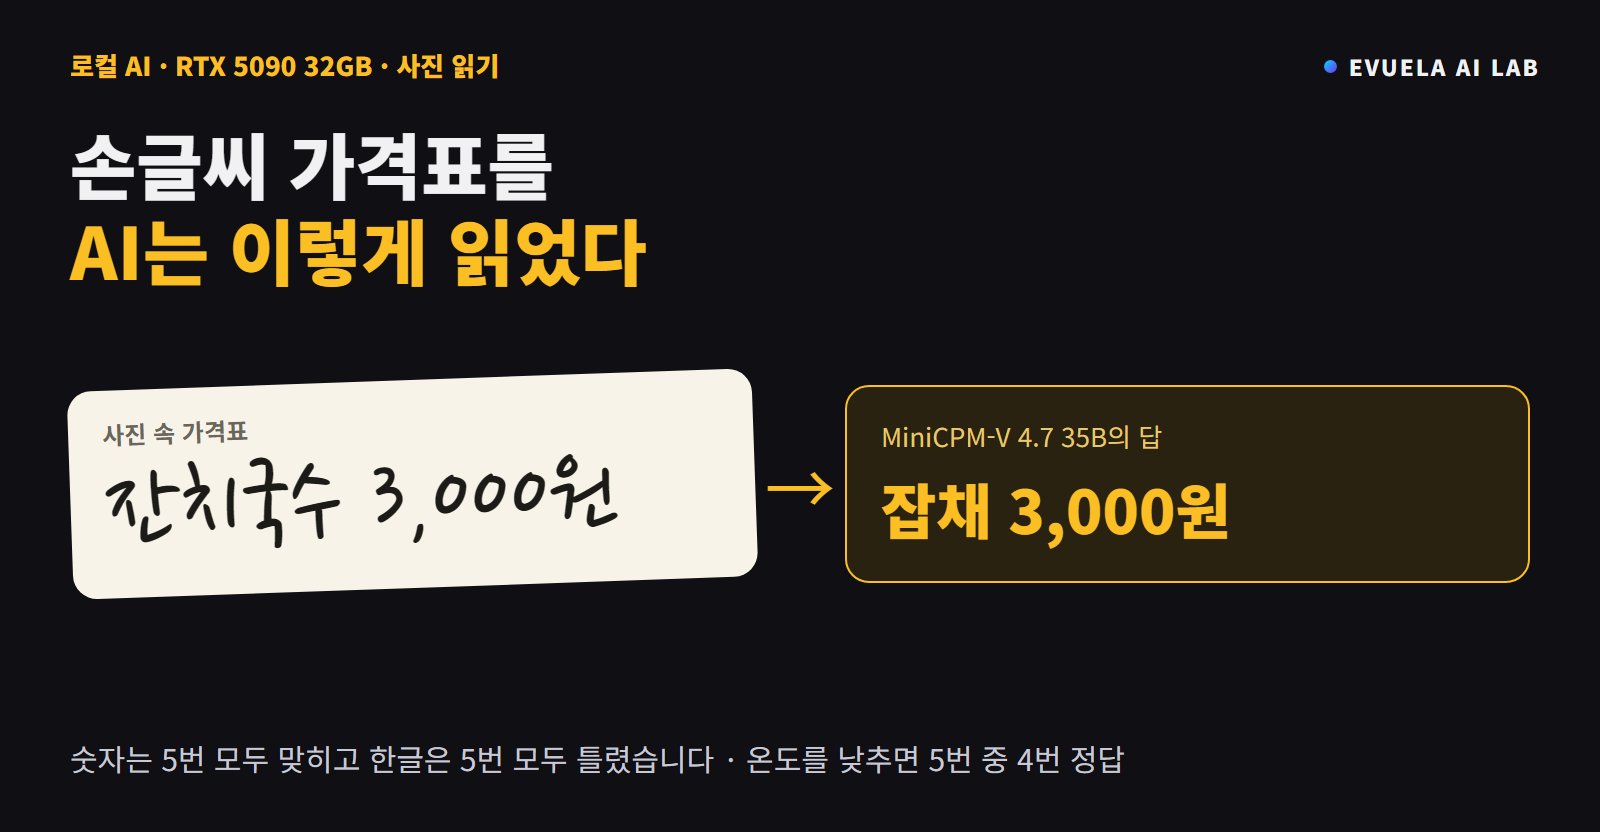
- 거리 사진의 한글 간판과 손글씨는 자주 틀렸습니다. 붓글씨 간판, 손으로 쓴 가격표, 간판이 빽빽한 밤거리에서 한두 글자씩 다르게 읽었습니다.
- 온도를 0.2로 낮추면 실제 사진 정답이 29번에서 38번으로 늘었습니다. 이 모델 파일의 기본 온도는 1.0입니다.
- 한국어 글을 쓰게 하면 한자와 일본어 글자가 섞였습니다. 800자 글 5번 모두 그랬고, 설정 세 가지를 바꿔도 없어지지 않았습니다.
- VRAM은 기본값에서 26.6GB입니다. 컨텍스트를 32,768로 줄이면 22.0GB입니다. 16GB 그래픽카드에는 이 파일(Q4_K_M)이 다 들어가지 않습니다.
이 글의 숫자는 모두 RTX 5090 32GB PC 한 대에서 2026년 10월 13일에 직접 잰 값입니다. 프로그램은 llama.cpp 본판의 llama-server(b11580)이고, 모델 파일은 제작사가 올린 Q4_K_M입니다. 화면이 아니라 API로 같은 질문을 시드만 바꿔 여러 번 보냈습니다. 제작사가 안내하는 transformers 코드로는 재지 않았습니다.
이 글의 내용을 20초로 요약한 영상입니다(소리 없음).
RTX 5090 32GB에서 잰 결과입니다.
MiniCPM-V 4.7 35B A3B는 무엇인가요?
MiniCPM-V는 중국 OpenBMB가 만드는 사진 읽기 모델 묶음입니다. 사진이나 영상을 넣고 글로 물으면 글로 답합니다. 그림을 그려 주는 모델은 아닙니다. 4.7판의 35B A3B는 허깅페이스에 10월 초에 올라왔고, 모델 카드는 이렇게 소개합니다.
"the first MoE model in the MiniCPM-V series" (MiniCPM-V 4.7 모델 카드)
MoE는 모델 전체를 다 쓰지 않고 토큰마다 일부만 골라 쓰는 구조입니다. 이름의 35B는 전체 크기가 350억 파라미터라는 뜻이고, A3B는 그중 한 번에 쓰는 부분이 30억쯤이라는 뜻입니다. 그래서 크기에 비해 빠릅니다. 이 블로그가 RTX 5060 Ti에서 잰 Qwen3.6 35B A3B와 같은 방식이고, 파일에 적힌 구조 이름(qwen35moe)도 같습니다.
| 항목 | 내용 |
|---|---|
| 만든 곳 | OpenBMB |
| 넣을 수 있는 것 | 글, 사진 한 장, 사진 여러 장, 영상 |
| 크기 | 35B (한 번에 쓰는 부분 약 3B) |
| 라이선스 | Apache 2.0 |
| 이번에 쓴 파일 | MiniCPM-V-4_7-35B-A3B-Q4_K_M.gguf 21.2GB |
| 사진 부분 파일 | 기본 mmproj-model-f16.gguf 1.12GB, 4x mmproj-model-f16-4x.gguf 0.91GB |
| 기본 컨텍스트 | 262,144 |
이 표가 뜻하는 것: 모델 파일 하나에 사진 부분 파일을 하나 붙여서 씁니다. 사진 부분은 두 가지가 있고, 어느 것을 붙이느냐에 따라 작은 글자를 읽는 능력이 달라졌습니다.
사진 부분 두 가지의 차이는 사진 한 장을 토큰 몇 개로 바꾸느냐입니다. 기본 사진 부분은 사진을 많이 줄여서 적은 토큰으로 넘기고, 4x 사진 부분은 네 배쯤 많은 토큰으로 넘깁니다. 토큰이 많으면 자세히 보지만 그만큼 시간과 컨텍스트를 씁니다.
왜 Unsloth Studio가 아니라 llama.cpp로 쟀나요?
이 블로그는 모델 테스트를 Unsloth Studio로 합니다. 이번에는 그렇게 할 수 없었습니다. Unsloth Studio 2026.10.3이 이 모델의 사진 부분을 아직 모르기 때문입니다.
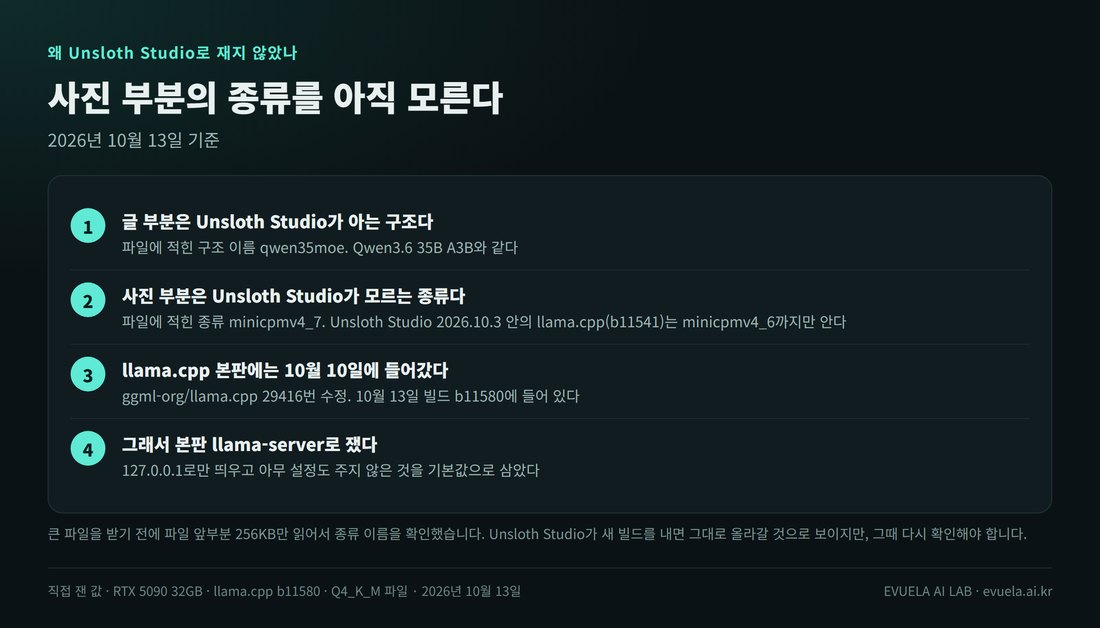
21GB 파일을 받기 전에 먼저 확인한 내용입니다.
확인한 방법은 이렇습니다. 허깅페이스에서 파일 전체를 받지 않고 앞부분 256KB만 읽으면 파일에 적힌 종류 이름을 볼 수 있습니다. 글 부분은 qwen35moe, 사진 부분은 minicpmv4_7이었습니다. 그다음 Unsloth Studio 설치 폴더에 있는 llama.cpp 소스에서 이 이름을 찾았습니다. minicpmv4_6까지만 있었습니다.
llama.cpp 본판에는 10월 10일에 4.7 지원이 들어갔습니다. Unsloth가 내놓은 가장 새 빌드는 10월 11일 것인데 여기에는 아직 없습니다. 그래서 llama.cpp 공식 릴리스의 윈도우용 빌드 b11580을 따로 받아 이 PC 안에서만 접속되는 주소로 띄웠습니다.
Unsloth Studio를 쓰시는 분은 이 모델을 올리면 글로 묻고 답하는 것은 되고, 사진을 넣으면 오류가 납니다. Unsloth Studio가 새 llama.cpp를 넣은 판을 내면 될 것으로 보이지만, 그때 다시 확인해야 합니다. 프로그램을 Unsloth Studio로 정한 이유는 LM Studio에서 Unsloth Studio로 바꾼 글에 적어 두었습니다.
테스트 PC와 방법
| 항목 | 내용 |
|---|---|
| 그래픽카드 | NVIDIA GeForce RTX 5090 (VRAM 32GB), 드라이버 617.42 |
| 프로그램 | llama.cpp b11580 (2026-10-13 빌드, 윈도우 CUDA 13.4)의 llama-server |
| 모델 파일 | openbmb/MiniCPM-V-4.7-35B-A3B-gguf 의 Q4_K_M |
| 기본값 | 모델 파일과 사진 부분 파일만 지정하고 다른 설정은 주지 않음 |
| 기본값에서 정해진 것 | 컨텍스트 262,144, 온도 1.0, top_k 20, top_p 0.95 (모델 파일에 적힌 값) |
| 생각 | 끔(enable_thinking false)을 기준으로, 켠 것도 따로 잼 |
| 사진 문제 | 25문제, 문제마다 시드를 1~5로 바꿔 5번 |
| 날짜 | 2026년 10월 13일 |
이 표가 뜻하는 것: 아래 숫자는 llama.cpp b11580에서 잰 값입니다. 다른 프로그램이나 다른 빌드에서는 달라질 수 있습니다.
사진 문제는 정답을 미리 알고 있는 것으로 골랐습니다. 14문제는 이 블로그가 직접 만든 그림과 화면 캡처이고, 11문제는 Pixabay에서 받은 실제 사진 10장입니다. 답 형식을 정해 주고("요금: X달러, 사용량: Y배" 같은 식으로) 꼭 나와야 하는 글자가 답에 있는지로 맞고 틀림을 가렸습니다. 띄어쓰기와 대소문자는 보지 않았습니다.
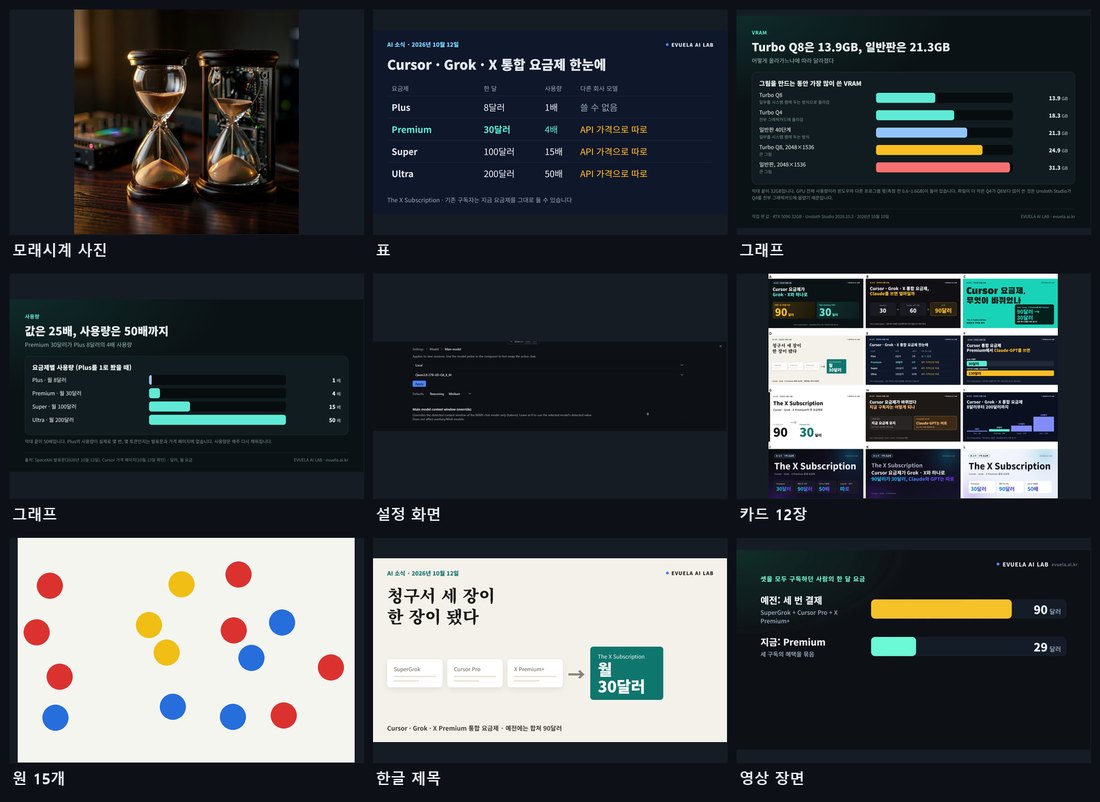
직접 만든 그림과 화면 캡처입니다. 숫자와 글자를 우리가 알고 있어서 채점이 분명합니다.
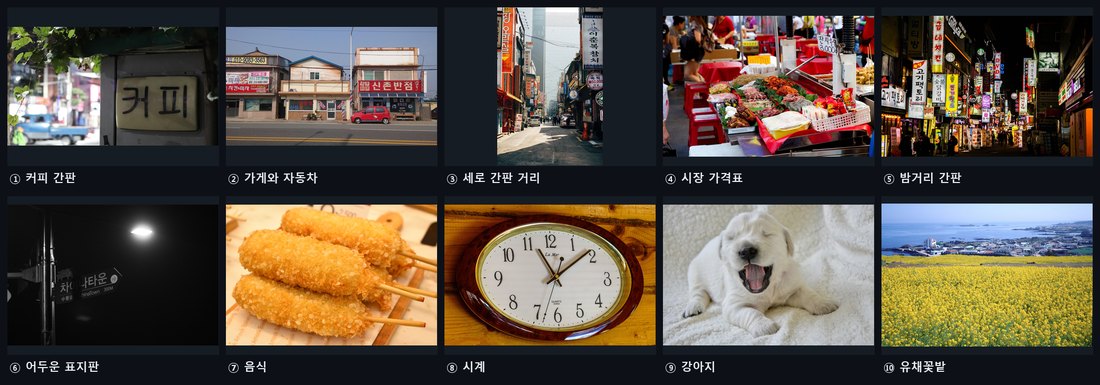
Pixabay에서 받은 사진입니다. 올린 분의 이름과 주소는 글 끝에 있습니다.
글 쓰는 속도와 VRAM은 얼마인가요?
사진을 넣지 않고 글만 쓰게 했을 때의 값입니다. 다른 글과 같은 질문("집에 있는 PC로 AI 모델을 돌릴 때 알아야 할 점"을 800자로)을 5번 보냈습니다.
| 항목 | 값 |
|---|---|
| 생성 속도 (생각 끔, 5번) | 평균 268.7 t/s (가장 느린 값 268.3, 가장 빠른 값 269.0) |
| 800자 글 한 편 (생각 끔) | 평균 1.8초 (1.6~1.9초) |
| 800자 글 한 편 (생각 켬, 3번) | 평균 3.3초. 답이 나오기 시작할 때까지 0.9~1.4초 |
| 첫 글자까지 | 0.1초 |
| 모델이 쓴 VRAM | 26.6GB (올리기 전 1.6GB, 올린 뒤 28.1GB) |
| 글 쓰는 동안 GPU | 사용률 평균 76%, 전력 평균 241W, 가장 높은 값 271W, 온도 52도까지 |
| PC 전체 램 | 가장 높았을 때 41.0GB |
| 올리는 데 걸린 시간 | 10.3초 (파일이 이미 한 번 읽힌 상태) |
이 표가 뜻하는 것: 800자 글이 2초 안에 나옵니다. 생각을 켜도 3초대입니다. 같은 PC에서 잰 Gemma 4 12B의 초당 233토큰보다 빠릅니다.
올리는 시간 10.3초는 받은 파일을 검사하느라 이미 한 번 읽은 뒤에 잰 값입니다. PC를 켠 직후 처음 올릴 때는 21GB를 디스크에서 읽어야 해서 더 걸립니다. 그 시간은 재지 못했습니다.
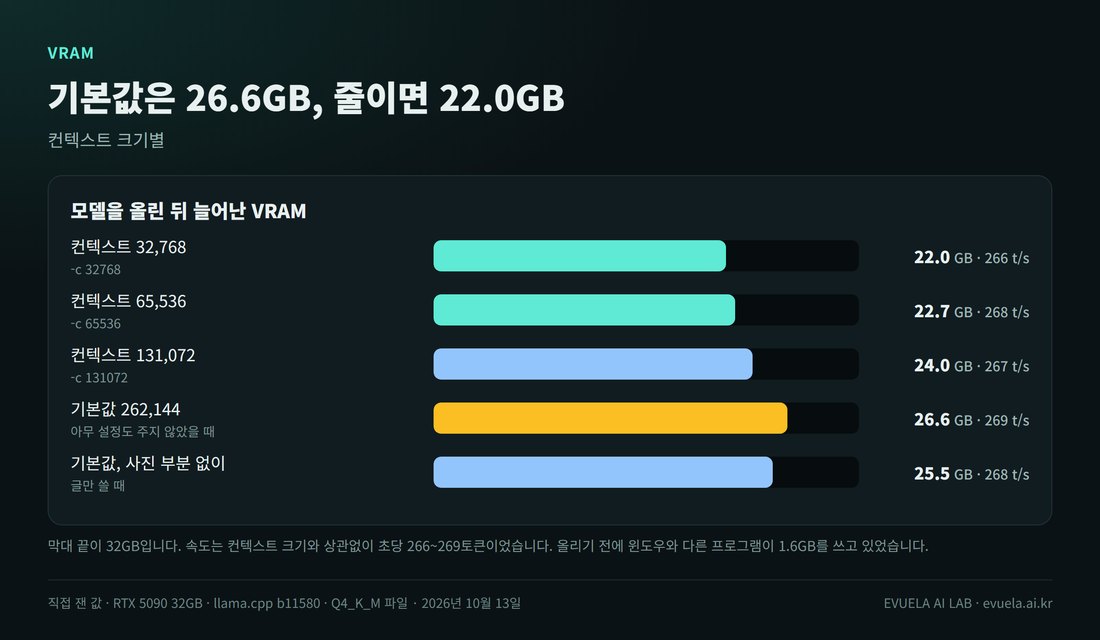
컨텍스트를 줄이면 VRAM이 줄고 속도는 그대로였습니다.
기본값은 컨텍스트를 모델이 받을 수 있는 가장 큰 값(262,144)으로 잡습니다. 그래서 VRAM을 26.6GB 씁니다. 컨텍스트를 32,768로 정해 주면 22.0GB로 줄고, 속도는 달라지지 않았습니다. 사진 부분이 쓰는 VRAM은 1.1GB쯤입니다(26.6GB와 25.5GB의 차이).
16GB 그래픽카드에는 이 파일이 다 들어가지 않습니다. 가장 작게 잡아도 22GB이기 때문입니다. 제작사가 15.5GB짜리 더 작은 파일도 올려 두었는데, 이번에는 받지 않았습니다.
이 글을 쓰기 전에 같은 모델을 RTX 그래픽카드에서 잰 다른 측정을 찾아봤습니다. 모델 카드, GGUF 저장소, 웹 검색을 봤지만 찾지 못했습니다. 제작사가 밝힌 속도는 아이폰 17 Pro Max에서 초당 13토큰이라는 값 하나뿐이고, 조건이 달라 비교할 수 없습니다. 이 블로그의 110번 글은 같은 구조의 Qwen3.6 35B A3B를 RTX 5060 Ti에서 초당 90토큰으로 쟀는데, 그래픽카드와 프로그램과 파일 종류가 모두 달라서 이것도 참고만 하시기 바랍니다.
우리가 만든 그림과 화면 캡처는 얼마나 읽었나요?
표, 그래프, 프로그램 설정 화면처럼 컴퓨터가 그린 깨끗한 글자입니다. 기본 사진 부분으로는 70번 중 51번, 4x 사진 부분으로는 70번 중 65번 맞혔습니다.
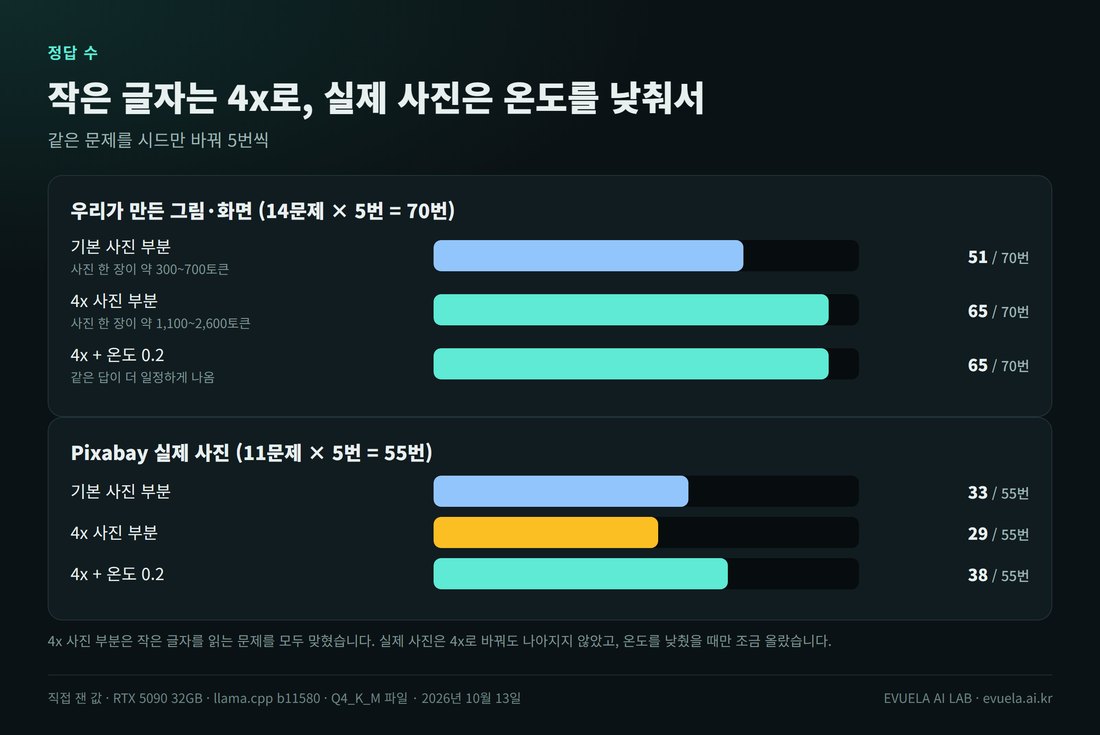
작은 글자는 4x로 바꾸면 읽었고, 실제 사진은 4x로 바꿔도 나아지지 않았습니다.
| 문제 | 정답 | 기본 사진 부분 | 4x 사진 부분 |
|---|---|---|---|
| 모래시계 사진 설명 | 모래시계 | 5/5 | 5/5 |
| 표에서 한 줄 읽기 | 100달러, 15배 | 5/5 | 5/5 |
| 표에서 조건에 맞는 줄 찾기 | Plus | 5/5 | 5/5 |
| 그래프에서 가장 큰 값 | 일반판 2048×1536, 31.3GB | 5/5 | 5/5 |
| 그래프 맨 아래 작은 글자 | Unsloth Studio 2026.10.3 | 0/5 | 5/5 |
| 막대가 가장 짧은 것과 긴 것 | Plus 1배, Ultra 50배 | 5/5 | 5/5 |
| 설정 화면의 모델 이름 | Qwen3.8-27B-UD-Q4_K_M | 0/5 | 5/5 |
| 설정 화면의 값 두 개 | Medium, 0 | 5/5 | 5/5 |
| 카드가 몇 장인가 | 12 | 5/5 | 5/5 |
| 표가 든 카드의 알파벳 | E | 1/5 | 5/5 |
| 색깔별 원의 개수 | 빨강 7, 파랑 5, 노랑 3 | 0/5 | 0/5 |
| 큰 한글 제목 옮겨 적기 | 청구서 세 장이 한 장이 됐다 | 5/5 | 5/5 |
| 그림 두 장에 공통인 숫자 | 90, 30 | 5/5 | 5/5 |
| 영상 장면 8장 | EVUELA AI LAB, Cursor 요금제 | 5/5 | 5/5 |
이 표가 뜻하는 것: 기본 사진 부분이 틀린 것은 모두 작은 글자였습니다. 4x로 바꾸면 그 세 문제를 모두 맞혔습니다. 원의 개수만 두 가지 모두에서 틀렸습니다.
기본 사진 부분이 작은 글자를 틀린 모습
기본 사진 부분의 답은 그럴듯해서 틀린 줄 모르고 넘어가기 쉽습니다. 그래프 아래의 "Unsloth Studio 2026.10.3"을 "Unslot Studio", "Unsold Studio", "Unsplash Studio"로 읽었고, 버전 숫자는 5번 모두 맞혔습니다. 설정 화면의 "Qwen3.8-27B-UD-Q4_K_M"은 5번 모두 "Qwen3-8-27B-UD-Q4_K_M"으로 읽었습니다. 점 하나를 줄표로 바꾼 것입니다.
모델 이름이나 버전처럼 한 글자가 중요한 것을 화면 캡처에서 읽게 할 때는 4x 사진 부분을 쓰는 편이 안전합니다.
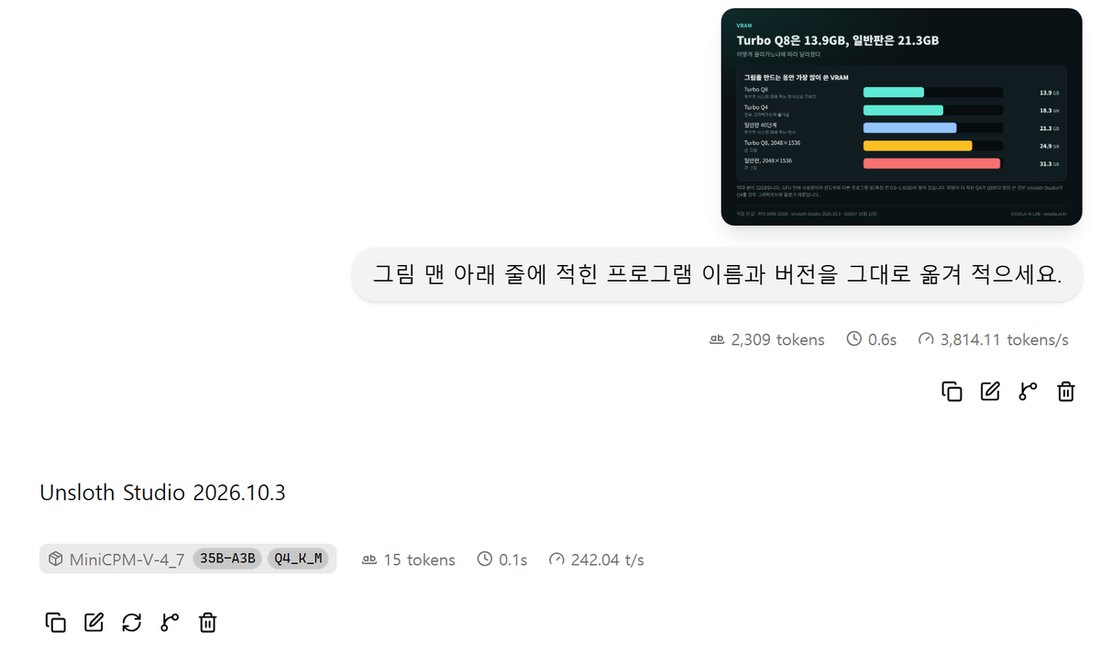
4x 사진 부분으로 그래프 아래의 작은 글자를 읽은 화면입니다.
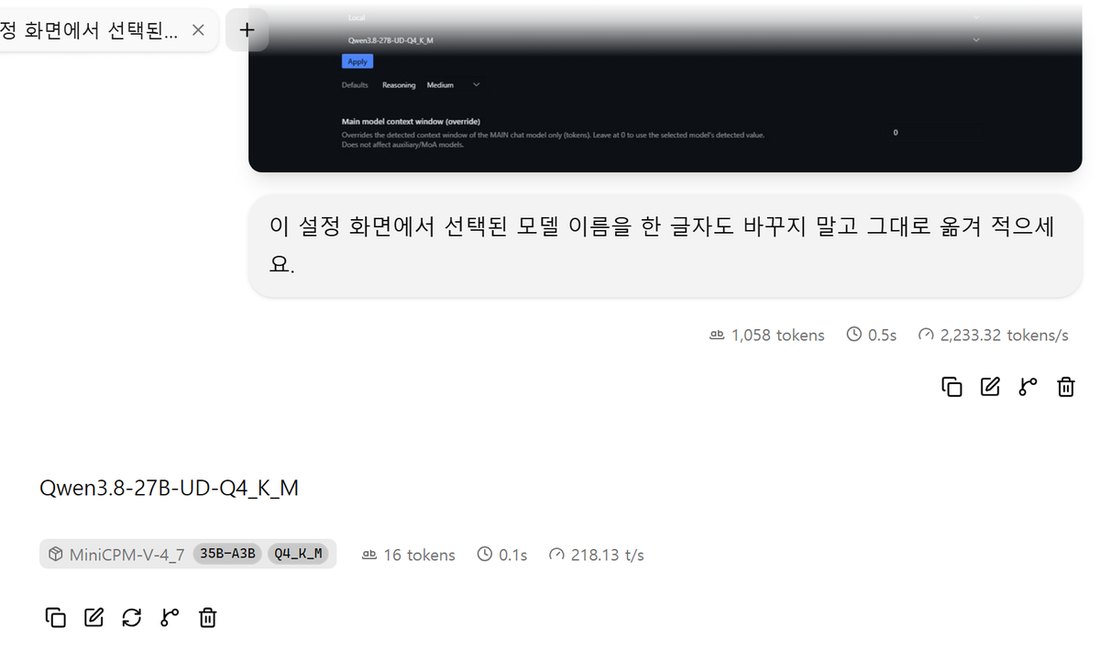
4x 사진 부분으로 설정 화면의 모델 이름을 읽은 화면입니다.
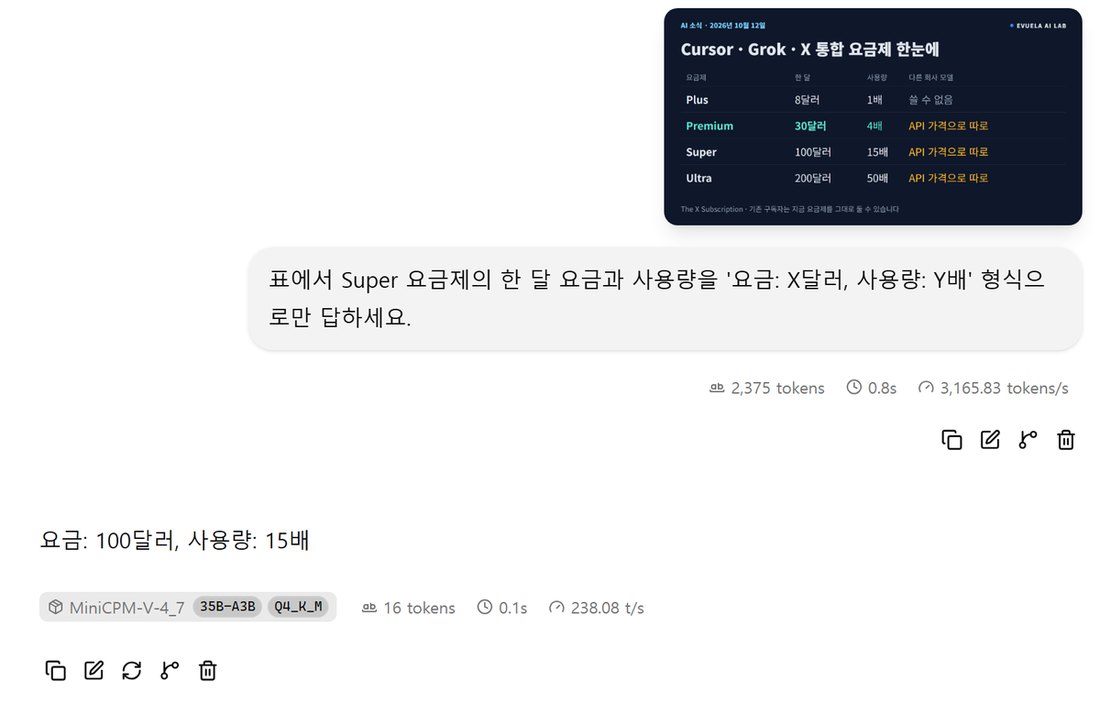
표에서 한 줄을 읽은 화면입니다.
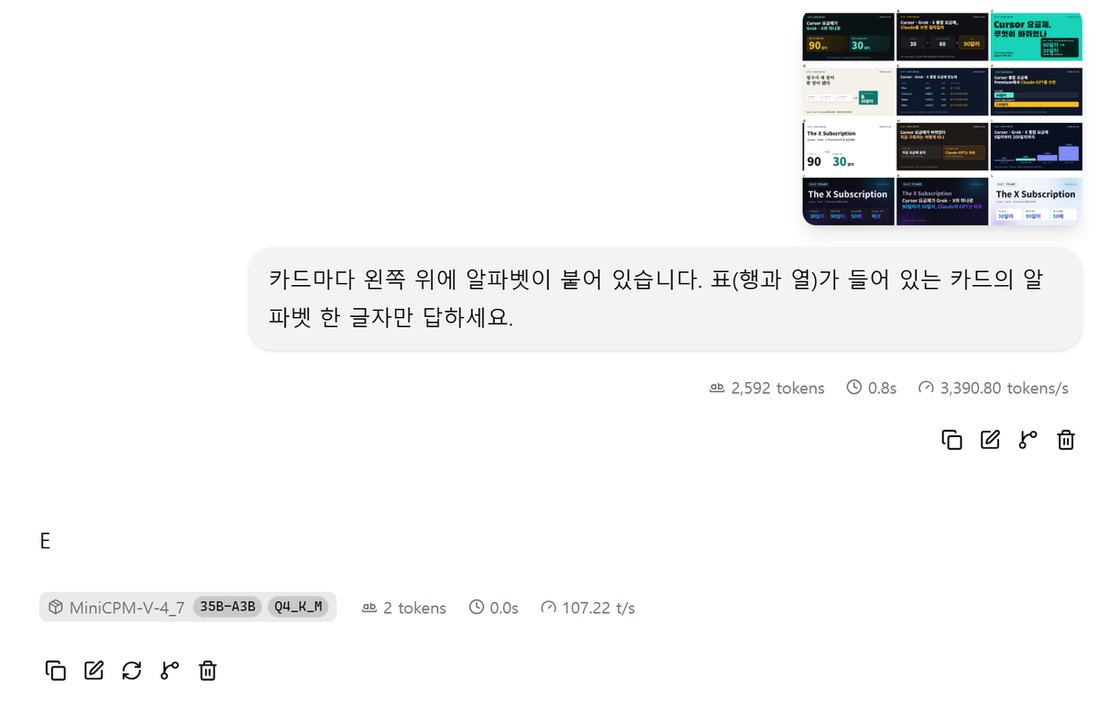
카드 12장 가운데 표가 든 카드를 찾은 화면입니다.
원의 개수는 설정을 바꿔도 틀렸습니다
흰 바탕에 빨강 7개, 파랑 5개, 노랑 3개의 원을 겹치지 않게 그린 그림입니다. 기본 사진 부분, 4x, 온도를 낮춘 것 모두 "빨강 6, 파랑 5, 노랑 3"이라고 답했습니다. 15번 모두 같은 답입니다. 생각을 켜면 원을 하나씩 세는 글을 4,000자 넘게 쓰고도 틀렸습니다.
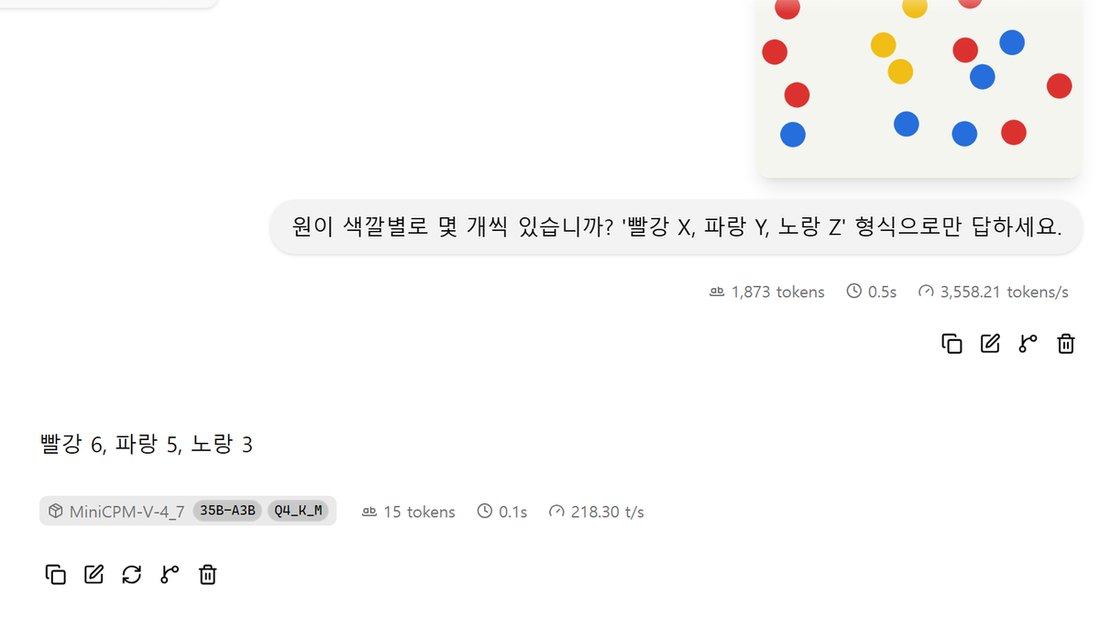
빨간 원은 7개인데 6개라고 답했습니다.
Pixabay 실제 사진은 얼마나 읽었나요?
카메라로 찍은 사진입니다. 글자가 기울어 있거나, 손으로 썼거나, 어둡거나, 여러 개가 겹쳐 있습니다. 4x 사진 부분으로 55번 중 29번 맞혔습니다.
| 사진 | 물은 것 | 정답 | 기본 | 4x | 4x + 온도 0.2 |
|---|---|---|---|---|---|
| ① 커피 간판 | 간판의 한글 | 커피 | 5/5 | 5/5 | 5/5 |
| ② 가게와 자동차 | 빨간 간판의 이름, 자동차 색 | 신촌반점, 빨간색 | 3/5 | 0/5 | 0/5 |
| ③ 세로 간판 거리 | 붓글씨 가게 이름 | 이춘복참치 | 0/5 | 0/5 | 0/5 |
| ③ 같은 사진 | 둥근 간판의 요금 두 개 | 50,000원, 20,000원 | 5/5 | 5/5 | 5/5 |
| ④ 시장 가격표 | 손글씨 음식 이름과 값 | 잔치국수, 3,000원 | 0/5 | 0/5 | 4/5 |
| ⑤ 밤거리 간판 | 가게 이름 두 개 | 고기팩토리, 굽네치킨 | 0/5 | 0/5 | 0/5 |
| ⑥ 어두운 표지판 | 지명과 거리 | 차이나타운, 300m | 5/5 | 5/5 | 5/5 |
| ⑦ 음식 | 이름과 개수 | 핫도그(콘도그), 4개 | 1/5 | 0/5 | 4/5 |
| ⑧ 시계 | 글자판의 상표 | La Mer | 5/5 | 5/5 | 5/5 |
| ⑨ 강아지 | 무엇이 무엇을 하나 | 강아지, 하품 | 4/5 | 4/5 | 5/5 |
| ⑩ 유채꽃밭 | 풍경 설명 | 유채꽃(노란 꽃), 바다 | 5/5 | 5/5 | 5/5 |
| 합계 | 33/55 | 29/55 | 38/55 | ||
이 표가 뜻하는 것: 숫자와 영어, 크고 반듯한 한글은 다 읽었습니다. 틀린 것은 붓글씨, 손글씨, 작은 간판이 여러 개 겹친 사진의 한글입니다. 4x로 바꿔도 이 부분은 나아지지 않았습니다.
잘 읽은 사진
어두운 밤에 찍은 표지판의 "차이나타운 300M"은 세 가지 설정 모두에서 15번 다 맞혔습니다. 숙박 요금이 적힌 둥근 간판의 "50,000"과 "20,000", 시계 글자판의 작은 상표 "La Mer"도 한 번도 틀리지 않았습니다. 풍경과 동물 설명도 내용이 사진과 맞았습니다.
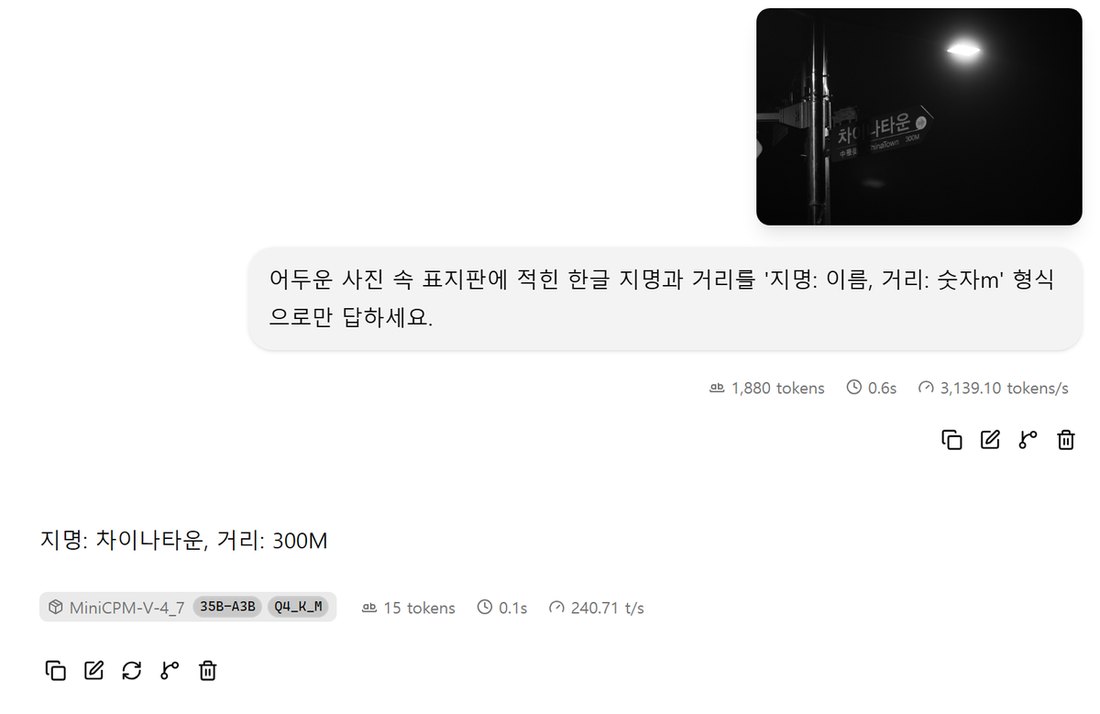
어두운 사진 속 표지판을 읽은 화면입니다.
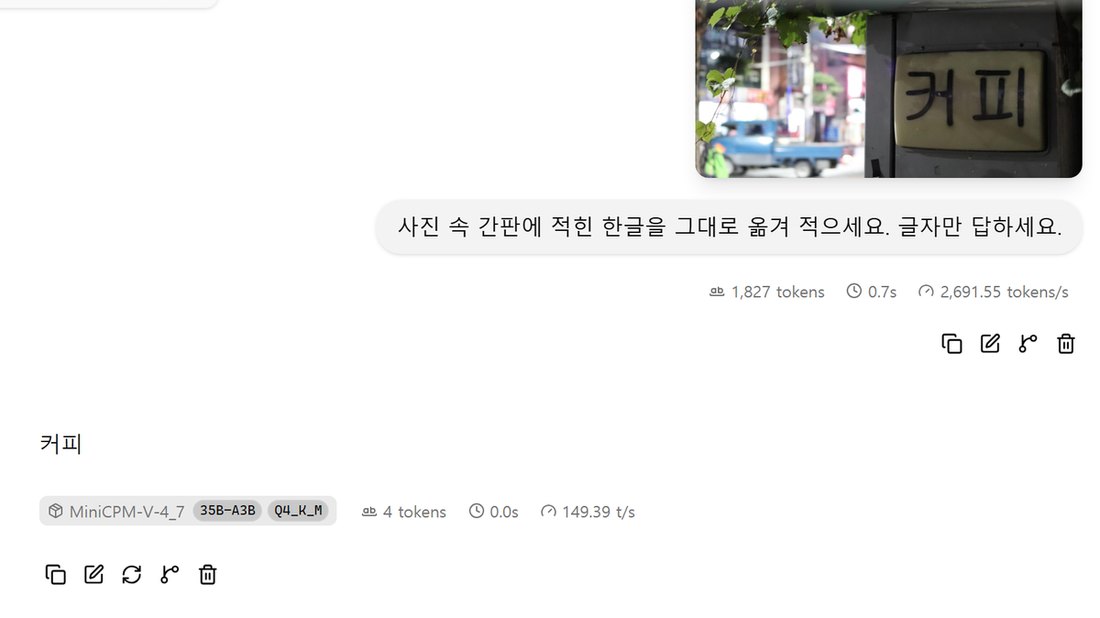
크고 반듯한 한글은 바로 읽었습니다.
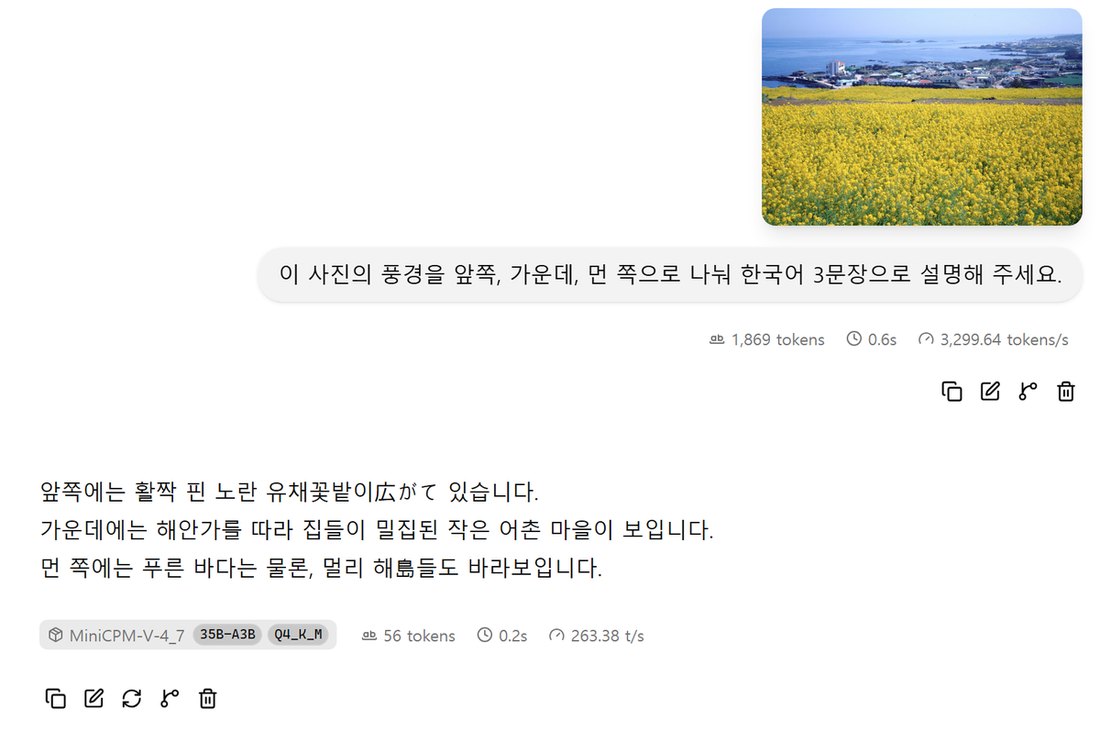
풍경 설명은 맞았습니다. 다만 이 답에도 일본어 글자와 한자가 한 군데씩 섞였습니다.
틀린 사진: 붓글씨, 손글씨, 빽빽한 간판
틀린 답을 그대로 적습니다.
| 사진 | 정답 | 모델이 낸 답 (4x, 5번) |
|---|---|---|
| ③ 붓글씨 세로 간판 | 이춘복참치 | 이춘부참치, 이층부참치, 이층부침개, 이 춘부 찹치, 이 춘부 Chopchi |
| ④ 손글씨 가격표 | 잔치국수 3,000원 | 잡채 3,000원, 자치카루 3,000원, 잡치파우 3,000원, 짠치커 3,000원 |
| ⑤ 밤거리 간판 | 고기팩토리, 굽네치킨 | 고기패토리, 고기 파토리, 고기 패토리 (5번 모두 틀림) / 굽네치킨으로 맞힌 답과 곰네치킨, 꿀네치킨이 섞임 |
| ② 빨간 간판 | 신촌반점 | 신촌비빔밥 (5번 모두) |
| ⑦ 음식 이름 | 핫도그 4개 | 개수 4개는 맞히고, 이름을 "콜드ogs"나 중국어로 답함 |
이 표가 뜻하는 것: 글자 수와 첫 글자는 대체로 맞고, 가운데 한두 글자가 다릅니다. 숫자(3,000원, 4개)는 맞히면서 한글만 틀리는 것이 눈에 띕니다. "신촌반점"을 "신촌비빔밥"으로 읽은 것처럼, 못 읽은 글자를 그럴듯한 낱말로 채우는 답도 있었습니다.
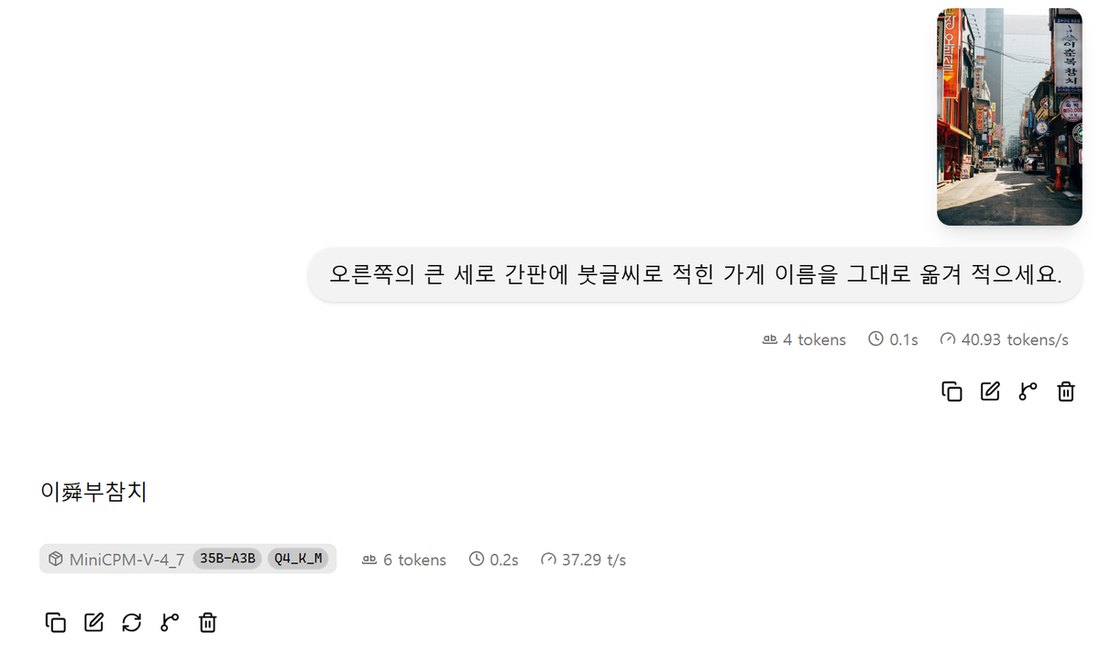
붓글씨 세로 간판을 틀리게 읽은 화면입니다.
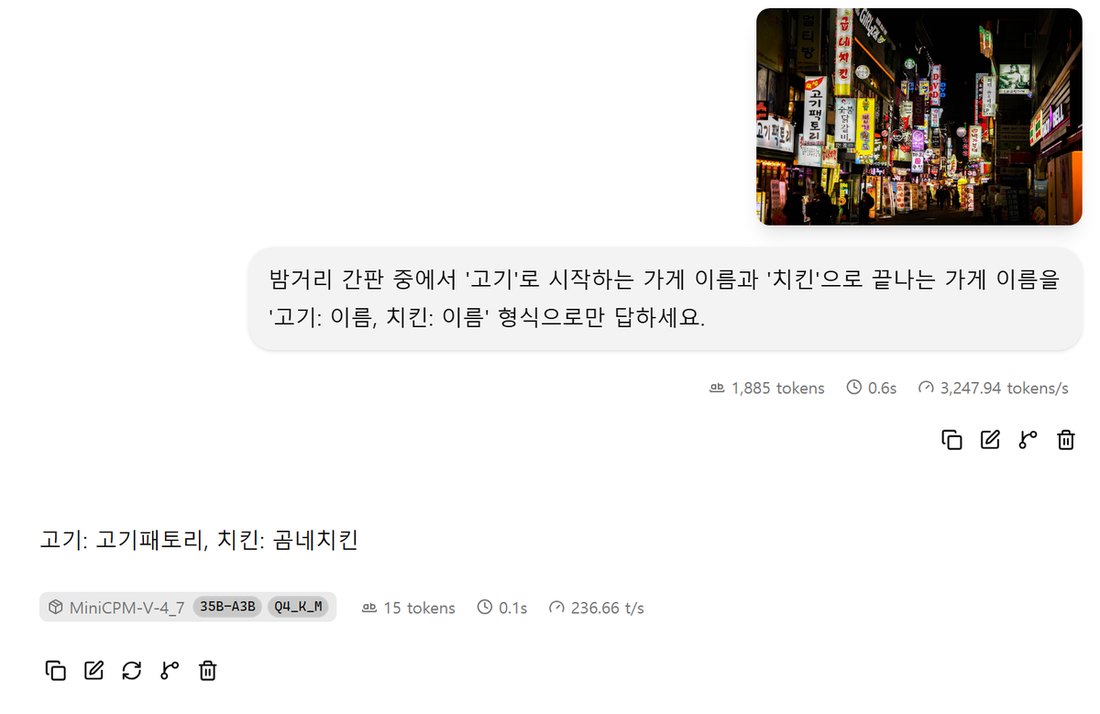
밤거리 간판은 한 글자씩 틀렸습니다.
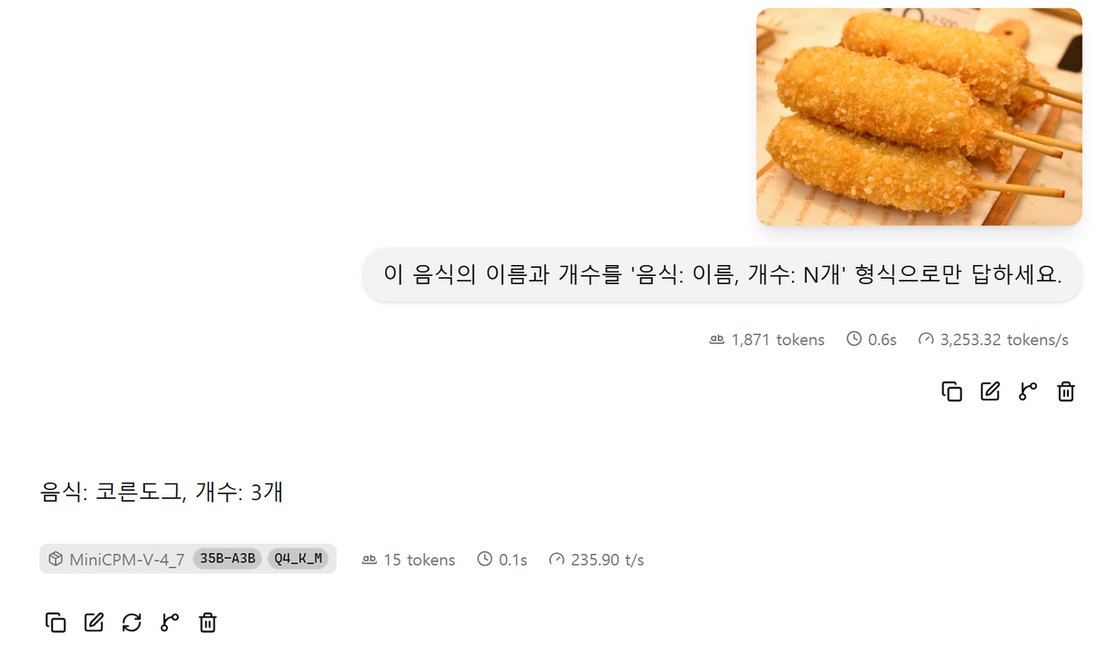
이 화면에서는 개수를 3개라고 답했습니다. 꼬치는 4개입니다.
웹 화면에서 한 번씩 다시 물었을 때는 답이 조금씩 달랐습니다. 시장 가격표는 API로 5번 물었을 때 모두 틀렸는데, 화면에서 물었을 때는 "잔치국수 3,000원"이라고 맞혔습니다. 온도가 1.0이라 같은 사진에도 답이 바뀝니다. 그래서 이 글의 정답 수는 화면이 아니라 API로 5번씩 물은 결과로 적었습니다.
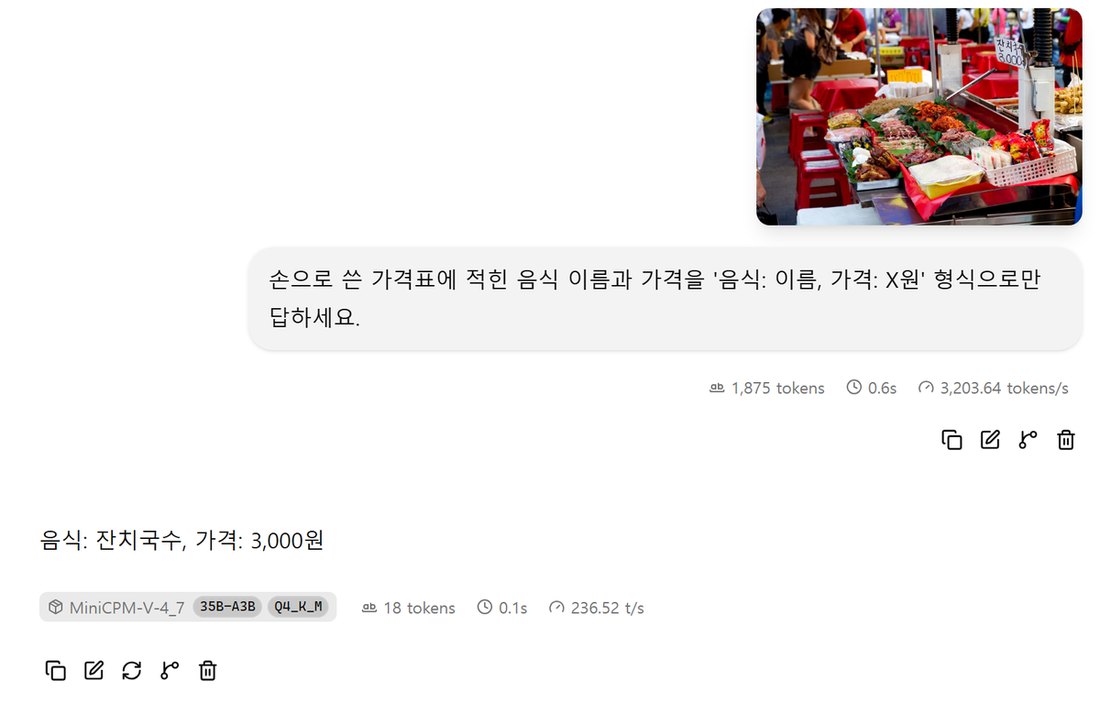
화면에서 물었을 때는 맞혔습니다. 같은 질문을 API로 5번 보냈을 때는 모두 틀렸습니다.
틀릴 때 무엇을 바꿔 보면 되나요?
세 가지를 바꿔서 다시 쟀습니다. 온도를 낮추는 것, 글자 부분만 잘라서 넣는 것, 생각을 켜는 것입니다.
온도를 0.2로 낮추면 조금 나아졌습니다
이 모델 파일에는 기본 온도가 1.0으로 적혀 있습니다. 온도는 답을 고를 때 얼마나 다양하게 고를지를 정하는 값입니다. 높으면 물을 때마다 답이 달라지고, 낮으면 가장 그럴듯한 답 하나로 모입니다. 글자를 읽는 일에는 낮은 쪽이 맞습니다.
4x 사진 부분에 온도만 0.2로 낮춰 같은 문제를 다시 물으니 실제 사진 정답이 55번 중 29번에서 38번으로 늘었습니다. 손글씨 가격표가 0번에서 4번, 음식 이름이 0번에서 4번으로 올랐습니다. 붓글씨 간판과 밤거리 간판, "신촌반점"은 온도를 낮춰도 5번 모두 틀렸습니다. 온도를 낮추면 틀린 답도 하나로 모입니다. 붓글씨 간판은 5번 모두 "이춘부참치"였습니다.
llama-server 웹 화면에서는 왼쪽 톱니바퀴(Settings)를 누르고 Sampling & Penalties에서 Temperature 칸에 0.2를 적은 뒤 Save settings를 누릅니다. 칸이 비어 있으면 모델 파일의 기본값(1)을 씁니다.
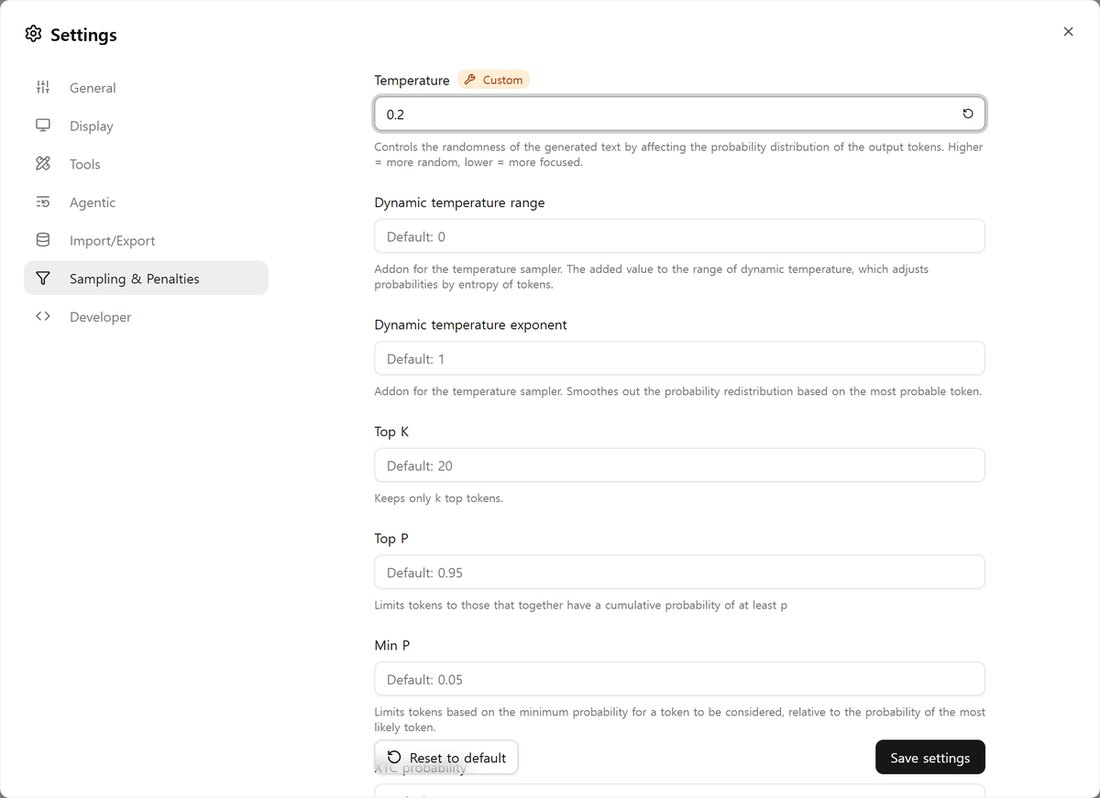
온도를 0.2로 바꾸는 곳입니다. 적고 나서 Save settings를 눌러야 적용됩니다.
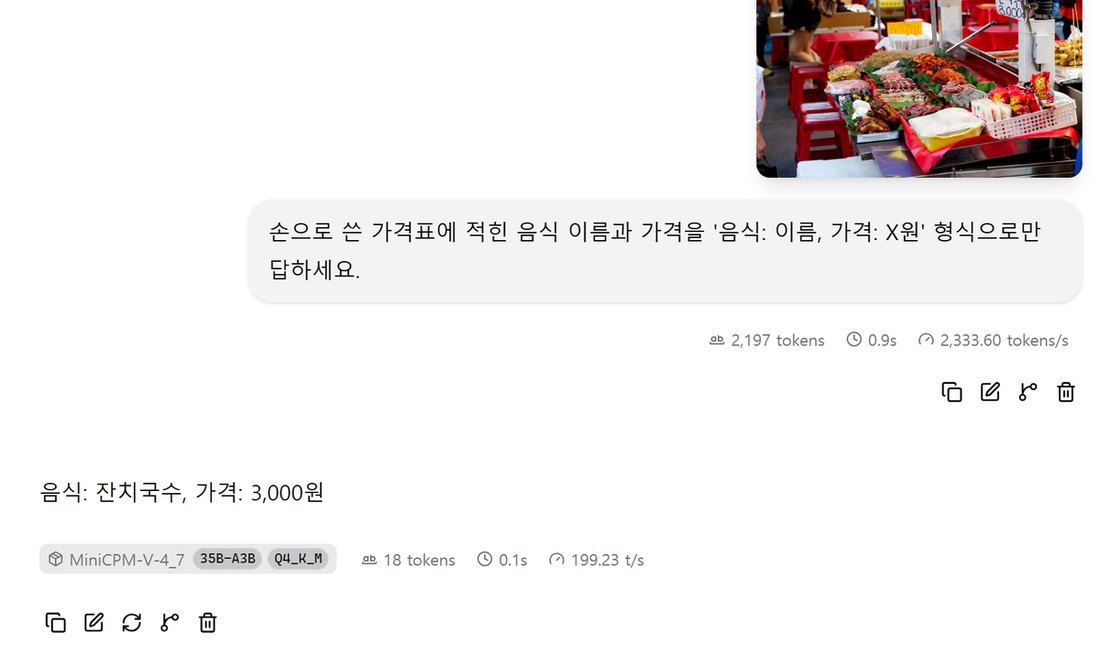
온도를 0.2로 저장한 뒤 같은 사진을 다시 물은 화면입니다.
글자 부분만 잘라서 넣으면 사진에 따라 달랐습니다
사진 전체가 아니라 글자가 있는 부분만 잘라서 같은 질문을 했습니다.
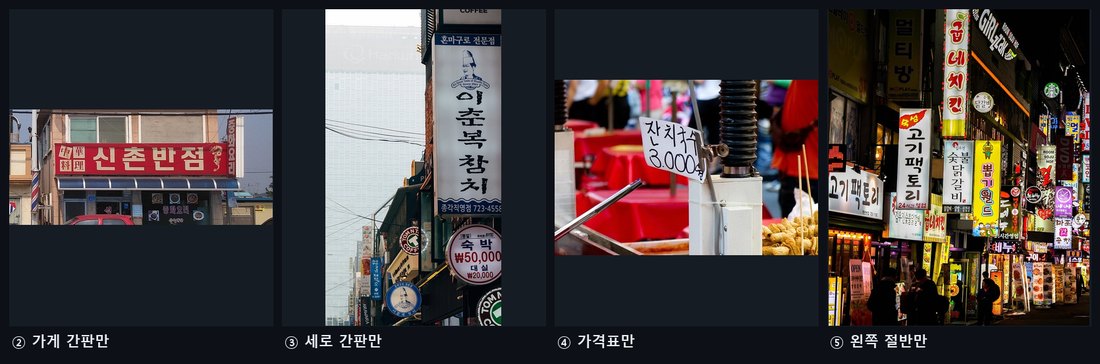
원래 사진에서 글자 부분만 잘라 낸 것입니다.
| 사진 | 전체 사진 (4x) | 잘라 낸 사진 (4x) | 잘라 낸 사진 + 온도 0.2 |
|---|---|---|---|
| ② 신촌반점 | 0/5 | 5/5 | 5/5 |
| ④ 잔치국수 3,000원 | 0/5 | 2/5 | 1/5 |
| ③ 이춘복참치 | 0/5 | 0/5 | 0/5 |
| ⑤ 고기팩토리, 굽네치킨 | 0/5 | 0/5 | 0/5 |
이 표가 뜻하는 것: 글자가 반듯한데 사진에서 작게 찍힌 경우(신촌반점)는 잘라 넣으면 읽습니다. 붓글씨처럼 글자 모양이 어려운 경우는 잘라 넣어도 못 읽었습니다.
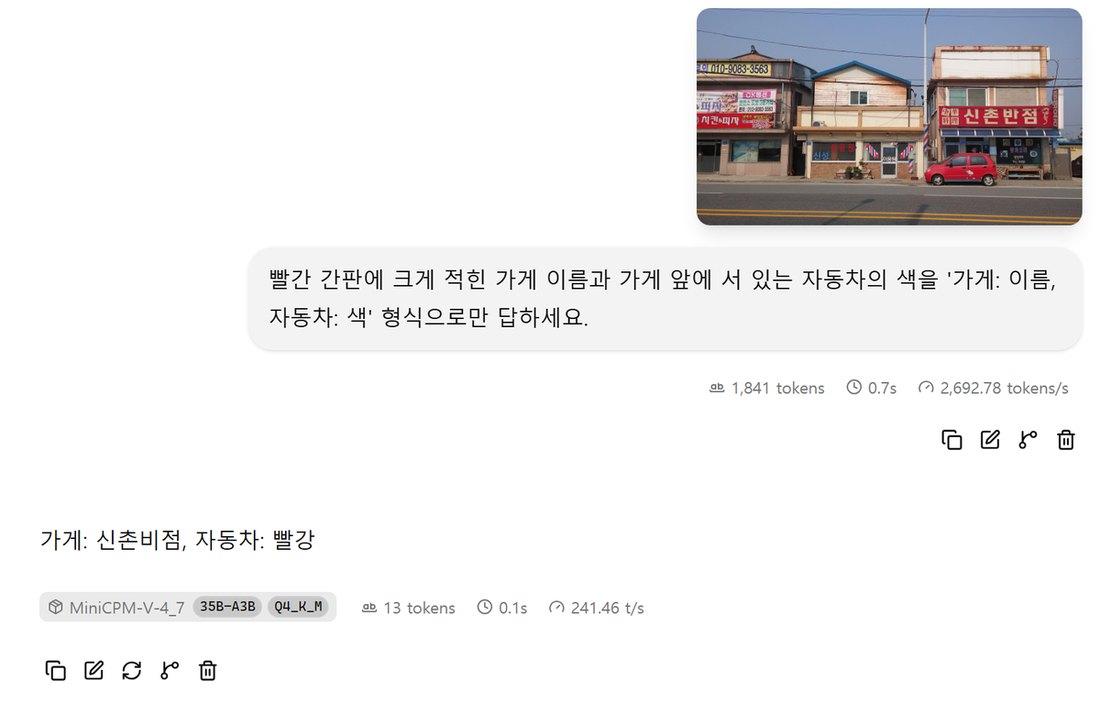
전체 사진에서는 가게 이름을 틀렸습니다.
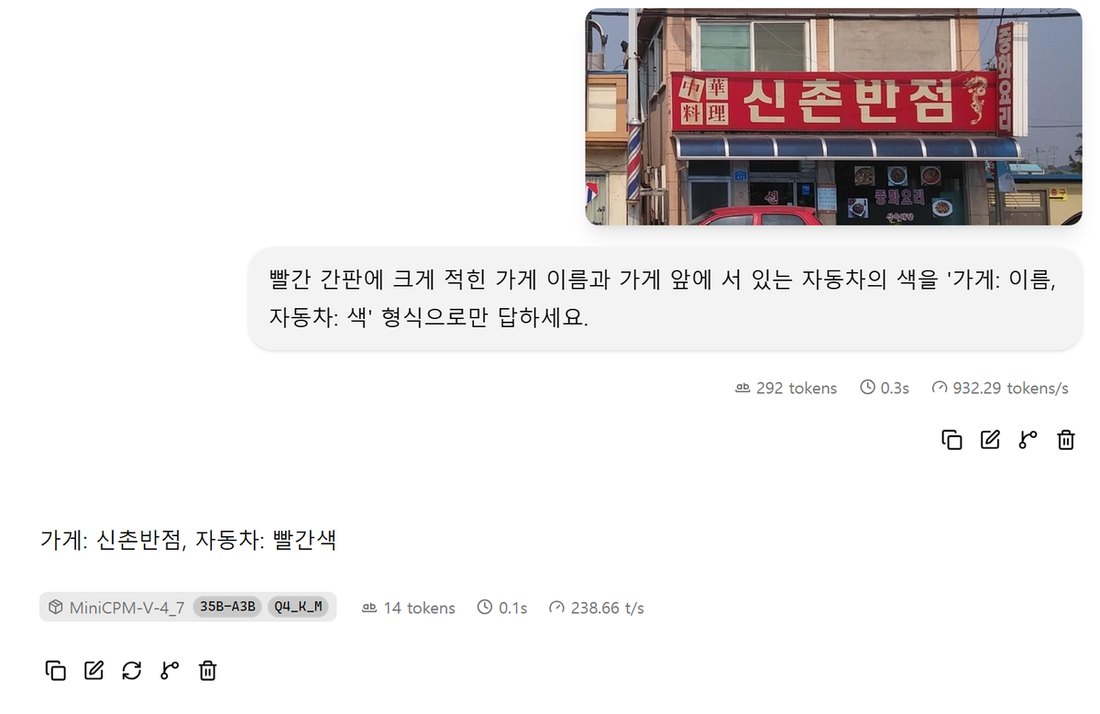
간판 부분만 잘라 넣으니 맞혔습니다.
생각을 켜도 더 맞히지 않았습니다
생각을 켜고 같은 25문제를 3번씩 물었습니다. 기본 사진 부분은 75번 중 47번, 4x는 75번 중 52번이었습니다. 생각을 껐을 때(5번 기준 125번 중 84번과 94번)와 비율이 거의 같거나 조금 낮습니다.
생각을 켜면 다른 문제가 생겼습니다. 답 형식을 정해 줬는데도 "To determine the selected model name, look at…"처럼 영어로 풀이를 쓰는 답이 많았습니다. 한국어로 물었는데 영어로 답하고, 정해 준 형식도 지키지 않았습니다. 사진에서 글자나 값을 뽑아내는 용도라면 생각을 끄는 편이 낫습니다.
웹 화면에서 생각을 끄는 곳은 입력 칸 아래의 전구 단추입니다. 누르면 Default, Off, Low, Medium, High, Max가 나오고, Off를 고르면 꺼집니다. 처음에는 Default(모델 기본값, 켜짐)로 되어 있습니다.
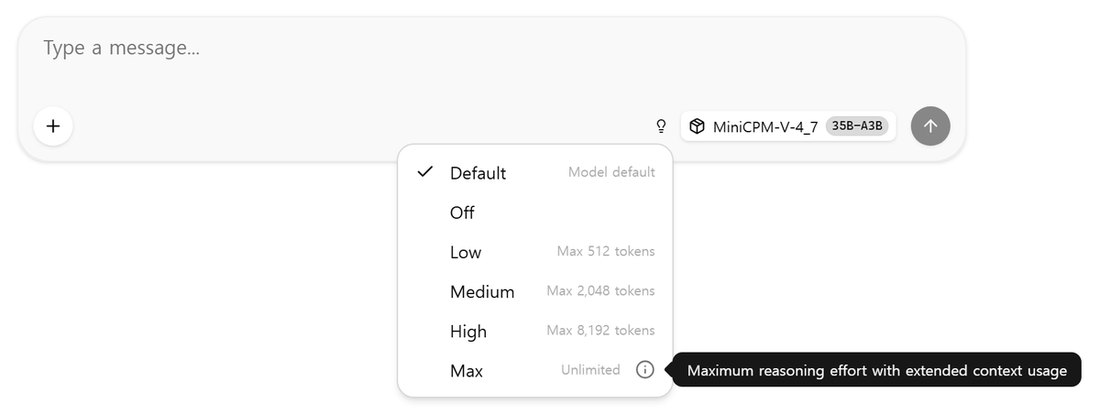
생각을 끄려면 여기서 Off를 고릅니다.
사진을 넣으면 얼마나 오래 걸리나요?
거의 기다리지 않습니다. 사진을 읽는 시간과 답을 쓰는 시간을 나눠 보면 이렇습니다.
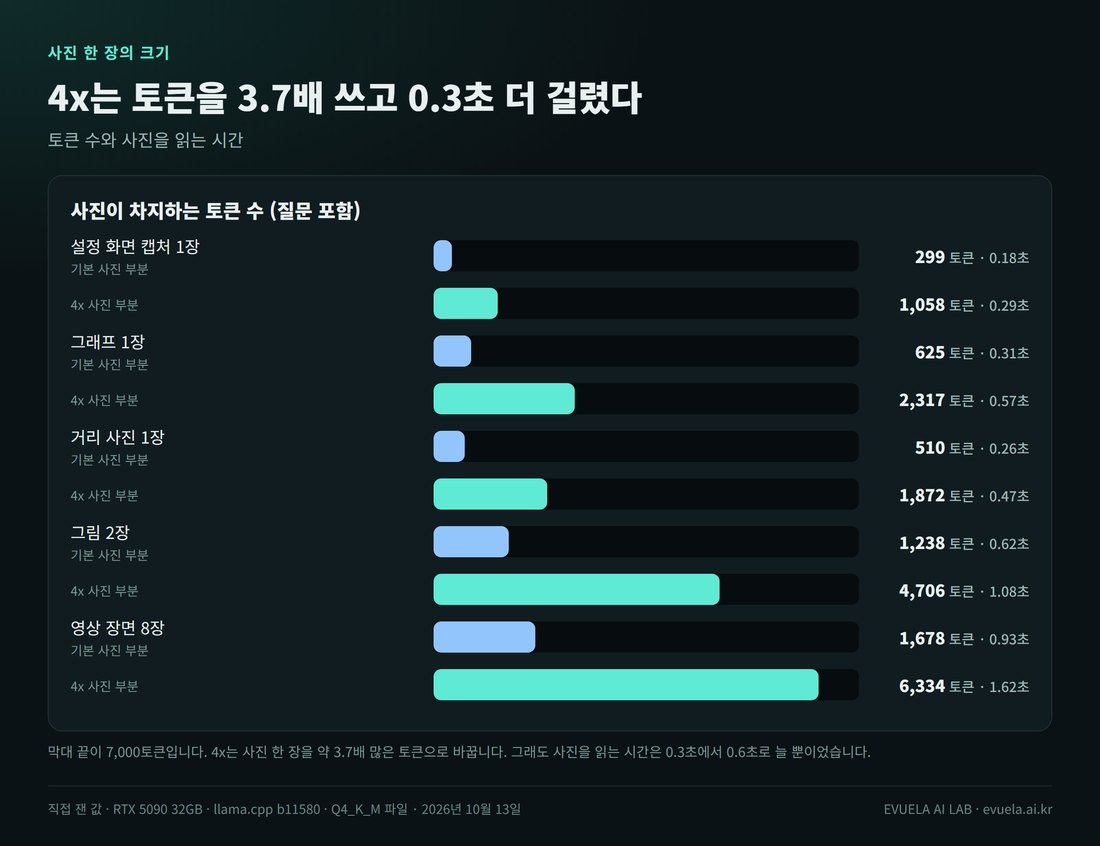
4x는 토큰을 3.7배쯤 쓰지만 시간은 0.3초쯤 더 걸릴 뿐입니다.
| 넣은 것 | 기본 사진 부분 | 4x 사진 부분 |
|---|---|---|
| 그래프 1장, 사진 읽기 | 625토큰, 0.31초 | 2,317토큰, 0.57초 |
| 그래프 1장, 답까지 전체 | 0.5초 | 0.8초 |
| 거리 사진 1장, 답까지 전체 | 0.4초 | 0.6초 |
| 그림 2장, 답까지 전체 | 0.8초 | 1.2초 |
| 영상 장면 8장, 답까지 전체 | 1.2초 | 2.0초 |
이 표가 뜻하는 것: 시간의 대부분은 사진을 읽는 데 쓰이고, 답을 쓰는 시간은 0.1초쯤입니다. 4x로 바꿔도 사진 한 장에 0.3초가 더 걸릴 뿐이라, 정확도가 필요하면 4x를 쓰지 않을 이유가 없었습니다.
영상 파일을 그대로 넣을 수 있나요?
넣을 수 있습니다. 다만 준비가 하나 필요합니다. llama-server는 영상에서 장면을 뽑을 때 ffmpeg라는 프로그램을 씁니다. ffmpeg가 없거나 위치를 모르면 이런 오류가 납니다.
"Failed to load image or audio file"
서버 기록에는 "ffprobe failed on buffer (is ffprobe in PATH?)"라고 남습니다. 서버를 띄울 때 --video-ffmpeg-dir로 ffmpeg와 ffprobe가 있는 폴더를 알려 주면 됩니다.
이 블로그가 만든 20초짜리 요약 영상(1280×720)을 넣고 "무엇을 알리는 영상인지, 크게 나온 금액은 무엇인지" 물었습니다.
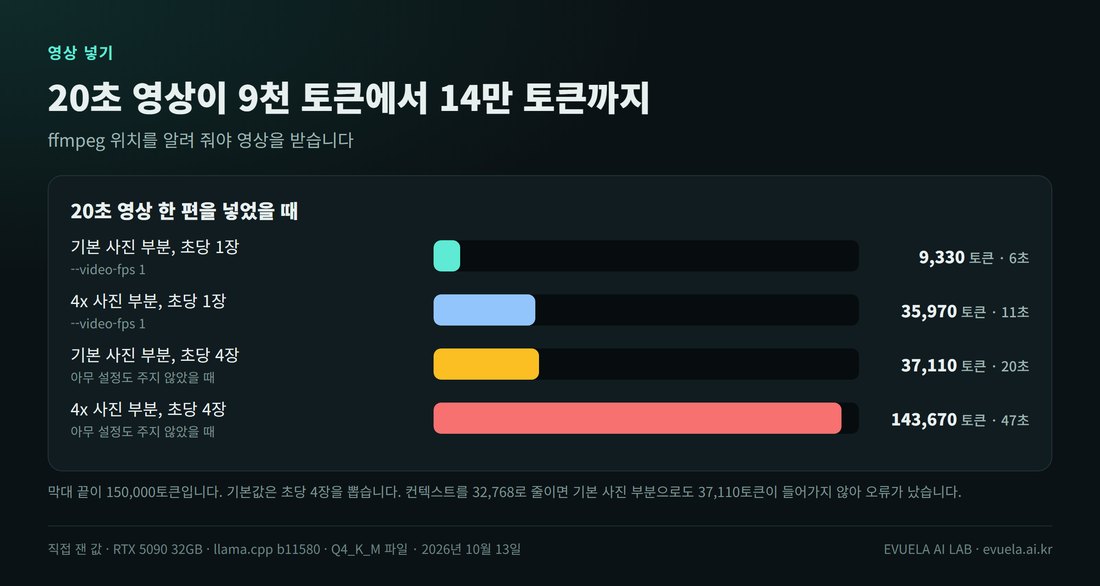
기본값은 초당 4장을 뽑습니다. 20초 영상이 80장쯤 됩니다.
| 설정 | 토큰 수 | 답까지 걸린 시간 | 답 |
|---|---|---|---|
| 기본 사진 부분, 초당 4장 (기본값) | 37,110 | 20초 | 내용 맞음. 금액은 숫자가 올라가는 중간값까지 적음 |
| 4x, 초당 4장 | 143,670 | 47초 | 내용 맞음. 중간값을 더 많이 적음 |
| 기본 사진 부분, 초당 1장 | 9,330 | 6초 | 3번 중 1번은 "60달러가 증가한다"고 반대로 답함 |
| 4x, 초당 1장 | 35,970 | 11초 | 내용 맞음 |
| 컨텍스트 32,768, 기본 사진 부분, 초당 4장 | 37,110 | 오류 | 컨텍스트보다 커서 받지 않음 |
이 표가 뜻하는 것: 20초 영상 하나가 설정에 따라 9천 토큰에서 14만 토큰까지 됩니다. 영상을 넣을 생각이면 컨텍스트를 줄이지 않거나, 초당 뽑는 장수를 줄여야 합니다.
영상이 무엇을 알리는지는 네 가지 설정 모두 맞게 답했습니다. Cursor 요금제가 Grok, X와 합쳐졌고 기존 구독자는 저절로 바뀌지 않는다는 내용입니다. 금액은 조금 달랐습니다. 이 영상에는 숫자가 0에서 90까지 올라가는 움직임이 있는데, 초당 4장을 뽑으면 "0, 33, 63, 82, 89, 90"처럼 올라가는 중간 숫자까지 모두 읽어서 적었습니다. 틀린 것은 아니지만 "크게 나온 금액"을 물은 뜻과는 다릅니다.
컨텍스트를 32,768로 줄인 서버에 같은 영상을 넣으면 이 오류가 납니다.
"request (37110 tokens) exceeds the available context size (32768 tokens), try increasing it"
VRAM을 아끼려고 컨텍스트를 줄였다면 20초 영상도 기본값으로는 들어가지 않습니다.
한국어 글쓰기는 어떤가요?
속도는 빠르지만 글에 외국 글자가 섞입니다. 800자 글을 5번 쓰게 했더니 5번 모두 한자나 일본어 글자가 들어갔습니다. 한 번은 태국 글자와 아랍 글자도 나왔습니다.
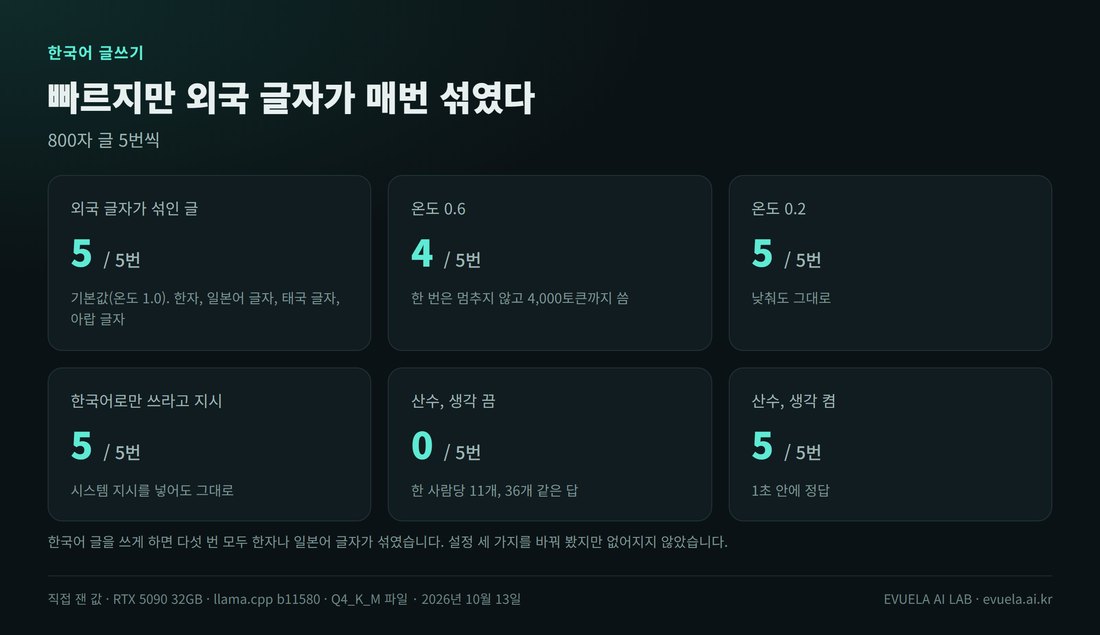
설정을 바꿔도 외국 글자는 없어지지 않았습니다.
| 설정 | 외국 글자가 섞인 글 | 섞여 나온 글자의 예 |
|---|---|---|
| 기본값 (온도 1.0) | 5번 중 5번 | 体验冷却, ポイントを预处理 |
| 온도 0.6 | 5번 중 4번 | 驱动轻量. 나머지 한 번은 멈추지 않고 17,000자를 씀 |
| 온도 0.2 | 5번 중 5번 | ゲーミング, 轻量级 |
| "한국어로만 답하고 한자와 일본어 글자를 쓰지 마세요"라고 지시 | 5번 중 5번 | 强大的技术等 |
이 표가 뜻하는 것: 온도를 낮추거나 지시를 넣는 것으로는 고쳐지지 않았습니다. 한국어로 긴 글을 쓰게 하는 용도로는 권하기 어렵습니다.
섞이는 모양은 이렇습니다. 문장은 한국어인데 낱말 하나가 중국어나 일본어로 바뀝니다. 없는 소설의 줄거리를 물었을 때도 "윤서하가 2018년에発表した 장편소설"처럼 일본어가 끼어들었습니다. 사진 설명에서도 가끔 나옵니다. 위의 유채꽃밭 화면에 그 모습이 찍혀 있습니다.
온도 0.6에서 한 번은 글을 끝내지 않고 정해 둔 한도인 4,000토큰까지 계속 썼습니다. 17,334자였습니다. 다섯 번 가운데 한 번이라 자주 있는 일인지는 더 재 봐야 압니다.
다른 기본 측정 결과도 적어 둡니다.
| 항목 | 결과 |
|---|---|
| 산수 (정답: 한 사람당 10개, 남는 것 3개), 생각 끔 | 5번 중 0번. "11개, 4개", "36개, 1개" 같은 답 |
| 산수, 생각 켬 | 5번 중 5번. 평균 0.8초 |
| 없는 소설의 줄거리 묻기, 생각 끔 | 3번 모두 "그런 소설은 없다"고 답함(지어내지 않음) |
| 없는 소설, 생각 켬 | 줄거리 정보가 없다고 답했지만, 그 소설이 실제로 있는 것처럼 말함 |
| 3,000자 글 요약 | 입력 1,486토큰, 첫 글자까지 0.3초 |
| 15,000자 글 요약 | 입력 7,402토큰, 첫 글자까지 1.0초 |
| 50,000자 글 요약 | 입력 22,146토큰, 첫 글자까지 3.0초 |
이 표가 뜻하는 것: 계산이 들어가는 질문은 생각을 켜야 맞힙니다. 켜도 1초가 안 걸립니다. 긴 글은 초당 7,600토큰쯤으로 읽어서 5만 자도 3초면 읽기 시작합니다.
어떤 용도에 맞나요?
재 본 결과로는 이렇게 나눌 수 있습니다.
| 용도 | 맞는가 | 이유 |
|---|---|---|
| 화면 캡처, 표, 그래프에서 값 뽑기 | 맞음 (4x 사진 부분으로) | 원 세기를 뺀 13문제를 4x에서 65번 모두 맞힘 |
| 사진에 무엇이 있는지 설명 | 맞음 | 풍경, 동물, 물건 설명이 사진과 맞았음 |
| 사진 속 숫자와 영어 읽기 | 맞음 | 요금, 거리, 상표를 한 번도 틀리지 않음 |
| 거리 간판이나 손글씨의 한글 읽기 | 확인이 필요함 | 한두 글자씩 틀리고, 그럴듯한 낱말로 채움 |
| 개수 세기 | 맞지 않음 | 원 15개를 15번 모두 하나 적게 셈 |
| 한국어 긴 글쓰기 | 맞지 않음 | 외국 글자가 매번 섞임 |
이 표가 뜻하는 것: 컴퓨터 화면을 읽히는 일에는 빠르고 정확했습니다. 카메라로 찍은 한글과 한국어 글쓰기는 사람이 다시 봐야 합니다.
써 보실 분께 드리는 설정은 세 가지입니다. 사진 부분은 4x 파일을 붙입니다. 온도는 0.2쯤으로 낮춥니다. 값을 뽑는 용도면 생각을 끕니다. 영상을 넣을 때는 ffmpeg 위치를 알려 주고, 컨텍스트를 줄였다면 초당 장수도 함께 줄입니다.
사진 부분 파일, 컨텍스트, 영상 설정은 화면에서 바꾸는 곳이 없고 서버를 띄울 때 정합니다. 이번에 쓴 명령은 이렇습니다.
llama-server.exe -m MiniCPM-V-4_7-35B-A3B-Q4_K_M.gguf --mmproj mmproj-model-f16-4x.gguf --host 127.0.0.1 --port 8090여기에 필요한 것을 덧붙입니다.
| 바꾸려는 것 | 덧붙이는 옵션 | 이번에 잰 결과 |
|---|---|---|
| 작은 글자 읽기 | --mmproj mmproj-model-f16-4x.gguf | 작은 글자 3문제가 0/5에서 5/5로 |
| VRAM 줄이기 | -c 32768 | 26.6GB에서 22.0GB로 |
| 영상 파일 받기 | --video-ffmpeg-dir 폴더 | 없으면 영상을 넣을 때 오류 |
| 영상 토큰 줄이기 | --video-fps 1 | 20초 영상이 37,110토큰에서 9,330토큰으로 |
| 생각을 처음부터 끄기 | --chat-template-kwargs {"enable_thinking": false} | 웹 화면에서 매번 Off를 고르지 않아도 됨 |
이 표가 뜻하는 것: 온도와 생각은 화면에서, 나머지는 서버를 띄울 때 정합니다. 사진 부분 파일을 바꾸려면 서버를 내렸다가 다시 띄워야 합니다.
사진을 읽는 다른 모델의 측정은 Gemma 4 26B A4B를 잰 글에 있습니다.
이 글의 한계
- Unsloth Studio로 재지 않았습니다. 다른 글의 숫자와 프로그램이 다릅니다. llama.cpp b11580의 값입니다.
- 파일은 Q4_K_M 하나만 쟀습니다. 더 큰 파일(Q6, Q8)이나 더 작은 파일에서 한글 읽기와 외국 글자 섞임이 달라지는지는 확인하지 못했습니다.
- 사진 문제는 25개뿐입니다. 이 블로그가 고른 문제이고, 널리 쓰이는 시험 묶음이 아닙니다. 문제마다 5번, 생각을 켠 것은 3번씩 물었습니다.
- 채점은 꼭 나와야 하는 글자가 답에 있는지로 했습니다. 설명 문제는 핵심 낱말만 확인했고 나머지는 눈으로 읽었습니다.
- 음식 사진의 정답은 처음에 3개로 잘못 잡았다가 4개로 고쳤습니다. 꼬치가 4개 보입니다. 정답 수는 고친 기준으로 다시 셌습니다.
- 영상은 20초짜리 한 편, 설정마다 3번만 넣었습니다. 긴 영상은 넣어 보지 않았습니다.
- 컨텍스트별 측정과 영상 측정은 설정마다 한 번씩 올려서 쟀습니다.
- PC를 켠 직후 처음 올리는 시간은 재지 못했습니다. 10.3초는 파일이 이미 읽힌 상태의 값입니다.
- 같은 모델을 RTX 그래픽카드에서 잰 다른 측정을 찾지 못해 비교하지 못했습니다.
- 제작사가 함께 올린 추측 디코딩용 모델(DSpark)은 쓰지 않았습니다.
- 기준 날짜는 2026년 10월 13일입니다.
자주 묻는 질문
MiniCPM-V 4.7 35B A3B는 16GB 그래픽카드에서 돌아가나요?
이번에 쓴 Q4_K_M 파일은 컨텍스트를 32,768로 줄여도 VRAM을 22.0GB 씁니다. 16GB에는 다 들어가지 않습니다. 제작사가 15.5GB짜리 더 작은 파일을 올려 두었지만 이 글에서는 재지 않았습니다.
Unsloth Studio에서 쓸 수 있나요?
2026년 10월 13일 기준 Unsloth Studio 2026.10.3에서는 글로 묻고 답하는 것만 되고 사진은 넣을 수 없습니다. 사진 부분의 종류(minicpmv4_7)를 안에 든 llama.cpp가 모르기 때문입니다. llama.cpp 본판에는 10월 10일에 들어갔습니다.
기본 사진 부분과 4x 사진 부분 중 무엇을 써야 하나요?
작은 글자를 읽어야 하면 4x를 씁니다. 모델 이름과 버전 같은 작은 글자를 기본 사진 부분은 5번 모두 틀렸고 4x는 5번 모두 맞혔습니다. 4x는 사진 한 장에 0.3초쯤 더 걸립니다. 영상처럼 장면이 많으면 토큰이 3.7배가 되니 그때는 기본 사진 부분이 낫습니다.
한글 간판을 읽을 수 있나요?
크고 반듯한 글자는 읽습니다. 붓글씨 간판, 손글씨 가격표, 간판이 여러 개 겹친 사진은 한두 글자씩 틀렸습니다. 온도를 0.2로 낮추고 글자 부분만 잘라 넣으면 일부는 나아졌습니다.
영상 파일을 넣었더니 오류가 납니다.
llama-server가 ffmpeg를 찾지 못하면 "Failed to load image or audio file" 오류가 납니다. 서버를 띄울 때 --video-ffmpeg-dir로 ffmpeg와 ffprobe가 있는 폴더를 알려 줍니다. 컨텍스트보다 영상이 크다는 오류가 나면 --video-fps를 1로 줄입니다.
출처
- MiniCPM-V 4.7 35B A3B 모델 카드: https://huggingface.co/openbmb/MiniCPM-V-4.7-35B-A3B
- GGUF 파일: https://huggingface.co/openbmb/MiniCPM-V-4.7-35B-A3B-gguf
- llama.cpp의 MiniCPM-V 4.7 지원: https://github.com/ggml-org/llama.cpp/pull/29416
- llama.cpp b11580 릴리스: https://github.com/ggml-org/llama.cpp/releases/tag/b11580
- llama.cpp의 MiniCPM-V 4.7 안내 문서: https://github.com/ggml-org/llama.cpp/blob/master/docs/multimodal/minicpmv4.7.md
시험에 쓴 실제 사진은 Pixabay에서 받았고, Pixabay Content License를 따릅니다. 올린 분은 다음과 같습니다. ① heesulee81, ② ychjung, ③ viarami, ④ tragrpx, ⑤ 8minwoo, ⑥ CreativeNerdTim, ⑦ joelmarrinan, ⑧ alexei_other, ⑨ JACLOU-DL, ⑩ kimdaejeung. 사진 속 간판의 가게 이름은 글자 읽기 시험에만 썼고, 이 글은 그 가게들과 관계가 없습니다.
댓글 0개