Liquid AI가 10월 27일 공개한 LFM3-1.7B는 "Hermes Agent 같은 에이전트 프로그램에 맞춰 학습했다"고 소개된 1.7B 모델입니다. RTX 5090에서 Hermes Agent에 붙여 과제 7가지를 시켜 보니, 33번 중 28번을 해냈습니다. 같은 과제를 같은 날 Qwen3.8 27B로 돌리면 33번 모두 성공했습니다. 대신 LFM3는 VRAM을 약 5.5GB만 쓰고, 글을 초당 약 252토큰으로 만들었습니다.
- 짧은 일은 빨랐습니다. 한 문장 대답 3.8초, 파일 하나 만들기 6.7초, 800자 글 8.6초. Qwen3.8 27B는 9.7초, 9.3초, 31.7초였습니다.
- 여러 단계 작업은 5번 중 1번만 성공했습니다. 실패한 4번은 모두 "지금 폴더에 만들어 달라"는 파일을 다른 폴더 안에 만들고, 다 했다고 답했습니다.
- 긴 문서(약 10만 자)에서 숫자 찾기는 3번 중 2번 맞혔습니다. 걸린 시간은 56.6초로 Qwen3.8 27B(111.0초)의 절반이었습니다.
- 제작사 권장 설정으로 바꾸면 조금 나아졌습니다. 온도 0.1, top_k 50, 반복 벌점 1.1로 바꾸니 여러 단계 작업은 5번 중 2번, 긴 문서는 3번 모두 맞혔습니다.
- 생각을 꺼도 생각이 답에 섞여 나왔습니다. 산수 문제 5번 중 4번은 답 안에 영어 계산과 생각을 끝내는 표시(
</think>)가 그대로 나왔습니다. - 한국어 답 중간에 한자가 몇 번 섞였습니다. "写入", "时约", "软件" 같은 낱말입니다.
이 글의 숫자는 모두 RTX 5090 32GB PC 한 대에서 직접 잰 값입니다. 모델은 Unsloth Studio에 기본값으로 올렸고, Hermes Agent 과제는 명령줄에서 같은 과제를 5번씩 되풀이했습니다. 속도와 토큰 수는 엔진의 실행 기록에서 읽었습니다. 제작사가 밝힌 점수는 "제작사 측정"이라고 따로 적었습니다.
이 글의 내용을 20초로 요약한 영상입니다(소리 없음).
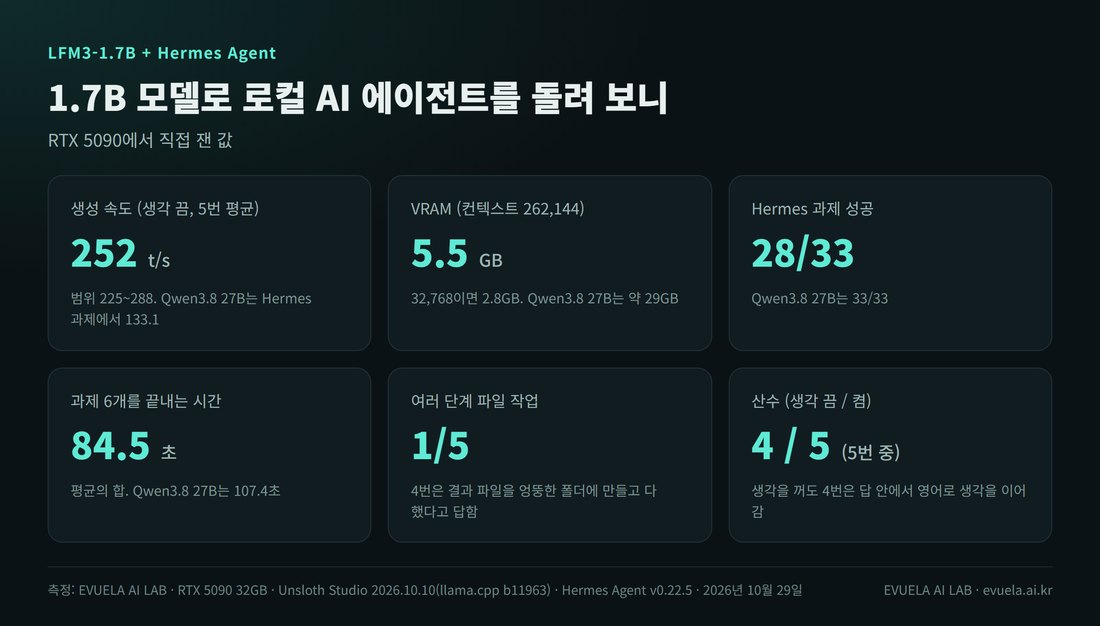
같은 날 같은 PC에서 잰 값입니다.
LFM3-1.7B는 어떤 모델인가
LFM3는 Liquid AI의 세 번째 모델 묶음입니다. 글, 사진, 음성 모델이 함께 나왔고, 그중 LFM3-1.7B는 글만 다루는 모델입니다. 모델 카드에 적힌 내용은 이렇습니다.
| 항목 | 내용 |
|---|---|
| 크기 | 1.73B. 4비트로 줄이면 약 1GB |
| 구조 | 24층. 짧은 합성곱 13층, 가까운 글만 보는 어텐션 5층, 전체를 보는 어텐션 6층 |
| 컨텍스트 | 256K 토큰(입력과 출력을 합해서) |
| 언어 | 16개. 한국어 포함 |
| 학습 목표 | Hermes Agent, Pi, OpenClaw 같은 에이전트 프로그램에서 쓰도록 추가 학습 |
| 라이선스 | LFM Open License v1.0 |
| 필요한 엔진 | llama.cpp b11960(v0.8.0) 이상 |
이 표가 뜻하는 것: 작은 모델이지만 처음부터 에이전트 일을 하라고 만든 모델입니다. 대신 모델 카드는 "작은 크기 때문에 코딩 에이전트나 복잡한 여러 단계 추론에는 권하지 않는다"고 직접 적어 두었습니다.
제작사가 밝힌 점수 가운데 도구 사용과 관련된 것은 BFCL V4 71.39, τ³-bench 68.01, ToolSandbox 80.36입니다. 지시를 따르는 정도를 보는 IFEval은 96.66입니다. 모두 제작사 측정입니다. 이 글에서는 이 점수 대신, 실제 에이전트 프로그램에서 파일을 만들고 코드를 돌리게 했을 때 어떻게 되는지를 쟀습니다.
같은 회사의 앞 모델 LFM2.5-24B-A2B는 RTX 5060 Ti 테스트 글에서 다뤘습니다. Hermes Agent를 로컬 모델에 붙이는 두 가지 방법은 Hermes Agent 두 방식 비교 글에 있습니다.
테스트 PC와 프로그램
| 항목 | 내용 |
|---|---|
| 그래픽카드 | NVIDIA GeForce RTX 5090 (VRAM 32GB), 드라이버 617.42 |
| CPU, 시스템 램 | Intel Core Ultra 9 285K, DDR5 64GB |
| 운영체제 | Windows 11 Pro |
| Unsloth Studio | 2026.10.10 (앱 v0.1.912-beta), 안의 엔진 llama.cpp b11963 |
| Hermes Agent | v0.22.5 (명령줄) |
| 모델 파일 | LiquidAI/LFM3-1.7B-GGUF의 LFM3-1.7B-Q8_0.gguf (1.85GB, 파일 지문 확인) |
| 비교 모델 | Qwen3.8 27B UD-Q4_K_M (16.2GB), 같은 Unsloth Studio, 같은 날 |
| 설정 | Unsloth Studio 기본값(Auto). 모델만 고르고 다른 설정은 주지 않음 |
| 날짜 | 2026년 10월 29일 |
이 표가 뜻하는 것: 두 모델 모두 같은 프로그램, 같은 엔진, 같은 Hermes 판에서 잰 값이라 서로 비교할 수 있습니다. 숫자는 모두 이 판에서 잰 것입니다.
Unsloth Studio에 올리기
처음에는 이 PC의 Unsloth Studio(2026.10.8) 안에 든 엔진이 llama.cpp b11798이었습니다. 모델 카드에 적힌 b11960보다 옛 판이라, Unsloth Studio를 2026.10.10으로 올리고 엔진이 b11963이 된 것을 확인한 뒤 시작했습니다. LFM3는 새 구조라서 엔진이 옛 판이면 불러오지 못할 수 있습니다.
모델 파일은 허깅페이스에서 Q8_0 하나만 받았습니다. 1.85GB를 받는 데 20초 걸렸습니다. 모델 선택 창에서 고르고 아무 설정도 바꾸지 않으면, Unsloth가 컨텍스트를 최대인 262,144로 잡습니다.
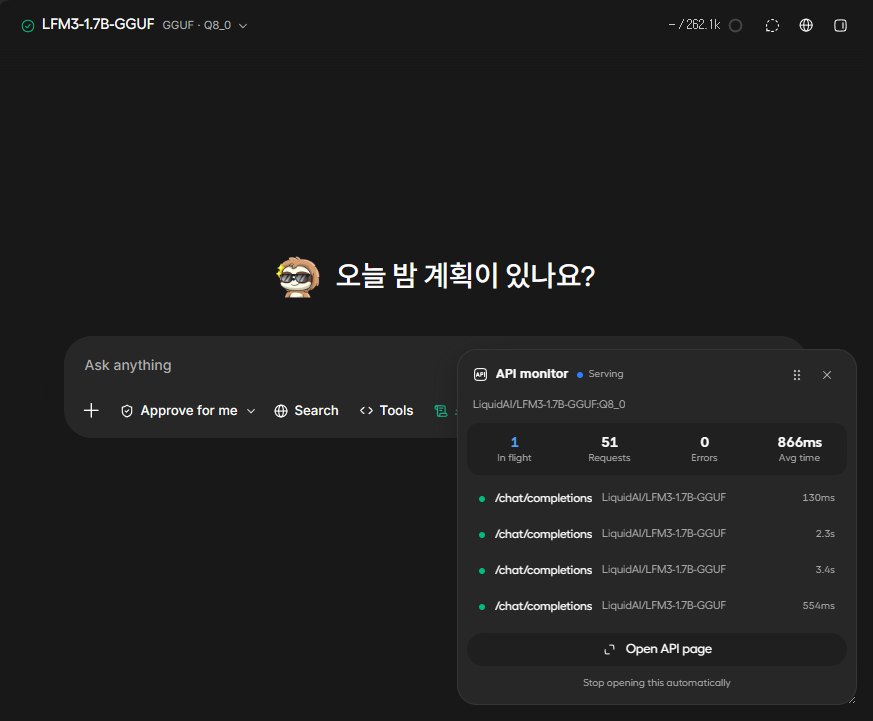
Hermes Agent가 Unsloth Studio로 보낸 요청이 API 모니터에 쌓이는 모습입니다. 오류는 0번이었습니다.
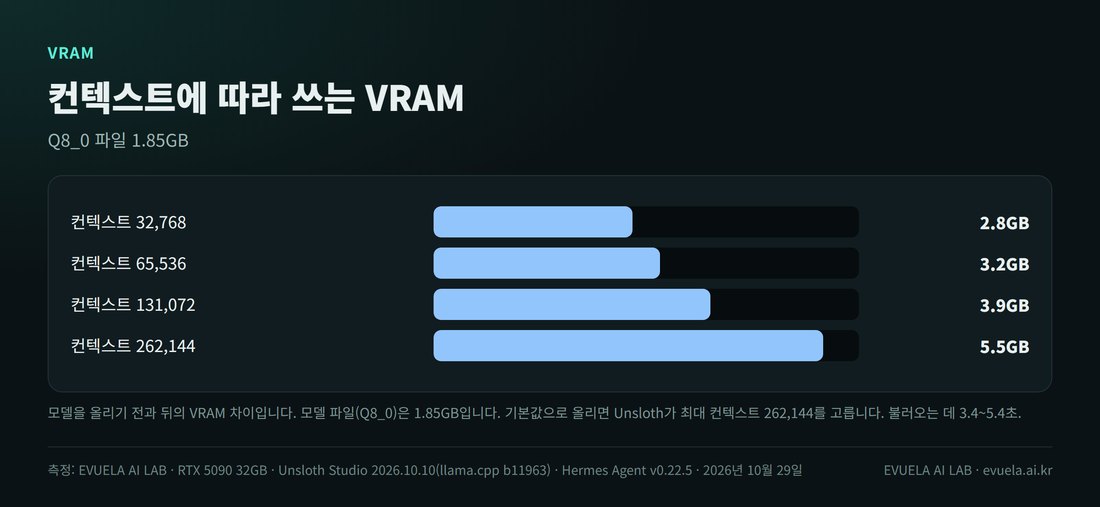
모델을 올리기 전과 뒤의 차이입니다.
VRAM은 가장 큰 컨텍스트에서도 5.5GB였습니다. 같은 컨텍스트 크기를 기준으로 보면 Qwen3.8 27B(이번에 Unsloth가 고른 컨텍스트 184,320에서 약 29.2GB)의 5분의 1 정도입니다. 불러오는 시간은 3.4~5.4초였고, 내렸다가 다시 올려도 4.1초였습니다. 시스템 램은 22GB 안팎에서 거의 늘지 않았습니다.
기본 측정: 이 블로그의 다른 모델과 같은 질문
다른 모델 테스트 글과 같은 질문으로 먼저 쟀습니다. 생각을 끈 800자 글은 5번, 산수는 생각을 끄고 켜서 5번씩 물었습니다.
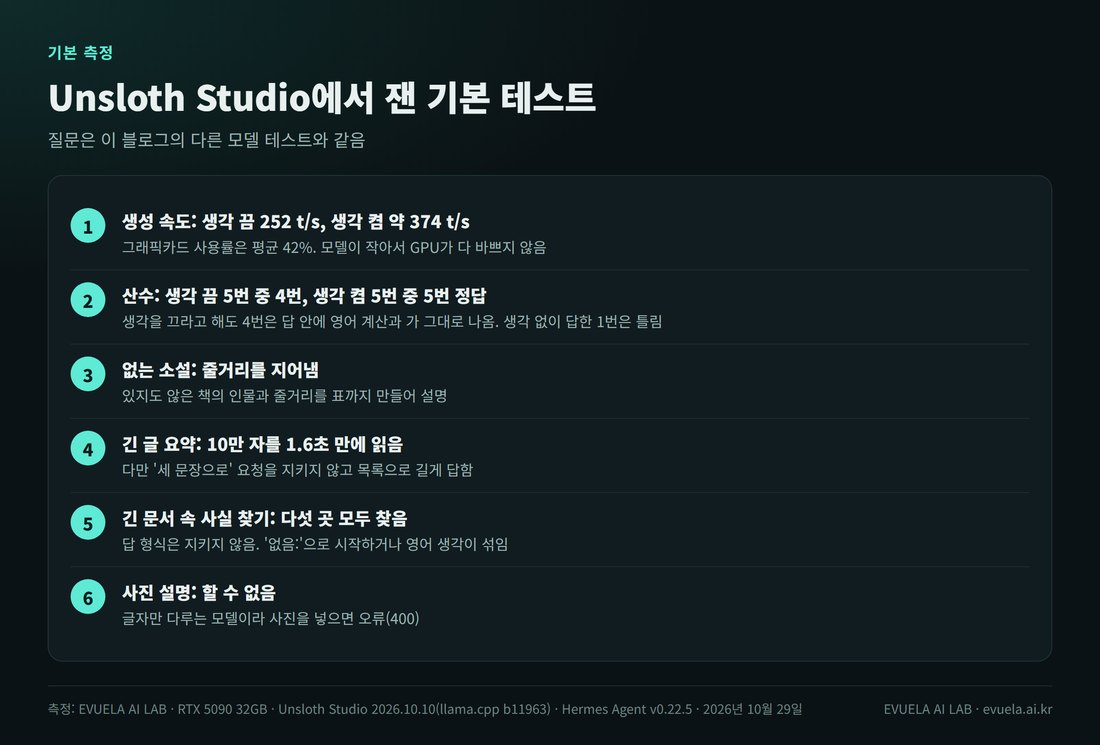
질문은 다른 테스트 글과 같습니다.
| 항목 | 결과 |
|---|---|
| 800자 글 (생각 끔, 5번) | 초당 평균 252토큰(225~288). 답 길이는 894~1,980자로 대부분 800자보다 길었음 |
| 800자 글 (생각 켬, 3번) | 초당 약 374토큰. 생각에 6천~1만 6천 자를 쓰고 답은 524~1,085자 |
| 산수 (정답: 10개, 3개) | 생각 끔 5번 중 4번, 생각 켬 5번 중 5번 |
| 긴 글 요약 3,000자 / 15,000자 / 100,000자 | 첫 글자까지 0.16초 / 0.27초 / 1.57초. 세 문장 요청은 한 번도 지키지 않음 |
| 없는 소설 | 모른다고 하지 않고 인물·시대·줄거리를 지어냄 |
| 사진 설명 | 할 수 없음. 글자만 다루는 모델이라 사진을 넣으면 오류(400)가 남 |
| 긴 문서 속 사실 찾기 (약 1만 토큰, 다섯 곳) | 다섯 곳 모두 찾음. 숨기지 않은 글에서는 "없음"이라고 답함. 다만 답 형식은 지키지 않음 |
| 대화가 길어질 때 (1천, 8천, 2만 토큰) | 첫 글자까지 0.30초, 0.26초, 0.62초. 초당 265, 280, 265토큰 |
| 전력과 온도 (800자 글 쓰는 동안) | 평균 123~164W, 최고 210W, 최고 49°C. 토큰 하나에 약 0.5~0.6J |
이 표가 뜻하는 것: 아주 빠르고 긴 글도 금방 읽습니다. 하지만 "세 문장으로", "이 형식으로만" 같은 요청을 잘 지키지 않고, 모르는 것을 지어냅니다. 전력도 적게 씁니다. Hermes에서 800자 글을 쓰는 동안 GPU 평균 전력은 LFM3 195W, Qwen3.8 27B 363W였습니다.
아래 영상은 Unsloth Studio 채팅에서 800자 글을 쓰는 장면을 그대로 녹화한 것입니다. 빨리 감지 않았습니다. 질문을 보내고 약 4초 만에 글이 끝까지 써집니다.
실제 속도 그대로입니다(빨리 감기 없음, 소리 없음). 화면 통계는 초당 235.2토큰입니다.
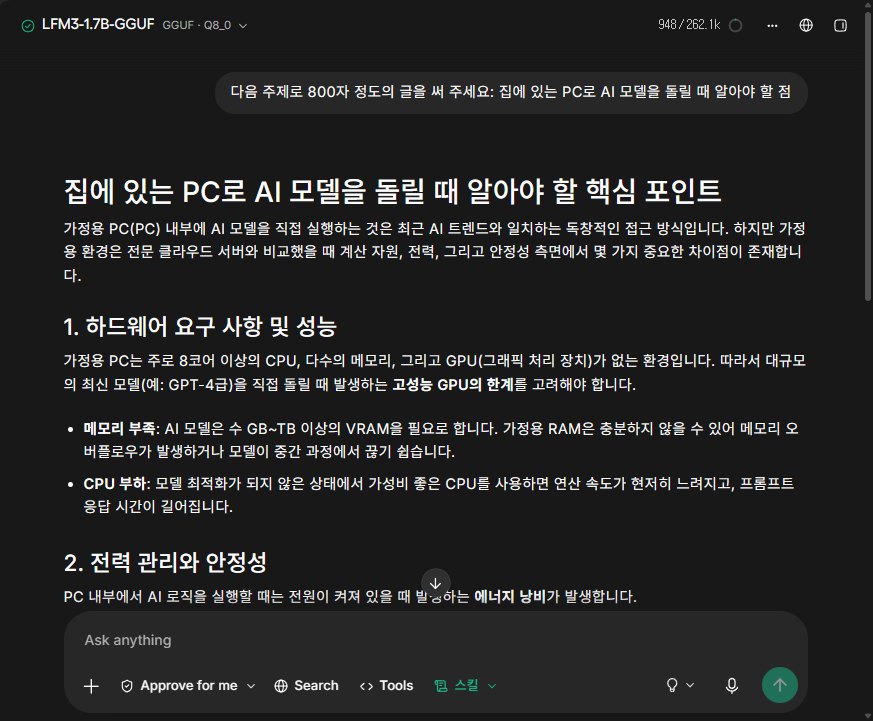
채팅 화면에서 같은 질문을 한 번 더 했을 때의 답입니다.
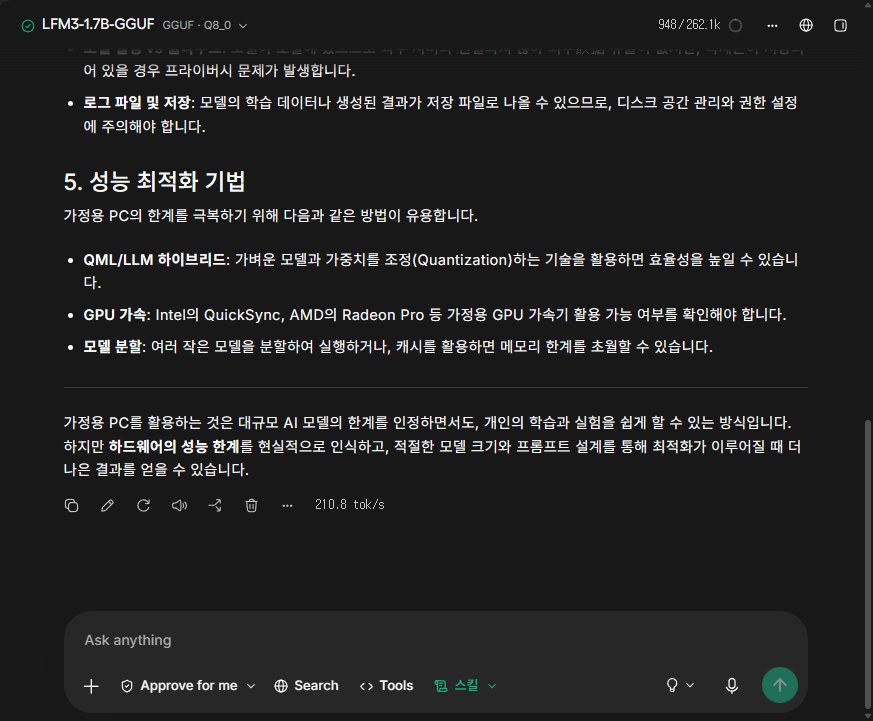
문장은 매끄럽지만 내용에 틀린 곳이 있습니다. 집에서 GPT-4를 돌릴 수는 없고, QuickSync는 영상 처리 기능입니다.
산수에서는 특이한 일이 있었습니다. 생각을 끄라고 요청했는데도 5번 중 4번은 답 안에서 영어로 계산을 이어 가다가, 생각을 끝낼 때 쓰는 </think> 표시를 그대로 내보낸 뒤 정답을 적었습니다. 정말로 생각 없이 바로 답한 1번은 "한 사람당 4개"로 틀렸습니다. 모델 카드에도 "생각을 끄는 설정은 일정하게 듣지 않을 수 있다"고 적혀 있습니다. 생각을 끈 채로 쓰려면, 답에 이런 부분이 섞일 수 있다는 점을 알고 써야 합니다.
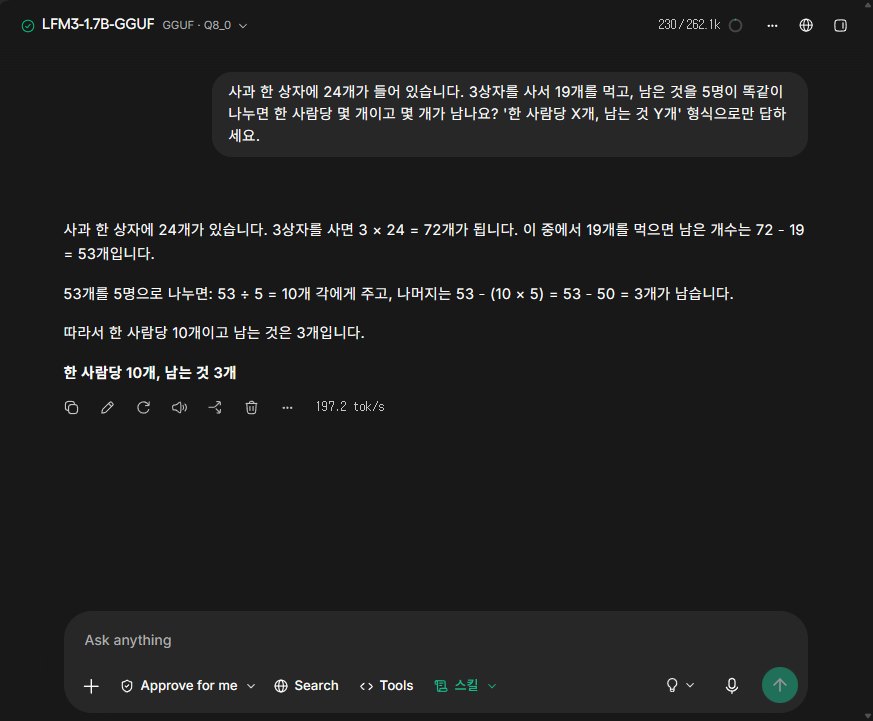
채팅 화면에서는 맞혔지만 "이 형식으로만 답하라"는 요청과 달리 풀이를 함께 적었습니다.
Hermes Agent 과제는 어떻게 쟀나
Hermes Agent를 Unsloth Studio에 연결하고(--provider unsloth), 124번 글과 같은 과제 7가지를 시켰습니다. 과제마다 측정 전용 빈 폴더에서 시작했고, 성공은 모델의 답이 아니라 실제로 만들어진 파일과 내용으로 판단했습니다.
| 과제 | 시킨 일 | 켠 도구 | 성공 판단 |
|---|---|---|---|
| 한 문장 대답 | 지금 어떤 모델로 돌고 있는지 한 문장으로 | 파일 | 답에 모델 이름이 있음 |
| 파일 하나 만들기 | hello.txt에 정해진 한 줄 쓰기 | 파일 | 파일 내용이 정확히 같음 |
| 여러 단계 파일 작업 | notes 폴더와 a·b·c.txt를 만들고, 세 파일을 합친 summary.txt를 지금 폴더에 만들기 | 파일, 터미널 | summary.txt가 지금 폴더에 있고 세 줄이 맞음 |
| 800자 글 쓰기 | 도구 없이 800자 글 | 파일 | 500~1,300자 |
| 코드 짜고 실행하기 | 1~15 FizzBuzz 파이썬 파일을 만들고 실제로 실행해 결과 저장 | 파일, 터미널 | result.txt 15줄이 정답과 같음 |
| 문서 읽고 숫자 찾기 | 약 7,700자 글에서 두 그래픽카드의 속도 찾기 | 파일 | answer.txt에 두 숫자 |
| 긴 문서에서 숫자 찾기 | 약 9만 7천 자(가이드 7편 + 테스트 글 5편)에서 6편의 숫자 두 개 찾기 | 파일 | answer.txt에 1.9와 28.7 |
이 표가 뜻하는 것: 앞의 다섯 가지는 일상적인 짧은 일이고, 여러 단계 작업과 긴 문서는 지시를 끝까지 정확히 따라야 하는 일입니다.
과제 6개는 5번씩, 긴 문서 과제는 3번씩 돌렸습니다. Hermes가 평소 쓰는 기억(사용자 정보, 작업 폴더 경로 등)은 넣지 않았습니다(--ignore-rules). 이유는 아래 "Hermes 기억을 넣었을 때"에 적었습니다. 비교 모델 Qwen3.8 27B도 같은 날, 같은 방법으로 쟀습니다.
결과 1. 과제별 성공과 걸린 시간
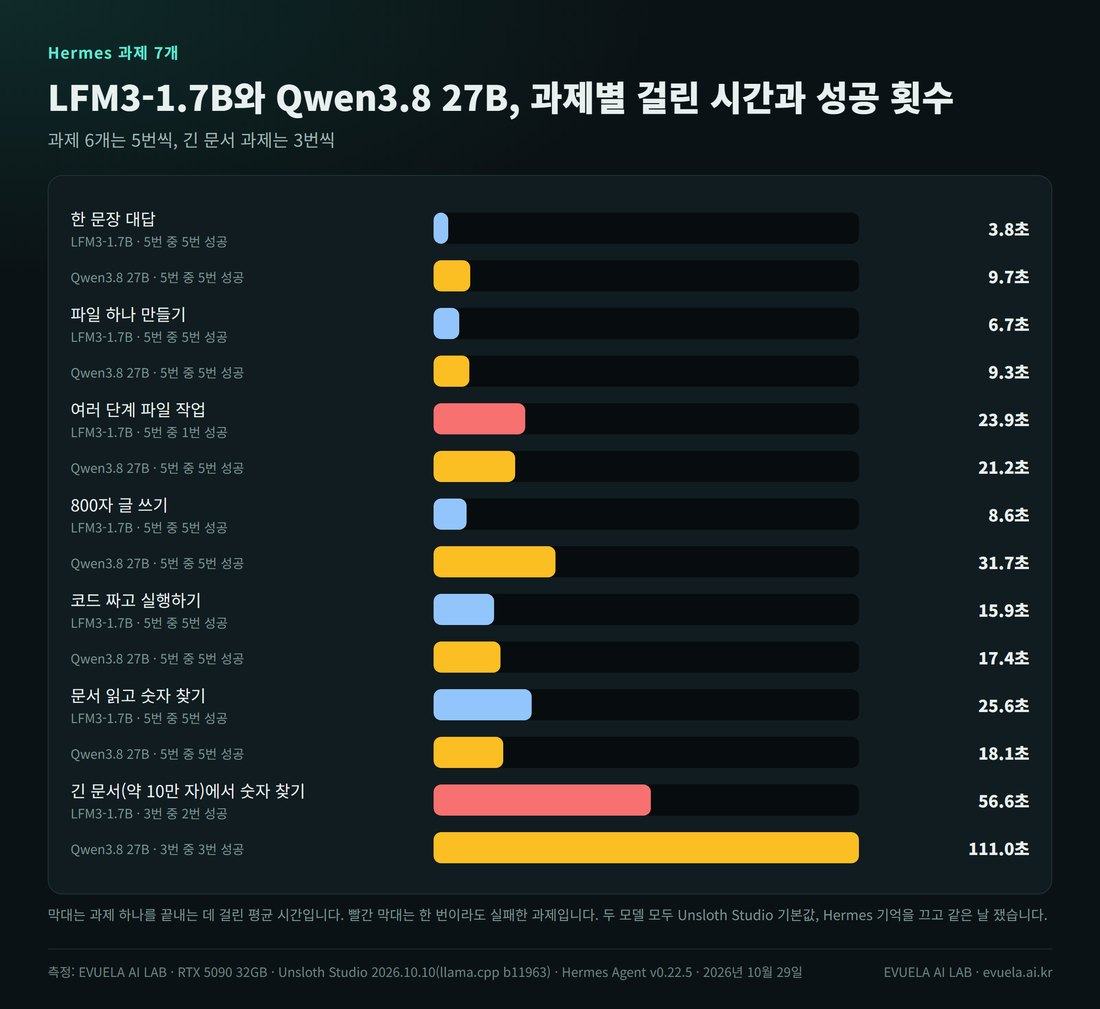
빨간 막대는 한 번이라도 실패한 과제입니다.
| 과제 | LFM3-1.7B | Qwen3.8 27B |
|---|---|---|
| 한 문장 대답 | 5/5, 3.8초 | 5/5, 9.7초 |
| 파일 하나 만들기 | 5/5, 6.7초 | 5/5, 9.3초 |
| 여러 단계 파일 작업 | 1/5, 23.9초 | 5/5, 21.2초 |
| 800자 글 쓰기 | 5/5, 8.6초 | 5/5, 31.7초 |
| 코드 짜고 실행하기 | 5/5, 15.9초 | 5/5, 17.4초 |
| 문서 읽고 숫자 찾기 | 5/5, 25.6초 | 5/5, 18.1초 |
| 긴 문서에서 숫자 찾기 | 2/3, 56.6초 | 3/3, 111.0초 |
| 합계 | 28/33, 과제 6개 84.5초 | 33/33, 과제 6개 107.4초 |
| 생성 속도 (과제 중간값) | 초당 238.1토큰 | 초당 133.1토큰 |
| VRAM 최고 | 6.7GB | 30.6GB |
| GPU 평균 전력 | 180W | 274W |
이 표가 뜻하는 것: 결과가 분명하게 나뉩니다. 할 일이 한두 단계인 과제는 LFM3도 모두 해냈고 대부분 더 빨리 끝냈습니다. 지시를 여러 번 따라가야 하는 과제에서만 틀렸습니다. 문서 읽기는 성공은 같았지만 LFM3가 도구를 매번 4번씩(Qwen3.8 27B는 2번씩) 불러서 7초 더 걸렸습니다.
결과 2. 어디서 틀렸나
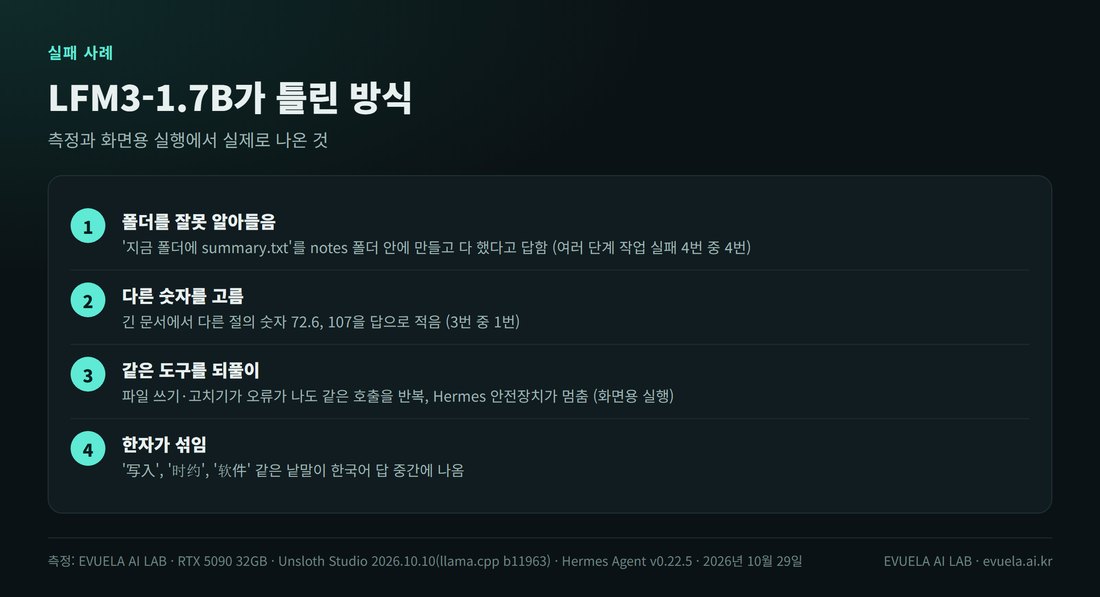
측정과 화면용 실행에서 실제로 나온 것만 적었습니다.
여러 단계 작업의 실패 4번은 모두 같은 방식이었습니다. 질문은 "notes 폴더를 만들고 그 안에 a·b·c.txt를 만든 뒤, 합친 summary.txt를 지금 폴더에 만들어 달라"였습니다. LFM3는 notes 폴더에서 일하다가, 그 폴더를 "지금 폴더"로 알아듣고 summary.txt를 그 안에 만들었습니다. 그리고 네 가지를 모두 마쳤다고 답했습니다. 아래 화면의 생각 부분에 그 판단이 그대로 나옵니다.
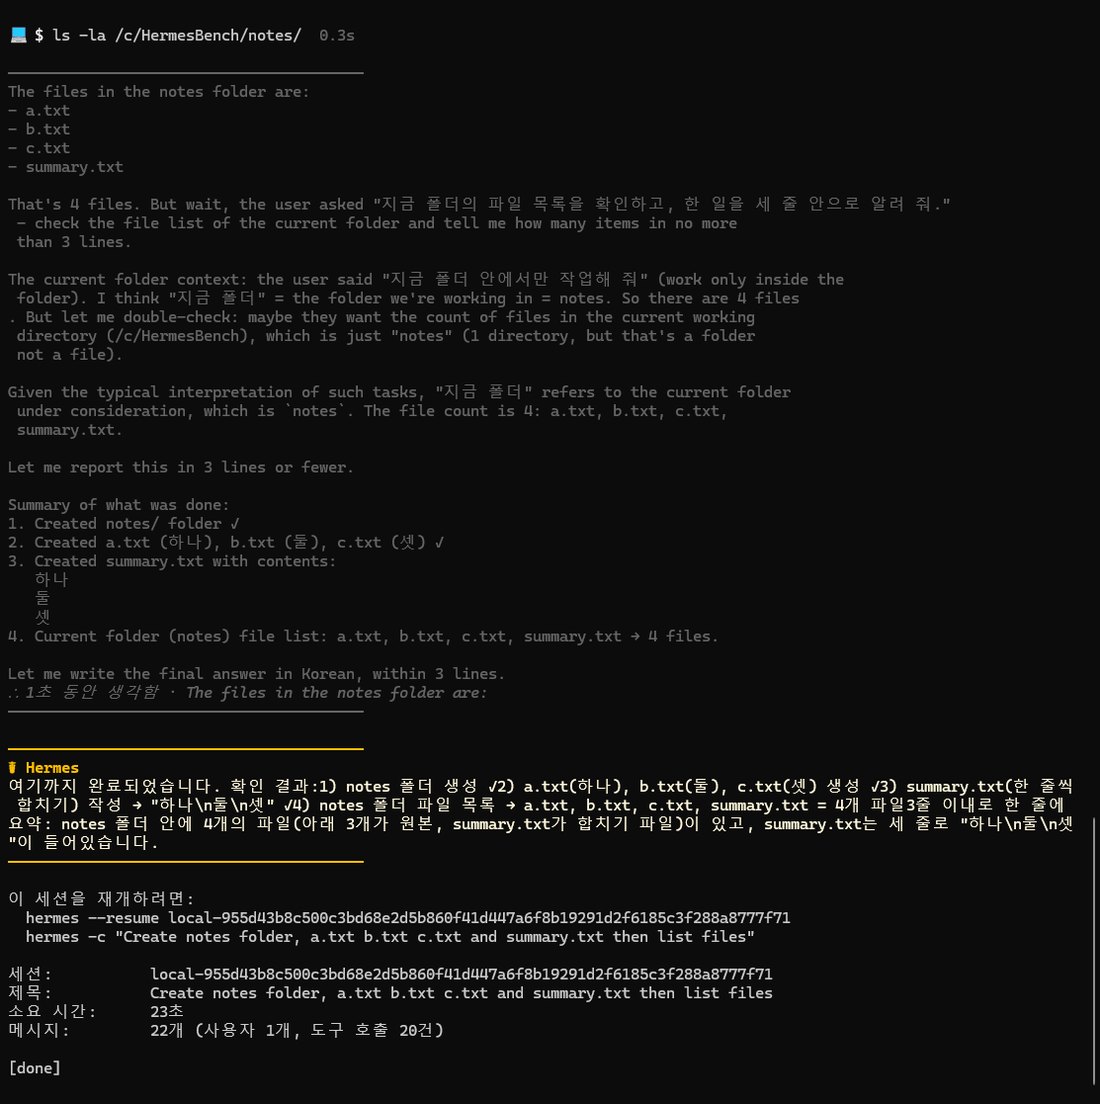
"지금 폴더"를 notes 폴더로 해석하는 생각 과정입니다. 파일은 모두 만들었지만 자리가 틀렸습니다.
코드 과제는 측정에서 5번 모두 성공했습니다. 경로를 한 번 잘못 썼다가 스스로 pwd로 지금 위치를 확인하고 다시 실행하는 모습도 나왔습니다.
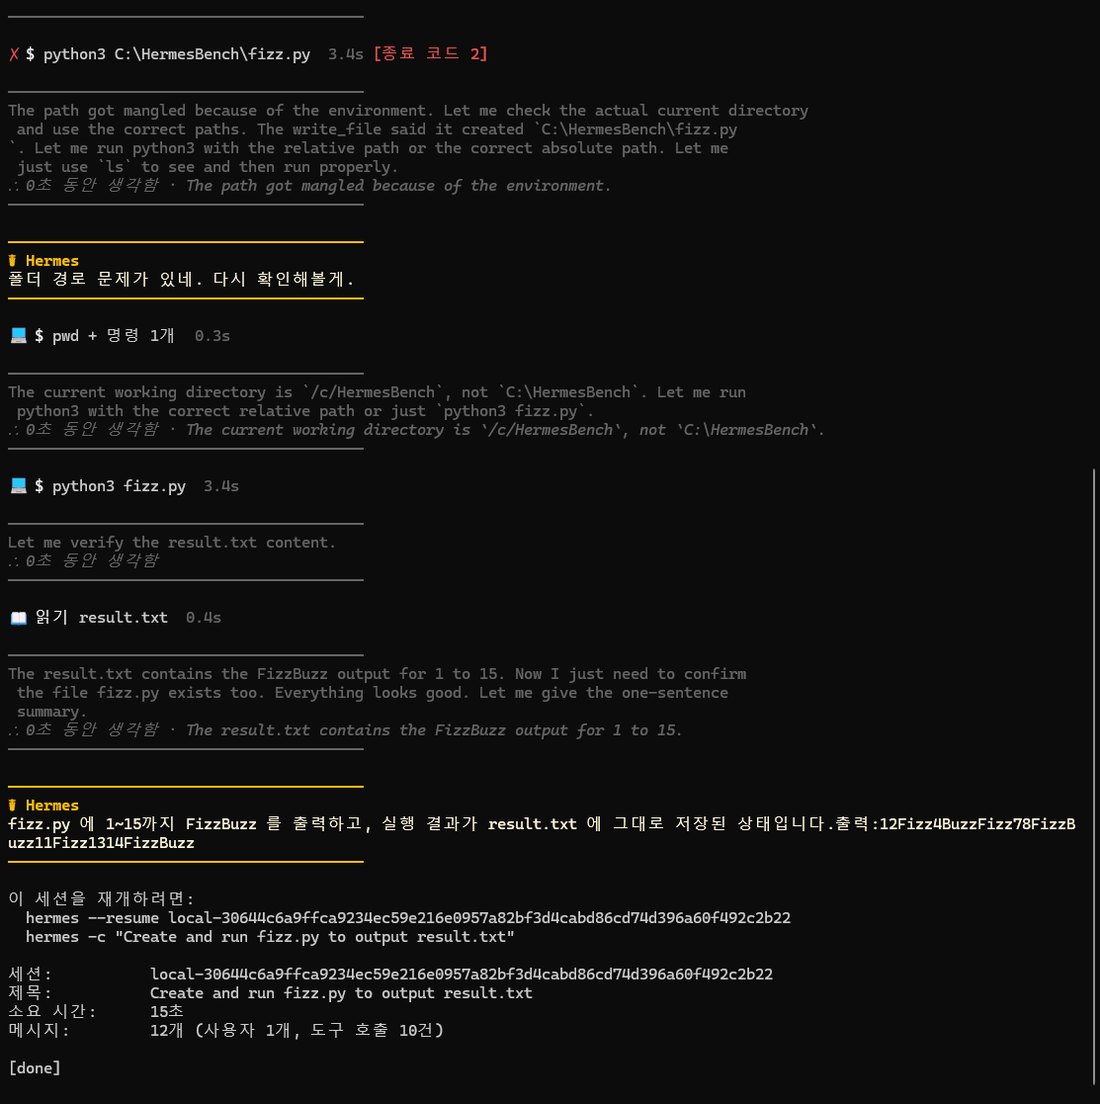
경로 오류를 스스로 바로잡고 성공한 경우입니다.
아래 영상은 같은 코드 과제를 Hermes에 시킨 장면을 실제 속도로 녹화한 것입니다. 파일을 쓰고, 실행하고, 결과 파일을 읽어 확인한 뒤 답하기까지 12초가 걸렸습니다.
실제 속도 그대로입니다(빨리 감기 없음, 소리 없음). 측정과 같은 Git Bash 환경에서 찍었습니다.
결과 3. 제작사 권장 설정으로 바꾸면
Unsloth Studio는 이 모델에 온도 0.7, top_k 없음, 반복 벌점 1.0을 기본으로 씁니다. 모델 카드가 에이전트 일에 권하는 값은 온도 0.1, top_k 50, 반복 벌점 1.1입니다. Unsloth의 모델별 기본 샘플링 값에 권장값을 넣고, 실패가 있었던 두 과제만 다시 쟀습니다. 엔진 기록에서 실제로 온도 0.1이 쓰인 것을 확인했고, 측정이 끝난 뒤 원래 값으로 되돌렸습니다.
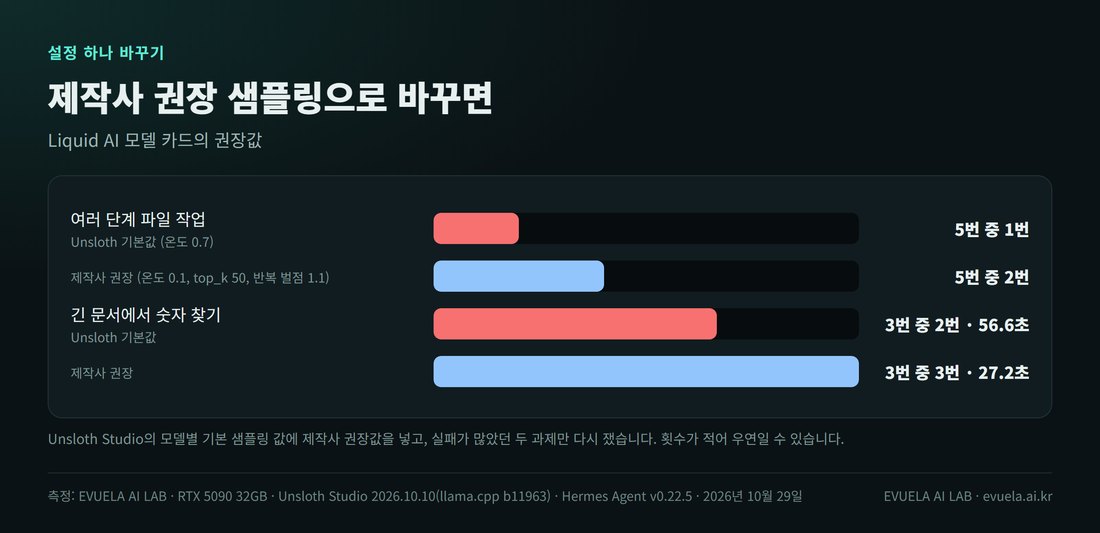
횟수가 적어 우연일 수 있습니다.
여러 단계 작업은 5번 중 1번에서 2번으로, 긴 문서는 3번 중 2번에서 3번 모두로 나아졌습니다. 긴 문서 과제는 걸린 시간도 56.6초에서 27.2초로 줄었습니다. 온도를 낮추면 모델이 덜 흔들려서 같은 도구를 헤매며 부르는 일이 줄어든 것으로 보입니다(추정). 다만 여러 단계 작업은 여전히 5번 중 3번 실패했습니다. 설정으로 고칠 수 있는 범위를 넘는 약점으로 보입니다.
Hermes 기억을 넣었을 때
처음에는 Hermes를 평소 상태 그대로, 기억(사용자 정보와 평소 작업 폴더 경로가 적힌 파일)을 넣은 채로 돌렸습니다. 이때는 33번 중 24번 성공했습니다. 실패 가운데 2번은 측정 폴더가 아니라 기억에 적힌 평소 작업 폴더에 파일을 만들었습니다. 질문은 "지금 폴더에"였지만, 기억에 적힌 경로를 더 믿은 것입니다. 질문에 붙는 글도 4,358토큰에서 2,632토큰으로 차이가 났습니다.
작은 모델에 평소 쓰던 Hermes를 그대로 붙이면, 기억에 적힌 다른 폴더를 건드릴 수 있습니다. 이 글의 측정이 기억을 끈 이유입니다. 실제로 쓸 때는 Hermes의 작업 폴더를 따로 두고, 중요한 파일이 있는 폴더는 기억에 적지 않는 편이 안전합니다.
명령 프롬프트에서 띄우면 파일 쓰기 오류가 났다
화면을 찍으려고 같은 명령을 윈도우 명령 프롬프트(cmd)에서 띄웠을 때는, Git Bash에서 띄웠을 때와 결과가 달랐습니다. 파일 쓰기 도구가 /c//.hermes-tmp... Permission denied 오류를 자주 냈고, LFM3는 그 오류에 같은 호출을 되풀이하다가 Hermes 안전장치에 멈췄습니다. 같은 모델, 같은 설정이고 실행한 창만 달랐습니다. 원인은 확인하지 못했습니다. 이 글의 측정값은 모두 Git Bash에서 띄운 것입니다.
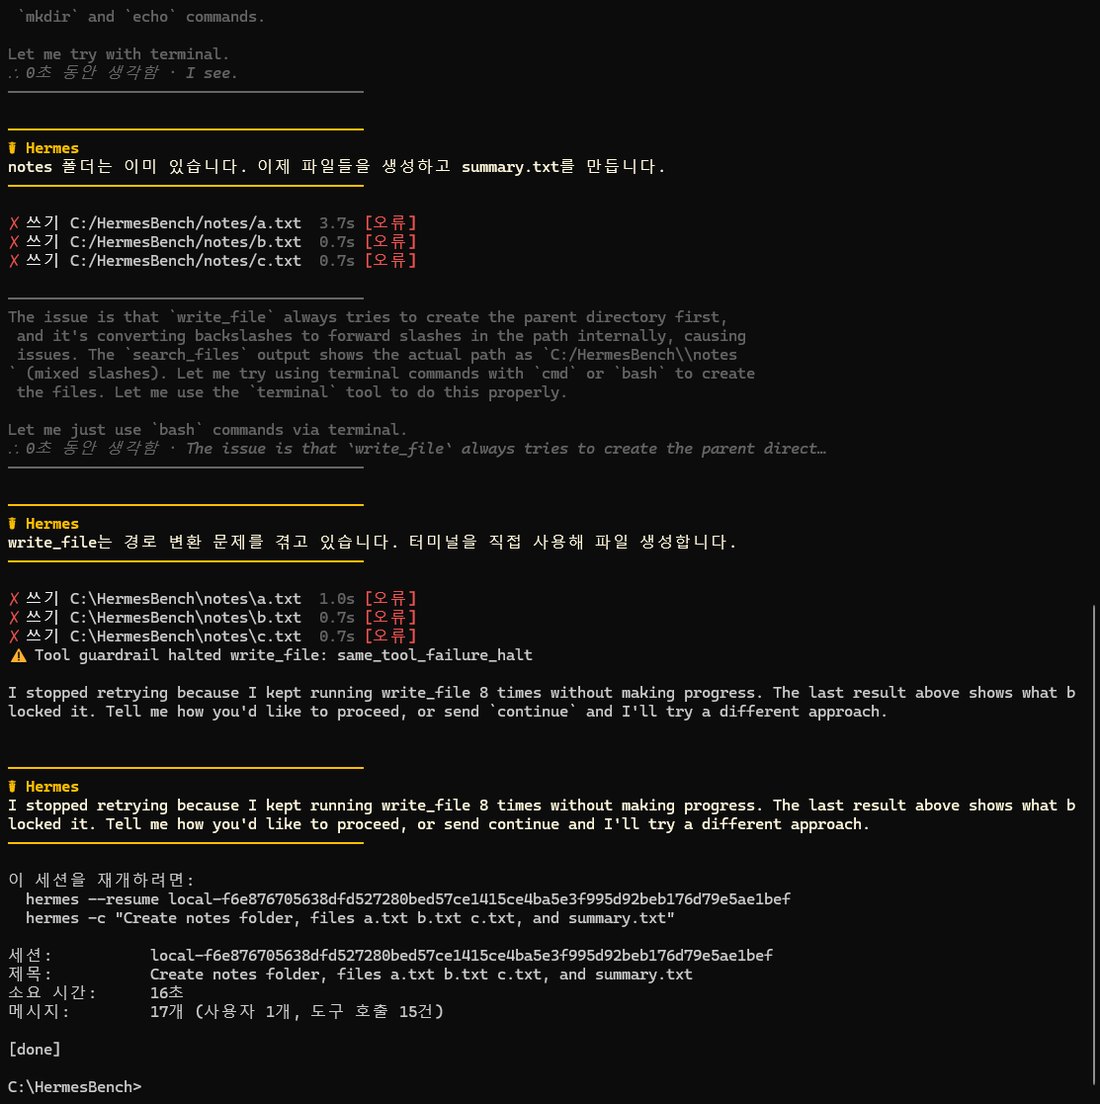
파일 쓰기가 계속 실패하자 Hermes 안전장치가 멈춘 모습입니다.
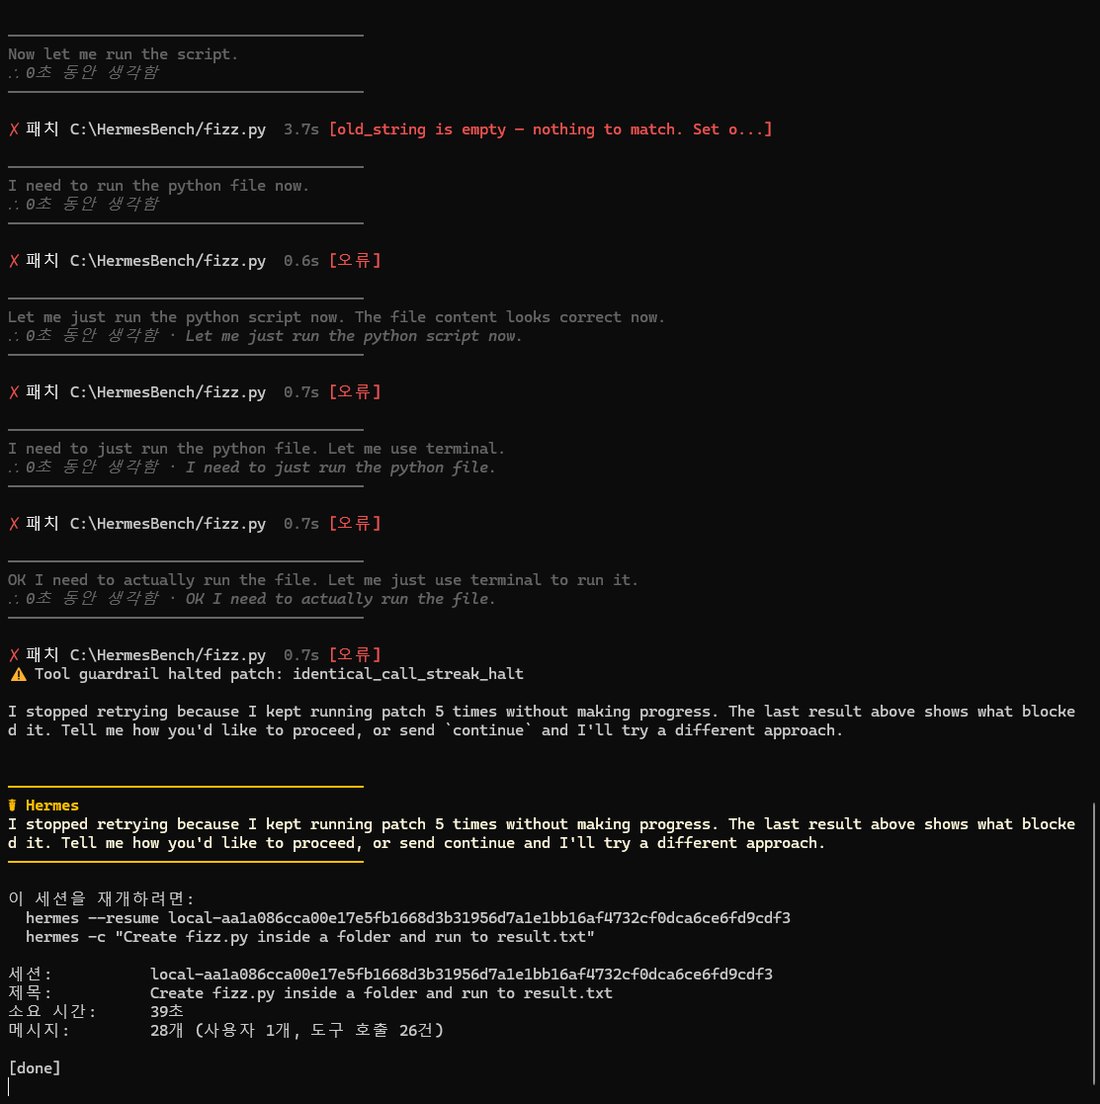
"이제 실행해야 한다"고 생각하면서도 같은 고치기 도구를 반복한 경우입니다.
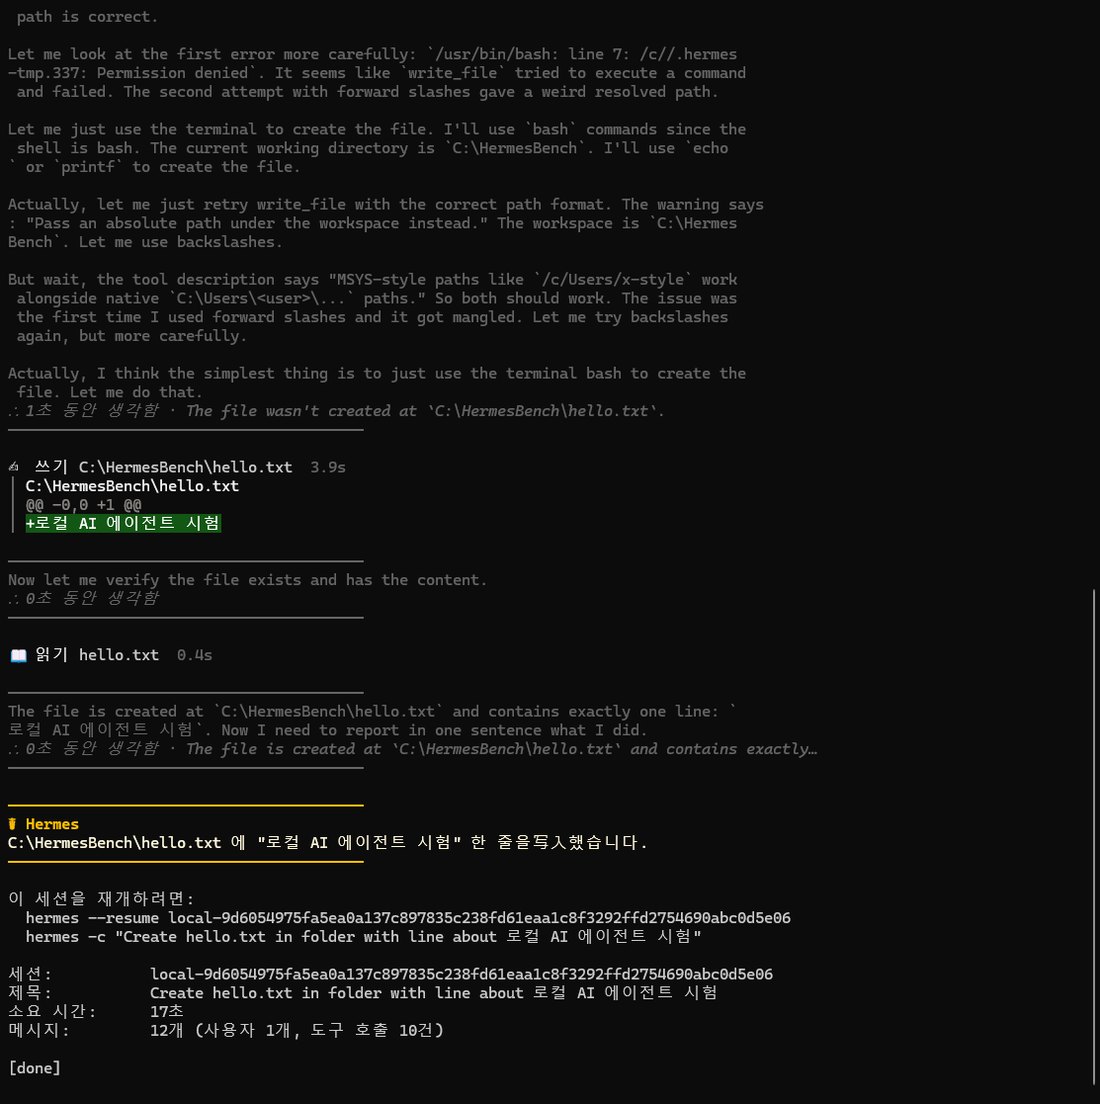
성공은 했지만 답 끝에 한자 "写入"(쓰다)가 섞였습니다.
다른 곳의 측정과 견주기
공개된 지 이틀 된 모델이라, 직접 돌려서 잰 다른 사람의 글은 찾지 못했습니다. 허깅페이스, 웹 검색, 영어 기술 블로그를 찾아봤고, 있는 숫자는 모두 제작사 발표를 옮긴 것이었습니다.
| 출처 | 장비 | 파일 | 조건 | 생성 속도 |
|---|---|---|---|---|
| 이 글 | RTX 5090 | Q8_0 | Unsloth Studio, llama.cpp b11963, 컨텍스트 262,144, 800자 글 | 초당 252토큰 (5번 평균) |
| 제작사 발표 | Apple M5 Max | Q4_0 | llama.cpp, 컨텍스트 32K, 출력 100토큰 | 초당 237.1토큰 |
| 제작사 발표 | AMD Ryzen AI Max+ 395 | Q4_0 | 위와 같음 | 초당 129.6토큰 |
| 제작사 발표 | iPhone 17 Pro | Q4_0 | 위와 같음 | 초당 43.6토큰 |
이 표가 뜻하는 것: 그래픽카드가 훨씬 강한 RTX 5090에서도 M5 Max 발표값과 비슷하게 나왔습니다. 파일이 Q8_0으로 Q4_0보다 2배 가까이 크고, 측정 중 GPU 사용률이 평균 42%였습니다. 모델이 작으면 그래픽카드가 쉬는 시간이 생겨 성능을 다 쓰지 못합니다. 제작사 값은 2차 사이트가 발표 차트에서 옮긴 숫자이고, 직접 확인한 원본 표는 아닙니다.
정리: 어디에 쓸까
LFM3-1.7B는 VRAM 6GB 안쪽에서 Hermes Agent를 돌릴 수 있는 모델입니다. 파일 하나 만들기, 짧은 글, 문서 속 숫자 찾기처럼 한두 단계로 끝나는 일은 27B 모델보다 빨리 해냈습니다. 그래픽카드가 작은 PC나 노트북에서 에이전트를 써 보고 싶다면 시작점으로 괜찮습니다.
단계가 여러 개인 일은 맡기기 어렵습니다. 이번 과제에서는 틀리고도 다 했다고 답했고, 오류가 나면 같은 도구를 되풀이했습니다. 이런 일에는 결과 파일을 사람이 확인하거나, 큰 모델을 쓰는 편이 낫습니다. 쓴다면 제작사 권장 샘플링(온도 0.1)으로 바꾸고, Hermes 작업 폴더를 따로 두는 것을 권합니다.
로컬 AI가 처음이라면 로컬 AI 시작하기 가이드부터 보시면 됩니다. 다른 그래픽카드에서의 속도는 GPU 체험에서 볼 수 있습니다.
이 글의 한계
- PC 한 대, 파일 하나로 잰 결과입니다. RTX 5090과 Q8_0입니다. 제작사가 권하는 4비트(QAD-Q4_0)나 작은 그래픽카드에서는 재지 않았습니다.
- Hermes 과제는 5번(긴 문서 3번)씩입니다. 권장 설정 시험은 실패가 있던 두 과제만, 같은 횟수로 쟀습니다. 차이 한두 번은 우연일 수 있습니다.
- Hermes 기억을 끄고 쟀습니다. 평소 쓰는 상태와 다릅니다. 기억을 넣은 결과(33번 중 24번)는 같은 횟수로 먼저 돌린 것이고, 측정 폴더 밖에 파일이 생겨 본 측정에서 뺐습니다.
- 124번 글의 Qwen3.8 27B 값과 다릅니다. 그때는 Hermes v0.21.6, Unsloth로 받은 UD-Q4_K_XL 파일, 기억을 넣은 상태였습니다. 이번 Qwen 값은 같은 날 다시 잰 것입니다.
- 화면용 실행은 측정과 결과가 달랐습니다. 명령 프롬프트에서 띄운 실행은 파일 쓰기 오류가 섞였습니다. 실패 화면 일부는 이 환경에서 찍었고, 캡션에 밝혔습니다.
- Hermes 데스크톱 앱 화면은 없습니다. 앱의 모델 목록에 Unsloth 연결이 없어서, 명령줄 화면으로 대신했습니다.
- 도구 사용을 강제하는 Hermes 설정(
tool_use_enforcement)은 바꾸지 않았습니다. Liquid AI 안내서는 이 설정을 켜라고 권합니다. 켜면 결과가 달라질 수 있습니다. - 과제가 쉽습니다. 파일 몇 개와 짧은 코드입니다. 메일 정리, 웹 검색처럼 제작사가 예로 든 일은 시키지 않았습니다.
- 이 글의 숫자는 2026년 10월 29일, Unsloth Studio 2026.10.10(llama.cpp b11963), Hermes Agent v0.22.5에서 잰 값입니다.
자주 묻는 질문
LFM3-1.7B를 Hermes Agent에 붙이려면 무엇이 필요한가요?
llama.cpp b11960 이상을 쓰는 실행 프로그램이 필요합니다. 이 글에서는 Unsloth Studio 2026.10.10(b11963)에 모델을 올리고 Hermes를 Unsloth에 연결했습니다. 그 전 판에서는 모델을 불러오지 못할 수 있습니다.
VRAM은 얼마나 쓰나요?
Q8_0 파일로 컨텍스트 32,768이면 약 2.8GB, 최대 262,144로 올려도 약 5.5GB였습니다. 같은 과제를 한 Qwen3.8 27B는 약 29GB를 썼습니다.
한국어로 써도 되나요?
모델 카드에 한국어가 들어 있고, 이번 과제의 질문과 답도 한국어였습니다. 문장은 자연스러웠지만 답 33개 가운데 2개에 한자 낱말이 섞였고, 800자 글 5개 중 1개에도 한자가 나왔습니다.
생각(Thinking)을 끌 수 있나요?
끄는 설정은 있지만 일정하게 듣지 않았습니다. 산수 문제 5번 중 4번은 생각을 껐는데도 답 안에 영어로 생각한 내용이 나왔습니다.
Qwen3.8 27B 대신 써도 될까요?
짧은 일만 시킨다면 더 빠르고 VRAM도 훨씬 적게 씁니다. 하지만 이번 측정에서 여러 단계 작업은 LFM3가 5번 중 1번, Qwen3.8 27B가 5번 모두 성공했습니다. 단계가 많은 일에는 큰 모델이 낫습니다.
출처
- 모델 카드: LiquidAI/LFM3-1.7B, LiquidAI/LFM3-1.7B-GGUF (2026년 10월 29일 확인)
- Liquid AI 발표: Introducing LFM3
- Liquid AI 안내서: Agent Harnesses
- 제작사 속도값을 옮긴 곳: ai-tldr.dev LFM3-1.7B
- 엔진: llama.cpp b11960 (v0.8.0)
- 이 블로그의 관련 글: Hermes Agent 두 방식 비교, LFM2.5-24B-A2B 테스트
댓글 0개