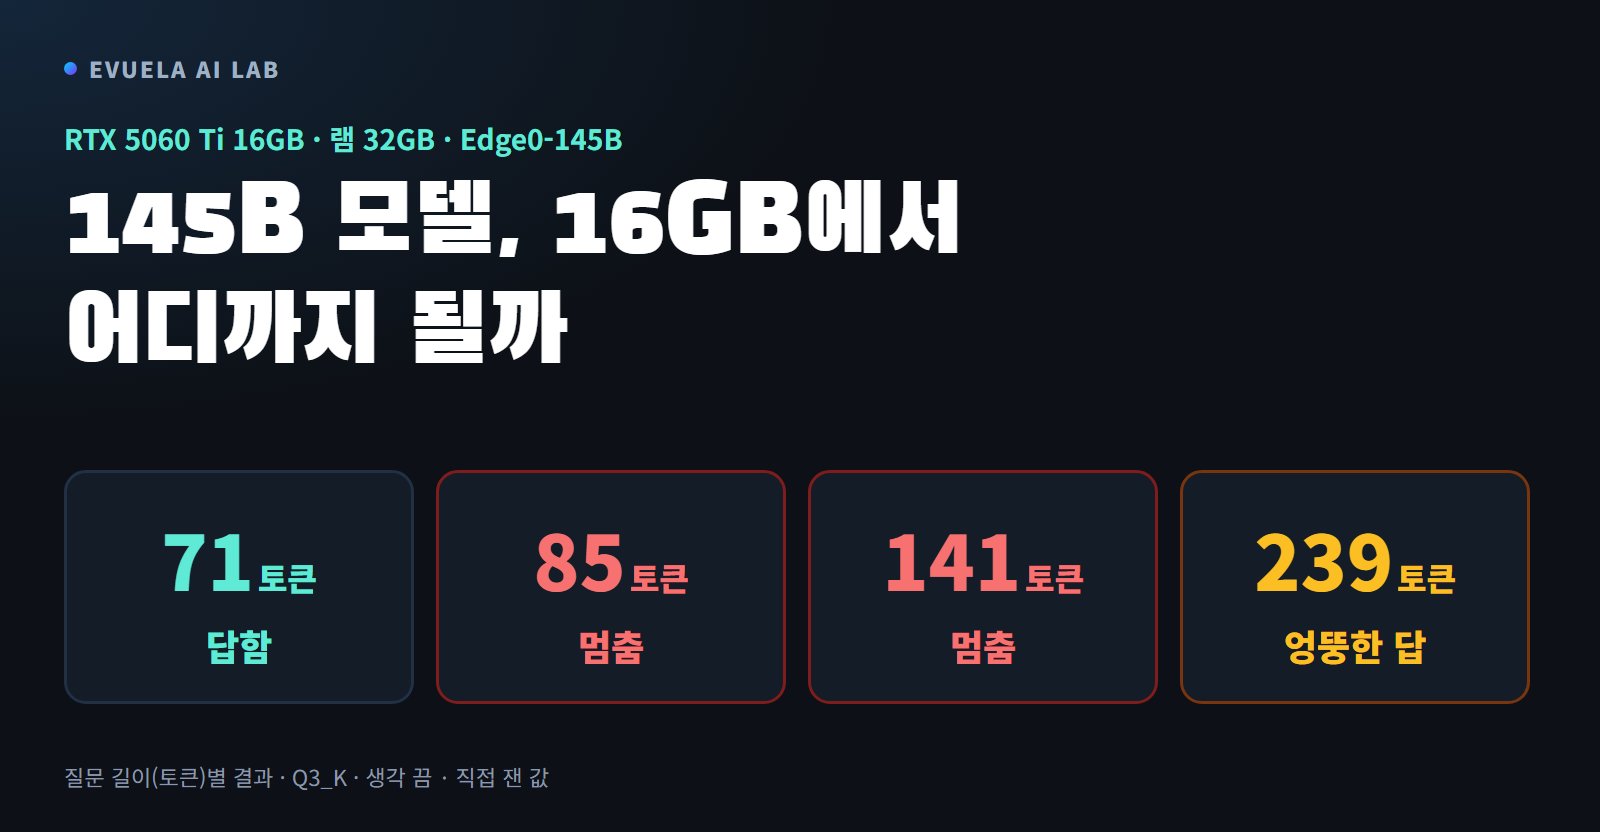
Edge0-145B는 전체 파라미터가 145B(1,450억 개)인 MoE 모델입니다. 제작사는 이 모델이 "16GB 그래픽카드와 램 20GB에서 돈다"며 초당 36.8토큰이라는 측정값을 냈습니다. 그 측정은 24GB 카드의 VRAM을 16GB로 묶어서 잰 값입니다. 그래서 진짜 16GB 카드인 RTX 5060 Ti 16GB(램 32GB, SATA SSD, PCIe 3.0 메인보드)에서 직접 돌려 봤습니다. 결론부터 적으면 짧은 질문에는 초당 17.6토큰으로 답했지만, 70토큰(한국어 두세 문장)을 넘는 질문은 대부분 읽다가 멈췄습니다. 몇 길이는 읽었지만 답이 질문과 맞지 않았습니다.
- 속도: 생각(Thinking) 끔으로 800자 글을 5번 쓰게 해 평균 17.56t/s(초당 토큰, 14.8~19.6)였습니다. 같은 질문을 되풀이할수록 빨라졌습니다.
- 질문 길이: 71토큰까지는 3~13초 안에 답을 시작했습니다. 76·85·113·141·169토큰과 3,000자 요약(1,486토큰)은 읽다가 멈추고 엔진이 꺼졌습니다. 183·239토큰과 앞 대화에 이어 붙인 225·235토큰은 읽었지만, 네 번 모두 질문과 다른 답을 했습니다.
- 못 한 측정: 그래서 산수, 긴 글 요약, 긴 대화, 문서 속 정보 찾기는 재지 못했습니다. 산수(76토큰)와 3,000자 요약은 보냈지만 읽다가 멈췄습니다.
- 메모리: 로드에 191~212초가 걸렸고, VRAM 15.4GB를 쓰고 시스템 램 32GB 중 0.2~0.5GB만 남겼습니다.
이 글의 숫자는 RTX 5060 Ti 16GB PC에서 2026년 11월 15일에 직접 잰 값입니다. 모델만 켠 깨끗한 상태가 아니라, 측정 프로그램과 평소 쓰는 프로그램 몇 개를 켜 둔 채로 쟀습니다. 제작사 값은 "제작사 측정"이라고 따로 적었습니다.
이 글의 결과를 20초로 요약한 영상입니다(소리 없음).
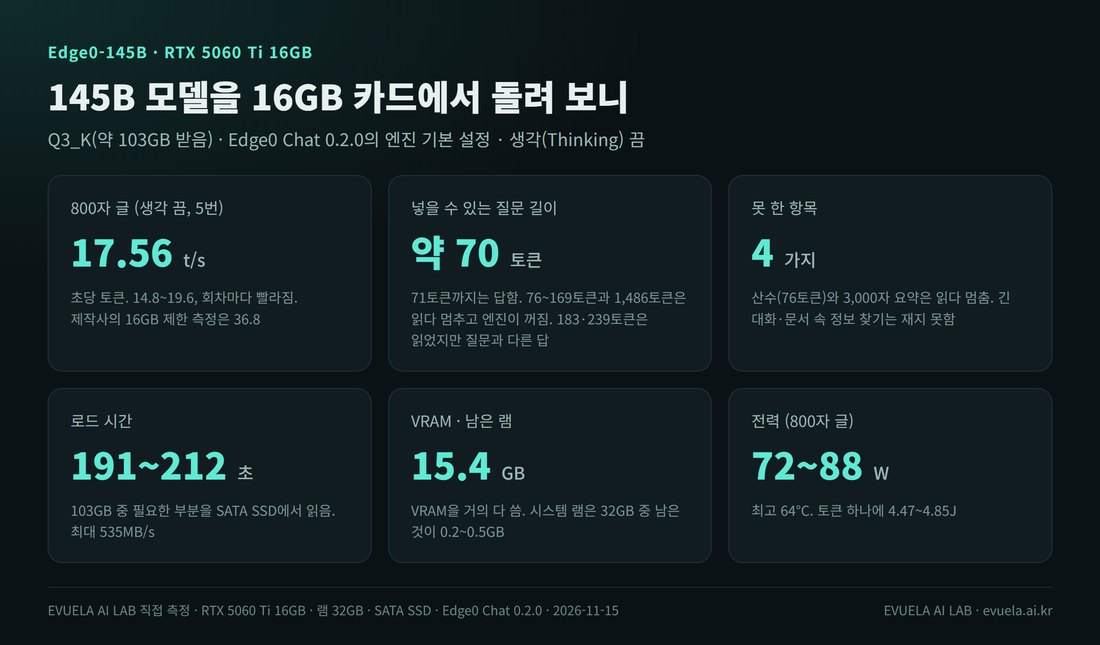
RTX 5060 Ti 16GB에서 직접 잰 값입니다.
테스트 PC와 실행 프로그램
| 항목 | 내용 |
|---|---|
| 그래픽카드 | RTX 5060 Ti 16GB |
| PCIe 연결 | PCIe 3.0 x8. 카드는 PCIe 5.0 x8을 지원하지만 메인보드가 3.0이라 3.0으로 연결됨(엔진 모니터 화면에서 확인) |
| GPU 드라이버 | 621.24 (CUDA 13.5 지원) |
| CPU, 램 | Intel Core i5-9400F (6코어), DDR4 32GB |
| 저장 장치 | SATA SSD (최대 읽기 약 535MB/s로 측정됨) |
| 운영체제 | Windows 11 Pro |
| 함께 켜 둔 프로그램 | 측정 프로그램과 평소 쓰는 프로그램 몇 개. 모델을 올리기 전 남은 램 24.6~26.5GB |
| 실행 프로그램 | Edge0 Chat 0.2.0 Windows판에 든 edge0-infer 0.2.0과 엔진 edge0-strata 0.1.55 |
| 설정 | 서버 프로그램이 정한 기본값 그대로 (컨텍스트 131,072, KV 캐시 int8을 모두 VRAM에, 익스퍼트 캐시 auto, MTP 사용). 모델 폴더의 model.json에 적힌 값 가운데 KV 캐시를 램으로 빼는 설정, CPU 작업 스레드 수 같은 몇 가지는 엔진에 넘어가지 않았습니다(엔진 실행 명령에서 확인). |
Edge0는 LM Studio나 Unsloth Studio 같은 llama.cpp 프로그램으로 열 수 없습니다. 제작사가 함께 낸 전용 프로그램으로만 돌아갑니다. PCIe 3.0 x8의 한 방향 대역폭은 약 7.9GB/s로, 카드가 지원하는 5.0 x8(약 31.5GB/s)의 4분의 1입니다. VRAM에 다 들어가지 않는 익스퍼트를 램에서 그래픽카드로 옮겨 와야 하는 이 모델에는 불리할 수 있는 조건입니다. 또 다른 프로그램을 켜 둔 만큼 모델이 쓸 수 있는 램이 줄었습니다. 모델만 켠 PC나 PCIe 4.0·5.0 메인보드에서는 결과가 다를 수 있습니다.
그래서 이 블로그가 요즘 쓰는 Unsloth Studio 대신 이 프로그램의 서버(edge0-infer serve)를 띄우고, 같은 질문을 API로 보내 쟀습니다. 질문 길이 시험 일부와 화면 캡처는 엔진에 딸린 웹 채팅 화면(Strata)과 엔진 API로 했습니다.
Edge0-145B는 어떤 모델인가요?
| 항목 | 내용 |
|---|---|
| 만든 곳 | Edge0 (2026년 11월 11일 0.2.0 공개) |
| 바탕 모델 | Qwen3.8-Flash-Next |
| 크기 | 전체 145B, 토큰 하나에 쓰는 활성 파라미터 약 10.12B. 48레이어, 레이어마다 익스퍼트 512개 중 10개 + 공용 1개 |
| 컨텍스트 | 최대 262,144 (서버 기본값 131,072) |
| 받은 파일 | Q3_K판 약 103GB (익스퍼트 40.8GB, 레이어별 임베딩 51.2GB, 뼈대 6.0GB 등) |
| 최소 사양 (제작사) | CUDA 13을 쓰는 NVIDIA GPU, GPU 메모리 16GiB 이상, 시스템 램 20GiB 이상 |
| 라이선스 | Edge0 Community Model License 1.0. 개인 사용과 답의 상업적 사용은 되고, 모델을 팔거나 상업 서비스로 돌리려면 따로 허락이 필요 |
MoE(Mixture of Experts)는 큰 모델을 작은 '익스퍼트' 묶음으로 나눠, 토큰마다 그중 몇 개만 계산하는 구조입니다. Edge0는 여기에 더해 VRAM에 다 들어가지 않는 익스퍼트를 시스템 램과 SSD에 두고, 다음에 쓸 익스퍼트를 미리 읽어 오는 방식을 씁니다. 145B 모델을 16GB 카드에서 돌릴 수 있다는 말은 이 방식에서 나옵니다.
어떻게 실행했나요?
압축을 풀고 서버를 띄우자 처음에는 바로 꺼졌습니다. 엔진이 NVIDIA의 수학 라이브러리 cuBLAS(cublas64_13.dll)를 찾지 못했기 때문입니다. 제작사 안내는 CUDA Toolkit 13을 설치하라고 합니다. 이 글에서는 툴킷 대신 NVIDIA가 PyPI에 올린 nvidia-cublas 13.5 패키지에서 DLL 파일만 꺼내, 서버를 띄울 때 그 폴더를 찾도록 했습니다.
생각을 끄는 방법은 API 요청에 "chat_template_kwargs": {"enable_thinking": false}를 넣는 것입니다. "reasoning_effort": "none"도 똑같이 생각이 꺼졌습니다. "thinking": "off"는 오류 없이 무시되어 생각이 켜진 채로 돌았습니다. 모든 답에서 생각 글자 수가 0인 것을 확인했습니다.
웹 채팅 화면에서는 어떻게 보이나요?
엔진이 뜨면 로그에 채팅 주소가 나옵니다. 브라우저로 그 주소를 열면 채팅, 모니터, 정보 세 탭이 있는 화면이 나오고, 정보 탭에서 화면 언어를 한국어로 바꿀 수 있습니다. 생각은 채팅 설정의 '추론'에서 끕니다.
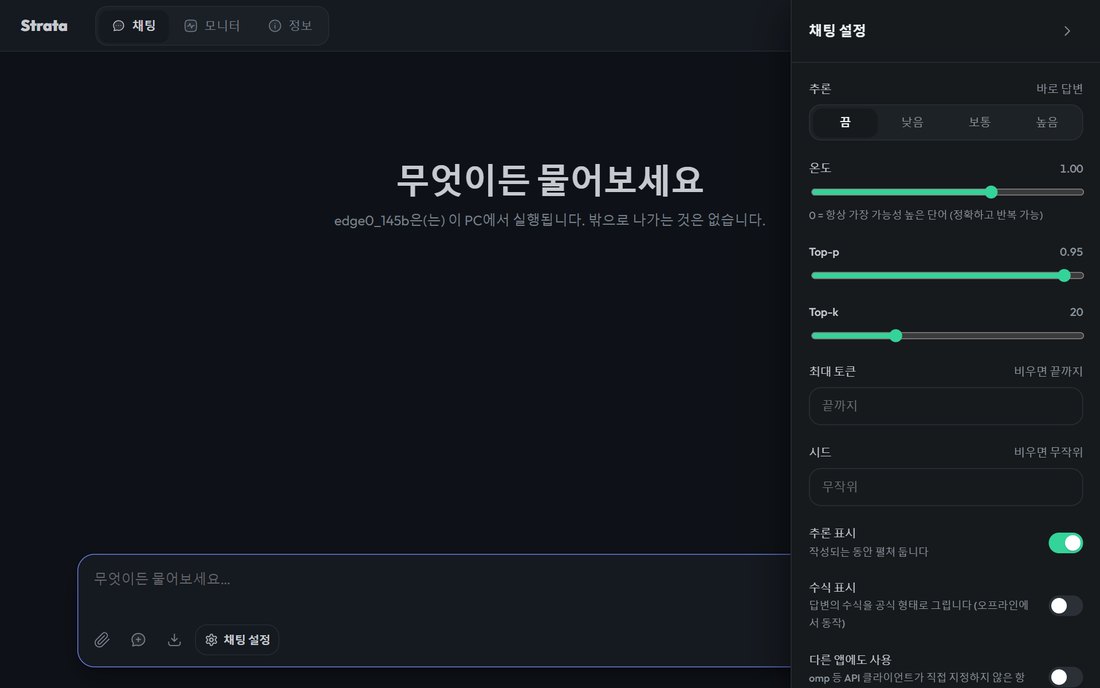
채팅 설정의 '추론'을 '끔'으로 고른 화면입니다.
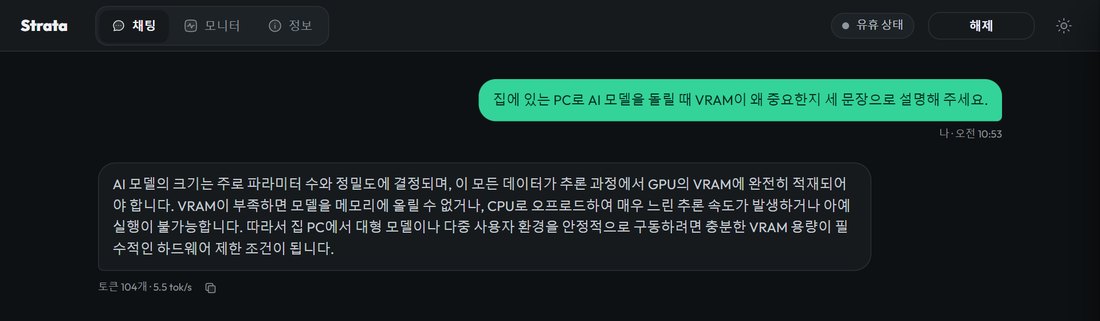
모델을 올린 뒤 처음 보낸 질문(35토큰)입니다.
모델을 올린 뒤 처음 보낸 질문이라 초당 5.5토큰으로 느렸습니다. API로 잴 때도 첫 요청은 2.1~6.3t/s였습니다. 답 첫 문장의 "정밀도에 결정되며"처럼 조사가 어색한 곳이 있었습니다.
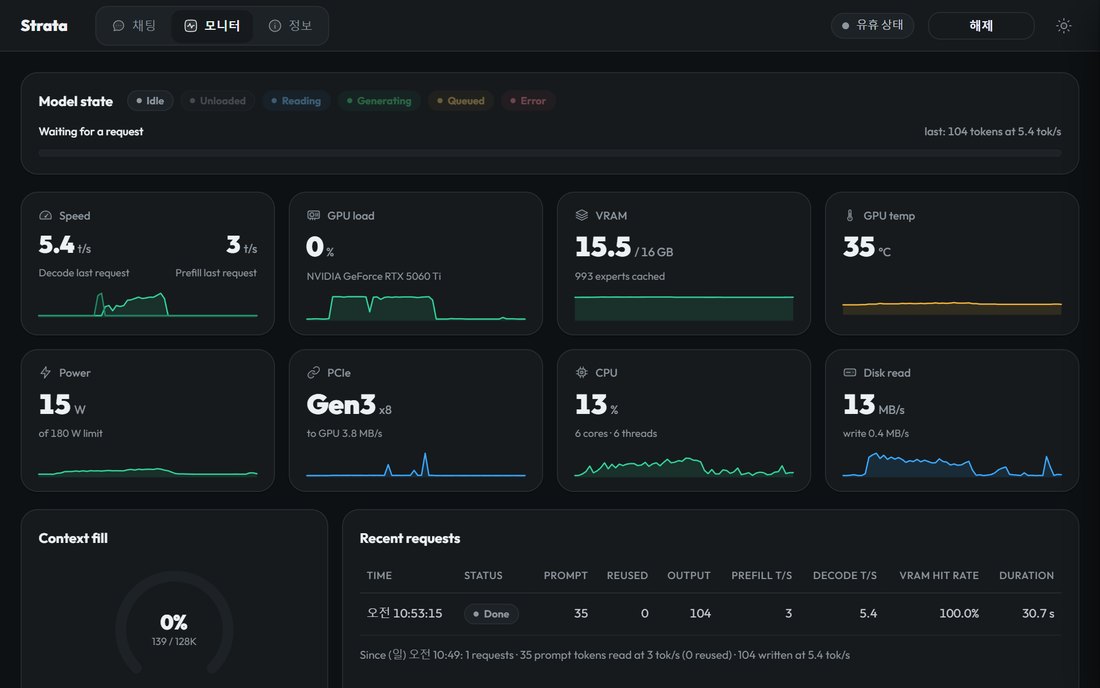
모니터 탭은 요청마다 질문 읽기·생성 속도와 VRAM, PCIe 연결을 보여 줍니다.
모니터 탭에 PCIe 연결이 Gen3 x8로 나옵니다. 이 PC의 그래픽카드는 PCIe 3.0 x8로 연결돼 있습니다. VRAM은 16GB 중 15.5GB를 썼습니다.
로드에 얼마나 걸리고 메모리는 얼마나 쓰나요?
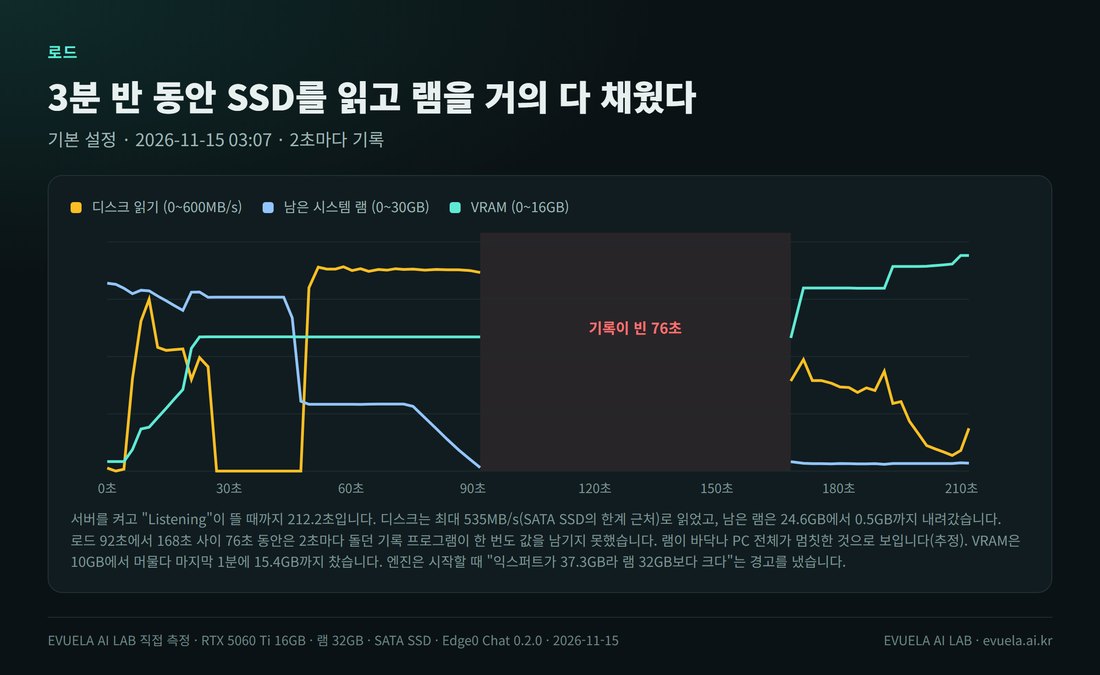
서버를 켠 뒤 'Listening'이 뜰 때까지 2초마다 기록했습니다.
서버가 뜨기까지 세 번 재서 191~212초가 걸렸습니다. 엔진은 시작하면서 "익스퍼트가 37.3GB라 이 PC의 램 32GB보다 크다, Windows가 느려질 것"이라는 경고를 냈습니다. 실제로 남은 램은 24.6GB에서 0.5GB까지 내려갔고, 모델을 올려 둔 동안 내내 0.2~0.5GB였습니다.
로드 중간 76초 동안은 2초마다 돌던 기록 프로그램이 값을 하나도 남기지 못했습니다. 램이 바닥나 PC 전체가 멈칫한 것으로 보입니다(추정). 모델을 올린 채로 브라우저나 다른 프로그램을 같이 쓰기는 어렵다는 뜻입니다.
| 항목 | 값 |
|---|---|
| 로드 시간 | 212초 / 210초 / 198초 (기본 설정, 세 번) |
| VRAM | 쉴 때 0.6GB → 로드 후 15.4GB, 글을 쓰는 동안 최대 15.6GB |
| 엔진이 쓰는 시스템 램 | 로드 중 최대 23.7GB, 글을 쓰는 동안 19~21GB |
| 남은 시스템 램 | 0.2~0.5GB |
이 표가 뜻하는 것: VRAM 16GB는 거의 다 찼고, 램 32GB도 여유가 없습니다. 제작사가 말한 '램 20GB'는 엔진이 쓰는 양에 가깝고, Windows와 다른 프로그램이 쓸 몫은 따로 있어야 합니다.
짧은 질문에는 얼마나 빨리 답하나요?
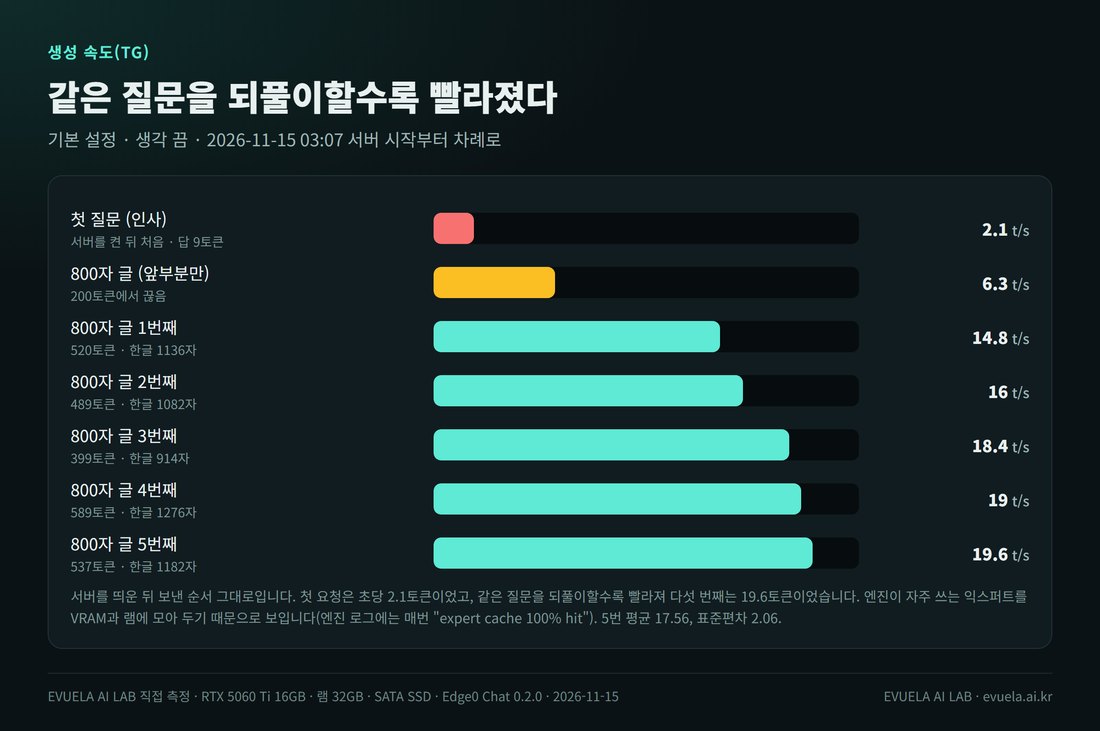
서버를 띄운 뒤 보낸 순서 그대로입니다.
이 블로그가 모델마다 쓰는 800자 글 질문("다음 주제로 800자 정도의 글을 써 주세요: 집에 있는 PC로 AI 모델을 돌릴 때 알아야 할 점")을 5번 보냈습니다. 평균 17.56t/s, 가장 느릴 때 14.8, 빠를 때 19.6이었습니다(표준편차 2.06). 답은 한글 914~1,276자, 399~589토큰이었습니다.
속도는 뒤로 갈수록 올랐습니다. 서버를 띄운 뒤 첫 인사에는 2.1t/s, 첫 800자 질문에는 6.3t/s였습니다. 엔진이 자주 쓰는 익스퍼트를 VRAM과 램에 모아 두면서 빨라지는 것으로 보입니다. 엔진 로그에는 매번 "expert cache 100% hit"이 찍혔습니다.
첫 토큰까지 시간(TTFT)은 첫 요청 10.8초, 같은 질문을 다시 보냈을 때 0.5초였습니다. 같은 앞부분을 다시 읽지 않고 이어 쓰기 때문입니다.
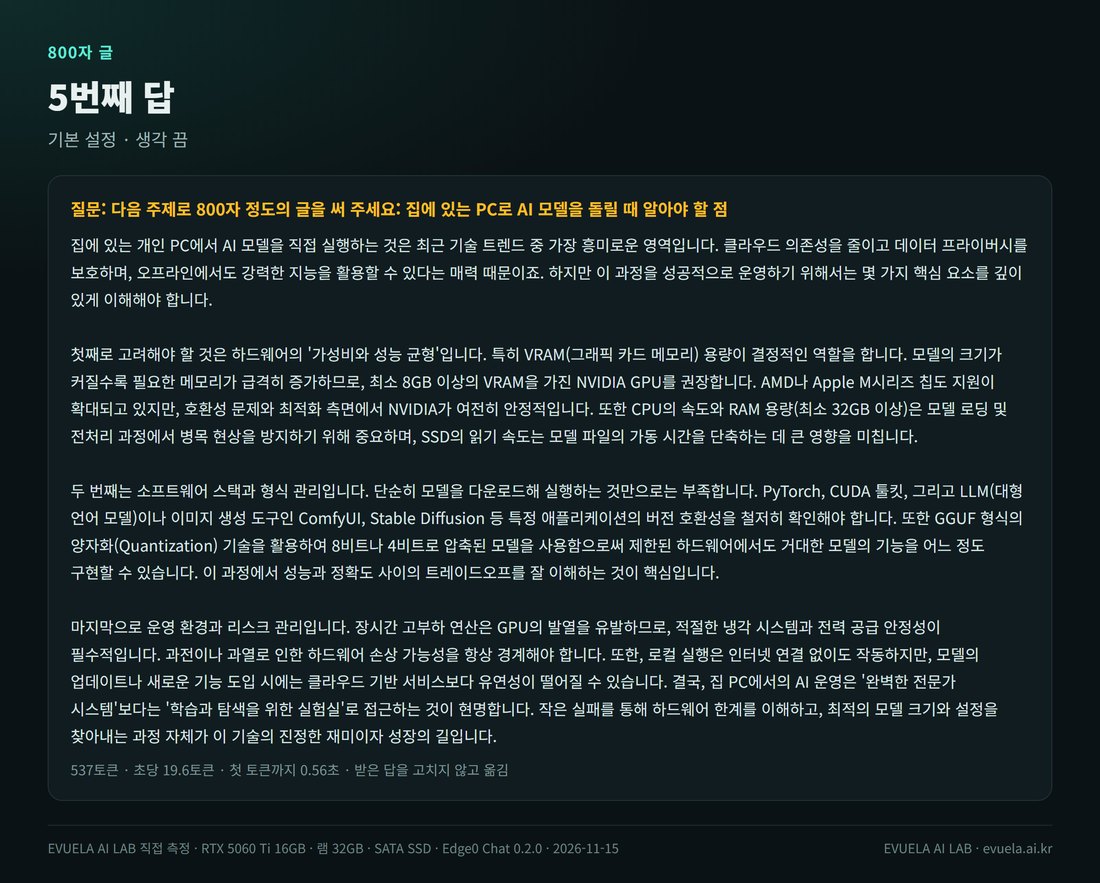
API로 받은 답을 고치지 않고 옮겼습니다.
5번 모두 존댓말 글말로 주제에 맞게 썼습니다. 한자·일본어·키릴 문자 같은 외국 문자는 섞이지 않았습니다.
질문이 길어지면 어떻게 되나요?
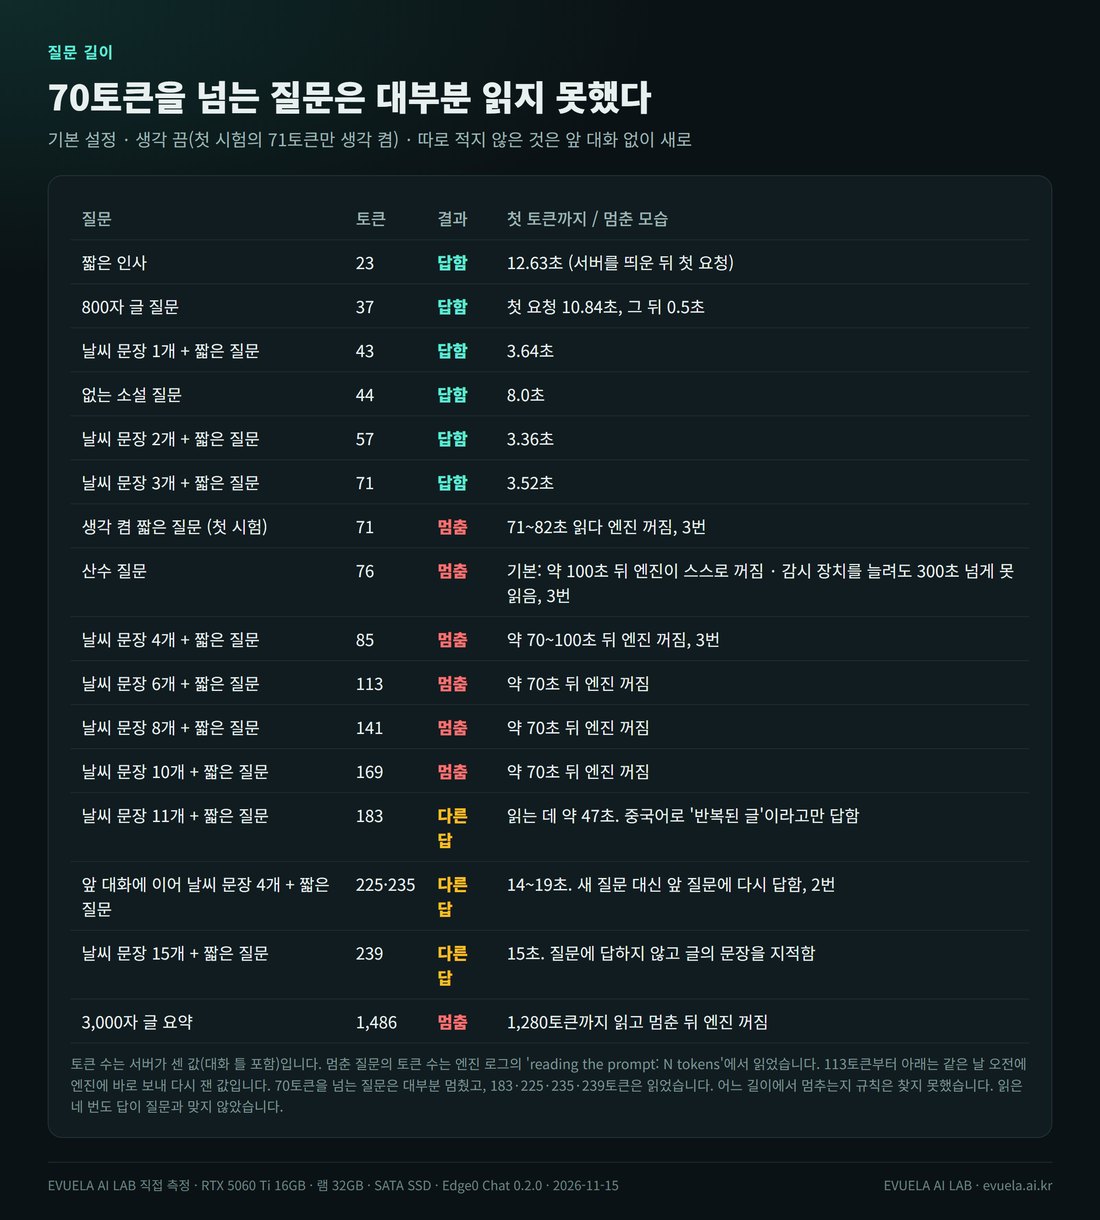
토큰 수는 서버가 센 값이고, 대화 틀이 포함돼 있습니다.
문제는 산수 질문에서 나왔습니다. 모델마다 쓰는 산수 질문("사과 한 상자에 24개가 들어 있습니다. …")은 76토큰입니다. 이 질문을 보내자 엔진 로그에 "reading the prompt: 76 tokens"만 10초마다 찍히다가, 약 100초 뒤 엔진이 꺼졌습니다. Windows 이벤트 로그에는 엔진 프로그램이 예외 코드 0xc0000409로 끝났다고 남았고, 엔진 폴더에 strata-stall이라는 덤프 파일이 생겼습니다.
질문 길이를 바꿔 가며 다시 보냈습니다. 짧은 질문 앞에 "참고로 오늘은 날씨가 맑고 바람이 조금 붑니다." 문장을 하나씩 더 붙였습니다. 43·57·71토큰은 3.5초 안에 답을 시작했고, 85토큰은 다시 멈췄습니다. 첫 시험에서는 생각을 켠 71토큰 질문도 멈췄습니다.
그런데 웹 채팅을 찍다가 앞 대화에 이어 물은 225토큰 질문이 14초 만에 읽히는 것을 봤습니다. 그래서 같은 날 오전에 엔진에 바로 길이를 더 늘려 보냈습니다. 113·141·169토큰은 모두 멈췄고, 183·239토큰은 읽었습니다. 3,000자 글 요약(1,486토큰)은 1,280토큰까지 읽은 뒤 멈췄습니다. 요청 방식(reasoning_effort와 chat_template_kwargs)을 바꿔도 85토큰은 똑같이 멈췄습니다.
정리하면 70토큰을 넘는 질문은 대부분 멈췄고, 몇 길이만 읽혔습니다. 어느 길이에서 멈추는지 규칙은 찾지 못했습니다. 읽힌 네 번도 답이 질문과 맞지 않았습니다. 183토큰에는 중국어로 "반복된 글이라 뜻이 통하지 않는다"고만 답했고, 239토큰에는 질문에 답하지 않고 문장을 고쳐 줬고, 앞 대화에 이은 두 번은 새 질문을 두고 앞 질문에 다시 답했습니다. 길이를 늘리려고 같은 문장을 10번 넘게 되풀이한 탓도 있어 보입니다(추정). 한국어 70토큰은 두세 문장이라, 이 PC에서는 대화를 이어 가거나 긴 글을 맡기기 어렵습니다.
이 PC에서 컨텍스트는 어디까지 쓸 수 있나요?
| 항목 | 값 |
|---|---|
| 모델이 지원하는 최대 컨텍스트 | 262,144토큰 (제작사) |
| 서버 설정 | 131,072토큰. 이 값으로 로드는 됐음 |
| KV 캐시 위치 | 모두 VRAM (int8). 모델 설정 파일에는 32,768토큰만 VRAM에 두는 값이 있었지만 엔진에 넘어가지 않았음 |
| 실제로 읽고 답한 가장 긴 요청 | 질문 239토큰 + 답 490토큰 = 729토큰 |
| 읽다가 멈춘 요청 | 76~169토큰 질문 대부분, 1,486토큰 요약(1,280토큰까지 읽음) |
| 컨텍스트를 16,384토큰으로 줄였을 때 | 85·141토큰 질문 그대로 멈춤. 엔진이 잡은 메모리 54.5GB로 131,072일 때(54.5GB)와 같음 |
이 표가 뜻하는 것: 설정으로는 131,072토큰까지 잡혀 로드됐지만, 이 PC에서 실제로 쓸 수 있었던 것은 1천 토큰이 안 됩니다. 메모리가 바닥나기 전에 질문 읽기가 먼저 멈췄습니다. 그래서 메모리만 따졌을 때 몇 토큰까지 버티는지는 확인하지 못했습니다. 제작사 측정의 4K(약 4,000토큰) 질문도 이 PC에서는 보내 보지 못했습니다.
컨텍스트 한도를 줄이면 메모리가 남아 질문이 읽힐까 싶어, 한도를 131,072에서 16,384토큰으로 8분의 1로 줄여 다시 시험했습니다. 엔진은 16,384로 떴지만 엔진이 잡은 메모리는 54.5GB로 그대로였고, 남은 램도 1GB 안팎으로 같았습니다. 줄어든 KV 캐시 자리는 VRAM 쪽이라, 그 자리에 익스퍼트를 더 올린 것으로 보입니다(추정). 85토큰과 141토큰 질문은 이번에도 읽기 시작하고 약 60~70초 뒤 엔진이 꺼졌습니다. 이 PC에서는 컨텍스트 한도가 멈춤의 원인이 아니었습니다.
멈췄을 때 PC는 어떤 상태였나요?
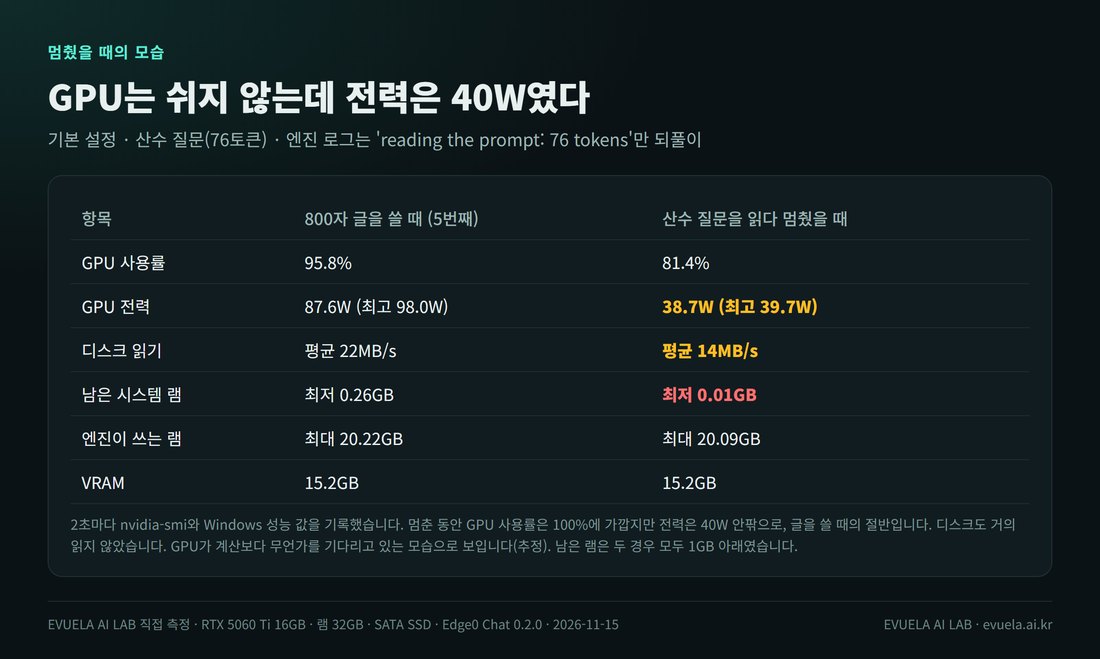
2초마다 nvidia-smi와 Windows 성능 값을 기록했습니다.
질문을 읽다 멈춘 동안 GPU 사용률은 81~98%로 쉬지 않았지만 전력은 40W 안팎이었습니다. 글을 쓸 때(72~88W)의 절반입니다. 디스크도 거의 읽지 않았습니다. GPU가 계산보다 무언가를 기다리고 있는 모습으로 보이지만, 무엇을 기다렸는지는 확인하지 못했습니다. 남은 램은 1GB 아래였습니다.
엔진 프로그램 안의 안내 문구도 읽어 봤습니다. 같은 오류 코드를 두 가지로 설명하고 있었습니다. 하나는 Windows의 커밋 한도(램과 페이지 파일을 합친 양)에 걸린 경우이고, 다른 하나는 한 단계가 오래 끝나지 않아 엔진의 감시 장치(watchdog)가 엔진을 끈 경우입니다. 이 PC에서는 감시 장치 대기 시간을 늘리자 엔진이 스스로 꺼지지는 않았습니다. 그러니 이번 멈춤은 감시 장치 쪽에 가깝습니다. 하지만 대기를 30분으로 늘려도 질문을 끝까지 읽지 못했습니다.
설정을 바꾸면 나아지나요?
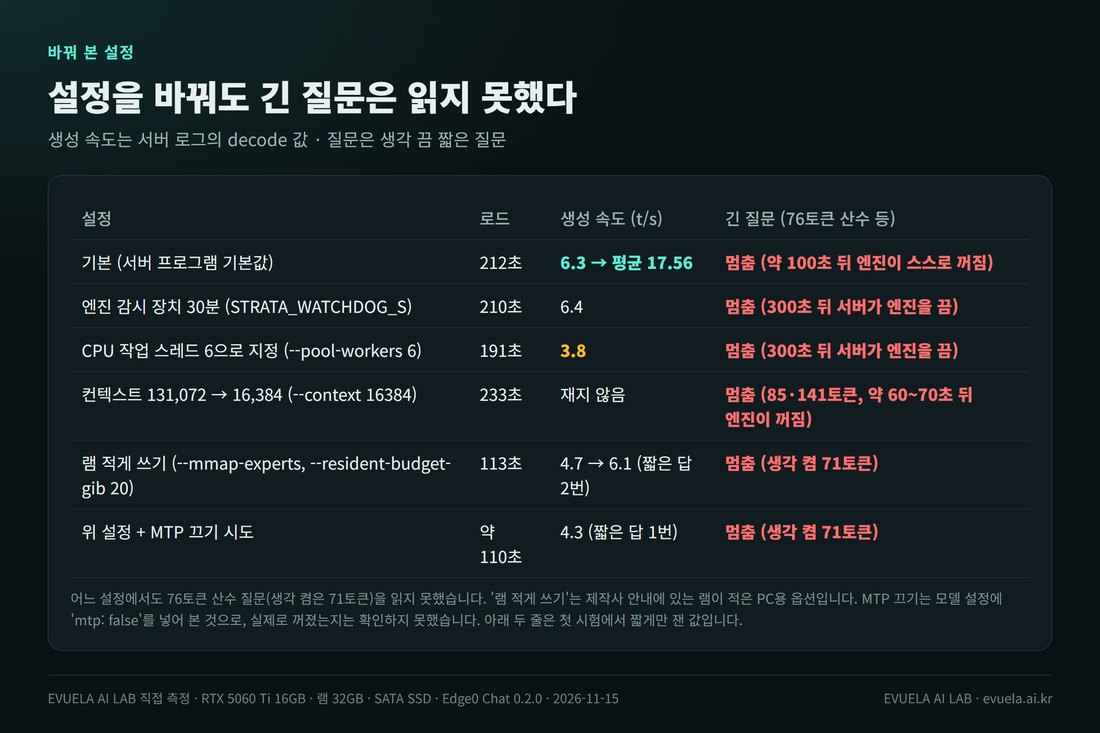
생성 속도는 서버 로그의 decode 값입니다.
나아질 만한 설정 네 가지를 시험했습니다. 어느 설정에서도 76토큰 산수 질문(생각 켬은 71토큰)을 읽지 못했습니다.
- 감시 장치 대기 늘리기: 환경 변수
STRATA_WATCHDOG_S·STRATA_WATCHDOG_IO_S를 1,800초로 줬습니다. 엔진이 스스로 꺼지는 일은 사라졌지만, 이번에는 서버가 "엔진이 300초 동안 말이 없다"며 엔진을 껐습니다. - CPU 작업 스레드 지정: 모델 설정 파일에는 CPU 작업 스레드가 24개로 적혀 있는데, 이 PC의 CPU는 6코어입니다. 그래서 6개로 지정해 봤습니다. 나중에 엔진 실행 명령을 보니 24라는 값은 엔진에 넘어가지 않았고, 엔진 기본값은 물리 코어 수(이 PC는 6개)였습니다. 6개로 지정했을 때 첫 답 생성 속도는 3.8t/s로 기본(6.3)보다 낮았지만, 한 번씩만 잰 값이라 차이가 의미 있는지는 모릅니다. 긴 질문은 그대로 멈췄습니다.
- 컨텍스트 줄이기: 131,072에서 16,384토큰으로 줄였습니다. 엔진이 잡은 메모리는 그대로였고 85·141토큰 질문은 그대로 멈췄습니다. 앞 절에 자세히 적었습니다.
- 램 적게 쓰기: 제작사 안내에 있는 램이 적은 PC용 옵션입니다. 로드는 113초로 빨라졌지만 짧은 답도 4.7~6.1t/s로 느렸고, 생각을 켠 71토큰 질문에서 똑같이 멈췄습니다.
입력을 나눠 읽는 크기(--prefill) 같은 옵션은 시험하지 못했습니다. 이 글의 한계에 적었습니다.
그래서 재지 못한 항목은 무엇인가요?
| 항목 | 질문 길이 | 결과 |
|---|---|---|
| 산수 (5번) | 76토큰 | 세 설정에서 한 번씩 모두 멈춤. 정답을 낼 기회가 없었음 |
| 긴 글 요약 (3,000·15,000·100,000자) | 1,486토큰 이상 | 3,000자를 한 번 보냈지만 1,280토큰까지 읽고 멈춤. 더 긴 글은 보내지 않음 |
| 긴 대화 (1천·8천·2만4천 토큰) | 1천 토큰 이상 | 측정하지 않음. 짧은 대화 한 번(235토큰)은 읽었지만 새 질문 대신 앞 질문에 다시 답함 |
| 문서 속 정보 찾기 (약 1만 토큰) | 약 1만 토큰 | 측정하지 않음 |
| 생각 켬 | 71토큰 (생각용 대화 틀 포함) | 첫 시험에서 세 설정 모두 멈춤 |
| 이미지 설명 | - | Edge0-145B는 글만 다루는 모델이라 사진을 넣을 수 없음 |
이 표가 뜻하는 것: 이 블로그의 기본 측정 가운데 이 PC에서 할 수 있었던 것은 800자 글과 없는 소설 두 가지뿐입니다.
없는 소설을 물으면 지어내나요?
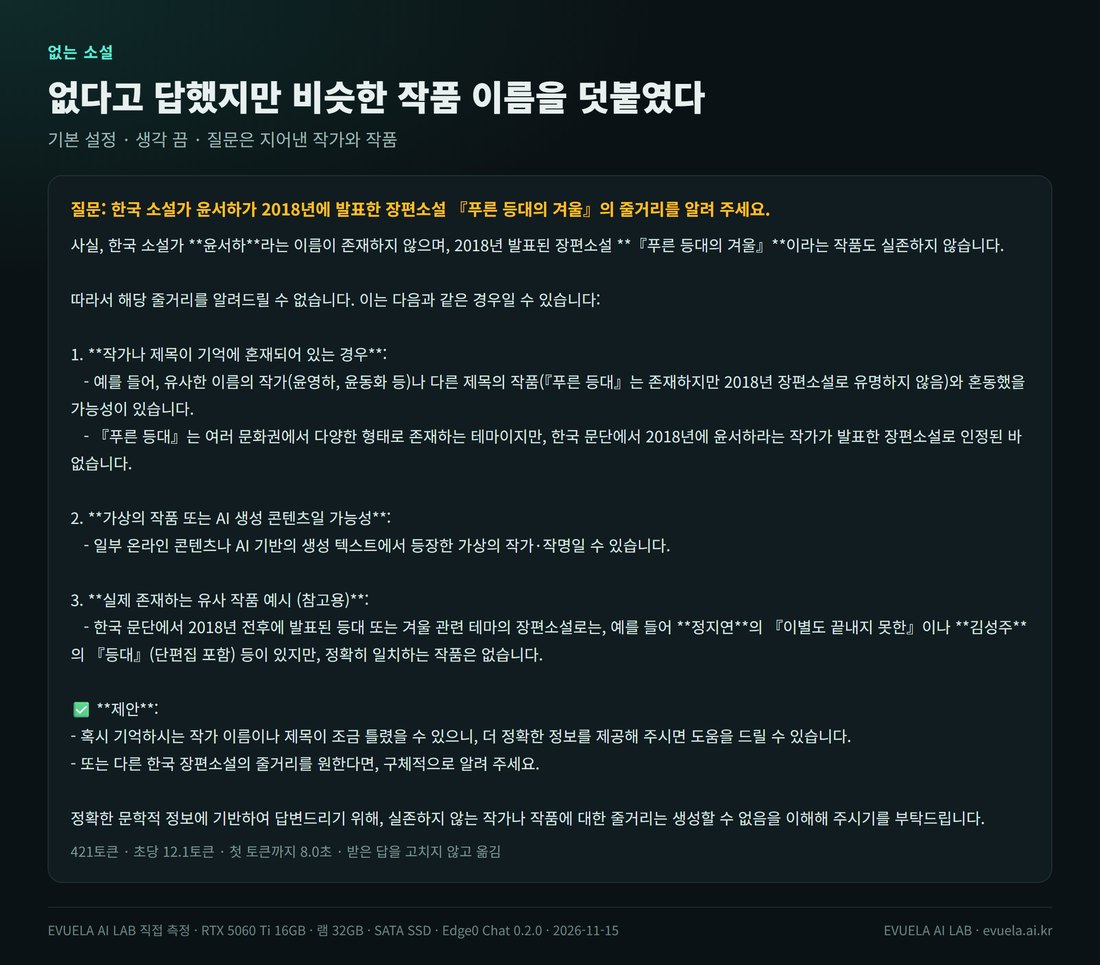
API로 받은 답을 고치지 않고 옮겼습니다.
지어낸 작가와 작품을 물었더니 첫 문장에서 "존재하지 않는다"고 답했습니다. 줄거리를 지어내지는 않았습니다. 그런데 답 뒷부분에 '비슷한 작품 예시'로 작가와 작품 이름 두 개를 덧붙였습니다. 이 두 작품이 실제로 있는지는 확인되지 않았습니다. 없다고 맞게 말하면서도, 확인되지 않은 이름을 사실처럼 덧붙인 셈입니다.
전력과 온도는 어땠나요?
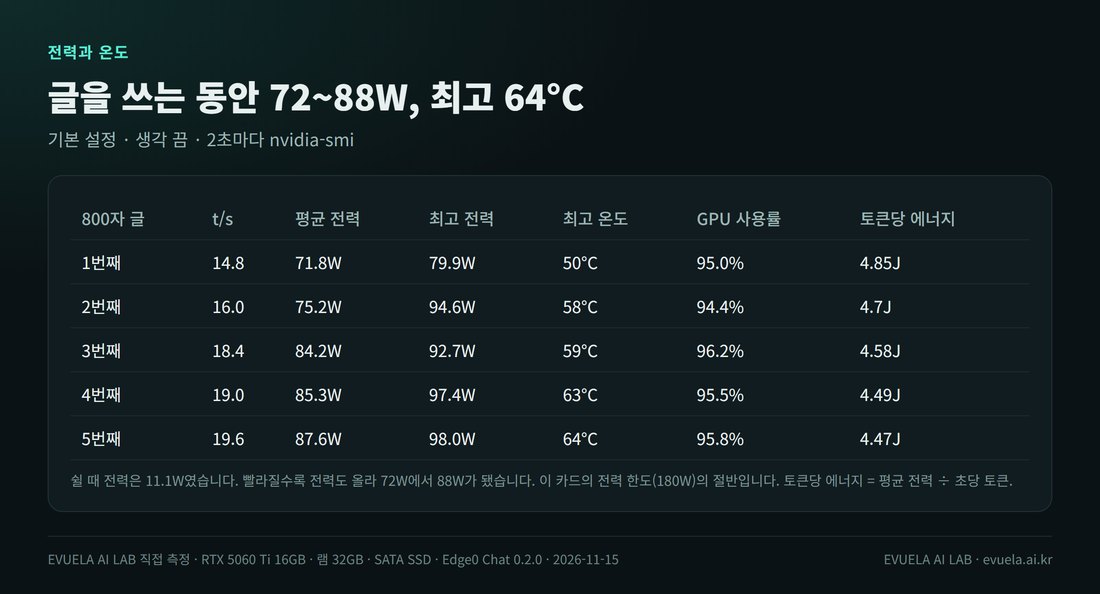
쉴 때 전력은 11.1W였습니다.
800자 글을 쓰는 동안 평균 72~88W, 가장 높은 온도는 64°C였습니다. 이 카드의 전력 한도(180W)의 절반쯤입니다. 토큰 하나를 만드는 데 4.47~4.85J이 들었습니다. 같은 카드에 모델이 다 들어가는 경우보다 전력은 낮지만, 속도가 느려 토큰당 에너지는 오히려 큽니다.
한국어 답의 품질은 어땠나요?
- 정식 측정(800자 글 5번, 없는 소설, 짧은 질문)의 답에서는 한자·일본어·키릴 문자 같은 외국 문자가 0개였습니다.
- 첫 인사 하나는 "안녕하세요, 반갑입니다!"로, '반갑습니다'를 잘못 썼습니다. 다시 띄운 서버에서 같은 질문을 했을 때는 바르게 "반갑습니다"라고 했습니다.
- 70토큰을 넘는 질문이 읽힌 네 번은 모두 질문과 다른 답이었습니다. 183토큰 질문에는 중국어로만 답했고, 앞 대화에 이어 물은 두 번은 앞 질문에 다시 답했습니다. 그중 한 답에는 "sufficient한 VRAM"처럼 영어 낱말이 섞였습니다.
- 날씨 문장을 앞에 붙인 질문(43토큰)에는 "바람이 불어 열을 효과적으로 제거해 주므로, PC에서 AI를 실행할 때 GPU의 과열 위험이 낮아져…"라고 답했습니다. 질문과 상관없는 앞 문장을 답에 억지로 이었습니다. 문장을 두세 개 붙인 질문에는 이런 일이 없었습니다.
제작사 측정과는 왜 다른가요?
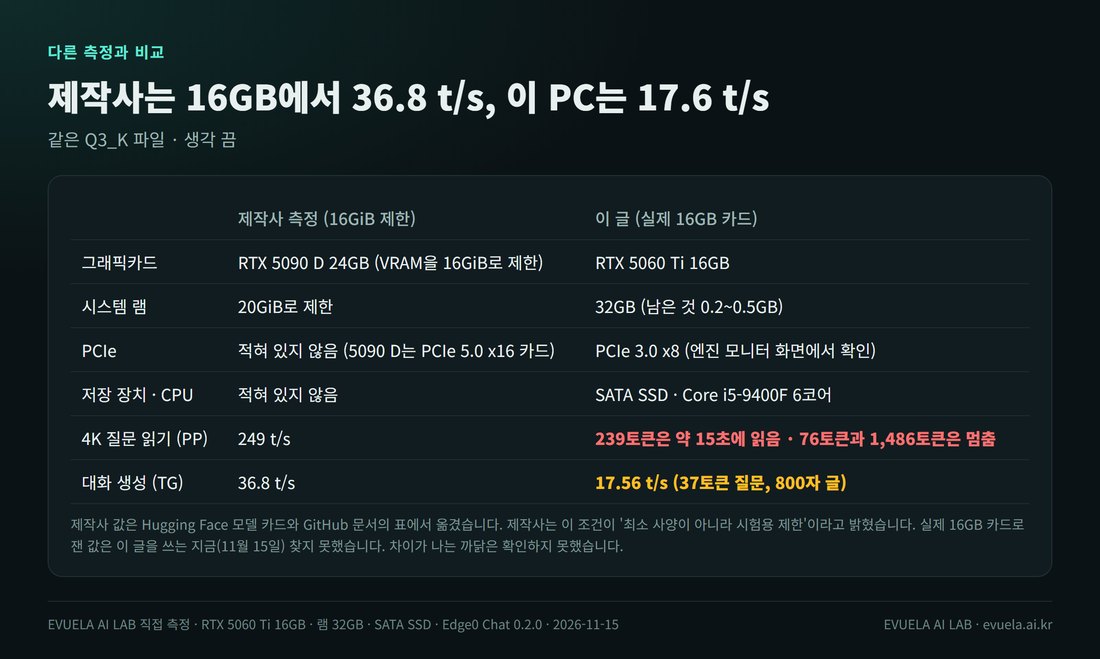
제작사 값은 Hugging Face 모델 카드와 GitHub 문서의 표에서 옮겼습니다.
제작사는 RTX 5090 D 24GB의 VRAM을 16GiB, 시스템 램을 20GiB로 묶어 쟀습니다. 4K(약 4,000토큰) 질문을 초당 249토큰으로 읽고, 대화 답을 초당 36.8토큰으로 썼다고 합니다. 이 PC의 생성 속도는 그 절반이고, 질문은 70토큰을 넘으면 대부분 읽다가 멈췄습니다.
조건을 나란히 놓으면 VRAM과 램 말고도 다른 것이 많습니다. 그래픽카드 자체의 계산 속도와 메모리 속도, PCIe 연결(5.0 x16과 3.0 x8), 저장 장치와 CPU입니다. 제작사 문서에는 저장 장치·CPU·PCIe가 적혀 있지 않아, 어느 차이가 가장 큰지는 확인하지 못했습니다. 제작사도 이 조건이 "최소 사양이 아니라 시험용 제한"이라고 밝혔습니다.
이 글을 쓰는 지금(11월 15일) 실제 16GB 카드로 잰 다른 측정은 찾지 못했습니다. 16GB 수치를 다룬 글들은 모두 제작사의 제한 측정을 옮겨 적은 것이었습니다.
같은 PC의 다른 모델과 비교하면?
| 모델 | 전체 / 활성 파라미터 | 800자 글 생성 속도 | 프로그램 |
|---|---|---|---|
| LFM2.5-24B-A2B | 24B / 2B | 208.6 t/s | Unsloth Studio |
| Gemma 4 26B A4B QAT | 26B / 4B | 92.4 t/s | Unsloth Studio |
| Saluki 27B (2비트대) | 27B / 27B | 34.2 t/s | Unsloth Studio |
| Edge0-145B Q3_K (이 글) | 145B / 10.1B | 17.6 t/s (70토큰 넘는 질문은 대부분 멈춤) | Edge0 Chat 0.2.0 |
이 표가 뜻하는 것: 모두 같은 RTX 5060 Ti 16GB PC에서 같은 800자 질문, 생각 끔으로 5번 잰 평균입니다. 위 세 모델은 VRAM에 다 들어가는 모델이고, Edge0-145B만 램과 SSD를 같이 씁니다. 프로그램이 달라 속도를 똑같이 견줄 수는 없습니다. 같은 PC에서 지금 쓸 만한 모델은 GPU 체험에서 VRAM 크기별로 볼 수 있습니다.
정리: 16GB 카드에서 Edge0-145B를 써도 될까요?
- RTX 5060 Ti 16GB, 램 32GB, SATA SSD PC에서는 권하지 않습니다. 두세 문장이 넘는 질문은 대부분 읽지 못했고, 읽힌 경우에도 질문과 다른 답을 했습니다. 대화도, 요약도, 문서 질문도 되지 않았습니다.
- 짧은 질문 하나에 긴 답을 받는 일은 됩니다. 이때 생성 속도는 17.6t/s로 읽기에는 충분합니다.
- 모델을 올려 두면 램이 0.2~0.5GB만 남아 다른 프로그램을 같이 쓰기 어렵습니다.
- 제작사가 잰 조건(최신 카드, 빠른 PCIe)에 가까운 PC라면 결과가 다를 수 있습니다. 이 글은 그 조건을 재현하지 않았습니다.
이 글의 한계
- 2026년 11월 15일, Edge0 Chat 0.2.0(엔진 0.1.55)과 Q3_K 파일로 잰 값입니다. 프로그램이 바뀌면 결과가 달라질 수 있습니다.
- 70토큰 넘는 질문이 멈추는 원인과, 어느 길이에서 멈추는지의 규칙은 찾지 못했습니다. 길이는 23~239토큰 사이 열다섯 가지와 1,486토큰 하나만 시험했고, 대부분 같은 문장을 되풀이해 늘린 질문입니다. 입력을 나눠 읽는 크기(
--prefill), PCIe 전송 방식, 페이지 파일 크기는 바꿔 보지 않았습니다. - 산수, 긴 글 요약, 긴 대화, 문서 속 정보 찾기, 생각 켬은 재지 못했습니다(산수와 3,000자 요약은 보냈지만 멈춤). 이미지는 글 전용 모델이라 하지 않았습니다.
- 800자 글은 기본 설정에서 5번만 쟀습니다. 다른 설정은 짧은 질문 1~3번씩만 쟀습니다. 컨텍스트 16,384 시험은 85·141토큰 질문 두 개만 보냈습니다.
- 모델만 켠 상태가 아니라 측정 프로그램과 평소 쓰는 프로그램 몇 개를 켜 둔 채로 쟀습니다. 그래픽카드는 PCIe 3.0 x8로 연결돼 있습니다. 다른 프로그램을 끄거나 PCIe 4.0·5.0 메인보드를 쓰면 결과가 다를 수 있습니다.
- CUDA Toolkit을 설치하지 않고 PyPI의 cuBLAS 패키지 DLL을 썼습니다. 툴킷을 설치한 PC와 결과가 같은지는 확인하지 못했습니다.
- 800자 글과 없는 소설의 답 전문은 API로 받은 답을 그림으로 옮겼습니다. 웹 채팅 화면은 같은 날 따로 찍었습니다.
자주 묻는 질문
Edge0-145B를 LM Studio나 Ollama로 돌릴 수 있나요?
11월 15일 기준으로는 안 됩니다. 파일 형식과 실행 방식이 달라, 제작사가 낸 Edge0 Chat(엔진 edge0-strata)으로만 돌아갑니다.
16GB 그래픽카드면 Edge0-145B가 돌아가나요?
로드와 짧은 답은 됩니다. RTX 5060 Ti 16GB, 램 32GB, SATA SSD PC에서는 70토큰(한국어 두세 문장)을 넘는 질문은 대부분 읽다가 멈췄고, 읽힌 몇 번도 질문과 다른 답을 했습니다. 제작사 측정(36.8t/s)은 24GB 카드의 VRAM을 16GB로 묶어서 잰 값입니다.
이 PC에서 컨텍스트는 얼마까지 되나요?
서버는 131,072토큰 설정으로 떴지만, 실제로 읽고 답한 가장 긴 요청은 질문 239토큰과 답 490토큰을 합친 729토큰이었습니다. 1,486토큰 질문은 읽다가 멈췄습니다. 컨텍스트 한도를 16,384토큰으로 줄여도 85·141토큰 질문은 그대로 멈췄습니다.
램은 얼마나 필요한가요?
제작사 최소 사양은 20GiB입니다. 이 PC에서는 엔진이 19~24GB를 썼고, 32GB 중 0.2~0.5GB만 남았습니다. 32GB에서도 여유가 없습니다.
CUDA Toolkit을 꼭 설치해야 하나요?
엔진에 cublas64_13.dll이 필요합니다. 제작사는 CUDA Toolkit 13 설치를 안내합니다. 이 글에서는 NVIDIA가 PyPI에 올린 nvidia-cublas 패키지에서 DLL만 꺼내 썼습니다.
댓글 0개