"Apache 2.0" 검색 결과 16건

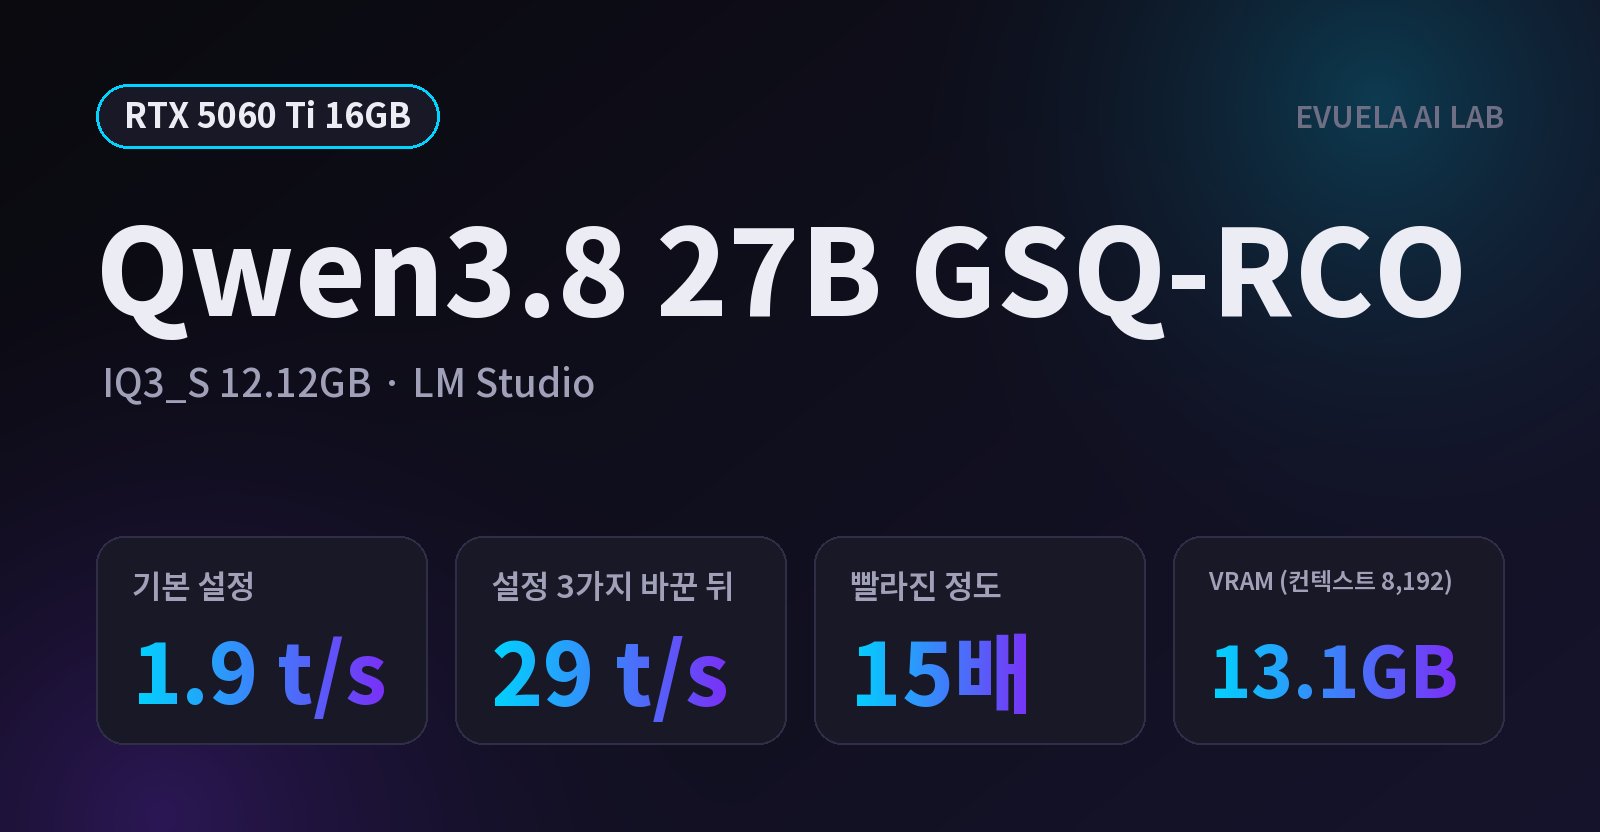
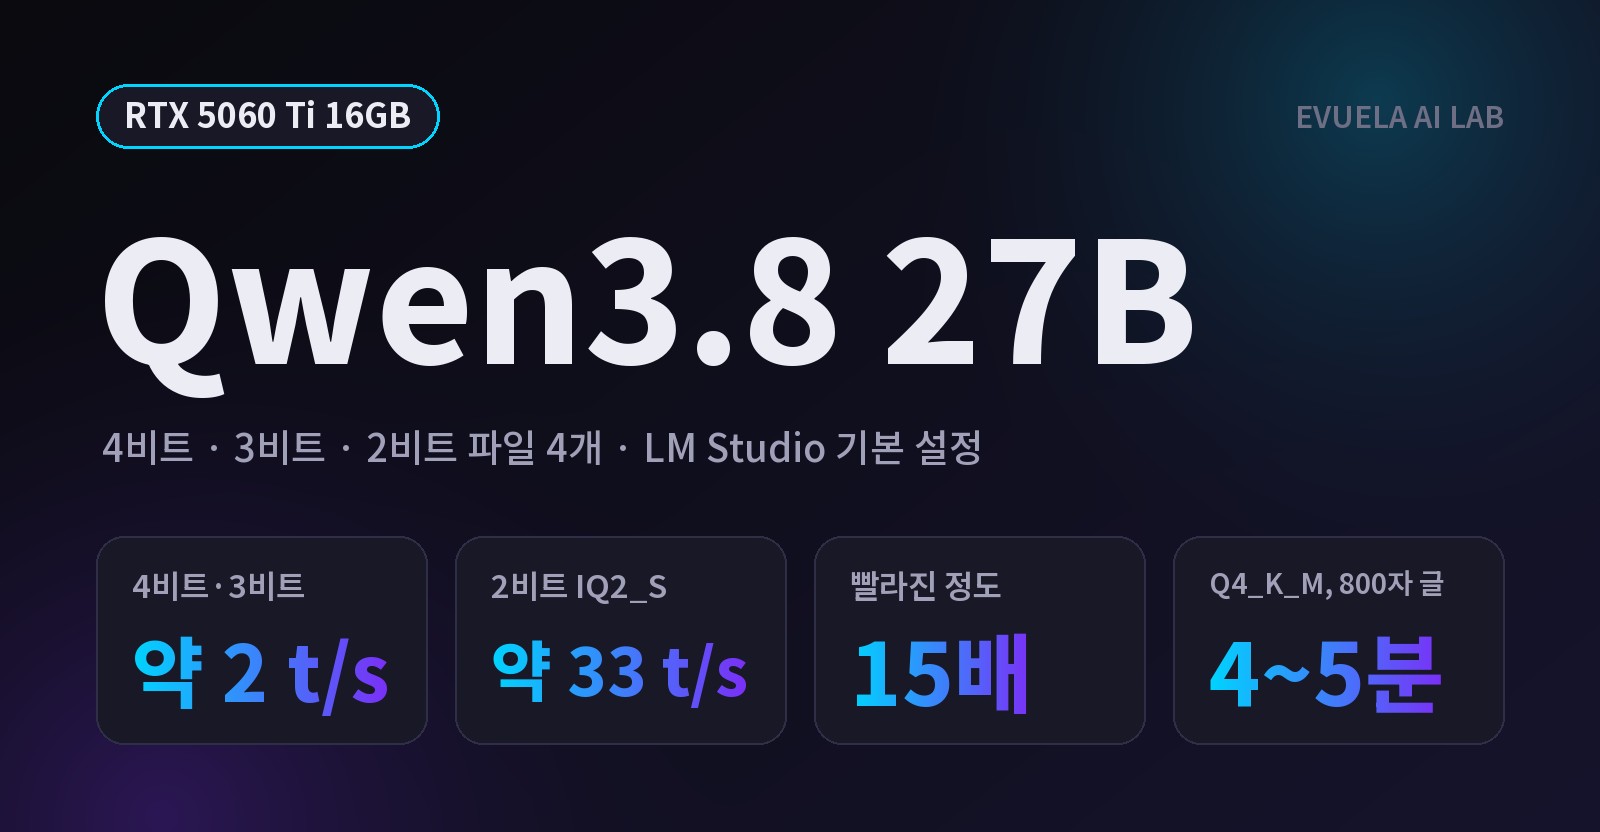
[RTX 5060 Ti 16GB] Qwen3.8 27B GSQ-RCO는 왜 2t/s밖에 안 나올까, 설정 세 가지를 바꾸자 29t/s가 됐다 RTX-5060TI 16GB

[RTX 5060 Ti 16GB] Qwen3.8 27B GSQ-RCO는 왜 2t/s밖에 안 나올까, 설정 세 가지를 바꾸자 29t/s가 됐다

RTX 5060 Ti 16GB PC의 LM Studio에서 Qwen3.8 27B GSQ-RCO(IQ3_S, 12.12GB)를 재 봤습니다. 기본 설정에서는 65개 레이어 중 56~58개만 GPU에 올라가 약 1.9t/s였고, Limit Model Offload 끄기·GPU 오프로드 최대·MTP 끄기 세 가지를 바꾸자 약 29t/s가 됐습니다. VRAM은 13.1GB, 컨텍스트는 32,768까지 맞았습니다.

2026.10.02 8
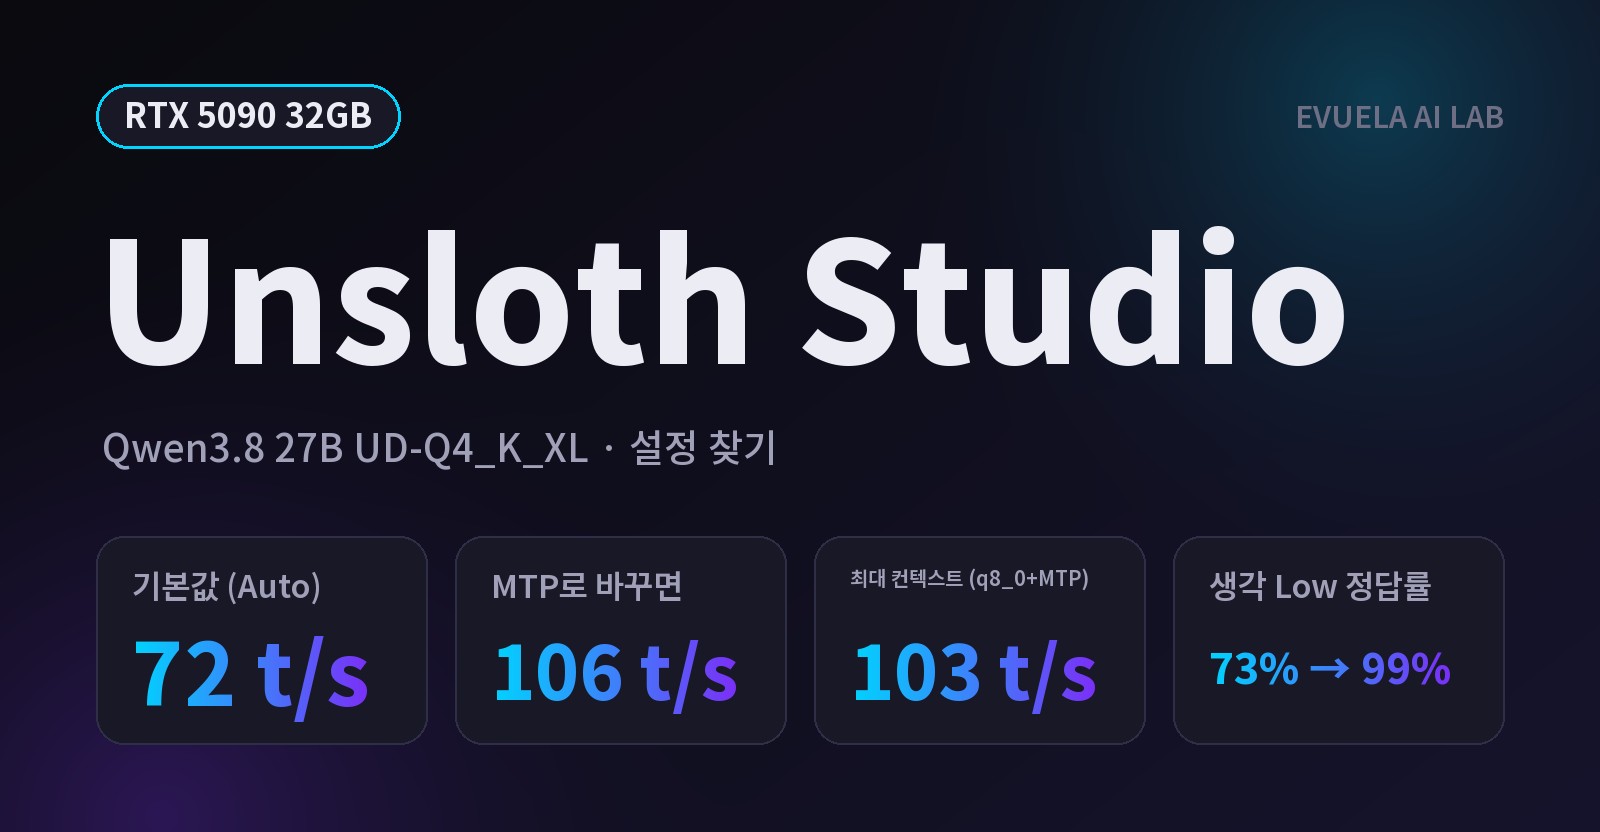
[RTX 5090 32GB] Unsloth Studio로 Qwen3.8 27B를 돌리면 어떤 설정이 좋을까, 최대 컨텍스트에서도 초당 103토큰이 나왔다 RTX-5090

[RTX 5090 32GB] Unsloth Studio로 Qwen3.8 27B를 돌리면 어떤 설정이 좋을까, 최대 컨텍스트에서도 초당 103토큰이 나왔다

Unsloth Studio를 RTX 5090에 설치하고 Qwen3.8 27B(UD-Q4_K_XL)로 설정을 하나씩 바꿔 가며 쟀습니다. 기본값은 컨텍스트를 16만 8천 토큰으로 알아서 잡았고 초당 72토큰이었습니다. 속도 기능을 MTP로 바꾸면 48% 빨라졌고, KV 캐시를 q8_0으로 줄이면 최대 컨텍스트 262,144에서도 초당 103토큰이 나왔습니다. 생각 단계별 정답률, 화면 캡처, 쓰임새별 추천 설정을 정리했습니다.

2026.10.02 16
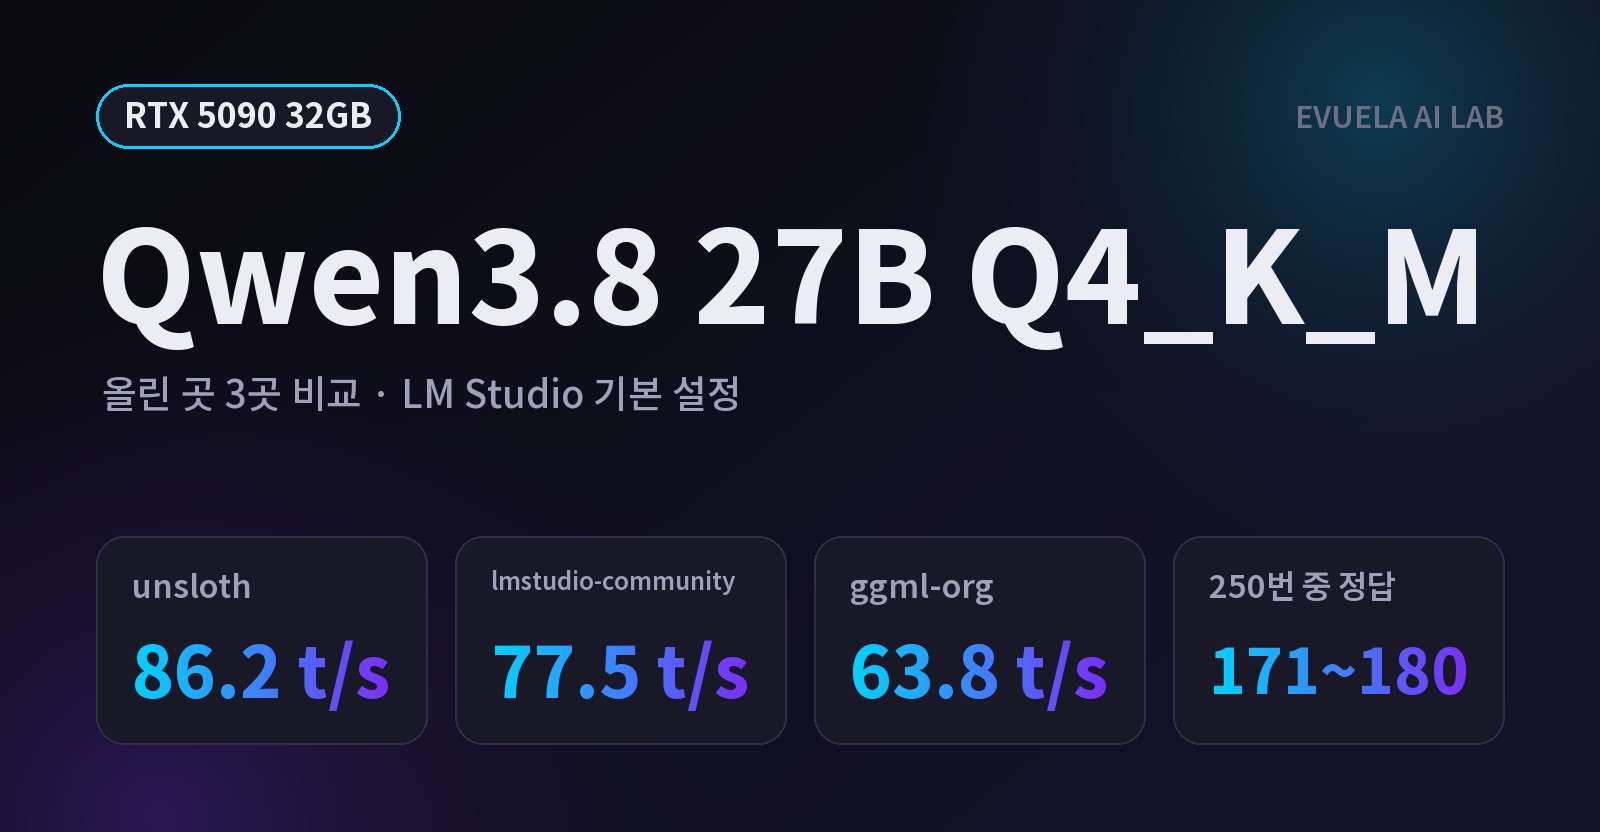
[RTX 5090 32GB] 같은 Q4_K_M인데 뭐가 다를까, unsloth·lmstudio-community·ggml-org의 Qwen3.8 27B는 정답률이 같고 속도만 달랐다 RTX-5090

[RTX 5090 32GB] 같은 Q4_K_M인데 뭐가 다를까, unsloth·lmstudio-community·ggml-org의 Qwen3.8 27B는 정답률이 같고 속도만 달랐다

Qwen3.8 27B Q4_K_M 파일을 lmstudio-community, unsloth, ggml-org 세 곳에서 받아 RTX 5090과 LM Studio로 비교했습니다. 채점 질문 250번 중 171~180번을 맞혀 정답률은 거의 같았고, 생성 속도는 초당 63.8~86.2토큰으로 달랐습니다. 차이는 파일 안에 MTP 레이어가 있느냐에서 나왔습니다. 파일 속 양자화 구성, VRAM, MCP 도구 호출 결과와 LM Studio 캡처를 함께 정리했습니다.

2026.10.01 31