[RTX 5060 Ti 16GB] 16GB 그래픽카드에서 Gemma 4 26B는 얼마나 빠를까, Unsloth Studio 기본값으로 초당 94토큰이었다
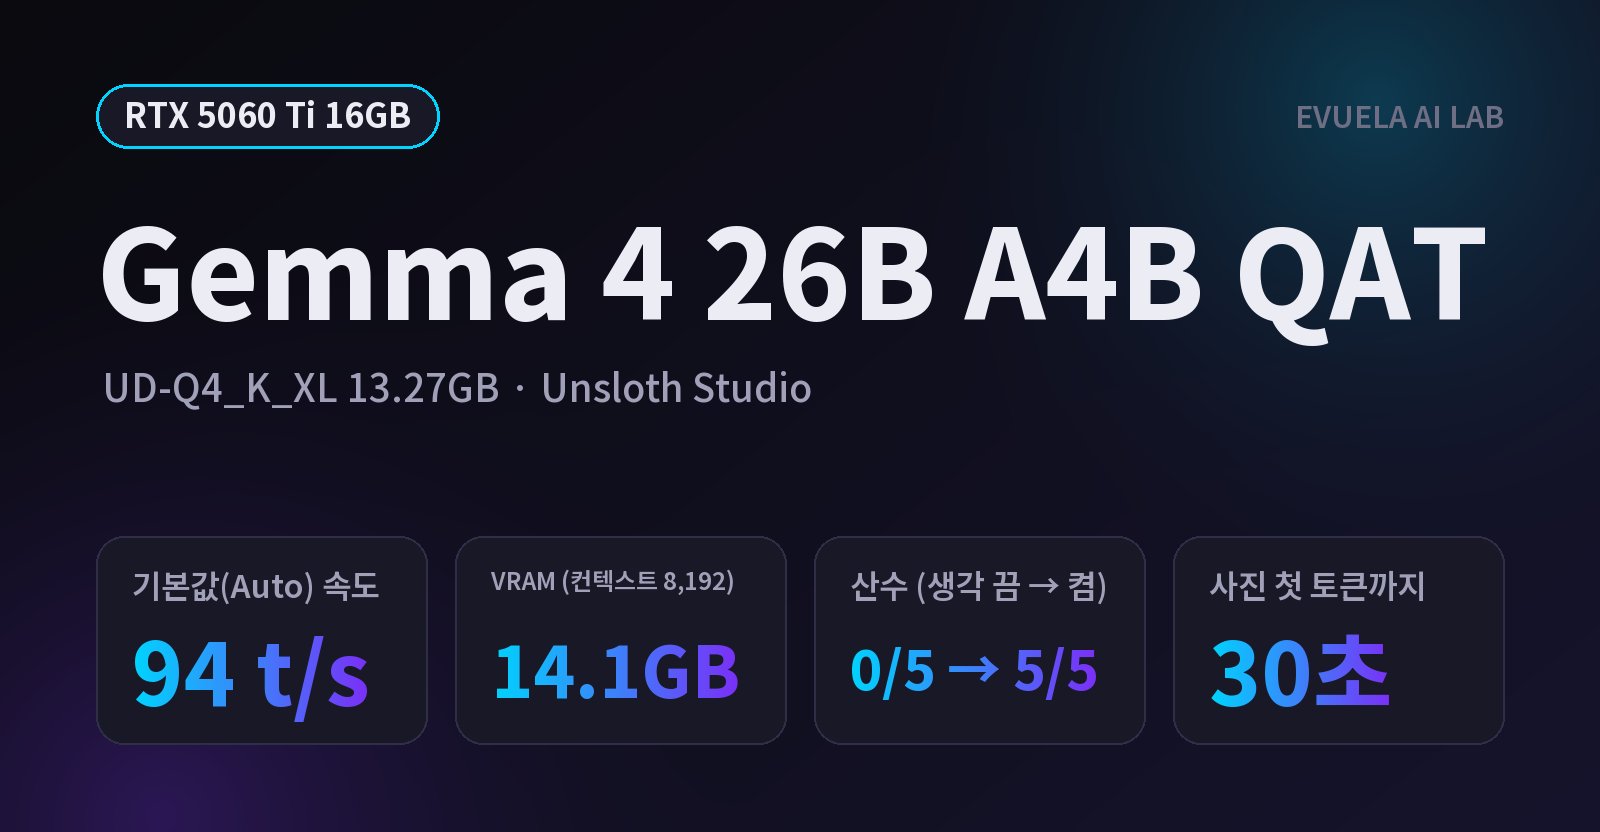
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"Gemma 4 26B" 검색 결과 5건
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.
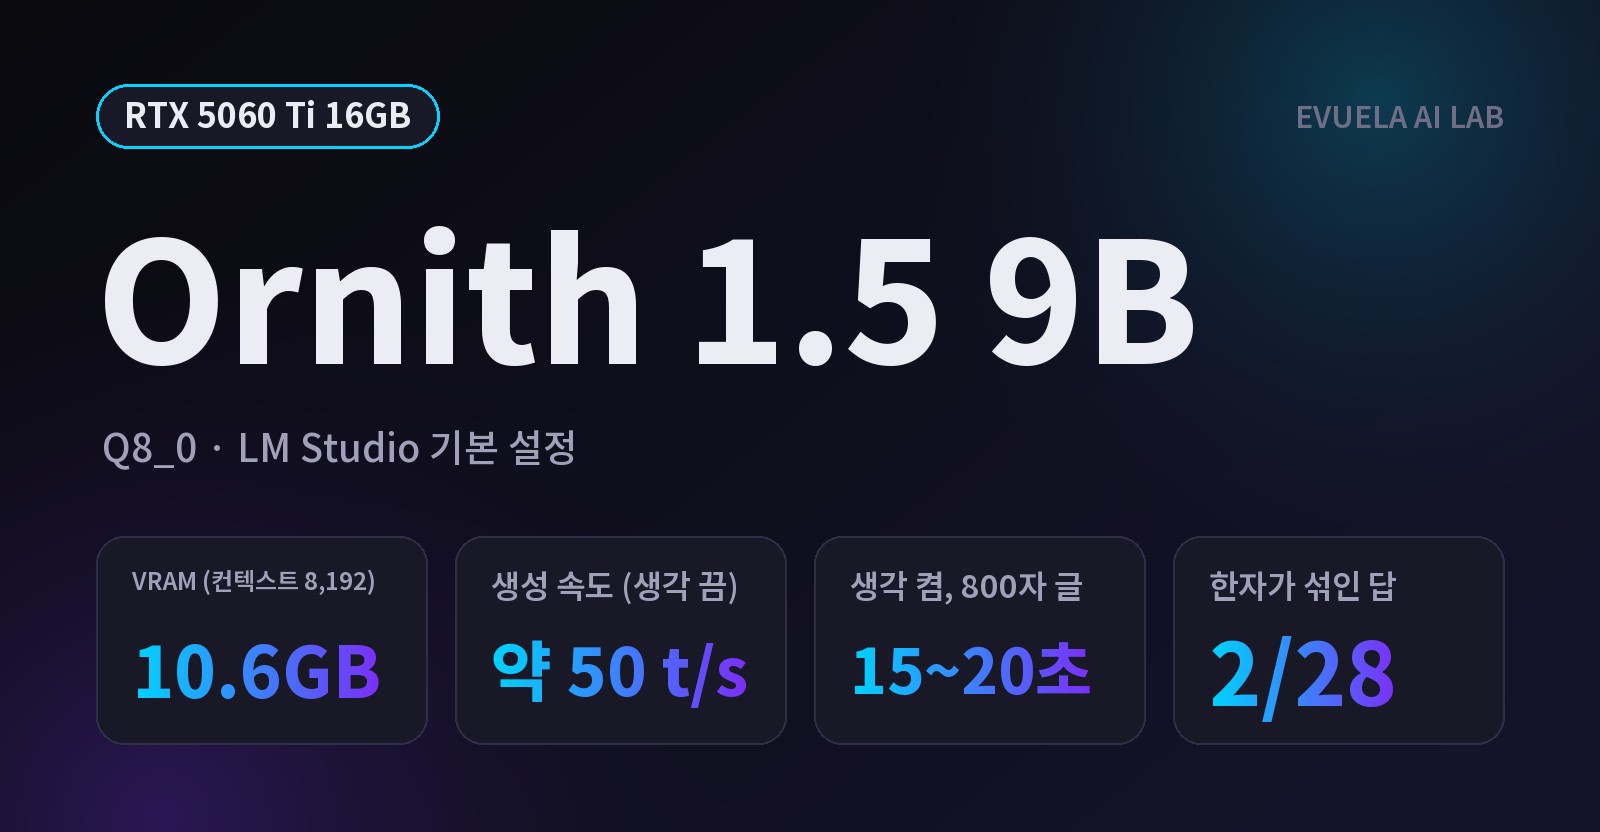
RTX 5060 Ti 16GB PC의 LM Studio에서 Ornith 1.5 9B(Q8_0, 9.79GB)를 기본 설정으로 재 봤습니다. VRAM 10.6GB, 생각 끔 약 50t/s, 생각 켬 56~65t/s였고 생각을 켜도 800자 글이 20초 안에 끝났습니다. 한국어 답 28개 중 2개에 한자가 섞였고, 형식 지시는 지키지 않았습니다.
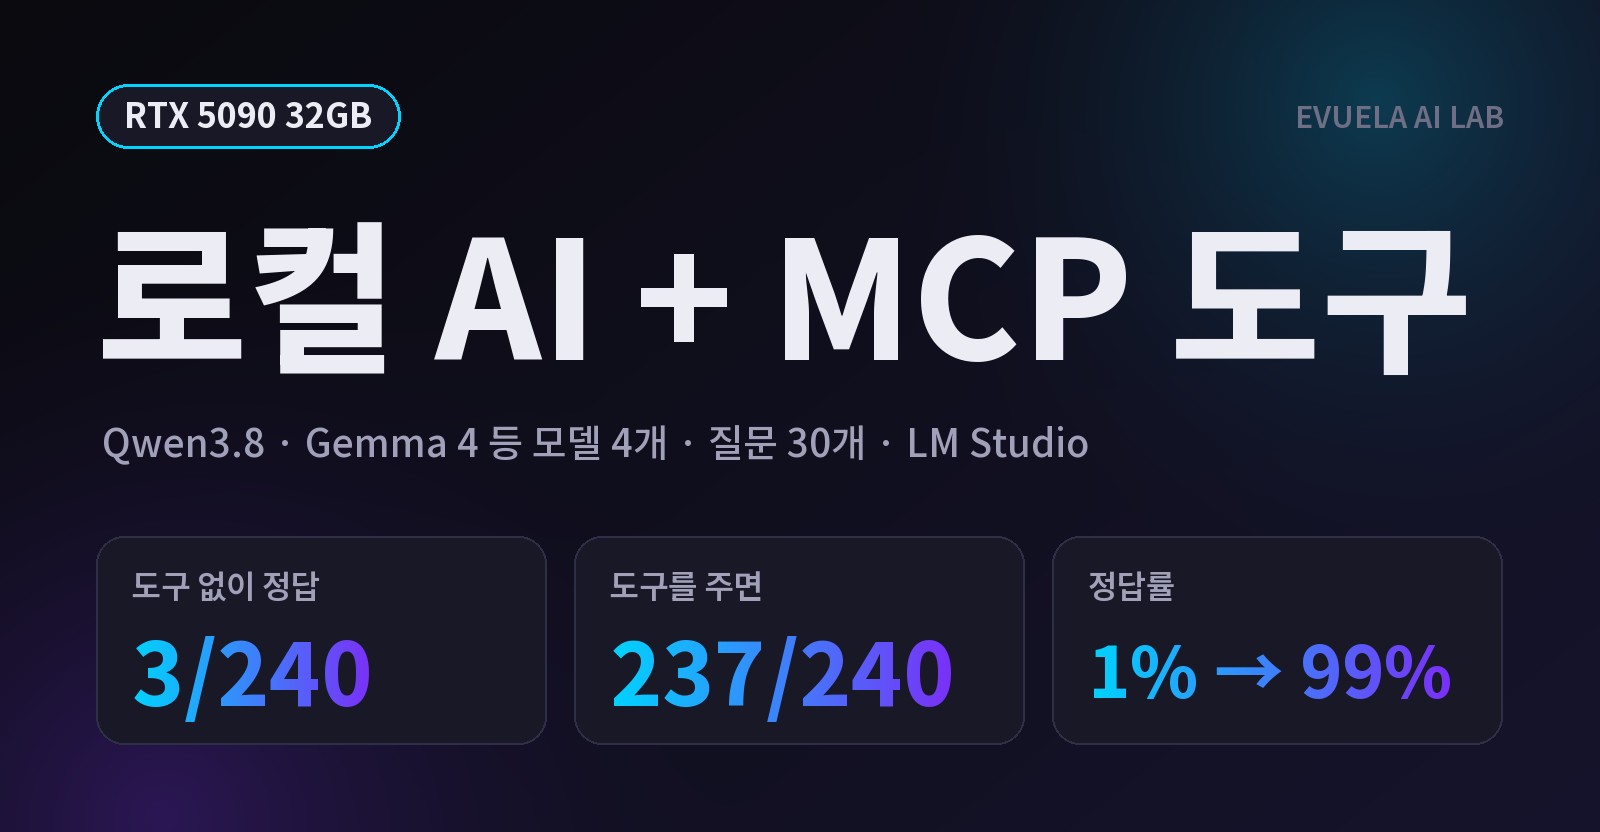
로컬 AI 모델 4개(Qwen3.8 27B, Gemma 4 26B A4B, Gemma 4 31B, Muse Glimmer)에 MCP 도구 3개(웹 페이지 읽기, 현재 시간, 파일 읽기)를 붙이고 같은 질문 30개를 물었습니다. 최신 정보와 파일 질문에서 240번 중 3번이던 정답이 237번이 됐고, 도구가 없을 때는 문서를 읽은 척 틀린 답을 하기도 했습니다. LM Studio 설정 방법과 캡처, 모델별 결과를 정리했습니다.
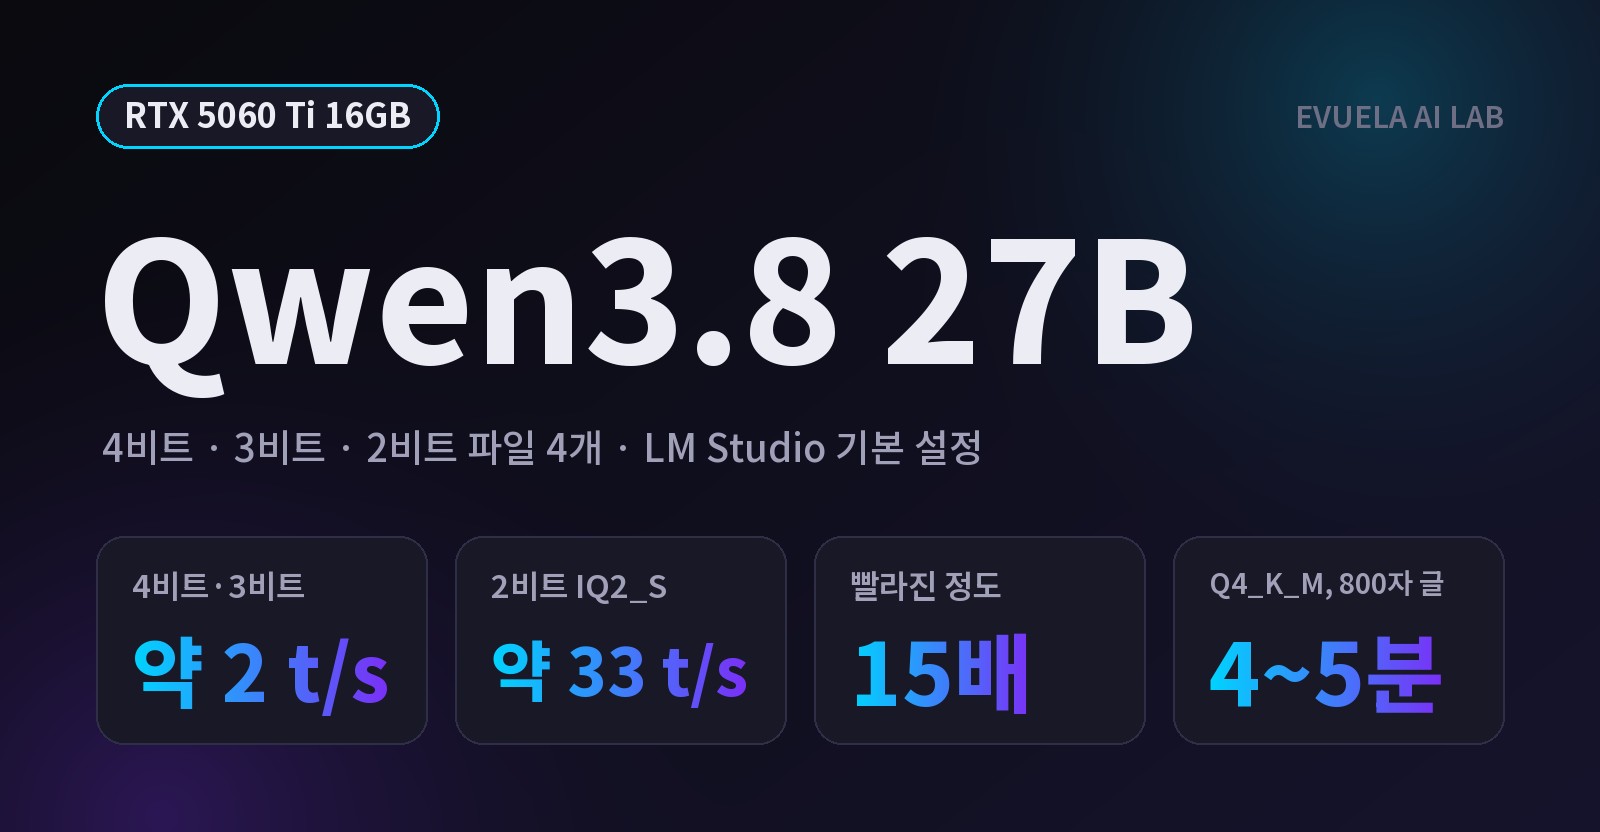
RTX 5060 Ti 16GB PC의 LM Studio에서 Qwen3.8 27B를 양자화 4종(Q4_K_M, Q3_K_XL, IQ3_S, IQ2_S)으로 돌려 봤습니다. 4비트와 3비트는 약 2t/s였고, 2비트 IQ2_S만 약 33t/s로 15배 빨랐습니다. 2비트는 생각을 켜야 정확했고, 컨텍스트는 32K가 알맞았습니다.
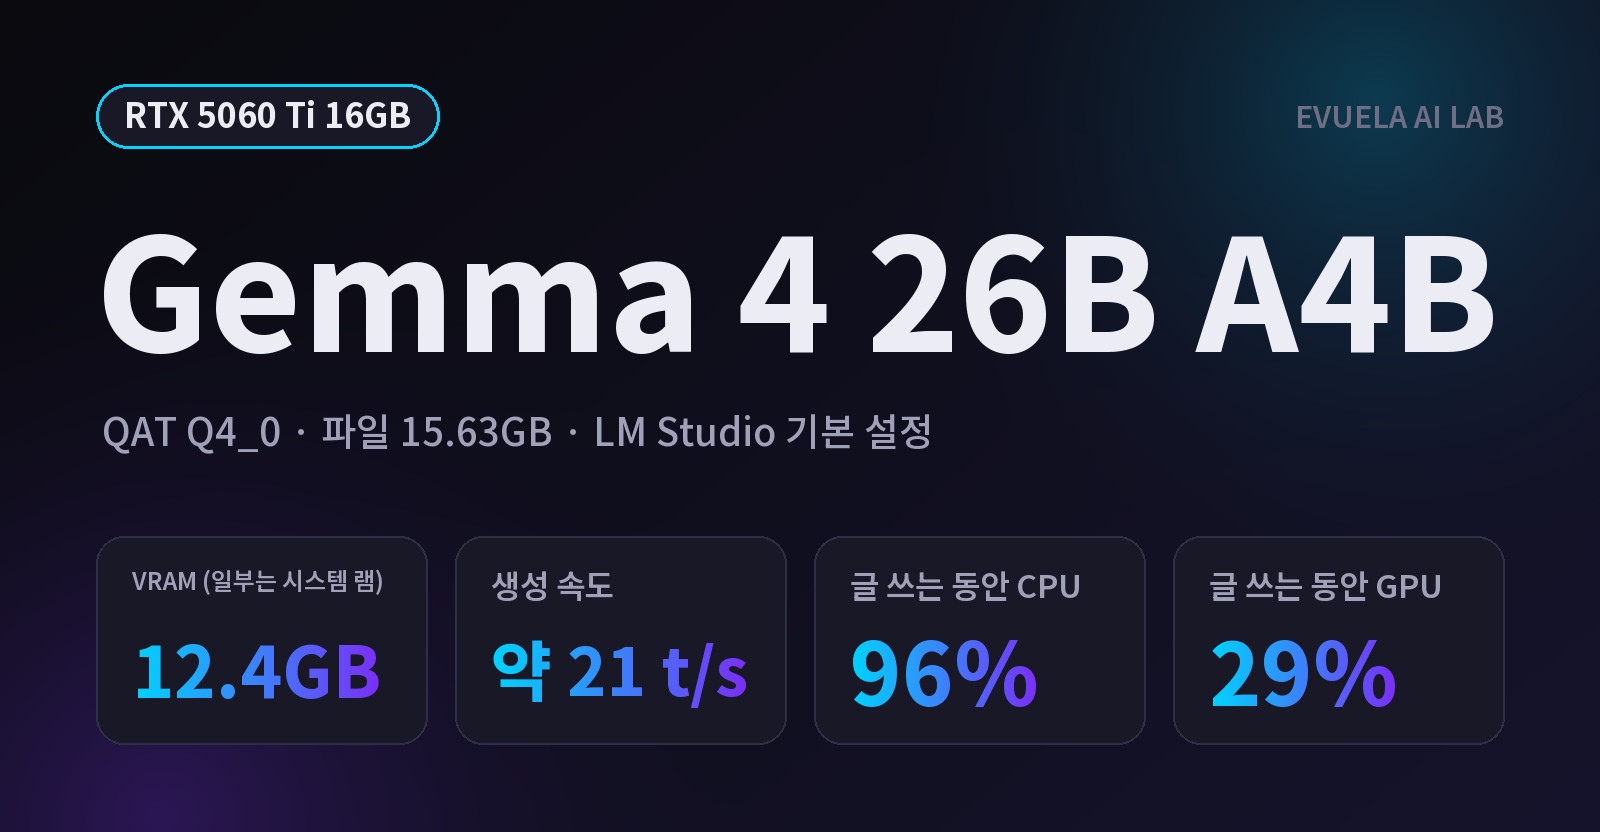
RTX 5060 Ti 16GB PC의 LM Studio에서 Gemma 4 26B A4B QAT(15.63GB)를 기본 설정 그대로 돌려 봤습니다. 모델은 로드됐지만 일부가 시스템 램에 남아, 답을 만드는 동안 CPU는 96%, GPU는 29%였습니다. 생성 속도는 약 21t/s로 같은 PC의 Gemma 4 12B의 절반이었습니다.