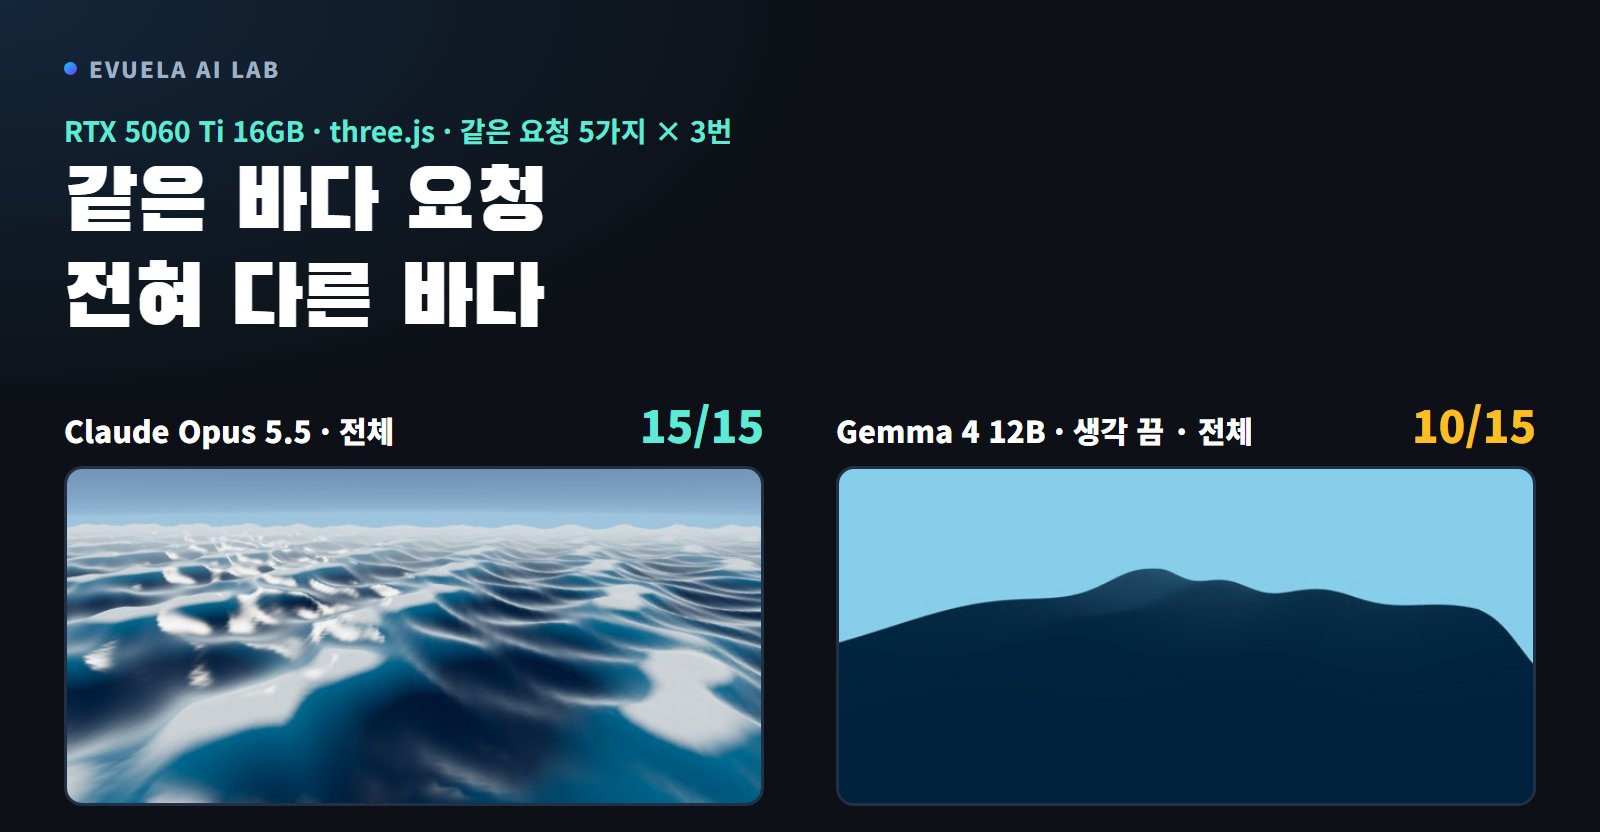
[RTX 5060 Ti 16GB] AI에게 three.js 3D 애니메이션을 시키면 될까? Claude는 15번 모두, 로컬 Gemma 4 12B는 10번 됐다
three.js로 3D 장면을 만드는 요청 5가지를 Claude Opus 5.5와 RTX 5060 Ti 16GB의 Gemma 4 12B QAT에 3번씩 똑같이 시켰습니다. Claude는 15번 모두, Gemma는 10번 요청대로 동작했고, 실패한 코드는 원인까지 찾았습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"Unsloth Studio API" 검색 결과 9건
three.js로 3D 장면을 만드는 요청 5가지를 Claude Opus 5.5와 RTX 5060 Ti 16GB의 Gemma 4 12B QAT에 3번씩 똑같이 시켰습니다. Claude는 15번 모두, Gemma는 10번 요청대로 동작했고, 실패한 코드는 원인까지 찾았습니다.
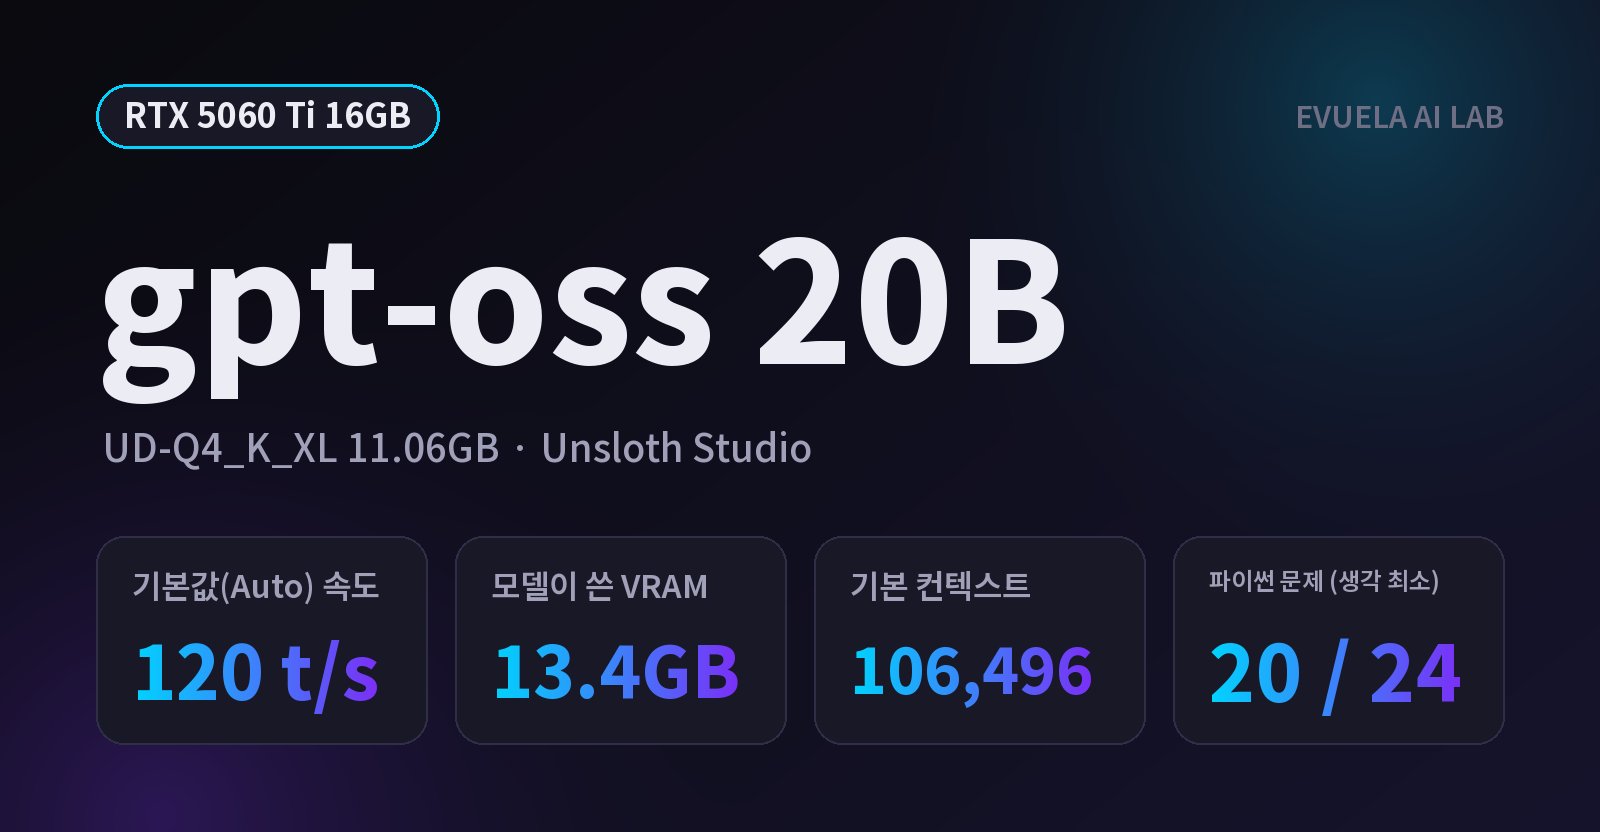
RTX 5060 Ti 16GB의 Unsloth Studio에서 OpenAI의 gpt-oss 20B(UD-Q4_K_XL 11.06GB)를 기본값으로 돌렸습니다. 초당 약 120토큰, 컨텍스트 65,536까지 같은 속도였고, 생각 단계에 따라 시간과 코딩 결과가 크게 달랐습니다.
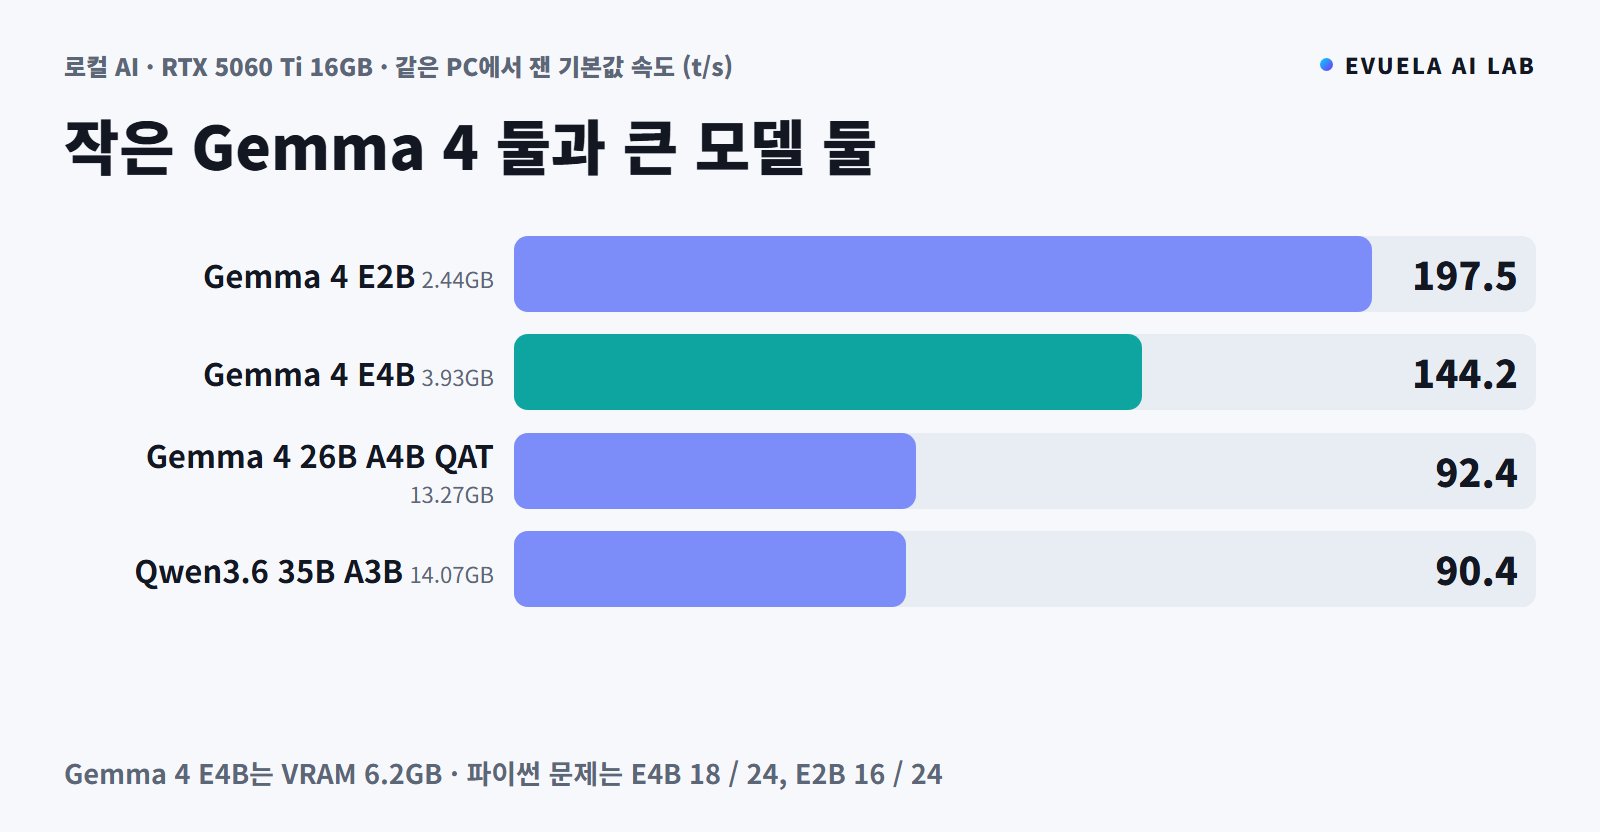
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 E4B(QAT UD-Q4_K_XL 3.93GB)를 기본값으로 돌렸습니다. VRAM 6.2GB에 초당 약 144토큰이었고, 같은 PC에서 잰 E2B와 속도·산수·코딩·사진 결과를 나란히 비교했습니다.
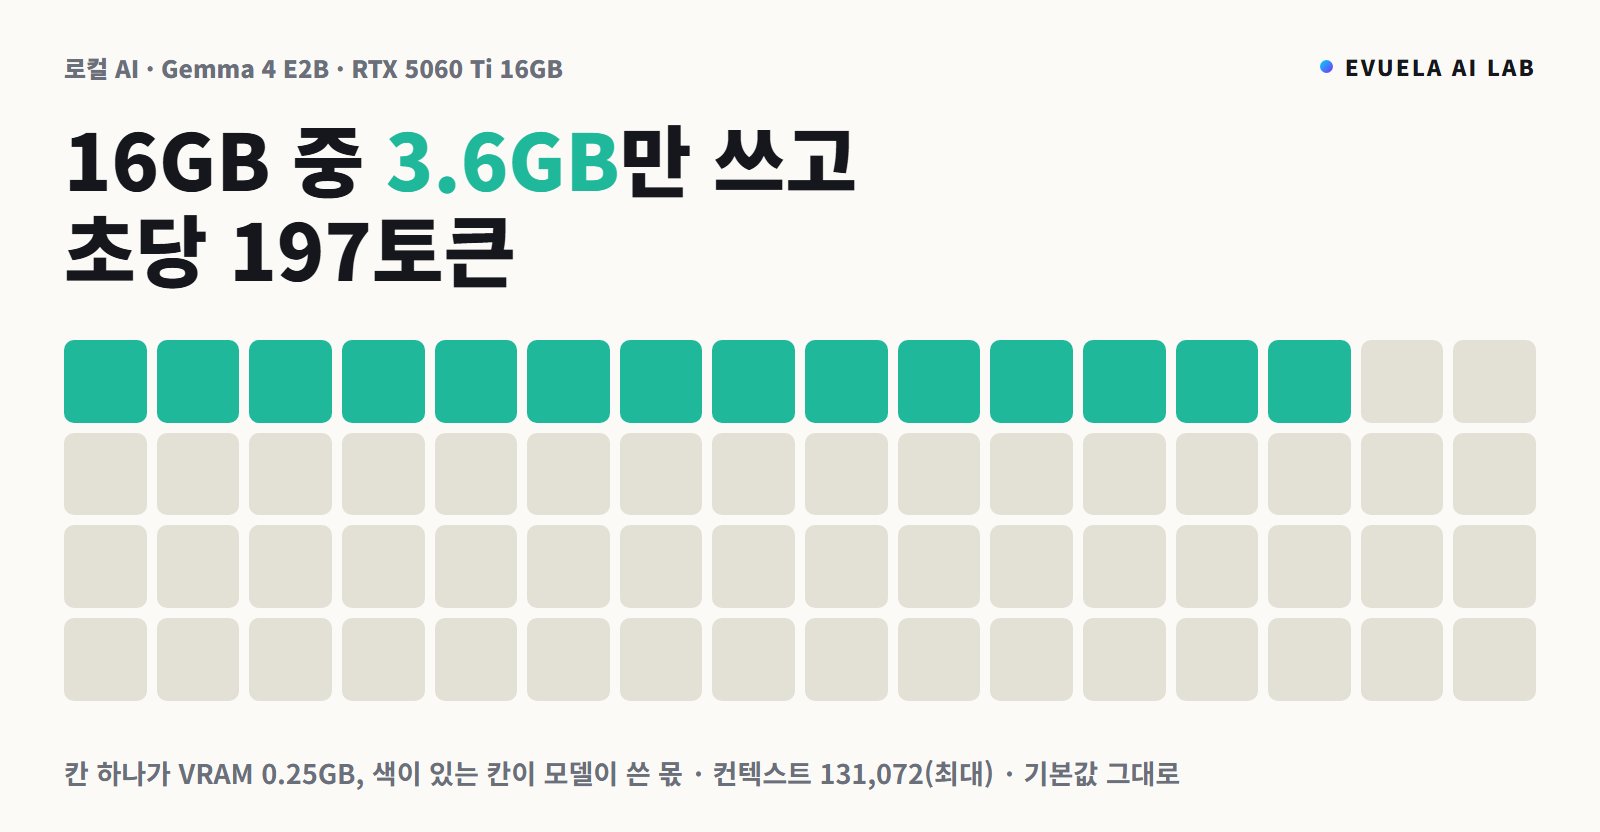
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 E2B(QAT UD-Q4_K_XL 2.44GB)를 기본값으로 돌렸습니다. VRAM 3.6GB에 초당 약 197토큰, 최대 컨텍스트 131,072에서도 같은 속도였습니다. 산수·코딩·사진 결과를 담았습니다.
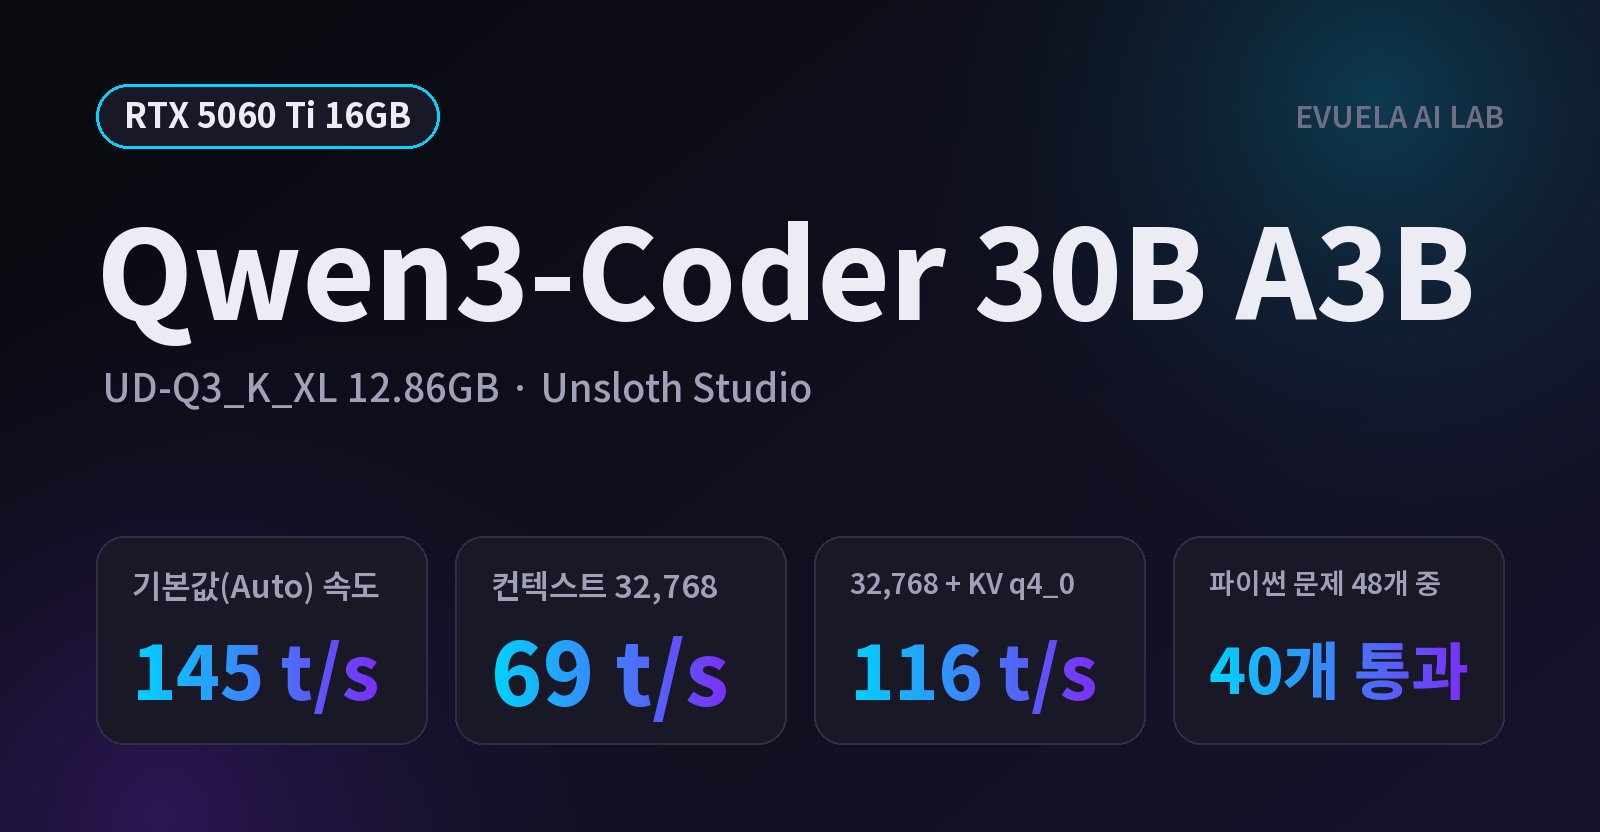
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3-Coder 30B A3B(UD-Q3_K_XL)를 돌렸습니다. 기본값은 초당 약 145토큰, 컨텍스트 32,768에서는 약 69토큰이었고 KV 캐시를 줄이면 116토큰이 됩니다. 파이썬 문제 결과도 담았습니다.
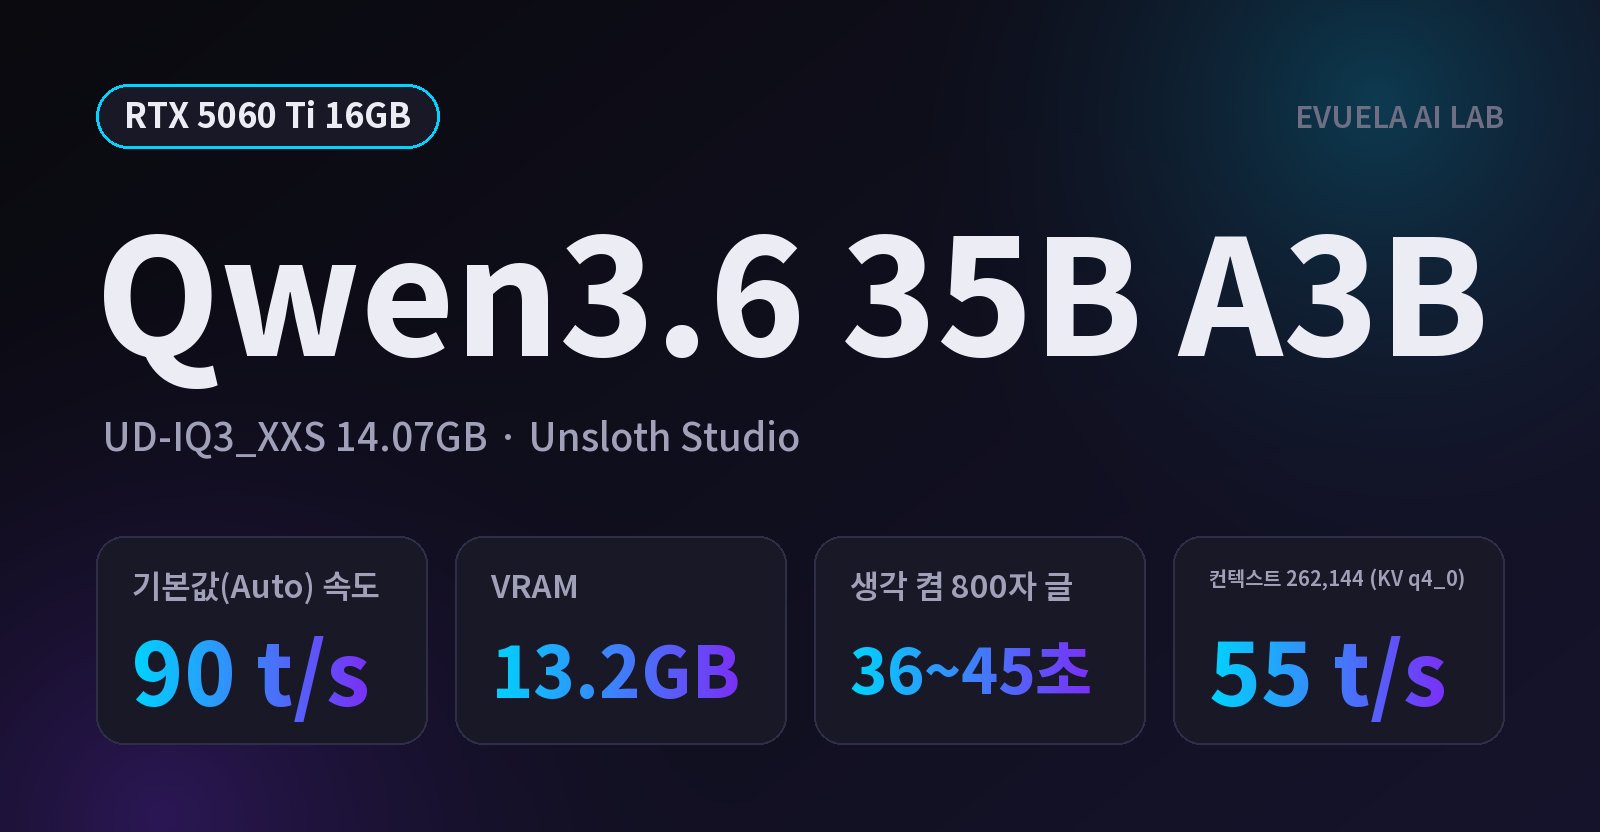
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3.6 35B A3B(UD-IQ3_XXS)를 기본값으로 돌렸습니다. VRAM 13.2GB에 다 들어갔고 초당 약 90토큰이었습니다. 컨텍스트별 속도, 설정 비교, Gemma 4 26B와의 비교를 담았습니다.
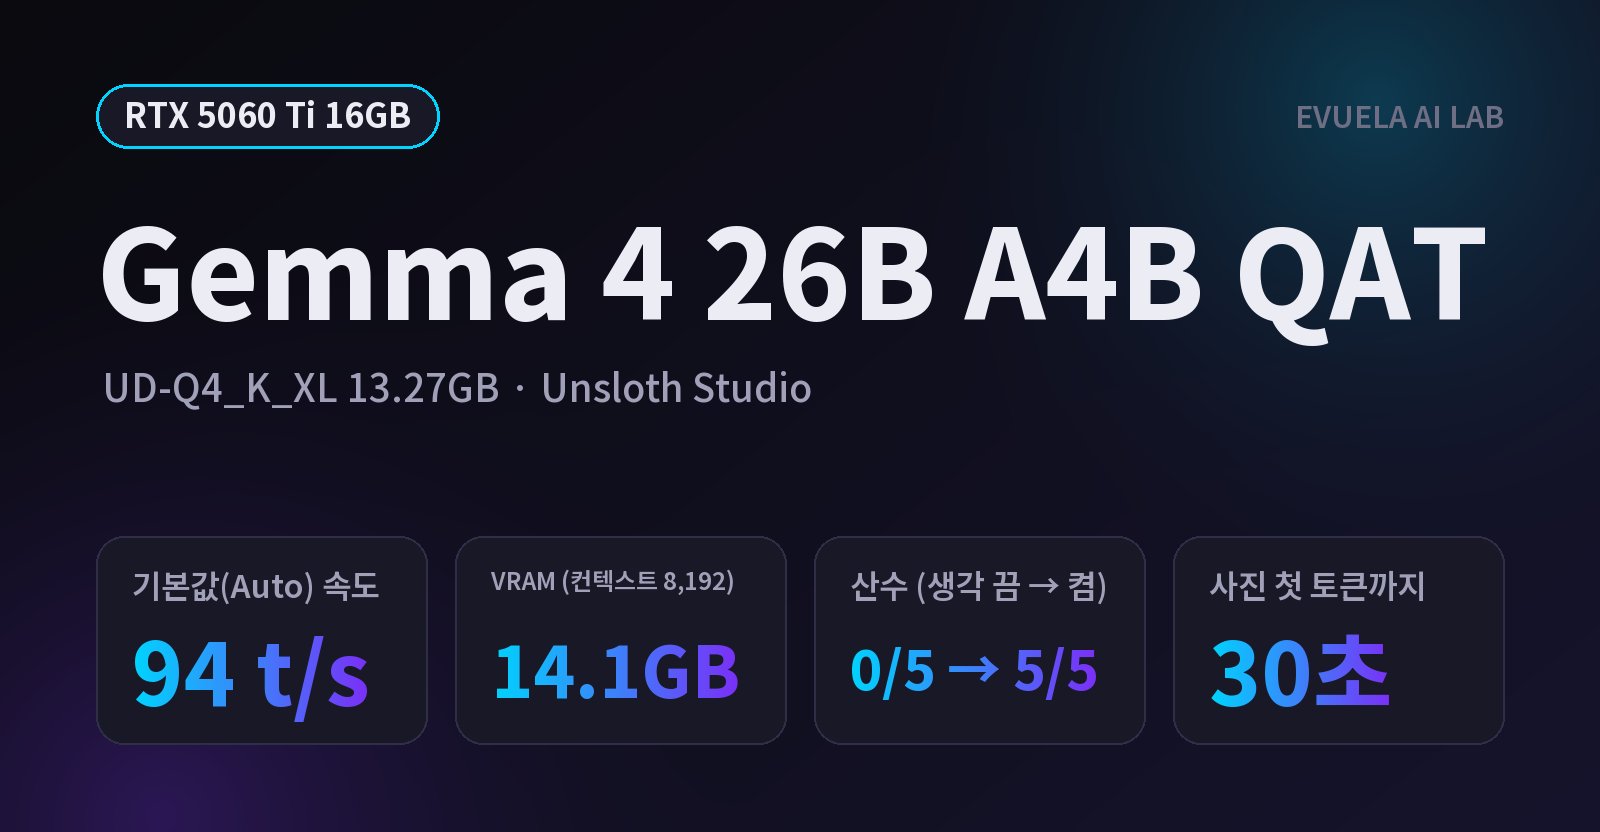
RTX 5060 Ti 16GB의 Unsloth Studio에서 Gemma 4 26B A4B QAT를 기본값으로 돌렸습니다. 초당 약 94토큰, VRAM 14.1GB였습니다. 컨텍스트별 속도, 산수·코딩 결과, Gemma 4 12B와의 비교를 담았습니다.
같은 Qwen3.8 27B 파일로 LM Studio와 Unsloth Studio를 비교했습니다. 기본값 속도는 65.4 대 65.6 t/s로 같았고, MTP를 켜면 35~44% 빨랐습니다. 생각 한도, 컨텍스트, 조심할 점과 앞으로의 측정 방법을 정리했습니다.
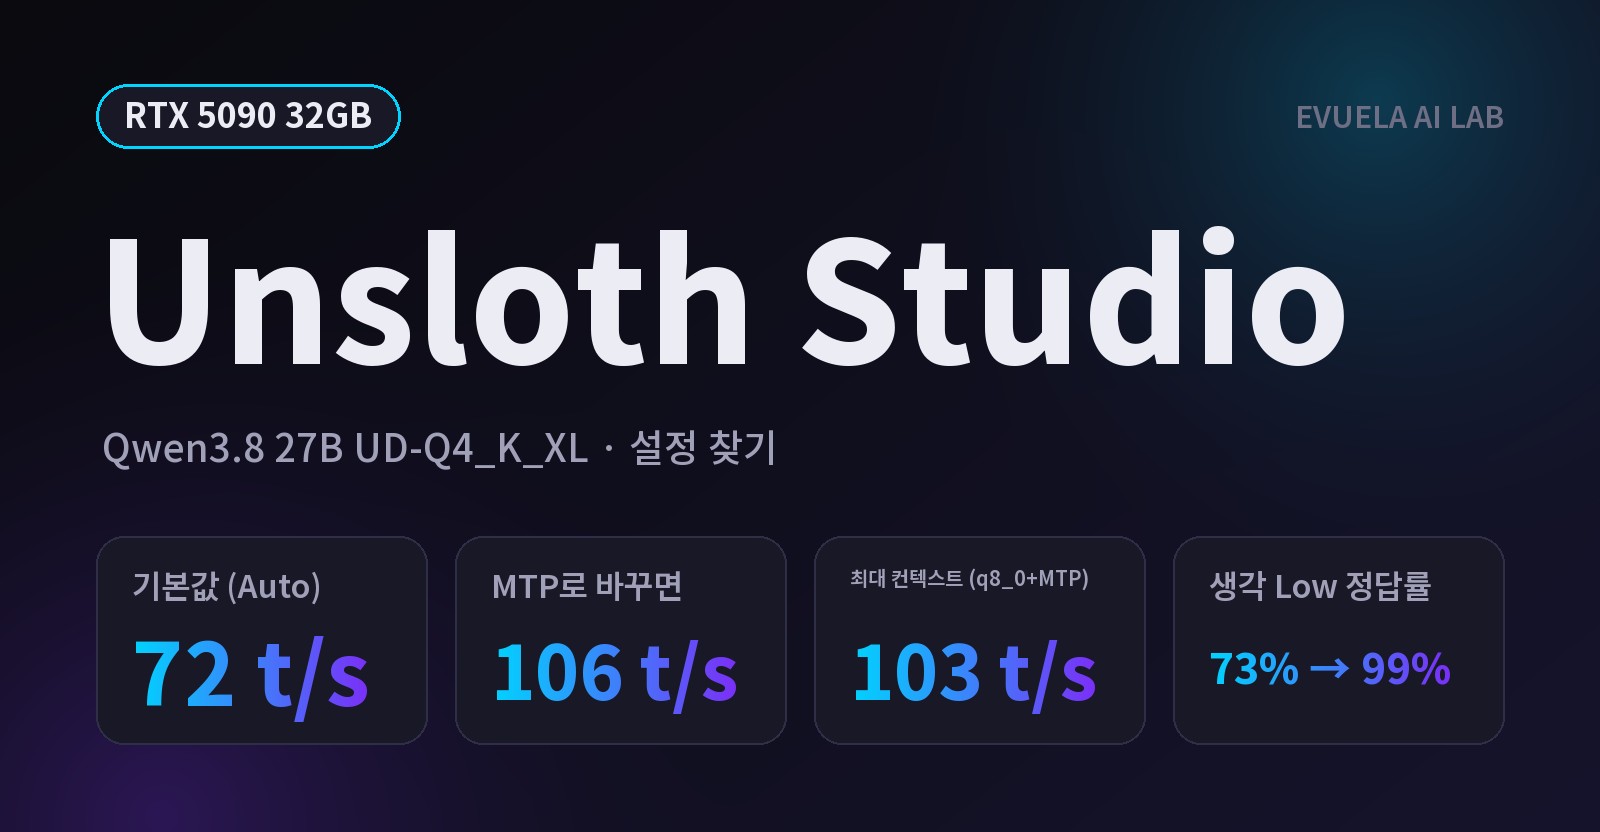
Unsloth Studio를 RTX 5090에 설치하고 Qwen3.8 27B(UD-Q4_K_XL)로 설정을 하나씩 바꿔 가며 쟀습니다. 기본값은 컨텍스트를 16만 8천 토큰으로 알아서 잡았고 초당 72토큰이었습니다. 속도 기능을 MTP로 바꾸면 48% 빨라졌고, KV 캐시를 q8_0으로 줄이면 최대 컨텍스트 262,144에서도 초당 103토큰이 나왔습니다. 생각 단계별 정답률, 화면 캡처, 쓰임새별 추천 설정을 정리했습니다.