[RTX 5090 32GB] Qwen3.8 27B는 왜 답을 안 할까, 생각 단계 하나 낮추자 12초 만에 나왔다
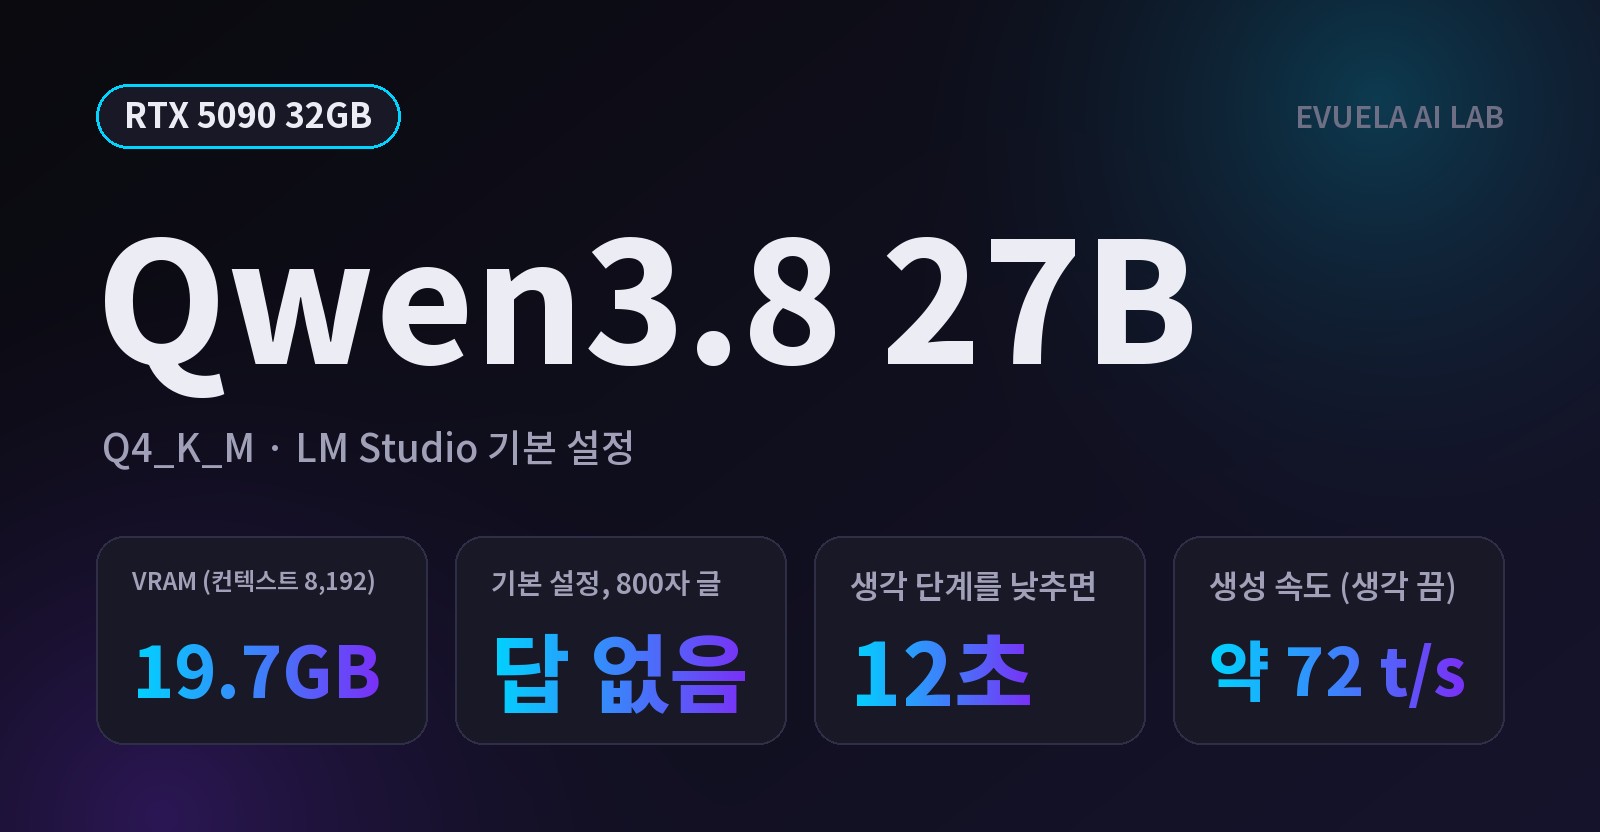
LM Studio 기본 설정으로 Qwen3.8 27B에 800자 글을 부탁하자 1분 넘게 생각만 하다 답 없이 멈췄습니다. 생각 단계를 낮추자 12초 만에 답이 나왔습니다. VRAM 19.7GB, 산수, 없는 소설, 이미지 입력, MTP 속도까지 RTX 5090에서 잰 결과입니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"VRAM" 검색 결과 57건
LM Studio 기본 설정으로 Qwen3.8 27B에 800자 글을 부탁하자 1분 넘게 생각만 하다 답 없이 멈췄습니다. 생각 단계를 낮추자 12초 만에 답이 나왔습니다. VRAM 19.7GB, 산수, 없는 소설, 이미지 입력, MTP 속도까지 RTX 5090에서 잰 결과입니다.
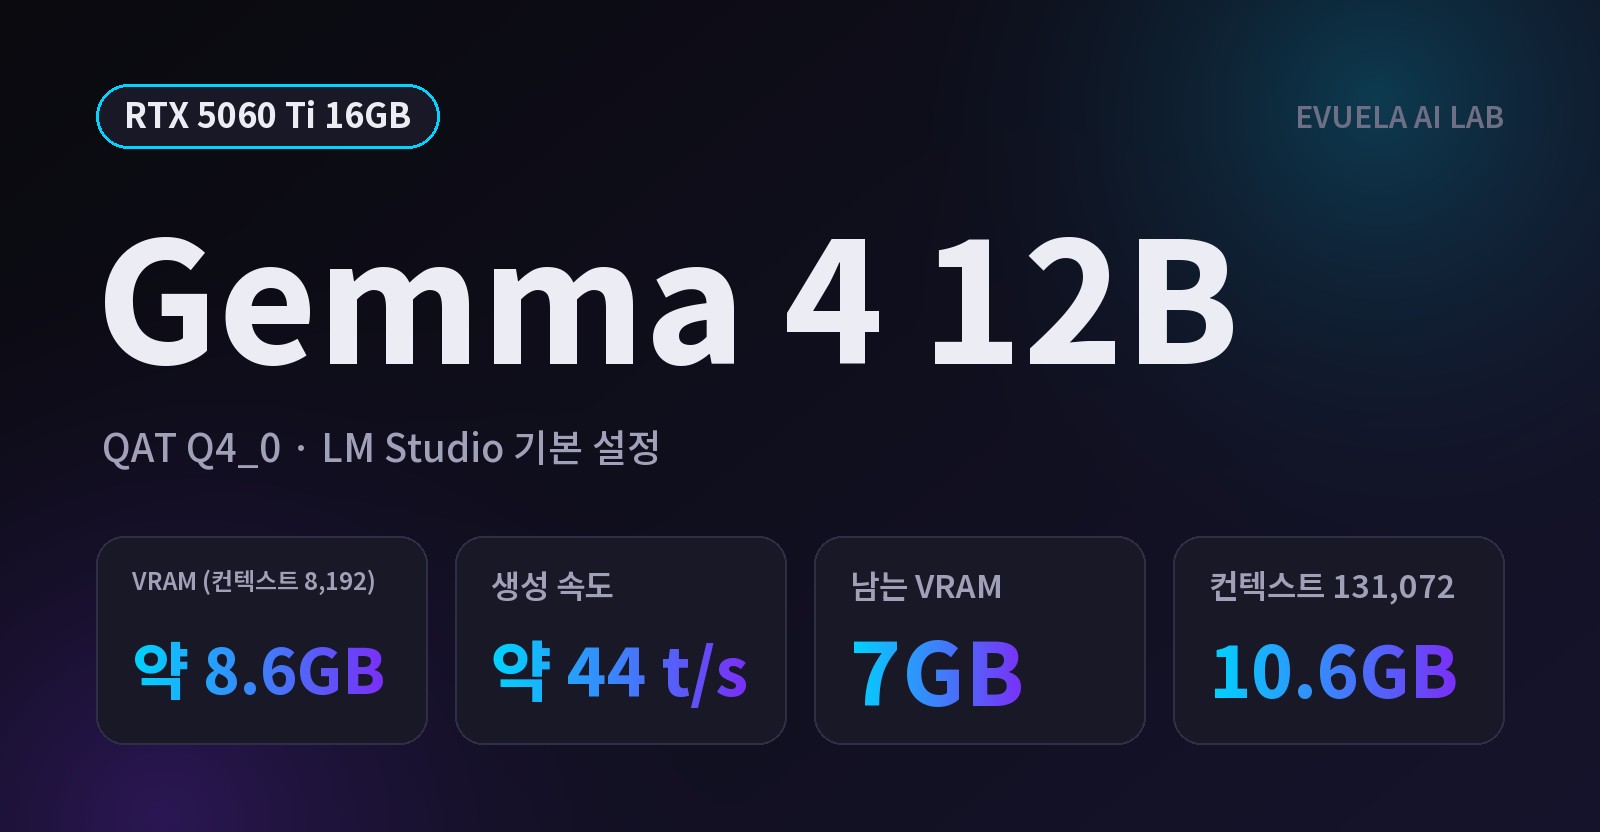
RTX 5060 Ti 16GB PC의 LM Studio에서 Gemma 4 12B QAT를 기본 설정 그대로 돌려 본 실측 기록입니다. 초당 약 44토큰, VRAM 약 8.6GB였고, 생각 기능을 끄면 산수를 5번 모두 틀렸습니다. 같은 방법으로 잰 RTX 5090 결과와 함께 비교합니다.
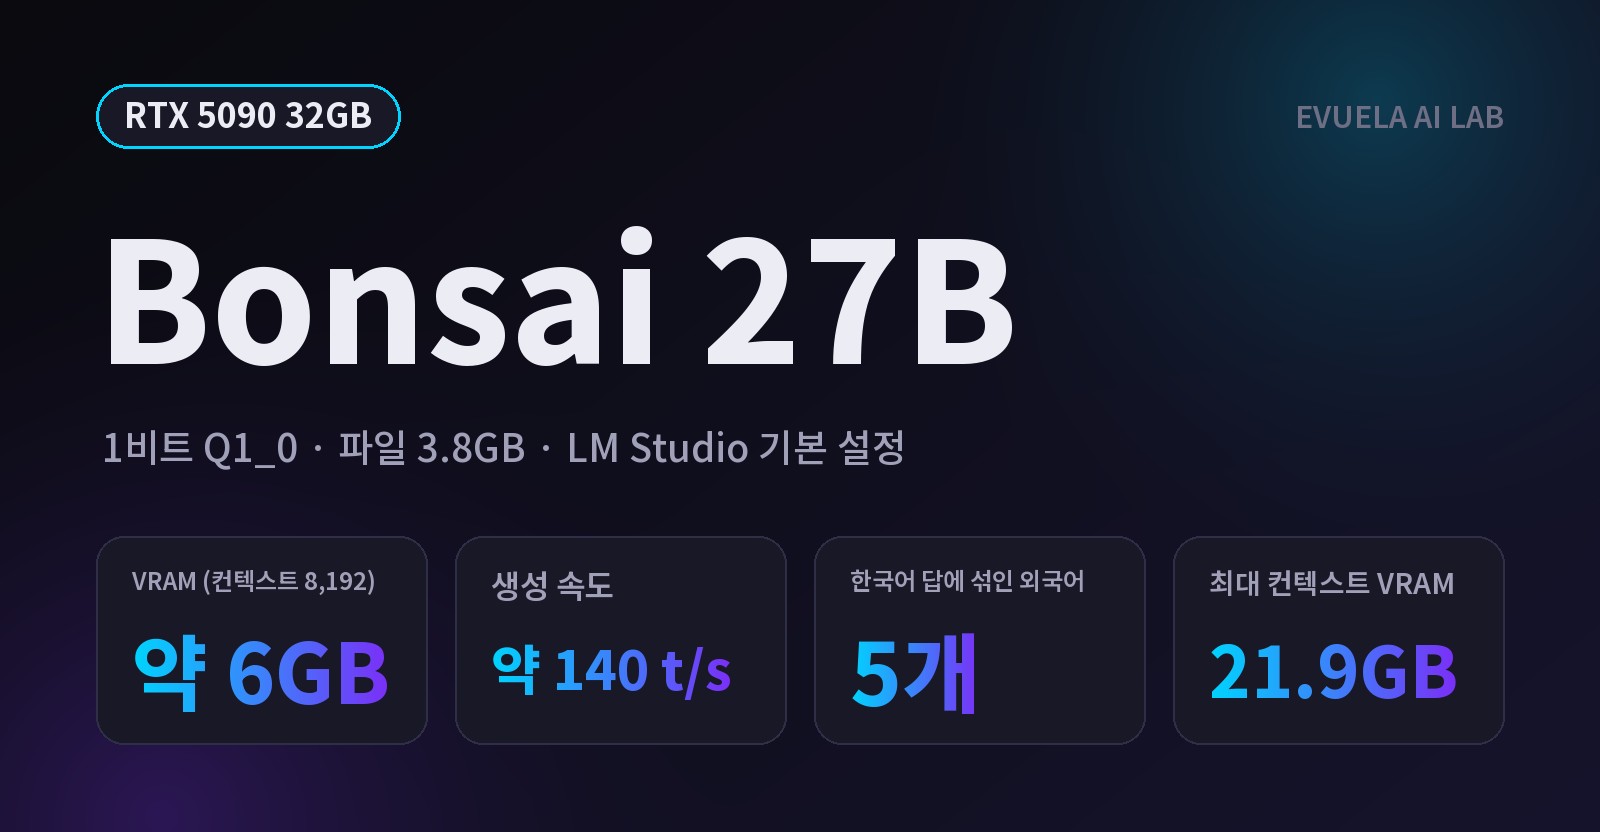
Qwen3.6-27B를 1비트로 줄인 Bonsai 27B를 RTX 5090 PC의 LM Studio에서 기본 설정으로 돌렸습니다. 초당 약 140토큰, 기본 VRAM 약 6GB로 빠르고 가벼웠지만, 한국어 답변에 외국어가 섞이고 산수는 5번 중 2번만 맞혔습니다. 캡처와 실측값으로 정리했습니다.
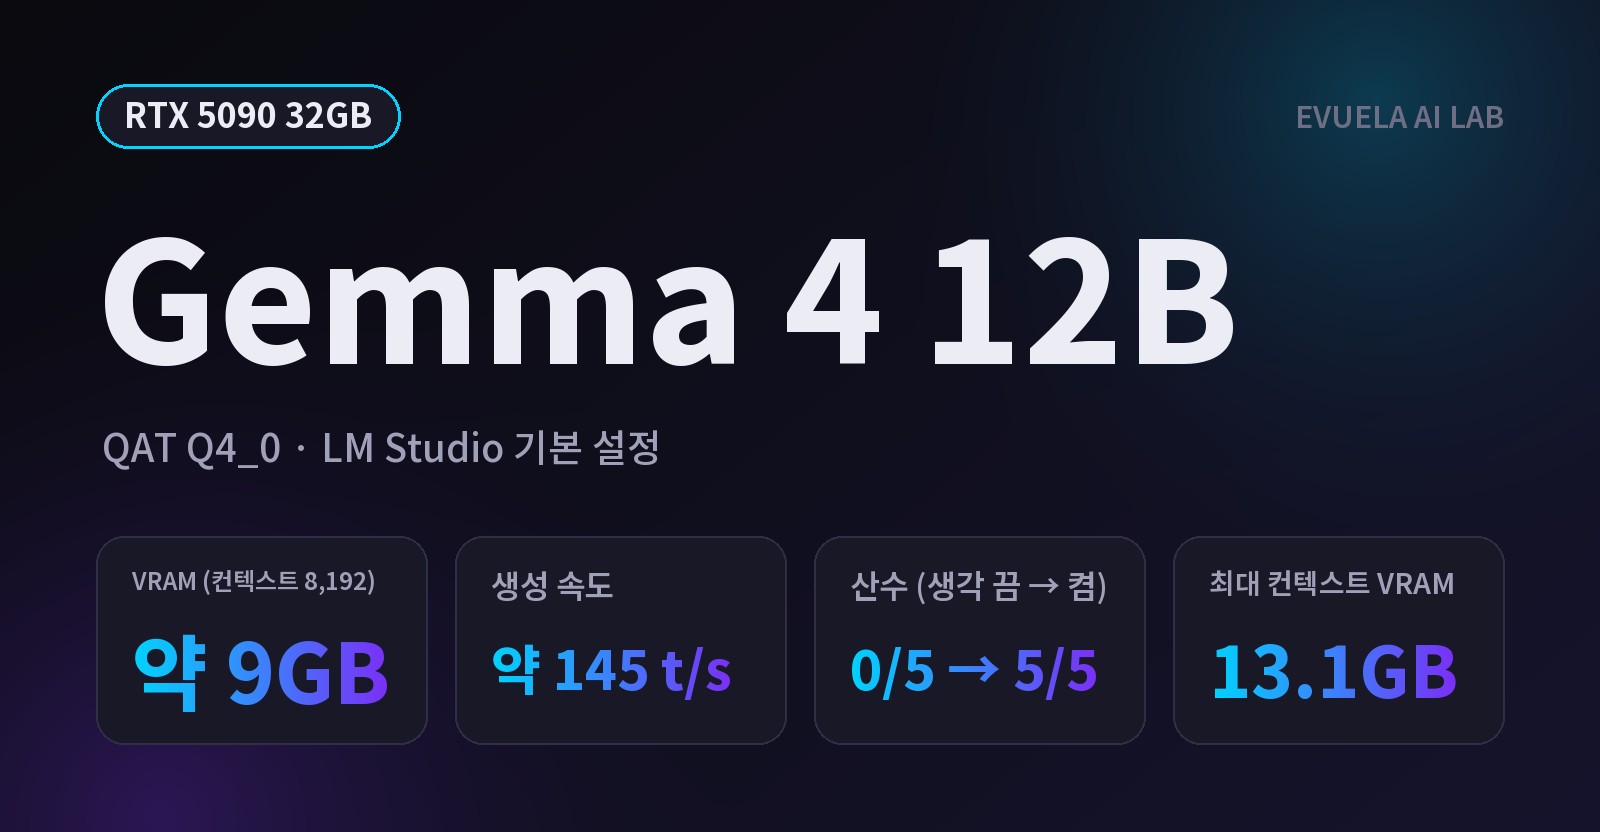
RTX 5090 PC의 LM Studio에서 Gemma 4 12B QAT(Q4_0)를 기본 설정으로 직접 돌린 기록입니다. PC 사양, LM Studio 기본 설정값, 생성 속도, 컨텍스트별 VRAM, 긴 글 요약, 생각 기능 켬·끔 비교, 이미지 입력까지 캡처와 실측값으로 정리했습니다.
2026년 8월 출시된 Qwen3.8-27B는 270억 파라미터의 개방형 멀티모달 모델로, Apache 2.0 라이선스 기반의 강력한 에이전트 코딩 및 실무 작업 성능을 제공한다. 로컬 LLM 환경에서의 VRAM 요구사항과 실무 적용 가능성을 깊이 있게 분석한다.
Dense 모델과 Mixture of Experts (MoE) 모델의 차이점을 파악하고, LLM 아키텍처가 실무에 미치는 영향을 기술적 관점에서 분석합니다. 로컬 AI, SI 환경에서의 활용 전략을 다룹니다.
AI 도구
제미나이(Gemini), 클로드(Claude) 같은 클라우드 AI의 구독료나 사내 코드 유출이 걱정되셨나요? 완전 무료 에디터인 VS Code에 'Continue' 확장 프로그램과 LM Studio를 결합하여 100% 무료, 100% 오프라인으로 동작하는 완벽한 로컬 AI 코딩 환경 구축법을 공유합니다.
AI 도구
내 PC 속 AI를 전문가로 만드는 비결! 프롬프트 엔지니어링 3대 기술과 AI의 성격을 결정하는 시스템 프롬프트 및 파라미터(온도 등) 설정법을 정리했습니다. 8GB VRAM 환경에서도 고성능 모델 못지않은 답변을 이끌어내는 실전 가이드를 기록합니다.
AI 도구
로컬 AI의 기억력과 답변 속도를 결정하는 핵심 요소, 토큰(Token)과 컨텍스트 길이(Context Length)에 대해 알아봅니다. 대중적인 8GB VRAM(RTX 4060 등) 환경에서 AI가 왜 말을 멈추는지, 어떻게 하면 더 긴 대화 맥락을 유지할 수 있는지 LM Studio 0.4.6 버전의 실제 설정 화면을 통해 최적의 세팅 가이드를 기록했습니다.