로컬 AI 시작하기 3편, Gemma 4 12B·Qwen3.8 27B 모델 이름은 어떻게 읽을까, Q4_K_M과 IQ2_S는 파일이 8GB 차이였다
모델 이름의 12B, A3B, QAT, GGUF, Q4_K_M이 무슨 뜻인지 조각별로 풀었습니다. 같은 Qwen3.8 27B도 4비트 파일은 17.74GB, 2비트 파일은 9.30GB였고, 같은 Q4_K_M도 올린 곳에 따라 16.46GB에서 18.97GB까지 달랐습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"Qwen3-Coder 30B" 검색 결과 12건
모델 이름의 12B, A3B, QAT, GGUF, Q4_K_M이 무슨 뜻인지 조각별로 풀었습니다. 같은 Qwen3.8 27B도 4비트 파일은 17.74GB, 2비트 파일은 9.30GB였고, 같은 Q4_K_M도 올린 곳에 따라 16.46GB에서 18.97GB까지 달랐습니다.
로컬 AI는 모델을 내 PC의 그래픽카드에서 돌리는 것입니다. 필요한 것 세 가지와 VRAM 확인하는 법을 정리하고, RTX 5060 Ti 16GB와 RTX 5090 32GB에서 직접 잰 속도와 VRAM을 한 표로 모았습니다. 가이드 일곱 편의 첫 편입니다.
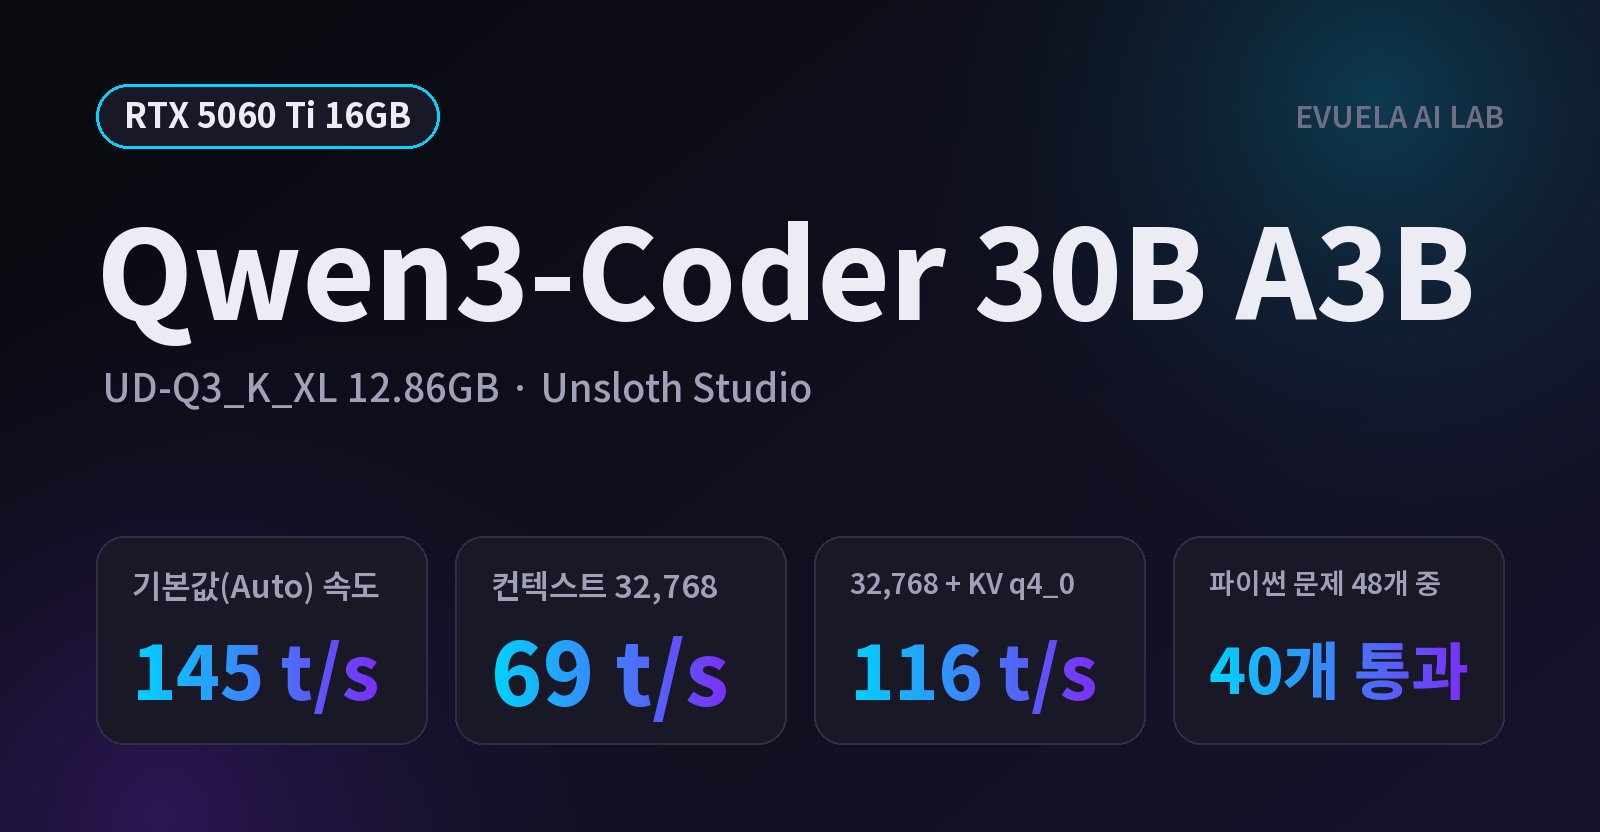
RTX 5060 Ti 16GB의 Unsloth Studio에서 Qwen3-Coder 30B A3B(UD-Q3_K_XL)를 돌렸습니다. 기본값은 초당 약 145토큰, 컨텍스트 32,768에서는 약 69토큰이었고 KV 캐시를 줄이면 116토큰이 됩니다. 파이썬 문제 결과도 담았습니다.