[RTX 5060 Ti 16GB] 16GB 그래픽카드로 Qwen3.8 27B 돌아갈까, 2비트로 줄이자 15배 빨라졌다
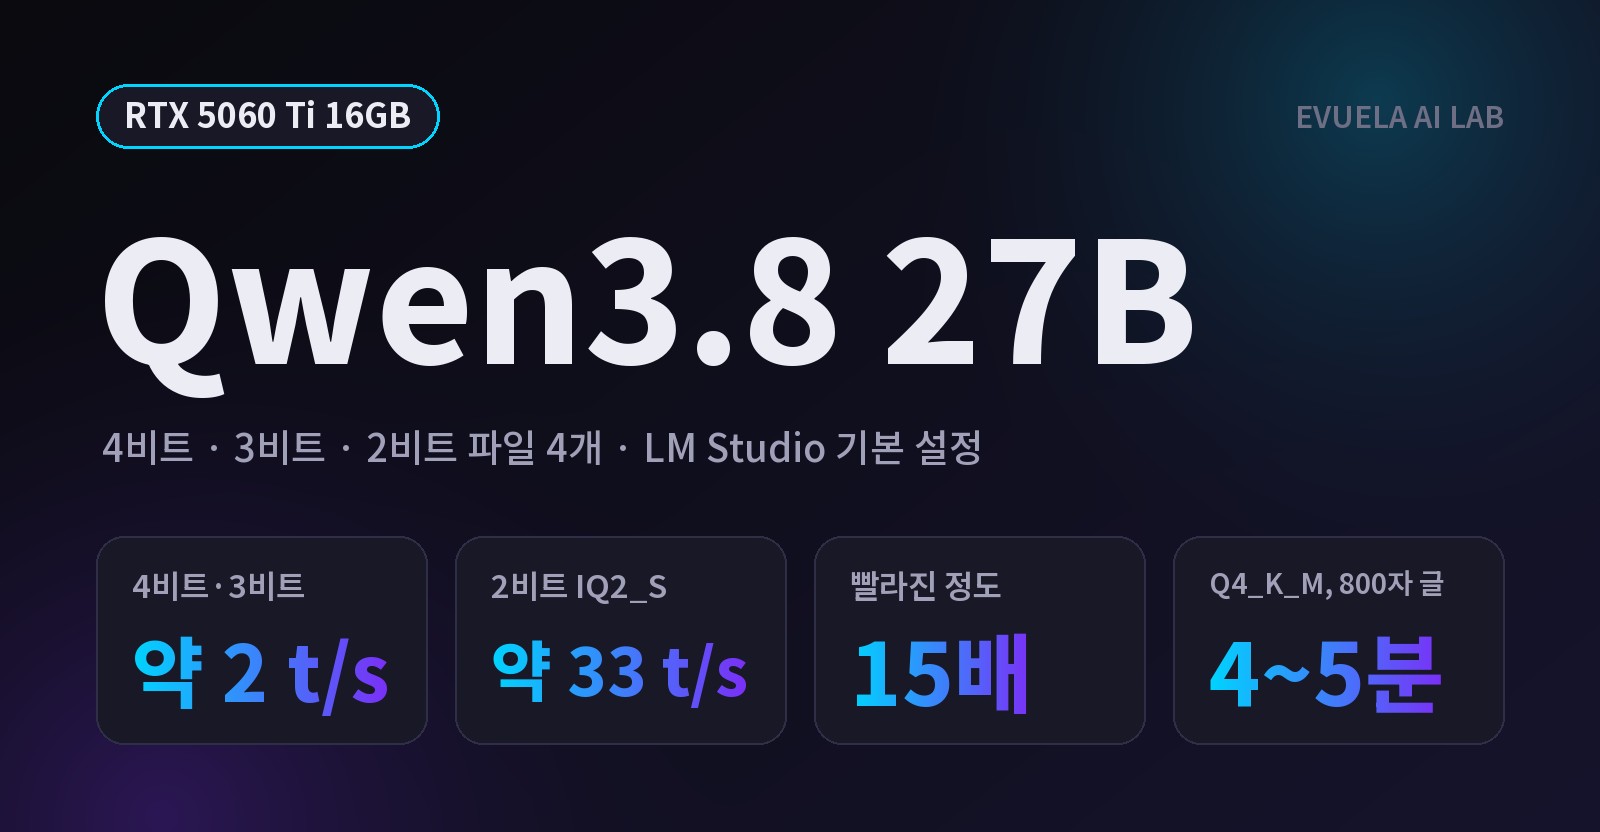
RTX 5060 Ti 16GB PC의 LM Studio에서 Qwen3.8 27B를 양자화 4종(Q4_K_M, Q3_K_XL, IQ3_S, IQ2_S)으로 돌려 봤습니다. 4비트와 3비트는 약 2t/s였고, 2비트 IQ2_S만 약 33t/s로 15배 빨랐습니다. 2비트는 생각을 켜야 정확했고, 컨텍스트는 32K가 알맞았습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"Gemma 4 12B" 검색 결과 17건
RTX 5060 Ti 16GB PC의 LM Studio에서 Qwen3.8 27B를 양자화 4종(Q4_K_M, Q3_K_XL, IQ3_S, IQ2_S)으로 돌려 봤습니다. 4비트와 3비트는 약 2t/s였고, 2비트 IQ2_S만 약 33t/s로 15배 빨랐습니다. 2비트는 생각을 켜야 정확했고, 컨텍스트는 32K가 알맞았습니다.
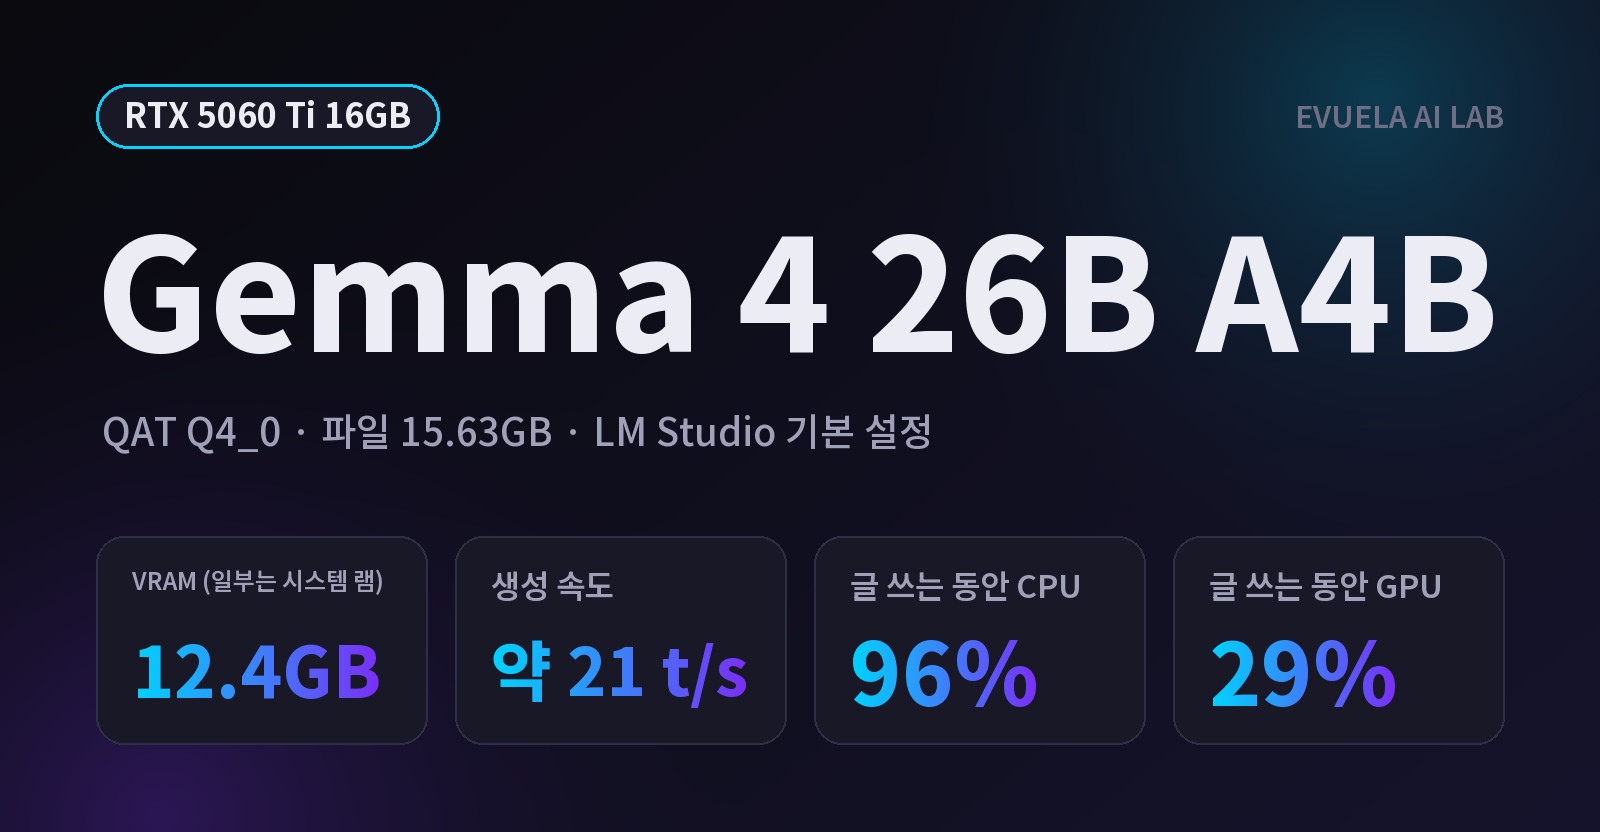
RTX 5060 Ti 16GB PC의 LM Studio에서 Gemma 4 26B A4B QAT(15.63GB)를 기본 설정 그대로 돌려 봤습니다. 모델은 로드됐지만 일부가 시스템 램에 남아, 답을 만드는 동안 CPU는 96%, GPU는 29%였습니다. 생성 속도는 약 21t/s로 같은 PC의 Gemma 4 12B의 절반이었습니다.
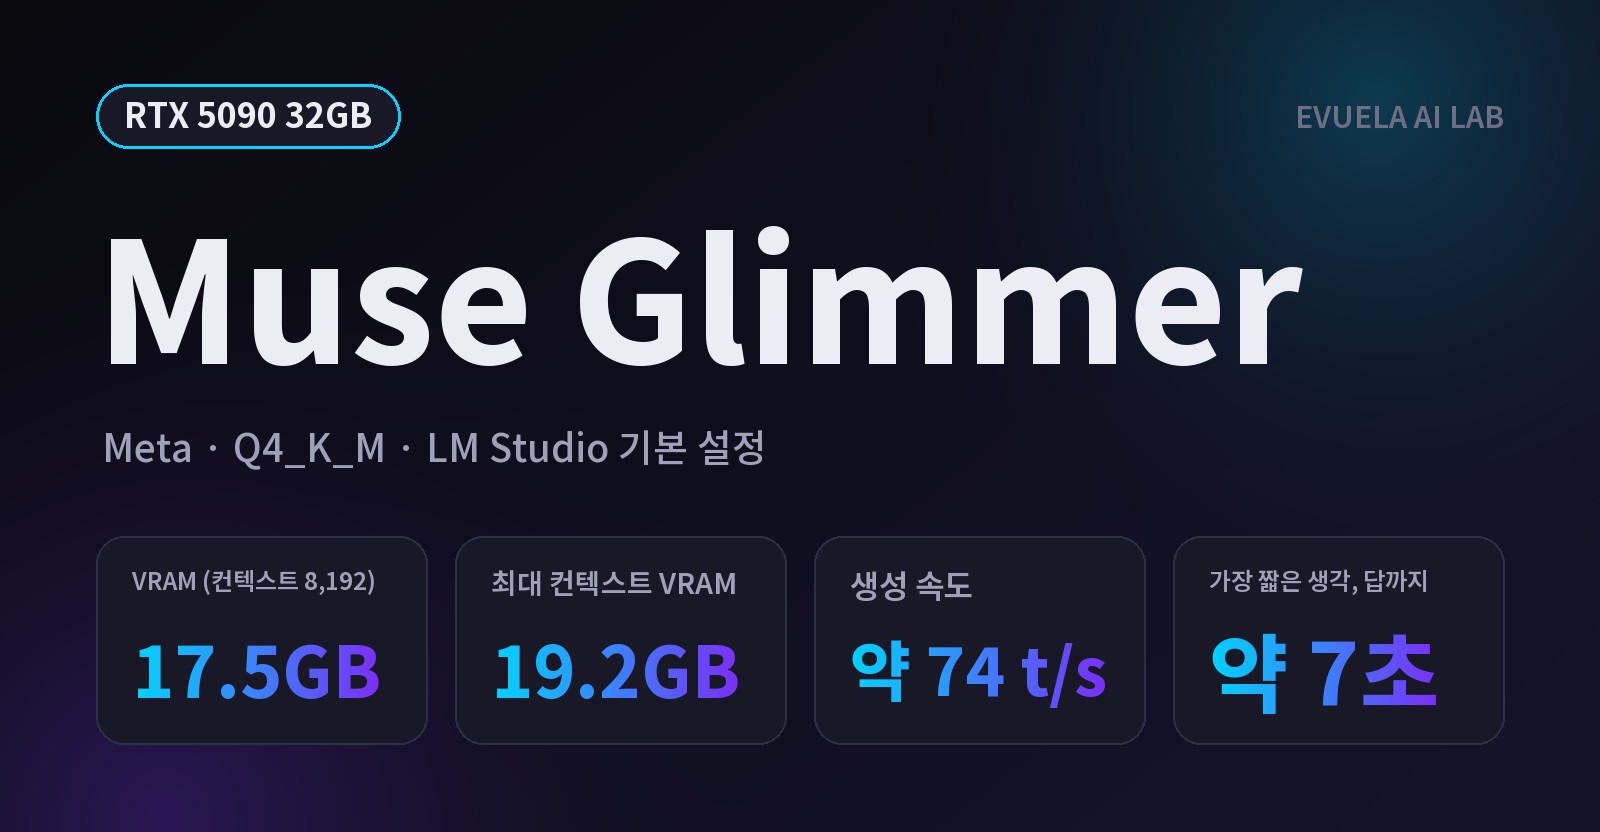
Meta가 공개한 약 300억 파라미터 모델 Muse Glimmer를 RTX 5090의 LM Studio 기본 설정으로 재 봤습니다. 컨텍스트를 16배 늘려도 VRAM은 17.5GB에서 19.2GB로 1.7GB만 늘었고, 기본 설정에서 27번 모두 답했습니다. 속도, 생각 단계, 한국어 품질, 이미지 입력까지 정리했습니다.
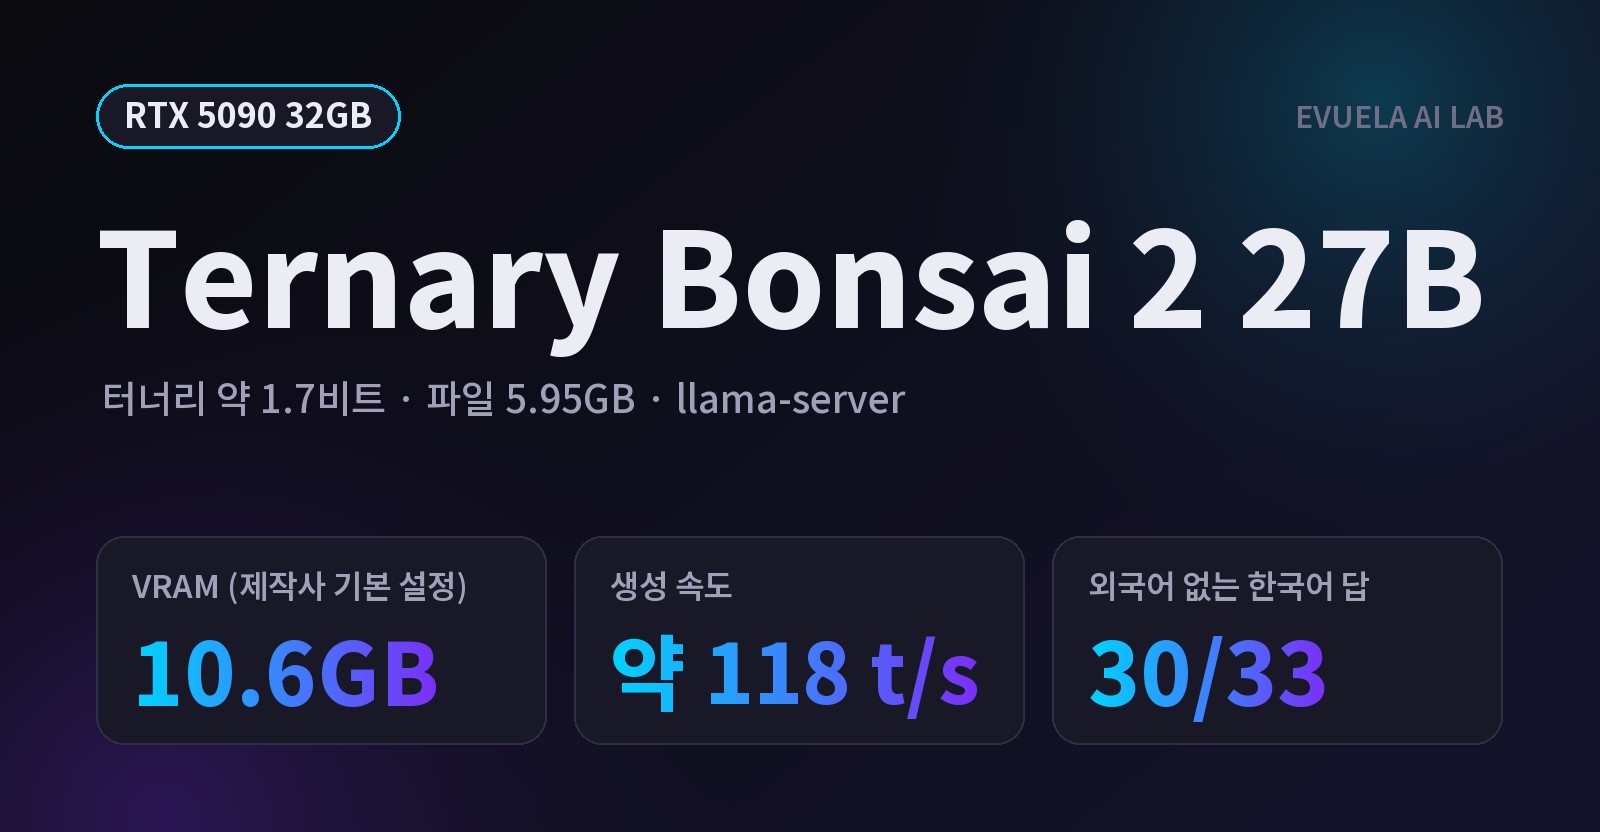
Qwen3.8 27B를 약 1.7비트로 줄인 PrismML Ternary Bonsai 2 27B(5.95GB)를 RTX 5090에서 재 봤습니다. LM Studio로는 아직 열리지 않아 제작사 llama.cpp로 돌렸고, 한국어 답 33개 중 30개에 외국어가 섞이지 않았습니다. VRAM 10.6GB, 약 118 t/s(초당 토큰 수), 생각 단계별 결과를 정리했습니다.
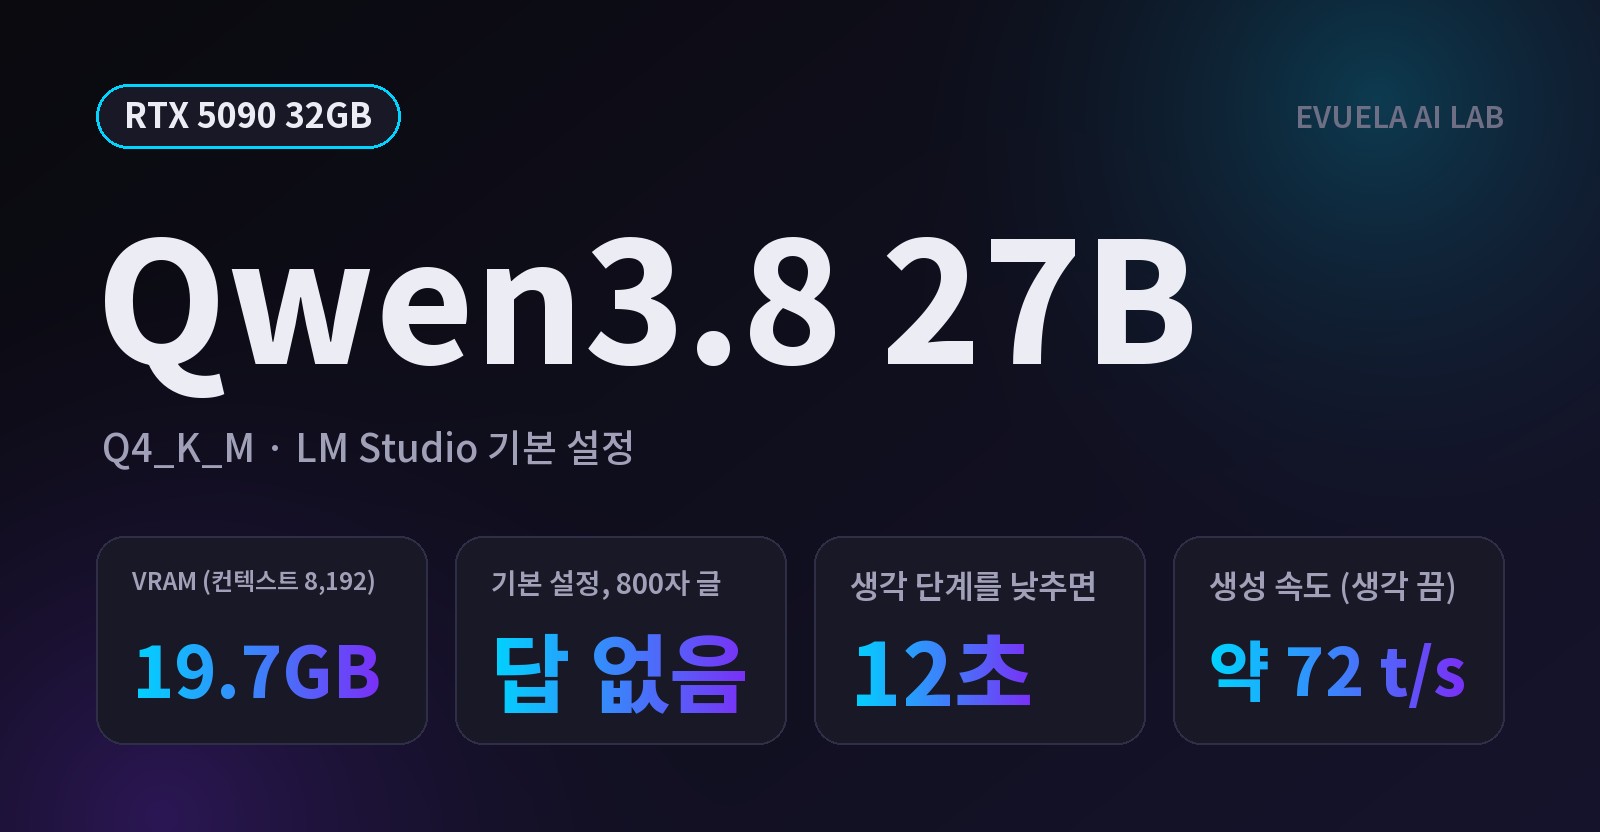
LM Studio 기본 설정으로 Qwen3.8 27B에 800자 글을 부탁하자 1분 넘게 생각만 하다 답 없이 멈췄습니다. 생각 단계를 낮추자 12초 만에 답이 나왔습니다. VRAM 19.7GB, 산수, 없는 소설, 이미지 입력, MTP 속도까지 RTX 5090에서 잰 결과입니다.
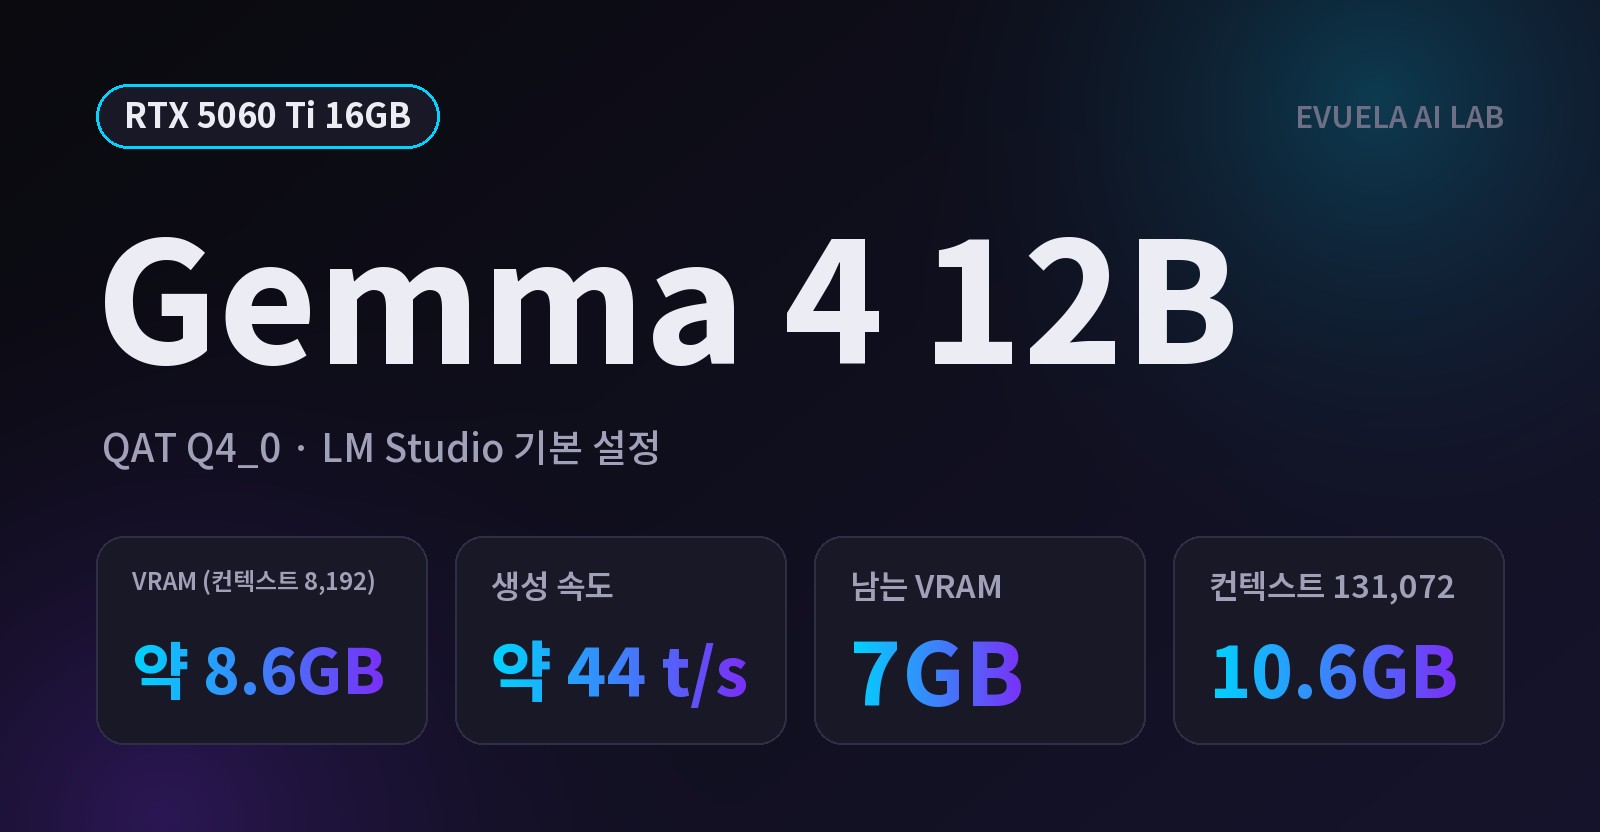
RTX 5060 Ti 16GB PC의 LM Studio에서 Gemma 4 12B QAT를 기본 설정 그대로 돌려 본 실측 기록입니다. 초당 약 44토큰, VRAM 약 8.6GB였고, 생각 기능을 끄면 산수를 5번 모두 틀렸습니다. 같은 방법으로 잰 RTX 5090 결과와 함께 비교합니다.
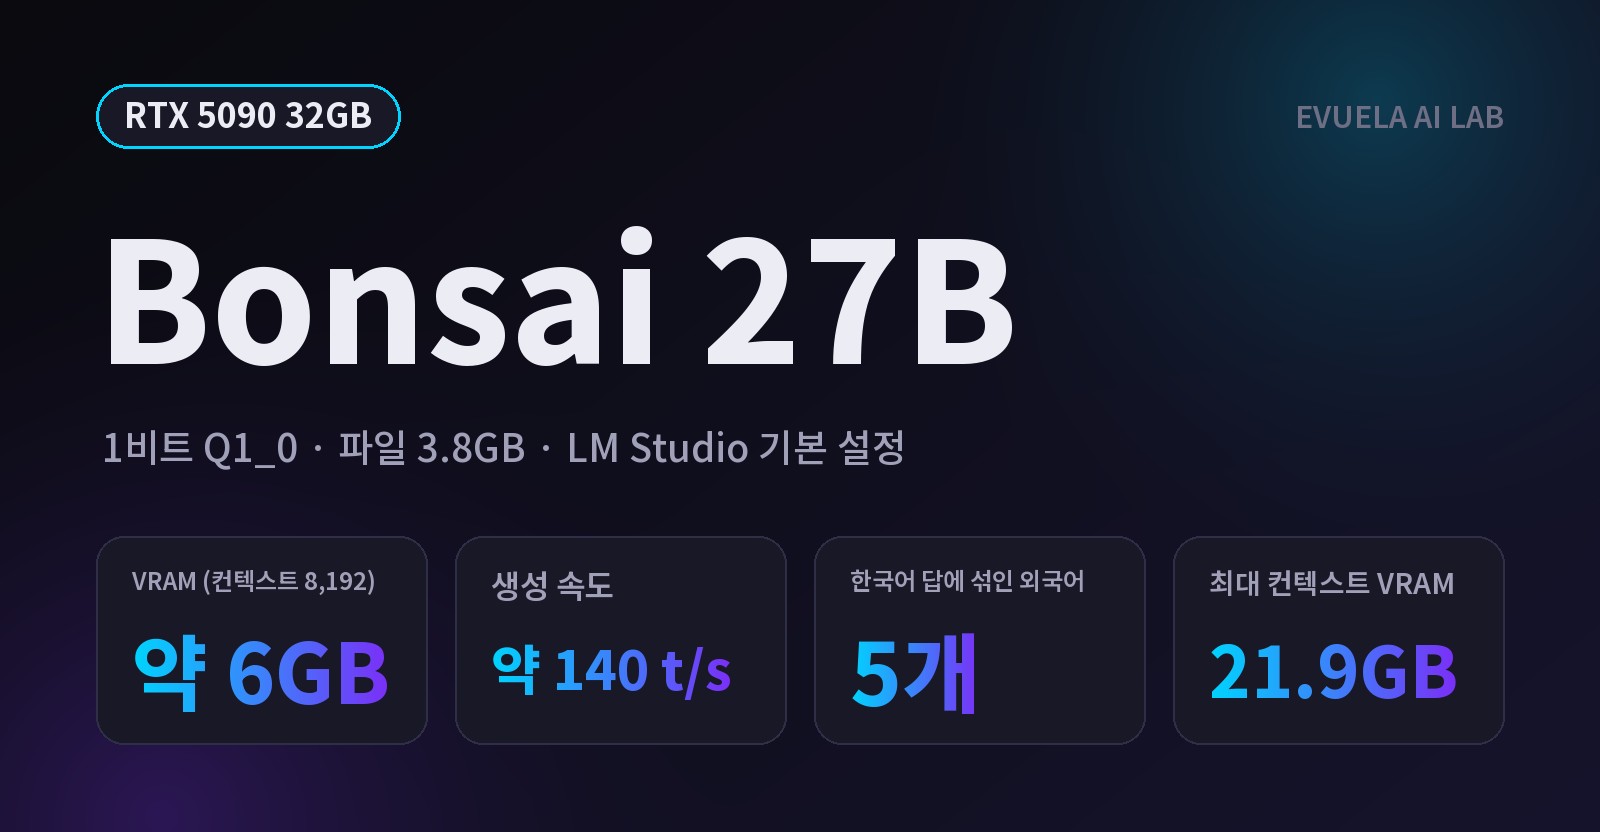
Qwen3.6-27B를 1비트로 줄인 Bonsai 27B를 RTX 5090 PC의 LM Studio에서 기본 설정으로 돌렸습니다. 초당 약 140토큰, 기본 VRAM 약 6GB로 빠르고 가벼웠지만, 한국어 답변에 외국어가 섞이고 산수는 5번 중 2번만 맞혔습니다. 캡처와 실측값으로 정리했습니다.
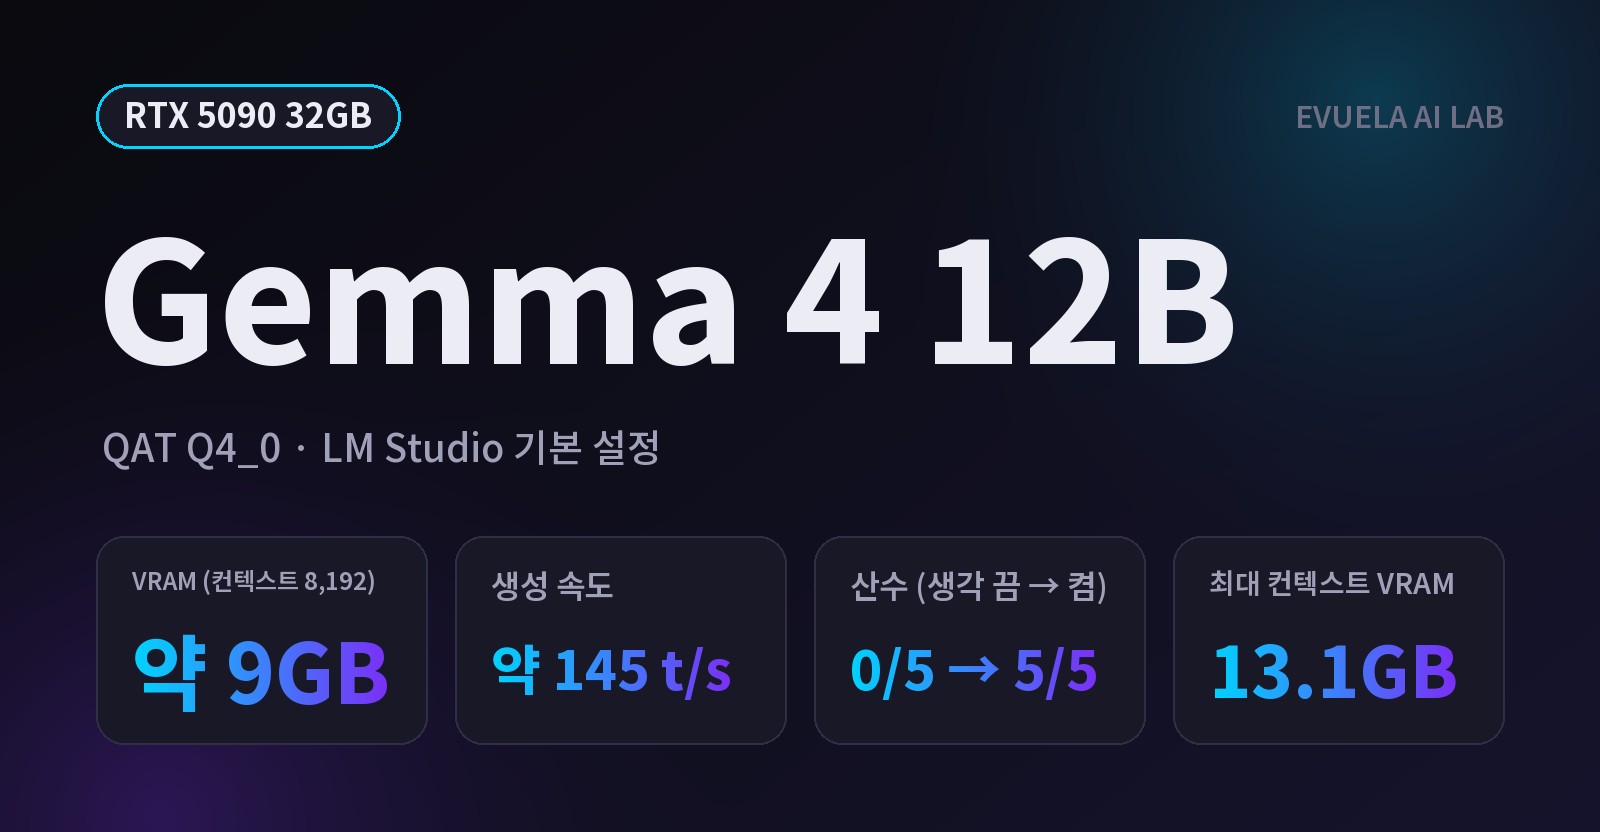
RTX 5090 PC의 LM Studio에서 Gemma 4 12B QAT(Q4_0)를 기본 설정으로 직접 돌린 기록입니다. PC 사양, LM Studio 기본 설정값, 생성 속도, 컨텍스트별 VRAM, 긴 글 요약, 생각 기능 켬·끔 비교, 이미지 입력까지 캡처와 실측값으로 정리했습니다.