 IT 뉴스
GitLab AI Gateway 9.9점 취약점은 누가 고쳐야 할까, 직접 설치한 곳만 19.4.1 등으로 올리면 된다
GitLab이 AI Gateway의 치명적 취약점 CVE-2026-90970(CVSS 9.9)을 고쳤습니다. 로그인한 사용자가 서버 명령을 실행할 수 있었습니다. 직접 설치한 곳만 해당되는지 확인하는 순서와 올릴 버전, 로컬 AI 서버에 주는 교훈을 정리했습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"MCP" 검색 결과 17건
IT 뉴스
GitLab이 AI Gateway의 치명적 취약점 CVE-2026-90970(CVSS 9.9)을 고쳤습니다. 로그인한 사용자가 서버 명령을 실행할 수 있었습니다. 직접 설치한 곳만 해당되는지 확인하는 순서와 올릴 버전, 로컬 AI 서버에 주는 교훈을 정리했습니다.
 RTX 5060 Ti 16GB
에 로컬 음성 AI VoiceStudio 0.5.6을 직접 설치해 한국어로 써 봤습니다. 기본 엔진 OmniVoice는 50초 음성을 약 11초에 만들었고 VRAM은 3.5GB 안쪽, 더 사람 같았던 VoxCPM2는 2분 넘게 걸렸습니다.
 RTX 5060 Ti 16GB
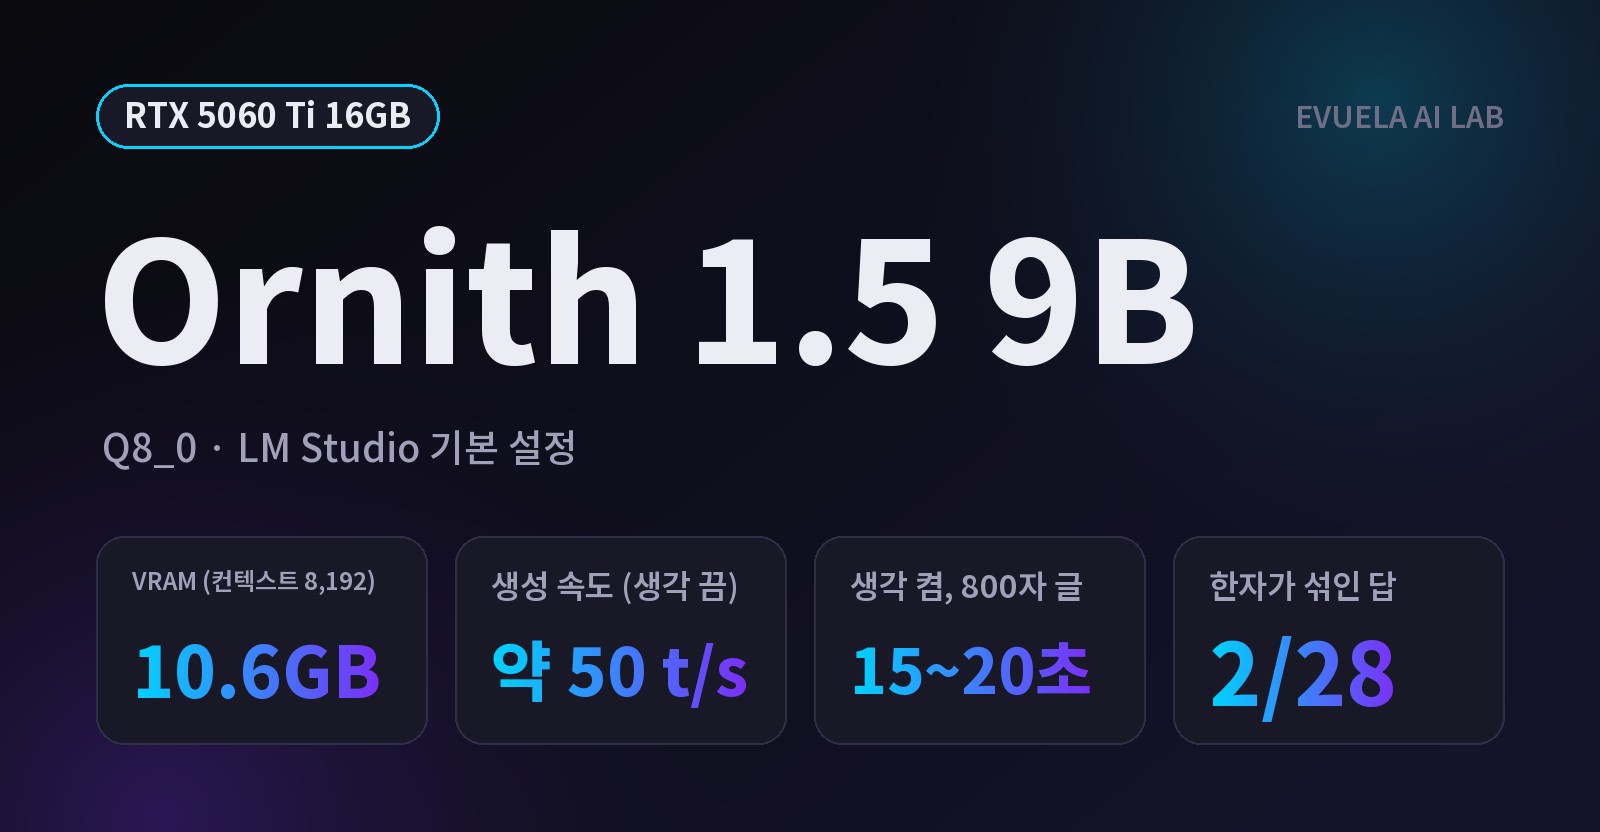
 PC의 LM Studio에서 Ornith 1.5 9B(Q8_0, 9.79GB)를 기본 설정으로 재 봤습니다. VRAM 10.6GB, 생각 끔 약 50t/s, 생각 켬 56~65t/s였고 생각을 켜도 800자 글이 20초 안에 끝났습니다. 한국어 답 28개 중 2개에 한자가 섞였고, 형식 지시는 지키지 않았습니다.
 RTX 5090 32GB
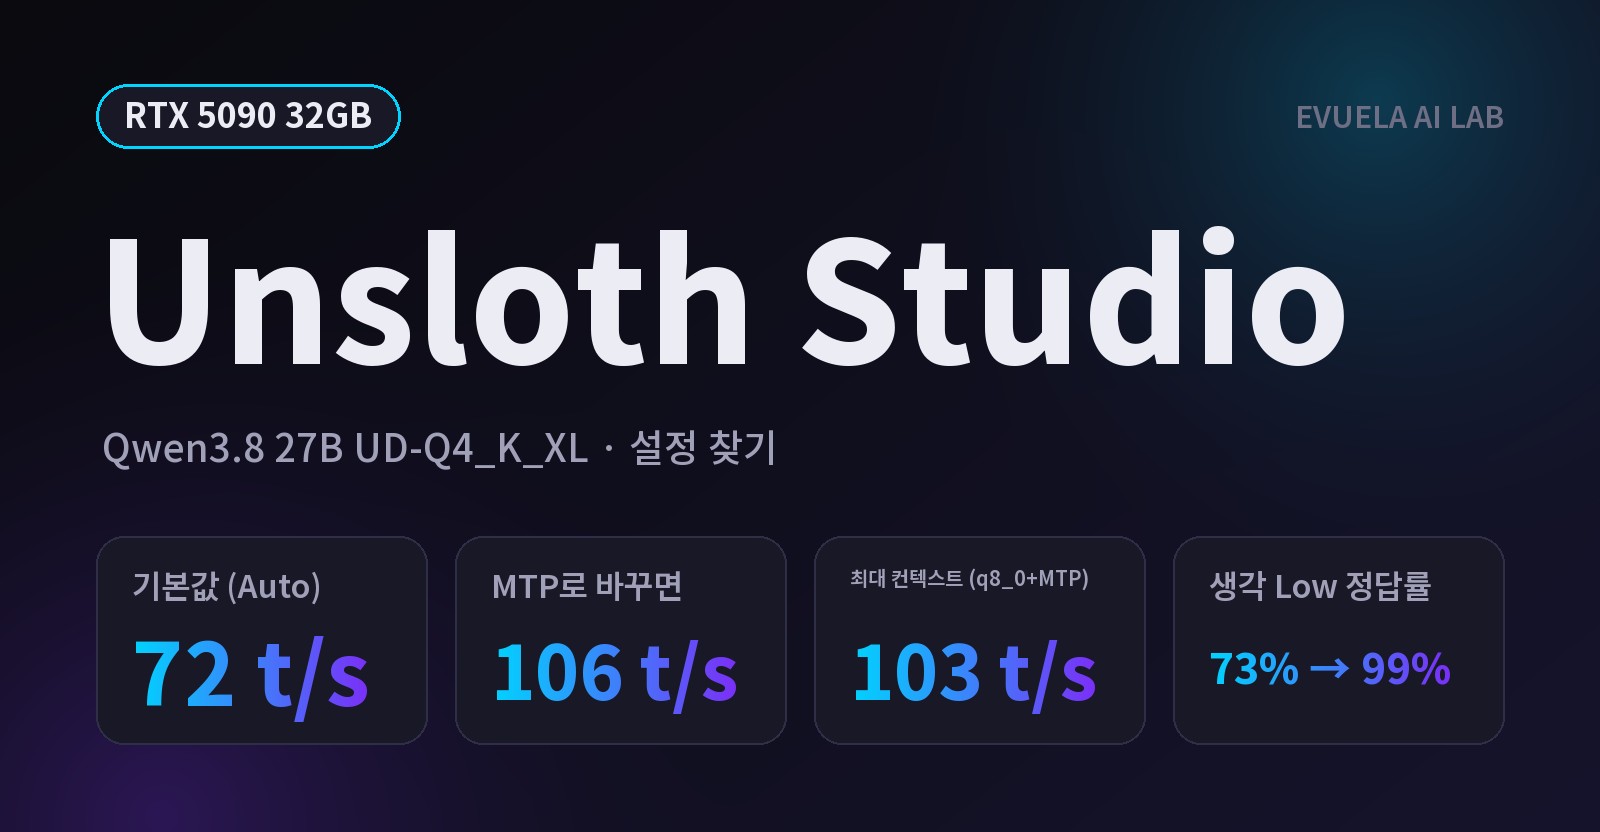
Unsloth Studio를 RTX 5090에 설치하고 Qwen3.8 27B(UD-Q4_K_XL)로 설정을 하나씩 바꿔 가며 쟀습니다. 기본값은 컨텍스트를 16만 8천 토큰으로 알아서 잡았고 초당 72토큰이었습니다. 속도 기능을 MTP로 바꾸면 48% 빨라졌고, KV 캐시를 q8_0으로 줄이면 최대 컨텍스트 262,144에서도 초당 103토큰이 나왔습니다. 생각 단계별 정답률, 화면 캡처, 쓰임새별 추천 설정을 정리했습니다.
 RTX 5090 32GB
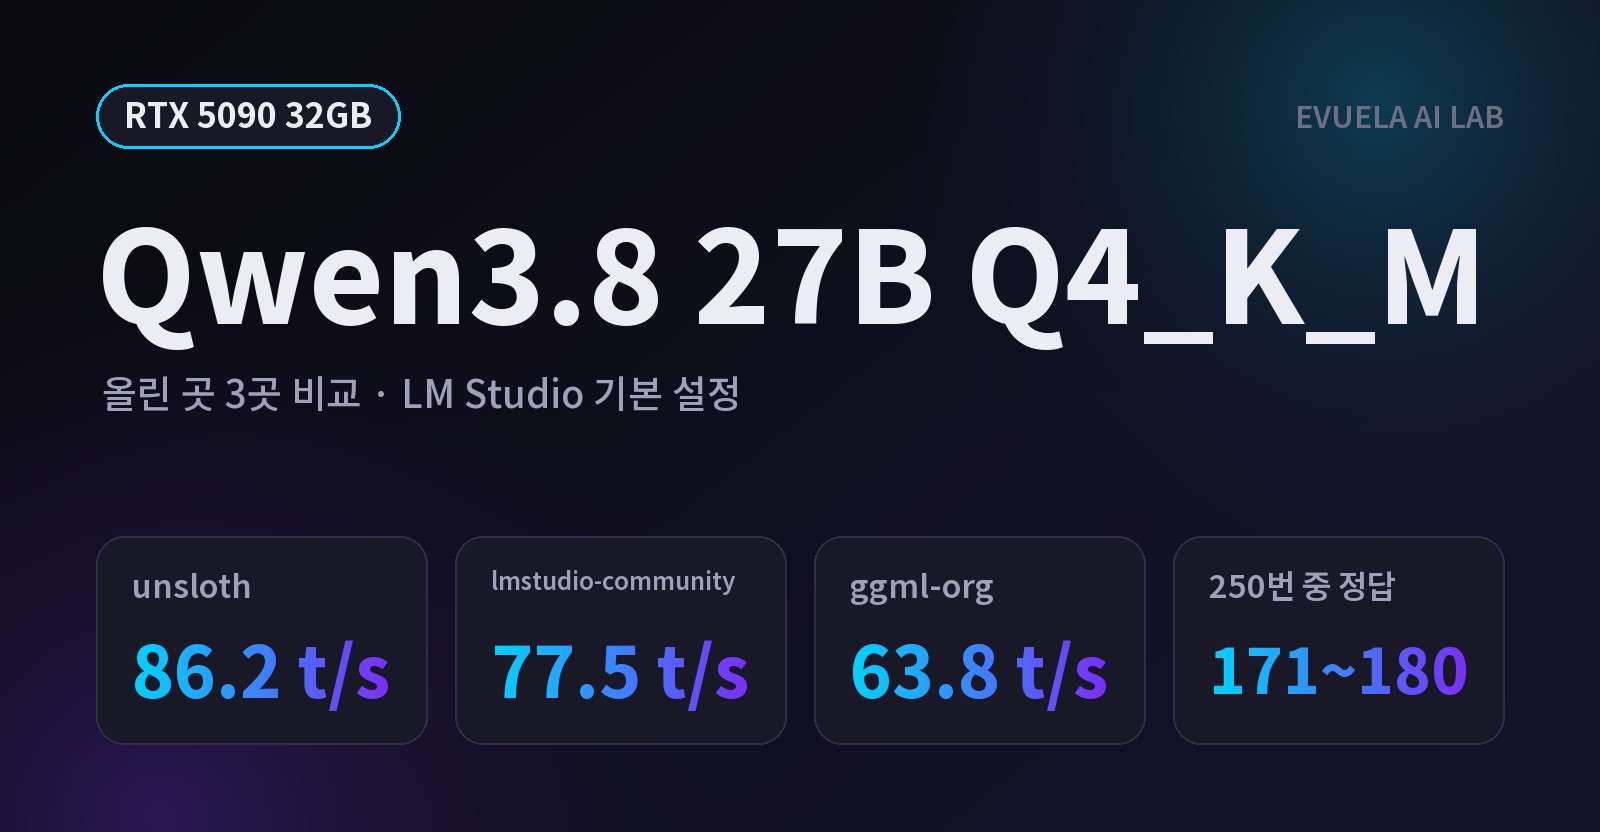
Qwen3.8 27B Q4_K_M 파일을 lmstudio-community, unsloth, ggml-org 세 곳에서 받아 RTX 5090과 LM Studio로 비교했습니다. 채점 질문 250번 중 171~180번을 맞혀 정답률은 거의 같았고, 생성 속도는 초당 63.8~86.2토큰으로 달랐습니다. 차이는 파일 안에 MTP 레이어가 있느냐에서 나왔습니다. 파일 속 양자화 구성, VRAM, MCP 도구 호출 결과와 LM Studio 캡처를 함께 정리했습니다.
 AI 뉴스
OpenAI가 DevDay 2026에서 발표한 dots와 GPT-6.1 Sol을 공식 발표문으로 정리했습니다. dots는 목표를 주면 자기 클라우드 컴퓨터에서 혼자 일하고, 밖으로 나가는 행동은 규칙에 따라 승인을 받습니다. 한국 Pro 사용자도 대상이며, GPT-6.1 Sol은 Astra에 가까운 성능을 5분의 1 가격에 제공합니다. 권한 규칙, 요금제별 가격, 비용 계산 예시를 함께 담았습니다.
 AI 도구
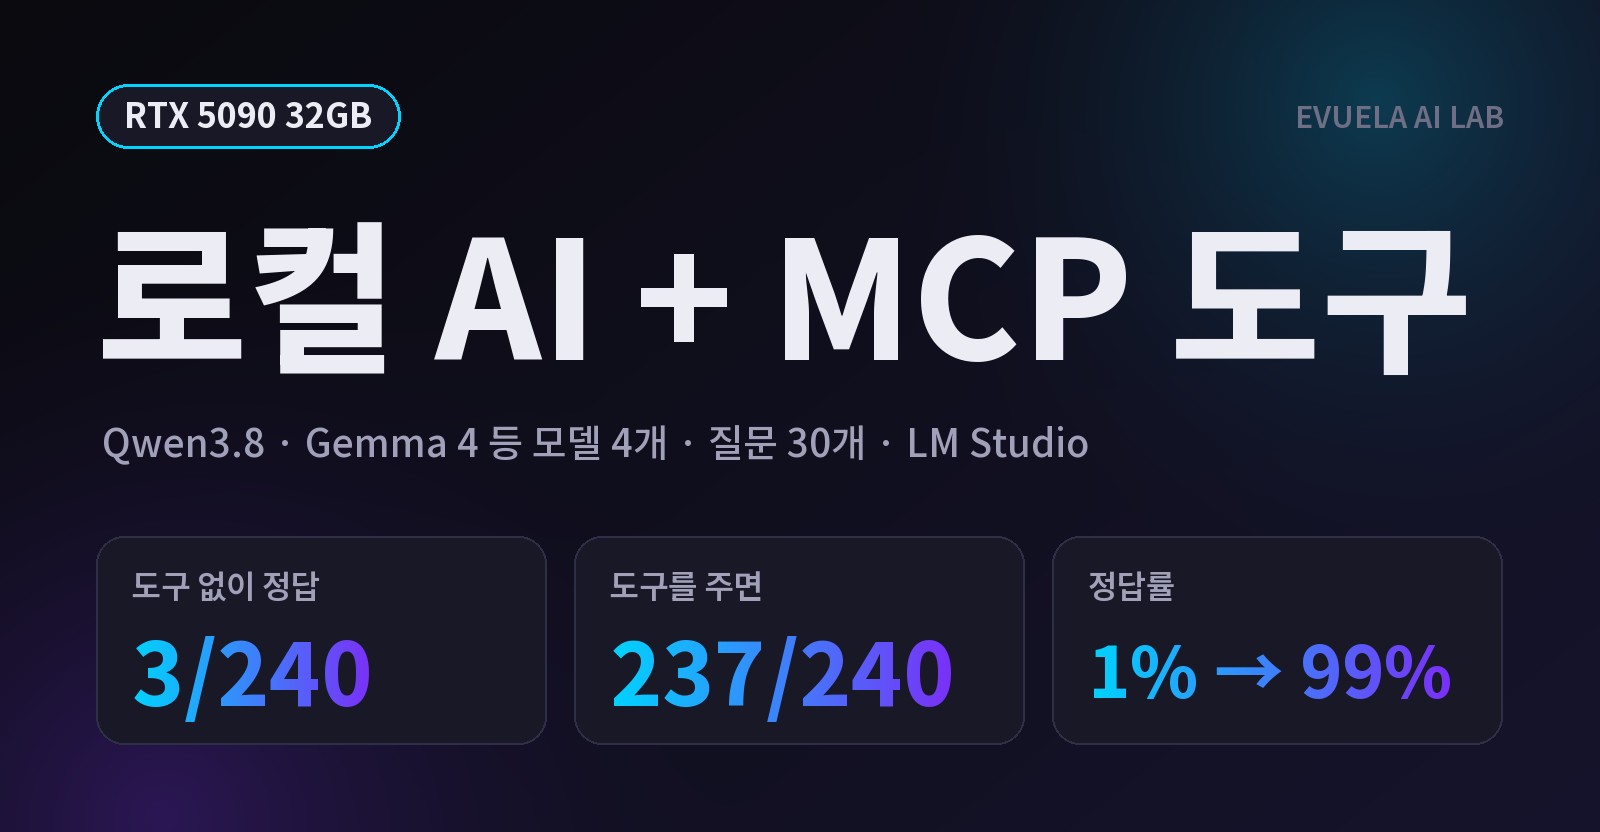
로컬 AI 모델 4개(Qwen3.8 27B, Gemma 4 26B A4B, Gemma 4 31B, Muse Glimmer)에 MCP 도구 3개(웹 페이지 읽기, 현재 시간, 파일 읽기)를 붙이고 같은 질문 30개를 물었습니다. 최신 정보와 파일 질문에서 240번 중 3번이던 정답이 237번이 됐고, 도구가 없을 때는 문서를 읽은 척 틀린 답을 하기도 했습니다. LM Studio 설정 방법과 캡처, 모델별 결과를 정리했습니다.
 RTX 5090 32GB
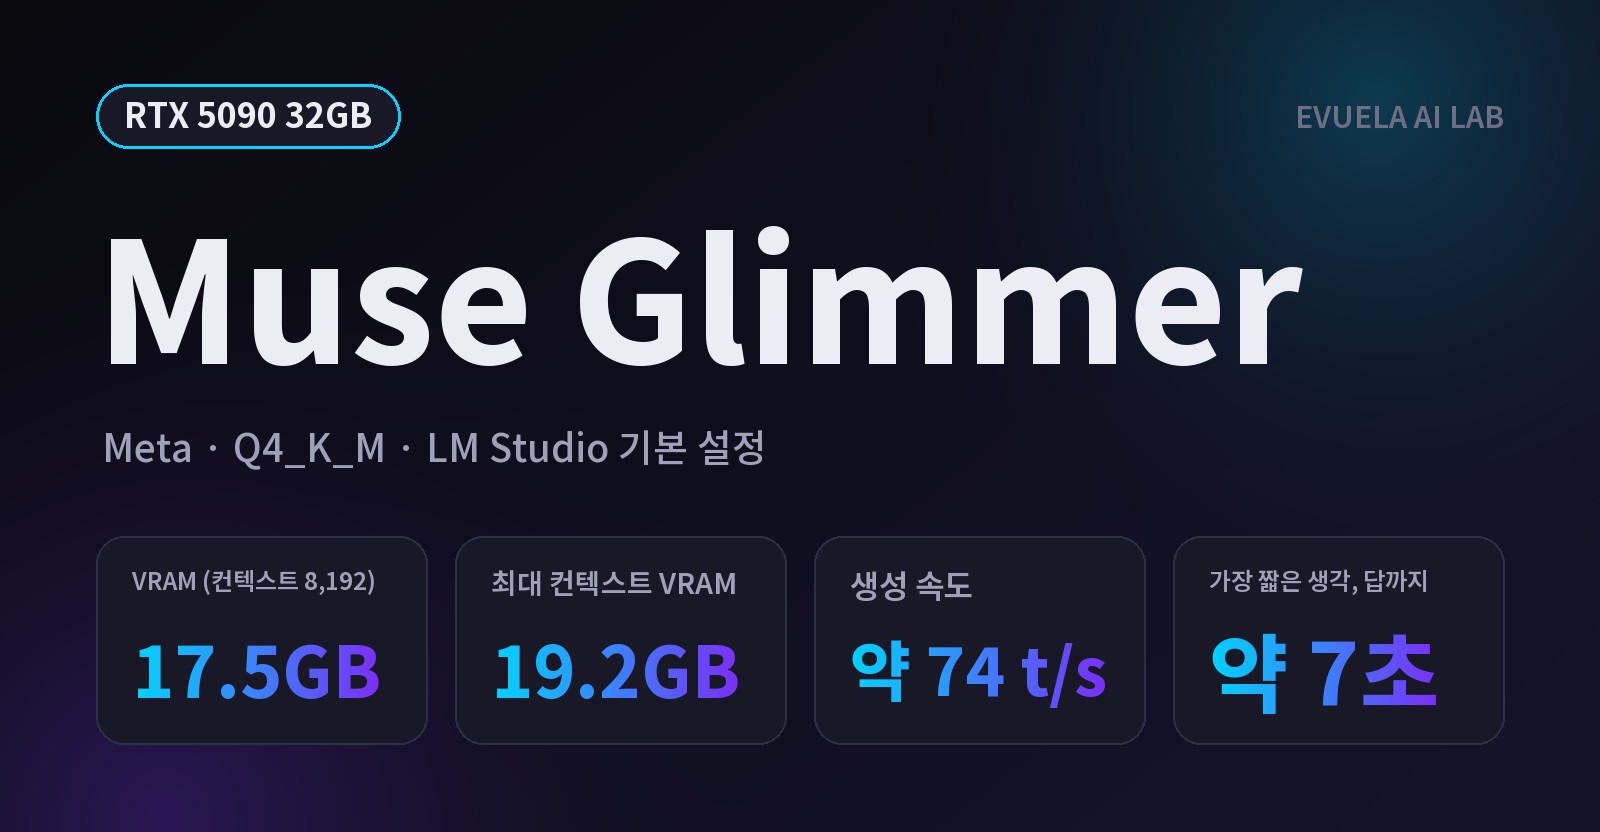
Meta가 공개한 약 300억 파라미터 모델 Muse Glimmer를 RTX 5090의 LM Studio 기본 설정으로 재 봤습니다. 컨텍스트를 16배 늘려도 VRAM은 17.5GB에서 19.2GB로 1.7GB만 늘었고, 기본 설정에서 27번 모두 답했습니다. 속도, 생각 단계, 한국어 품질, 이미지 입력까지 정리했습니다.