 AI 뉴스
GPU 1장으로 돌아간다는 솔라 미니 4, 내 그래픽카드로도 될까, H100 80GB 한 장이라는 뜻이었다
업스테이지 솔라 미니 4의 'GPU 1장 구동'을 공식 발표로 확인했습니다. 양자화한 모델이 H100 80GB 한 장에 올라간다는 뜻이고, 모델 파일은 공개되지 않았습니다. 같은 크기 공개 모델로 그래픽카드별 크기를 가늠했습니다.
EVUELA AI LAB에서 원하는 정보를 찾아보세요
"MoE" 검색 결과 16건
AI 뉴스
업스테이지 솔라 미니 4의 'GPU 1장 구동'을 공식 발표로 확인했습니다. 양자화한 모델이 H100 80GB 한 장에 올라간다는 뜻이고, 모델 파일은 공개되지 않았습니다. 같은 크기 공개 모델로 그래픽카드별 크기를 가늠했습니다.
 AI 뉴스
AMD Ryzen AI Max PRO 400 시리즈가 들어간 PC가 팔리기 시작했습니다. 통합 메모리 192GB 가운데 160GB를 AI 모델에 쓸 수 있고, AMD는 300B 모델까지 돌릴 수 있다고 밝혔습니다. 공식 발표를 정리하고, 직접 잰 Qwen3.8 27B 파일 크기와 RTX 5090 속도를 가져와 300B가 정말 들어가는지, 들어가면 얼마나 빠를지 계산했습니다. 제품 가격과 RTX 5090과의 차이도 함께 담았습니다.
 AI 도구
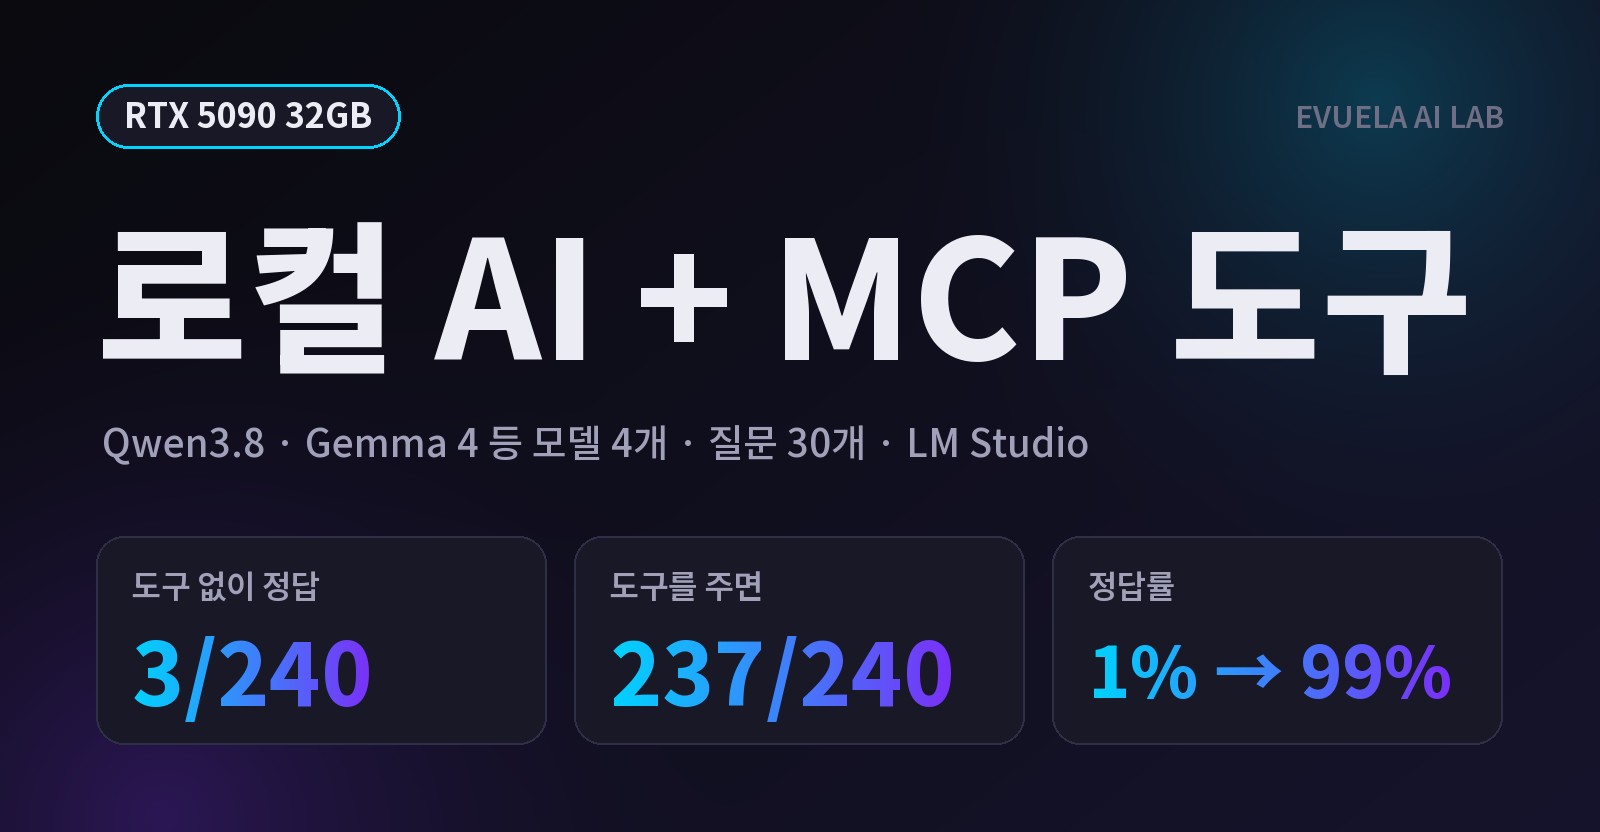
로컬 AI 모델 4개(Qwen3.8 27B, Gemma 4 26B A4B, Gemma 4 31B, Muse Glimmer)에 MCP 도구 3개(웹 페이지 읽기, 현재 시간, 파일 읽기)를 붙이고 같은 질문 30개를 물었습니다. 최신 정보와 파일 질문에서 240번 중 3번이던 정답이 237번이 됐고, 도구가 없을 때는 문서를 읽은 척 틀린 답을 하기도 했습니다. LM Studio 설정 방법과 캡처, 모델별 결과를 정리했습니다.
 RTX 5060 Ti 16GB
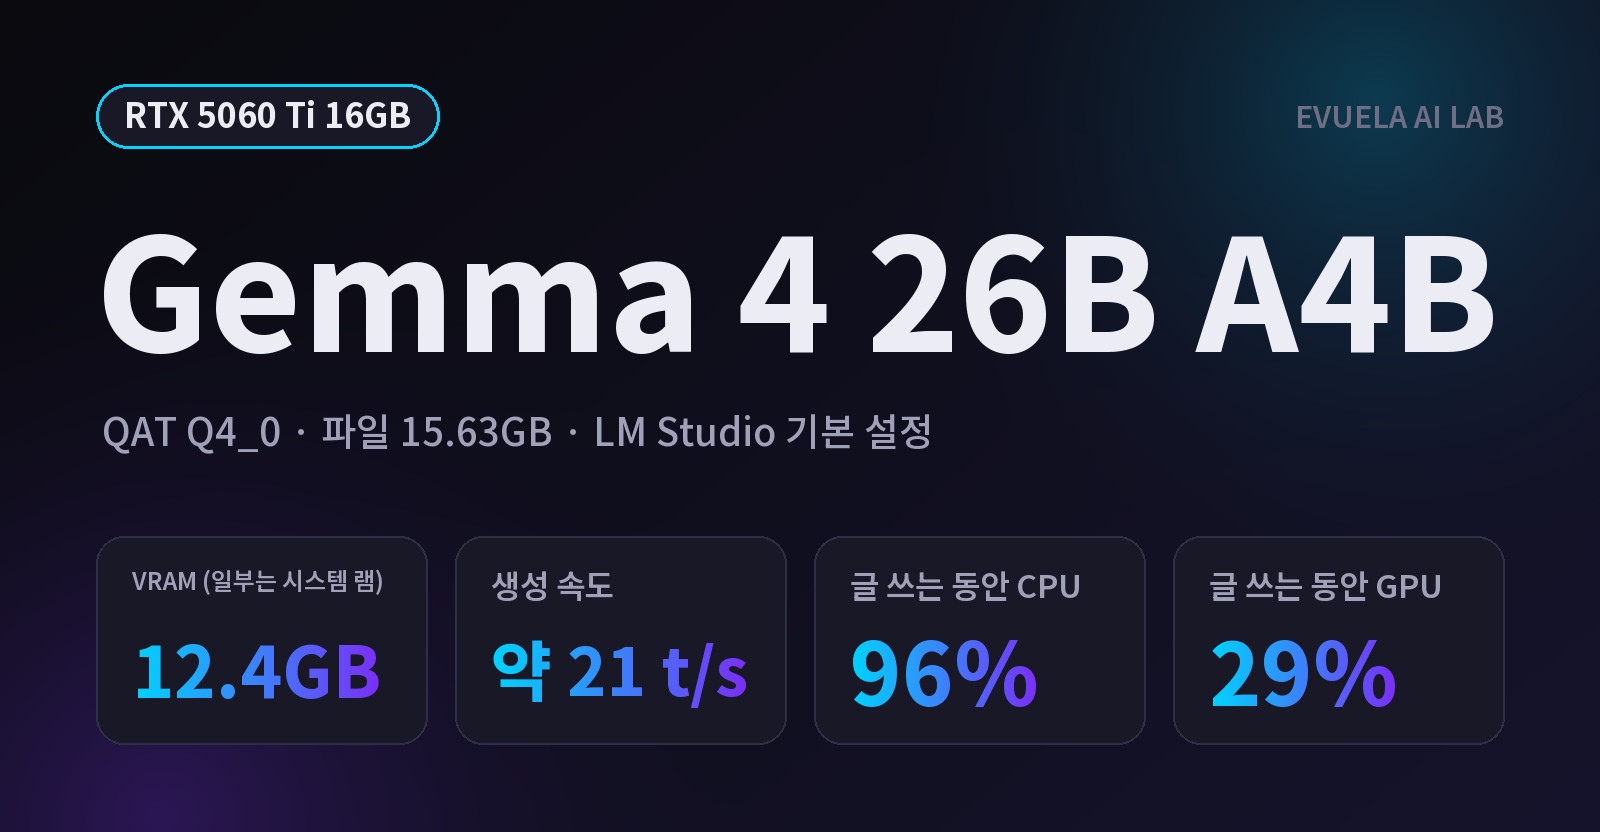
 PC의 LM Studio에서 Gemma 4 26B A4B QAT(15.63GB)를 기본 설정 그대로 돌려 봤습니다. 모델은 로드됐지만 일부가 시스템 램에 남아, 답을 만드는 동안 CPU는 96%, GPU는 29%였습니다. 생성 속도는 약 21t/s로 같은 PC의 Gemma 4 12B의 절반이었습니다.
 AI 뉴스
2026년 9월 22일 함께 나온 GPT-6 Sol·Luna, Claude Opus 5.5, Solar Mini 4와 Gemini 3.8 Flash의 API 가격을 공식 자료 기준으로 한 표에 모았습니다. 같은 작업 1,000회 비용 계산과 할인·인상 날짜, 로컬 GPU 실측 속도도 함께 비교합니다.
 AI 뉴스
2026년 8월 출시된 Qwen3.8-27B는 270억 파라미터의 개방형 멀티모달 모델로, Apache 2.0 라이선스 기반의 강력한 에이전트 코딩 및 실무 작업 성능을 제공한다. 로컬 LLM 환경에서의 VRAM 요구사항과 실무 적용 가능성을 깊이 있게 분석한다.
 AI 뉴스
Dense 모델과 Mixture of Experts (MoE) 모델의 차이점을 파악하고, LLM 아키텍처가 실무에 미치는 영향을 기술적 관점에서 분석합니다. 로컬 AI, SI 환경에서의 활용 전략을 다룹니다.